Respuesta rápida: GPT-6 Luna es el modelo de OpenAI diseñado para tareas específicas de gran volumen. La API oficial indica $0,10 por cada millón de tokens de entrada y $0,50 por cada millón de tokens de salida en tarifas estándar, con una ventana de contexto de 1,05 millones de tokens y una salida máxima de 128 000. Actualmente, GlobalGPT muestra GPT-5.6 Sol y GPT-5.6 Luna en lugar de las rutas exactas de GPT-6, por lo que la denominación de la plataforma debe comprobarse por separado del ID del modelo de la API de OpenAI.
OpenAI describe GPT-6 Luna como su modelo más eficiente para tareas específicas y de gran volumen. Esa frase es una estrategia de posicionamiento del proveedor, no una puntuación de calidad cuantificada. Esta reseña traduce las especificaciones publicadas en decisiones de compra y de arquitectura, y a continuación recoge la reacción del público con la correspondiente atribución. También hemos realizado una prueba de compatibilidad de la API con un alcance definido, conservando el ID del modelo, la ruta, el conjunto de indicaciones, la salida sin procesar y el uso. Los resultados de la tarea se muestran a continuación como una ejecución observada, no como una prueba de rendimiento oficial.
Opinión rápida
Luna es la opción pragmática que prioriza el coste en la lista de precios oficial: mantiene el mismo contexto general y los mismos límites máximos de salida que Sol, pero cobra una fracción de las tarifas de los tokens. Esto la convierte en una opción atractiva para llamadas específicas y repetidas, pero el bajo precio no es garantía de menor latencia ni de menor calidad sin una prueba controlada.
La distinción más útil no es simplemente “inteligente” frente a “rápido”, sino la forma de la carga de trabajo. GPT-6 Luna tiene el mismo contexto general y los mismos límites máximos de salida que su modelo hermano, pero su posicionamiento y su precio hacen que tenga sentido optar por un punto de funcionamiento diferente. Compara el más amplio Guía para la selección de modelos de IA y el mejor modelo de IA para codificación Guía para cuando la tarea abarca a más de un proveedor.
GPT-6 Luna de un vistazo
La tabla que figura a continuación se ajusta a la normativa vigente página oficial del modelo GPT-6 Luna. La capacidad de contexto no es lo mismo que el tamaño recomendado de la solicitud, y la entrada máxima es independiente de la ventana de contexto del titular.
| Campo | Valor oficial |
|---|---|
| ID oficial de la API | gpt-6-luna |
| Posicionamiento del proveedor | tareas que requieren concentración y un gran volumen de trabajo |
| Ventana de contexto | 1 050 000 tokens |
| Entrada máxima | 922 000 tokens |
| Potencia máxima | 128 000 tokens |
| Límite de conocimientos | 18 de mayo de 2026 |
| Entrada / salida | Entrada de texto e imagen / salida de texto |
| Esfuerzo de razonamiento | ninguno, bajo, medio, alto, muy alto, máximo |
| Puntos finales compatibles | Autocompletado de chat, respuestas, procesamiento por lotes |
Ambos modelos hermanos admiten salidas estructuradas, llamadas a funciones, transmisión en tiempo real, almacenamiento en caché de indicaciones, entrada de imágenes, búsqueda de archivos y búsqueda en la web, tal y como se indica en el conjunto de características documentadas. El comportamiento exacto de la herramienta sigue dependiendo del punto final, la cuenta y la configuración de la solicitud; no se debe dar por hecho que la herramienta se ejecutará correctamente solo porque una casilla de verificación indique que dispone de esa capacidad.
En cuanto al contexto familiar, el Reseña del GPT-6 Astra muestra cómo un artículo relacionado con GPT-6 distingue entre la documentación del proveedor, las rutas de la plataforma y las reacciones atribuidas.
Los precios de GPT-6 Luna y la regla de los 272 000
Según las tarifas estándar, el Página de precios de OpenAI Indica $0,10 de entrada, $0,01 de entrada en caché, $0,125 de escrituras en caché y $0,50 de salida por cada millón de tokens. Las escrituras en caché equivalen a 1,25 veces la entrada sin caché. Los modos Batch y Flex tienen un precio de 501 TP40T en el modo Estándar; el modo Rápido cuesta el doble de la tarifa aplicable, y el procesamiento regional añade 101 TP40T cuando está disponible.
| Categoría de tarifa | Hasta 272 000 entradas | Más de 272 000 entradas |
|---|---|---|
| Entrada sin almacenar en caché | $0.10 / 1M | $0.20 / 1M |
| Entrada almacenada en caché | $0.01 / 1M | $0.02 / 1M |
| Escritura en caché | $0,125 / 1M | $0,25 / 1M |
| Salida | $0.50 / 1M | $0,75 / 1M |
La columna de «contexto largo» se calcula a partir de la regla OpenAI: por encima de 272K de entrada, las tasas de entrada y de caché se duplican y la salida se multiplica por 1,5 para la solicitud completa. No se trata de una factura de tarifas mixtas. Como referencia práctica para el presupuesto, 100 000 de entrada más 10 000 de salida cuestan aproximadamente $0.015 antes de las herramientas o el aumento regional; un ejemplo con 300 000 de entrada y 20 000 de salida cuesta aproximadamente $0.075 a las tarifas de contexto largo.
Una ventana de contexto grande puede resultar útil, aunque no sea fácil de llenar. La recuperación, la selección de fragmentos, la reutilización de la caché y los límites de salida son más importantes que la cifra de 1,05 millones que aparece en el titular. Consulta el Desglose de precios del GPT-6 Astra para obtener una explicación relacionada con los umbrales de contexto y el funcionamiento de la caché.
GPT-6 Luna: adaptación a la API, herramientas y límites
OpenAI recomienda la API de respuestas para las herramientas integradas y la llamada a funciones. La función «Completar en el chat» solo admite la llamada a funciones cuando esfuerzo_de_razonamiento está configurado en ninguno. Ese es un detalle de implementación que conviene tener en cuenta antes de la migración: una solicitud puede ser sintácticamente válida y, sin embargo, no ajustarse al comportamiento de la herramienta que espera tu integración actual.
| Capacidad | Comportamiento admitido o documentado |
|---|---|
| Respuestas | Compatible; herramientas integradas y llamada a funciones |
| Autocompletado en el chat | Compatible; la llamada a la función solo se realiza cuando reasoning_effort=none |
| Lote | Compatible; modo de procesamiento independiente con tarifas estándar de tokens 50% |
| Audio / en tiempo real / vídeo | No está disponible en la página del modelo |
| Entrada de imágenes | Compatible; el resultado sigue siendo texto |
| Entrada máxima | 922 000 tokens; no hay que confundir esto con la ventana de contexto de 1,05 millones |
La tabla de límites de velocidad actual recoge los siguientes niveles estándar. RPM significa «solicitudes por minuto», TPM significa «tokens por minuto» y el valor de la cola es el límite de tokens por lote.
| Nivel | RPM | TPM | Cola de lotes |
|---|---|---|---|
| Nivel 1 | 500 | 500,000 | 5,000,000 |
| Nivel 2 | 5,000 | 2,000,000 | 20,000,000 |
| Nivel 3 | 5,000 | 4,000,000 | 40,000,000 |
| Nivel 4 | 10,000 | 10,000,000 | 1,000,000,000 |
| Nivel 5 | 30,000 | 180,000,000 | 15,000,000,000 |
Antes de poner en marcha la producción, comprueba el nivel exacto, el punto final, el modo de transmisión y el contrato de la herramienta en tu propia cuenta. El Guía sobre los límites de uso del Codex Es un contexto útil para explicar por qué el límite máximo publicado de un modelo no coincide con el límite real de una cuenta.
Lo que sugieren las especificaciones del GPT-6 Luna
| Puesto de lector | Por qué encaja | Qué hay que comprobar |
|---|---|---|
| Extracción selectiva | El proveedor asigna a Luna tareas específicas de gran volumen a una tarifa baja en tokens. | Define un esquema y comprueba si hay campos con formato incorrecto o que falten. |
| Resúmenes repetidos | Los bajos precios de las materias primas, la memoria caché y los productos finales facilitan la elaboración del presupuesto para los trabajos recurrentes. | Comprueba las entradas en caché y los límites de salida en tu ruta. |
| Lotes de entrada de gran tamaño | Una entrada máxima de 922K y un contexto de 1,05M permiten gestionar conjuntos de fuentes de gran tamaño. | Presta atención al multiplicador de contexto largo de 272K. |
| Trabajo de agente sin plazo determinado | La API ofrece el mismo amplio vocabulario de herramientas que en papel. | Ejecuta una tarea controlada antes de dar por sentada la calidad o la latencia propias de Sol. |
Esto es un mapa de ajuste, no una prueba de rendimiento. Utiliza el Guía de flujo de trabajo para modelos de IA «todo en uno» cuando lo que realmente tienes que decidir es cómo cambiar de modelo dentro de un proceso repetible, en lugar de cuál de los modelos suena más convincente.
Prueba práctica de la API: tres tareas relacionadas
Ejecutamos las mismas tres pequeñas tareas a través de la API de compatibilidad de Broly Anywhere en https://anywhere.broly.ai/v1/chat/completions utilizando el ID del modelo gpt-6-luna: una revisión del código, un memorándum de decisión con un contexto extenso y una extracción estricta de JSON. Se trata de observaciones útiles sobre el flujo de trabajo, no de una prueba de rendimiento oficial OpenAI ni de una clasificación universal. Las dos primeras pasadas se encontraron con respuestas HTTP 503 temporales por sobrecarga; tras volver a intentarlo, las tres tareas se completaron con un código de estado HTTP 200.
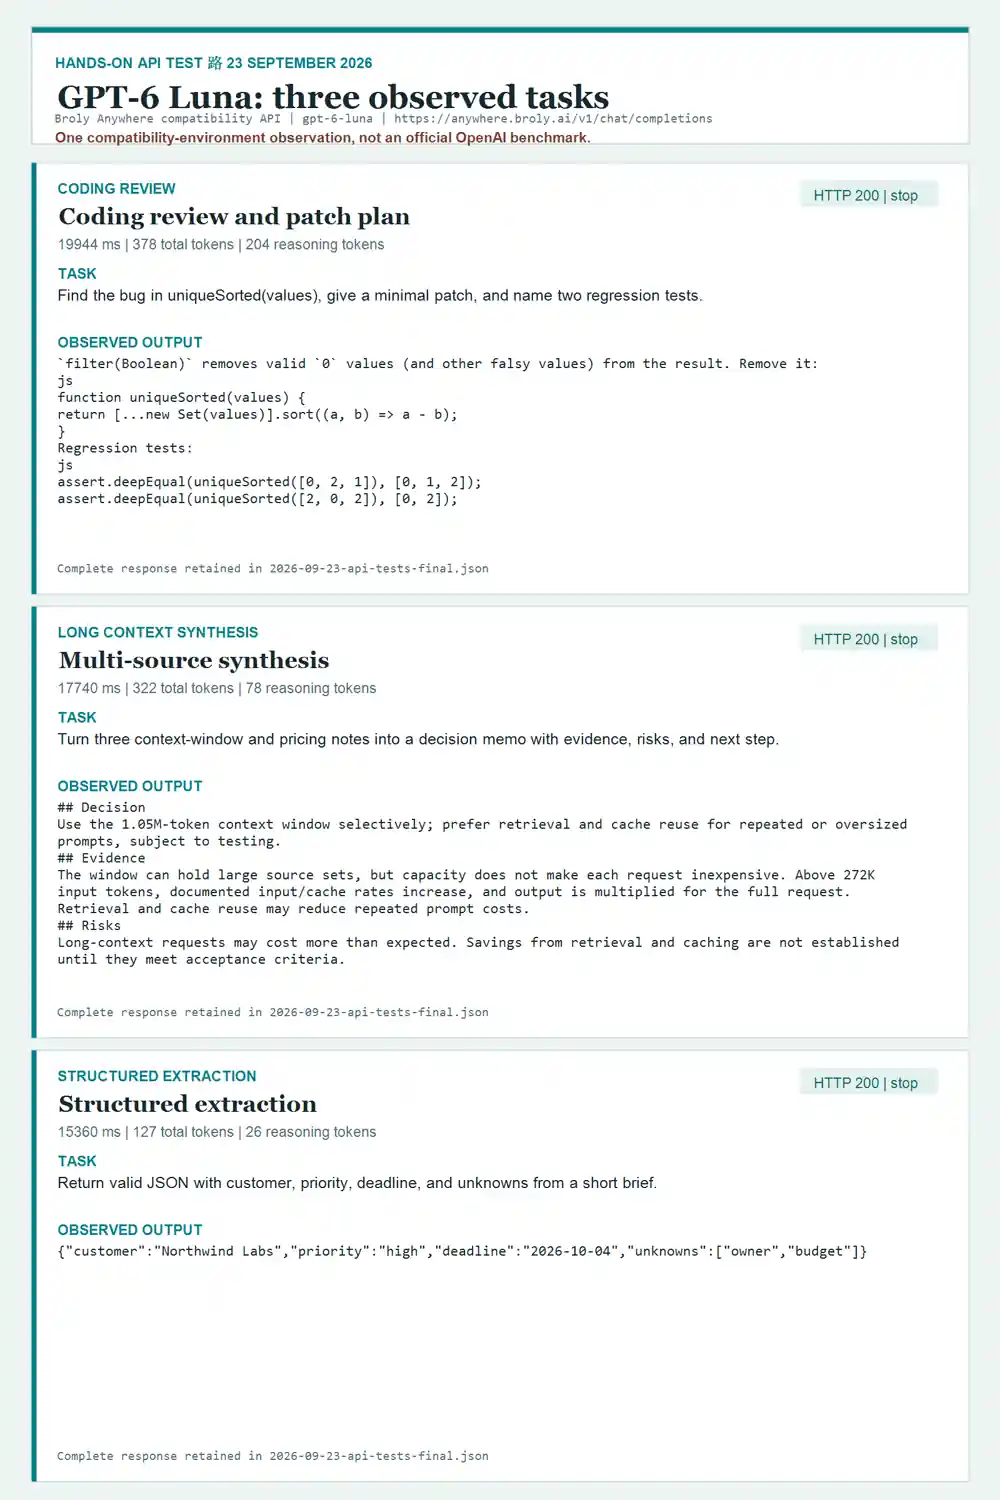
El informe JSON completo incluye todas las consultas, respuestas, códigos de estado HTTP, motivos de finalización, latencia y campos de uso. Las fichas que aparecen a continuación permiten editar esa misma información en el código fuente de WordPress.
Revisión del código y plan de correcciones
19 944 ms · 378 tokens en total · 204 tokens de razonamiento
Revisa esta pequeña función de JavaScript como si formara parte de un repositorio de producción. Identifica el error, explica el modo de fallo y propone un parche mínimo, además de dos pruebas de regresión específicas. Función: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }`filter(Boolean)` elimina los valores `0` válidos (y otros valores que dan «false») del resultado. Elimínalo:
```js
function uniqueSorted(values) {
return [...new Set(values)].sort((a, b) => a - b);
}
```
Pruebas de regresión:
```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```Síntesis a partir de múltiples fuentes
17 740 ms · 322 tokens en total · 78 tokens de razonamiento
Sintetiza las tres notas siguientes en un memorándum de decisión conciso que incluya: la decisión, las pruebas, los riesgos y el siguiente paso. Nota A: Una ventana de contexto de 1,05 millones de tokens puede albergar grandes conjuntos de datos de origen, pero no garantiza que todas las solicitudes sean económicas. Nota B: Por encima de los 272 000 tokens de entrada, las tasas de entrada y caché documentadas aumentan y la salida se multiplica para la solicitud completa. Nota C: La recuperación y la reutilización de la caché pueden reducir el coste de las peticiones repetidas, pero aún es necesario probar los criterios de aceptación.
## Decisión
Utilizar la ventana de contexto de 1,05 millones de tokens de forma selectiva; dar prioridad a la recuperación y la reutilización de la caché para indicaciones repetidas o de gran tamaño, previa realización de pruebas.

## Evidencia
La ventana puede albergar grandes conjuntos de fuentes, pero su capacidad no garantiza que cada solicitud resulte económica. Por encima de los 272 000 tokens de entrada, aumentan las tasas documentadas de entrada y caché, y la salida se multiplica para la solicitud completa. La recuperación y la reutilización de la caché pueden reducir los costes de las solicitudes repetidas.

## Riesgos
Las solicitudes con contexto extenso pueden resultar más costosas de lo esperado. Los ahorros derivados de la recuperación y el almacenamiento en caché no se confirman hasta que cumplen los criterios de aceptación.

## Próximo paso
Probar cargas de trabajo representativas según criterios de aceptación definidos de calidad y coste, incluyendo solicitudes superiores a 272 000 tokens y escenarios de indicaciones repetidas.
Extracción estructurada
15 360 ms · 127 tokens en total · 26 tokens de razonamiento
Extrae los siguientes campos de este resumen y devuelve únicamente un JSON válido con las claves «customer», «priority», «deadline» y «unknowns». Resumen: Cliente: Northwind Labs. Prioridad: alta. Fecha límite: 04/10/2026. No se indica el nombre del responsable y el presupuesto no está confirmado.
{"cliente":"Northwind Labs","prioridad":"alta","fecha límite":"04-10-2026","incógnitas":["responsable","presupuesto"]}En la tarea de programación, GPT-6 Luna detectó el error relacionado con el valor «falsy» en filter(Boolean) y proporcionó un parche además de la cobertura de regresión; la ejecución completa utilizó un total de 378 tokens. En la tarea de contexto largo, mantuvo la estructura de decisión, evidencia, riesgo y siguiente paso, al tiempo que trasladó la advertencia sobre los precios de 272K; la respuesta utilizó un total de 322 tokens. En la tarea de extracción estructurada, devolvió los campos solicitados de cliente, prioridad, plazo y incógnitas en formato JSON. Se trata de formatos de salida observados para esta ruta, no de una prueba de que un modelo sea universalmente mejor.
Lo que las reacciones del público pueden y no pueden decirte
Las siguientes fuentes se incluyen como reacción del público, con la debida atribución, y no como documentación oficial ni como pruebas de referencia contrastadas. Sus títulos reflejan lo que cada autor decidió analizar o explicar; no constituyen un resultado representativo de todo el mercado.
- Chase AI: Ya están aquí GPT 6 Sol y Luna (¡y el 50% es más barato!). Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
- Rob, el experto en IA: ChatGPT ha lanzado GPT-6 Sol y GPT-6 Luna (nuevos modelos y agentes de ChatGPT). Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
- IA con Surya: GPT-6 Soul, Luna y Claude Opus 5.5: ¿cuál deberías usar?. Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
Aquí hay otra cuestión relacionada con la denominación que es importante: varios vídeos públicos utilizan “GPT-6” y “GPT-5.6” indistintamente en los títulos. Indica siempre el identificador exacto del modelo cuando reproduzcas una afirmación. El Comparación entre el GPT-6 Astra y el GPT-5.6 Sol Es un ejemplo útil de por qué la identidad del proveedor, la etiqueta de la plataforma y la ruta deben registrarse por separado.
Acceso a GlobalGPT y nota sobre la denominación de GPT-5.6
El catálogo de modelos verificados de GlobalGPT ofrece actualmente GPT-5.6 Sol y GPT-5.6 Luna. Los ID exactos de la API OpenAI que aparecen en este artículo son gpt-6-luna y forman parte de la documentación oficial de OpenAI. Una versión exacta /home/gpt-6-luna La ruta GlobalGPT no se ha verificado, por lo que este artículo no afirma que la ruta de la plataforma sea un acceso a GPT-6.
Para conocer la nomenclatura actual de las plataformas y el contexto de los créditos independientes, consulta el Guía de precios de GPT-5.6 y el Comparación de modelos GPT-5.6. Esas páginas corresponden al contexto de la plataforma o editorial; no prevalecen sobre la tabla de precios de la API de OpenAI.
Este enlace muestra la denominación actual de la plataforma GlobalGPT, no un identificador de modelo OpenAI de GPT-6 verificado.
Abrir el catálogo de modelos GlobalGPT¿A quién le conviene elegir GPT-6 Luna?
Si en tu lista de opciones hay alternativas más económicas, compara las un catálogo de modelos más amplio en lugar de dar por sentado que el modelo más reciente es automáticamente el que ofrece la mejor relación calidad-precio. Si estás evaluando tareas que requieren un gran volumen de datos, el Guía sobre modelos de análisis de datos ofrece una perspectiva independiente sobre los flujos de trabajo.
Preguntas frecuentes
¿Qué es GPT-6 Luna?
GPT-6 Luna es el modelo de OpenAI diseñado para tareas específicas y de gran volumen. Su identificador oficial de modelo de API es gpt-6-luna.
¿Cuánto cuesta el GPT-6 Luna?
OpenAI indica que GPT-6 Luna tiene un coste de $0,10 por cada millón de tokens de entrada, $0,01 por cada millón de tokens de entrada almacenados en caché, $0,125 por cada millón de escrituras en caché y $0,50 por cada millón de tokens de salida, según las tarifas estándar.
¿Qué ocurre cuando se superan los 272 000 tokens de entrada?
Cuando una solicitud supera los 272K tokens de entrada, OpenAI aplica el doble de las tasas de entrada y de caché, y 1,5 veces las tasas de salida, a toda la solicitud.
¿Cuáles son los límites de contexto y de salida?
GPT-6 Luna presenta una ventana de contexto de 1 050 000 tokens, una entrada máxima de 922 000 tokens y una salida máxima de 128 000 tokens.
¿Cuál es el nivel mínimo de conocimientos exigido?
En la página actual del modelo OpenAI se indica el 18 de mayo de 2026 como fecha límite de actualización de conocimientos para GPT-6 Luna.
¿Qué opciones de razonamiento hay disponibles?
La API documenta los niveles de esfuerzo de razonamiento «none», «low», «medium», «high», «xhigh» y «max», siendo «medium» el valor predeterminado.
¿Qué puntos finales de la API son compatibles?
GPT-6 Luna es compatible con las funciones «Chat Completions», «Responses» y «Batch». En la página del modelo no se indican como compatibles las funciones «Realtime», «Assistants», audio, vídeo, generación de imágenes, incrustaciones, ajuste fino, moderación ni las funciones «Completions» heredadas.
¿GPT-6 Luna admite imágenes?
Sí. En la página del modelo se indican entradas de texto e imágenes, con salida de texto. Eso no lo convierte en un modelo de generación de imágenes.
¿Está disponible GPT-6 Luna en GlobalGPT?
El nombre oficial del modelo OpenAI es GPT-6 Luna, pero GlobalGPT muestra actualmente las etiquetas GPT-5.6 Sol y GPT-5.6 Luna. La ruta exacta de GPT-6 GlobalGPT no está verificada, por lo que este artículo no afirma que se pueda acceder a GPT-6 a través de GlobalGPT.
¿Incluye este artículo alguna referencia comparativa?
Sí, pero el alcance es limitado: tres tareas emparejadas a través de la API de compatibilidad de Broly Anywhere. Los resultados se registran como una sola ejecución observada y no constituyen una prueba de rendimiento oficial OpenAI ni una declaración de victoria universal.
Veredicto final
Luna es la opción pragmática que prioriza el coste en la hoja de precios oficial: mantiene el mismo contexto general y los mismos límites máximos de salida que Sol, pero cobra una fracción de las tarifas de los tokens. Esto la hace muy atractiva para llamadas específicas y repetidas, pero su bajo precio no garantiza una menor latencia ni una menor calidad sin una prueba controlada. Vuelve a consultar el modelo oficial y las páginas de precios el día de la publicación antes de publicar el artículo.
Consultado el 23 de septiembre de 2026. Datos oficiales: OpenAI Developers. Denominación de la ruta de la plataforma: GlobalGPT. Reacción del público: creadores y publicaciones enlazados, solo con atribución.