
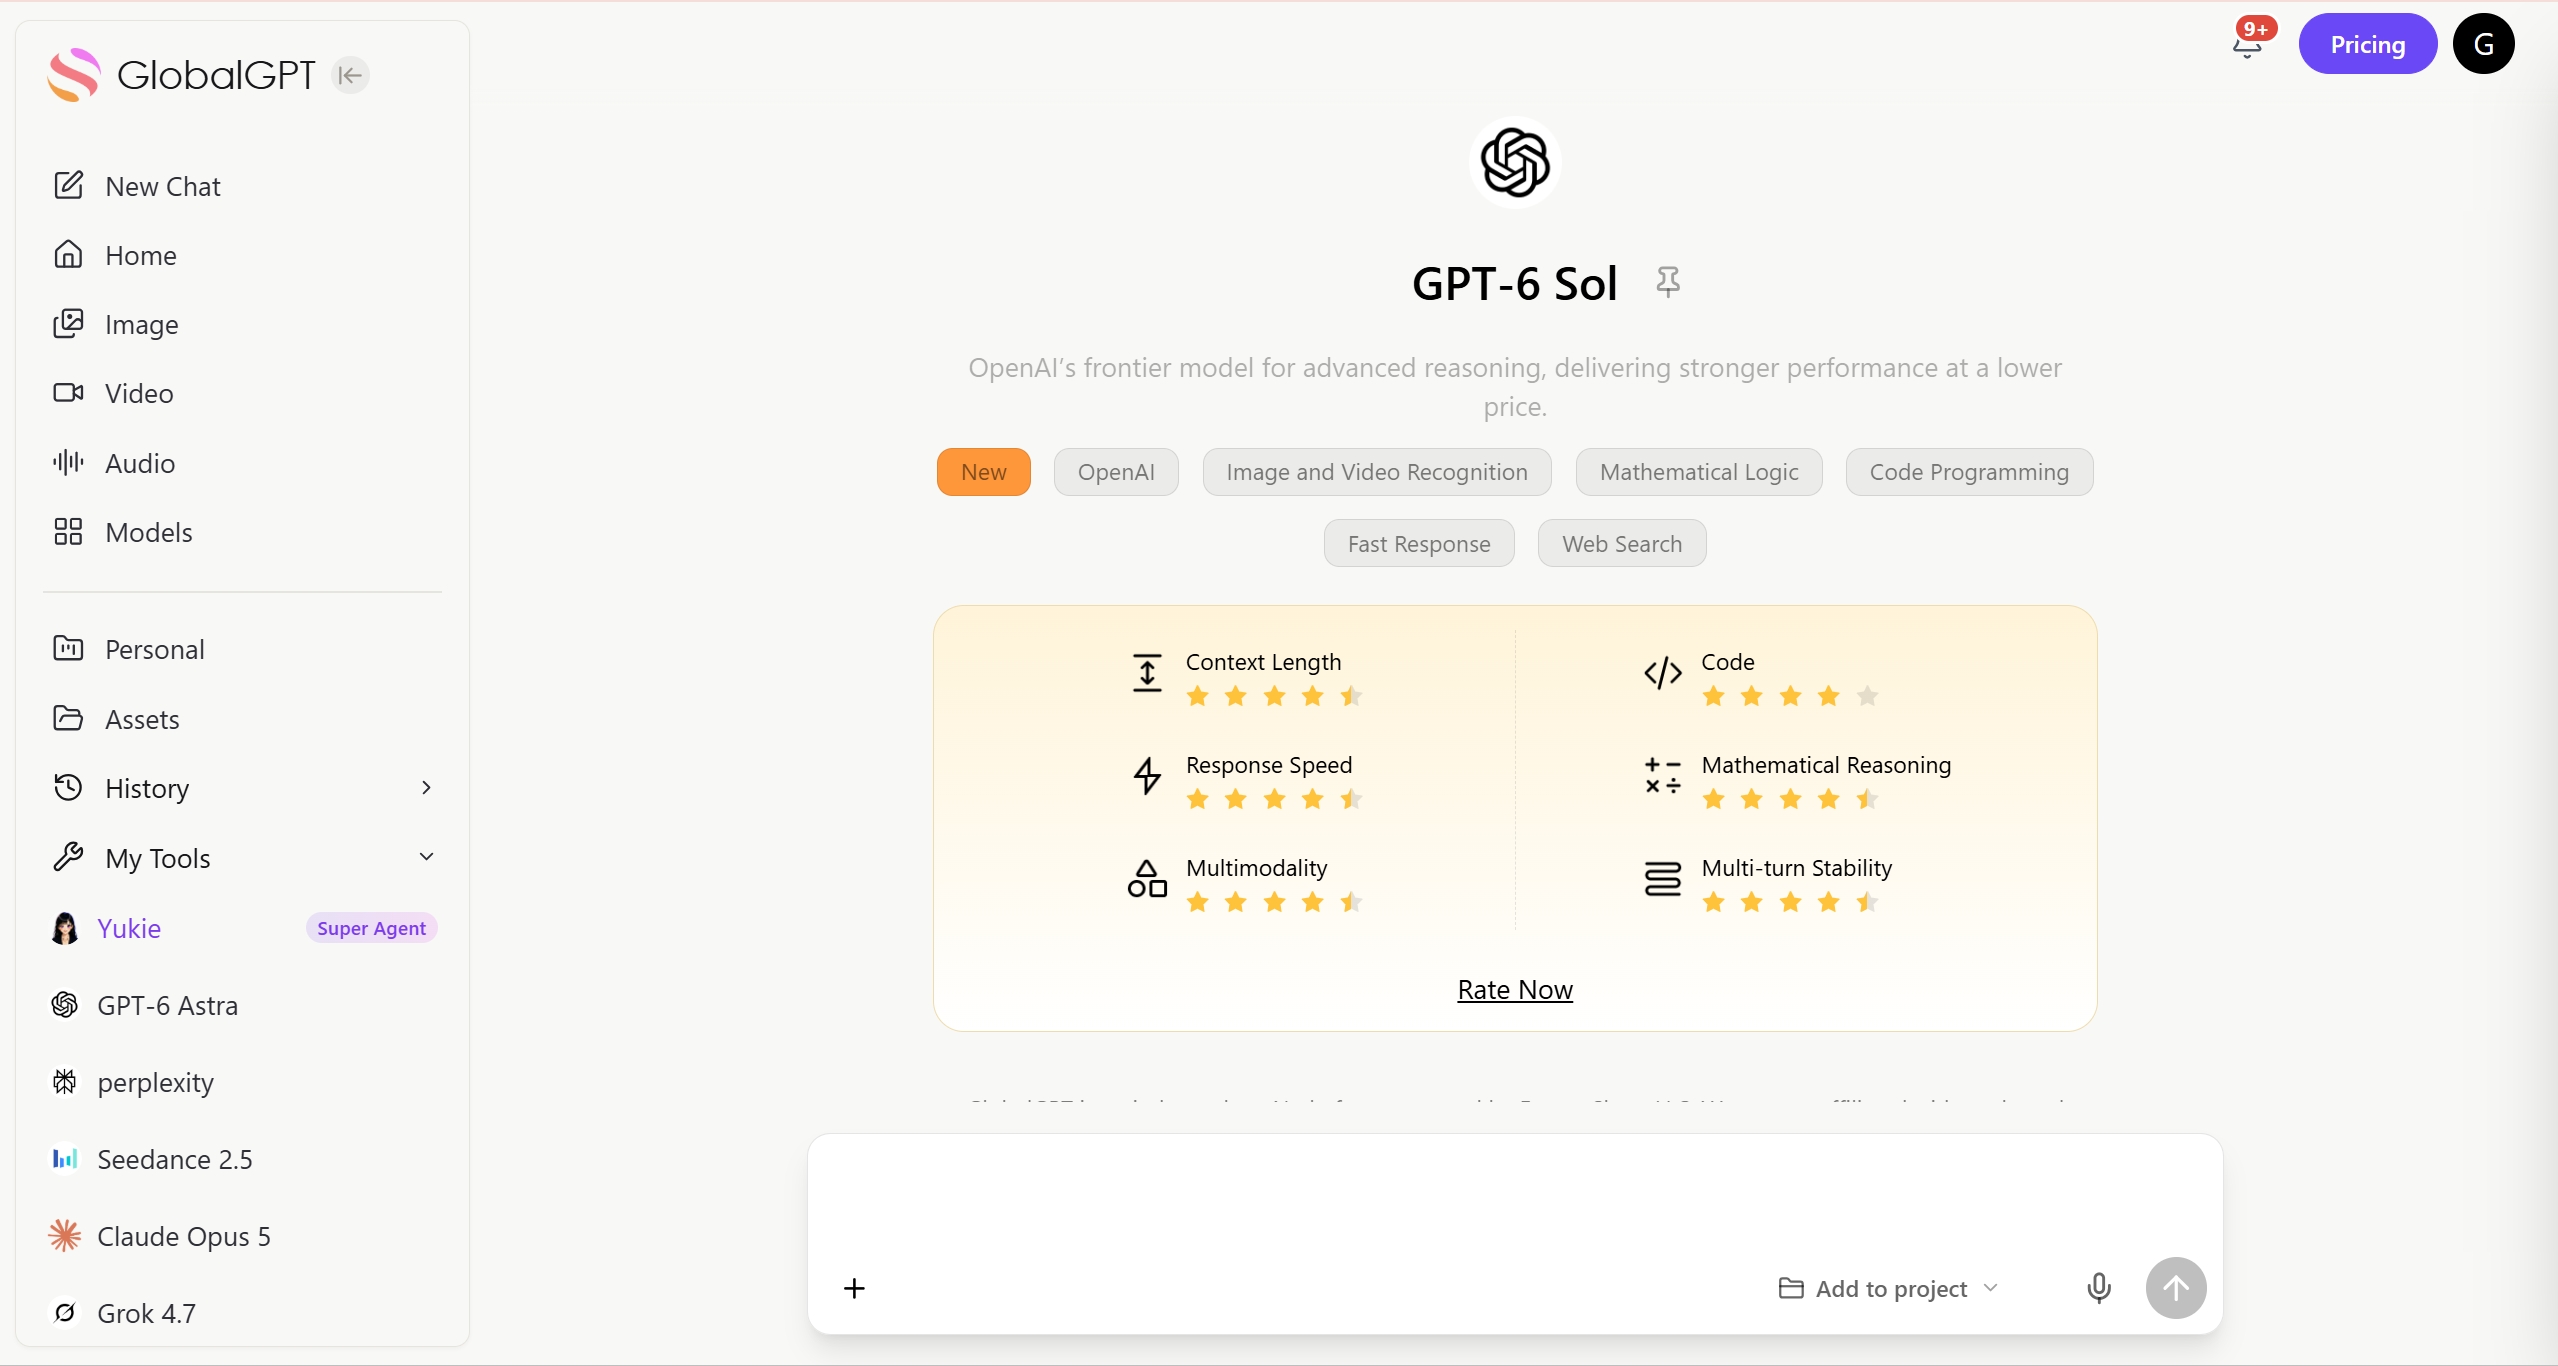
Respuesta rápida: GPT-6 Sol es el modelo de codificación compleja y flujos de trabajo agentivos de OpenAI. La API oficial indica un coste de $2,00 por cada millón de tokens de entrada y de $10,00 por cada millón de tokens de salida en las tarifas estándar, con una ventana de contexto de 1,05 millones de tokens y una salida máxima de 128 000. La cuestión más importante a la hora de adquirir el servicio es si sus respuestas satisfacen los requisitos de tu tarea a un coste total aceptable.
OpenAI posiciona a GPT-6 Sol para tareas de codificación complejas y flujos de trabajo con agentes. Esa frase refleja el posicionamiento del proveedor, no una puntuación de calidad cuantificada. Esta reseña traduce las especificaciones publicadas en decisiones de compra y de arquitectura, y posteriormente recoge la reacción del público con la correspondiente atribución. También ejecutamos tres pequeñas tareas conservando el ID del modelo, la ruta, el conjunto de indicaciones, la salida sin procesar y el uso. Los resultados de las tareas se muestran a continuación como una ejecución observada, no como una prueba de rendimiento oficial.
Opinión rápida
Sol es el modelo que conviene analizar cuando el trabajo es realmente complejo, requiere un uso intensivo de herramientas o se centra en el código, y se puede aceptar un mayor número de tokens. Los datos que aquí se presentan combinan la documentación oficial con nuestra pequeña muestra de tareas, y no constituyen una prueba de rendimiento controlada, por lo que la conclusión responsable es que resulta adecuado, pero no se trata de una clasificación universal.
La distinción más útil no es simplemente “inteligente” frente a “rápido”, sino la forma de la carga de trabajo. GPT-6 Sol tiene el mismo contexto general y los mismos límites máximos de salida que su modelo hermano, pero su posicionamiento y su precio hacen que tenga sentido optar por un punto de funcionamiento diferente. Compara el más amplio Guía para la selección de modelos de IA y el mejor modelo de IA para codificación Guía para cuando la tarea abarca a más de un proveedor.
GPT-6 Sol de un vistazo
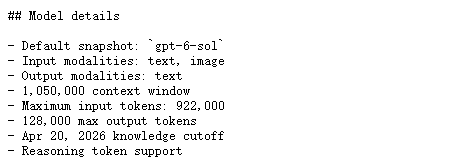
La tabla que figura a continuación se ajusta a la normativa vigente página oficial del modelo Sol de GPT-6. La capacidad de contexto no es lo mismo que el tamaño recomendado de la solicitud, y la entrada máxima es independiente de la ventana de contexto del titular.
gpt-6-solAmbos modelos hermanos admiten salidas estructuradas, llamadas a funciones, transmisión en tiempo real, almacenamiento en caché de indicaciones, entrada de imágenes, búsqueda de archivos y búsqueda en la web, tal y como se indica en el conjunto de características documentadas. El comportamiento exacto de la herramienta sigue dependiendo del punto final, la cuenta y la configuración de la solicitud; no se debe dar por hecho que la herramienta se ejecutará correctamente solo porque una casilla de verificación indique que dispone de esa capacidad.
En cuanto al contexto familiar, el Reseña del GPT-6 Astra muestra cómo un artículo relacionado con GPT-6 distingue entre la documentación del proveedor, las rutas de la plataforma y las reacciones atribuidas.
Precios de GPT-6 Sol y la regla de los 272 000
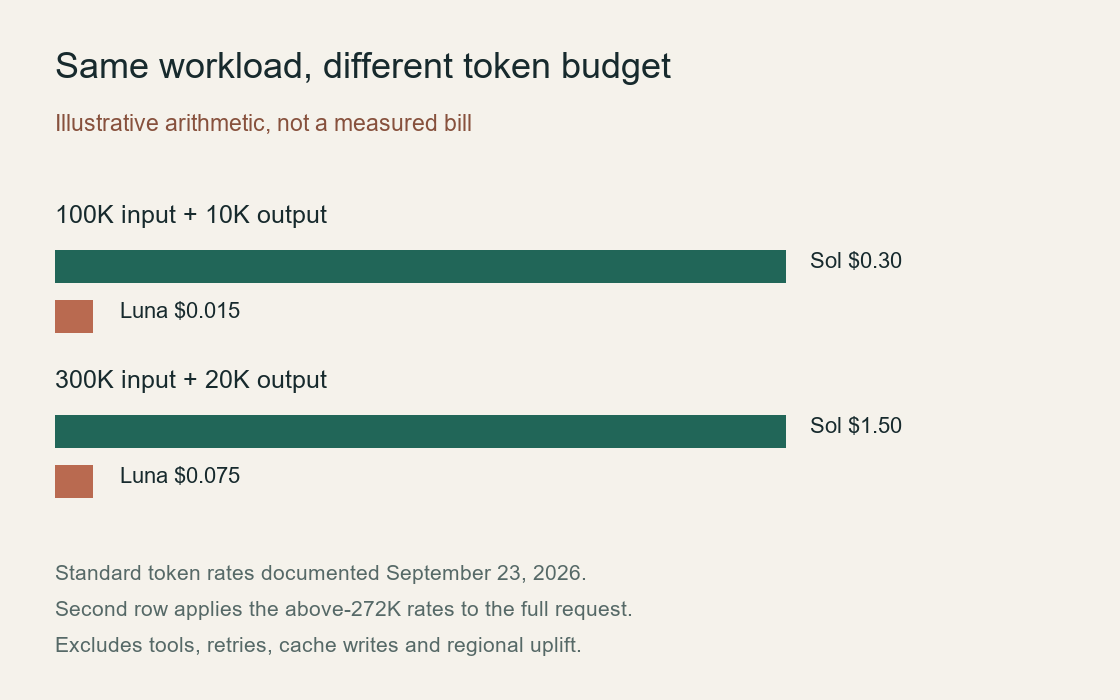
Según las tarifas estándar, el Página de precios de OpenAI Indica $2,00 de entrada, $0,20 de entrada en caché, $2,50 de escrituras en caché y $10,00 de salida por cada 1 millón de tokens. Las escrituras en caché equivalen a 1,25 veces la entrada sin caché. Los modos Batch y Flex tienen un precio de 501 TP40T en el modo Estándar; el modo Rápido cuesta el doble de la tarifa aplicable; y el procesamiento regional añade 101 TP40T cuando está disponible.
La columna de «contexto largo» se calcula a partir de la regla OpenAI: por encima de 272K de entrada, las tasas de entrada y de caché se duplican y la salida se multiplica por 1,5 para la solicitud completa. No se trata de una factura de tarifas mixtas. Como referencia práctica para el presupuesto, 100 000 de entrada más 10 000 de salida cuestan aproximadamente $0.30 antes de las herramientas o el aumento regional; un ejemplo con 300 000 de entrada y 20 000 de salida cuesta aproximadamente $1.50 a las tarifas de contexto largo.
Una ventana de contexto grande puede resultar útil, aunque no sea fácil de llenar. La recuperación, la selección de fragmentos, la reutilización de la caché y los límites de salida son más importantes que la cifra de 1,05 millones que aparece en el titular. Consulta el Desglose de precios del GPT-6 Astra para obtener una explicación relacionada con los umbrales de contexto y el funcionamiento de la caché.
Compatibilidad, herramientas y límites de la API de GPT-6 Sol
OpenAI recomienda la API de respuestas para las herramientas integradas y la llamada a funciones. La función «Completar en el chat» solo admite la llamada a funciones cuando esfuerzo_de_razonamiento está configurado en ninguno. Ese es un detalle de implementación que conviene tener en cuenta antes de la migración: una solicitud puede ser sintácticamente válida y, sin embargo, no ajustarse al comportamiento de la herramienta que espera tu integración actual.
La tabla de límites de velocidad actual recoge los siguientes niveles estándar. RPM significa «solicitudes por minuto», TPM significa «tokens por minuto» y el valor de la cola es el límite de tokens por lote.
Antes de poner en marcha la producción, comprueba el nivel exacto, el punto final, el modo de transmisión y el contrato de la herramienta en tu propia cuenta. El Guía sobre los límites de uso del Codex Es un contexto útil para explicar por qué el límite máximo publicado de un modelo no coincide con el límite real de una cuenta.
Lo que sugieren las especificaciones del GPT-6 Sol
Esto es un mapa de ajuste, no una prueba de rendimiento. Utiliza el Guía de flujo de trabajo para modelos de IA «todo en uno» cuando lo que realmente tienes que decidir es cómo cambiar de modelo dentro de un proceso repetible, en lugar de cuál de los modelos suena más convincente.
En nuestras pruebas: GPT-6 Sol en tres tareas prácticas
El 23 de septiembre de 2026 probamos una pequeña corrección de JavaScript, un memorándum de decisión de tres notas y la extracción de JSON. Los resultados que se muestran a continuación son respuestas completas para el ID del modelo gpt-6-sol. Los intentos anteriores se toparon con errores de sobrecarga temporales, por lo que estos resultados no deben interpretarse como mediciones de fiabilidad obtenidas en un primer intento. Analizamos qué contienen las respuestas, qué puede reutilizar el lector y qué aspectos aún no se han comprobado.
Reparación de código: conservar el cero sin reescribir la función
Revisa esta pequeña función de JavaScript como si formara parte de un repositorio de producción. Identifica el error, explica el modo de fallo y propone un parche mínimo, además de dos pruebas de regresión específicas. Función: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }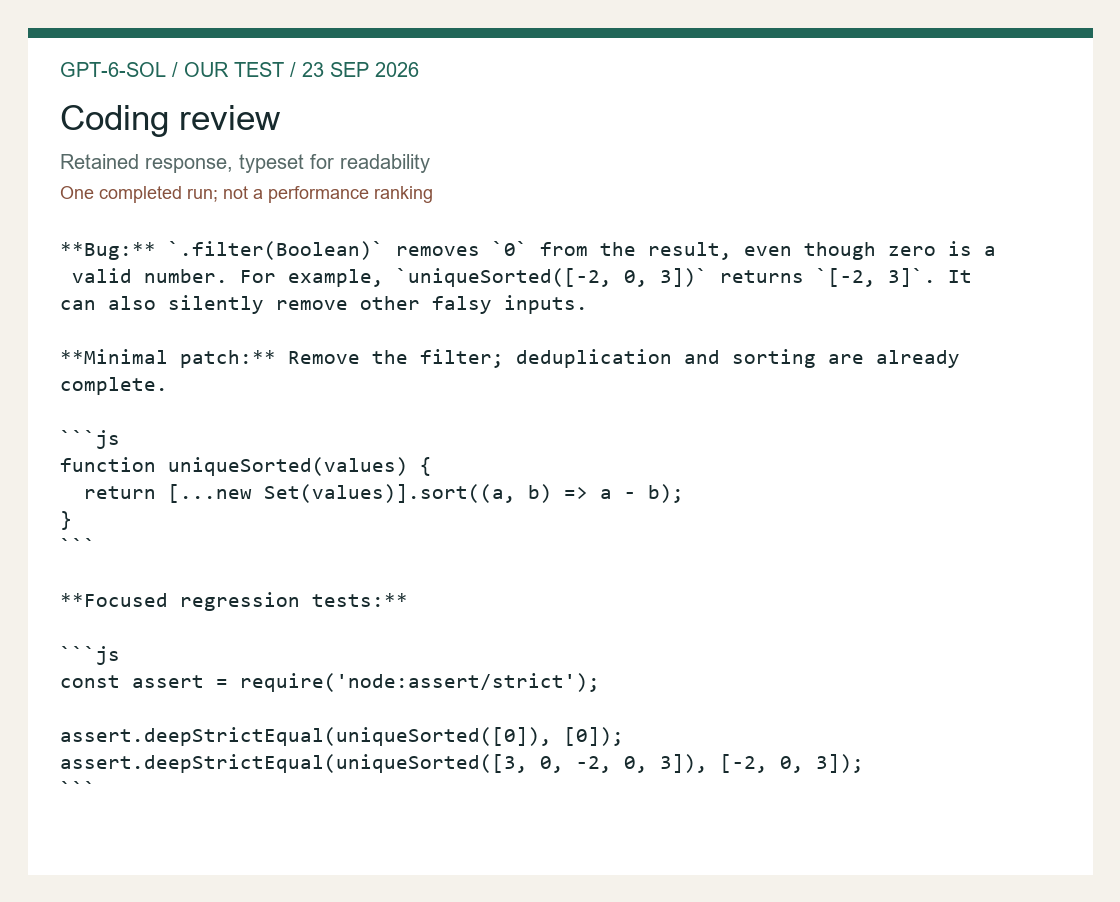
**Error:** `.filter(Boolean)` elimina el `0` del resultado, aunque el cero sea un número válido. Por ejemplo, `uniqueSorted([-2, 0, 3])` devuelve `[-2, 3]`. También puede eliminar silenciosamente otros valores falsos.

**Parche mínimo:** Eliminar el filtro; la deduplicación y la ordenación ya están completas.

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**Pruebas de regresión específicas:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
Uso indicado para esta respuesta completada: 71 tokens de entrada, 409 tokens de finalización, 480 tokens en total. El uso de la finalización puede incluir tokens de razonamiento; no se trata simplemente de la longitud de la respuesta visible.
Sol encontró el fallo real, en lugar de reescribir la función para adaptarla a una preferencia que no tenía nada que ver. El resultado final .filter(Booleano) descartan el cero porque JavaScript convierte el cero en «false». La deduplicación y la ordenación numérica ascendente ya se producen antes de ese filtro. Por lo tanto, eliminar únicamente el filtro corrige el fallo detectado, al tiempo que deja intacto el resto del algoritmo. Este es el tipo de pequeño parche que un revisor puede comprender rápidamente: la explicación identifica el valor defectuoso, la modificación se centra en la operación responsable y las pruebas muestran el comportamiento previsto.
Las dos afirmaciones de regresión cumplen funciones diferentes. El caso del singleton [0] aisla el defecto del «cero que desaparece». El caso mixto combina un número negativo, un cero, un número positivo y duplicados, comprobando que la deduplicación y el orden numérico se mantengan tras la edición. Sol también incluyó require('node:assert/strict'), por lo que la dependencia de la afirmación queda patente. Esos detalles hacen que la respuesta sea más útil que un parche acompañado de un consejo impreciso sobre la necesidad de añadir pruebas. Sin embargo, siguen sin aclarar cómo Sol inspeccionaría un repositorio, resolvería las importaciones entre archivos o gestionaría una compilación fallida.
Hay una cuestión relacionada con el contrato de interfaz que va más allá del error detectado. ¿Se supone que esta función solo debe aceptar números finitos o valores arbitrarios de JavaScript? Al eliminar el filtro, también se conservan otras entradas que devuelven «false» si los usuarios que la llaman las envían. Los valores NaN, el cero negativo, los infinitos, las cadenas numéricas y el valor null requieren decisiones deliberadas sobre la política a seguir. No añadiríamos silenciosamente coerción o validación a este parche sin esa política. Una corrección mínima es valiosa precisamente porque separa el defecto confirmado de un rediseño más amplio.
Síntesis de tres notas: mantener la decisión condicional
Sintetiza las tres notas siguientes en un memorándum de decisión conciso que incluya: la decisión, las pruebas, los riesgos y el siguiente paso. Nota A: Una ventana de contexto de 1,05 millones de tokens puede albergar grandes conjuntos de datos de origen, pero no garantiza que todas las solicitudes sean económicas. Nota B: Por encima de los 272 000 tokens de entrada, las tasas de entrada y caché documentadas aumentan y la salida se multiplica para la solicitud completa. Nota C: La recuperación y la reutilización de la caché pueden reducir el coste de las peticiones repetidas, pero aún es necesario probar los criterios de aceptación.
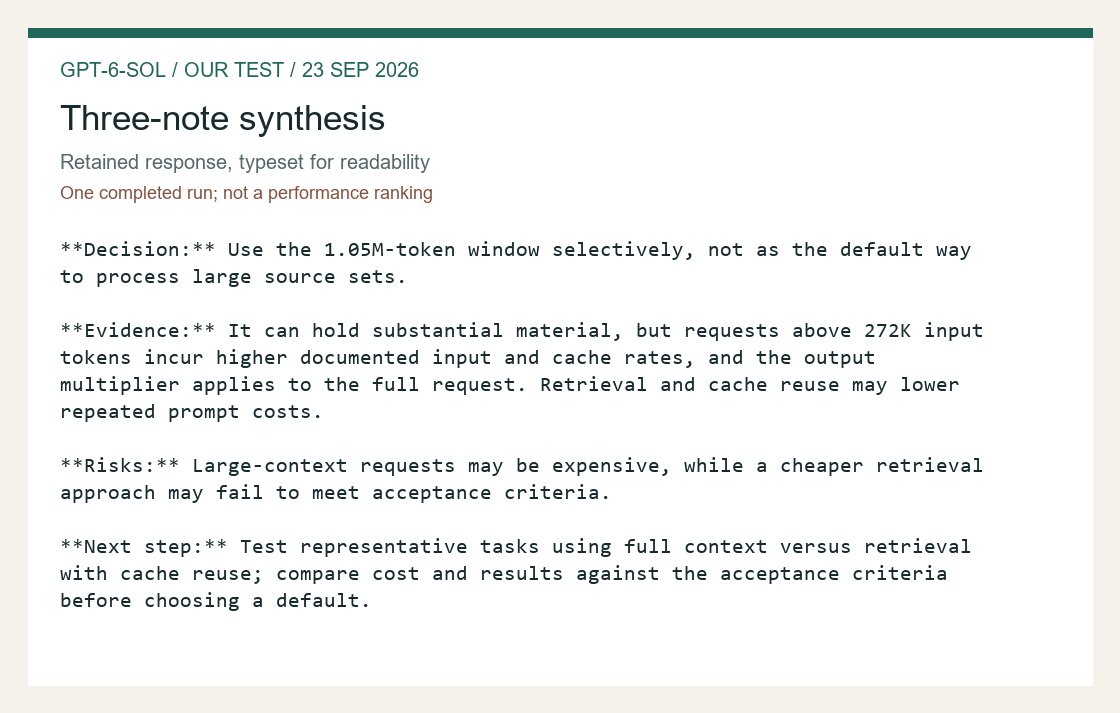
**Decisión:** Utilizar la ventana de 1,05 millones de tokens de forma selectiva, y no como método predeterminado para procesar conjuntos de datos de origen de gran tamaño.

**Justificación:** Puede albergar una cantidad considerable de material, pero las solicitudes con más de 272 000 tokens de entrada conllevan unas tasas de entrada y de caché más elevadas, según se ha documentado, y el multiplicador de salida se aplica a la solicitud completa. La recuperación y la reutilización de la caché pueden reducir los costes de las peticiones repetidas.

**Riesgos:** Las solicitudes con contextos extensos pueden resultar costosas, mientras que un enfoque de recuperación más económico podría no cumplir los criterios de aceptación.

**Próximo paso:** Probar tareas representativas utilizando el contexto completo frente a la recuperación con reutilización de la caché; comparar el coste y los resultados con los criterios de aceptación antes de elegir un método por defecto.
Uso indicado para esta respuesta completada: 99 tokens de entrada, 186 tokens de finalización, 285 tokens en total. El uso de la finalización puede incluir tokens de razonamiento; no se trata simplemente de la longitud de la respuesta visible.
Sol organizó las tres notas en «decisión», «pruebas», «riesgos» y «próximo paso». Su recomendación fue el uso selectivo de la ventana grande, evaluando la recuperación y la reutilización de la caché en función de criterios de aceptación. El comportamiento útil fue la preservación de la formulación condicional: la recuperación puede reducir el coste, pero solo una prueba de carga de trabajo puede determinar si conserva la información que necesita la decisión. La respuesta no estableció un porcentaje de ahorro, una puntuación de recuperación medida ni una recomendación de enviar siempre el contexto máximo.
Esta entrada constaba únicamente de 99 tokens de indicaciones. Sirve para poner a prueba la síntesis de notas breves y el seguimiento de instrucciones, no la capacidad de recuperar un dato oculto entre cientos de miles de tokens. Las declaraciones sobre precios se proporcionaron en las notas; repetirlas correctamente no constituye una verificación independiente de los precios. En un memorándum de arquitectura real, añadiríamos identificadores de fuente, un responsable de la decisión y una hipótesis presupuestaria explícita. Esas adiciones harían que cada frase fuera auditable, sin pretender que este breve ejercicio abarcara toda la ventana de contexto.
Extracción de JSON: mantener explícitas las incógnitas
Extrae los siguientes campos de este resumen y devuelve únicamente un JSON válido con las claves «customer», «priority», «deadline» y «unknowns». Resumen: Cliente: Northwind Labs. Prioridad: alta. Fecha límite: 04/10/2026. No se indica el nombre del responsable y el presupuesto no está confirmado.
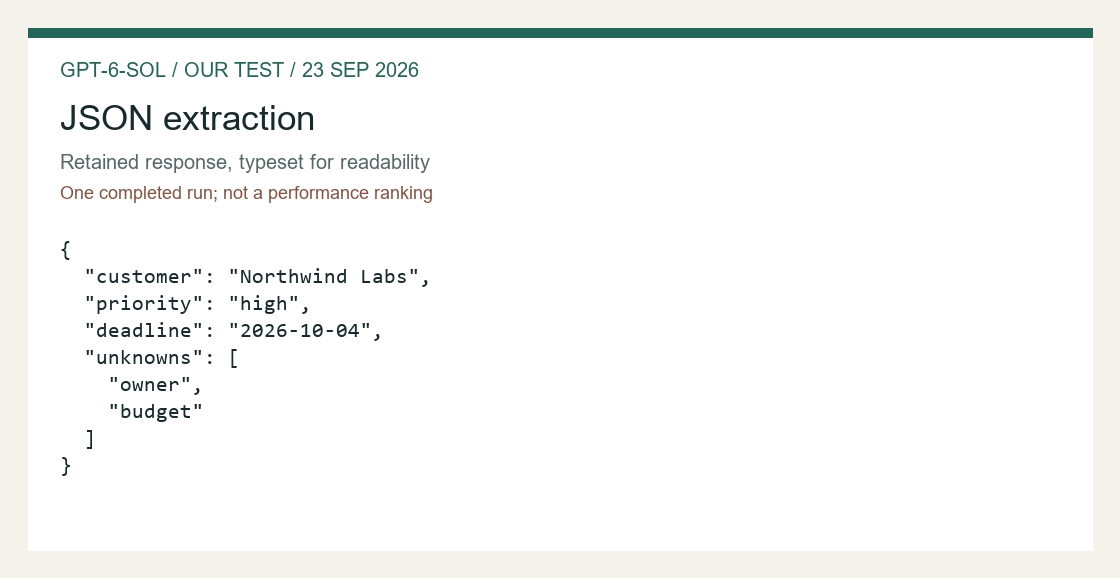
{"cliente":"Northwind Labs","prioridad":"alta","fecha límite":"04-10-2026","incógnitas":["responsable","presupuesto"]}Uso indicado para esta respuesta completada: 64 tokens de entrada, 64 tokens de finalización, 128 tokens en total. El uso de la finalización puede incluir tokens de razonamiento; no se trata simplemente de la longitud de la respuesta visible.
Sol devolvió exactamente los campos solicitados: cliente, prioridad, plazo y datos desconocidos. La lista de datos desconocidos conservó el campo «propietario» sin rellenar y el de «presupuesto» sin confirmar, en lugar de completarlos con suposiciones plausibles. Esto supone un éxito significativo para esta pequeña tarea: un sistema posterior puede distinguir entre un plazo conocido y la falta de información. Además, la salida no contenía ninguna barra de Markdown ni introducción explicativa, lo que permitía analizarla directamente como JSON.
El mismo JSON apareció en el resultado conservado por Luna. En este caso no se observa ninguna ventaja en cuanto a la calidad de la extracción que justifique pagar la tarifa más alta de Sol por esta entrada concreta. Podría merecer la pena evaluar Sol cuando la extracción dependa de la resolución de contradicciones entre varios documentos, pero esa es una tarea diferente. Nuestro punto de partida práctico sería una ruta de extracción validada más económica, con escalado en caso de pruebas contradictorias, en lugar de utilizar el modelo más caro para cada registro.
Una prueba de regresión ejecutable para el defecto detectado
Lo que sigue es un ejemplo de validación editorial, no una respuesta adicional del modelo. Se ejecuta localmente en Node.js y no realiza ninguna solicitud al modelo. Comprueba el fixture específico mencionado anteriormente; no se trata de una evaluación general del modelo.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('El parche se aplica correctamente; se reproduce el defecto original del valor cero.');
La afirmación negativa final confirma que la función original pierde el valor cero. Esto dota a la comprobación de un control sensible a los fallos: la prueba no se limita a aceptar la nueva implementación, sino que pone de manifiesto el síntoma que el cambio pretende corregir. El caso del array vacío es una comprobación editorial adicional, claramente separada de las dos aserciones proporcionadas por el modelo. Para el código de producción, coloca la prueba junto a la función real y ejecuta el comando de prueba del proyecto real; copiar una función a un archivo de prueba independiente no permite detectar errores de integración.
Cómo GPT-6 Sol transforma un flujo de trabajo real
Las especificaciones principales solo importan cuando cambian la forma de trabajar de un equipo. GPT-6 Sol está pensado para la programación compleja y los flujos de trabajo autónomos, por lo que la primera pregunta es si tu carga de trabajo se beneficia de ese enfoque. Si cada solicitud tiene una entrada breve, un contrato de salida limitado y una prueba de aceptación clara, el modelo puede integrarse en un proceso repetible. Si la tarea es ambigua, requiere muchas herramientas o es probable que necesite varias rondas de corrección, la coordinación del entorno es tan importante como el nombre del modelo.
En el caso de GPT-6 Sol, un patrón de producción útil es una ruta de dos pasadas: primero se solicita una respuesta concisa con incertidumbre explícita y, a continuación, se envía únicamente la parte controvertida o incompleta a una segunda pasada. Esto limita el desperdicio de tokens de salida y hace que los errores sean visibles. Además, te ofrece un mejor punto de comparación con GPT-6 Luna: la cuestión no es qué nombre suena mejor, sino qué ruta cumple los criterios de aceptación con menos reintentos.
Un modelo de costes sencillo antes de realizar el envío
La tabla oficial de precios debería traducirse a las unidades que tu equipo compra realmente: solicitudes al día, tokens de entrada medios, cuota de prefijos en caché, tokens de salida y el porcentaje de llamadas que superan los 272 000 de entrada. Una hoja de cálculo que solo refleje el precio de entrada principal oculta el multiplicador de contexto largo y el coste de los reintentos.
Este cálculo resulta especialmente relevante a la hora de comparar GPT-6 Sol con GPT-6 Luna. Una solicitud más económica puede acabar resultando cara si requiere varias rondas de corrección; por el contrario, una solicitud más potente puede suponer un derroche cuando la tarea consiste en una extracción determinista. La referencia adecuada es una pequeña muestra de tu propio tráfico con las mismas instrucciones, el mismo esquema y la misma regla de revisión.
Modos de fallo que hay que comprobar antes de la puesta en servicio
Una página de modelo puede indicarte qué puntos finales y modalidades están documentados, pero no puede garantizar que tu aplicación actual se comporte de la misma manera tras la migración. Comprueba si los eventos de streaming se analizan correctamente, si las llamadas a las herramientas conservan el estado entre los distintos intentos, si la salida estructurada rechaza los campos mal formados y si tu canal de registro registra el ID del modelo y la configuración de razonamiento para cada solicitud.
Esas mismas limitaciones hacen que las observaciones prácticas de esta revisión resulten útiles sin convertirlas en una tabla de clasificación. Nuestras tres tareas muestran cómo la ruta gestionó un pequeño defecto de código, un memorándum de decisión y una extracción estricta de JSON. No determinan la latencia, la fiabilidad a gran escala ni una clasificación universal de calidad.
Un marco de toma de decisiones para equipos reales
Una revisión del modelo resulta útil cuando ayuda a alguien a tomar una decisión en un contexto de restricciones. En el caso de GPT-6 Sol, las restricciones más relevantes son la estructura de la solicitud, el coste de la revisión, el tamaño del contexto, el formato de salida y las consecuencias de una respuesta errónea. La descripción del proveedor apunta hacia una codificación compleja y flujos de trabajo basados en agentes, pero el equipo aún debe traducir esa descripción en una ruta que pueda supervisar. Empieza por plasmar la tarea en una sola frase, la entrada que recibirá el modelo, la salida que espera otro sistema y el punto de control humano que evita un error silencioso.
El primer error es elegir un modelo a partir de una solicitud de demostración. Una demostración premia la fluidez y oculta detalles operativos como los reintentos, el recuento de tokens, los permisos de las herramientas y los errores de esquema. Una comparación más adecuada utiliza tres tareas representativas: una solicitud normal, una solicitud difícil y una solicitud que debería rechazarse o derivarse a un nivel superior. El resultado no es una puntuación única, sino un pequeño mapa que muestra en qué aspectos el modelo ahorra tiempo, en cuáles necesita supervisión y en cuáles otro modelo —a menudo GPT-6 Luna— resulta la opción más económica o segura.
Empieza por la prueba de aceptación
Escribe la prueba de aceptación antes de redactar la indicación. En el caso del código, la prueba puede consistir en una prueba unitaria que se supere o en un parche que no altere la API pública. Para la extracción, puede ser un JSON válido en el que figuren todas las claves necesarias y se conserven explícitamente los valores desconocidos. En el caso de un memorándum de decisión, puede ser una estructura fija que incluya pruebas, riesgos, responsable y siguiente paso. El modelo solo puede evaluarse en función de un objetivo visible. Sin ese objetivo, un párrafo bien redactado puede parecer correcto, aunque omita silenciosamente el único campo que necesita el proceso posterior.
Una buena prueba de aceptación debe ser lo suficientemente específica como para ejecutarse automáticamente y lo suficientemente significativa como para proteger al usuario. También debe permitir identificar claramente los desacuerdos. Si dos resultados difieren, el equipo debe poder señalar un dato que falte, una suposición sin fundamento, un campo mal formateado o un cálculo incorrecto. Esto resulta más útil que decir que una respuesta “parecía más acertada”. Es también la diferencia entre una revisión que ayuda al departamento de compras y una revisión que se limita a repetir el discurso del lanzamiento.
Utiliza el nombre del modelo para elegir una hipótesis inicial. Recurre a tu prueba de aceptación para decidir si la hipótesis resiste el paso a producción.
Diseño de la solicitud que se ajuste al perfil del modelo
No se debe copiar la misma indicación sin modificaciones en todos los modelos. El contrato de la tarea puede mantenerse estable, pero la cantidad de contexto, las instrucciones de razonamiento y las restricciones de salida deben ajustarse a la ruta. En el caso de GPT-6 Sol, las instrucciones del sistema deben ser lo suficientemente breves como para que no compitan con el material de origen. Indica la función, la regla de decisión, el formato requerido de la salida y las condiciones que requieren una incógnita explícita o una escalación.
En el caso de documentos largos, separa la extracción de la evaluación. Primero identifica los pasajes que responden a la pregunta; a continuación, extrae la conclusión utilizando únicamente esos pasajes y los criterios establecidos. Esto reduce la probabilidad de que se construya una frase con seguridad a partir de un detalle lejano e irrelevante. Además, hace que una ventana de contexto de 1,05 millones de tokens sea una herramienta en lugar de un valor por defecto. Un contexto amplio resulta valioso cuando la relación entre pruebas distantes entre sí es relevante. Sin embargo, supone un desperdicio cuando la tarea puede resolverse con un conjunto pequeño y bien seleccionado.
En los flujos de trabajo que utilizan herramientas, describe el límite entre el modelo y la herramienta. El modelo debe decidir si se necesita una herramienta, proporcionar argumentos siguiendo un esquema estricto y explicar qué hará con el valor devuelto. La aplicación debe aplicar los permisos, validar los argumentos, registrar la llamada y decidir si se puede volver a intentar una llamada a la herramienta que haya fallado. Considerar el modelo como la aplicación en su totalidad dificulta la depuración y aumenta el alcance de las consecuencias de una suposición errónea.
Una guía reutilizable de cuatro partes
Contexto: Aporta únicamente los datos y documentos necesarios para la tarea. Objetivo: Expresa la decisión o la transformación en una sola frase. Restricciones: especificar el formato, las exclusiones, el tratamiento de la incertidumbre y los límites de la herramienta. Comprueba: Pide al modelo que enumere los datos que faltan o las contradicciones antes de dar la respuesta definitiva. Esta estructura es lo suficientemente breve como para realizar llamadas repetidas y lo suficientemente explícita como para comparar distintos modelos.
Cuando resulta útil disponer de una ventana de contexto grande
El titular de «1,05 millones de tokens» es fácil de repetir y de utilizar incorrectamente. Una ventana de contexto te indica cuánto material cabe en una solicitud; no te indica cuánto material se debe enviar, en qué medida el modelo aprovechará cada pasaje ni cuánto costará la solicitud. Una solicitud extensa también puede ralentizar la revisión, ya que el equipo tiene más información que examinar y más margen para que surjan conflictos sutiles entre las instrucciones.
Utiliza la ventana completa cuando la tarea dependa realmente de referencias distantes: un contrato con definiciones separadas de las excepciones, un repositorio en el que las interfaces y las implementaciones estén muy alejadas entre sí, o un extenso archivo de investigación en el que la respuesta requiera seguir una secuencia. Utiliza la recuperación cuando la consulta sea local, cuando el conjunto de fuentes cambie con frecuencia o cuando desees un historial de citas compacto. Utiliza el almacenamiento en caché cuando se reutilice un prefijo estable en muchas solicitudes y la plataforma ofrezca suficientes detalles de uso para demostrar que la caché funciona.
El umbral de 272 000 debería figurar en el diagrama de arquitectura, no como una nota al pie en el apartado de precios. Una solicitud que resulta segura por debajo del umbral puede resultar considerablemente más cara por encima de él. Los equipos deberían registrar los tokens de entrada, los tokens almacenados en caché, los tokens de salida, el ID del modelo, la configuración del razonamiento y si la solicitud ha superado el umbral. Ese registro respalda un modelo de costes real y permite detectar un aumento accidental del contexto antes de que se convierta en una sorpresa mensual.
Preguntas sobre la migración de la API que merecen una prueba en un entorno de prueba
Antes de trasladar una integración existente a GPT-6 Sol, crea un entorno de prueba que reproduzca una pequeña muestra anonimizada. Compara el texto final, los campos estructurados, las llamadas a herramientas, los motivos de interrupción y el uso de tokens. No te limites a comparar solo la primera pantalla de la respuesta. Un modelo puede mantener la conclusión visible al tiempo que cambia el nombre de un campo, omite una condición de error o devuelve un argumento de herramienta que la aplicación no puede ejecutar de forma segura.
Las «respuestas» y las «conclusiones de chat» no son etiquetas intercambiables en un plan de integración. La compatibilidad con los puntos finales, la configuración del razonamiento, el comportamiento de la herramienta, los eventos de streaming y los objetos de error afectan al adaptador. Fija el ID del modelo en la configuración, pero manténlo visible en los registros y en los informes de pruebas. Cuando falla una solicitud, el registro debe mostrar el punto final, el modelo, el esfuerzo de razonamiento, la versión de la pregunta, el tamaño de la solicitud y la decisión de reintento. Esa información permite a un ingeniero reproducir el fallo en lugar de debatir si el modelo simplemente estaba teniendo un mal día.
El procesamiento por lotes modifica la economía y el ritmo operativo. Puede resultar adecuado para la clasificación nocturna, la preparación de documentos o una cola de transformaciones de baja urgencia. Sin embargo, no es la opción más adecuada para una acción interactiva que requiera una respuesta dirigida al usuario. Los modos «rápido» y «regional» también modifican el cálculo del precio. Trátalos como opciones de configuración explícitas y refléjalas en la hoja de cálculo del presupuesto, en lugar de ocultarlas en un valor predeterminado.
Reproduzca las entradas representativas, valide los resultados estructurados, recopile los argumentos de las herramientas, compare los motivos de interrupción, mida el uso de tokens y pruebe una ruta de fallo antes de modificar el valor por defecto en producción.
Calidad, seguridad y coste de la revisión
Un precio más bajo por token no implica automáticamente un menor coste total, y un modelo más caro no garantiza automáticamente un mejor resultado empresarial. El coste total incluye los reintentos, la revisión humana, la gestión de incidencias y el trabajo necesario para reparar los datos posteriores. La métrica útil es el coste por resultado aceptado, desglosado por familia de tareas. Una ruta que resulte ligeramente más cara por solicitud puede seguir siendo la mejor opción si reduce el trabajo de reparación en tareas de gran impacto; una ruta muy económica puede resultar claramente la mejor opción para la extracción determinista con una validación rigurosa.
El riesgo debe clasificarse en función de la acción, no de la marca del modelo. Leer un documento público y redactar un resumen es diferente a modificar el expediente de un cliente, autorizar un pago, borrar datos o publicar un comunicado legal. Las acciones irreversibles deben someterse a un control humano o a un segundo paso de validación independiente. Pide al modelo que identifique la incertidumbre, pero nunca consideres una frase que suene a certeza como un sistema de autorización.
Las cuestiones relativas a la privacidad y la conservación de datos deben tratarse en la revisión de la implementación. Confirma qué datos se envían, cuánto tiempo se conservan los registros, quién puede inspeccionar las solicitudes y si la solicitud contiene información confidencial o datos personales. Oculte la información siempre que sea posible, reduzca al mínimo el contexto y mantenga un registro claro de los campos que se han eliminado. Estas medidas de control se aplican tanto si el modelo se utiliza a través de una API oficial como si se utiliza por otra vía compatible.
Cómo comparar GPT-6 Sol con GPT-6 Luna
Una comparación justa mantiene constantes la tarea y la regla de aceptación, al tiempo que permite que cada modelo aproveche sus puntos fuertes documentados. Ejecuta el mismo paquete de entrada, pero anota si un modelo necesita una configuración de razonamiento diferente o un punto final distinto. Expone las diferencias con claridad: uno puede generar un parche más completo, otro puede resultar más económico para la extracción repetida y un tercero puede ser más fácil de integrar porque su contrato de herramientas se ajusta a tu adaptador actual.
No conviertas una tarea realizada con éxito en una clasificación general. Tres tareas pequeñas sirven para detectar problemas en el flujo de trabajo, no para demostrar que hay un ganador universal. Repite la tarea con varios datos de entrada realistas, incluye al menos un caso adverso o incompleto, y decide de antemano qué se considera un resultado satisfactorio. Si la muestra es demasiado pequeña para respaldar una conclusión, dilo claramente. Ese límite refuerza la confianza en lugar de debilitar la revisión.
Una implantación por fases que permite revertir la decisión
Empieza con tráfico simulado o una cola no crítica. Deja que la nueva ruta genere una respuesta mientras la ruta existente sigue siendo la fuente de referencia. Compara la tasa de aceptación, el coste de los tokens, el tiempo de revisión y las categorías de fallos durante un periodo determinado. A continuación, traslada una familia de tareas cada vez, manteniendo un interruptor de reversión y una etiqueta de versión rápida. Una implantación por etapas convierte la elección de un modelo en un cambio de ingeniería observable, en lugar de una sustitución de un solo día.
Durante la implementación, presta atención a los cambios que no se reflejan en una simple tasa de éxito: resultados más extensos, más llamadas a herramientas, más escalaciones o más solicitudes que superan el umbral de contexto largo. Un modelo puede parecer preciso, pero consumir más presupuesto o aumentar la carga de trabajo de los operadores. Añade alertas para esas dimensiones y revísalas con las personas que se encargan realmente de gestionar las excepciones.
Cómo se define el éxito
El éxito es una ruta estable con un coste conocido, un modo de fallo visible y un proceso de revisión que la gente puede seguir. No requiere fingir que el modelo es perfecto. Requiere saber qué tareas gestiona bien, qué tareas necesitan otra vía y cómo detenerlo o corregirlo cuando los datos de entrada están incompletos. Ese es el criterio práctico que subyace a las observaciones y la documentación recopiladas en esta revisión.
Lo que las reacciones del público pueden y no pueden decirte
Las siguientes fuentes se incluyen como reacción del público, con la debida atribución, y no como documentación oficial ni como pruebas de referencia contrastadas. Sus títulos reflejan lo que cada autor decidió analizar o explicar; no constituyen un resultado representativo de todo el mercado.
- Nate Herk | Automatización mediante IA: He comparado Opus 5.5 y GPT-6 Sol en 10 casos de uso reales. Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
- Arena AI: GPT-6 Sol | Primeras impresiones. Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
- Chase AI: Ya están aquí GPT 6 Sol y Luna (¡y el 50% es más barato!). Considera el enfoque y cualquier demostración como la experiencia de ese creador, no como una regla universal.
Aquí hay otra cuestión relacionada con la denominación que es importante: varios vídeos públicos utilizan “GPT-6” y “GPT-5.6” indistintamente en los títulos. Indica siempre el identificador exacto del modelo cuando reproduzcas una afirmación. El Comparación entre el GPT-6 Astra y el GPT-5.6 Sol Es un ejemplo útil de por qué la identidad del proveedor, la etiqueta de la plataforma y la ruta deben registrarse por separado.
Cómo acceder a GPT-6 Sol
Abra el Espacio de trabajo de GPT-6 Sol Empieza con una tarea que puedas evaluar: un pequeño ejemplo de código, un paquete de código fuente breve o un resumen de extracción estructurado. Mantén a la vista el resultado solicitado y las reglas de aceptación mientras comparas las revisiones. Los precios oficiales de los tokens que figuran más arriba se refieren al uso directo de la API, no constituyen una promesa sobre créditos del espacio de trabajo ni asignaciones de suscripción.
Para conocer la nomenclatura actual de las plataformas y el contexto de los créditos independientes, consulta el Guía de precios de GPT-5.6 y el Comparación de modelos GPT-5.6. Esas páginas corresponden al contexto de la plataforma o editorial; no prevalecen sobre la tabla de precios de la API de OpenAI.
Trae una tarea representativa y compara el resultado con tus propios criterios de aceptación.
Abrir el espacio de trabajo de GPT-6 Sol¿Quién debería optar por GPT-6 Sol?
Si en tu lista de opciones hay alternativas más económicas, compara las un catálogo de modelos más amplio en lugar de dar por sentado que el modelo más reciente es automáticamente el que ofrece la mejor relación calidad-precio. Si estás evaluando tareas que requieren un gran volumen de datos, el Guía sobre modelos de análisis de datos ofrece una perspectiva independiente sobre los flujos de trabajo.
Preguntas frecuentes
¿Qué es GPT-6 Sol?
GPT-6 Sol es el modelo de OpenAI para flujos de trabajo complejos de codificación y agenciales. Su identificador oficial de modelo de API es gpt-6-sol.
¿Cuánto cuesta GPT-6 Sol?
OpenAI establece el precio de GPT-6 Sol en $2,00 por cada millón de tokens de entrada, $0,20 por cada millón de tokens de entrada almacenados en caché, $2,50 por cada millón de escrituras en caché y $10,00 por cada millón de tokens de salida, según las tarifas estándar.
¿Qué ocurre cuando se superan los 272 000 tokens de entrada?
Cuando una solicitud supera los 272K tokens de entrada, OpenAI aplica el doble de las tasas de entrada y de caché, y 1,5 veces las tasas de salida, a toda la solicitud.
¿Cuáles son los límites de contexto y de salida?
GPT-6 Sol presenta una ventana de contexto de 1 050 000 tokens, una entrada máxima de 922 000 tokens y una salida máxima de 128 000 tokens.
¿Cuál es el nivel mínimo de conocimientos exigido?
La página actual del modelo OpenAI indica el 20 de abril de 2026 como fecha límite de actualización de conocimientos para GPT-6 Sol.
¿Qué opciones de razonamiento hay disponibles?
La API documenta los niveles de esfuerzo de razonamiento «none», «low», «medium», «high», «xhigh» y «max», siendo «medium» el valor predeterminado.
¿Qué puntos finales de la API son compatibles?
GPT-6 Sol es compatible con las funciones «Chat Completions», «Responses» y «Batch». En la página del modelo no se indican como compatibles las funciones «Realtime», «Assistants», audio, vídeo, generación de imágenes, incrustaciones, ajuste fino, moderación ni las funciones «Completions» heredadas.
¿GPT-6 Sol admite imágenes?
Sí. En la página del modelo se indican entradas de texto e imágenes, con salida de texto. Eso no lo convierte en un modelo de generación de imágenes.
¿Está disponible GPT-6 Sol en GlobalGPT?
Utiliza la página específica del modelo GPT-6 Sol cuyo enlace aparece más arriba. Los créditos del espacio de trabajo y las asignaciones de los planes son independientes de las tarifas directas de los tokens de API descritas en esta reseña.
¿Incluye este artículo alguna referencia comparativa?
Incluye tres pequeñas observaciones de tareas, no una prueba comparativa controlada. Luna necesitó una indicación de programación revisada al volver a intentarlo. Estos resultados no determinan un ganador universal ni el rendimiento a gran escala.
Veredicto final
Sol es el modelo que hay que tener en cuenta cuando el trabajo es realmente complejo, requiere un uso intensivo de herramientas o se centra en el código, y se puede aceptar un mayor número de tokens. Los datos que aquí se presentan combinan la documentación oficial con nuestra pequeña muestra de tareas, y no constituyen una prueba de rendimiento controlada, por lo que el veredicto responsable es que resulta adecuado, no una clasificación universal. Elige en función de los resultados aceptados y del coste operativo total, y luego revisa tu elección cuando cambie tu carga de trabajo.
Consultado el 23 de septiembre de 2026. Datos oficiales: OpenAI Developers. Denominación de la ruta de la plataforma: GlobalGPT. Reacción del público: creadores y publicaciones enlazados, solo con atribución.









