
La versión Grok 4.7 supone una importante mejora en materia de programación y trabajo intelectual, pero aún es pronto para sacar conclusiones: tanto las afirmaciones oficiales del lanzamiento como las pruebas de rendimiento independientes apuntan a una mejora, pero no a un éxito rotundo.
Respuesta rápida
Grok 4.7 es la actualización de xAI del 21 de septiembre de 2026, destinada a la programación y a tareas complejas de trabajo intelectual. xAI afirma que dedica más tiempo a los problemas complejos, revisa su trabajo con mayor detenimiento e incorpora un nuevo conjunto de medidas de seguridad, al tiempo que mantiene el mismo precio y la misma velocidad que la versión Grok 4.6. La página de lanzamiento también la presenta como el doble de rápida y a la mitad de precio que los modelos comparables, una comparación entre proveedores que debe interpretarse teniendo en cuenta la tarea y la ruta subyacentes. Los datos independientes de Artificial Analysis le otorgan una ligera mejora general con respecto a Grok 4.6 y registran una ventana de contexto de 500 000. En nuestra prueba de API de tres tareas, el Grok 4.7 destacó en la depuración y en la disciplina de los límites de código fuente; su plan de proyecto conservó bien la incertidumbre, pero resultó menos aplicable de lo solicitado. Se trata de una evidencia práctica útil, no de una prueba de que supere a todos los modelos de la competencia.
¿Qué es Grok 4.7?
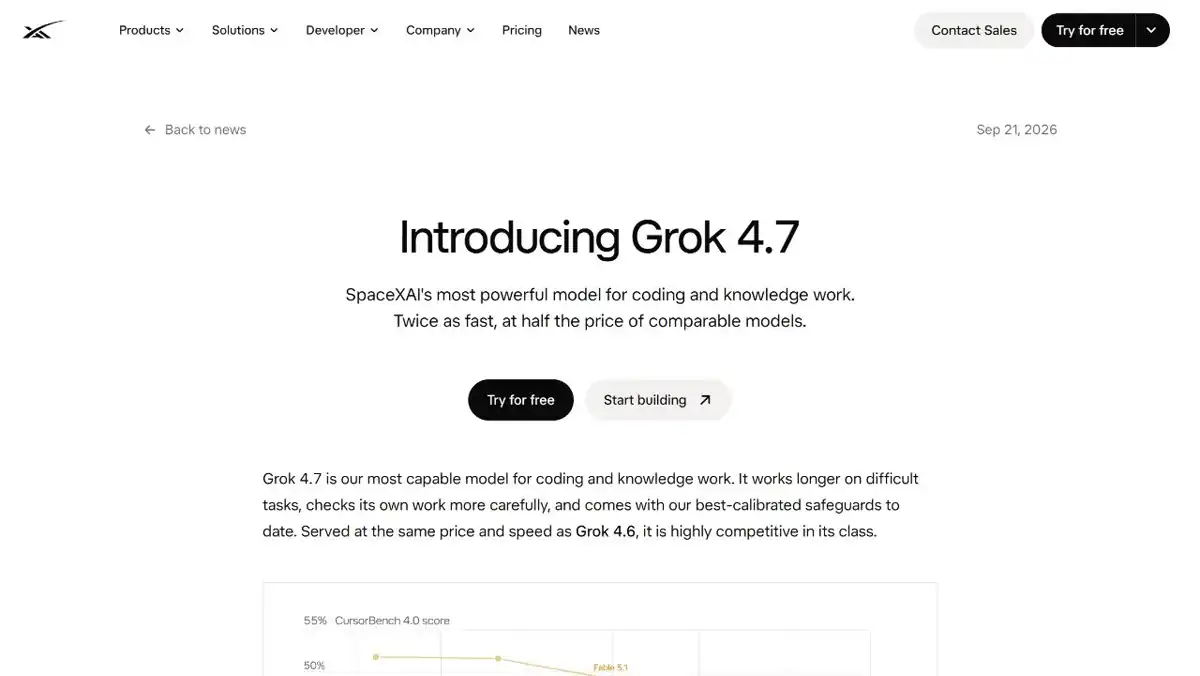
El Grok 4.7 es el último modelo de la gama Grok de xAI, presentado el 21 de septiembre de 2026. El Anuncio oficial de xAI lo posiciona como el modelo más capaz de la empresa para la programación y el trabajo intelectual. El cambio significativo no radica en una nueva lista de funciones dirigidas al consumidor, sino en cómo se espera que el modelo distribuya sus esfuerzos: más tiempo dedicado a tareas complejas, más autocorrección y una capa de seguridad destinada a hacer que esa capacidad adicional sea más controlable.
Ese posicionamiento es importante porque describe un modelo de flujo de trabajo más que la personalidad de un chatbot. El modelo Grok 4.7 se comercializa como un modelo para tareas que se benefician de un análisis continuado: depuración, planificación, redacción técnica, síntesis de investigaciones y solicitudes largas que requieren que el modelo tenga en cuenta varias restricciones.
El límite es igualmente importante. El anuncio de xAI es una declaración del proveedor sobre el comportamiento previsto. No es una prueba independiente de que Grok 4.7 supere a todos los modelos de la competencia, a todas las indicaciones o a todos los repositorios de código. Considera la página de lanzamiento como la fuente de lo que afirma xAI y, a continuación, utiliza mediciones independientes y tu propia tarea para decidir si esas afirmaciones son relevantes.
Grok 4.7 frente a Grok 4.6: ¿qué ha cambiado realmente?
La conclusión más razonable es que se trata de una mejora en cuanto al esfuerzo y la fiabilidad, y no de un producto completamente diferente.
| Área | Grok 4,7 | Lo que respaldan los datos |
|---|---|---|
| Lanzamiento | 21 de septiembre de 2026 | Fecha indicada en la página oficial de lanzamiento de xAI |
| Posicionamiento principal | Programación y trabajo intelectual | Posicionamiento oficial de xAI |
| Tareas difíciles | Un esfuerzo más prolongado y una autocorrección más minuciosa | Descripción oficial de xAI; nuestra prueba con la API en tres tareas ofrece una pequeña comprobación práctica, no una comparación exhaustiva. |
| Seguridad | Nueva pila de medidas de seguridad | Descripción oficial de xAI |
| Precio y velocidad | Igual que Grok 4.6, según xAI | Una reclamación por lanzamiento, no una auditoría de precios realizada por terceros |
| Contexto | 500 000 tokens en el perfil «Análisis artificial» | Perfil de modelo independiente; comprueba la ruta que utilizas |
| Controles de razonamiento | De ’Low» a «xhigh» en la lista de Artificial Analysis | Metadatos independientes de rutas y modelos |
Esta distinción resulta útil para los compradores. Si la versión Grok 4.6 ya se adapta a tu flujo de trabajo, la 4.7 es una actualización sencilla que merece la pena valorar. Si la 4.6 no se adaptaba debido a limitaciones relacionadas con el ecosistema, la latencia, la fiabilidad o el acceso, una puntuación más alta en las pruebas de rendimiento por sí sola no resuelve esos problemas.
Para disponer de un marco más amplio en la adquisición de modelos, el Guía de precios de GPT-5.6 y Comparación entre 1TP y 21T Son recordatorios útiles para diferenciar la calidad del modelo de los aspectos económicos del proyecto y la adecuación al flujo de trabajo.
Capacidades: en qué aspectos debería ser útil el modelo Grok 4.7
Codificación y depuración
El principal argumento de venta de xAI es la programación. La promesa no es simplemente que Grok 4.7 escriba más código, sino que es capaz de dedicarse durante más tiempo a un problema de ingeniería complejo, analizar su propia respuesta y ofrecer un parche o una explicación más meditada. Ese es el comportamiento que hay que buscar en un repositorio real: ¿conserva el diseño existente, identifica la causa raíz, añade pruebas útiles y señala lo que aún no puede saber?
No evalúes el modelo con una indicación del tipo “crea una aplicación de tareas” partiendo de cero. Proporciónale un error delimitado con una prueba fallida, un pequeño conjunto de archivos y restricciones explícitas. Pide un diagnóstico antes de un parche. Así resulta más fácil comprobar si el razonamiento más extenso supone menos trabajo de revisión o si simplemente se trata de un texto más largo.
La misma norma se aplica a los equipos que comparan diferentes vías de codificación. A Reseña del DeepSeek V4 Pro y el Revisión del plan de codificación de GLM ofrecen un contexto útil para la comparación, pero ninguna de ellas debe considerarse un sustituto de las pruebas que realices con el repositorio y el conjunto de herramientas que utilices realmente.
Trabajo intelectual con un contexto amplio
Artificial Analysis indica una ventana de contexto de 500 000 tokens para Grok 4.7. Es lo suficientemente amplia como para cambiar tu forma de abordar los trabajos con gran volumen de material de origen: una especificación técnica extensa, un conjunto de notas de reuniones, una parte del código fuente o un paquete de investigación pueden mantenerse en una sola conversación, en lugar de tener que resumirlos repetidamente.
La capacidad contextual no es lo mismo que la calidad contextual. Un modelo puede aceptar una entrada extensa y, aun así, pasar por alto una restricción situada cerca de la mitad, dar demasiada importancia al último párrafo o generar un resumen que parezca fiable, pero que requiera comprobar la fuente. La prueba práctica consiste en la recuperación de información bajo presión: coloca algunos datos decisivos en diferentes partes de un documento extenso, solicita una decisión sujeta a restricciones y comprueba si la respuesta cita los pasajes correctos.
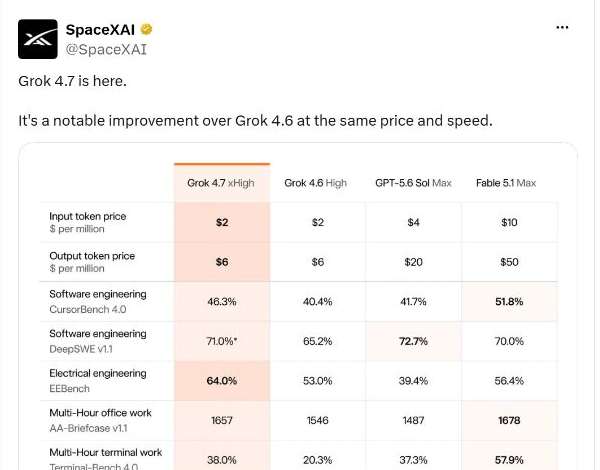
La cuenta oficial de SpaceXAI en X repitió el 22 de septiembre el argumento sobre el lanzamiento, calificando el Grok 4.7 como una mejora notable con respecto al Grok 4.6, con el mismo precio y la misma velocidad, y compartiendo el gráfico comparativo de los modelos. Esa publicación es una prueba útil del posicionamiento público de la empresa, pero no constituye una validación independiente ni un consenso de la comunidad.
Si se utiliza el modelo con fines de investigación, mantén visible el ciclo de evidencia. Nuestro Comparación entre Gemini y Perplexity y Guía de alternativas a Perplexity apuntan lo mismo en la práctica: una respuesta bien redactada no equivale a una auditoría de fuentes.
Autocomprobación y seguridad
xAI afirma que Grok 4.7 revisa su trabajo con mayor detenimiento e introduce una nueva pila de medidas de seguridad. Se trata de objetivos valiosos, sobre todo cuando se le pide al modelo que tome una larga cadena de decisiones. Sin embargo, no garantizan que el resultado sea correcto ni seguro para su ejecución automática.
Para su uso en producción, mantén los controles habituales en torno al modelo: pruebas, permisos, revisión humana, comprobaciones de citas y una condición de parada clara. La autocomprobación del modelo es otra señal que hay que tener en cuenta, pero no sustituye a los controles que lo rodean.
Pruebas de rendimiento del Grok 4.7: lo que demuestran las cifras
Un resultado de codificación muy bueno: según la tabla oficial, el Grok 4.7 se sitúa por delante del Grok 4.6.
La comparación con el modelo de mayor tamaño muestra una mejora significativa en esta prueba de rendimiento para trabajos basados en el conocimiento.
Una indicación útil para los procesos de trabajo en los que se utilizan herramientas, pero sigue siendo una evaluación concreta y no una puntuación universal.
El índice independiente apunta en la misma dirección: una mejora, no una prueba de una victoria generalizada.
Considera estas tarjetas como una orientación. La composición del conjunto de datos, el acceso a las herramientas, el muestreo y la configuración del modelo pueden influir en la clasificación.
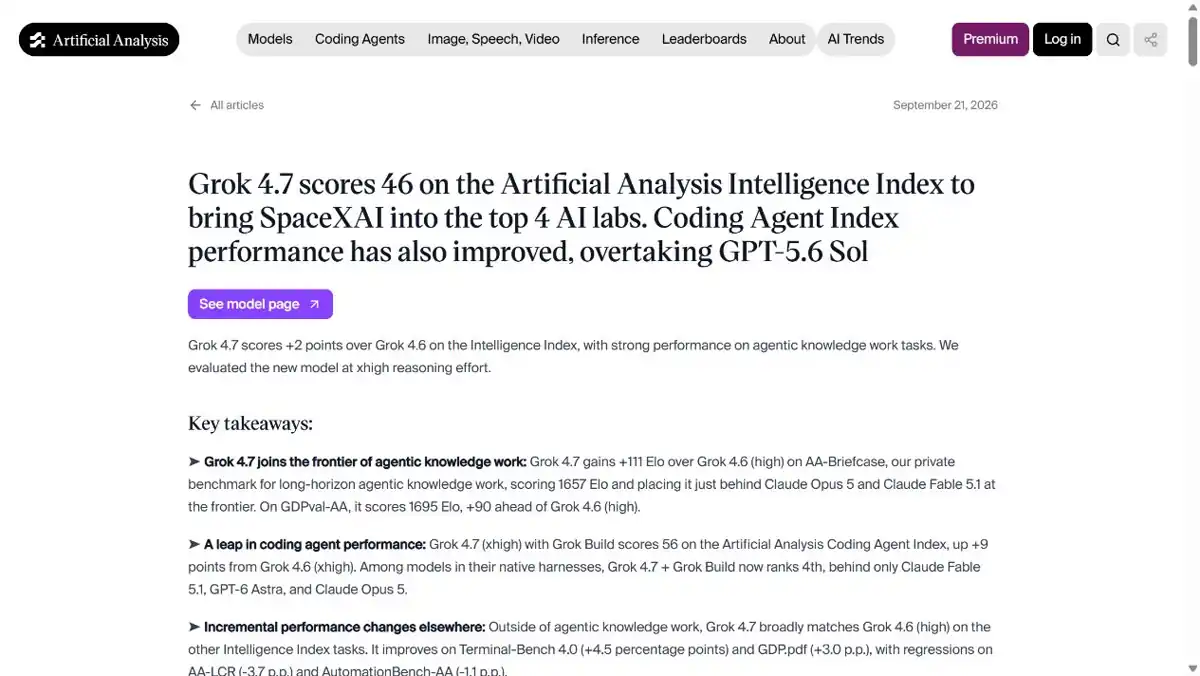
La visión general independiente más útil en estos momentos procede de Artículo comparativo de ’Artificial Analysis» sobre el Grok 4.7, con fecha del 21 de septiembre de 2026.
| Medida | Resultado comunicado | Cómo leerlo |
|---|---|---|
| Índice de Análisis de Inteligencia Artificial | 46 | Dos puntos por encima del Grok 4,6 en el mismo índice |
| AA-Maletín | 1.657 Elo | 111 de Elo por encima de Grok 4,6 en esa evaluación |
| Ventana de contexto | 500 000 tokens | Un campo de perfiles de modelos, no una prueba de la recuperación perfecta de contextos largos |
| Esfuerzo de razonamiento | De bajo a xalto | Un control a nivel de ruta incluido en la lista de Artificial Analysis |
La tendencia es alentadora: el índice independiente muestra una mejora con respecto a la versión anterior, y la mayor diferencia de Elo en AA-Briefcase sugiere un avance más notable en esa evaluación concreta. Sin embargo, la tabla sigue reflejando dos conjuntos de datos, no una clasificación universal. La composición de los puntos de referencia, el acceso a las herramientas, el muestreo y la configuración de los modelos pueden alterar el resultado.
La página oficial de lanzamiento de xAI muestra Grok 4.7 en 46,31 TP40T en CursorBench 4.0 en su tabla comparativa, junto a Grok 4,6 a 40,4%, GPT-5.6 Sol a 41,7% y Fable 5.1 a 51,8%. La página también muestra 71,01 TP40T en DeepSWE v1.1 con un nivel de esfuerzo alto, 64,01 TP40T en EEBench y 1.657 en AA-Briefcase v1.1. Se trata de cifras comparativas presentadas por el proveedor, por lo que deben considerarse como resultados oficiales comunicados y no como un sustituto de una replicación independiente. La conclusión más prudente es que xAI se centra en tareas serias de programación y de trabajo intelectual profesional, mientras que las mediciones independientes muestran una mejora significativa en algunas tareas y resultados más moderados en otras.
Prueba práctica del Grok 4.7: tres tareas prácticas
Probamos tres indicaciones fijas con el grok-4.7 ID del modelo a través de una API de prueba compatible con OpenAI el 23 de septiembre de 2026. Se trató de una evaluación de ruta única, no de la API directa de xAI ni de una prueba comparativa con la competencia. A continuación se conservan las respuestas visibles de cada ejecución; se han excluido los rastros de razonamiento privados.
| Tarea | Tiempo observado | Resultado |
|---|---|---|
| Error de concurrencia en TypeScript | 333,7 segundos, retransmitido en streaming | Aprobado con nota alta: diagnóstico correcto de «shared-promise», parche mínimo, dos pruebas útiles y una limitación cuidadosa de lo que el fragmento de código podía demostrar |
| Notas de investigación contradictorias | 68,7 segundos | Aprobación con reservas: se mantuvo la atribución, se calcularon ambos escenarios de asignación y se denegó la aprobación hasta que se verificara el conflicto de fuentes. |
| Un plan desordenado de una semana | 50,6 segundos | Aprobado parcialmente: se han respetado los plazos, hay contradicciones, se desconocen los propietarios y se han identificado cinco riesgos, pero no se ha convertido el trabajo en un calendario diario claro. |
Las cifras de latencia se refieren únicamente a esta ruta y a estas solicitudes. La tarea de codificación sufrió primero un tiempo de espera agotado en una pasarela sin streaming y, a continuación, se completó con el streaming activado. Se trata de una advertencia práctica sobre la implementación en lo que respecta al transporte y la gestión de los tiempos de espera, no de una puntuación general de velocidad de 4,7 para Grok.
Prueba 1: Depuración de la concurrencia en TypeScript
Tarea 1 — Depuración de la concurrencia en un controlador de la API de TypeScript

Un pequeño controlador de TypeScript devuelve de forma intermitente un código de estado HTTP 200 con un cuerpo vacío cuando llegan dos solicitudes muy seguidas.

Archivos proporcionados:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

El síntoma en producción es intermitente y solo se produce cuando se solapan dos solicitudes. El cargador en sí mismo se puede invocar de forma concurrente sin problemas y devuelve una carga útil diferente para cada solicitud. No hay otros archivos disponibles.

Incluye exactamente estas secciones:
1. Causa raíz
2. Parche mínimo seguro (muestra una comparación unificada)
3. Dos pruebas de regresión (código en TypeScript o al estilo de Jest)
4. Supuestos y limitaciones
No afirmes haber ejecutado el código.1. Causa principal
`current` es un estado a nivel de módulo compartido por todas las llamadas. En un ciclo de JavaScript, la comprobación de `null` y la asignación son atómicas, por lo que dos llamadas que se solapan no ejecutan ambas `load()`. La primera llamada almacena su promesa; una segunda llamada que llega antes de que esa promesa se resuelva omite su propio `load()` y espera a la misma promesa. A continuación, `handler` devuelve un código de estado HTTP 200 cuyo `body` es la cadena de la primera llamada, no la carga útil de la segunda solicitud. Esa ventana solo existe mientras una llamada está en curso, por lo que el error solo se manifiesta cuando las solicitudes se solapan.
`current = null` se ejecuta en cada continuación después de que `await` ya haya capturado la promesa. No hace que el otro esperante vuelva a leer la variable, por lo que estos archivos por sí solos no resuelven ese esperante como `null` o `""`. Lo que sí producen al solaparse es una resolución compartida y una carga por solicitud omitida. Además, esto convierte la ranura en una mala caché de un solo vuelo: la primera continuación que se reanuda descarta `current`, y una llamada posterior puede iniciar un `load()` diferente mientras otra llamada aún se está desenrollando.
2. Parche seguro más pequeño (mostrar una diferencia unificada)
Cada solicitud debe llamar a `load()` por sí misma. Se permiten llamadas concurrentes a `load()`, y cada una devuelve una carga útil diferente, por lo que la deduplicación en una promesa compartida no es segura. `handler.ts` no necesita ningún cambio.
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. Dos pruebas de regresión (código en TypeScript o al estilo de Jest)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('las solicitudes superpuestas se ejecutan simultáneamente y conservan su propio cuerpo', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('una carga superpuesta rechazada no modifica la otra respuesta', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('error en el proceso anterior'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('error en el proceso anterior');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. Supuestos y limitaciones
No he ejecutado este código ni las pruebas. Las pruebas asumen un ejecutor al estilo de Jest y un archivo situado en un directorio a nivel de `src/` (por ejemplo, `test/cache.test.ts`).
He considerado que “cada solicitud tiene una carga útil diferente” como un requisito por el que las llamadas superpuestas a `getPayload` no deben compartir un mismo resultado de `load()`. Una reescritura correcta de un solo paso (`load().finally(() => { current = null; }); return current`) seguiría acoplando esas solicitudes, por lo que no la utilicé. No hay ninguna clave de caché y no se especifica ningún requisito de deduplicación.
Las instrucciones mostradas no escriben un cuerpo HTTP literalmente vacío si `load` devuelve una cadena no vacía. Si ese síntoma proviene de un adaptador ajeno a estos archivos, aquí no es visible. El parche solo elimina el acoplamiento por solapamiento que estos archivos implementan realmente. No añade bloqueo, reintentos ni una caché con clave.Grok 4.7 determinó correctamente que el nivel de módulo actual La promesa hace que las solicitudes superpuestas compartan un mismo resultado del cargador, aunque cada solicitud necesite su propia carga útil. Se propuso el cambio mínimo que garantizara la seguridad: eliminar la promesa compartida y llamar a load() según lo solicitado. Las dos pruebas de regresión abarcaban cargas útiles concurrentes distintas y el aislamiento en caso de que un cargador rechazara la solicitud. Lo más destacado de la respuesta fue su moderación: afirmaba explícitamente que el código mostrado demuestra el acoplamiento entre solicitudes, pero que, por sí solo, no explica un cuerpo literalmente vacío si el cargador siempre devuelve una cadena no vacía.
Veredicto: Se ha superado con creces la prueba en cuanto a precisión en la identificación de la causa raíz, alcance de los parches, cobertura de las pruebas de regresión y gestión de la incertidumbre.
Prueba 2: Nota de investigación sobre fuentes contradictorias
Tarea 2 — Conciliar las notas de investigación contradictorias en un memorándum de decisión.

Utiliza únicamente estas seis notas e indica el nombre de la fuente junto a cada afirmación objetiva:

- Proveedor A, página de precios, 20 de septiembre de 2026: El plan «Team» cuesta $40 al mes por usuario e incluye 100 000 acciones.
- Proveedor B, publicación comparativa, 21 de septiembre de 2026: El plan «Team» del proveedor A incluye 120 000 acciones al mes por usuario.
- Entrevista con un cliente, 18/09/2026: Nuestro equipo cuenta con 8 puestos y el mes pasado realizó 710 000 acciones.
- Hoja de cálculo de finanzas, 19/09/2026: El límite presupuestario actual es de $360 al mes.
- Proveedor A, página de límites, 20 de septiembre de 2026: El exceso se factura a $0,004 por acción una vez superada la asignación incluida.
- Nota de compras, 22/09/2026: Solo se aceptará un cambio si el total mensual se mantiene dentro del presupuesto y se verifica la asignación.

Devuelve exactamente estas secciones:
1. Hechos verificados
2. Afirmaciones atribuidas
3. Tabla de conflictos
4. Cálculos independientes (calcula los escenarios de 8 x 100 000 y 8 x 120 000, más cualquier exceso)
5. Recomendación
6. Una sola pregunta aclaratoria si el conflicto modifica la recomendación
No resuelvas el conflicto entre 100 000 y 120 000 sin explicarlo.
1. Datos contrastados
- El plan Team cuesta $40 por puesto al mes (Proveedor A, página de precios, 20 de septiembre de 2026).
- El equipo cuenta con 8 puestos y realizó 710 000 acciones el mes pasado (entrevista con el cliente, 18 de septiembre de 2026).
- El límite presupuestario actual es de $360 al mes (hoja de cálculo de Finanzas, 19 de septiembre de 2026).
- El exceso se factura a $0,004 por acción una vez superada la asignación incluida (Proveedor A, página de límites, 20 de septiembre de 2026).
- Solo se aceptará un cambio si el total mensual se mantiene dentro del presupuesto y se verifica la asignación (nota de compras, 22 de septiembre de 2026).

2. Reclamaciones atribuidas
- El equipo incluye 100 000 acciones incluidas (Proveedor A, página de precios, 20 de septiembre de 2026). Esa nota no especifica explícitamente “por puesto”.
- El equipo del proveedor A incluye 120 000 acciones por puesto al mes (Proveedor B, publicación comparativa, 21 de septiembre de 2026).

3. Tabla de conflictos
| Elemento | Afirmación | Fuente | Estado |
| --- | --- | --- | --- |
| Acciones incluidas | 100 000 acciones incluidas; no se especifica “por puesto” | Proveedor A, página de precios, 20 de septiembre de 2026 | Sin resolver |
| Acciones incluidas | 120 000 acciones por puesto al mes | Proveedor B, publicación comparativa, 21/09/2026 | Sin resolver |

El conflicto entre 100 000 y 120 000 no está resuelto. Estas notas no indican cuál de las cifras es la correcta.

4. Cálculos independientes
Coste base por puesto, igual en ambos escenarios: 8 puestos (entrevista al cliente, 18/09/2026) × $40 por puesto al mes (Proveedor A, página de precios, 20 de septiembre de 2026) = $320 al mes.

Los dos multiplicadores que figuran a continuación se han calculado tal y como se solicitó. No constituyen una conclusión de que el Proveedor A haya establecido una asignación por puesto.

- 8 × 100.000 = 800.000 acciones incluidas, utilizando la cifra de 100.000 (Proveedor A, página de precios, 20 de septiembre de 2026).
- El uso de 710 000 (entrevista con el cliente, 18/09/2026) es 90 000 inferior a 800 000, por lo que las acciones excedentes = 0.
- Cargo por exceso = 0 × $0,004 = $0 (Proveedor A, página de límites, 20 de septiembre de 2026).
- Total mensual = $320 + $0 = $320, lo que se encuentra dentro del límite máximo de $360 (hoja de cálculo de Finanzas, 19 de septiembre de 2026).

- 8 × 120 000 = 960 000 acciones incluidas, utilizando la cifra de 120 000 (Proveedor B, publicación comparativa, 21 de septiembre de 2026).
- El uso de 710 000 (entrevista con el cliente, 18/09/2026) es 250 000 inferior a 960 000, por lo que las acciones por exceso = 0.
- Cargo por exceso = 0 × $0,004 = $0 (Proveedor A, página de límites, 20 de septiembre de 2026).
- Total mensual = $320 + $0 = $320, lo que se encuentra dentro del límite máximo de $360 (hoja de cálculo de Finanzas, 19/09/2026).

5. Recomendación
No apruebe el cambio todavía. Según ambos límites calculados, las 710 000 acciones del mes pasado (entrevista con el cliente, 18 de septiembre de 2026) no generan ningún exceso y dan lugar a un total mensual de $320, que se encuentra dentro del límite máximo de $360 (hoja de cálculo de Finanzas, 19 de septiembre de 2026). Ese resultado en cuanto al coste no depende de si se eligen 100 000 o 120 000. El cambio sigue sin cumplir la segunda condición: el límite debe verificarse (nota de compras, 22 de septiembre de 2026), y estas notas indican 100 000 (Proveedor A, página de precios, 20-09-2026) en conflicto con 120 000 (Proveedor B, publicación comparativa, 21-09-2026).

6. Una sola pregunta aclaratoria si el conflicto modifica la recomendación
No hay ninguna pregunta aclaratoria. El conflicto entre 100 000 y 120 000 no modifica la recomendación.
El dossier de investigación presentaba deliberadamente contradicciones sobre si el límite era de 100.000 o 120.000 acciones por asiento. El documento Grok 4.7 mantuvo separadas las dos fuentes, observó que la primera fuente no indicaba explícitamente “por puesto”, calculó ambos escenarios de ocho puestos y demostró que ambos se mantenían en $320 sin exceder el uso previsto. Aun así, recomendó retener la aprobación porque el departamento de compras exigía que se verificara la asignación. Esa es la distinción correcta entre una recomendación numéricamente estable y un hecho contractual sin resolver.
Veredicto: Nota alta en atribución, aritmética, gestión de conflictos y disciplina en la toma de decisiones.
Prueba 3: De notas desordenadas al plan de ejecución
Tarea 3 — Convierte estas notas desordenadas del proyecto en un plan de ejecución de una semana con menos de 700 palabras.

Notas:
- Lanzamiento de la página de destino el viernes a las 17:00; el responsable del producto indica en una nota posterior que será el jueves por la mañana.
- Mina: redactar el titular y la tabla de precios. Mina también indica que solo podrá revisar el texto el miércoles por la tarde.
- Arjun: eventos de análisis; una nota duplicada indica que el responsable de análisis está por determinar.
- El equipo de diseño tiene dos tareas duplicadas: “recorte del banner principal para móvil” y “recorte final del banner principal para móvil”.
- La revisión legal debe realizarse antes de cualquier lanzamiento público.
- El control de calidad necesita un día completo una vez que los eventos de análisis estén disponibles.
- Omar estará ausente el martes por la tarde.
- El correo electrónico de lanzamiento está programado para el viernes a las 16:00.
- Desconocido: quién tiene la responsabilidad final de dar luz verde o rechazar el proyecto.

Requisitos: agrupar el trabajo duplicado, marcar los responsables desconocidos como «por determinar», mantener ambos plazos inamovibles, señalar las contradicciones en lugar de resolverlas en silencio y terminar con una lista de cinco riesgos.

Incluye exactamente estas secciones:
1. Plan semanal
2. Contradicciones e incógnitas
3. Cinco riesgos
No inventes responsables ni fechas.
1. Plan semanal

No hay fechas en el calendario en las notas, por lo que no se añade ninguna. Solo se utilizan los puntos de referencia y las dependencias indicadas. El trabajo de diseño duplicado se considera una sola tarea. Los responsables desconocidos se mantienen como “por determinar”. Se mantienen ambas fechas de lanzamiento en conflicto.

- Redacción: Mina redacta el titular y la tabla de precios. Su revisión del texto tendrá lugar únicamente el miércoles por la tarde.
- Diseño: una tarea, recorte del elemento principal para móvil, incluida la revisión “final”. No se ha designado ningún responsable concreto.
- Eventos de análisis: deben existir antes del control de calidad. El responsable no está definido (Arjun en una nota; «por determinar» en otra).
- Control de calidad: un día completo, solo después de que los eventos analíticos estén disponibles. Responsable: por determinar. Aquí no se asigna ningún día para el control de calidad.
- Revisión legal: necesaria antes de cualquier lanzamiento público. Responsable: por determinar. No está programada en las notas.
- Luz verde/luz roja: responsable: por determinar. No se considera decidido.
- Fechas clave del lanzamiento público, ambas se mantienen: jueves por la mañana (responsable del producto) y viernes a las 17:00 (página de destino).
- Correo electrónico de lanzamiento: viernes a las 16:00. Responsable: por determinar.
- Omar estará ausente el martes por la tarde. Ninguna tarea de estas notas está asignada a Omar, por lo que no se traslada ninguna.

Orden, sin nuevas fechas: el borrador de Mina debe estar listo para la revisión del miércoles por la tarde; el equipo de diseño termina el recorte de la imagen principal; los eventos analíticos los entrega el responsable aún sin asignar; el equipo de control de calidad dispone entonces de un día completo; la revisión legal finaliza antes de cualquier lanzamiento público; la decisión de seguir adelante o no (por determinar) sigue sin tener un responsable. No se deben eliminar el jueves por la mañana, el viernes a las 17:00 ni el viernes a las 16:00.

2. Contradicciones e incógnitas

Contradicciones (sin resolver):
- El lanzamiento de la página de destino es el viernes a las 17:00, y una nota posterior del responsable de producto indica que es el jueves por la mañana.
- El responsable de analítica es Arjun en una nota y «por determinar» en otra nota duplicada.

Incógnitas, marcadas como «por determinar»:
- Responsable definitivo de la decisión de seguir adelante o no.
- Responsable definitivo de analítica.
- Responsable de la revisión jurídica.
- Responsable de control de calidad.
- Responsable del correo electrónico de lanzamiento.
- Responsable de diseño designado, más allá de «Diseño».
- La función de Omar; solo se indica su ausencia el martes por la tarde.
- Qué hora de lanzamiento es la definitiva, y si el correo electrónico del viernes a las 16:00 coincide con alguna de esas horas. No se indican fechas más allá de esas horas entre semana.

3. Cinco riesgos

1. No pueden coincidir el jueves por la mañana y el viernes a las 17:00 como fecha de lanzamiento de la página de destino; utilizar cualquiera de las dos sin una decisión puede provocar un lanzamiento prematuro o incumplir el otro plazo.
2. El correo electrónico de lanzamiento está fijado para el viernes a las 16:00, antes de las 17:00 del viernes, y no está alineado en las notas con la mañana del jueves, por lo que podría enviarse en relación con una página que aún no se encuentre, o ya no se encuentre, en el estado previsto.
3. La responsabilidad sobre el análisis de datos está en disputa, por lo que los eventos podrían retrasarse; el control de calidad (QA) sigue necesitando un día completo tras los eventos y puede que no quepa antes de ninguno de los dos plazos clave del lanzamiento.
4. La revisión jurídica debe preceder a cualquier lanzamiento público, pero no tiene responsable ni franja horaria asignada, por lo que el lanzamiento podría bloquearse o llevarse a cabo sin dicha revisión.
5. No se ha designado a ningún responsable de la decisión de «adelante» o «no adelante», por lo que ninguno de los dos plazos fijos cuenta con una persona designada para aprobar o detener el lanzamiento.
La versión Grok 4.7 fusionó la tarea duplicada «mobile-hero», mantuvo el conflicto de lanzamiento del jueves por la mañana y el viernes a las 17:00, conservó el plazo del correo electrónico del viernes a las 16:00, marcó a los responsables sin asignar como «por determinar» y terminó con exactamente cinco riesgos. No inventó fechas del calendario ni responsables. El punto débil fue la viabilidad: en lugar de asignar el trabajo a lo largo de una secuencia de lunes a viernes, devolvió una lista ordenada de dependencias y indicó que no se podía asignar ningún día para el control de calidad. Esa precaución es defendible, pero la pregunta solicitaba un plan de ejecución de una semana, por lo que la respuesta solo se ajustó parcialmente al formato solicitado.
Veredicto: Aprobado parcial: excelente conservación de las restricciones, menor utilidad para la programación.
¿Qué cambios introduce la versión Grok 4.7 en los flujos de trabajo reales?
La forma más útil de interpretar el lanzamiento es planteárselo como una cuestión de flujo de trabajo: ¿en qué casos el razonamiento sostenido reduce el trabajo de revisión y en qué casos simplemente da lugar a una respuesta más larga? Las tres tareas de la API sugieren un patrón práctico. Grok 4.7 se desenvuelve bien manteniendo varias restricciones visibles a la vez, especialmente cuando la indicación le pide que separe los hechos de las suposiciones. Resulta menos convincente cuando la tarea requiere un calendario concreto o una secuencia de ejecución que las notas de origen no especifican por completo.
Codificación y depuración
En lo que respecta al trabajo con repositorios, el modelo se adapta mejor a un diagnóstico delimitado que a una solicitud abierta del tipo “crear una aplicación”. Proporciónale el conjunto de archivos más reducido que sea útil, describe el síntoma del fallo y exige que se identifique la causa raíz antes de aplicar un parche. Solicita pruebas que fallaran antes del cambio y que pasaran después de este. En nuestra prueba del controlador, la respuesta se mantuvo fiel al código proporcionado y evitó inventar una causa externa para el síntoma del cuerpo vacío.
Ese comportamiento es importante porque la calidad de la programación no se limita a la generación de código. Una respuesta de programación útil debe preservar el diseño local, limitar las diferencias, identificar supuestos y facilitar la verificación. Grok 4.7 logró todo eso en una pequeña tarea, pero una sola tarea no basta para garantizar la fiabilidad a escala del repositorio. Los equipos deberían aplicar la misma rúbrica a un error real, una refactorización, un cambio en varios archivos y una ruta sensible desde el punto de vista de la seguridad antes de pasar a la fase de producción.
Investigación y síntesis de fuentes
La tarea de investigación puso de manifiesto otro punto fuerte: la rigurosidad en la delimitación de las fuentes. Grok 4.7 no fusionó sin más la afirmación del proveedor de 100 000 acciones con la cifra de 120 000 de la publicación de comparación. Además, distinguió un cálculo que resulta válido en ambos escenarios de una condición de adquisición que aún requiere verificación.
Este es el patrón adecuado para trabajos que requieren una gran cantidad de investigación. Pide al modelo que etiquete por separado los hechos verificados, las afirmaciones atribuidas, los conflictos sin resolver, los cálculos y las recomendaciones. Un informe bien redactado puede seguir siendo erróneo si disfraza una afirmación secundaria como un hecho sin citar. La respuesta de Grok 4.7 resultó útil porque mantuvo el conflicto a la vista, aunque el resultado aritmético no cambiara.
Planificación y operaciones
Fue durante la planificación cuando las limitaciones se hicieron más evidentes. El modelo conservaba todos los plazos y los propietarios desconocidos, pero no llegaba a generar un calendario de lunes a viernes. Esto es más seguro que inventarse fechas, aunque implica que el usuario sigue teniendo que convertir las dependencias en asignaciones de calendario.
En el caso de las indicaciones operativas, incluye el horizonte de planificación, los días laborables disponibles, la disponibilidad del propietario y la persona encargada de tomar la decisión. Si faltan esos campos, solicita primero un mapa de dependencias y, a continuación, un calendario. Este flujo de trabajo en dos fases permite que la advertencia del modelo resulte útil, en lugar de interpretarla como una falta de capacidad para tomar decisiones.
Recuperación de contexto extenso
Una ventana de contexto de 500K modifica lo que cabe en una sola solicitud, pero no lo que se puede dar por cierto sin comprobarlo. El trabajo con contextos largos debería utilizar pruebas de recuperación: colocar los hechos decisivos cerca del principio, la mitad y el final de un paquete; añadir un conflicto deliberado; y, a continuación, solicitar una decisión indicando las ubicaciones de origen. Mide tanto la recuperación como la disciplina de límites.
No juzgues una ruta de contexto largo por el mero hecho de que acepte una solicitud de gran tamaño. Registra en qué puntos el modelo omite datos, si da demasiado peso a la sección final, en qué medida aumenta la latencia con el tamaño de la entrada y si el proveedor trunca o transforma la solicitud. Una ventana de tamaño grande anunciada es una afirmación de capacidad, no una garantía de razonamiento estable en el límite.
Cómo evaluar tú mismo el modelo Grok 4.7
Utiliza un conjunto de pruebas pequeño y repetible antes de modificar un valor predeterminado de producción. El objetivo no es volver a crear una tabla de clasificación, sino comparar el modelo con el proceso de revisión y seguimiento por el que ya pagas.
- Congela las entradas. Guarda exactamente el mensaje de solicitud, los archivos, el paquete de origen, el ID del modelo, la temperatura, la configuración del razonamiento y los permisos de la herramienta. No compares una ruta directa con una ruta del proveedor mientras modificas al mismo tiempo el mensaje de solicitud.
- Valora la obra, no la prosa. En cuanto a la programación, evalúa la precisión en la identificación de la causa raíz, el alcance del parche, las pruebas y los supuestos. En cuanto a la investigación, evalúa los límites de las citas, la aritmética, los conflictos y la calidad de las recomendaciones. En cuanto a la planificación, evalúa el cumplimiento de los plazos, la responsabilidad, las dependencias y la viabilidad.
- Registra el transporte por separado. Registra en un log de rutas el tiempo hasta el primer token, el tiempo total, el modo «stream» o «no stream», el estado HTTP y el comportamiento de los reintentos. Un tiempo de espera agotado en la pasarela no supone automáticamente un fallo de calidad del modelo, pero sigue representando un coste de producción.
- Comprueba el comportamiento en caso de fallo. Incluye una entrada ambigua, una fuente contradictoria y un conjunto de archivos deliberadamente incompleto. La pregunta relevante es si el modelo señala la incertidumbre o si llena el vacío con una suposición segura.
- Analiza conjuntamente los costes y el esfuerzo. Realiza un seguimiento de los tokens de entrada, los tokens de salida, la entrada almacenada en caché, los tokens de razonamiento cuando se exponen y las actas de revisión humana. Una respuesta más barata que tarda el doble de tiempo en verificarse puede que, en la práctica, no resulte más económica.
- Repítelo antes de cambiar. Realiza cada tarea al menos dos veces o con varios ejemplos representativos antes de modificar un valor predeterminado del equipo. Conserva la respuesta original visible y las notas de puntuación para que otro revisor pueda reproducir la decisión.
Las tres ejecuciones que se incluyen en esta reseña constituyen una muestra inicial, no un sustituto del conjunto de evaluación de un equipo. Muestran cómo se comporta Grok 4.7 en una tarea de codificación, un memorándum sobre conflictos de fuentes y un paquete de planificación; no establecen una clasificación universal.
Grok 4.7: precios y acceso a la API
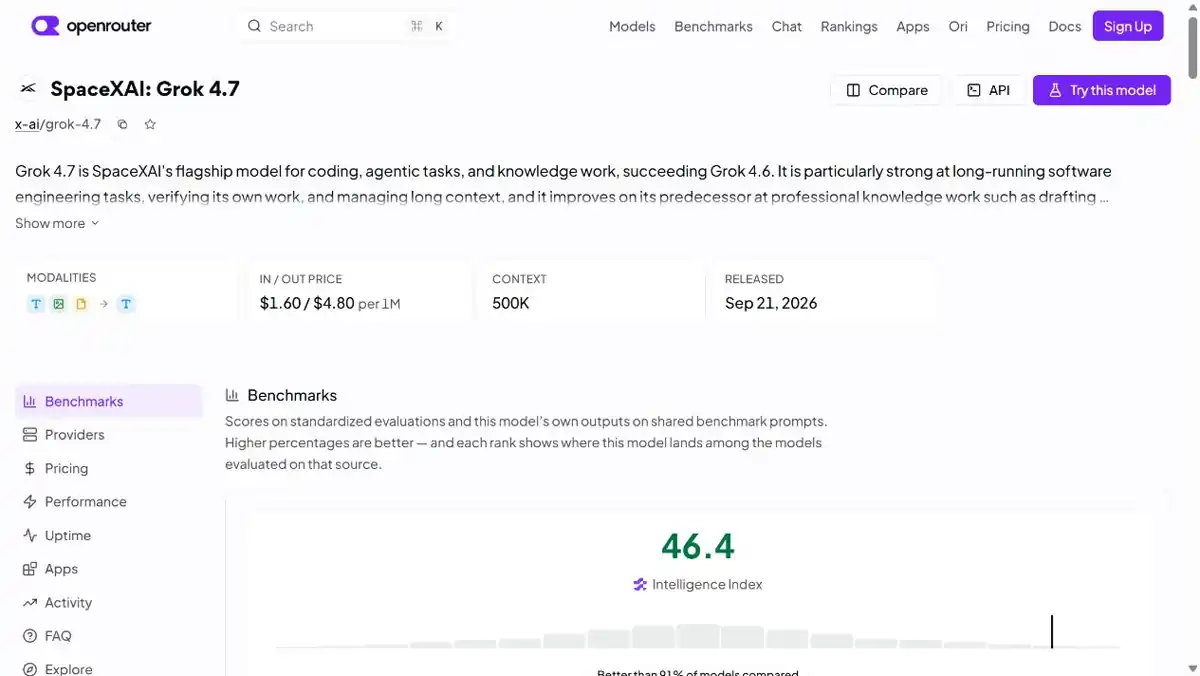
El tema de los precios es donde las reseñas de modelos suelen resultar engañosas. Hay al menos tres cifras diferentes que el lector puede encontrar: el precio directo de la API de xAI, el precio de la ruta de un agregador y el precio de la suscripción para el consumidor. No son intercambiables.
Según el comunicado de xAI, el Grok 4.7 se ofrece al mismo precio y con la misma velocidad que el Grok 4.6. La página de lanzamiento indica que el modelo estándar tiene un precio inicial de $2 por cada millón de tokens de entrada y $6 por cada millón de tokens emitidos; «Análisis artificial» recoge por separado las mismas cifras de rutas directas y $0,50 por cada millón de tokens de entrada almacenados en caché. xAI también afirma que una variante rápida duplica la velocidad de producción, aunque a un precio el doble. Utiliza el documentación oficial para desarrolladores para consultar el contrato de API vigente y la disponibilidad específica de la cuenta antes de enviar tráfico de producción.
Página 4.7 del Grok de OpenRouter muestra $1,60 por cada millón de tokens de entrada y $4,80 por cada millón de tokens emitidos para su ruta. Se trata de un precio de OpenRouter/proveedor, no de una corrección del precio de catálogo directo de xAI. El enrutamiento, el margen de beneficio, el almacenamiento en caché, los límites y la disponibilidad pueden variar según el proveedor.
No hay una respuesta única y fiable a la pregunta “¿Cuánto cuesta el Grok 4.7?” sin especificar la ruta. Para un comprador de API, compare:
- tasas de tokens de entrada y salida;
- tratamiento de entradas almacenadas en caché;
- límites de contexto y de salida;
- límites de tarifas y disponibilidad regional;
- si el proveedor ofrece controles de razonamiento;
- Condiciones relativas al registro, la conservación y el tratamiento de datos.
En lo que respecta al acceso de los consumidores, no des por sentado que el precio de una API refleja el precio de una suscripción X o Grok. El plan para consumidores, la ruta de la API y el agregador de terceros pueden tener normas de acceso diferentes.
¿Qué ruta de la API deberías elegir?
| Ruta | Lo mejor para | Qué hay que comprobar antes de utilizarlo | Principal dilema |
|---|---|---|---|
| API de Direct xAI | Sistemas de producción que requieren un contrato propio del proveedor | Identificador oficial del modelo, límites de velocidad, condiciones de datos, regiones, streaming y precio actual | La procedencia más fiable, pero tú te encargas directamente de la facturación y la disponibilidad |
| OpenRouter | Comparación rápida de proveedores y prueba de rutas | Proveedor real de origen, precio de la ruta, almacenamiento en caché, privacidad, contexto y comportamiento de reserva | El cambio es más sencillo, pero la ruta no es la misma que la del servicio directo de xAI |
| API de pruebas compatible con OpenAI | Evaluación interna o un cliente heredado que ya utiliza el esquema OpenAI | Asignación de modelos, límites de tiempo de espera, compatibilidad con la transmisión en continuo, campos de uso, retención y semántica de errores | Integración práctica, pero la compatibilidad no garantiza que el comportamiento de los proveedores sea idéntico |
La ruta compatible utilizada para la parte práctica devolvió grok-4.7 y admitía transmisión en continuo. Su solicitud de codificación sin transmisión en continuo superó el intervalo de espera de la pasarela antes de que finalizara el reintento de la transmisión en continuo. Esta observación resulta útil a la hora de diseñar un cliente, pero no debe utilizarse para justificar una reclamación de latencia de DirectX AI.
Cómo acceder a Grok 4.7
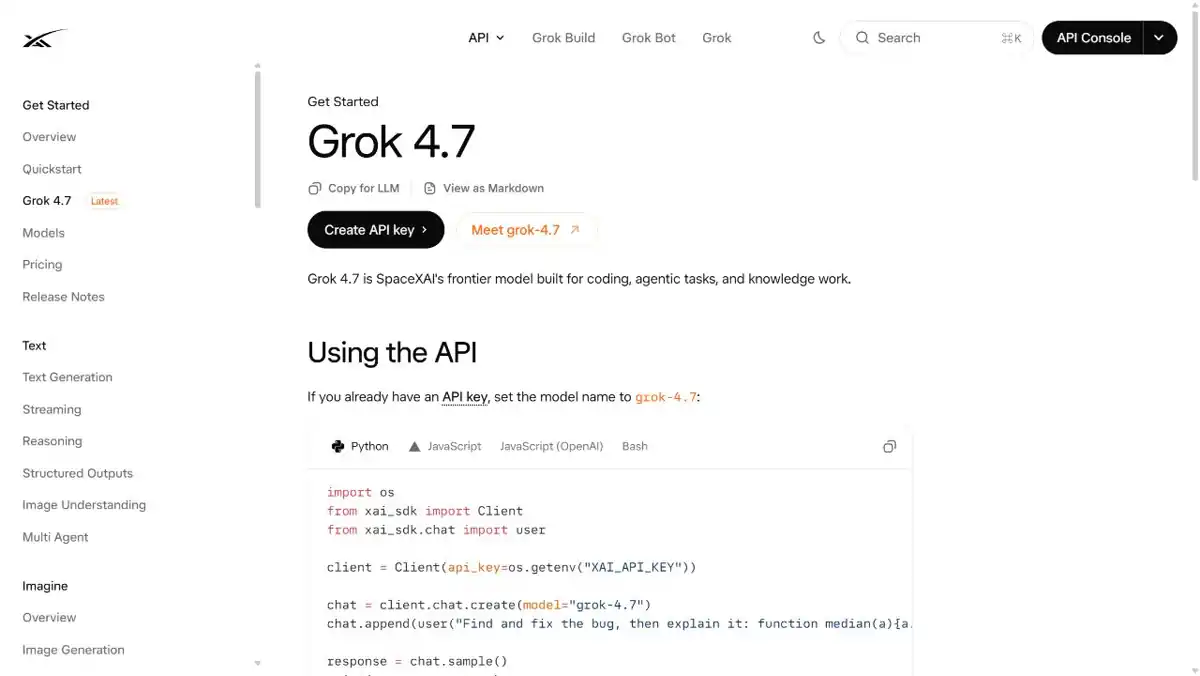
La forma más sencilla es empezar por el Anuncio de xAI y Página para desarrolladores de xAI, y a continuación confirma si necesitas Grok Build, Cursor, la API directa o un agregador. xAI afirma que Grok 4.7 está disponible en Cursor y Grok Build, a través de la API de Grok, así como a través de entornos de programación de terceros, enrutadores de modelos y plataformas en la nube. Esa distinción determina la facturación, los controles de los modelos, las condiciones de privacidad y las herramientas disponibles.
Si utilizas un agregador, abre la página del modelo y comprueba la ruta del proveedor, los precios de los tokens, el límite de contexto y el identificador del modelo antes de desarrollar sobre la base de este. OpenRouter es una ruta documentada, pero sus precios no deben copiarse en una tabla de facturación de xAI.
Para los lectores que deseen comparar varias familias de modelos en un mismo espacio de trabajo, El espacio de trabajo multimodelo de GlobalGPT puede resultar útil para evaluar las indicaciones de forma comparativa. Este artículo... no afirman que la ruta Grok 4,7 ya está disponible allí. La disponibilidad de la ruta que figura en el catálogo, una vez verificada, es una cuestión aparte y debe comprobarse en la interfaz de usuario del producto antes de realizar la compra.
Grok 4,7 frente a ChatGPT, Claude y Gemini
Esta reseña incluye tres resultados de la tarea Grok 4.7, pero no hay comparaciones con ChatGPT, Claude ni Gemini. Una conclusión general del tipo “el Grok 4.7 gana” seguiría siendo una estrategia de marketing, no un análisis. Una mejor elección depende del trabajo realizado en torno al modelo:
| Si su prioridad es... | Empieza por evaluar… | Por qué |
|---|---|---|
| Paquetes técnicos extensos | Grok 4.7 y otras rutas de amplio contexto | Comprueba la precisión de la recuperación de datos, no solo el intervalo anunciado |
| Depuración del repositorio | Grok 4.7, un modelo centrado en la programación, y tu bucle de prueba habitual | Comparar la calidad del análisis de las causas raíz y el tiempo de revisión |
| Investigación basada en las fuentes primarias | Un flujo de trabajo orientado a la investigación, junto con un modelo de razonamiento general | Comprueba las referencias antes de aceptar las conclusiones |
| Integraciones de productividad existentes | El modelo ya está integrado en tus herramientas | El coste de cambio puede superar la ganancia respecto al índice de referencia |
| Factura de API más baja | Rutas directas y de agregadores, una al lado de la otra | Los precios varían según el proveedor y el comportamiento de la caché |
En “Guía ”¿Por qué IA merece la pena pagar?». plantea la pregunta adecuada a la hora de comprar: ¿qué tarea recurrente mejora lo suficiente como para amortizar el coste de la suscripción o la factura de la API? Esa es una regla de decisión más sólida que ir a la caza de la última novedad en las listas de éxitos.
Limitaciones y cuestiones pendientes
La versión Grok 4.7 es demasiado reciente para que exista un consenso independiente generalizado. Los datos disponibles dejan varias cuestiones sin resolver:
- ¿En qué medida es uniforme la mejora en las tareas de programación, investigación, redacción y tareas multimodales?
- ¿Sigue siendo fiable el contexto de 500K cerca del límite, o el rendimiento de la recuperación se deteriora antes?
- ¿Cuánta latencia adicional supone el mayor esfuerzo de razonamiento?
- ¿Qué planes de consumo, regiones, herramientas y límites de velocidad afectan al modelo?
- ¿Cómo se aplican las nuevas medidas de seguridad a los trabajos técnicos legítimos pero sensibles?
- ¿Direct xAI, OpenRouter y otros proveedores ofrecen resultados o límites sustancialmente diferentes?
Esas preguntas no son motivos para descartar el modelo. Son la razón por la que conviene realizar una evaluación pequeña pero representativa antes de migrar un flujo de trabajo o prometer un ahorro de costes.
¿Quién debería utilizar el Grok 4.7?
Merece la pena probar primero el Grok 4.7 si:
- depurar código o analizar material técnico durante largos periodos de tiempo;
- trabajar con paquetes de código fuente que superen el tamaño habitual de las ventanas de chat;
- valorar un modelo que esté dispuesto a dedicar más esfuerzo a una indicación compleja;
- puede revisar los resultados en lugar de enviarlos directamente a producción;
- están comparando la rentabilidad de las API directas y la de los agregadores.
No es la mejor opción si necesitas una integración madura, un plan de uso claramente documentado o una ventaja demostrada en la misma tarea frente al modelo que ya tienes en tu pila. En esos casos, la capa de acceso y flujo de trabajo puede ser más importante que una mejora de dos puntos en el índice.
PREGUNTAS FRECUENTES
¿Qué es Grok 4.7?
Grok 4.7 es la versión del modelo de xAI, lanzada el 21 de septiembre de 2026, destinada a la programación y el trabajo intelectual. Según xAI, este modelo dedica más tiempo a las tareas difíciles, revisa su trabajo con mayor detenimiento e incorpora un nuevo conjunto de medidas de seguridad, al tiempo que mantiene el mismo precio y la misma velocidad que la versión Grok 4.6.
¿Cuándo se lanzó la versión Grok 4.7?
xAI anunció el Grok 4.7 el 21 de septiembre de 2026. La página oficial de lanzamiento y la documentación para desarrolladores son las mejores fuentes de información sobre el estado del lanzamiento, la disponibilidad de los modelos y los cambios en la API.
¿Es el Grok 4.7 mejor que el Grok 4.6?
Artificial Analysis indica un índice de inteligencia de 46, dos puntos por encima del Grok 4.6, y un Elo de 1.657 en AA-Briefcase, 111 puntos por encima del 4.6. Se trata de señales útiles, pero no de un resultado universal válido para todos los flujos de trabajo.
¿Qué es la ventana de contexto de Grok 4.7?
Artificial Analysis indica una ventana de contexto de 500 000 tokens para Grok 4.7. Una ventana grande no garantiza una recuperación perfecta, por lo que conviene probar el modelo con datos situados en distintos puntos de un documento extenso antes de confiar en él para trabajos con gran volumen de fuentes.
¿Cuánto cuesta el Grok 4.7 API?
Artificial Analysis indica que el rendimiento de la ruta directa de la API es de $2 por cada millón de tokens de entrada y de $6 por cada millón de tokens de salida, mientras que el de la entrada almacenada en caché es de $0,50 por cada millón de tokens. Consulta la documentación actualizada de xAI antes de utilizarlo en entorno de producción.
¿El precio del Grok 4.7 de OpenRouter es el mismo que el de xAI?
No. OpenRouter indica $1,60 por cada millón de tokens de entrada y $4,80 por cada millón de tokens de salida para su ruta. Se trata de un precio específico del proveedor y debe compararse por separado de los precios de la API directa de xAI. OpenRouter también muestra campos específicos del proveedor relacionados con la caché, la latencia, el rendimiento y la privacidad, que pueden modificar el coste real de una ruta.
¿Cómo puedo acceder a Grok 4.7?
Empieza por consultar el anuncio oficial y la documentación para desarrolladores de xAI; a continuación, elige el producto Grok para consumidores, la API directa de xAI o un agregador como OpenRouter. Comprueba el ID del modelo, la región, los límites de velocidad, el contexto y la facturación de la ruta que realmente tengas previsto utilizar.
¿Está disponible la versión Grok 4.7 en GlobalGPT?
Esta reseña no afirma que la ruta Grok 4.7 haya sido verificada en el modelo GlobalGPT. El modelo GlobalGPT puede utilizarse para comparar las familias de modelos disponibles, pero antes de la compra conviene comprobar el catálogo actual y la disponibilidad exacta de los modelos en la interfaz de usuario del producto.
¿Es el Grok 4.7 adecuado para los agentes de codificación?
Merece la pena probarlo en contextos de depuración acotada, revisión de código y razonamiento con múltiples archivos, en los que el agente debe explicar sus supuestos y generar pruebas. La tarea práctica de programación fue muy buena, pero no evaluó la ejecución de herramientas, la edición del repositorio, los permisos ni un ciclo completo del agente.
¿Por qué era necesario el streaming para la prueba de programación?
La primera solicitud sin streaming superó el intervalo de espera de la pasarela de la ruta de prueba. La misma solicitud se completó con el streaming activado. Esto demuestra por qué los clientes de producción deben admitir el streaming y los tiempos de espera explícitos; no prueba que todas las rutas Grok 4.7 tengan el mismo comportamiento en cuanto a latencia.
¿Cómo debo probar la ventana de contexto de 500 000?
Utiliza un paquete fijo con datos clave situados al principio, en el centro y al final, además de un conflicto intencionado. Solicita la ubicación de las fuentes y evalúa la capacidad de recuperación, la gestión de conflictos y la latencia con distintos volúmenes de datos de entrada, en lugar de basarte únicamente en el máximo anunciado.
¿Merece la pena actualizar de la versión Grok 4.6 a la Grok 4.7?
Los primeros resultados apuntan a una mejora significativa, aunque gradual: las mediciones independientes han mejorado y la sesión práctica ha dado buenos resultados en cuanto a la depuración y la síntesis de código fuente. Actualiza el sistema solo cuando tus propias tareas muestren un menor esfuerzo de revisión o una mayor precisión, a un coste específico por ruta que puedas justificar.
Veredicto final
Grok 4.7 parece una actualización importante y gradual del modelo con un objetivo claro: el trabajo de programación y de conocimiento que recompensa el esfuerzo sostenido. El comunicado oficial ofrece una explicación creíble del cambio; los primeros datos de Artificial Analysis muestran una mejora con respecto a la versión Grok 4.6, en lugar de un retroceso, y nuestra prueba con la API aporta una señal práctica más discreta. El modelo gestionó especialmente bien un error de concurrencia y un memo de fuentes conflictivas; su respuesta de planificación fue prudente, pero no tan operativa como se solicitaba.
El veredicto objetivo sigue siendo provisional. Se trata de tres pruebas individuales realizadas en una ruta de prueba; la tarea más lenta requirió la transmisión en streaming tras un tiempo de espera de la pasarela sin transmisión, y no hay ninguna prueba comparable de la competencia ni un consenso independiente generalizado. Empieza con una tarea compleja de tu flujo de trabajo real, compara los resultados y el tiempo de revisión con el modelo que ya utilizas y, a continuación, decide si la actualización compensa el coste específico de esa ruta.









