Análisis del Claude Opus 5.5: precio, pruebas de rendimiento y pruebas reales de la API
Claude Opus 5.5 combina una ventana de contexto de 1 millón de tokens con un precio de la API de $4 / $20 por cada millón de tokens. Este análisis distingue entre las afirmaciones publicadas por Anthropic, las instantáneas de pruebas comparativas independientes y cinco ejecuciones directas de tareas a través de la ruta de la API de mensajes.
El resultado de la medición es específico. Tres tareas arrojaron resultados correctos y útiles; la tarea de programación dio una respuesta útil, pero alcanzó el límite máximo de 1.024 tokens; la prueba de escritura en chino generó un texto ilegible en la ruta probada. La muestra refleja un comportamiento concreto y los límites de las rutas, no una tasa de éxito universal.
Respuesta rápida
- Rendimiento: Anthropic presenta un rendimiento de nivel Fable 5.1 en la mayoría de las tareas, mientras que Artificial Analysis registró una puntuación de 58 en el Índice de Inteligencia al dar el máximo esfuerzo. Los datos más limitados de METR sobre la capacidad de juicio no mostraron una mejora significativa con respecto a Fable 5.1.
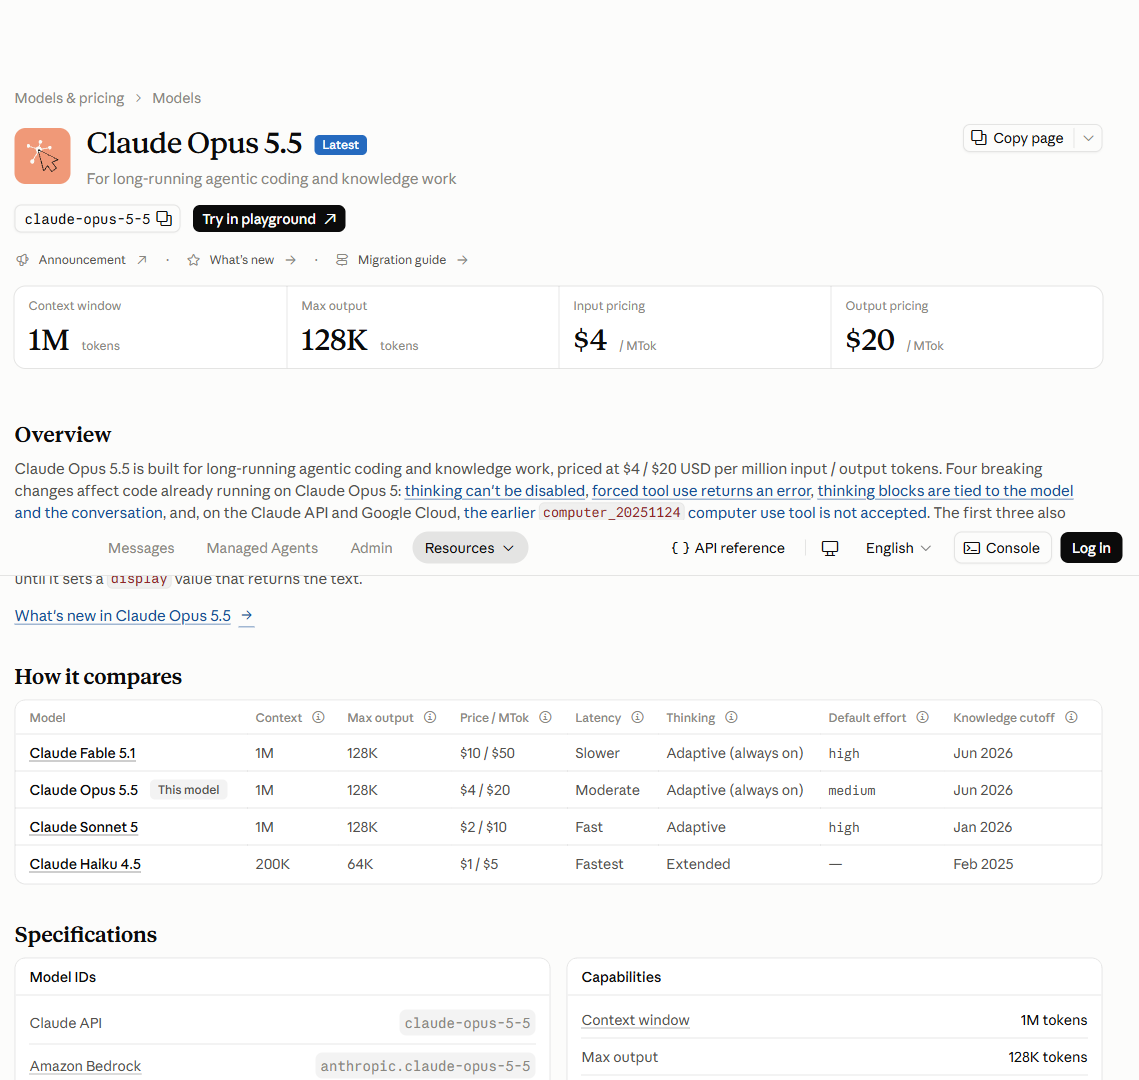
- Precio: El tipo de cambio oficial de la API es $4 por cada millón de tokens de entrada y $20 por cada millón de tokens de salida. Las lecturas de caché cuestan $0,20 por millón; las escrituras de caché de 5 minutos cuestan $5 por millón.
- Resultado práctico: La extracción de texto largo, el JSON estricto y el razonamiento aritmético se superaron en las ejecuciones registradas. La codificación resultó útil, pero se vio limitada por el límite máximo inicial. El resultado del chino se ha registrado como un problema de ruta o codificación, no como un veredicto lingüístico a nivel de modelo.
- Advertencia de la API: No se puede desactivar el pensamiento; si se intenta utilizar la herramienta a la fuerza, se produce un error; los bloques de pensamiento están vinculados al modelo y a la conversación, y los antiguos
ordenador_20251124La herramienta no es compatible con la API Claude ni con la ruta de Google Cloud.
Lo que dicen los documentos oficiales
La página de lanzamiento de Anthropic sitúa la fecha de Claude Opus 5.5 el 22 de septiembre de 2026 y lo describe como el primer modelo de la familia Claude 5.5. El anuncio afirma que ofrece un rendimiento al nivel del Claude Fable 5.1 en la mayoría de las tareas, un coste típico por carga de trabajo 40% inferior al del Opus 5 y una velocidad de salida más de 30% superior a la del Opus 5. Se trata de afirmaciones del proveedor, por lo que se muestran por separado de las pruebas independientes y prácticas que se presentan a continuación.
En Documentación de la plataforma Claude indica el ID del modelo de la API como claude-opus-5-5, una ventana de contexto de 1 millón de tokens, una salida máxima de 128 K y un sistema de razonamiento adaptativo siempre activo. La documentación también enumera los cambios que afectan a las integraciones existentes de Opus 5, que se tratan en la sección de migración que figura a continuación.
Datos sobre el rendimiento
Aquí no hay una única cifra que refleje el “rendimiento”. Las tres fuentes públicas miden aspectos diferentes, por lo que cada ficha mantiene visibles sus propios parámetros y el alcance de los datos.
Anuncio sobre Anthropic
Señal publicada: Según Anthropic, Opus 5.5 ofrece un rendimiento similar al de Claude Fable 5.1 en la mayoría de las tareas, cuesta 40% menos que Opus 5 en cargas de trabajo habituales y genera resultados más de 30% más rápido.
Límite: Ejemplos de posicionamiento y pruebas publicados por el proveedor; no se trata de una evaluación comparativa independiente.
Análisis artificial
Señal publicada: La instantánea de máximo esfuerzo registra 59,61 TP40T en Terminal-Bench 4.0, 61,41 TP40T en «Humanity’s Last Exam» y 66,91 TP40T en SciCode.
Límite: Las puntuaciones dependen del esfuerzo, el sistema de evaluación, la fecha y la definición de los parámetros. No predicen todas las peticiones de la API.
Evaluación previa a la implantación de METR
Señal publicada: METR afirma que sus datos no mostraron una mejora significativa con respecto a Fable 5.1 en las habilidades de juicio que evaluó, aunque sigue esperando una aceleración significativa en algunos trabajos de I+D.
Límite: Se trata de una evaluación más limitada del criterio y la rapidez en la realización de las tareas, no de una clasificación completa de la calidad.
En conjunto, los datos apuntan a una conclusión limitada: el Opus 5.5 es el modelo líder en varias evaluaciones públicas antiguas, pero la magnitud de la ventaja varía en función de la tarea, el nivel de esfuerzo y el diseño de la evaluación. Los datos no establecen un resultado universal que lo convierta en el “mejor modelo”.
Claude Opus 5.5: unidades de precio y facturación
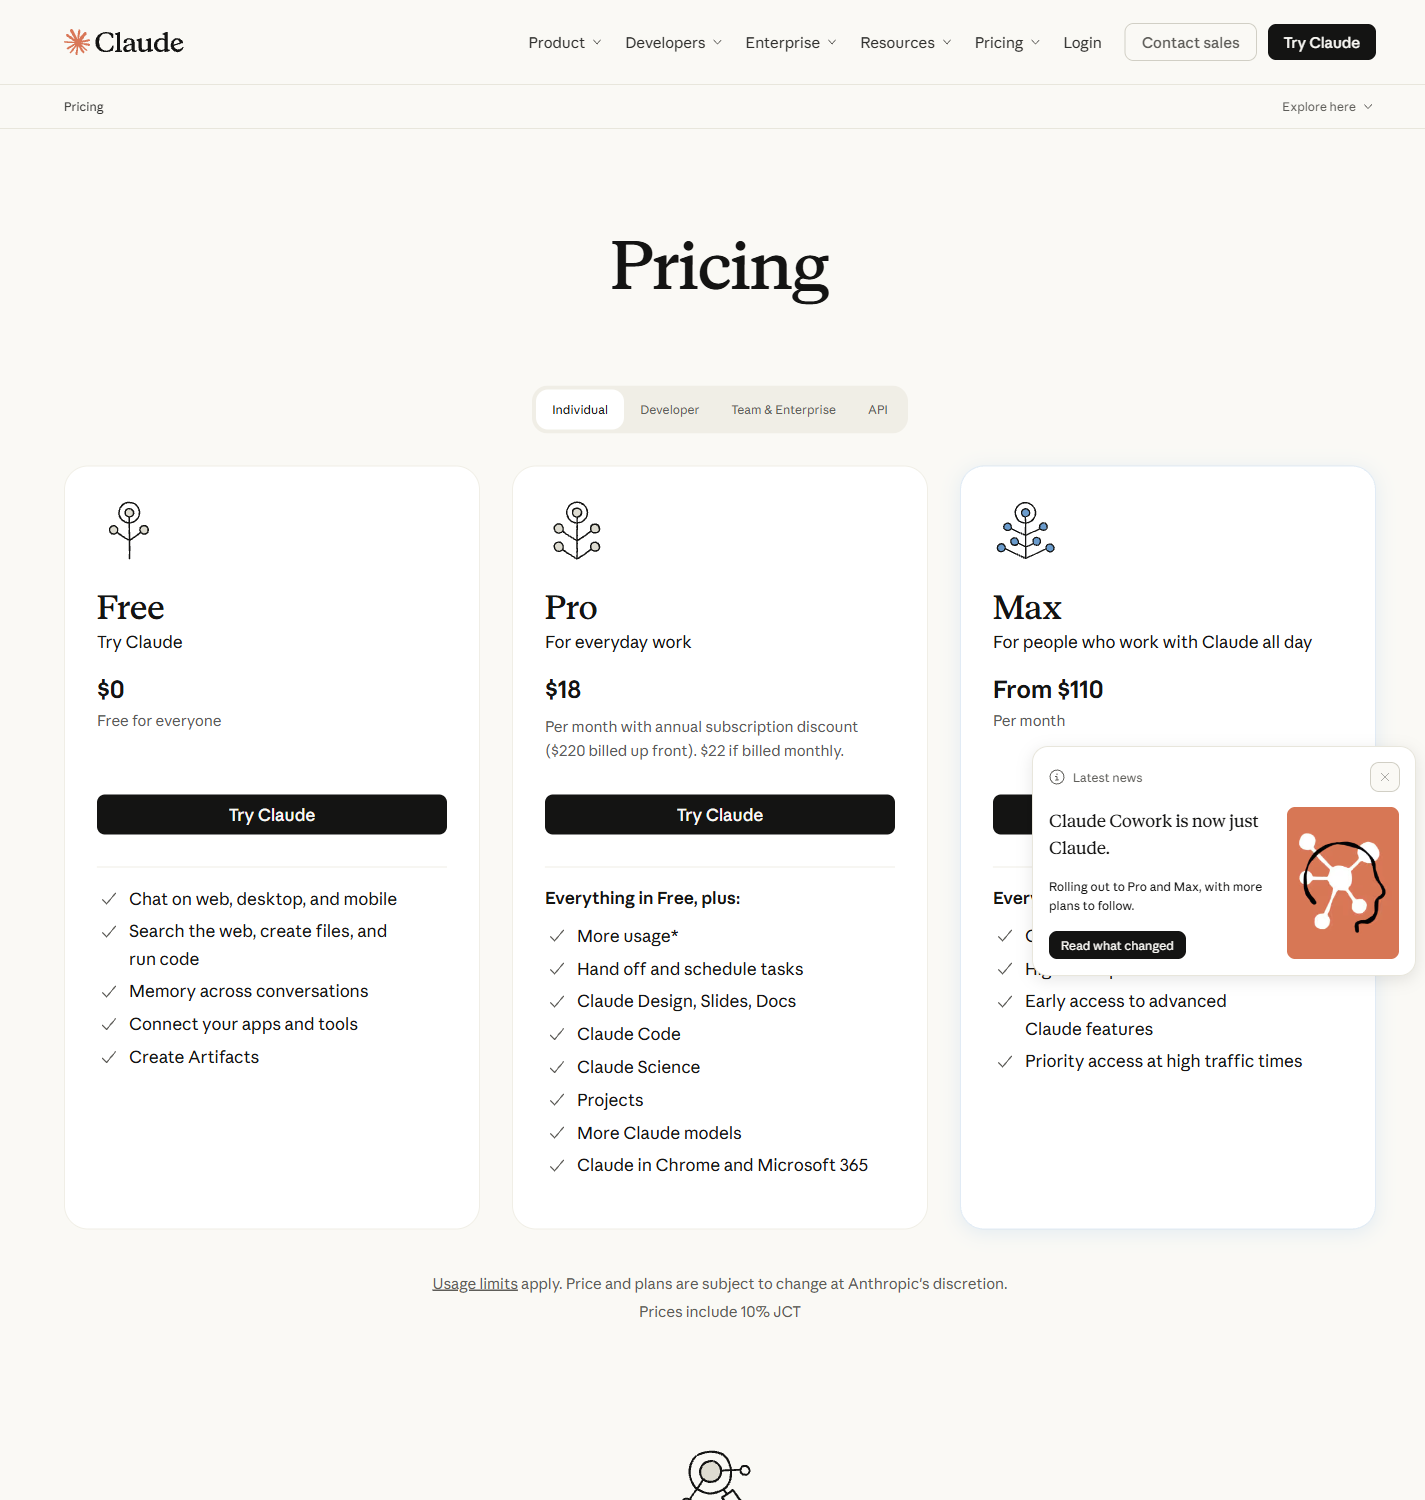
El precio de la API y el precio de la suscripción para el consumidor son productos distintos. Las cifras de la API que se muestran a continuación son los precios unitarios que se utilizan para la gestión del presupuesto de tokens; las cifras para el consumidor corresponden a las fichas de planes que se ven en la zona del navegador capturada.
Precios oficiales de la API
Estimación sencilla: 10.000 tokens de entrada más 2.000 tokens de salida equivalen aproximadamente a $0,08 a tarifas estándar, antes de tener en cuenta la caché, el procesamiento por lotes, los impuestos o el margen de la plataforma.
Captura de pantalla del plan para consumidores
La captura de pantalla también muestra una nota JCT 10%. Se trata de valores que varían según la región, no de una promesa de precio global.
Para obtener una explicación detallada sobre la facturación por tokens y el coste de la ventana de contexto, consulta el Guía de precios y contexto de GPT-5.5. La tarifa de la API del proveedor, el precio de la suscripción y cualquier saldo de crédito de la plataforma multimodelo deben figurar por separado en tu presupuesto.
Prueba práctica: cinco tarjetas de resultados de tareas
El 23 de septiembre de 2026 enviamos cinco solicitudes independientes a través de la misma ruta controlada de la API de mensajes con el ID de modelo claude-opus-5-5. En la primera pasada se utilizó max_tokens: 1024. Registramos el tiempo transcurrido localmente, los tokens de entrada y salida, el motivo de la interrupción, la corrección y el cumplimiento del formato literal. La tarea de escritura en chino se volvió a ejecutar con un límite máximo de 4.096 tokens después de que la primera pasada pusiera de manifiesto el problema de salida de la ruta. Se trata de una muestra de cinco tareas, no de una estimación de fiabilidad.
¿Es capaz de reparar una función de deduplicación de tipo mixto?
Configuración de la tarea
Encuentra el error en un código de Python deduplicación función, gestionar valores que no sean cadenas ni se puedan convertir en hash, conservar la primera grafía y proporcionar pruebas.
En la respuesta se identificó el .lower() fallaba con valores que no eran cadenas; se ha cambiado «cadenas» por casefold(), añadió una solución alternativa no hashable y devolvió el código corregido junto con los casos de prueba.
La respuesta se detuvo al alcanzar el límite de 1.024 tokens. La solución fue útil, pero la configuración era demasiado limitada para una revisión completa del código.
Veredicto sobre la tarjeta: Se ha obtenido una respuesta útil desde el punto de vista técnico; esta ejecución no permite afirmar nada sobre la latencia ni la exhaustividad, ya que el límite máximo de tokens la ha interrumpido.
¿Puede conservar los hechos y las limitaciones de las pruebas?
Configuración de la tarea
Extrae cinco conclusiones numeradas de un breve informe de evaluación, incluyendo el método utilizado y lo que no se midió en la siguiente ronda.
Presentó exactamente cinco puntos numerados. Mantuvo las comparaciones con los asistentes, el método de las 20 preguntas y las lagunas en torno a la retención a largo plazo y la conversión de clientes.
Se trataba de un paquete de código fuente breve, por lo que no comprueba la ventana de contexto de 1M.
Veredicto sobre la tarjeta: extracción limpia con el número solicitado y conservando los límites de las pruebas del memorándum de origen.
¿Puede generar una salida legible por máquina sin necesidad de depuración?
Configuración de la tarea
Devuelve un objeto JSON fijo con un título, un público objetivo, dos ventajas, dos desventajas y un veredicto. No se permitía el uso de la delimitadora de Markdown.
Devolvió un JSON analizable con las claves solicitadas, dos ventajas, dos inconvenientes y una recomendación concisa. No se encontró ningún contenedor de Markdown.
Una respuesta válida no demuestra la fiabilidad del esquema en objetos más grandes o anidados.
Veredicto sobre la tarjeta: En esta ejecución se ha superado la comprobación de conformidad literal con JSON.
¿Es capaz de aplicar correctamente una regla de redondeo repetido?
Configuración de la tarea
Empieza con 12 artículos, multiplica cada lote siguiente por 1,25, redondea a la baja después de cada lote y calcula el total de los cuatro lotes.
Devolvió 12, 15, 18 y 22, y luego los sumó para obtener 67. Se podían ver los cálculos intermedios.
La tarea es determinista y de poca envergadura; no refleja una capacidad de razonamiento amplia.
Veredicto sobre la tarjeta: un resultado correcto y unos pasos intermedios transparentes.
¿La ruta probada devolvió texto en chino que se pudiera utilizar?
Configuración de la tarea
Redacta un inicio para una reseña sobre un producto chino en el que se distingan las afirmaciones oficiales, el precio, las pruebas comparativas y las pruebas prácticas.
La estructura de la respuesta estaba presente, pero los caracteres chinos aparecían distorsionados en el resultado guardado a través de la ruta probada.
Los datos no distinguen entre la calidad del lenguaje del modelo y el comportamiento de la ruta o de la codificación. No se asigna ninguna puntuación de calidad al chino.
Veredicto sobre la tarjeta: El texto devuelto en esta ruta no es válido; vuelve a ejecutarlo con una ruta UTF-8 verificada antes de hacer afirmaciones sobre la calidad del idioma.
En las cuatro ejecuciones en inglés o en un entorno sin idioma específico, la media local fue de 6,24 segundos. Esa cifra corresponde a cinco solicitudes consecutivas en una ruta y no representa la latencia por parte del proveedor. Los comportamientos más destacados que se observaron fueron la extracción concisa, el cumplimiento literal del formato JSON y la aritmética correcta; los dos problemas sin resolver fueron la presión sobre el presupuesto de salida en la codificación y la salida en chino ilegible en la ruta probada.
Consideraciones sobre la API y la migración
La respuesta breve incluye estos aspectos porque pueden alterar una integración incluso cuando la calidad del texto del modelo parece buena.
- La mente nunca deja de funcionar. Utiliza el parámetro de esfuerzo documentado para controlar la profundidad, la latencia y el coste; no hay opción de desactivarlo.
- El uso forzado de la herramienta genera un error. El código existente que requiere la selección obligatoria de herramientas necesita una prueba de migración independiente.
- Los bloqueos cognitivos están ligados al modelo y a la conversación. No des por sentado que un bloque de pensamiento se pueda reutilizar tras cambiar de modelo.
ordenador_20251124no se acepta sobre la API Claude y la ruta de Google Cloud que se indican en la documentación.- Los límites máximos de producción son importantes. La tarjeta de codificación muestra que una respuesta útil puede verse interrumpida incluso por un pequeño
max_tokensvalor. - El modo por lotes y el modo rápido son modalidades de facturación distintas. Mantén sus descuentos o recargos separados de los precios estándar de las fichas.
Veredicto basado en pruebas
El Claude Opus 5.5 cuenta con pruebas comparativas públicas sólidas y contrastadas, así como con una tasa API estándar publicada inferior a las cifras del Opus 5 que figuran en el comunicado de Anthropic. En las cinco ejecuciones de tareas registradas, generó una extracción limpia, un JSON estricto y operaciones aritméticas; la respuesta de programación fue útil, pero quedó truncada por el límite máximo inicial; y la salida en chino no fue utilizable a través de la ruta probada.
Por lo tanto, la conclusión que se puede extraer es limitada: el modelo demostró un alto nivel de aprendizaje en varias tareas sencillas, mientras que la ruta y la configuración plantearon límites evidentes. Cualquier decisión sobre la migración debería repetir las mismas instrucciones con un presupuesto de salida adecuado, verificar las llamadas a las herramientas y mantener las tarifas oficiales de tokens separadas de los créditos de suscripción o de la plataforma.
Si quieres una segunda ruta para comparar, la Formato de prueba DeepSeek V4 Pro frente a Flash muestra cómo los veredictos a nivel de tarea pueden mantenerse separados de las afirmaciones que abarcan todo el modelo. El Guía de casos de uso de GPT-5.5 añade un punto de referencia orientado a las tareas, mientras que Notas sobre la prueba de rendimiento Flash del Gemini y el Guía comparativa de modelos de IA proporcionar contexto sobre los modelos cercanos. Para el acceso a múltiples modelos, consulta Suscripciones «todo en uno» de IA y Comparación de plataformas multimodelo.
Preguntas frecuentes
¿Cuánto cuesta el modelo Claude Opus 5.5?
La tarifa oficial de la API es de $4 por cada millón de tokens de entrada y de $20 por cada millón de tokens de salida. Las lecturas de caché cuestan $0,20 por cada millón de tokens, y las escrituras de caché cada 5 minutos cuestan $5 por cada millón de tokens.
¿Qué es la ventana de contexto Claude Opus 5.5?
La documentación de la plataforma Claude indica una ventana de contexto de 1 millón de tokens y una salida máxima de 128 000 tokens. Una ruta beta documentada por separado admite hasta 300 000 tokens de salida para los lotes de mensajes.
¿Es el Claude Opus 5.5 mejor que el Opus 5?
Anthropic presenta un menor coste por carga de trabajo típica y una salida más rápida, mientras que las evaluaciones independientes muestran buenos resultados en varias tareas antiguas. La magnitud de cualquier mejora en la calidad depende de la prueba de referencia, la configuración del esfuerzo, la indicación y la ruta.
¿Se puede «apagar» el pensamiento?
No. Según la documentación actual del modelo, el pensamiento adaptativo está siempre activado. Utiliza el parámetro de esfuerzo para controlar la profundidad del pensamiento, la latencia y el coste.
¿Demostraron las cinco tareas de la API su fiabilidad?
No. Las tarjetas muestran un comportamiento concreto y los límites de configuración, pero cinco tareas no permiten estimar una tasa de éxito general. Los problemas relacionados con el «techo de codificación» y la «ruta china» se recogen por separado.
¿Ha demostrado esta reseña la calidad china?
No. La ruta probada devolvió texto en chino ilegible, por lo que el resultado se ha registrado como un problema de codificación o de ruta, a la espera de que se vuelva a ejecutar la prueba con UTF-8 y se verifique el resultado.