GPT-6.1 Sol เป็นโมเดลที่สมดุลของ OpenAI สำหรับการเขียนโค้ดที่ซับซ้อน การใช้คอมพิวเตอร์ และงานระดับมืออาชีพ. ระบบนี้ยังคงรักษาหน้าต่างบริบท 1,050,000 โทเคน และขีดจำกัดผลลัพธ์ 128,000 โทเคน ของ GPT-6 Astra แต่ราคาของ Standard API ลดลงเหลือ $2 ต่อหนึ่งล้านโทเคนข้อมูลเข้า และ $10 ต่อหนึ่งล้านโทเคนผลลัพธ์ นั่นคือหนึ่งในห้าของอัตราค่าโทเคนปัจจุบันของ Astra การแลกเปลี่ยนนี้เรียบง่าย: Astra ยังคงเป็นผลิตภัณฑ์หลัก ส่วน Sol มุ่งเน้นที่จะมอบความสามารถเพียงพอให้กับทีมที่ให้ความสำคัญกับค่าใช้จ่ายต่องานที่เสร็จสิ้น.
คู่มือนี้แบ่งแยกสิ่งที่ เอกสาร OpenAI สำหรับ GPT-6.1 Sol จากสิ่งที่ผู้สร้างเนื้อหาอิสระสังเกตเห็นในการทดสอบเบื้องต้น นอกจากนี้ยังแสดงกฎการกำหนดราคาในบริบทที่ยาว ตัวอย่างค่าใช้จ่ายที่สมจริง รูปแบบ API Responses ที่ใช้งานได้จริง และวิธีปฏิบัติจริงในการเลือกระหว่าง Sol, Astra, Luna และ GPT-6 Sol รุ่นก่อนหน้า.
GPT-6.1 Sol คืออะไร?
GPT-6.1 Sol เป็นรุ่น Sol ที่ใหม่ที่สุดในตระกูล GPT-6 ของ OpenAI ตามคำอธิบายอย่างเป็นทางการ โมเดลนี้ถูกออกแบบมาสำหรับการเขียนโค้ดที่ซับซ้อน การใช้คอมพิวเตอร์ และงานระดับมืออาชีพ โดยมีประสิทธิภาพใกล้เคียงกับ Astra แต่ในราคาที่ต่ำกว่า ในลำดับชั้นของตระกูลนี้ Astra เป็นตัวเลือกที่มีประสิทธิภาพสูงสุด Luna เป็นตัวเลือกที่เน้นความประหยัด และ Sol เป็นตัวเลือกกลางสำหรับงานที่ยากพอที่จะต้องใช้การวิเคราะห์อย่างลึกซึ้ง แต่ทำบ่อยพอที่จะทำให้ต้นทุนต่อหน่วยเป็นปัจจัยสำคัญ.
รหัสแบบคือ gpt-6.1-sol. สตริงนั้นมีความสำคัญในการเรียก API, บันทึกการทดสอบ, บันทึกการเรียกเก็บเงิน และการกำหนดค่าการปรับใช้ ส่วนเวอร์ชันเก่า gpt-6-sol ยังคงเป็นรุ่นที่ต่างกัน แม้ราคาเข้าและออกที่ยังไม่ถูกเก็บไว้ในแคชจะตรงกันก็ตาม หน้าของ OpenAI สำหรับรุ่นเก่าตอนนี้ได้ชี้ให้ผู้อ่านไปยังรุ่นใหม่ ส่วนของเรา รีวิว GPT-6 Sol และข้อจำกัดของ API ให้ข้อมูลพื้นฐานทางประวัติศาสตร์.
เหตุผลที่ชัดเจนที่สุดที่ทำให้การอัปเดตนี้ควรได้รับความสนใจ ไม่ใช่เพียงตัวเลขบนตารางอันดับเดียว แต่เป็นการผสมผสานระหว่างหน้าต่างบริบทที่มีขนาดกว้างใหญ่ การสนับสนุนเครื่องมืออย่างกว้างขวาง ระดับความซับซ้อนในการวิเคราะห์ 5 ระดับ และราคาที่ดึงดูดให้ใช้งานได้กว้างขวางกว่า Astra โมเดลที่ประสิทธิภาพอาจอ่อนกว่าเล็กน้อย แต่มีราคาที่เข้าถึงได้พอที่จะใช้งานได้ในทุกขั้นตอนการร่างเอกสารอย่างจริงจัง การตรวจสอบโค้ด หรือกระบวนการทำงานหลายขั้นตอน สามารถสร้างมูลค่าได้มากกว่าโมเดลเรือธงที่สงวนไว้สำหรับโอกาสพิเศษเท่านั้น.
การจัดวางตำแหน่งนั้นยังต้องทดสอบดูว่าเหมาะสมกับงานของคุณหรือไม่ OpenAI’s คำแนะนำในการเลือกแบบจำลอง แนะนำอย่างชัดเจนให้เปรียบเทียบ Sol กับ Astra ในงานเดียวกัน กระบวนการทำงานของเอกสารทางกฎหมาย การปรับโครงสร้างใหม่ของรีโพซิทอรี ตัวแทนเบราว์เซอร์ และการนำเสนอในบอร์ด สามารถทดสอบความสามารถที่แตกต่างกันได้ ให้ถือว่าป้ายกำกับของโมเดลเป็นสมมติฐานเริ่มต้น จากนั้นวัดความถูกต้อง จำนวนการแก้ไข ความล่าช้า และค่าใช้จ่ายรวมต่อผลลัพธ์ที่ได้รับการยอมรับ.
ข้อมูลจำเพาะของ GPT-6.1 Sol
The แคตตาล็อกรุ่นอย่างเป็นทางการ แสดงรายการข้อมูลเข้าแบบข้อความและภาพ พร้อมผลลัพธ์เป็นข้อความ โมเดลนี้ไม่รองรับข้อมูลเข้าหรือผลลัพธ์แบบเสียงและวิดีโอ การแยกประเภทนี้มีประโยชน์ในการออกแบบผลิตภัณฑ์: คุณสามารถส่งภาพหน้าจอ แผนภาพ หน้าหนังสือที่สแกน หรือภาพอื่น ๆ ได้ แต่การแปลงเสียงเป็นข้อความและการวิเคราะห์วิดีโอจำเป็นต้องใช้ส่วนประกอบหรือเครื่องมือแยกต่างหาก.
ขนาดข้อมูลเข้าสูงสุดของมันต่ำกว่าหน้าต่างบริบทของหัวข้อหลัก เนื่องจากผลลัพธ์และการประมวลผลภายในจำเป็นต้องมีพื้นที่ภายในงบประมาณรวม ขีดจำกัดผลลัพธ์ที่ 128,000 โทเคนนั้นถือว่ากว้างขวาง แต่การขอคำตอบที่มีขนาดใหญ่มากมักไม่ใช่การออกแบบที่ดีที่สุด ผลลัพธ์ที่ยาวมีค่าใช้จ่ายสูง ใช้เวลานานกว่าในการตรวจสอบ และอาจเกิดการเบี่ยงเบน สำหรับงานซอฟต์แวร์ส่วนใหญ่ ผลลัพธ์ที่มีโครงสร้างขนาดเล็กพร้อมจุดตรวจสอบจะตรวจสอบความถูกต้องได้ง่ายกว่า.
การสนับสนุนในการใช้เหตุผล ต่ำ, ปานกลาง, สูง, xสูง, และ max; ค่าเริ่มต้นคือ medium. The ไม่มี และ น้อยที่สุด การตั้งค่าดังกล่าวไม่สามารถใช้งานได้ ให้ใช้ความพยายามน้อยลงสำหรับการแปลงข้อมูลตามปกติ และเพิ่มระดับความพยายามขึ้นเฉพาะเมื่อค่าใช้จ่ายจากข้อผิดพลาดหรือความซับซ้อนของงานนั้นทำให้การใช้โทเคนและเวลาเพิ่มเติมเป็นสิ่งที่สมเหตุสมผล เป้าหมายในทางปฏิบัติคือการตั้งค่าที่เบาที่สุดที่ยังคงผ่านการทดสอบการยอมรับได้.
ผู้พัฒนาที่ต้องการเปรียบเทียบราคาและพฤติกรรมของโทเคนในอดีตสามารถใช้เครื่องมือของเราได้ ตัวอย่างราคาและค่าใช้จ่ายของ GPT-6 Sol เพื่อใช้เป็นจุดอ้างอิง การเปลี่ยนแปลงหลักในข้อกำหนดไม่ใช่ขนาดของบริบท ซึ่งยังคงสอดคล้องกันในทุกโมเดล GPT-6 ที่กล่าวถึงในบทความนี้ แต่เป็นการปรับปรุงตำแหน่งของ Sol รุ่นใหม่ และข้อมูลเข้าที่เก็บไว้ในแคชซึ่งมีต้นทุนต่ำกว่า.
ประสิทธิภาพ: สิ่งที่หลักฐานอย่างเป็นทางการแสดงให้เห็น
ตามคำอธิบายในการเปิดตัว OpenAI ระบุว่า GPT-6.1 Sol มีประสิทธิภาพที่ดีขึ้นอย่างมีนัยสำคัญเมื่อเทียบกับ GPT-6 Sol ในงานมืออาชีพที่ซับซ้อน เช่น การเขียนและแก้ไขข้อผิดพลาดในโค้ด การเข้าใจเอกสาร และการดำเนินการตามขั้นตอนการทำงานทางธุรกิจหลายขั้นตอน บริษัทระบุว่า GPT-6 Astra มีผลการประเมินที่ใกล้เคียงกันในหลายด้าน แต่ด้วยต้นทุนที่ต่ำกว่า นี่เป็นคำกล่าวอ้างผลการประเมินอย่างเป็นทางการ ไม่ใช่การรับประกันว่าทุกคำสั่งจะให้ผลลัพธ์ที่ใกล้เคียงกับ Astra.
The ส่วนเสริมของบัตรระบบสุริยะ GPT-6.1 กำหนดขอบเขตสำคัญ: การประเมินถูกดำเนินการในสภาพแวดล้อมการวิจัยของ OpenAI หรือผ่าน API ส่วน ChatGPT ในสภาพแวดล้อมการผลิตอาจมีความแตกต่าง เนื่องจากข้อความแจ้งเตือนของระบบ เครื่องมือที่มีอยู่ และการตั้งค่าความพยายามไม่เหมือนกัน นี่คือเหตุผลที่บทความที่มีคุณภาพควรแยกหลักฐานการทดสอบประสิทธิภาพอย่างเป็นทางการออกจากผลการทดสอบของผู้สร้าง และจากการประเมินภายในของบริษัท.
ตัวอย่างที่ชัดเจนหนึ่งคือ HealthBench ในตารางที่เผยแพร่ GPT-6.1 Sol ได้คะแนนที่ปรับตามความยาวอยู่ที่ 64.2 สำหรับ HealthBench Professional, 58.5 สำหรับ HealthBench, 36.2 สำหรับ HealthBench Hard และ 96.0 สำหรับ HealthBench Consensus. คะแนนของ Astra ที่สอดคล้องกันคือ 64.7, 58.3, 36.6 และ 95.5 OpenAI อธิบายว่าโมเดลเหล่านี้มีผลต่างไม่เกิน 0.5 จุดเปอร์เซ็นต์ในการประเมินทั้งสี่ครั้งดังกล่าว.
ผลลัพธ์ดังกล่าวสนับสนุนคำกล่าว “ใกล้กับ Astra” ในกลุ่มการประเมินนั้น แต่ไม่ได้พิสูจน์ว่าคุณภาพการวิศวกรรมซอฟต์แวร์ ความน่าเชื่อถือของเบราว์เซอร์ หรือรูปแบบผลลัพธ์จะเท่ากัน การวัดประสิทธิภาพด้านสุขภาพนั้นวัดความสามารถที่แตกต่างจากการแก้ไขภาวะการแข่งขัน (race condition) หรือการประสานงานระหว่างเครื่องมือ สำหรับการวิเคราะห์อย่างลึกซึ้งเกี่ยวกับโปรไฟล์การทดสอบที่กว้างขึ้นของรุ่นเรือธง โปรดดูที่ รีวิวและทดสอบจริง GPT-6 Astra.
การตีความในทางปฏิบัติที่แข็งแกร่งที่สุดนั้นเป็นแบบมีเงื่อนไข: GPT-6.1 Sol ควรอยู่ในกลุ่มผู้สมัครสำหรับงานที่ต้องการความพยายามสูง โดยเฉพาะเมื่อราคาของ Astra อาจจำกัดการใช้งาน มันสมควรได้รับการประเมินแบบเปรียบเทียบโดยตรง ไม่ใช่การเลื่อนขั้นอัตโนมัติ วัดอัตราการผ่านเกณฑ์ จำนวนการแก้ไขโดยมนุษย์ ข้อผิดพลาดของเครื่องมือ จำนวนโทเคนผลลัพธ์ และเวลาที่ใช้จนได้ผลลัพธ์ที่ได้รับการยอมรับ ตัวชี้วัดเหล่านี้จะเปลี่ยนการเปรียบเทียบโมเดลให้กลายเป็นการตัดสินใจทางธุรกิจ.
การเขียนโค้ด: GPT-6.1 Sol สามารถทำอะไรได้บ้าง
GPT-6.1 Sol มีองค์ประกอบพื้นฐานที่คาดหวังจากโมเดลการเขียนโค้ดสมัยใหม่ ได้แก่ การสตรีมมิ่ง ผลลัพธ์ที่มีโครงสร้าง การเรียกใช้ฟังก์ชัน การค้นหาไฟล์ การรับข้อมูลภาพ การค้นหาบนเว็บ และการเก็บแคชคำสั่ง ผ่าน API Responses, OpenAI ยังระบุถึงตัวแปลโค้ด, เชลล์ที่โฮสต์, การประยุกต์ใช้แพตช์, ทักษะ, การใช้คอมพิวเตอร์, MCP และการค้นหาเครื่องมือ ซึ่งทำให้โมเดลนี้เหมาะสำหรับกระบวนการทำงานที่ตรวจสอบไฟล์, เสนอการเปลี่ยนแปลง, ดำเนินการคำสั่ง และส่งคืนผลลัพธ์ที่ผ่านการตรวจสอบโดยเครื่อง.
การสนับสนุนความสามารถไม่ได้หมายความว่าทุกสภาพแวดล้อมจะเปิดเผยเครื่องมือทุกชนิดโดยอัตโนมัติ แอปพลิเคชันของคุณยังคงเป็นผู้ตัดสินใจว่าเครื่องมือใดมีอยู่ ได้รับสิทธิ์อะไรบ้าง ผลลัพธ์จะถูกส่งกลับไปยังโมเดลอย่างไร และการดำเนินการใดที่จำเป็นต้องได้รับการยืนยัน Chat Completions ทำงานได้กับ GPT-6.1 Sol โดยไม่ต้องเรียกใช้เครื่องมือ ในขณะที่ OpenAI จะนำแอปพลิเคชันที่ใช้เครื่องมือไปยัง Responses ระบบเอเจนต์ใหม่ควรมองขอบเขต API ดังกล่าวเป็นตัวเลือกทางสถาปัตยกรรม ไม่ใช่ความแตกต่างทางไวยากรณ์เพียงเล็กน้อย.
ณ เวลาที่เผยแพร่ คู่มือนี้ไม่ได้ระบุชื่อรุ่นที่แม่นยำในรายชื่อแชทของสถานที่ทดสอบ ดังนั้น คู่มือนี้จึงไม่อ้างว่าเป็นเกณฑ์มาตรฐานใหม่ของระบบสำหรับงานเขียนโค้ดทั้งสี่งานที่วางแผนไว้ การประเมินการเขียนโค้ดนี้อิงจากข้อมูลความสามารถอย่างเป็นทางการและผลการทดสอบสาธารณะที่ระบุชื่ออย่างชัดเจน ซึ่งมีความเป็นประโยชน์มากกว่าการแทนที่ Astra หรือ Sol รุ่นเก่าอย่างลับๆ แล้วติดชื่อรุ่นที่ผิดให้กับผลลัพธ์.
การประเมินที่ครบถ้วนควรรวมถึงการแก้ไขข้อผิดพลาดด้วยทดสอบการถดถอย (regression tests), คุณสมบัติหลายไฟล์ที่มีขอบเขตจำกัด, การตรวจสอบความปลอดภัย และการตัดสินใจด้านวิศวกรรมที่จำกัดโดยสคีมา งานเหล่านี้ไม่เพียงแต่ทดสอบการสร้างโค้ดเท่านั้น แต่ยังช่วยเปิดเผยว่าโมเดลนั้นรักษา API ไว้ได้หรือไม่, สามารถตรวจจับกรณีขอบได้หรือไม่, ปฏิบัติตามข้อจำกัดของผลลัพธ์หรือไม่ และระบุสิ่งที่โมเดลไม่สามารถตรวจสอบได้ ส่วนของเรา คู่มือเกี่ยวกับโมเดล AI ที่ดีที่สุดสำหรับการเขียนโค้ดในปี 2026 อธิบายว่าทำไมตัวเลือกที่ดีที่สุดจึงเปลี่ยนแปลงไปตามกระบวนการทำงาน.
ค้นหาข้อบกพร่องที่เล็กที่สุด รักษา API ให้คงเดิม และเพิ่มการทดสอบที่สามารถรันได้.
ให้คำนึงถึงการทำงานพร้อมกัน ลำดับการดำเนินการ การตรวจสอบความถูกต้อง และพฤติกรรมเมื่อเกิดข้อผิดพลาด.
จัดลำดับความสำคัญของช่องโหว่ ให้การแก้ไขเบื้องต้น และหลีกเลี่ยงการอ้างอิงถึงเฟรมเวิร์กที่สร้างขึ้นเอง.
เมื่อคุณรันคำสั่งแบบนี้ ให้ประเมินผลลัพธ์อย่างอัตโนมัติ: ผลลัพธ์เป็นศูนย์อยู่หรือไม่? ข้อมูลซ้ำถูกลบออกแล้วหรือไม่? การเรียงลำดับตามค่าตัวเลขถูกต้องหรือไม่? การทดสอบทำงานได้หรือไม่ node --test? การอธิบายที่เรียบเรียงอย่างประณีตไม่สามารถชดเชยข้ออ้างที่ผิดพลาดได้ หลักการเดียวกันนี้ใช้กับงานในรีโพซิทอรีด้วย: กำหนดเงื่อนไขการยอมรับก่อนที่จะเลือกโมเดล แล้วตรวจสอบแพตช์แทนที่จะตรวจสอบความน่าเชื่อถือของข้อความ.
ราคา GPT-6.1 Sol
The หน้ากำหนดราคา API อย่างเป็นทางการ วัดอัตรา Sol ของ GPT-6.1 ต่อหนึ่งล้านโทเคน ค่าใช้จ่ายในการป้อนข้อมูลคือ $2 ค่าใช้จ่ายในการป้อนข้อมูลที่เก็บในแคชคือ $0.10 ค่าใช้จ่ายในการเขียนข้อมูลลงแคชคือ $2.50 และค่าใช้จ่ายในการส่งออกข้อมูลคือ $10. ดังนั้น ค่าการป้อนข้อมูลที่เก็บในแคชจึงเท่ากับ 5% ของอัตราค่าการป้อนข้อมูลที่ไม่เก็บในแคช ส่วนค่าการเขียนเนื้อหาใหม่ลงในแคชมีค่าใช้จ่ายเท่ากับ 1.25 เท่าของค่าการป้อนข้อมูลปกติ ค่าธรรมเนียมเฉพาะเครื่องมือสามารถเพิ่มได้แยกต่างหาก ดังนั้น การคำนวณค่าโทเคนจึงเป็นเพียงส่วนหนึ่งของภาระงานที่ใช้เครื่องมือเท่านั้น.
รายละเอียดการกำหนดราคาที่สำคัญที่สุดคือขีดจำกัด 272K เมื่อปริมาณข้อมูลเข้าเกิน 272,000 โทเคน คำขอทั้งหมดจะเปลี่ยนไปใช้อัตราข้อมูลเข้าและแคชเป็นสองเท่า และอัตราข้อมูลออกเป็น 1.5 เท่า นี่ไม่ใช่ค่าธรรมเนียมเพิ่มเติมแบบขอบเขตที่นำไปใช้เฉพาะกับโทเคนที่เกินขีดจำกัดเท่านั้น แอปพลิเคชันที่มักอยู่ใกล้ขีดจำกัดนี้ควรนับจำนวนโทเคนก่อนส่ง และพิจารณาการแบ่งเป็นชิ้น (chunking), การเรียกข้อมูล (retrieval) หรือการบีบอัด (compaction).
โหมด Fast มีราคาสูงเป็นสองเท่าของราคา Standard โหมด Batch และ Flex ลดราคา Standard ลง 50% ส่วนการประมวลผลตามภูมิภาคจะเพิ่มค่าพรีเมียม 10% ในพื้นที่ที่มีบริการ โหมดต่าง ๆ เหล่านี้แก้ปัญหาที่แตกต่างกัน: โหมด Fast ชดเชยความล่าช้าด้วยค่าใช้จ่าย โหมด Batch แลกความทันทีกับค่าใช้จ่าย โหมด Flex แลกความคาดการณ์ได้ของกำหนดเวลาการประมวลผลกับค่าใช้จ่าย และการประมวลผลระดับภูมิภาคตอบสนองความต้องการด้านตำแหน่งข้อมูล อย่าเปรียบเทียบราคาของโหมดต่าง ๆ โดยไม่พิจารณาข้อจำกัดในการดำเนินงานของแต่ละโหมด.
ราคา Standard ของ Astra คือ $10 สำหรับการป้อนข้อมูล และ $50 สำหรับการส่งออก ต่อหนึ่งล้านโทเคน ซึ่งเท่ากับ 5 เท่าของอัตราหลักของ Sol. The ราคาและขีดจำกัดโทเค็นของ GPT-6 Astra API คู่มือนี้วิเคราะห์ส่วนต่างราคาดังกล่าวอย่างละเอียดยิ่งขึ้น Sol และ GPT-6 Sol รุ่นก่อนมีราคาอินพุตและเอาต์พุตที่ไม่ถูกเก็บในแคชเท่ากัน แต่ GPT-6.1 Sol ได้ลดราคาอินพุตที่ถูกเก็บในแคชจาก $0.20 เป็น $0.10 ต่อหนึ่งล้านโทเคน.
ตัวอย่างค่าใช้จ่ายจริง
ราคาโทเคนจะประเมินได้ง่ายขึ้นเมื่อแปลงเป็นคำขอที่สมบูรณ์ ตัวอย่างด้านล่างนี้ใช้การประมวลผลแบบมาตรฐาน ไม่มีค่าธรรมเนียมการเรียกใช้เครื่องมือ ไม่มีค่าพรีเมียมตามภูมิภาค และไม่มีการใช้ข้อมูลที่เก็บไว้ในแคช เว้นแต่จะระบุไว้เป็นอย่างอื่น ความยาวของผลลัพธ์จริงมักส่งผลให้ค่าใช้จ่ายสูงกว่าที่นักพัฒนาคาดไว้ เนื่องจากค่าใช้จ่ายในการสร้างผลลัพธ์บน GPT-6.1 Sol สูงกว่าค่าใช้จ่ายในการรับข้อมูลปกติถึงห้าเท่า.
สำหรับการตรวจสอบโค้ดที่มีข้อมูลเข้า 100K และข้อมูลออก 5K ค่าใช้จ่ายของข้อมูลเข้าคือ $0.20 และค่าใช้จ่ายของข้อมูลออกคือ $0.05 ซึ่งให้ค่าประมาณ $0.25 หากข้อมูลเข้าทั้งหมด 100K ได้รับการจัดเก็บในแคช ส่วนข้อมูลเข้าจะลดลงเหลือ $0.01 และค่ารวมจะกลายเป็น $0.06 หากแอปพลิเคชันต้องเขียนส่วน prefix 100K นั้นลงในแคชก่อน ส่วนการเขียนลงในแคชจะอยู่ที่ $0.25 ก่อนการส่งออก.
ตัวอย่างที่มีข้อมูลเข้า 300K ได้เกินขีดจำกัด การคิดค่าบริการสำหรับข้อมูลเข้าอยู่ที่อัตรา $4 ต่อหนึ่งล้าน ดังนั้น 300K จะมีค่าใช้จ่าย $1.20 ส่วนข้อมูลออกถูกคิดค่าบริการที่อัตรา $15 ต่อหนึ่งล้าน ดังนั้น 10K จะมีค่าใช้จ่าย $0.15 รวมเป็น $1.35 ดังนั้น คำขอที่เกินเกณฑ์เพียงเล็กน้อยอาจมีค่าใช้จ่ายสูงกว่าคำขอที่อยู่ต่ำกว่าเกณฑ์เล็กน้อยมาก แม้ยังไม่รวมค่าเครื่องมือ.
โหมด Batch หรือ Flex จะลดครึ่งหนึ่งของค่า Standard ที่ได้รับสิทธิ์ ส่วนโหมด Fast จะเพิ่มเป็นสองเท่า สำหรับตัวอย่างแรก นั่นหมายความว่าประมาณ $0.125 ในโหมด Batch หรือ Flex และ $0.50 ในโหมด Fast ทีมที่ยังใช้โมเดล GPT-5.6 รุ่นเก่าสามารถเปรียบเทียบสมมติฐานเหล่านั้นกับของเรา ราคา GPT-5.6 และเครดิต Codex การชำรุด.
วิธีใช้ GPT-6.1 Sol
วิธีพัฒนาที่เรียบง่ายที่สุดคือการใช้ Responses API ติดตั้ง SDK OpenAI เวอร์ชันล่าสุด กำหนดคีย์ API ผ่านสภาพแวดล้อมของคุณ และตั้งค่า แบบจำลอง ถึง gpt-6.1-sol. . คู่มืออย่างเป็นทางการสำหรับการสร้างข้อความ แนะนำให้ใช้ Responses สำหรับคำขอแบบโมเดลโดยตรง และหน้าโมเดลจำเป็นต้องใช้มันเพื่อเรียกใช้เครื่องมือ.
1. เริ่มด้วยคำขอ API Responses แบบธรรมดา
ให้คำขอแรกเป็นแบบเรียบง่าย ตรวจสอบให้แน่ใจว่า ID ของโมเดลที่ถูกต้องมีอยู่ในโครงการของคุณ จับข้อมูลโมเดลและฟิลด์การใช้งานที่ส่งกลับมา และเก็บข้อมูลเมตาดาต้าเพียงพอเพื่อสามารถทำซ้ำการรันได้ อย่าเริ่มต้นด้วยชุดเครื่องมือที่ซับซ้อน คำขอแบบเรียบง่ายจะช่วยแยกปัญหาการเข้าถึงโมเดลออกจากปัญหาที่เกี่ยวข้องกับการกำหนดเครื่องมือ สิทธิ์ และการจัดการ.
2. เพิ่มเครื่องมือได้เฉพาะผ่าน API Responses เท่านั้น
เมื่อกระบวนการทำงานต้องการการค้นหาไฟล์ การค้นหาบนเว็บ การดำเนินการโค้ด การเข้าถึงเชลล์ การใช้คอมพิวเตอร์ MCP หรือฟังก์ชันที่กำหนดเอง ให้กำหนดชุดเครื่องมือที่จำเป็นขั้นต่ำที่สุด จำกัดขอบเขตของไฟล์และเครือข่าย ตรวจสอบความถูกต้องของอาร์กิวเมนต์ของเครื่องมือ และตัดสินใจว่าการดำเนินการใดต้องการการยืนยันจากผู้ใช้ โมเดลสามารถเสนอและเรียกใช้เครื่องมือได้ แต่แอปพลิเคชันของคุณยังคงรับผิดชอบในการดำเนินการเครื่องมือเหล่านั้นและบังคับใช้สิทธิ์.
3. ปรับระดับความพยายามในการวิเคราะห์ให้สอดคล้องกับการประเมิน
เริ่มต้นด้วยระดับกลาง ซึ่งเป็นค่าเริ่มต้น ดำเนินการชุดข้อมูลประเมินที่เป็นตัวแทน แล้วเปรียบเทียบระดับต่ำ ระดับสูง หรือ xสูง กับอัตราการยอมรับ จำนวนโทเคนผลลัพธ์ ความล่าช้า และจำนวนการแก้ไข การใช้ระดับความพยายามสูงสุดอาจช่วยได้สำหรับงานที่ยากที่สุด แต่การใช้มันในทุกกรณีอาจทำให้ข้อได้เปรียบด้านต้นทุนที่ทำให้ Sol น่าสนใจหายไป ให้ใช้การตั้งค่าที่เบาที่สุดที่สามารถผ่านการประเมินได้อย่างน่าเชื่อถือ.
4. ใช้ GlobalGPT เพื่อเปรียบเทียบแบบโต้ตอบ
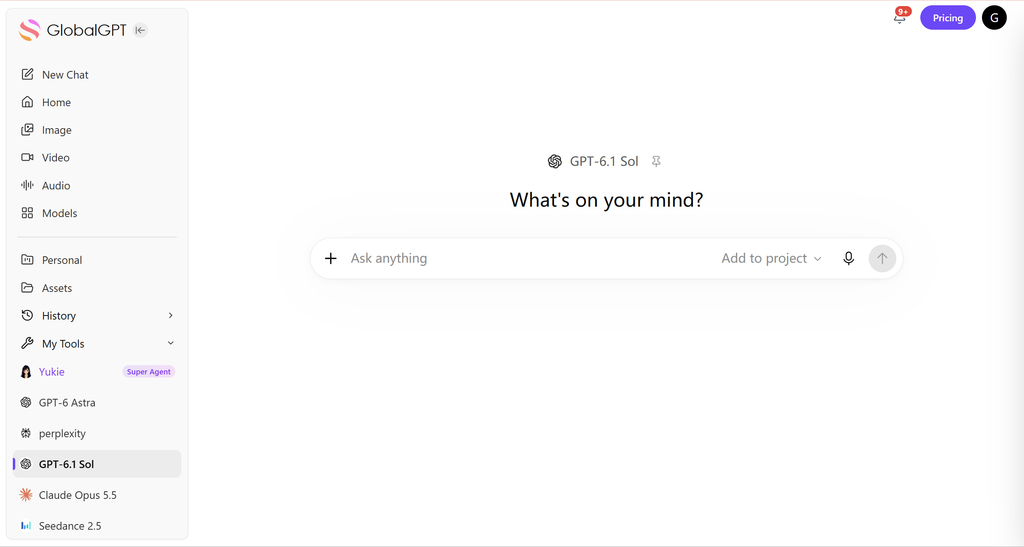
สำหรับงานแบบโต้ตอบ ให้เปิด พื้นที่ทำงานแบบหลายโมเดลของ GlobalGPT และเลือก GPT-6.1 Sol เมื่อมันปรากฏในตัวเลือกของบัญชีคุณ วิธีนี้มีประโยชน์สำหรับการเปรียบเทียบคำตอบโดยไม่ต้องเปิดแท็บหรือสมัครสมาชิกแยกกัน มันไม่แทนที่การควบคุมการปรับใช้ API การอัตโนมัติของรีโพสิตอรี Codex หรือ IDE คู่มือของเราเกี่ยวกับ ตัวเลือกแบบ ChatGPT สำหรับการเขียนโค้ด อธิบายความแตกต่างในกระบวนการทำงานดังกล่าว.
GPT-6.1 Sol เทียบกับ GPT-6 Sol, Astra และ Luna
ทั้งสี่โมเดลในการเปรียบเทียบนี้สามารถรับข้อความและภาพได้ ให้ผลลัพธ์เป็นข้อความ และกำหนดหน้าต่างบริบท (context window) ขนาด 1,050,000 โทเคน พร้อมปริมาณผลลัพธ์สูงสุด 128,000 โทเคน ความแตกต่างที่สำคัญอยู่ที่ตำแหน่ง ราคา วันที่ตัดรอบ การตั้งค่าการให้เหตุผล และระดับคุณภาพที่คุณสังเกตเห็นในการทำงานจริง ตารางนี้ใช้ราคาโทเคนมาตรฐานอย่างเป็นทางการล่าสุดที่ตรวจสอบเมื่อวันที่ 1 ตุลาคม 2026.
| แบบจำลอง | เหมาะสมที่สุด | อินพุต / 1M | เก็บไว้ในแคช / 1M | เอาต์พุต / 1 ล้าน | จุดตัด |
|---|---|---|---|---|---|
| GPT-6.1 Sol | งานที่ซับซ้อนพร้อมการควบคุมค่าใช้จ่าย | $2 | $0.10 | $10 | 30 เมษายน 2026 |
| GPT-6 Astra | งานที่เน้นคุณภาพเป็นอันดับแรกและมีความท้าทายสูงที่สุด | $10 | $1 | $50 | 30 เมษายน 2026 |
| GPT-6 Sol | การผสานระบบ Sol รุ่นเก่าที่มีอยู่ | $2 | $0.20 | $10 | 20 เมษายน 2026 |
| GPT-6 Luna | งานที่ต้องการความตั้งใจและปริมาณมาก | $0.10 | $0.01 | $0.50 | 18 พฤษภาคม 2569 |
เลือก Astra เมื่องานมีความยากพอที่การปรับปรุงคุณภาพเพียงเล็กน้อยก็สามารถป้องกันการต้องทำใหม่โดยมนุษย์ซึ่งมีค่าใช้จ่ายสูงได้ เลือก GPT-6.1 Sol เมื่องานยังคงซับซ้อนแต่ทำบ่อยๆ โดยเฉพาะอย่างยิ่งหากการลดค่าใช้จ่ายจากข้อมูลที่เก็บไว้ในแคชช่วยได้ เลือก Luna เมื่อปริมาณงานและความล่าช้าเป็นปัจจัยหลัก และขอบเขตงานถูกกำหนดไว้อย่างชัดเจน ใช้ Sol เวอร์ชันเก่าต่อไปเฉพาะในกรณีที่ความเสี่ยงในการย้ายระบบ การประเมินที่มีอยู่ หรือปัญหาความเข้ากันได้ ทำให้การเปลี่ยนระบบทันทีไม่น่าสนใจ.
ความแตกต่างของราคาระหว่าง Sol และ Astra ที่ถึง 5 เท่านั้นถือว่าสูงมาก แต่ราคาต่อโทเคนนั้นไม่เท่ากันกับราคาต่อผลลัพธ์ที่ได้รับการยอมรับ โมเดลที่มีประสิทธิภาพสูงกว่าอาจใช้โทเคนผลลัพธ์น้อยลง เรียกใช้เครื่องมือน้อยลง หรือต้องการการแก้ไขน้อยลง ในทางกลับกัน Sol อาจชนะได้แม้จะมีการแก้ไขเพิ่มเติมหนึ่งครั้ง หากราคาต่อหน่วยของ Astra สามารถชดเชยความแตกต่างนั้นได้ ควรเปรียบเทียบรอยทางงานที่เสร็จสมบูรณ์ แทนที่จะคูณความยาวของพรอมต์เพียงครั้งเดียว.
ผู้อ่านที่กำลังพิจารณาว่าการอัปเกรดจากรุ่นหลักนั้นคุ้มค่าหรือไม่ สามารถใช้ การเปรียบเทียบระหว่าง GPT-6 Astra และ GPT-5.6 Sol เพื่อดูบริบทของระดับก่อนหน้า สำหรับสายผลิตภัณฑ์ที่มีต้นทุนต่ำที่สุดในตระกูลปัจจุบัน, รีวิว GPT-6 Luna และวิธีใช้งานที่ดีที่สุด ให้ทราบขีดจำกัดของ API ที่เกี่ยวข้องและความเหมาะสมกับปริมาณงาน.
ความคิดเห็นจากผู้รีวิว
OpenAI ได้เปิดตัว GPT-6.1 Sol ในงาน DevDay เมื่อวันที่ 29 กันยายน 2569 พร้อมกับผลิตภัณฑ์อื่นๆ ที่เปิดตัวในวันเดียวกัน วิดีโออย่างเป็นทางการดังกล่าวระบุช่วงเวลาการเปิดตัวและตำแหน่งทางการตลาด แต่ไม่ใช่หลักฐานที่เป็นอิสระ ส่วนปฏิกิริยาจากภายนอกที่มีประโยชน์นั้นมาจากผู้สร้างเนื้อหา ซึ่งเปิดเผยรายละเอียดเกี่ยวกับงานที่ทดสอบ ชุดข้อมูลเปรียบเทียบ วิธีการคำนวณค่าใช้จ่าย และข้อผิดพลาด แทนที่จะเพียงแต่ซ้ำคำพูดจากงานเปิดตัว.
มันเขียนโค้ดได้ไหม? รายงานว่า Sol ทำงานได้เร็วกว่าและประหยัดทรัพยากรมากกว่าในการเปรียบเทียบระหว่าง Blender และ Godot ที่ดำเนินการ 3 รอบ แต่ระบุว่าคุณภาพเกมลดลงตามจำนวนรอบ.
แมตต์ จอนสตัน รายงานคะแนนถ่วงน้ำหนัก 96 และค่าใช้จ่ายชุด $2.63 ในระบบทดสอบ 9 ครั้งของเขา พร้อมทั้งระบุอย่างชัดเจนว่าภารกิจเพนกวินนั้นล้มเหลว.
ดันแคน โรโกฟ ได้เปรียบเทียบ Sol กับ Sonnet 5.5 ในหกเวอร์ชันการพัฒนา และติดตามเวลา โทเคน และค่าใช้จ่ายสุดท้าย.
ใน วิดีโอ 3 รอบของ ’Can It Code?’, งานได้พัฒนาจากชุดดันเจียนแบบโลว์โพลีใน Blender ไปสู่การสร้างตัวละครและแอนิเมชัน และสุดท้ายเป็นเกม Godot ที่สามารถเล่นได้ ผู้สร้างประมาณเวลาที่ใช้สำหรับ Sol ในทุกรอบอยู่ที่ $29.17 และ 7 ชั่วโมง 5 นาที ซึ่งต่ำกว่าการทดสอบเปรียบเทียบอย่างมาก แต่ประเมินว่าเกมสุดท้ายไม่น่าพอใจ และระบุว่า Sol แย่ลงในแต่ละรอบ ข้อสรุปคือเรื่องค่าใช้จ่ายและความเร็ว พร้อมคำเตือนเกี่ยวกับคุณภาพ ไม่ใช่การจัดอันดับโดยรวม.
บทวิจารณ์ 9 นัดของแมตต์ จอนสตัน รายงานคะแนนถ่วงน้ำหนัก 96 ซึ่งเท่ากันกับ Sonnet 5.5 ในตาราง Stonelabs ของเขา และค่าใช้จ่ายชุด $2.63 เทียบกับประมาณ $14 สำหรับ Astra และ $12 สำหรับ Opus 5.5 เขายังชี้ให้เห็นถึงข้อผิดพลาดในภารกิจเพนกวินด้วย ตัวเลขเหล่านี้เป็นส่วนหนึ่งของการออกแบบมาตรฐานและการคำนวณต้นทุนของเขา ซึ่งควรได้รับการตรวจสอบและยืนยันความถูกต้องก่อนที่จะนำไปใช้ในการจัดซื้อ.
การเปรียบเทียบหกแบบของดันแคน โรโกฟ รวมถึงหน้าแลนดิ้งเพจ เกม 3D บนเบราว์เซอร์ ฉากใน Blender วิดีโออธิบายแบบโต้ตอบ และชุดนำเสนอสำหรับนักลงทุน คำอธิบายสาธารณะระบุว่า การทดสอบนี้ติดตามเวลาการสร้าง การใช้โทเคน และค่าใช้จ่ายสุดท้าย จนกว่าผลการทดสอบที่ครบถ้วนและชัดเจนจะได้รับการตรวจสอบ คู่มือนี้จึงใช้วิดีโอดังกล่าวเป็นหลักฐานของวิธีการเปรียบเทียบในทางปฏิบัติ ไม่ใช่หลักฐานที่แสดงว่าโมเดลใดชนะ.
บทวิจารณ์เบื้องต้นเหล่านี้เห็นพ้องกันในคำถามที่มีประโยชน์หนึ่งข้อ: ราคาที่ต่ำของ Sol จะยังคงอยู่ได้หรือไม่เมื่อนำไปใช้ในโครงการที่สมบูรณ์? คำตอบของพวกเขาขึ้นอยู่กับแต่ละงาน ผู้สร้างคนหนึ่งเห็นความคุ้มค่าด้านต้นทุนที่โดดเด่น แต่คุณภาพเกมสุดท้ายกลับด้อยลง; อีกคนหนึ่งรายงานว่าได้คะแนนสูงและต้นทุนชุดเครื่องมือต่ำ; ส่วนคนที่สามได้ออกแบบเกมแบบแข่งขันตัวต่อตัวที่มีขอบเขตกว้าง ความหลากหลายนี้ให้ข้อมูลที่มีประโยชน์มากกว่าประโยคสรุปที่สร้างขึ้นจากความเห็นร่วม.
ใครควรใช้ GPT-6.1 Sol?
GPT-6.1 Sol เหมาะสำหรับทีมที่มีงานที่มีความหมายและวงจรการประเมินอยู่แล้ว มันมีความน่าสนใจเป็นพิเศษเมื่อบริบทขนาดใหญ่เดียวกันถูกนำกลับมาใช้ซ้ำผ่านการเก็บแคชคำสั่ง (prompt caching) เมื่อการปรับใช้ Astra มีค่าใช้จ่ายสูงเกินไปสำหรับการขยายขนาด หรือเมื่อ Luna ไม่ให้ความลึกเพียงพอสำหรับงานนั้น โมเดลนี้อาจไม่ดึงดูดเท่าที่ควร หากงานการสกัดข้อมูลหรือการจัดประเภทแบบเบาๆ ทำงานได้อย่างน่าเชื่อถืออยู่แล้วบนระดับราคาที่ถูกกว่า.
- การเขียนโค้ดในระดับรีโพสิตอรี
- ผลงานมืออาชีพที่ซับซ้อน
- การตรวจสอบบริบทยาวพร้อมการเก็บไว้ในแคช
- ขั้นตอนการทำงานที่ใช้เครื่องมือร่วมกับ evals
- การตัดสินใจที่มีความสำคัญต่อความปลอดภัย
- งานที่ความผิดพลาดอาจก่อให้เกิดความสูญเสียอย่างรุนแรง
- ทำงานใกล้ระดับ 272K
- การไหลที่ไวต่อความล่าช้า
- การติดแท็กแบบง่ายๆ
- การแปลงแบบกำหนดค่าสั้น
- การสกัดปริมาณมาก ความเสี่ยงต่ำ
- งานที่ Luna ได้แก้ไขแล้ว
ทีมพัฒนาซอฟต์แวร์ควรพิจารณาใช้ Sol เมื่อต้องการโมเดลเพื่อวิเคราะห์ข้อมูลจากหลายไฟล์ สร้างการทดสอบ ตรวจสอบปัญหาด้านความปลอดภัย หรือดำเนินการเครื่องมือภายใต้การกำกับดูแล นักวิเคราะห์สามารถใช้ Sol สำหรับการสังเคราะห์เอกสารหลายฉบับและผลลัพธ์ที่มีโครงสร้าง ส่วนทีมปฏิบัติการสามารถใช้ Sol สำหรับกระบวนการทำงานที่รวมข้อมูล กฎ และบริบททางธุรกิจ ในทุกกรณี กระบวนการทำงานดังกล่าวจำเป็นต้องมีเกณฑ์การยอมรับที่ชัดเจน และขั้นตอนการตรวจสอบโดยมนุษย์หรือระบบอัตโนมัติ.
ผู้ใช้เดี่ยวและทีมขนาดเล็กอาจชอบใช้พื้นที่ทำงานแบบหลายโมเดลที่มีปฏิสัมพันธ์กัน ก่อนที่จะสร้างการบูรณาการ API ซึ่งช่วยให้การเปรียบเทียบระหว่าง Sol และ Astra เป็นรูปธรรมได้ โดยไม่ต้องกำหนดโครงสร้างสถาปัตยกรรมแอปพลิเคชันไว้ล่วงหน้า หากคุณยังกำลังตัดสินใจเลือกระหว่างผู้ให้บริการและรูปแบบต่าง ๆ คู่มือของเราเกี่ยวกับ การเลือกโมเดล AI ตามงาน เครื่องมือ และค่าใช้จ่าย ให้รายชื่อผู้เข้ารอบสุดท้ายที่กว้างขึ้น.
ขีดจำกัดและรูปแบบความล้มเหลว
หน้าต่างบริบทขนาดหนึ่งล้านโทเคนเป็นขีดความสามารถ ไม่ใช่ความจำที่สมบูรณ์แบบ คำสั่งสำคัญอาจถูกเจือจางโดยเอกสารที่มีข้อมูลรบกวน กฎที่ซ้ำซ้อน หรือหลักฐานที่ขัดแย้งกัน จัดโครงสร้างข้อมูลเข้าที่ยาว ระบุแหล่งข้อมูลที่น่าเชื่อถือ และขอให้โมเดลอ้างอิงไฟล์หรือส่วนข้อความที่เป็นพื้นฐานของข้อสรุปสำคัญ การดึงข้อมูลและการบีบอัดข้อมูลอาจให้ผลลัพธ์ที่ดีกว่าการส่งข้อมูลทั้งหมดในทุกครั้ง.
ขั้นตอนการกำหนดราคาตามบริบทที่ยาวเป็นความเสี่ยงประการที่สอง การส่งคำขอที่มีโทเคนอินพุต 273K จะถูกคิดค่าบริการตามอัตราที่สูงขึ้นสำหรับคำขอทั้งหมด ไม่ใช่เพียงโทเคน 1,000 ตัวสุดท้ายเท่านั้น สิ่งนี้อาจก่อให้เกิดค่าใช้จ่ายที่ไม่คาดคิดในแอปพลิเคชันที่สร้างบริบทแบบไดนามิก ให้เพิ่มการนับโทเคนและการตรวจสอบงบประมาณก่อนส่งคำขอ และบันทึกว่าเอกสารใดที่ทำให้การเรียกข้ามขีดจำกัด.
การใช้เครื่องมือจะขยายขีดความสามารถและพื้นที่เสี่ยงต่อการโจมตี ให้ถือว่าหน้าเว็บ ไฟล์ที่ดาวน์โหลดมา และผลลัพธ์จากเครื่องมือเป็นข้อมูลที่ไม่น่าเชื่อถือ ตรวจสอบความถูกต้องของอาร์กิวเมนต์ของฟังก์ชัน แยกการรันโค้ด จำกัดเส้นทางไฟล์และการเข้าถึงเครือข่าย และกำหนดให้ต้องยืนยันก่อนดำเนินการที่มีผลกระทบสูง การที่โมเดลนี้สนับสนุนการใช้เชลล์ที่โฮสต์หรือการใช้คอมพิวเตอร์ ไม่ควรเป็นเหตุผลในการให้สิทธิ์การเข้าถึงอย่างกว้างขวาง.
สุดท้ายนี้ การทดสอบผู้สร้างในขั้นต้นสามารถให้ข้อมูลที่เป็นประโยชน์ได้ แม้จะไม่ใช่ผลลัพธ์ที่แน่นอนก็ตาม การเปลี่ยนแปลงในคำสั่งระบบ เครื่องมือ โครงสร้างสนับสนุน ข้อจำกัดเวลา และเกณฑ์การให้คะแนน อาจทำให้ผลลัพธ์ที่ดูเหมือนผู้ชนะในตอนแรกกลับกลายเป็นผู้แพ้ได้ ดังนั้น ควรใช้การทดสอบสาธารณะเพื่อออกแบบระบบการประเมินของคุณเอง ไม่ใช่เพื่อหลีกเลี่ยงการประเมินนั้น โมเดลที่แสดงประสิทธิภาพยอดเยี่ยมในการสร้างเกมแบบภาพ อาจล้มเหลวในแผนการย้ายระบบของคุณ และในทางกลับกันก็เป็นไปได้เช่นกัน.
คำถามที่พบบ่อย
คำตอบเหล่านี้สรุปข้อมูลอย่างเป็นทางการเกี่ยวกับ API และจุดตัดสินใจในทางปฏิบัติที่ได้กล่าวถึงข้างต้น.
GPT-6.1 Sol คืออะไร?
GPT-6.1 Sol เป็นโมเดลการวิเคราะห์เหตุผลแบบ OpenAI ที่ออกแบบมาสำหรับการเขียนโค้ดที่ซับซ้อน การใช้คอมพิวเตอร์ และงานระดับมืออาชีพ ระดับ OpenAI วางตำแหน่งโมเดลนี้อยู่ระหว่างระดับ Luna ที่มีราคาต่ำ และระดับ Astra ซึ่งเป็นรุ่นเรือธง โดยมีความสามารถใกล้เคียงกับ Astra แต่มีราคา API ที่ต่ำกว่า.
GPT-6.1 Sol มีราคาเท่าไร?
ราคา API มาตรฐานคือ $2 ต่อหนึ่งล้านโทเคนข้อมูลเข้า, $0.10 ต่อหนึ่งล้านโทเคนข้อมูลเข้าที่เก็บในแคช, $2.50 ต่อหนึ่งล้านโทเคนที่เขียนเข้าแคช และ $10 ต่อหนึ่งล้านโทเคนข้อมูลออก คำสั่งที่ยาว โหมดเร็ว การประมวลผลตามภูมิภาค การประมวลผลแบบกลุ่ม และ Flex อาจส่งผลให้อัตราค่าบริการจริงเปลี่ยนแปลงได้.
หน้าต่างบริบทของ GPT-6.1 Sol คืออะไร?
OpenAI กำหนดหน้าต่างบริบท (context window) 1,050,000 โทเคน ปริมาณข้อมูลเข้าสูงสุด 922,000 โทเคน และปริมาณข้อมูลออกสูงสุด 128,000 โทเคน หน้าต่างที่ใหญ่ช่วยให้โมเดลสามารถวิเคราะห์ข้อมูลในปริมาณมากได้ แต่ไม่รับประกันการเรียกคืนข้อมูลที่สมบูรณ์แบบ หรือทำให้ทุกคำขอที่มีขนาดใหญ่เป็นไปอย่างประหยัด.
GPT-6.1 Sol เหมาะสำหรับการเขียนโค้ดหรือไม่?
ระบบนี้ได้รับการออกแบบมาเพื่อรองรับการเขียนโค้ดที่ซับซ้อน และสนับสนุนผลลัพธ์ที่มีโครงสร้าง การเรียกใช้ฟังก์ชัน ตัวแปลโค้ด เชลล์ที่โฮสต์ การติดตั้งแพตช์ ทักษะ MCP และเครื่องมืออื่น ๆ ผ่าน Responses API ทีมผลิตควรดำเนินการทดสอบเฉพาะรีโพสิตอรีต่อไป ก่อนที่จะเปลี่ยนเวิร์กโฟลว์ที่สำคัญ.
ควรใช้ GPT-6.1 Sol หรือ GPT-6 Astra ดีกว่า?
เลือก Sol เมื่อค่าใช้จ่ายเป็นปัจจัยสำคัญ และผลการประเมินของคุณเองแสดงให้เห็นว่ามันตรงตามมาตรฐานคุณภาพ เลือก Astra สำหรับงานที่ต้องการคุณภาพสูงสุด เมื่อคุณภาพที่เหนือกว่าเล็กน้อยคุ้มค่ากับอัตราค่าโทเคน Standard ที่สูงกว่าถึงห้าเท่า ทดสอบทั้งสองบนงานตัวอย่างที่เหมือนกันก่อนที่จะตัดสินใจ.
จะเกิดอะไรขึ้นเมื่อคำสั่งมีจำนวนโทเค็นอินพุตเกิน 272K?
OpenAI ระบุว่า เมื่อปริมาณข้อมูลเข้าเกิน 272K tokens คำขอทั้งหมดจะถูกคิดค่าตามอัตราข้อมูลเข้าและแคชสองเท่าของอัตราปกติ และอัตราข้อมูลออก 1.5 เท่าของอัตราปกติ การเปลี่ยนแปลงแบบขั้นบันไดนี้อาจมีความสำคัญมากกว่าขนาดหน้าต่างบริบทที่ระบุไว้ในหัวข้อหลัก ในแอปพลิเคชันที่ทำงานกับเอกสารยาว.
GPT-6.1 Sol รองรับ API Chat Completions หรือไม่?
ใช่, ฟีเจอร์ Chat Completions รองรับสำหรับคำขอที่ไม่มีการเรียกใช้เครื่องมือ OpenAI แนะนำให้ผู้พัฒนาใช้ Responses API สำหรับการเรียกใช้เครื่องมือ ดังนั้น แอปพลิเคชันใหม่ที่ทำงานแบบเอเจนต์หรือใช้เครื่องมือควรเริ่มต้นด้วย Responses แทนที่จะพึ่งพาอินเทอร์เฟซเวอร์ชันเก่า.
GPT-6.1 Sol สามารถรับภาพได้หรือไม่?
ใช่ครับ หน้าโมเดลอย่างเป็นทางการระบุไว้ว่าโมเดลนี้รองรับการป้อนข้อมูลแบบข้อความและรูปภาพ พร้อมทั้งให้ผลลัพธ์เป็นข้อความ ส่วนเสียงและวิดีโอไม่ได้รับการสนับสนุนเป็นรูปแบบข้อมูลของโมเดล แต่แอปพลิเคชันสามารถใช้บริการหรือเครื่องมืออื่น ๆ ที่เกี่ยวข้องกับโมเดลได้ เมื่อจำเป็นต้องใช้ประเภทสื่อดังกล่าว.
ฉันสามารถใช้ GPT-6.1 Sol บน GlobalGPT ได้อย่างไร?
เปิด GlobalGPT, เริ่มการสนทนาใหม่ และเลือก GPT-6.1 Sol เมื่อมันปรากฏในตัวเลือกรุ่น (model picker) ของบัญชีคุณ GlobalGPT เป็นพื้นที่ทำงานแบบหลายรุ่นที่สะดวกสบาย; กุญแจ API, การควบคุมการปรับใช้ และระบบอัตโนมัติของ repositories ยังคงเป็นกระบวนการทำงานของนักพัฒนาที่แยกกัน.
คำตัดสินสุดท้าย
GPT-6.1 Sol เป็นตัวเลือก GPT-6 ที่น่าสนใจที่สุดสำหรับผู้ซื้อที่ต้องการความสามารถในการวิเคราะห์และเขียนโค้ดอย่างจริงจัง แต่ไม่สามารถใช้ Astra ได้ในทุกครั้ง มันมีขีดจำกัดด้านบริบทและผลลัพธ์ที่เทียบเท่ากับ Astra ใช้ข้อมูลความรู้ที่ตัดวันที่ 30 เมษายน 2026 เช่นเดียวกัน และมีค่าใช้จ่ายเพียงหนึ่งในห้าต่อโทเคนข้อมูลเข้าและออกที่ไม่ได้เก็บไว้ในแคช ตามอัตรา Standard ส่วนส่วนลดสำหรับข้อมูลเข้าที่เก็บไว้ในแคชก็สูงกว่า GPT-6 Sol รุ่นก่อน.
รุ่นนี้ไม่ได้เป็นตัวเลือกที่ดีที่สุดโดยอัตโนมัติ Luna ยังคงมีราคาถูกกว่าอย่างชัดเจนสำหรับงานที่ต้องการความแม่นยำสูง ส่วน Astra อาจช่วยลดจำนวนการแก้ไขได้สำหรับงานที่ยากที่สุด การเปรียบเทียบที่ถูกต้องคือค่าใช้จ่ายรวมต่อผลลัพธ์ที่ได้รับการยอมรับ โดยวัดด้วยคำสั่ง เครื่องมือ ข้อมูล และกฎการให้คะแนนเดียวกัน เมื่อจำนวนโทเคนอินพุตเกิน 272K ให้พิจารณาตัวคูณราคาด้วยก่อนที่จะตัดสินใจ.
เปิด GlobalGPT, เลือก GPT-6.1 Sol เมื่อมีพร้อมใช้งาน และเปรียบเทียบกับ Astra หรือ Luna โดยใช้ภารกิจจริงหนึ่งรายการและรายการตรวจสอบการยอมรับหนึ่งรายการ.
เปิด GlobalGPTสำหรับการปรับใช้ API ให้เริ่มจากหน้าโมเดลอย่างเป็นทางการและคำขอ API Responses ขนาดเล็ก สำหรับการเปรียบเทียบแบบโต้ตอบ ให้ใช้เส้นทาง multi-model ข้างต้น ไม่ว่าจะใช้วิธีใดก็ตาม ให้เก็บรักษาผลลัพธ์ การใช้งาน การตั้งค่า และข้อผิดพลาดไว้ คำสัญญาของ GPT-6.1 Sol ไม่ใช่เพียงแค่โทเคนที่ราคาถูกกว่า แต่เป็นโอกาสที่ดีกว่าในการดำเนินการวิเคราะห์อย่างมีประสิทธิภาพบ่อยพอจนกลายเป็นส่วนหนึ่งของกระบวนการทำงาน.