Lors de nos tests du 7 juillet 2026, Claude Sonnet 5 s'est révélé être la meilleure première approche pour la révision de code, l'analyse des causes profondes, la planification architecturale et le raisonnement à long terme. Le modèle GPT-5.5 s'est révélé le meilleur choix en première étape lorsque vous avez besoin d'un projet d'implémentation complet, d'une structure de test exécutable ou d'exemples prêts à être copiés. Pour le travail au niveau du référentiel, comparez Claude Code avec Codex plutôt que de juger l'une ou l'autre entreprise uniquement à partir de la fenêtre de discussion.
La distinction utile ne se résume pas simplement à “ Claude l'emporte ” ou “ ChatGPT l'emporte ”. Au 27 septembre 2026, la gamme Anthropic comprend Claude Fable 5.1, Opus 5.5, Sonnet 5 et Haiku 4.5 ; la famille GPT-6 de OpenAI comprend Astra, Sol et Luna. L'accès aux produits est important : Sol et Luna ont été lancés dans ChatGPT Work, Codex et l'API, l'annonce excluant explicitement le Chat standard. Les sections pratiques ci-dessous constituent une comparaison désormais obsolète entre Claude Sonnet 5 et GPT-5.5, testées avec les mêmes invites le 7 juillet 2026. Pour une comparaison actuelle, voir Claude Opus 5.5 contre GPT-6 Sol.
Si vous souhaitez comparer différents modèles sans avoir à jongler entre plusieurs abonnements, GlobalGPT est un espace de travail multimodèle pratique intégrant GPT-6 Astra et Claude Opus 5,5 disponible dans son sélecteur de modèles. Il est utile pour comparer des solutions de codage, planifier, rédiger et effectuer des recherches, mais il ne remplace pas le code Claude, le Codex, les API officielles, un IDE ni un workflow de développement prenant en compte les dépôts.

Table des matières
- Claude contre ChatGPT pour la programmation : réponse rapide
- Qu'est-ce qui a changé en 2026 ?
- Gamme actuelle de modèles de codage
- Présentation des benchmarks : SWE-Bench, Terminal-Bench et leur signification
- Comment nous avons testé Claude et ChatGPT pour la programmation
- Test n° 1 : débogage et analyse des causes profondes
- Test n° 2 : refactorisation et facilité de maintenance
- Test n° 3 : raisonnement et planification portant sur plusieurs fichiers
- Test n° 4 : tests unitaires et vérification
- Test n° 5 : évaluation de la sécurité et de la fiabilité
- Claude Code et Codex : quand le chat ne suffit pas
- Tarifs : Claude, ChatGPT, Codex et GlobalGPT
- Quelle configuration de codage choisir ?
- Pourquoi de nombreux développeurs continuent-ils à utiliser les deux ?
- FAQ
Claude contre ChatGPT pour la programmation : réponse rapide
Lors de nos tests de chat réalisés le 7 juillet avec la même consigne, Claude Sonnet 5 s'est révélé plus performant lors de la première réponse lorsque le problème était ambigu : il a hiérarchisé les causes probables, fait le tri parmi les informations superflues et expliqué clairement les risques. Le modèle GPT-5.5 s’est révélé plus performant lorsque l’étape suivante consistait en un projet de mise en œuvre plus complet, comprenant des importations, une structure de test et davantage de détails sur le code. Ces observations concernent spécifiquement ce test et ne s’appliquent pas nécessairement à toutes les futures versions du modèle.
Pour le développement au quotidien, le meilleur processus de travail est généralement le suivant :
- Commence par utiliser Claude pour la révision du code, le tri des bogues, les décisions d'architecture et les questions du type “ par quoi dois-je commencer mon inspection ? ”.
- Commencez par utiliser ChatGPT pour créer une implémentation de départ, rédiger des structures de test, produire des exemples et transformer un projet en code.
- Utilisez les deux pour les migrations, les modifications ayant un impact sur la sécurité, les paiements, l'authentification, les téléchargements de fichiers et tout ce qui pourrait endommager les données de production.
| Besoin en programmation | Un meilleur premier choix | Pourquoi |
|---|---|---|
| Débogage d'un bug épineux | Claude d'abord | Lors de notre test, Claude a identifié la cause probable en priorité et a clairement expliqué le cheminement de la défaillance. |
| Rédaction d'un projet de mise en œuvre complet | ChatGPT d'abord | Lors de notre test, GPT-5.5 a fourni un code plus complet et des structures plus prêtes à l'emploi. |
| Analyse des risques liés à la sécurité ou à la fiabilité | Claude d'abord, puis ChatGPT | Claude a clairement hiérarchisé les niveaux de gravité ; ChatGPT a ajouté des modèles de mise en œuvre concrets. |
| Modification de fichiers dans un référentiel | Claude Code ou Codex | Le contexte du dépôt, l'exécution des commandes, les tests et les comparaisons sont plus importants qu'une simple réponse sous forme de discussion. |
Si votre question principale est de savoir quelle famille de modèles est la mieux adaptée au codage en général, la réponse plus générale est Le meilleur modèle d'IA pour le codage Cette comparaison constitue une lecture complémentaire utile. Si votre choix porte principalement sur l'écosystème OpenAI, le guide « Le meilleur modèle ChatGPT pour le codage » fournit davantage de détails sur la sélection des modèles GPT.
Ce qui a changé en 2026
Pour être pertinente, une comparaison portant sur l'année 2026 doit tenir compte de trois évolutions.
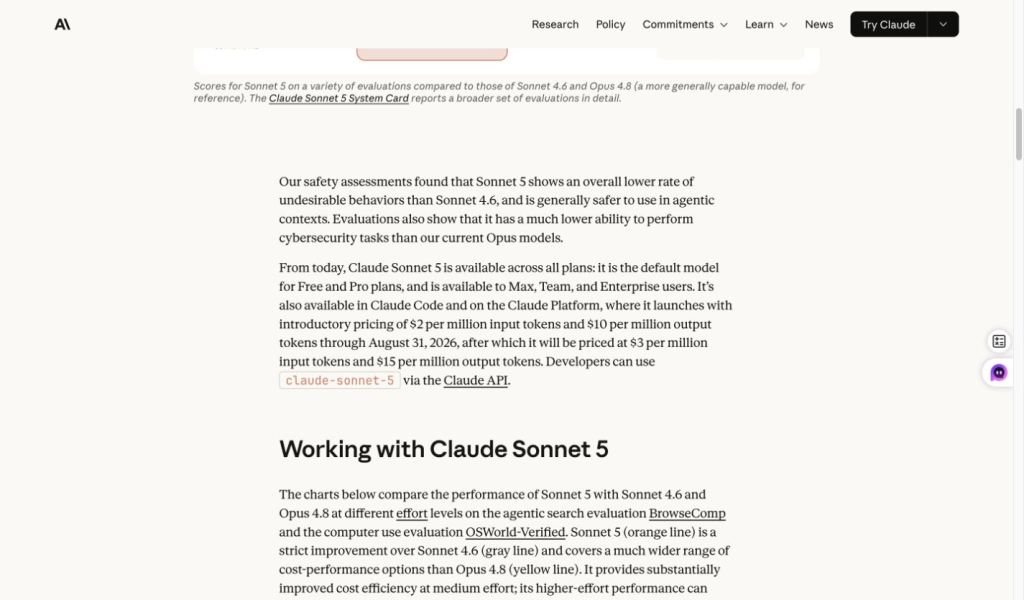
Tout d'abord, le « Claude Sonnet 5 » a modifié la partie de la décision concernant Claude. Anthropic indique que Sonnet 5 est disponible dans tous les forfaits et sous le code Claude, avec un accès à la plateforme Claude réservé aux développeurs. C'est important, car Claude n'est plus seulement un assistant de chat destiné à fournir des explications sur le codage ; il fait désormais partie intégrante du flux de travail de l'agent de codage de Anthropic.
Deuxièmement, GPT-6 constitue désormais la famille de modèles utilisée par OpenAI pour ses travaux de programmation. Astra se concentre sur l'ingénierie logicielle complexe ; Sol et Luna proposent des options plus abordables. Annonce de la sortie de OpenAI le 22 septembre mentionne Sol et Luna dans les versions ChatGPT Work et Codex pour les éditions Plus, Pro, Business, Enterprise et Edu ; Luna est également disponible pour les utilisateurs des éditions Free et Go dans l'application de bureau. Il est clairement indiqué que ces modèles ne sont pas encore disponibles dans Chat. L'accès à l'API est facturé séparément.
Troisièmement, les assistants de chat et les agents de programmation prennent en charge différentes parties du travail. Le chat simple est utile pour les extraits de code, le débogage, les explications et la planification. Code Claude et Codex Il s'agit de workflows intégrant la gestion des dépôts, conçus pour analyser des fichiers, exécuter des commandes, tester des modifications et intervenir dans le cadre de tâches plus vastes. Une comparaison équitable distingue la qualité des réponses fournies par l'assistant de chat des fonctionnalités du produit « coding-agent ».
Gamme actuelle de modèles de codage
Au 27 septembre 2026, la comparaison des codes relève d'un choix de composition d'équipe plutôt que d'un simple affrontement entre les formations Claude et ChatGPT :
| Côté | Modèles actuels à prendre en considération | Meilleure utilisation du code |
|---|---|---|
| Claude | Claude Fable 5,1, Claude Opus 5,5, Claude Sonnet 5 et Claude Haiku 4,5 | Révision à long terme, planification, débogage, programmation active et workflows de code Claude. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol et GPT-6 Luna ; la disponibilité varie selon les versions ChatGPT Work, Chat, Codex et API | Mise en œuvre, développement front-end, tests, workflows utilisant des outils et tâches liées au Codex. |
| GlobalGPT | GPT-6 Astra et Claude Opus 5.5, vérifié dans GlobalGPT ; il s'agit d'un abonnement distinct à la plateforme | Comparaison côte à côte de suggestions, questions quotidiennes sur le code, recherches et évaluation des approches. |
Si vous suivez les accès de Claude et les détails de son forfait, consultez le document séparé Les projets de Claude AI pour 2026 guide et le guide plus détaillé sur les tarifs de l'IA Claude. Si vous comparez les formules OpenAI, le détail des formules d'abonnement ChatGPT pour 2026 constitue un complément plus clair.
Présentation des benchmarks : SWE-Bench, Terminal-Bench et leur signification
Les benchmarks sont utiles car ils montrent comment les modèles se comportent dans des tâches de codage contrôlées. L'essentiel est de bien comprendre ce que chaque benchmark mesure réellement. Un benchmark issu d'un ticket de dépôt, un benchmark terminal-agent et un tableau officiel de lancement de modèles ne fournissent pas les mêmes informations ; ils doivent donc être utilisés en complément des tests pratiques présentés ci-dessous.
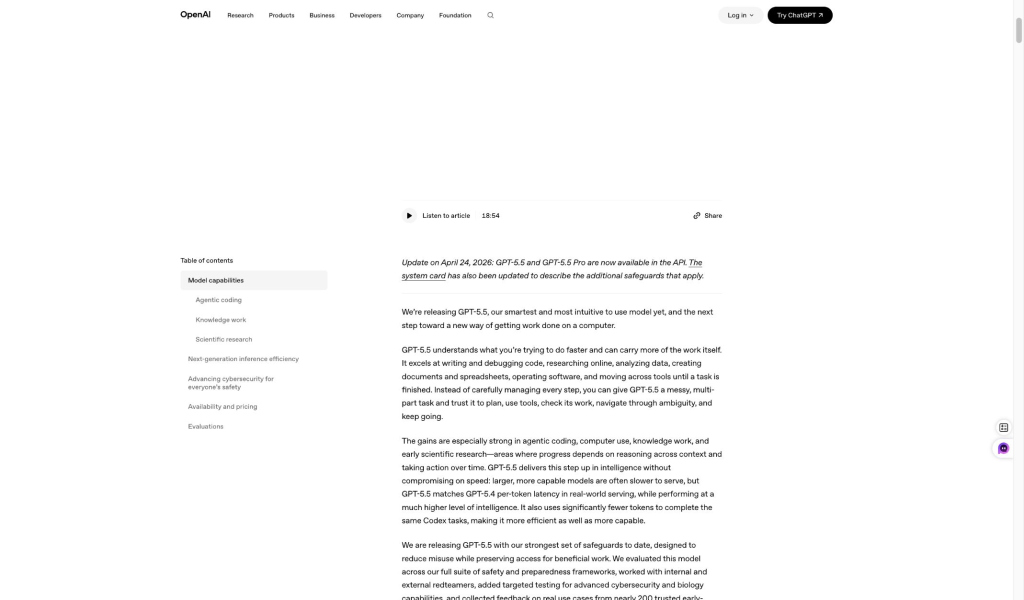
GPT-5.5 : Données de codage issues de la date de l'examen
Les informations ci-dessous concernant le modèle GPT-5.5 sont conservées car elles correspondent au modèle utilisé lors de la comparaison pratique du 7 juillet. Il corrobore les observations de la section de test, qui mettent l’accent sur les implémentations, mais ne doit pas être interprété comme la gamme actuelle de modèles OpenAI ; GPT-6 est désormais la famille active, dont l’accès varie entre ChatGPT Work, Chat standard, Codex et l’API.
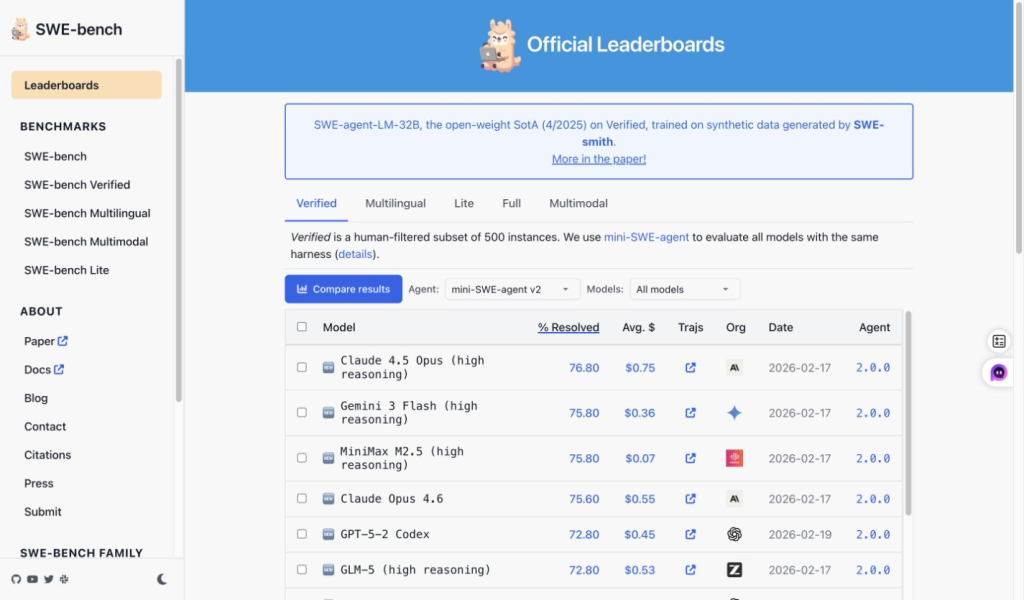
SWE-Bench : résolution des problèmes liés au référentiel
SWE-Bench est utile car il se rapproche davantage de la maintenance logicielle réelle qu’une simple invite sous forme de court extrait de code. Il examine les tickets du dépôt et détermine si un modèle est capable de proposer des modifications permettant de résoudre la tâche. Dans le cas de la comparaison entre Claude et ChatGPT, cela donne une indication sur les compétences en génie logiciel, mais cela ne dit pas tout sur la qualité des explications, le jugement porté lors de la révision ou le degré d’utilité perçu d’une réponse dans un flux de conversation.
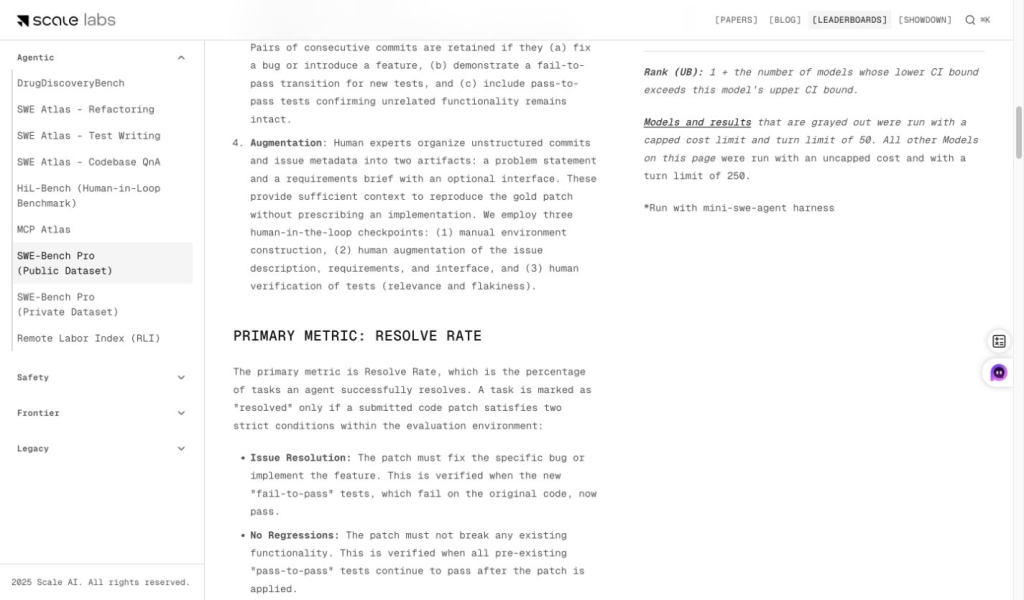
SWE-Bench Pro : tâches de programmation plus complexes et taux de résolution
Classement public SWE-Bench Pro de Scale Il s'agit d'un indicateur plus exigeant, car il se concentre sur des tâches liées au dépôt plus complexes et utilise le taux de résolution comme indicateur principal. Cela s'avère particulièrement utile lorsque l'on s'intéresse aux capacités réelles d'un agent de codage : il ne s'agit pas seulement de savoir si le modèle est capable d'expliquer un bug, mais s'il est capable de faire évoluer un dépôt vers une correction fonctionnelle dans des conditions de test standard.
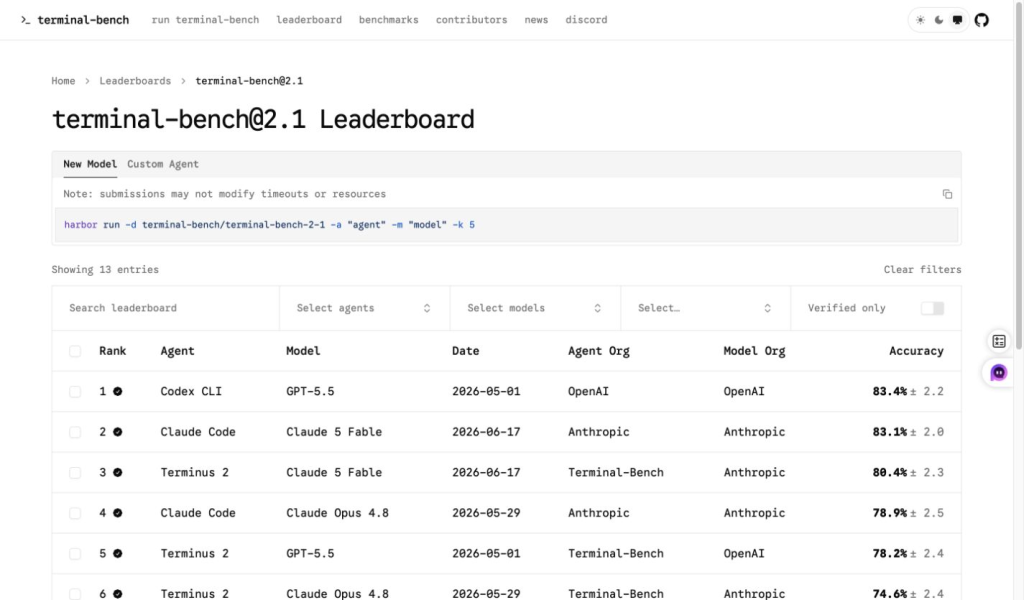
Terminal-Bench : tâches de ligne de commande et de workflow des agents
Terminal-Bench 2.1 Il se distingue de SWE-Bench en ce qu'il met l'accent sur la réalisation de tâches en terminal et en ligne de commande via la configuration d'agents ou de modèles. Il est donc plus adapté aux workflows de type “ Claude Code ” et « ChatGPT Codex » qu'à une simple invite de chat du type « écrivez cette fonction ». Si vous cherchez un assistant de codage pour des tâches au niveau du dépôt ou en ligne de commande, ce benchmark doit faire partie de votre réflexion.
| Preuves | À lire absolument pour | Points à retenir |
|---|---|---|
| Ressources de programmation pour OpenAI GPT-5.5 | Programmation GPT-5.5 et approche « agentique » de l'ingénierie logicielle. | ChatGPT bénéficie d'un large soutien en tant qu'assistant de programmation axé sur la mise en œuvre. |
| SWE-Bench | Résolution des problèmes liés au référentiel et tâches de maintenance logicielle. | C'est un bon indicateur des compétences en programmation, surtout lorsque le contexte du dépôt joue un rôle important. |
| SWE-Bench Pro | Tâches plus complexes liées au dépôt et comparaison des taux de résolution. | Utile pour évaluer la capacité de codage agentique à un niveau avancé. |
| Terminal-Bench 2.1 | Tâches en terminal, exécution de commandes et configuration des agents/modèles. | Cela concerne davantage les workflows de Claude Code et Codex que de simples invites de chat. |
Les tests de performance font de ces deux familles de modèles des options de codage crédibles, mais ils ne permettent pas de trancher quant au choix à adopter dans le cadre du travail quotidien. Les sections ci-dessous utilisent les mêmes cas d'utilisation pour le débogage, la refactorisation, la planification, les tests unitaires et l'analyse de sécurité, afin que vous puissiez constater en quoi les réponses ont divergé dans la pratique.
Comment nous avons testé Claude et ChatGPT pour la programmation
Nous avons testé GPT-5.5 et Claude Sonnet 5 le 7 juillet 2026 sur GlobalGPT, en utilisant la même interface et les mêmes invites. L'objectif n'était pas de reproduire un benchmark complet des agents IDE, mais de comparer l'aide au codage au quotidien : débogage, refactorisation, raisonnement sur plusieurs fichiers, rédaction de tests et vérification de la sécurité.
Les critères d'évaluation étaient simples : exactitude, analyse des causes profondes, facilité de maintenance, prise en charge des cas limites, vérification et respect des consignes. Cela permet de refléter au mieux la manière dont les développeurs utilisent réellement les assistants de codage basés sur l'IA.
Test n° 1 : Débogage et analyse des causes profondes
La première consigne demandait aux deux modèles d'analyser une fonction JavaScript qui regroupe les tickets par priorité. Le bug est subtil mais courant : la fonction tente d'ajouter dans acc[ticket.priority] avant que ce tableau n'existe.
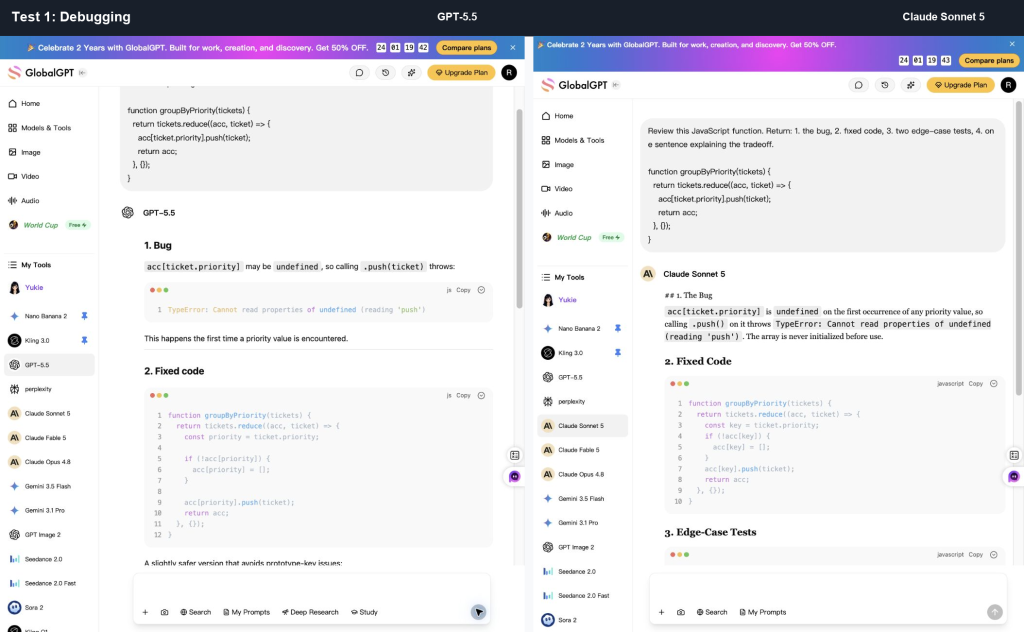
Ce que ChatGPT a bien réussi : GPT-5.5 a détecté le bug, a fourni le code corrigé, a ajouté des tests pour les cas limites et a intégré une approche plus prudente Object.create(null) variante. Ce détail d'implémentation supplémentaire s'avère utile lorsque les clés d'objet risquent d'entrer en conflit avec des propriétés héritées.
Ce que Claude a bien fait : Claude Sonnet 5 a repéré le même bug et a apporté une réponse plus précise. Il a également soulevé un cas limite dont la priorité n'était pas définie, ce qui correspond au genre de limite pratique qu'un relecteur devrait prendre en compte.
Gagnant : Égalité, avec un léger avantage pour ChatGPT en termes de nuances de mise en œuvre. Claude était plus épuré ; GPT-5.5 était plus complet.
Test n° 2 : Refactorisation et maintenabilité
La deuxième consigne demandait de refactoriser le code pour en améliorer la lisibilité sans en modifier le comportement. C'est un bon test, car de nombreuses réponses générées par l'IA ont tendance à refactoriser de manière excessive de petits utilitaires et à créer davantage d'éléments mobiles que ne le nécessite le code d'origine.
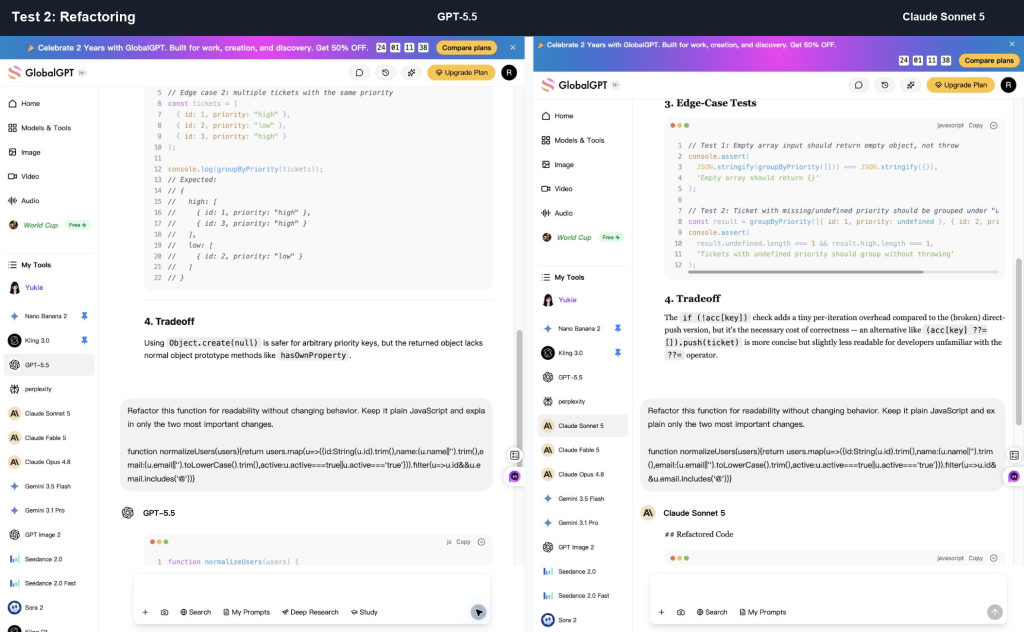
Ce que ChatGPT a bien réussi : GPT-5.5 a conservé une structure proche de l'originale, a introduit des valeurs intermédiaires nommées et a suivi à la lettre la consigne “ deux changements importants seulement ”. Cela s'avère utile lorsque l'utilisateur souhaite une refactorisation prudente.
Ce que Claude a bien fait : Claude Sonnet 5 a extrait des fonctions auxiliaires telles qu’un normalisateur et un validateur. Le résultat a rendu le code plus facile à parcourir, mais cela a modifié la structure davantage que ne l’avait fait GPT-5.5.
Gagnant : ChatGPT pour la sobriété ; Claude pour la lisibilité modulaire. Si vous avez besoin d'une refactorisation minimale et sûre, commencez par ChatGPT. Si vous souhaitez une nomenclature plus claire, demandez à Claude de relire le code.
Test n° 3 : Raisonnement et planification sur plusieurs fichiers
Le troisième exercice proposait une petite arborescence de fichiers Next.js et un rapport de bogue : les utilisateurs connectés peuvent télécharger des fichiers de petite taille, mais le téléchargement des fichiers de plus de 8 Mo échoue sans message d'erreur une fois que la barre de progression atteint 100%.
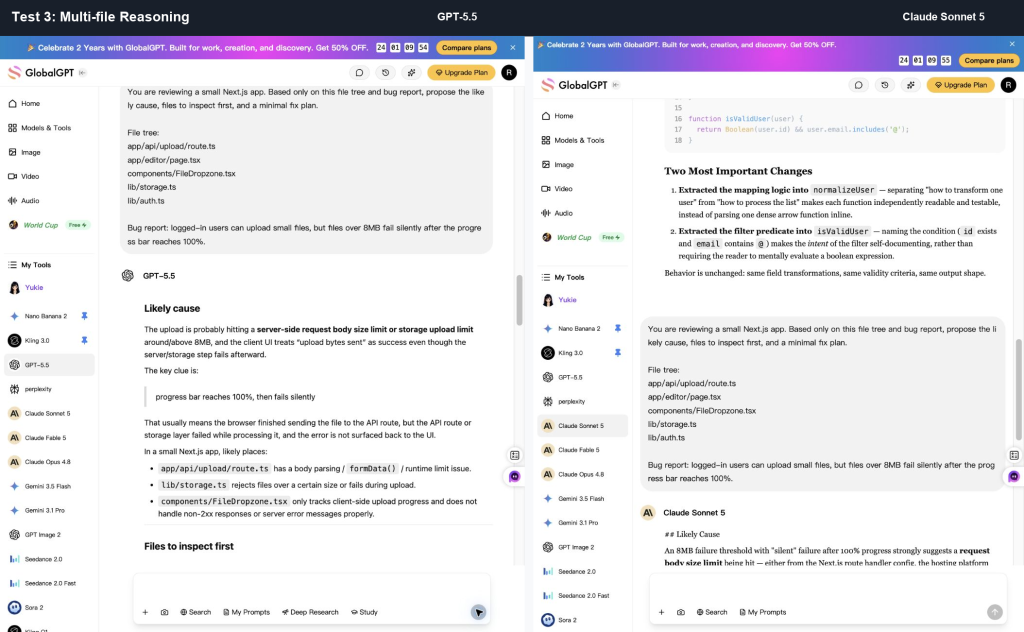
Ce que ChatGPT a bien réussi : GPT-5.5 a élaboré un plan détaillé axé sur la mise en œuvre. Ce plan abordait notamment la vérification de la taille des serveurs, la gestion des réponses des clients et la propagation des erreurs de stockage.
Ce que Claude a bien fait : Claude Sonnet 5 a d'emblée mis l'accent sur le seuil des 8 Mo, probablement lié à des contraintes liées à la plateforme ou à la taille de l'appareil, sur la sémantique de la barre de progression, ainsi que sur un parcours de vérification à 7 Mo, 8 Mo et 9 Mo. Cela ressemblait davantage à une note de révision rédigée par un responsable.
Gagnant : Claude. Cela a permis d'identifier plus rapidement la cause probable et de définir un parcours d'inspection minimal plus précis.
Test n° 4 : Tests unitaires et vérification
La quatrième consigne demandait aux deux modèles d'écrire des tests unitaires en TypeScript pour une fonction d'aide qui renvoie les limites du forfait concernant les téléchargements et l'accès à Codex. Cela permet de vérifier si le modèle est capable de protéger la logique de branchement contre d'éventuelles régressions futures.
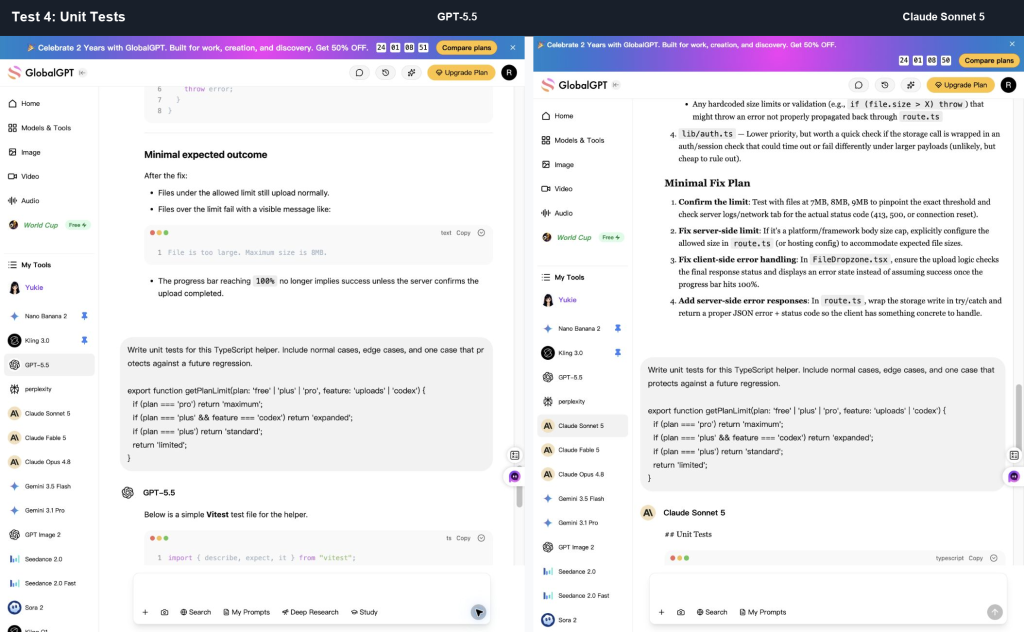
Ce que ChatGPT a bien réussi : GPT-5.5 a intégré les importations du framework de test et a généré un fichier Vitest qui semblait prêt à l'emploi. Il couvrait toutes les combinaisons attendues et permettait d'intégrer facilement la réponse dans un projet.
Ce que Claude a bien fait : Claude Sonnet 5 a mieux expliqué le risque réel de régression : pro + codex doit être exécutée avant les vérifications spécifiques à chaque fonctionnalité. C'était une réponse plus solide sur le plan du raisonnement, même si elle était moins facile à intégrer telle quelle dans un fichier.
Gagnant : Claude pour la conception des tests ; ChatGPT pour la génération d'un fichier de départ. En pratique, utilisez ChatGPT pour la première ébauche des tests et Claude pour vérifier si ces tests garantissent le bon comportement.
Test n° 5 : Évaluation de la sécurité et de la fiabilité
La cinquième consigne demandait aux deux modèles d'analyser un point de terminaison de webhook Express. Une bonne réponse devait aborder la vérification de la signature, les exigences relatives au corps brut, l'idempotence, la validation, la gestion des erreurs de base de données et les limites de taille des requêtes.
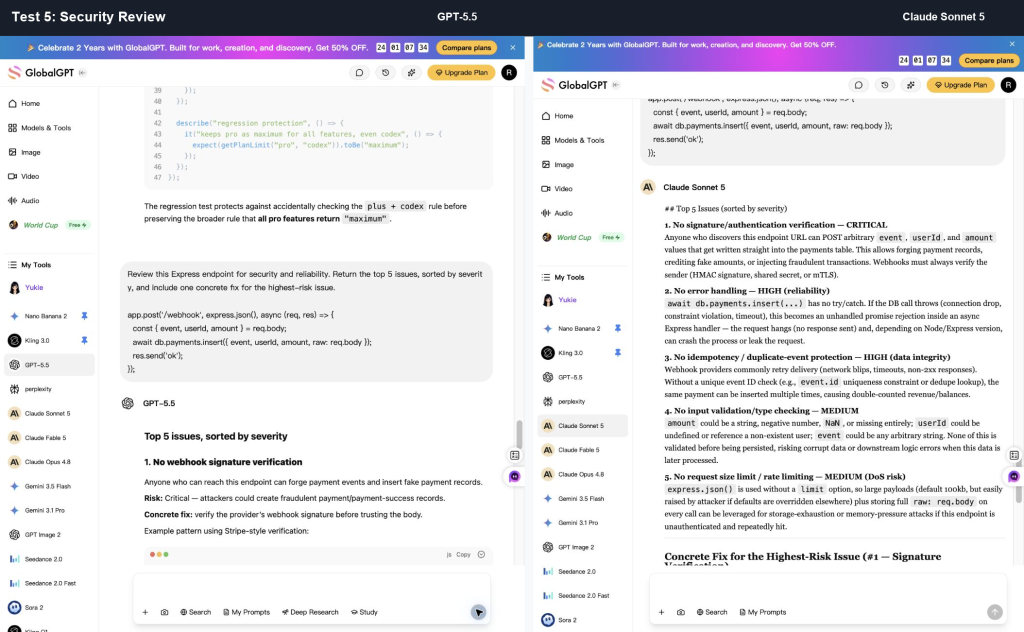
Ce que ChatGPT a bien réussi : GPT-5.5 a proposé une solution de type « fournisseur », comprenant un système similaire à Stripe express.raw() modèle. Cela s'avère utile lorsque l'étape suivante consiste à implémenter un gestionnaire de webhook concret.
Ce que Claude a bien fait : Claude Sonnet 5 proposait un raisonnement plus rigoureux et intégrait des détails plus fiables concernant la comparaison des signatures, en s'appuyant sur des concepts de comparaison en temps constant. Cela a permis d'affiner le classement des risques.
Gagnant : Égalité, avec un léger avantage pour Claude en matière d'explication des mesures de sécurité. Les deux modèles étaient suffisamment performants pour être utiles, mais aucune de ces deux solutions ne devrait se substituer à un véritable audit de sécurité des flux de paiement ou d'authentification.
Claude Code contre ChatGPT Codex
La sortie du chat ne constitue qu'un aspect parmi d'autres de la décision de codage. Claude Code et Codex sont deux workflows distincts de développement agentique destinés aux tâches impliquant des fichiers, des commandes, des tests, des pull requests ou des modifications plus larges de la base de code.
| Flux de travail | Meilleure adéquation | Limite importante |
|---|---|---|
| Claude chat | Raisonnement, débogage, révision, explication et planification. | Il ne prend en compte que le contexte que vous lui fournissez, à moins qu'il ne soit relié à des outils ou à un flux de travail plus large. |
| Chat avec ChatGPT | Projets de mise en œuvre, tests, exemples et questions relatives à l'utilisation de l'API. | Même une réponse convaincante doit encore être vérifiée dans le cadre de votre projet. |
| Claude Code | Codage respectant les conventions Repo, navigation dans la base de code, tests et planification de tâches de grande envergure. | Vérifiez les autorisations, la politique de sécurité et le diff proposé avant d'accepter les modifications. |
| Codex | Mise en œuvre tenant compte de Repo, débogage, tests, révision et workflows de codage intégrant OpenAI. | Les conditions d'accès, d'utilisation et de disponibilité du modèle diffèrent de celles d'un chat classique et peuvent évoluer au fil du temps. |
L'approche pratique : utilisez des modèles de chat pour la réflexion, les explications et les petites tâches ; utilisez Claude Code ou Codex lorsque le travail nécessite le contexte d'un référentiel et des étapes exécutables.
Tarifs : Claude, ChatGPT, Codex et GlobalGPT
Commencez par vous demander ce pour quoi vous payez. Un forfait « chat » donne accès à une aide interactive quotidienne en matière de programmation. Un forfait « workflow d’agent de programmation » couvre les tâches liées aux dépôts de code, telles que les opérations via l’interface en ligne de commande (CLI), l’IDE, le Web, le cloud ou les intégrations. La tarification des API s’effectue au million de tokens. Un espace de travail multimodèle permet de passer plus facilement d’un modèle à l’autre (Claude, GPT, Gemini, Perplexity et autres) depuis un seul et même endroit.
Les prix vérifiés le 27 septembre 2026 sont exprimés en dollars américains, hors taxes applicables. Le tableau présente séparément les abonnements grand public, les tarifs standard des jetons API et les formules annuelles proposées par GlobalGPT. Page des tarifs de Claude L'équivalent annuel chez Rounds Pro correspond à $17 par mois ; le paiement initial de $200 équivaut à $16,67 par mois.
| Produit ou formule | Prix affiché | Ce que cela implique pour la programmation |
|---|---|---|
| Grand public · Claude Gratuit | $0 | C'est suffisant pour répondre à quelques questions simples de programmation et tester le style de Claude avant de payer. |
| Grand public · Claude Pro | $20 par mois ; $200 par an, payable d'avance (équivalent à $16,67 par mois) | Code Claude inclus ; utilisation du chat et du code Claude dans le cadre d'un forfait payant. |
| Grand public · Claude Max | À partir de $100 par mois | Options d'utilisation plus étendues ; code Claude inclus. La facturation de la console API est distincte. |
| Grand public · ChatGPT Gratuit | $0/mois | Chat allégé ; l'accès à GPT-6 Luna sur ordinateur de bureau est différent du Chat classique. |
| Consommateurs · ChatGPT Go | $8/mois selon la référence américaine d'origine ; les tarifs locaux peuvent varier | Abonnement mensuel ; consultez la page des tarifs locaux pour connaître le montant applicable dans votre région. |
| Consommateurs · ChatGPT Plus | $20 par mois, facturé mensuellement | Accès régulier aux consignes de codage et aux services Codex/Work éligibles ; l'utilisation de l'API est facturée séparément. |
| Consommateurs · ChatGPT Pro | $100/mois ; les abonnements existants à $200/mois sont maintenus | Les nouvelles inscriptions et les mises à niveau vers la formule $200 seront suspendues à compter du 10 septembre 2026. Les abonnements à la formule $100 restent disponibles. |
| API · Claude Sonnet 5 | Entrée $2/M ; sortie $10/M | Tarif API standard pour les outils de codage et les workflows à grande échelle. |
| API · Claude Opus 5,5 | Entrée $4/M ; sortie $20/M | Vitesse standard. En mode rapide, les valeurs d'entrée sont $8/M et celles de sortie $40/M. |
| API · GPT-6 Astra | Entrée $10/M ; sortie $50/M | Tarif API standard ; distinct du forfait ChatGPT. |
| API · GPT-6 Sol / Luna | Sol : entrée $2/M, sortie $10/M ; Luna : entrée $0.10/M, sortie $0.50/M | Facturation distincte pour les développeurs ; veillez à indiquer l'identifiant exact du modèle et le tarif correspondant. |
| Plateforme · GlobalGPT Basic | Équivalent à $5,80 par mois ; $69,60 facturé annuellement | Une solution économique pour comparer plusieurs familles de modèles dans le cadre de tâches quotidiennes de codage et de recherche. |
| Plateforme · GlobalGPT Pro | Équivalent à $10,80 par mois ; $129,60 facturé annuellement | Une meilleure adaptation lorsque vous passez d'une famille de modèles à une autre dans le cadre de votre travail quotidien. |
| Plateforme · GlobalGPT Illimité | Équivalent à $25 par mois ; $300 facturé annuellement | Pour effectuer régulièrement des comparaisons entre plusieurs modèles au sein d'un même espace de travail. Ces formules n'incluent pas de crédits API officiels ni d'abonnements natifs à Claude Code/Codex. |
Pour la plupart des développeurs indépendants, la question n’est pas de savoir “ quelle entreprise est la moins chère ? ”, mais “ quel tarif correspond le mieux à mon mode de travail ? ”. Si vous passez la plupart de votre temps à poser des questions et à coller des extraits de code, Claude Pro ou ChatGPT Plus Cela pourrait suffire. Si vous souhaitez une implémentation compatible avec Repo, comparez l'accès au code Claude et à Codex. Si vous comparez plusieurs modèles chaque jour, GlobalGPT peut constituer un espace de travail quotidien plus épuré, car le coût est lié à un seul forfait multimodèle plutôt qu’à plusieurs abonnements distincts.
Pour les outils de programmation qui font largement appel aux API, les tarifs d'abonnement ne constituent pas un bon critère de comparaison. La tarification au jeton revêt davantage d'importance, car le contexte du code est très vaste. Claude Sonnet 5 coûte $2/M en entrée et $10/M en sortie, tandis qu’Opus 5.5 coûte $4/M et $20/M à vitesse standard. Un million de jetons d'entrée plus un million de jetons de sortie coûtent donc $12 sur Sonnet 5 ou $24 sur Opus 5.5. Pour OpenAI, la même utilisation coûte $60 sur Astra, $12 sur Sol ou $0,60 sur Luna aux tarifs standard. Il s’agit de frais liés à l’API, et non de quotas inclus dans les abonnements ChatGPT, Claude ou GlobalGPT.
Quelle configuration de codage choisir ?
Ne vous fiez pas uniquement au nom du modèle. Choisissez en fonction du type de travail de programmation que vous effectuez réellement. Une même personne peut utiliser ChatGPT pour une première implémentation, Claude pour la révision, Codex pour les tâches liées au dépôt de code exécutable et GlobalGPT pour des vérifications rapides et parallèles des modèles au cours d'une journée de travail normale.
Débutants souhaitant apprendre à programmer : Commencez par ChatGPT. Ce site propose généralement davantage d’exemples, plus de conseils et un parcours plus accessible pour passer de “ Je ne comprends pas cette erreur ” à “ Voici la solution ”.”
Un développeur junior en train de corriger des bugs : Commencez par Claude lorsque le problème n'est pas clair. Claude excelle à circonscrire les causes possibles, à identifier les éléments à vérifier en priorité et à fournir une explication ciblée. Utilisez ensuite ChatGPT lorsque vous souhaitez obtenir un correctif concret, un cas de test ou un exemple d'implémentation.
Ingénieur senior chargé de valider une modification : Commencez par Claude. Cet outil est mieux adapté aux compromis, à l'évaluation de la gravité des problèmes, aux questions d'architecture et aux critiques concises. Pour les tâches portant sur des bases de code plus volumineuses, passez de la discussion à Claude Code ou Codex afin que le modèle puisse travailler avec des fichiers et des commandes plutôt qu'avec un simple extrait collé.
Développeur front-end ou concepteur d'interface utilisateur : Commencez par utiliser ChatGPT pour la première ébauche. Cet outil a tendance à générer un code de composants plus complet, ainsi que la gestion de l'état et des structures de test. Utilisez ensuite Claude pour vérifier l'accessibilité, les limites des composants, la nomenclature et déterminer si le code n'est pas trop sophistiqué par rapport à la conception.
Responsable de la maintenance d'une base de code volumineuse : Choisissez entre Claude Code et Codex en fonction de votre infrastructure, de vos droits d'accès au compte, de votre politique de sécurité et de votre flux de travail préféré. Lorsqu'une tâche porte sur plusieurs fichiers, le flux de travail de l'agent a généralement plus d'importance que la réponse la plus convaincante donnée par le chatbot.
Fondateur indépendant ou petite équipe : Utilisez les deux familles de modèles si le budget le permet. Une configuration pratique consiste à utiliser GlobalGPT pour la comparaison quotidienne des modèles et la génération de code à partir d'idées, ainsi que Claude Code ou Codex lorsqu'une tâche nécessite un accès au dépôt et des étapes exécutables.
| Type de développeur | Le meilleur premier choix | Pourquoi |
|---|---|---|
| Débutant qui apprend à programmer | ChatGPT | Davantage d'exemples, des explications plus complètes et des supports pédagogiques adaptés aux débutants. |
| Développeur junior chargé de corriger les bugs | Claude d'abord | Une réflexion plus rigoureuse sur les causes profondes et des conseils plus précis sur les points à vérifier en priorité. |
| Ingénieur senior chargé de valider une modification | Claude | Plus adapté aux compromis, à la hiérarchisation des risques et à la critique concise. |
| Développeur front-end / Concepteur d'interface utilisateur | ChatGPT d'abord, Claude ensuite | ChatGPT rédige le premier jet du composant ; Claude en vérifie l'accessibilité, la structure et la facilité de maintenance. |
| Responsable de la maintenance d'une base de code volumineuse | Claude Code ou Codex, selon la pile et le mode d'accès | Les fichiers, les commandes, les tests et les droits d'accès ont plus d'importance qu'une simple réponse dans un chat. |
| Fondateur de Solo | Les deux, souvent via un espace de travail multimodèle unique | Des ébauches rapides, une révision minutieuse et des changements de modèle rapides : tout cela a son importance lorsqu'une seule personne est responsable du produit. |
Si vous hésitez entre les nouvelles gammes de modèles Claude et GPT, la comparaison entre le Claude Opus 5.5 et le GPT-6 Sol vous fournira davantage d'informations spécifiques à chaque modèle. Si vous envisagez de souscrire à l'un des forfaits payants OpenAI, le ChatGPT Plus vs Pro Cette comparaison peut aider à déterminer si une utilisation plus intensive en vaut la peine.
Pourquoi de nombreux développeurs continuent-ils à utiliser les deux ?
Utiliser à la fois Claude et ChatGPT n'est pas un signe d'indécision. C'est un cycle de contrôle qualité plus efficace.
- Planifier avec Claude, mettre en œuvre avec ChatGPT : Utile lorsque vous souhaitez utiliser Claude pour limiter les risques et ChatGPT pour générer la première implémentation.
- Rédaction avec ChatGPT, révision avec Claude : Utile lorsque vous avez besoin d'un code rapide, mais que vous souhaitez bénéficier d'un deuxième avis plus rigoureux.
- Avant de passer à la production, posez ces deux questions : utile pour les paiements, l'authentification, les téléchargements, les migrations, la mise en cache et les modifications destructrices de la base de données.
- Utilisez un agent lorsque la tâche nécessite des fichiers : Le « Claude Code » ou « Codex » peut s'avérer plus pertinent qu'une simple conversation lorsque le modèle a besoin du contexte du référentiel.
La méthode GlobalGPT correspond au modèle “ utiliser les deux ” lorsque la tâche consiste à comparer rapidement des modèles, à obtenir une aide quotidienne à la programmation, à planifier ou à mener des recherches. Elle est particulièrement utile pour comparer quotidiennement des modèles, itérer sur des ébauches, obtenir rapidement un deuxième avis et choisir le style de modèle le mieux adapté au prochain projet.
Si l'accès à Claude est le seul critère que vous prenez en compte, alors le Meilleures alternatives à Claude AI Cette liste constitue un guide de secours plus général.
FAQ
Qui est le meilleur pour la programmation en 2026 : Claude ou ChatGPT ?
Privilégiez d'abord Claude pour la révision de code, le débogage de cas ambigus, la planification de l'architecture et le raisonnement à long terme. Optez d’abord pour ChatGPT pour les ébauches d’implémentation, les exemples, le travail sur le front-end et la mise en place de tests. Lorsque la tâche nécessite un accès au dépôt, l’utilisation de commandes, la réalisation de tests ou des modifications sur plusieurs fichiers, comparez Claude Code avec Codex plutôt que de vous fier uniquement au chat.
Claude est-il plus efficace que ChatGPT pour le débogage ?
Claude s'avère souvent plus efficace lors de la première étape de débogage, car il a tendance à mettre en avant la cause la plus probable et à expliquer clairement le cheminement de l'erreur. Dans nos tests JavaScript et Next.js, Claude Sonnet 5 s'est montré particulièrement performant pour établir des diagnostics concis. ChatGPT restait toutefois performant lorsque la correction nécessitait des détails de mise en œuvre plus complets.
ChatGPT Codex est-il meilleur que Claude Code ?
Aucune des deux options n’est automatiquement la meilleure pour toutes les équipes. Le Codex ChatGPT convient aux flux de travail axés sur OpenAI et aux tâches d’agent nécessitant une mise en œuvre importante. Le Code Claude est particulièrement efficace lorsque le travail tire parti du style de Claude en matière de planification, de révision et de raisonnement à long terme. Le choix le plus approprié dépend de l’accès au référentiel, de la tarification, de la pile technologique, des autorisations et de la politique de l’équipe.
Qu'est-ce qui est préférable pour une base de code volumineuse ?
Dans le cas d'une base de code volumineuse, le workflow de l'agent revêt une importance plus grande que le modèle de chat à lui seul. Utilisez Claude Code ou Codex lorsque l'assistant doit inspecter des fichiers, lancer des commandes, exécuter des tests ou suivre le comportement d'un module à l'autre. Prévoyez une vérification humaine pour les autorisations, les commandes à risque et le diff final.
Qu'est-ce qui est le mieux pour les débutants qui apprennent à programmer ?
ChatGPT est généralement plus accessible aux débutants, car il a tendance à fournir davantage d'exemples, des explications plus complètes et des extraits de code prêts à l'emploi. Claude peut s'avérer plus utile lorsque le débutant ne comprend pas pourquoi quelque chose ne fonctionne pas et a besoin d'une explication conceptuelle plus claire.
Qu'est-ce qui est le mieux pour le code HTML et l'interface utilisateur (UI) du front-end ?
ChatGPT est souvent plus performant pour générer une première ébauche de code HTML, CSS ou de composants. Claude est utile pour vérifier la structure, simplifier la mise en page et repérer les problèmes d'accessibilité ou de maintenabilité. Pour un travail front-end soigné, utilisez ChatGPT pour la rédaction et Claude pour la révision.
Quel modèle est le plus adapté à la rédaction de tests ?
ChatGPT est plus adapté lorsque vous souhaitez obtenir un fichier de test complet, comprenant les importations et une structure qui semble exécutable. Claude est plus adapté lorsque vous souhaitez comprendre quels comportements doivent être protégés et pourquoi un test de régression est important. Une bonne méthode consiste à générer des tests avec ChatGPT, puis à demander à Claude quels cas limites manquent.
Les tests de performance comme SWE-Bench permettent-ils de déterminer quel assistant de programmation est le meilleur ?
Non. SWE-Bench, SWE-Bench Pro et Terminal-Bench constituent des indicateurs précieux, en particulier pour les processus de codage axés sur l'agent, mais ils ne permettent pas de prédire entièrement l'aide apportée au codage au quotidien. Les tests de performance évaluent un environnement contrôlé ; dans la réalité, les développeurs ont également besoin d'un raisonnement clair, d'un code exploitable, de modifications faciles à maintenir et de bonnes étapes de vérification.
Les développeurs devraient-ils utiliser à la fois Claude et ChatGPT ?
Oui, surtout pour les projets sérieux. Utilisez Claude pour la planification, l'analyse des risques et le diagnostic. Utilisez ChatGPT pour les ébauches de mise en œuvre, les exemples et les structures de test. Ensuite, exécutez le code, examinez les différences et vérifiez le comportement dans votre propre projet.
Puis-je comparer Claude et ChatGPT dans GlobalGPT ?
Oui. GlobalGPT est utile pour comparer les réponses de Claude et ChatGPT au sein d’un même espace de travail lorsque les modèles nécessaires y sont disponibles. Il fonctionne bien pour les questions quotidiennes relatives au code, la planification, la recherche et les deuxièmes avis. Il ne remplace pas Claude Code, Codex, un IDE, les API officielles ni les outils au niveau du référentiel.