Быстрый ответ: GPT-6 Luna — это модель OpenAI, предназначенная для выполнения целенаправленных задач с большим объемом данных. В официальном API указаны тарифы Standard: $0.10 за 1 млн входных токенов и $0.50 за 1 млн выходных токенов, с окном контекста в 1,05 млн токенов и максимальным объемом выходных данных 128 тыс. В настоящее время в GlobalGPT указаны модели GPT-5.6 Sol и GPT-5.6 Luna, а не точные маршруты GPT-6, поэтому наименование платформы необходимо проверять отдельно от идентификатора модели API OpenAI.
OpenAI описывает GPT-6 Luna как свою наиболее эффективную модель для целенаправленных задач с большим объемом данных. Эта формулировка представляет собой позиционирование поставщика, а не выверенный показатель качества. В данном обзоре опубликованные технические характеристики преобразуются в решения по закупкам и архитектуре, после чего фиксируется реакция общественности с указанием источников. Мы также провели тест на совместимость API с ограниченным охватом, сохранив идентификатор модели, маршрут, набор подсказок, исходные данные вывода и условия использования. Результаты задачи приведены ниже в виде одного наблюдаемого прогона, а не в качестве официального теста производительности.
Краткий вывод
Luna — это прагматичный вариант из официального прайс-листа, ориентированный в первую очередь на стоимость: она сохраняет те же основные параметры и предельные значения производительности, что и Sol, при этом взимая гораздо меньшую плату за токены. Это делает её привлекательной для целенаправленных и повторяющихся запросов, однако низкая цена не является доказательством меньшей задержки или более низкого качества без проведения контролируемого тестирования.
Наиболее полезное различие заключается не просто в противопоставлении “умного” и “быстрого”, а в характере рабочей нагрузки. GPT-6 Luna имеет те же номинальные контекстные и выходные ограничения, что и его аналог, но его позиционирование и цена делают целесообразным выбор иной рабочей точки. Сравните более широкий Руководство по выбору моделей искусственного интеллекта и Лучшая модель искусственного интеллекта для кодирования руководство для случаев, когда задача охватывает более одного поставщика.
Краткий обзор GPT-6 Luna
Приведенная ниже таблица соответствует действующим официальная страница модели GPT-6 Luna. Емкость контекста — это не то же самое, что рекомендуемый размер промпта, а максимальный объем входных данных не зависит от окна контекста заголовка.
| Поле | Официальное значение |
|---|---|
| Официальный идентификатор API | gpt-6-luna |
| Позиционирование поставщика | целенаправленные задачи с большим объемом работы |
| Окно контекста | 1 050 000 токенов |
| Максимальный входной сигнал | 922 000 токенов |
| Максимальная мощность | 128 000 токенов |
| Отбор знаний | 18 мая 2026 года |
| Ввод / вывод | Ввод текста и изображения / вывод текста |
| Усилие рассуждения | нет, низкий, средний, высокий, очень высокий, максимальный |
| Поддерживаемые конечные точки | Автозаполнение в чате, ответы, пакетная обработка |
Обе родственные модели поддерживают структурированные результаты, вызов функций, потоковую обработку, кэширование подсказок, ввод изображений, поиск по файлам и веб-поиск в рамках описанного набора функций. Точное поведение инструмента по-прежнему зависит от конечной точки, учетной записи и настроек запроса; не следует делать вывод об успешном запуске инструмента только на основании того, что соответствующий флажок в списке возможностей установлен.
Что касается контекста на уровне семьи, то Обзор GPT-6 Astra показывает, как в аналогичной статье о GPT-6 разделены документация поставщика, маршруты платформы и реакции с атрибутами.
Цены на GPT-6 Luna и правило 272K
По стандартным тарифам Страница с ценами на OpenAI Указывает $0.10 входных данных, $0.01 кэшированных входных данных, $0.125 операций записи в кэш и $0.50 выходных данных на 1 млн токенов. Количество операций записи в кэш составляет 1,25-кратную величину от количества некэшированных входных данных. Стоимость режимов Batch и Flex составляет 501 TP40T в стандартном режиме, в режиме Fast она в 2 раза превышает соответствующий тариф, а при обработке в регионе добавляется 101 TP40T, если такая возможность доступна.
| Категория тарифа | Входной сигнал до 272K | Более 272K входных данных |
|---|---|---|
| Некешированные входные данные | $0.10 / 1M | $0.20 / 1M |
| Кэшированный ввод | $0.01 / 1M | $0.02 / 1M |
| Запись в кэш | $0,125 / 1M | $0,25 / 1M |
| Выход | $0.50 / 1M | $0,75 / 1M |
Столбец «Длинный контекст» рассчитывается по правилу OpenAI: при объёме входных данных свыше 272K скорости ввода и кэширования удваиваются, а скорость вывода умножается на 1,5 для всего запроса. Это не тариф со смешанными скоростями. Для практической базовой оценки бюджета 100K входных операций плюс 10K выходных операций обходятся примерно в $0.015 до учета инструментов или регионального подъема; пример с входными данными 300K и выходными данными 20K обходится примерно в $0.075 по тарифам с длительным контекстом.
Большое окно контекста может быть полезным, хотя его и не так просто заполнить. Поиск, выбор фрагментов, повторное использование кэша и ограничения на вывод данных имеют большее значение, чем цифра 1,05 млн в заголовке. См. Разбивка цен на GPT-6 Astra для получения соответствующих пояснений по поводу пороговых значений контекста и принципов работы кэша.
GPT-6 Luna: подбор API, инструменты и ограничения
OpenAI рекомендует использовать API Responses для встроенных инструментов и вызова функций. Функция «Автозаполнение в чате» поддерживает вызов функций только в том случае, если логическое_усилие устанавливается на нет. Это деталь реализации, на которую стоит обратить внимание перед миграцией: запрос может быть синтаксически корректным, но при этом не соответствовать поведению инструмента, на которое рассчитана ваша текущая интеграция.
| Возможности | Поддерживаемое или задокументированное поведение |
|---|---|
| Ответы | Поддерживается; встроенные инструменты и вызов функций |
| Автозаполнение в чате | Поддерживается; вызов функции возможен только при значении reasoning_effort=none |
| Партия | Поддерживается; отдельный режим обработки со стандартными тарифами токенов 50% |
| Аудио / в реальном времени / видео | Не поддерживается на странице модели |
| Ввод изображения | Поддерживается; выходные данные остаются текстовыми |
| Максимальный входной сигнал | 922 000 токенов; не путайте это с контекстным окном размером 1,05 млн |
В текущей таблице ограничений скорости перечислены следующие стандартные уровни. RPM означает количество запросов в минуту, TPM — количество токенов в минуту, а значение «очередь» — ограничение на количество токенов в пакете.
| Уровень | RPM | TPM | Очередь пакетных заданий |
|---|---|---|---|
| Уровень 1 | 500 | 500,000 | 5,000,000 |
| Уровень 2 | 5,000 | 2,000,000 | 20,000,000 |
| Уровень 3 | 5,000 | 4,000,000 | 40,000,000 |
| Уровень 4 | 10,000 | 10,000,000 | 1,000,000,000 |
| Уровень 5 | 30,000 | 180,000,000 | 15,000,000,000 |
Перед запуском в производственную среду проверьте в своей учетной записи точный уровень, конечную точку, режим потоковой передачи и контракт инструмента. Руководство по ограничениям использования Codex Это помогает понять, почему опубликованный лимит модели не совпадает с фактическим лимитом аккаунта.
Что следует из технических характеристик GPT-6 Luna
| Работа читателя | Почему это подходит | Что необходимо проверить |
|---|---|---|
| Целенаправленная добыча | Провайдер использует Luna для выполнения специализированных задач с большим объемом при низкой ставке в токенах. | Определите схему и проверьте наличие полей с некорректным форматом или отсутствующих полей. |
| Повторяющиеся резюме | Низкие цены на входные ресурсы, кэш и выходные данные упрощают составление бюджета на повторяющиеся работы. | Убедитесь, что в вашем маршруте настроены проверка попаданий в кэш и ограничения на вывод данных. |
| Крупные партии входных данных | Максимальный объем входных данных 922K и поддержка контекста объемом 1,05M позволяют обрабатывать значительные наборы исходных данных. | Следите за множителем с длинным контекстом 272K. |
| Работа агента без установленных сроков | API предоставляет тот же обширный набор инструментов, что и в бумажном варианте. | Прежде чем делать выводы о качестве или задержке на уровне Sol, запустите контролируемую задачу. |
Это карта соответствий, а не эталон. Используйте Руководство по рабочему процессу с использованием универсальных моделей искусственного интеллекта когда на самом деле вам предстоит решить, как переключаться между моделями в рамках одного повторяемого процесса, а не какая из отдельных моделей кажется наиболее убедительной.
Практическое тестирование API: три сопоставимые задачи
Мы выполнили те же три небольшие задачи с помощью API совместимости Broly Anywhere по адресу https://anywhere.broly.ai/v1/chat/completions с использованием идентификатора модели gpt-6-luna: проверка кода, служебная записка с подробным обоснованием решения и строгий извлечение данных в формате JSON. Это полезные наблюдения за рабочим процессом, а не официальный тест OpenAI или универсальный рейтинг. При первых двух попытках были получены временные ответы HTTP 503, связанные с перегрузкой; после повторной попытки все три задачи были выполнены с кодом HTTP 200.
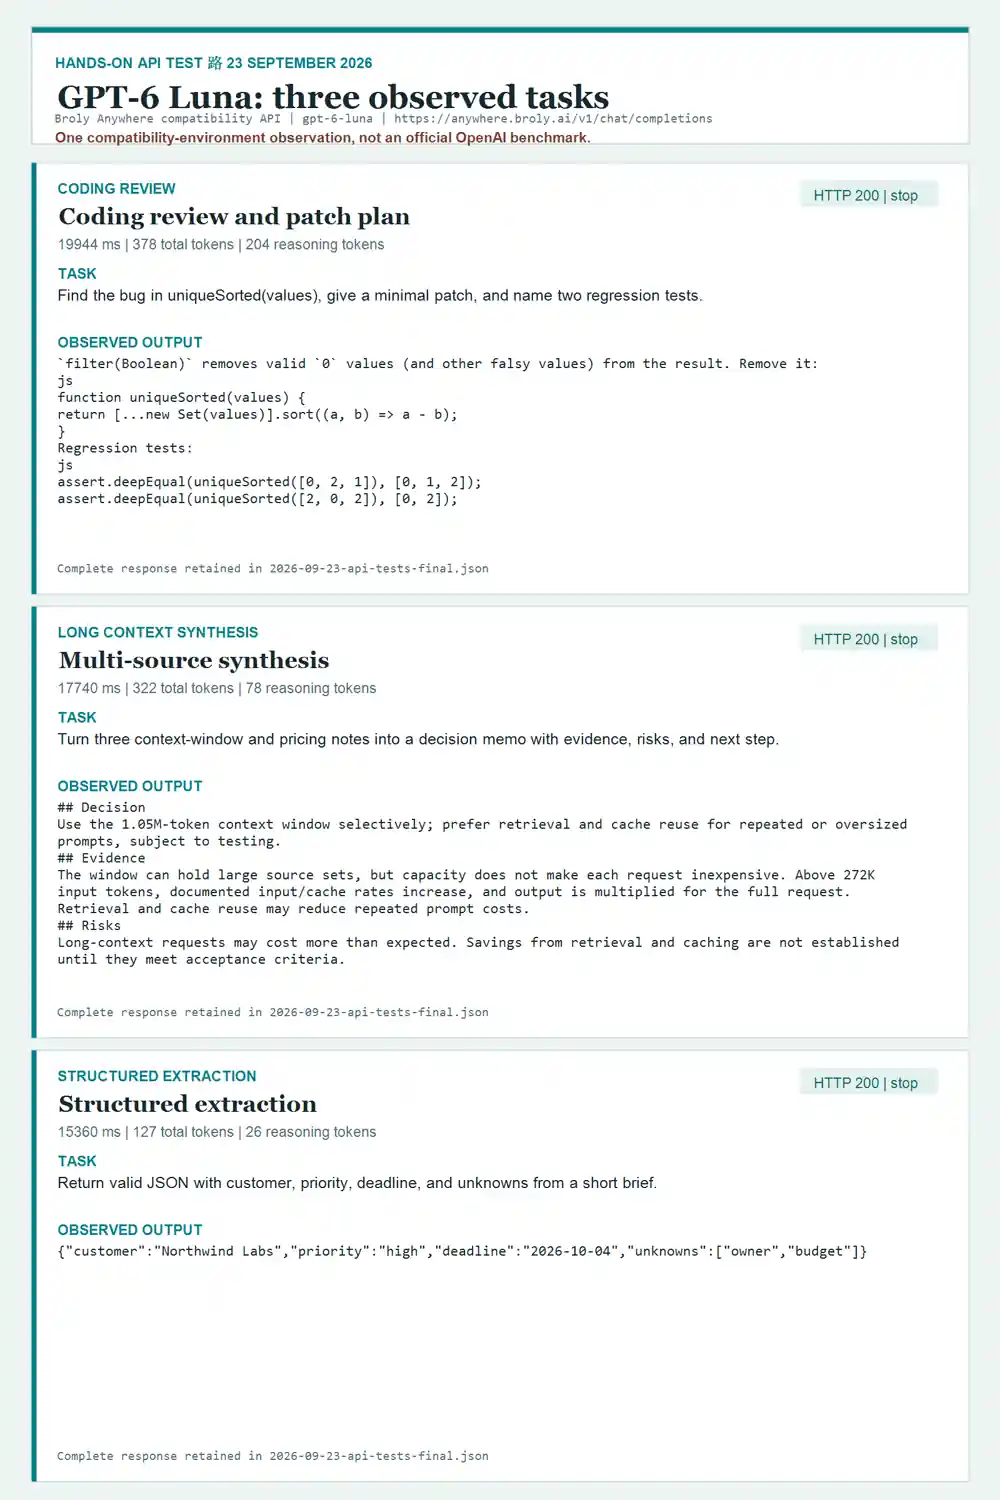
В полном отчете в формате JSON сохраняются все поля: запросы, результаты, статус HTTP, причина завершения, задержка и данные об использовании. На приведенных ниже карточках эта же информация доступна для редактирования в исходном коде WordPress.
Анализ кода и план внедрения исправлений
19 944 мс · всего 378 токенов · 204 токена рассуждений
Проанализируйте эту небольшую функцию на JavaScript так, как если бы она была частью репозитория, используемого в производственной среде. Найдите ошибку, объясните, как она проявляется, и предложите минимальный патч, а также два целенаправленных регрессионных теста. Функция: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }`filter(Boolean)` удаляет из результата допустимые значения `0` (и другие значения, оцениваемые как false). Удалите его:
```js
function uniqueSorted(values) {
return [...new Set(values)].sort((a, b) => a - b);
}
```
Регрессионные тесты:
```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```Синтез из нескольких источников
17 740 мс · всего 322 токена · 78 токенов рассуждений
Объедините следующие три заметки в краткую служебную записку с изложением решения, в которой должны быть указаны: решение, обоснование, риски и дальнейшие действия. Примечание A: Контекстное окно объемом 1,05 млн токенов может вмещать большие наборы исходных данных, но не делает каждый запрос недорогим. Примечание B: При количестве входных токенов свыше 272K задокументированные показатели ввода/кэширования увеличиваются, а объем вывода умножается для полного запроса. Примечание C: Извлечение и повторное использование кэша могут снизить затраты на повторные промпты, но критерии приемлемости все равно необходимо тестировать.
## Решение
Использовать контекстное окно объемом 1,05 млн токенов выборочно; при повторяющихся или чрезмерно больших запросах отдавать предпочтение извлечению и повторному использованию кэша, при условии проведения тестирования.

## Обоснование
Окно может вмещать большие наборы исходных данных, но его емкость не делает каждый запрос недорогим. При количестве входных токенов свыше 272K задокументированные показатели ввода/кэширования увеличиваются, а объем вывода умножается для полного запроса. Извлечение и повторное использование кэша могут снизить затраты на повторяющиеся запросы.

## Риски
Запросы с длинным контекстом могут обойтись дороже, чем ожидалось. Экономия за счёт извлечения и кэширования не будет подтверждена до тех пор, пока не будут выполнены критерии приемлемости.

## Следующий шаг
Протестируйте репрезентативные рабочие нагрузки на соответствие определённым критериям приемлемости качества и стоимости, включая запросы свыше 272K токенов и сценарии с повторяющимися запросами.
Структурированное извлечение
15 360 мс · всего 127 токенов · 26 токенов рассуждений
Извлеките из данного технического задания следующие поля и верните только корректный JSON-объект с ключами «customer», «priority», «deadline» и «unknowns». Техническое задание: Заказчик: Northwind Labs. Приоритет: высокий. Срок выполнения: 04.10.2026. Ответственное лицо не указано, бюджет не подтвержден.
{"заказчик":"Northwind Labs","приоритет":"высокий","срок выполнения":"2026-10-04","неизвестные параметры":["ответственное лицо","бюджет"]}В задаче по программированию GPT-6 Luna обнаружила ошибку, связанную с ложными значениями, в фильтр(логическое значение) и предоставила патч, а также данные о регрессионном тестировании; в завершенном прогоне было использовано в общей сложности 378 токенов. В задаче с длинным контекстом система сохранила структуру, состоящую из решения, обоснования, риска и следующего шага, при этом перенеся вперед оговорку о ценообразовании объемом 272K; в ответе было использовано в общей сложности 322 токена. В задаче структурированного извлечения система вернула запрошенные поля «клиент», «приоритет», «срок» и «неизвестные» в формате JSON. Это наблюдаемые формы вывода для данного подхода, а не доказательство того, что одна модель универсально лучше другой.
О чём может рассказать реакция общественности, а о чём — нет
Приведенные ниже источники включены в качестве отражения общественной реакции с указанием авторства, а не в качестве официальной документации или контролируемых данных тестов производительности. Их названия отражают то, что каждый автор решил проверить или объяснить; они не отражают результаты в масштабах всего рынка.
- Chase AI: GPT 6 Sol и Luna уже в продаже (и на 50% дешевле!). Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
- Роб, специалист по искусственному интеллекту: ChatGPT выпустила GPT-6 Sol и GPT-6 Luna (новые модели и агенты ChatGPT). Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
- ИИ с Сурьей: GPT-6 Soul, Luna и Claude Opus 5.5: что выбрать?. Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
Здесь важен еще один момент, связанный с наименованием: в названиях нескольких общедоступных видео термины “GPT-6” и “GPT-5.6” используются как синонимы. При цитировании утверждения указывайте точный идентификатор модели. Сравнение GPT-6 Astra и GPT-5.6 Sol Это наглядный пример того, почему идентификатор провайдера, метку платформы и маршрут следует регистрировать отдельно.
Доступ к GlobalGPT и примечание по наименованию GPT-5.6
В каталоге проверенных моделей GlobalGPT в настоящее время представлены GPT-5.6 Sol и GPT-5.6 Luna. Точные идентификаторы API OpenAI, упомянутые в данной статье, — это gpt-6-luna и являются частью официальной документации по OpenAI. Точное /home/gpt-6-luna Маршрут GlobalGPT не был проверен, поэтому в данной статье не утверждается, что этот маршрут платформы обеспечивает доступ к GPT-6.
Информацию о текущей системе наименования платформ и принципах указания отдельных авторов см. в Руководство по ценам на GPT-5.6 и Сравнение моделей GPT-5.6. Эти страницы отражают особенности платформы и редакционную политику; они не имеют приоритета над таблицей цен API OpenAI.
По этой ссылке открывается текущее название платформы GlobalGPT, а не проверенный идентификатор модели GPT-6 OpenAI.
Открыть каталог моделей GlobalGPTКому стоит выбрать GPT-6 Luna?
Если в ваш список финалистов вошли более недорогие варианты, сравните более обширный каталог моделей а не исходить из того, что новейшая модель автоматически является наиболее выгодным вариантом. Если вы оцениваете задачи с большим объемом данных, то Руководство по моделированию анализа данных предоставляет отдельный модуль для организации рабочего процесса.
Часто задаваемые вопросы
Что такое GPT-6 Luna?
GPT-6 Luna — это модель OpenAI, предназначенная для выполнения целенаправленных задач с большим объемом данных. Ее официальный идентификатор модели API — gpt-6-luna.
Сколько стоит GPT-6 Luna?
В таблице OpenAI указаны следующие показатели для GPT-6 Luna: $0.10 на 1 млн входных токенов, $0.01 на 1 млн кэшированных входных токенов, $0,125 за 1 млн записей в кэш и $0,50 за 1 млн выходных токенов по стандартным тарифам.
Что происходит при количестве входных токенов свыше 272K?
Когда объем запроса превышает 272K входных токенов, OpenAI применяет к всему запросу 2-кратную скорость ввода и кэширования, а также 1,5-кратную скорость вывода.
Каковы ограничения по контексту и выводу?
GPT-6 Luna поддерживает контекстное окно объемом 1 050 000 токенов, максимальный объем входных данных — 922 000 токенов, а максимальный объем выходных данных — 128 000 токенов.
Каков порог знаний?
На текущей странице модели OpenAI в качестве даты окончания обновления знаний для GPT-6 Luna указано 18 мая 2026 года.
Какие настройки логики доступны?
В документации по API описаны уровни затрат на рассуждения: none, low, medium, high, xhigh и max, причем по умолчанию установлен уровень medium.
Какие конечные точки API поддерживаются?
GPT-6 Luna поддерживает функции «Завершение чата», «Ответы» и «Пакетная обработка». На странице модели не указаны в качестве поддерживаемых функций «Работа в реальном времени», «Помощники», аудио, видео, генерация изображений, встраивание, точная настройка, модерация или устаревшие функции «Завершение».
Может ли GPT-6 Luna обрабатывать изображения?
Да. На странице модели указаны входные данные в виде текста и изображений, а также текстовый вывод. Однако это не делает её моделью для генерации изображений.
Доступна ли модель GPT-6 Luna в конфигурации GlobalGPT?
Официальное название модели OpenAI — GPT-6 Luna, однако в настоящее время GlobalGPT предоставляет доступ к меткам GPT-5.6 Sol и GPT-5.6 Luna. Точный маршрут GPT-6 через GlobalGPT не подтверждён, поэтому в данной статье не утверждается, что доступ к GPT-6 возможен через GlobalGPT.
В этой статье приводится тест производительности?
Да, но сфера применения ограничена: три сопоставимые задачи, выполненные через API совместимости Broly Anywhere. Результаты сохраняются как данные одного тестового прогона и не являются официальным результатом теста OpenAI или утверждением о превосходстве над другими системами.
Окончательный вердикт
Luna — это прагматичный вариант из официального прайс-листа, ориентированный в первую очередь на стоимость: он сохраняет те же основные параметры и предельные значения производительности, что и Sol, при этом тарифы за токены составляют лишь небольшую часть от цен Sol. Это делает его привлекательным для целенаправленных и повторяющихся запросов, однако низкая цена не является доказательством меньшей задержки или более низкого качества без проведения контролируемого тестирования. Перед публикацией еще раз проверьте официальные страницы с описанием модели и ценами в день публикации.
Проверено 23 сентября 2026 года. Официальные данные: разработчики OpenAI. Наименование маршрута на платформе: GlobalGPT. Реакция общественности: приведены ссылки на авторов и публикации с указанием авторства.