
Быстрый ответ: GPT-6 Sol — это модель сложных кодовых и агентных рабочих процессов OpenAI. В официальном API указаны тарифы Standard: $2.00 за 1 млн входных токенов и $10.00 за 1 млн выходных токенов, с окном контекста в 1,05 млн токенов и максимальным объемом вывода 128 тыс. Главный вопрос при покупке заключается в том, соответствуют ли его ответы требованиям вашей задачи при приемлемой общей стоимости.
OpenAI позиционирует GPT-6 Sol как решение для сложного программирования и агентных рабочих процессов. Данная формулировка представляет собой позиционирование поставщика, а не объективный показатель качества. В данном обзоре опубликованные технические характеристики преобразуются в решения по закупкам и архитектуре, после чего фиксируется реакция общественности с указанием источников. Мы также выполнили три небольших задания, сохранив идентификатор модели, маршрут, набор подсказок, исходные результаты и условия использования. Результаты заданий приведены ниже в качестве одного наблюдаемого прогона, а не в качестве официального теста производительности.
Краткий вывод
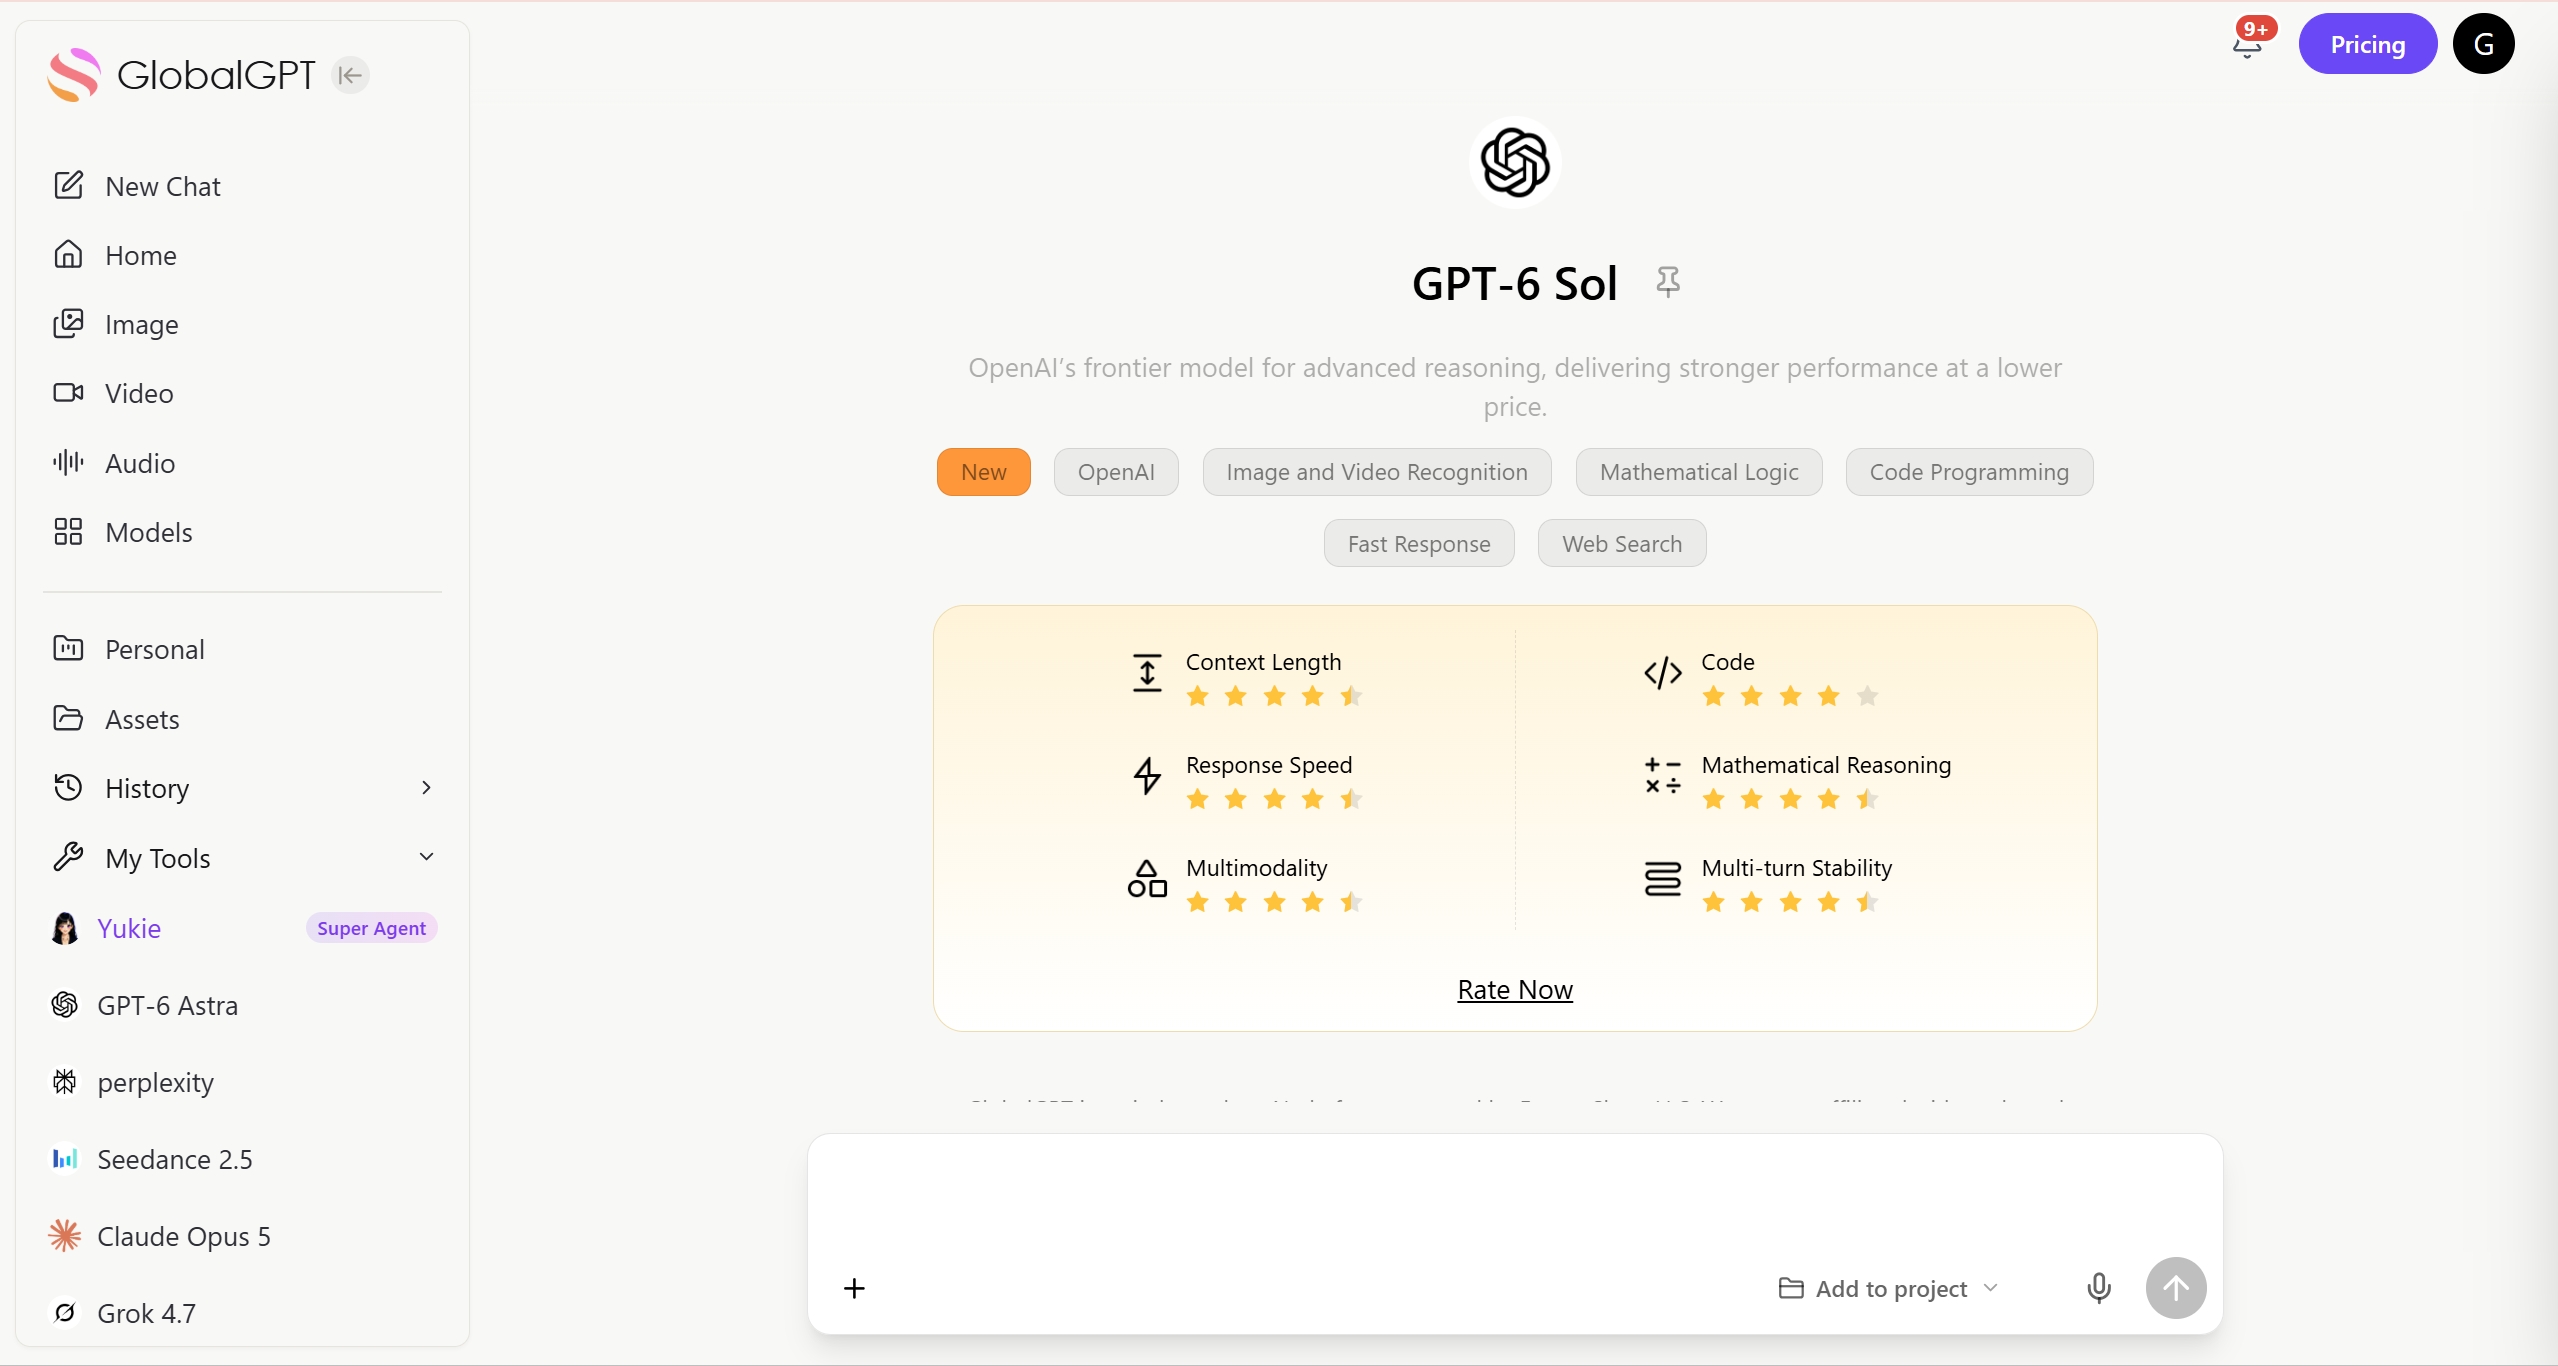
Sol — это подходящая модель для анализа в тех случаях, когда работа действительно сложна, требует интенсивного использования инструментов или ориентирована на код, и при этом допустим более высокий объем токенов. Данные в данном случае основаны на сочетании официальной документации и нашей небольшой выборки задач, а не на контролируемом тестировании, поэтому оправданным будет заключение о ее пригодности, а не универсальный рейтинг.
Наиболее полезное различие заключается не просто в противопоставлении “умного” и “быстрого”, а в характере рабочей нагрузки. GPT-6 Sol имеет те же максимальные показатели контекста и вывода, что и его аналог, но его позиционирование и цена делают целесообразным выбор иной рабочей точки. Сравните более широкий Руководство по выбору моделей искусственного интеллекта и Лучшая модель искусственного интеллекта для кодирования руководство для случаев, когда задача охватывает более одного поставщика.
Краткий обзор GPT-6 Sol
Приведенная ниже таблица соответствует действующим официальная страница модели GPT-6 Sol. Емкость контекста — это не то же самое, что рекомендуемый размер промпта, а максимальный объем входных данных не зависит от окна контекста заголовка.
gpt-6-solОбе родственные модели поддерживают структурированные результаты, вызов функций, потоковую обработку, кэширование подсказок, ввод изображений, поиск по файлам и веб-поиск в рамках описанного набора функций. Точное поведение инструмента по-прежнему зависит от конечной точки, учетной записи и настроек запроса; не следует делать вывод об успешном запуске инструмента только на основании того, что соответствующий флажок в списке возможностей установлен.
Что касается контекста на уровне семьи, то Обзор GPT-6 Astra показывает, как в аналогичной статье о GPT-6 разделены документация поставщика, маршруты платформы и реакции с атрибутами.
Стоимость GPT-6 Sol и правило 272K
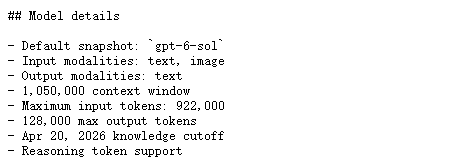
По стандартным тарифам Страница с ценами на OpenAI Указываются следующие показатели: $2.00 входных данных, $0.20 кешированных входных данных, $2.50 записей в кэш и $10.00 выходных данных на 1 млн токенов. Записи в кэш составляют 1,25-кратную величину от объема некешированных входных данных. Стоимость режимов Batch и Flex составляет 501 TP40T в стандартном режиме, в режиме Fast она в 2 раза выше применимой ставки, а при обработке в регионе добавляется 101 TP40T, если такая возможность доступна.
Столбец «Длинный контекст» рассчитывается по правилу OpenAI: при объёме входных данных свыше 272K скорости ввода и кэширования удваиваются, а скорость вывода умножается на 1,5 для всего запроса. Это не тариф со смешанными скоростями. Для практической базовой оценки бюджета 100K входных операций плюс 10K выходных операций обходятся примерно в $0.30 до учета инструментов или регионального подъема; пример с входными данными 300K и выходными данными 20K обходится примерно в $1.50 по тарифам с длительным контекстом.
Большое окно контекста может быть полезным, хотя его и не так просто заполнить. Поиск, выбор фрагментов, повторное использование кэша и ограничения на вывод данных имеют большее значение, чем цифра 1,05 млн в заголовке. См. Разбивка цен на GPT-6 Astra для получения соответствующих пояснений по поводу пороговых значений контекста и принципов работы кэша.
GPT-6 Sol: совместимость с API, инструменты и ограничения
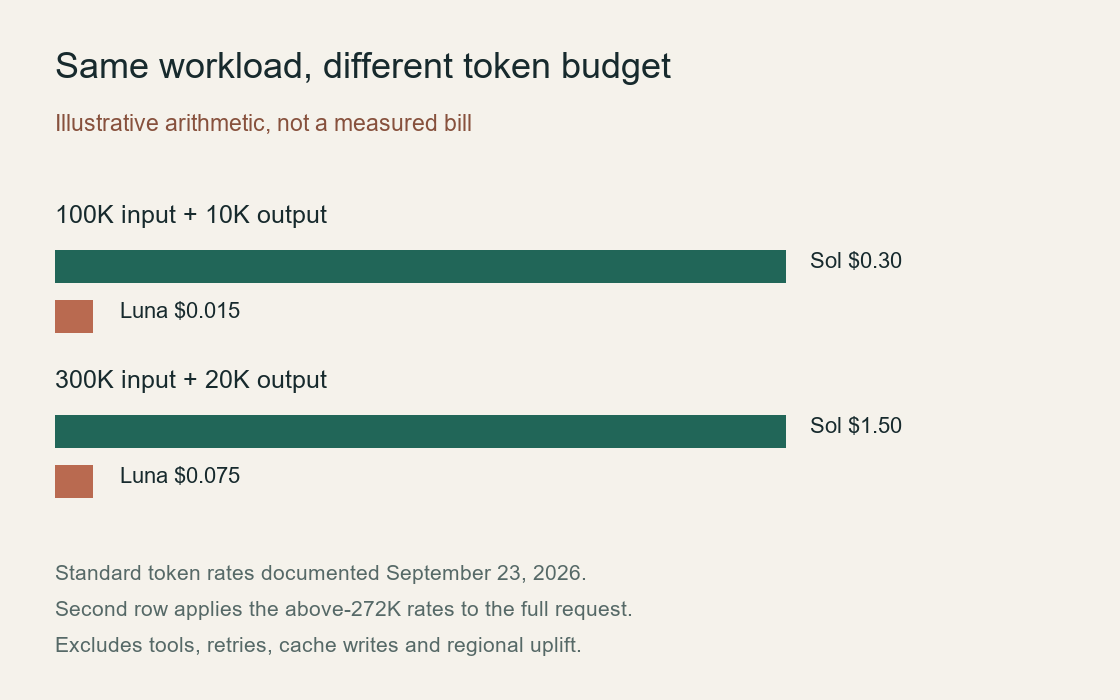
OpenAI рекомендует использовать API Responses для встроенных инструментов и вызова функций. Функция «Автозаполнение в чате» поддерживает вызов функций только в том случае, если логическое_усилие устанавливается на нет. Это деталь реализации, на которую стоит обратить внимание перед миграцией: запрос может быть синтаксически корректным, но при этом не соответствовать поведению инструмента, на которое рассчитана ваша текущая интеграция.
В текущей таблице ограничений скорости перечислены следующие стандартные уровни. RPM означает количество запросов в минуту, TPM — количество токенов в минуту, а значение «очередь» — ограничение на количество токенов в пакете.
Перед запуском в производственную среду проверьте в своей учетной записи точный уровень, конечную точку, режим потоковой передачи и контракт инструмента. Руководство по ограничениям использования Codex Это помогает понять, почему опубликованный лимит модели не совпадает с фактическим лимитом аккаунта.
Что следует из технических характеристик GPT-6 Sol
Это карта соответствий, а не эталон. Используйте Руководство по рабочему процессу с использованием универсальных моделей искусственного интеллекта когда на самом деле вам предстоит решить, как переключаться между моделями в рамках одного повторяемого процесса, а не какая из отдельных моделей кажется наиболее убедительной.
В ходе наших тестов: GPT-6 Sol в решении трёх практических задач
23 сентября 2026 года мы протестировали небольшое исправление в коде JavaScript, памятку по принятию решения, состоящую из трёх пунктов, и извлечение данных в формате JSON. Приведённые ниже результаты представляют собой полные ответы для модели с идентификатором gpt-6-sol. В ходе предыдущих попыток возникали ошибки временной перегрузки, поэтому эти результаты не следует рассматривать как измерения надёжности, полученные с первой попытки. Мы анализируем, что содержат ответы, что читатель может использовать повторно, а что остаётся непроверенным.
Исправление кода: сохранение нуля без переписывания функции
Проанализируйте эту небольшую функцию на JavaScript так, как если бы она была частью репозитория, используемого в производственной среде. Найдите ошибку, объясните, как она проявляется, и предложите минимальный патч, а также два целенаправленных регрессионных теста. Функция: function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }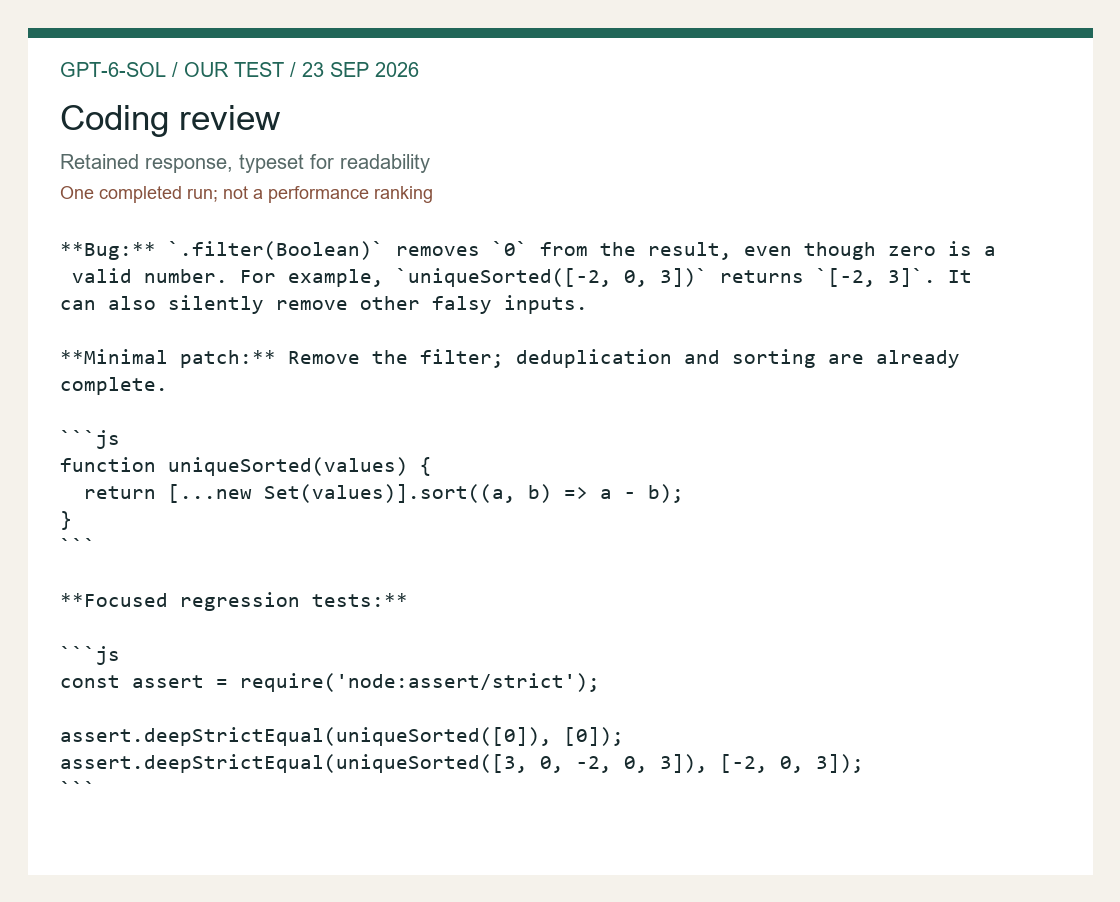
**Ошибка:** `.filter(Boolean)` удаляет `0` из результата, хотя ноль является допустимым числом. Например, `uniqueSorted([-2, 0, 3])` возвращает `[-2, 3]`. Кроме того, он может незаметно удалять и другие входные значения, которые оцениваются как ложь.

**Минимальный патч:** Удалить фильтр; удаление дубликатов и сортировка уже выполнены.

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

**Целевые регрессионные тесты:**

```js
const assert = require('node:assert/strict');

assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
```
Сообщенные данные об использовании данного завершенного ответа: 71 входной токен, 409 токенов завершения, всего 480 токенов. В использовании автозаполнения могут учитываться символы, обозначающие ход рассуждений; речь идет не просто о длине видимого ответа.
Сол обнаружил реальный дефект, а не переписал функцию с учётом постороннего предпочтения. Итоговый .filter(Boolean) исключает ноль, поскольку JavaScript преобразует ноль в значение false. Удаление дубликатов и сортировка чисел по возрастанию уже происходят до этого фильтра. Поэтому удаление только этого фильтра устраняет показанную ошибку, оставляя остальную часть алгоритма без изменений. Это именно тот вид небольшого исправления, который рецензент может быстро понять: в пояснении указано значение, вызывающее сбой, исправление направлено на соответствующую операцию, а тесты демонстрируют ожидаемое поведение.
Эти два утверждения о регрессии выполняют разные задачи. Случай с синглатоном [0] выявляет дефект «исчезающего нуля». В смешанном случае сочетаются отрицательное число, ноль, положительное число и дубликаты, при этом проверяется, сохраняются ли результаты удаления дубликатов и числовой сортировки после редактирования. Сол также включил require('node:assert/strict'), поэтому зависимость утверждения становится очевидной. Эти подробности делают ответ более полезным, чем патч, сопровождаемый расплывчатыми рекомендациями добавить тесты. Однако они по-прежнему не дают представления о том, как Sol будет проверять репозиторий, разрешать импорты между файлами или обрабатывать сбой сборки.
Помимо обнаруженной ошибки возникает вопрос, касающийся соглашения. Должна ли эта функция принимать только конечные числа или произвольные значения JavaScript? Удаление фильтра также приводит к сохранению других ложных входных данных, если вызывающие функции их передают. Для NaN, отрицательного нуля, бесконечностей, числовых строк и null требуются осознанные решения в рамках политики. Без такой политики мы бы не стали незаметно добавлять принудительное преобразование или валидацию в этот патч. Минимальное исправление ценно именно потому, что оно отделяет подтвержденный дефект от более широкой переработки кода.
Синтез из трёх нот: сохранение условности решения
Объедините следующие три заметки в краткую служебную записку с изложением решения, в которой должны быть указаны: решение, обоснование, риски и дальнейшие действия. Примечание A: Контекстное окно объемом 1,05 млн токенов может вмещать большие наборы исходных данных, но не делает каждый запрос недорогим. Примечание B: При количестве входных токенов свыше 272K задокументированные показатели ввода/кэширования увеличиваются, а объем вывода умножается для полного запроса. Примечание C: Извлечение и повторное использование кэша могут снизить затраты на повторные промпты, но критерии приемлемости все равно необходимо тестировать.
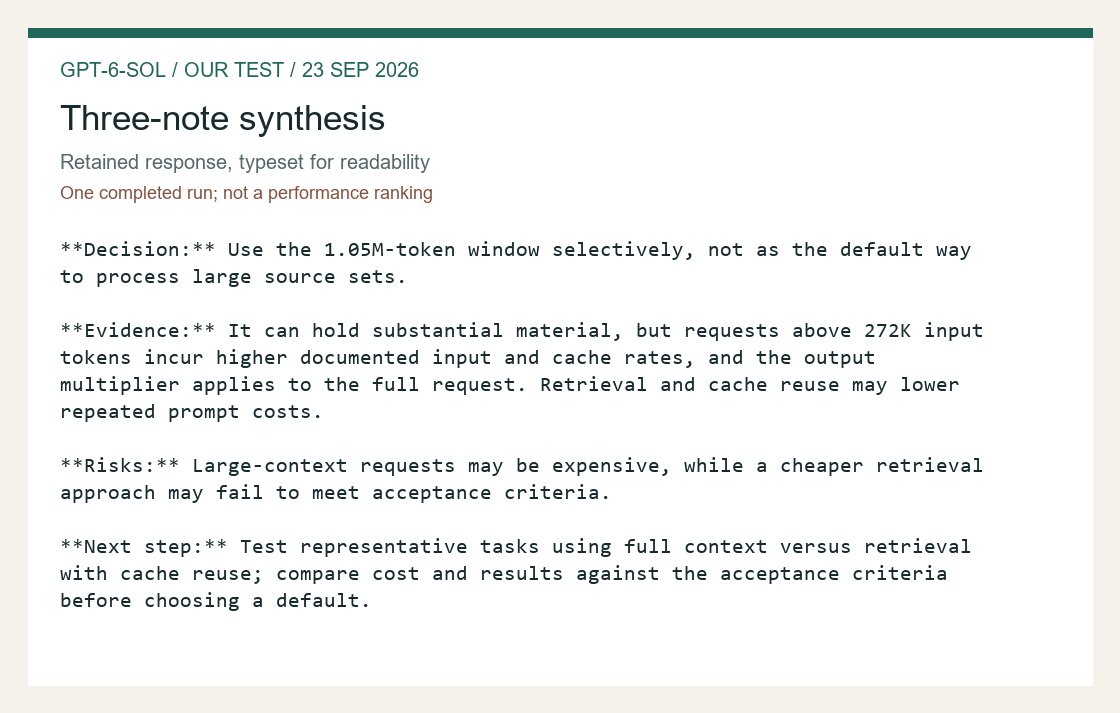
**Решение:** Использовать окно размером 1,05 млн токенов выборочно, а не в качестве стандартного способа обработки больших наборов исходных данных.

**Обоснование:** Оно может вместить значительный объем материала, однако запросы, превышающие 272K входных токенов, приводят к более высоким задокументированным показателям ввода и кэширования, а множитель вывода применяется ко всему запросу. Извлечение и повторное использование кэша могут снизить затраты на повторные запросы.

**Риски:** Запросы с большим контекстом могут быть дорогостоящими, в то время как более экономичный подход с извлечением может не соответствовать критериям приемлемости.

**Следующий шаг:** Протестировать типичные задачи, используя полный контекст в сравнении с извлечением с повторным использованием кэша; сравнить затраты и результаты с критериями приемлемости перед выбором варианта по умолчанию.
Сообщенные данные об использовании данного завершенного ответа: 99 входных токенов, 186 токенов завершения, всего 285 токенов. В использовании автозаполнения могут учитываться символы, обозначающие ход рассуждений; речь идет не просто о длине видимого ответа.
Sol сгруппировал три заметки по следующим категориям: «решение», «доказательства», «риски» и «следующий шаг». В качестве рекомендации было предложено выборочное использование большого окна, при этом извлечение данных и повторное использование кэша должны оцениваться с учетом критериев приемлемости. Полезным поведением было сохранение условной формулировки: извлечение данных может снизить затраты, но только тест рабочей нагрузки может установить, сохраняется ли при этом информация, необходимая для принятия решения. В ответе не было указано процентное соотношение экономии, измеренного показателя полноты поиска или рекомендации всегда отправлять максимальный контекст.
Этот ввод состоял всего из 99 указанных токенов подсказки. Он проверяет синтез коротких заметок и выполнение инструкций, а не способность извлекать скрытый факт из сотен тысяч токенов. Указания по ценам были приведены в заметках; их правильное повторение не является независимой проверкой цен. В случае реальной служебной записки по архитектуре мы бы добавили идентификаторы источников, лицо, принимающее решение, и явно указанные бюджетные допущения. Эти дополнения сделали бы каждое предложение поддающимся проверке, не создавая при этом иллюзию, что это краткое упражнение охватывает полное контекстное окно.
Извлечение данных из JSON: явное указание неизвестных значений
Извлеките из данного технического задания следующие поля и верните только корректный JSON-объект с ключами «customer», «priority», «deadline» и «unknowns». Техническое задание: Заказчик: Northwind Labs. Приоритет: высокий. Срок выполнения: 04.10.2026. Ответственное лицо не указано, бюджет не подтвержден.
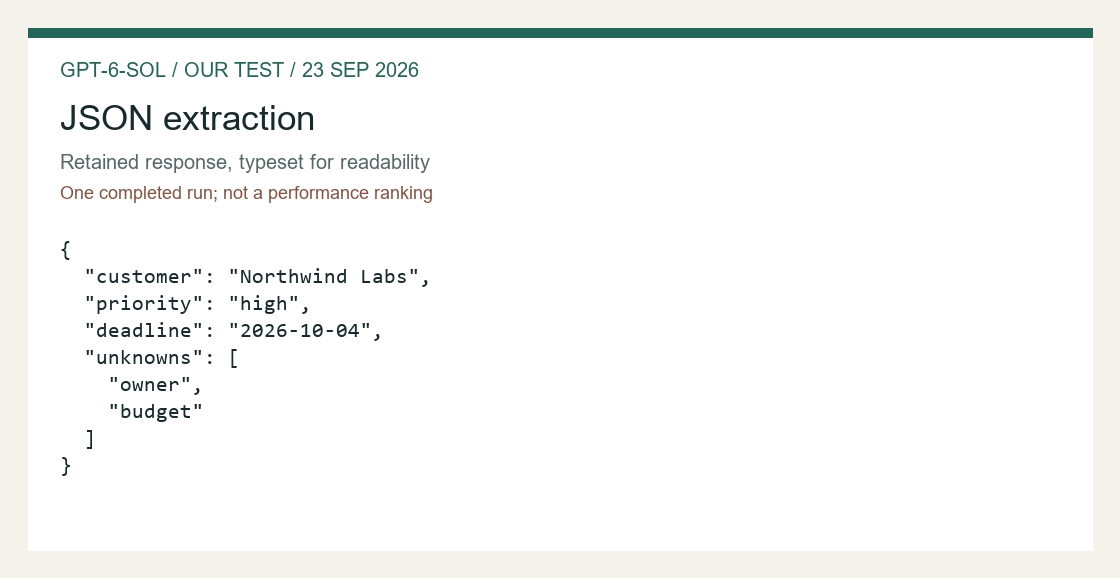
{"заказчик":"Northwind Labs","приоритет":"высокий","срок выполнения":"2026-10-04","неизвестные параметры":["ответственное лицо","бюджет"]}Сообщенные данные об использовании данного завершенного ответа: 64 входных токена, 64 токена завершения, всего 128 токенов. В использовании автозаполнения могут учитываться символы, обозначающие ход рассуждений; речь идет не просто о длине видимого ответа.
Sol вернул именно те поля, которые запрашивались: «клиент», «приоритет», «срок» и «неизвестные». В списке «неизвестных» были сохранены отсутствующие данные о владельце и неподтвержденном бюджете, вместо того чтобы заполнять их вероятными предположениями. Это значимый успех для данной небольшой задачи: последующая система сможет отличить известный срок от отсутствующей информации. Вывод также не содержал разделителя Markdown или пояснительного введения, что позволяло напрямую анализировать его как JSON.
Тот же JSON появился в сохраненном результате Luna. В данном случае не наблюдается преимуществ в качестве извлечения, которые оправдывали бы оплату более высокой ставки Sol за этот конкретный входной набор данных. Sol всё же может стоить рассмотрения, когда извлечение зависит от разрешения противоречий между несколькими документами, но это уже другая задача. Нашей практической отправной точкой будет более дешёвый проверенный способ извлечения с эскалацией в случае противоречивых данных, а не использование самой дорогой модели для каждой записи.
Работоспособная регрессионная проверка для выявленного дефекта
Ниже приведён пример редакционной проверки, а не дополнительный ответ модели. Он запускается локально в Node.js и не отправляет запросов к модели. Он проверяет конкретный фикстур, о котором говорилось выше; это не является общей оценкой модели.
const assert = require('node:assert/strict');
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
assert.deepStrictEqual(uniqueSorted([0]), [0]);
assert.deepStrictEqual(uniqueSorted([3, 0, -2, 0, 3]), [-2, 0, 3]);
assert.deepStrictEqual(uniqueSorted([]), []);
const original = values => [...new Set(values)].sort((a, b) => a - b).filter(Boolean);
assert.notDeepStrictEqual(original([0]), [0]);
console.log('Патч прошел успешно; исходный дефект с нулевым значением воспроизведён.');
Заключительное отрицательное утверждение подтверждает, что исходная функция теряет нуль. Это придаёт проверке чувствительность к сбоям: тест не просто принимает новую реализацию, но и демонстрирует симптом, который должно устранить данное изменение. Случай с пустым массивом представляет собой дополнительную редакционную проверку, чётко отделённую от двух утверждений, предусмотренных моделью. В производственном коде разместите тест рядом с реальной функцией и запустите фактическую команду тестирования проекта; копирование функции в отдельный тестовый файл не позволяет выявить ошибки интеграции.
Как GPT-6 Sol меняет реальный рабочий процесс
Основные технические характеристики имеют значение только в том случае, если они меняют подход к работе команды. GPT-6 Sol предназначен для сложного программирования и агентных рабочих процессов, поэтому в первую очередь следует задаться вопросом: подходит ли эта модель для вашей рабочей нагрузки? Если каждый запрос имеет короткий входной поток, узкий контракт на выходные данные и чёткий приёмный тест, модель может быть интегрирована в повторяемый конвейер. Если же задача неоднозначна, требует интенсивного использования инструментов или, скорее всего, потребует нескольких циклов корректировки, то организация рабочего процесса имеет не меньшее значение, чем название самой модели.
Для GPT-6 Sol эффективной схмой генерации ответов является двухэтапный подход: сначала запрашивается лаконичный ответ с явным указанием степени неопределённости, а затем на второй этап отправляется только та часть, которая вызывает сомнения или является неполной. Это ограничивает количество ненужных токенов в выводе и делает ошибки заметными. Кроме того, это дает вам более точку для сравнения с GPT-6 Luna: вопрос не в том, какое название звучит убедительнее, а в том, какой алгоритм достигает критериев приемлемости с меньшим количеством повторных попыток.
Простая модель расчета затрат перед отправкой
Официальную таблицу цен следует пересчитать в единицы измерения, которые фактически использует ваша команда: количество запросов в день, среднее количество входных токенов, доля кэшированных префиксов, количество выходных токенов и процент вызовов, в которых количество входных данных превышает 272K. Таблица, в которой отражена только основная цена за входные данные, не учитывает множитель, зависящий от длительности контекста, и затраты на повторные попытки.
Этот расчет особенно актуален при сравнении GPT-6 Sol и GPT-6 Luna. Более дешевый запрос может обойтись дорого, если потребуется несколько циклов доработки; более мощный запрос может оказаться излишним, если речь идет о детерминированном извлечении информации. Наилучшим эталоном служит небольшая выборка вашего собственного трафика с использованием тех же подсказок, той же схемы и тех же правил проверки.
Типы отказов, которые необходимо проверить перед вводом в эксплуатацию
На странице модели можно узнать, какие конечные точки и методы обрабатываются, но она не может гарантировать, что ваше существующее приложение будет вести себя так же после миграции. Проверьте, правильно ли анализируются потоковые события, сохраняется ли состояние при повторных вызовах инструментов, отклоняет ли структурированный вывод поля с некорректным форматом и фиксирует ли ваш конвейер ведения журнала идентификатор модели и настройки вывода заключений для каждого запроса.
Именно эти критерии делают практические наблюдения, приведенные в данном обзоре, полезными, не превращая их при этом в рейтинг. Наши три задачи демонстрируют, как маршрут справился с небольшим дефектом в коде, служебной запиской и строгим извлечением данных в формате JSON. Они не позволяют определить задержку, надежность при масштабировании или составить универсальный рейтинг качества.
Система принятия решений для реальных команд
Анализ модели полезен, когда он помогает принять решение в условиях определенных ограничений. Для GPT-6 Sol наиболее значимыми ограничениями являются форма запроса, стоимость анализа, размер контекста, формат вывода и последствия неправильного ответа. Описание поставщика указывает на сложное кодирование и агентные рабочие процессы, но команде всё равно необходимо преобразовать это описание в маршрут, который она сможет контролировать. Начните с того, что сформулируйте задачу одним предложением, укажите входные данные, которые получит модель, выходные данные, ожидаемые другой системой, а также контрольную точку, обеспечиваемую человеком, которая предотвращает незаметную ошибку.
Первая ошибка — выбор модели на основе демо-задания. Демо-задание поощряет беглость ответа и скрывает операционные детали, такие как повторные попытки, подсчёт токенов, разрешения на использование инструментов и сбои схемы. Более адекватное сравнение предполагает использование трёх типичных заданий: одного обычного запроса, одного сложного запроса и одного запроса, который должен быть отклонён или перенаправлен на более высокий уровень. Результатом является не просто единая оценка, а небольшая схема, показывающая, в каких случаях модель позволяет сэкономить время, в каких требует контроля, а в каких более выгодным или безопасным выбором будет другая модель — зачастую GPT-6 Luna.
Начните с приемочного тестирования
Сначала напишите приемочный тест, а уже потом — задание. В случае с кодом тестом может служить успешно прошедший модульный тест или патч, не изменяющий публичный API. В случае извлечения данных — это может быть корректный JSON-файл, содержащий все обязательные ключи и явно сохраняющий неизвестные значения. В случае служебной записки с решением — это может быть фиксированная структура, включающая доказательства, риски, ответственное лицо и следующий шаг. Модель можно оценить только по видимой цели. Без этой цели отполированный абзац может выглядеть удачным, хотя в нём незаметно пропущено именно то поле, которое необходимо для последующего процесса.
Хороший приемочный тест должен быть достаточно узконаправленным, чтобы его можно было запускать автоматически, и достаточно содержательным, чтобы обеспечить защиту пользователя. Он также должен позволять четко выявить несоответствия. Если два результата различаются, команда должна иметь возможность указать на отсутствующий факт, необоснованное предположение, некорректно заполненное поле или неверный расчет. Такой подход более конструктивен, чем просто сказать, что один из ответов “выглядел более разумным”. В этом также заключается разница между проверкой, которая помогает процессу закупки, и проверкой, которая просто повторяет формулировки из анонса запуска.
Используйте название модели для выбора исходной гипотезы. Опирайтесь на результаты приемочных испытаний, чтобы определить, выдержит ли гипотеза проверку в условиях реальной эксплуатации.
Оптимальная конструкция, соответствующая профилю модели
Не следует копировать одну и ту же подсказку без изменений для всех моделей. Описание задачи может оставаться неизменным, но объем контекста, инструкции по рассуждениям и ограничения на выходные данные должны соответствовать конкретному случаю. Для GPT-6 Sol инструкции системы должны быть достаточно краткими, чтобы не конкурировать с исходным материалом. Укажите роль, правило принятия решения, требуемый формат вывода, а также условия, при которых требуется явное указание неизвестного параметра или эскалация.
В случае длинных документов следует отделять поиск от вывода. Сначала необходимо выявить фрагменты, отвечающие на вопрос; затем сформулировать вывод, используя только эти фрагменты и указанные критерии. Это снижает вероятность того, что уверенное утверждение будет построено на основе отдаленной, нерелевантной детали. Кроме того, это позволяет использовать контекстное окно размером 1,05 млн токенов не как стандартное значение по умолчанию, а как инструмент. Широкий контекст ценен, когда важна взаимосвязь между удалёнными доказательствами. Он является излишним, когда задачу можно решить с помощью небольшого, тщательно подобранного набора фрагментов.
В рабочих процессах, использующих инструменты, необходимо описать границу между моделью и инструментом. Модель должна определять, нужен ли инструмент, предоставлять аргументы в строгой схеме и объяснять, что она будет делать с возвращаемым значением. Приложение должно обеспечивать соблюдение прав доступа, проверять аргументы, регистрировать вызов и определять, можно ли повторить вызов инструмента в случае сбоя. Рассматривание модели как всего приложения в целом затрудняет отладку и увеличивает масштаб последствий ошибочного допущения.
Многоразовый подсказчик из четырёх частей
Контекст: Приводите только те факты и документы, которые необходимы для выполнения задания. Цель: Опишите решение или преобразование одним предложением. Ограничения: укажите формат, исключения, подход к обработке погрешностей и пределы инструмента. Проверьте: попросите модель перечислить недостающие входные данные или противоречия, прежде чем она сформирует окончательный ответ. Эта структура достаточно лаконична для многократного использования и достаточно конкретна, чтобы сравнивать результаты разных моделей.
Когда помогает большое контекстное окно
Заголовок «1,05 млн токенов» легко повторить и легко неправильно использовать. Окно контекста показывает, сколько материала может поместиться в запросе; оно не указывает, сколько материала следует отправить, насколько эффективно модель будет использовать каждый фрагмент или во сколько обойдётся запрос. Длинный запрос также может замедлить процесс проверки, поскольку команде приходится анализировать больше данных, а вероятность возникновения тонких противоречий в инструкциях возрастает.
Используйте полное окно, если задача действительно зависит от отдаленных ссылок: например, в случае контракта, где определения отделены от исключений, репозитория, в котором интерфейсы и реализации находятся далеко друг от друга, или обширного архива исследований, где для получения ответа требуется отслеживание последовательности. Используйте поиск, если запрос носит локальный характер, если набор источников часто меняется или если вам нужна компактная цепочка ссылок. Используйте кэширование, когда стабильный префикс повторно используется во многих запросах, а платформа предоставляет достаточно подробных сведений об использовании, чтобы подтвердить работоспособность кэша.
Пороговое значение в 272K должно быть указано на схеме архитектуры, а не в сноске в разделе о ценообразовании. Запрос, стоимость которого не превышает это пороговое значение, может стать существенно дороже при его превышении. Команды должны регистрировать в журнале входные токены, кэшированные токены, выходные токены, идентификатор модели, настройки рассуждений, а также информацию о том, превысил ли запрос порог. Такой журнал поддерживает модель реальных затрат и позволяет выявлять случайное увеличение объема контекста до того, как оно станет неприятным сюрпризом в конце месяца.
Вопросы по миграции API, которые требуют тестирования на промежуточном сервере
Прежде чем переносить существующую интеграцию в GPT-6 Sol, создайте тестовую среду, которая воспроизводит небольшую анонимизированную выборку. Сравните итоговый текст, структурированные поля, вызовы инструментов, причины остановки и использование токенов. Не сравнивайте только первый экран ответа. Модель может сохранить видимый вывод, изменив при этом название поля, опустив условие ошибки или вернув аргумент инструмента, который приложение не может безопасно выполнить.
«Ответы» и «Завершения чата» — это не взаимозаменяемые метки в плане интеграции. На работу адаптера влияют поддержка конечных точек, настройки логического вывода, поведение инструментов, потоковые события и объекты ошибок. Закрепите идентификатор модели в конфигурации, но оставьте его видимым в журналах и отчетах о тестировании. При сбое запроса в записи должны отображаться конечная точка, модель, затраты на вывод, версия подсказки, размер запроса и решение о повторной попытке. Эти данные позволяют инженеру воспроизвести сбой, а не спорить о том, просто ли у модели был «плохой день».
Пакетная обработка меняет экономику и ритм работы. Она может быть целесообразной для ночной классификации, подготовки документов или очереди преобразований с низкой степенью срочности. Она плохо подходит для интерактивных действий, требующих обратной связи с пользователем. Быстрый и региональный режимы также влияют на расчет стоимости. Рассматривайте их как явные параметры конфигурации и отражайте в таблице бюджета, а не скрывайте в настройках по умолчанию.
Перед изменением значения по умолчанию в производственной среде необходимо воспроизвести входные данные представителя, проверить правильность структурированного вывода, зафиксировать аргументы инструмента, сравнить причины остановки, оценить использование токенов и протестировать один из сценариев сбоя.
Качество, безопасность и стоимость проверки
Более низкая стоимость токена не означает автоматически более низкую совокупную стоимость, а более дорогая модель не гарантирует автоматически лучших бизнес-результатов. Совокупная стоимость включает повторные попытки, проверку специалистом, устранение инцидентов и работу, необходимую для исправления данных на последующих этапах. Полезным показателем является стоимость одного принятого результата, с разбивкой по группам задач. Маршрут, который обходится немного дороже на один запрос, всё равно может оказаться выгоднее, если он сокращает объём работ по исправлению результатов в задачах с высоким уровнем риска; очень дешёвый маршрут может оказаться бесспорно выгоднее при детерминированном извлечении данных с тщательной валидацией.
Риски следует классифицировать по типу действия, а не по бренду модели. Чтение публичного документа и составление его резюме отличается от изменения записи о клиенте, утверждения платежа, удаления данных или публикации юридического заявления. Необратимые действия должны проходить через контроль со стороны человека или второй независимый этап проверки. Попросите модель выявлять неопределенности, но никогда не рассматривайте фразу, звучащую как выражение уверенности, в качестве системы разрешений.
Вопросы, касающиеся конфиденциальности и сроков хранения данных, должны рассматриваться в рамках проверки развертывания. Уточните, какие данные передаются, как долго хранятся журналы, кто может просматривать запросы, а также содержит ли запрос конфиденциальную информацию или персональные данные. По возможности удаляйте конфиденциальную информацию, сводите контекст к минимуму и ведите четкий учет того, какие поля были удалены. Эти меры контроля применяются независимо от того, используется ли модель через официальный API или по другому совместимому каналу.
Как сравнить GPT-6 Sol и GPT-6 Luna
Для объективного сравнения необходимо сохранять неизменными задачу и правило принятия, позволяя при этом каждой модели использовать свои задокументированные преимущества. Запустите один и тот же входной пакет, но фиксируйте, требуется ли модели иная настройка вывода заключений или иная конечная точка. Чётко опишите различия: одна модель может генерировать более полный патч, другая — быть более экономичной при многократном извлечении, а третья — проще интегрироваться, поскольку её инструментальный контракт соответствует вашему текущему адаптеру.
Не следует превращать одно успешное выполнение задачи в общий рейтинг. Три небольшие задачи полезны для выявления проблем в рабочем процессе, а не для доказательства существования универсального победителя. Повторите задачу с несколькими реалистичными входными данными, включите как минимум один враждебный или неполный случай и заранее определите, что считается успешным выполнением. Если выборка слишком мала, чтобы сделать вывод, скажите об этом. Такая осторожность укрепляет доверие, а не ослабляет рецензию.
Поэтапное внедрение, при котором решение можно отменить
Начните с тестового трафика или некритической очереди. Позвольте новому маршруту генерировать ответ, при этом существующий маршрут останется эталоном. Сравните коэффициент принятия, стоимость токенов, время проверки и категории сбоев за фиксированный период. Затем переносите по одному семейству задач за раз, сохраняя переключатель для отката и метку текущей версии. Поэтапное внедрение превращает выбор модели в наблюдаемое инженерное изменение, а не в однодневную замену.
В ходе внедрения обращайте внимание на изменения, которые не отражаются в простом показателе успешности: более длительные результаты, большее количество вызовов инструментов, большее количество эскалаций или большее количество запросов, превышающих порог длительного контекста. Модель может казаться точной, но при этом расходовать больше бюджета или увеличивать нагрузку на операторов. Настройте оповещения по этим показателям и анализируйте их совместно с сотрудниками, которые непосредственно занимаются устранением исключений.
Как выглядит успех
Успех — это стабильный маршрут с известной стоимостью, очевидными признаками неудачи и процессом проверки, которому люди могут следовать. Для этого не нужно делать вид, что модель идеальна. Нужно знать, с какими задачами она справляется хорошо, для каких задач требуется другой подход, и как остановить или скорректировать её работу, если входные данные неполны. Именно это и является практическим стандартом, лежащим в основе наблюдений и документации, собранных в рамках данного обзора.
О чём может рассказать реакция общественности, а о чём — нет
Приведенные ниже источники включены в качестве отражения общественной реакции с указанием авторства, а не в качестве официальной документации или контролируемых данных тестов производительности. Их названия отражают то, что каждый автор решил проверить или объяснить; они не отражают результаты в масштабах всего рынка.
- Нейт Херк | Автоматизация с помощью ИИ: Я проверил Opus 5.5 и GPT-6 Sol на 10 реальных сценариях использования. Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
- Arena AI: GPT-6 Sol | Первые впечатления. Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
- Chase AI: GPT 6 Sol и Luna уже в продаже (и на 50% дешевле!). Рассматривайте ракурс и любую демонстрацию как личный опыт автора, а не как универсальный образец.
Здесь важен еще один момент, связанный с наименованием: в названиях нескольких общедоступных видео термины “GPT-6” и “GPT-5.6” используются как синонимы. При цитировании утверждения указывайте точный идентификатор модели. Сравнение GPT-6 Astra и GPT-5.6 Sol Это наглядный пример того, почему идентификатор провайдера, метку платформы и маршрут следует регистрировать отдельно.
Как получить доступ к GPT-6 Sol
Откройте Рабочая область GPT-6 Sol Начните с задачи, которую можно оценить: небольшого примера кода, короткого пакета исходного кода или структурированного задания на извлечение данных. При сравнении версий держите на виду требуемый результат и критерии приемки. Указанные выше официальные цены на токены относятся к прямому использованию API и не являются обещанием в отношении кредитов рабочей среды или лимитов по подписке.
Информацию о текущей системе наименования платформ и принципах указания отдельных авторов см. в Руководство по ценам на GPT-5.6 и Сравнение моделей GPT-5.6. Эти страницы отражают особенности платформы и редакционную политику; они не имеют приоритета над таблицей цен API OpenAI.
Приведите типичную задачу и сравните результат с вашими собственными критериями приемки.
Открыть рабочую область GPT-6 SolКому стоит выбрать GPT-6 Sol?
Если в ваш список финалистов вошли более недорогие варианты, сравните более обширный каталог моделей а не исходить из того, что новейшая модель автоматически является наиболее выгодным вариантом. Если вы оцениваете задачи с большим объемом данных, то Руководство по моделированию анализа данных предоставляет отдельный модуль для организации рабочего процесса.
Часто задаваемые вопросы
Что такое GPT-6 Sol?
GPT-6 Sol — это модель OpenAI, предназначенная для обработки сложных кодирующих и агентных рабочих процессов. Официальный идентификатор модели в API — gpt-6-sol.
Сколько стоит GPT-6 Sol?
В таблице OpenAI указаны тарифы для GPT-6 Sol: $2.00 за 1 млн входных токенов, $0.20 за 1 млн кэшированных входных токенов, $2,50 за 1 млн записей в кэш и $10,00 за 1 млн выходных токенов по стандартным тарифам.
Что происходит при количестве входных токенов свыше 272K?
Когда объем запроса превышает 272K входных токенов, OpenAI применяет к всему запросу 2-кратную скорость ввода и кэширования, а также 1,5-кратную скорость вывода.
Каковы ограничения по контексту и выводу?
В спецификации GPT-6 Sol указано, что окно контекста составляет 1 050 000 токенов, максимальный объем входных данных — 922 000 токенов, а максимальный объем выходных данных — 128 000 токенов.
Каков порог знаний?
На текущей странице модели OpenAI в качестве даты окончания накопления знаний для GPT-6 Sol указано 20 апреля 2026 года.
Какие настройки логики доступны?
В документации по API описаны уровни затрат на рассуждения: none, low, medium, high, xhigh и max, причем по умолчанию установлен уровень medium.
Какие конечные точки API поддерживаются?
GPT-6 Sol поддерживает функции «Завершение чата», «Ответы» и «Пакетная обработка». На странице модели не указаны в списке поддерживаемых функций «Работа в реальном времени», «Помощники», аудио, видео, генерация изображений, вложения, точная настройка, модерация или устаревшие функции «Завершение».
Может ли GPT-6 Sol принимать изображения?
Да. На странице модели указаны входные данные в виде текста и изображений, а также текстовый вывод. Однако это не делает её моделью для генерации изображений.
Доступен ли GPT-6 Sol в версии GlobalGPT?
Воспользуйтесь специальной страницей модели GPT-6 Sol, ссылка на которую приведена выше. Кредиты рабочего пространства и лимиты тарифных планов не связаны с тарифами на прямые API-токены, описанными в данном обзоре.
В этой статье приводится тест производительности?
Он включает в себя три небольших задания для наблюдения, а не контролируемое сравнительное тестирование. При повторной попытке Луне потребовалась скорректированная инструкция по программированию. Эти результаты не позволяют определить однозначного победителя или оценить производительность в масштабе.
Окончательный вердикт
Sol — это модель, которую стоит рассмотреть в тех случаях, когда задача действительно сложна, требует интенсивного использования инструментов или ориентирована на код, и при этом допустим более высокий объем токенов. Приведенные здесь данные основаны на сочетании официальной документации и нашей небольшой выборки задач, а не на контролируемом тестировании, поэтому разумным будет считать эту модель подходящей, а не составлять универсальный рейтинг. Делайте выбор, исходя из приемлемых результатов и совокупных эксплуатационных затрат, а затем пересмотрите свой выбор при изменении рабочей нагрузки.
Проверено 23 сентября 2026 года. Официальные данные: разработчики OpenAI. Наименование маршрута на платформе: GlobalGPT. Реакция общественности: приведены ссылки на авторов и публикации с указанием авторства.









