
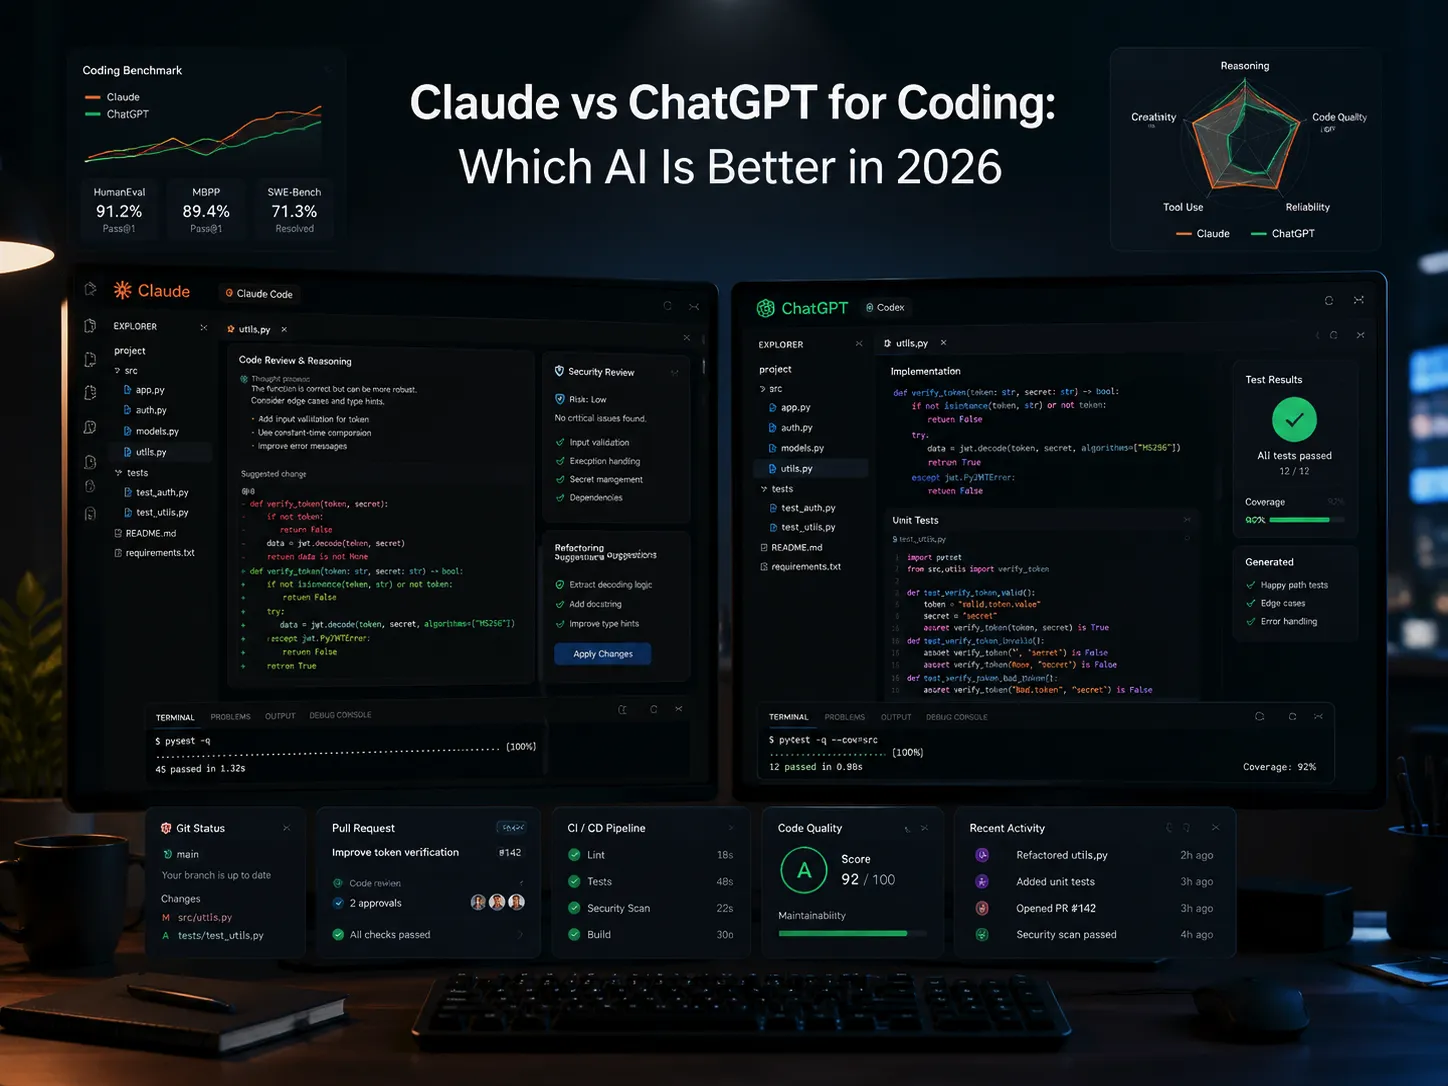
Dalam pengujian kami pada 7 Juli 2026, Claude Sonnet 5 terbukti lebih unggul sebagai langkah awal untuk tinjauan kode, analisis akar masalah, perencanaan arsitektur, dan penalaran konteks panjang. GPT-5.5 merupakan pilihan awal yang lebih baik ketika Anda membutuhkan draf implementasi lengkap, kerangka kerja pengujian yang dapat dijalankan, atau contoh kode yang siap disalin. Untuk pekerjaan di tingkat repositori, bandingkan Claude Code dengan Codex daripada menilai kedua perusahaan tersebut hanya berdasarkan jendela obrolan saja.
Pembagian yang berguna ini bukan sekadar “Claude menang” atau “ChatGPT menang.” Per 27 September 2026, jajaran produk Anthropic mencakup Claude Fable 5.1, Opus 5.5, Sonnet 5, dan Haiku 4.5; keluarga GPT-6 dari OpenAI mencakup Astra, Sol, dan Luna. Akses produk sangat penting: Sol dan Luna diluncurkan di ChatGPT Work, Codex, dan API, dengan pengumuman yang secara eksplisit mengecualikan Chat biasa. Bagian uji coba di bawah ini masih merupakan perbandingan yang sudah ketinggalan zaman antara Claude Sonnet 5 dan GPT-5.5, yang diuji dengan prompt yang sama pada 7 Juli 2026. Untuk perbandingan terkini, lihat Claude Opus 5.5 vs GPT-6 Sol.
Jika Anda ingin membandingkan berbagai model tanpa harus berganti-ganti langganan, GlobalGPT adalah ruang kerja multi-model yang praktis dengan GPT-6 Astra dan Claude Opus 5,5 tersedia di pemilih modelnya. Fitur ini berguna untuk membandingkan jawaban pemrograman, perencanaan, penulisan, dan penelitian, tetapi tidak dapat menggantikan Claude Code, Codex, API resmi, IDE, atau alur kerja pengembangan yang mendukung repositori.

Daftar isi
- Claude vs ChatGPT dalam hal pemrograman: jawaban singkat
- Apa yang berubah pada tahun 2026
- Jajaran model pengkodean saat ini
- Gambaran umum benchmark: SWE-Bench, Terminal-Bench, dan apa artinya
- Bagaimana kami menguji Claude dan ChatGPT dalam hal pemrograman
- Tes 1: debugging dan analisis akar masalah
- Uji Coba 2: refaktoring dan kemudahan pemeliharaan
- Tes 3: penalaran dan perencanaan multi-file
- Uji Coba 4: uji unit dan verifikasi
- Uji Coba 5: Penilaian Keamanan dan Keandalan
- Claude Code dan Codex: ketika obrolan saja tidak cukup
- Harga: Claude, ChatGPT, Codex, dan GlobalGPT
- Pengaturan pemrograman mana yang sebaiknya Anda pilih?
- Mengapa banyak pengembang masih menggunakan keduanya
- PERTANYAAN YANG SERING DIAJUKAN
Claude vs ChatGPT dalam Pemrograman: Jawaban Singkat
Dalam uji percakapan dengan prompt yang sama pada 7 Juli, Claude Sonnet 5 menunjukkan kinerja yang lebih baik pada tahap awal ketika masalahnya ambigu: model ini memprioritaskan penyebab yang paling mungkin, menyaring informasi yang tidak relevan, dan menjelaskan risiko dengan jelas. GPT-5.5 lebih unggul ketika langkah selanjutnya adalah draf implementasi yang lebih lengkap dengan impor, kerangka kerja pengujian, dan detail kode yang lebih rinci. Pengamatan tersebut menggambarkan pengujian tersebut, bukan setiap rilis model di masa depan.
Untuk pengembangan sehari-hari, alur kerja yang paling baik biasanya adalah:
- Gunakan Claude terlebih dahulu untuk tinjauan kode, penyaringan bug, pengambilan keputusan arsitektur, dan pertanyaan seperti “Apa yang sebaiknya saya periksa terlebih dahulu?”.
- Cobalah ChatGPT terlebih dahulu untuk membuat implementasi awal, menyusun kerangka kerja pengujian, menyusun contoh-contoh, dan mewujudkan rencana menjadi kode.
- Gunakan keduanya untuk migrasi, perubahan yang berdampak pada keamanan, pembayaran, otentikasi, pengunggahan berkas, dan segala hal yang berpotensi merusak data produksi.
| Kebutuhan pemrograman | Pilihan pertama yang lebih baik | Mengapa |
|---|---|---|
| Memperbaiki bug yang rumit | Claude pertama | Dalam pengujian kami, Claude mengutamakan penyebab yang paling mungkin dan menjelaskan jalur kegagalan dengan jelas. |
| Menyusun draf implementasi yang lengkap | ChatGPT terlebih dahulu | Dalam pengujian kami, GPT-5.5 menghasilkan kode yang lebih lengkap dan kerangka kode yang lebih siap pakai. |
| Meninjau risiko keamanan atau keandalan | Claude dulu, baru ChatGPT | Claude mengklasifikasikan tingkat keparahan dengan jelas; ChatGPT menambahkan pola implementasi yang konkret. |
| Mengubah berkas di seluruh repositori | Kode Claude atau Codex | Konteks repo, eksekusi perintah, pengujian, dan perbandingan (diffs) lebih penting daripada jawaban yang hanya berupa obrolan. |
Jika pertanyaan utama Anda adalah keluarga model mana yang paling baik untuk pemrograman secara umum, maka secara lebih luas model AI terbaik untuk pengkodean Perbandingan ini bisa menjadi bacaan lanjutan yang bermanfaat. Jika keputusan utama Anda berada dalam ekosistem OpenAI, panduan pemilihan model ChatGPT terbaik untuk pemrograman memberikan penjelasan lebih rinci mengenai pemilihan model GPT.
Apa yang Berubah pada Tahun 2026
Sebuah perbandingan yang bermanfaat untuk tahun 2026 harus memperhitungkan tiga perubahan.
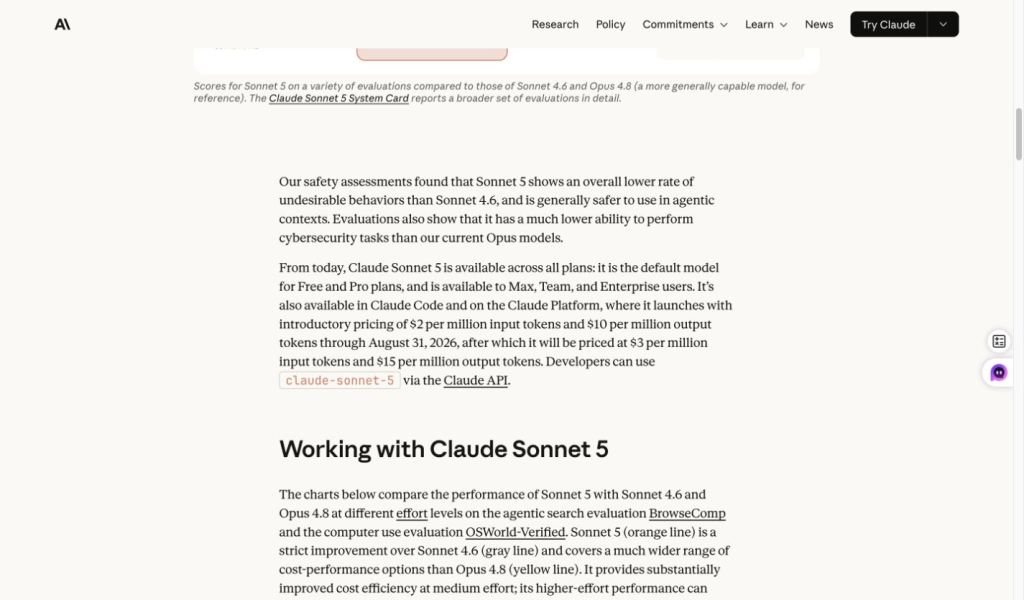
Pertama, Claude Sonnet 5 mengubah sisi Claude dalam keputusan tersebut. Anthropic menjelaskan bahwa Sonnet 5 tersedia di seluruh paket dan dalam Kode Claude, dengan akses ke Platform Claude bagi para pengembang. Hal ini penting karena Claude kini tidak lagi sekadar asisten obrolan untuk penjelasan pemrograman; melainkan merupakan bagian dari alur kerja agen pemrograman Anthropic.
Kedua, GPT-6 kini menjadi keluarga model yang digunakan OpenAI untuk pekerjaan pemrograman. Astra menargetkan bidang rekayasa perangkat lunak yang kompleks; Sol dan Luna menawarkan opsi dengan biaya lebih terjangkau. Pengumuman peluncuran OpenAI pada 22 September Mencantumkan Sol dan Luna dalam ChatGPT Work dan Codex untuk edisi Plus, Pro, Business, Enterprise, dan Edu, sementara Luna juga tersedia bagi pengguna Free dan Go di aplikasi desktop. Disebutkan secara eksplisit bahwa model-model ini belum tersedia di Chat. Akses API ditagih secara terpisah.
Ketiga, asisten obrolan dan agen pemrograman menangani bagian-bagian yang berbeda dari pekerjaan tersebut. Obrolan biasa berguna untuk cuplikan kode, debugging, penjelasan, dan perencanaan. Kode dan Kodeks Claude adalah alur kerja yang mendukung repositori, yang dirancang untuk memeriksa berkas, menjalankan perintah, menguji perubahan, dan menangani tugas-tugas berskala besar. Perbandingan yang adil memisahkan kualitas keluaran obrolan dari kemampuan produk agen pemrograman tersebut.
Daftar Model Pemrograman Saat Ini
Per 27 September 2026, perbandingan kode tersebut merupakan keputusan terkait susunan pemain, bukan sekadar pertarungan satu lawan satu antara Claude dan ChatGPT:
| Sisi | Model-model terkini yang patut dipertimbangkan | Penggunaan pemrograman terbaik |
|---|---|---|
| Claude | Claude Fable 5,1, Claude Opus 5,5, Claude Sonnet 5, dan Claude Haiku 4,5 | Tinjauan konteks jangka panjang, perencanaan, debugging, pemrograman berbasis agen, dan alur kerja Claude Code. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol, dan GPT-6 Luna; ketersediaannya berbeda-beda antara ChatGPT Work, Chat, Codex, dan API | Implementasi, pengembangan frontend, pengujian, alur kerja penggunaan alat, dan tugas-tugas Codex. |
| GlobalGPT | GPT-6 Astra dan Claude Opus 5.5, yang telah diverifikasi pada GlobalGPT; ini adalah langganan platform terpisah | Perbandingan prompt secara berdampingan, pertanyaan seputar kode sehari-hari, penelitian, dan evaluasi pendekatan. |
Jika Anda sedang melacak akses Claude dan rincian paket, lihat halaman terpisah Rencana Claude AI untuk Tahun 2026 panduan ini dan panduan harga AI Claude yang lebih mendalam. Jika Anda membandingkan paket OpenAI, rincian paket langganan ChatGPT tahun 2026 merupakan panduan pelengkap yang lebih jelas.
Gambaran Umum Tolok Ukur: SWE-Bench, Terminal-Bench, dan Maknanya
Tolok ukur berguna karena menunjukkan bagaimana model berperilaku dalam tugas-tugas pemrograman yang terkendali. Kuncinya adalah memahami apa yang sebenarnya diukur oleh masing-masing tolok ukur tersebut. Tolok ukur masalah repositori, tolok ukur agen terminal, dan tabel peluncuran model resmi bukanlah indikator yang sama, sehingga ketiganya sebaiknya digunakan bersamaan dengan uji coba praktis di bawah ini.
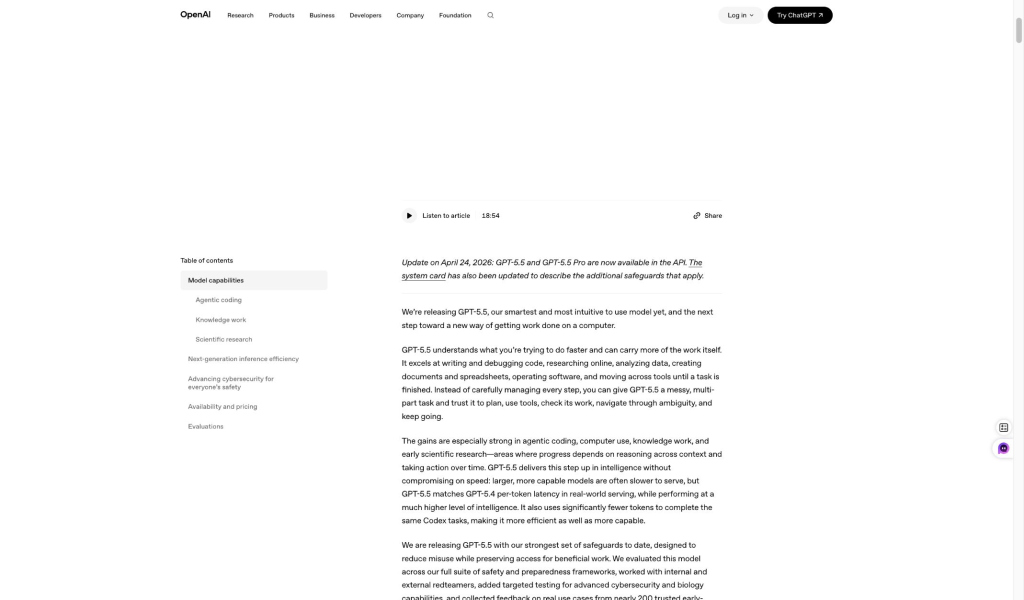
GPT-5.5: Bukti Kode Berdasarkan Tanggal Ujian
Materi GPT-5.5 di bawah ini tetap disertakan karena sesuai dengan model yang digunakan dalam perbandingan langsung pada 7 Juli. Material ini mendukung temuan-temuan yang berfokus pada implementasi dalam bagian pengujian, namun tidak boleh diartikan sebagai jajaran model OpenAI saat ini; GPT-6 kini menjadi keluarga model yang aktif, dengan akses yang bervariasi antara ChatGPT Work, Chat biasa, Codex, dan API.
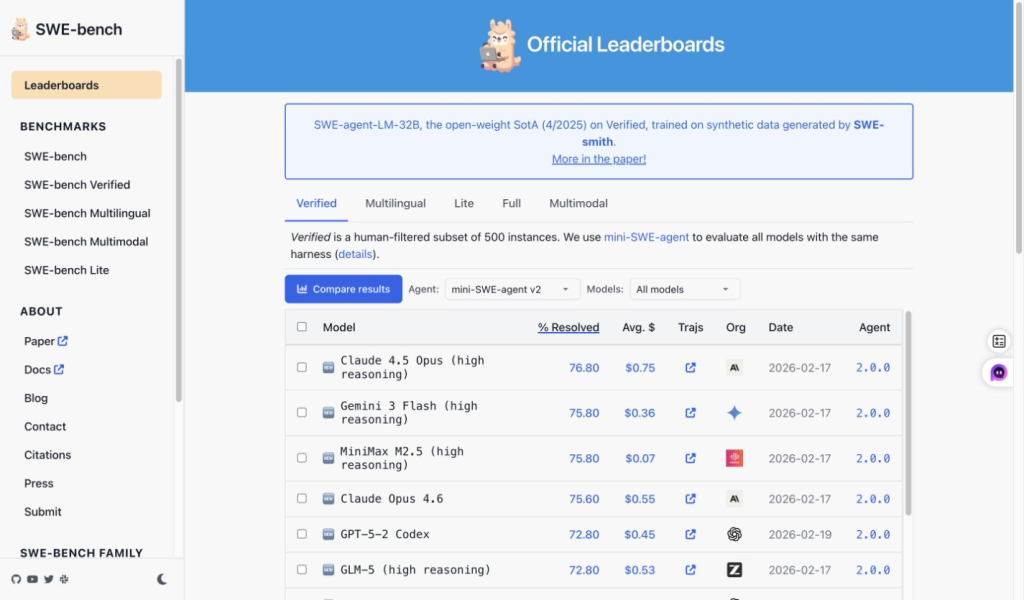
SWE-Bench: penyelesaian masalah repositori
SWE-Bench Hal ini berguna karena lebih mendekati pemeliharaan perangkat lunak yang sesungguhnya dibandingkan dengan prompt berupa potongan kode pendek. Sistem ini menganalisis masalah di repositori dan menilai apakah model dapat menghasilkan perubahan yang menyelesaikan tugas tersebut. Dalam perbandingan antara Claude dan ChatGPT, hal ini memberikan gambaran mengenai kekuatan rekayasa perangkat lunak, namun belum menceritakan keseluruhan cerita mengenai kualitas penjelasan, penilaian tinjauan, atau seberapa bermanfaat jawaban tersebut dirasakan dalam alur kerja obrolan.
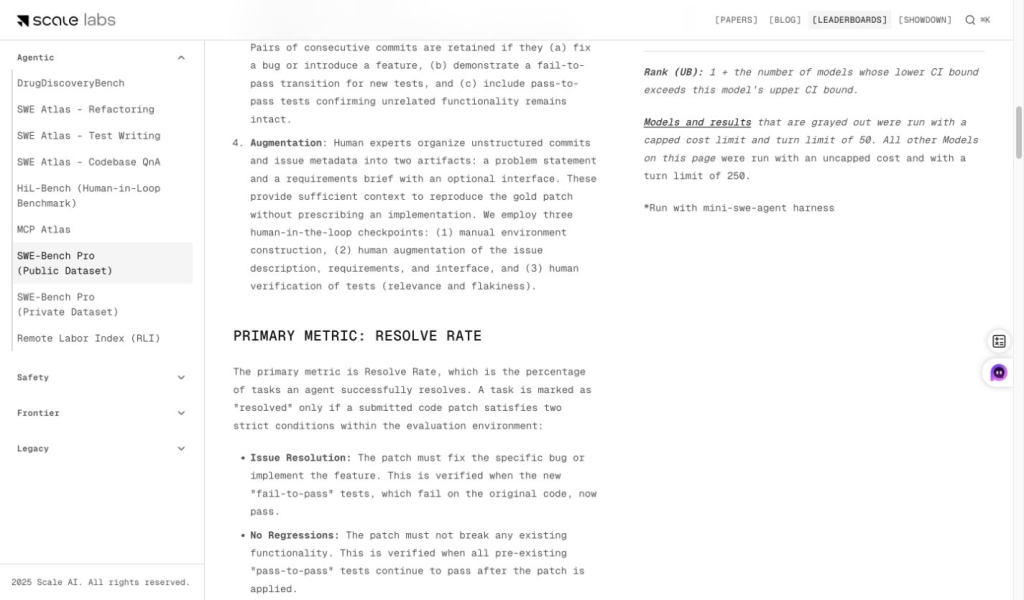
SWE-Bench Pro: tugas pemrograman yang lebih sulit dan tingkat keberhasilan
Papan peringkat publik SWE-Bench Pro dari Scale merupakan indikator yang lebih ketat karena berfokus pada tugas-tugas repositori yang lebih menantang dan menggunakan tingkat penyelesaian sebagai tolok ukur utamanya. Hal ini sangat berguna ketika Anda ingin menilai kemampuan agen pemrograman secara mendalam: bukan sekadar apakah model tersebut mampu menjelaskan suatu bug, melainkan apakah model tersebut mampu mengarahkan repositori menuju solusi yang berfungsi di bawah kondisi pengujian standar.
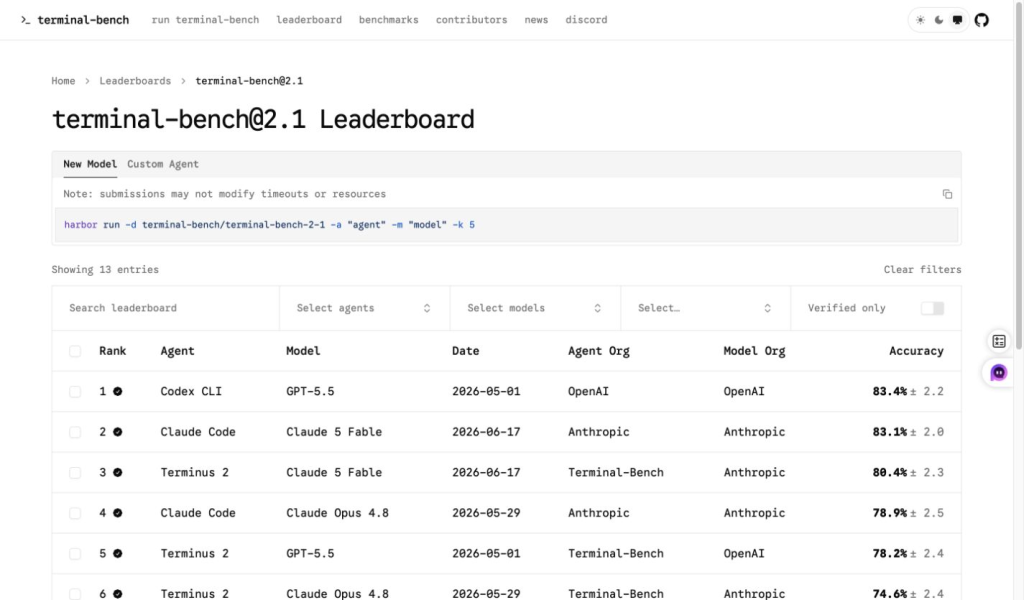
Terminal-Bench: tugas alur kerja baris perintah dan agen
Terminal-Bangku 2.1 Berbeda dengan SWE-Bench karena fokusnya pada penyelesaian tugas di terminal dan baris perintah melalui konfigurasi agen/model. Hal ini membuatnya lebih relevan untuk alur kerja bergaya Claude Code dan ChatGPT Codex daripada perintah obrolan biasa seperti “tulis fungsi ini”. Jika Anda sedang memilih asisten pemrograman untuk pekerjaan di tingkat repositori atau baris perintah, tolok ukur ini harus menjadi pertimbangan dalam pengambilan keputusan.
| Bukti | Bacaan terbaik untuk | Pelajaran praktis yang dapat dipetik |
|---|---|---|
| Materi pemrograman OpenAI GPT-5.5 | Pemrograman GPT-5.5 dan posisi rekayasa perangkat lunak berbasis agen. | Dukungan yang kuat terhadap ChatGPT sebagai asisten pemrograman yang berfokus pada implementasi. |
| SWE-Bench | Penyelesaian masalah pada repositori dan tugas-tugas pemeliharaan perangkat lunak. | Tanda yang baik untuk kemampuan pemrograman, terutama ketika konteks repositori menjadi faktor penting. |
| SWE-Bench Pro | Tugas-tugas repositori yang lebih sulit dan perbandingan tingkat penyelesaian. | Berguna untuk menilai kemampuan pengkodean agensial yang serius. |
| Terminal-Bangku 2.1 | Tugas-tugas terminal, eksekusi perintah, dan pengaturan agen/model. | Lebih relevan bagi alur kerja Claude Code dan Codex daripada sekadar prompt obrolan. |
Hasil pengujian perbandingan menjadikan kedua keluarga model tersebut sebagai pilihan pemrograman yang dapat diandalkan, namun hal itu belum menentukan pilihan dalam alur kerja sehari-hari. Bagian-bagian di bawah ini menggunakan prompt yang sama untuk debugging, refactoring, perencanaan, pengujian unit, dan tinjauan keamanan, sehingga Anda dapat melihat di mana jawabannya berbeda dalam praktiknya.
Bagaimana Kami Menguji Claude dan ChatGPT dalam Hal Pemrograman
Kami menguji GPT-5.5 dan Claude Sonnet 5 pada tanggal 7 Juli 2026 di GlobalGPT, dengan menggunakan antarmuka dan prompt yang sama. Tujuannya bukanlah untuk mereplikasi benchmark agen IDE secara menyeluruh. Tujuannya adalah untuk membandingkan bantuan pemrograman sehari-hari: debugging, refactoring, penalaran multi-file, penulisan tes, dan tinjauan keamanan.
Sistem penilaiannya sederhana: keakuratan, penalaran terhadap akar masalah, kemudahan pemeliharaan, cakupan kasus-kasus khusus, verifikasi, dan kepatuhan terhadap instruksi. Hal ini membuat perbandingan tersebut tetap mencerminkan cara pengembang sebenarnya menggunakan asisten pemrograman berbasis AI.
Tes 1: Debugging dan Analisis Penyebab Utama
Perintah pertama meminta kedua model untuk meninjau sebuah fungsi JavaScript yang mengelompokkan tiket berdasarkan prioritas. Kesalahannya tidak terlalu mencolok namun sering terjadi: fungsi tersebut mencoba memasukkan ke dalam acc[tiket.prioritas] sebelum array tersebut ada.
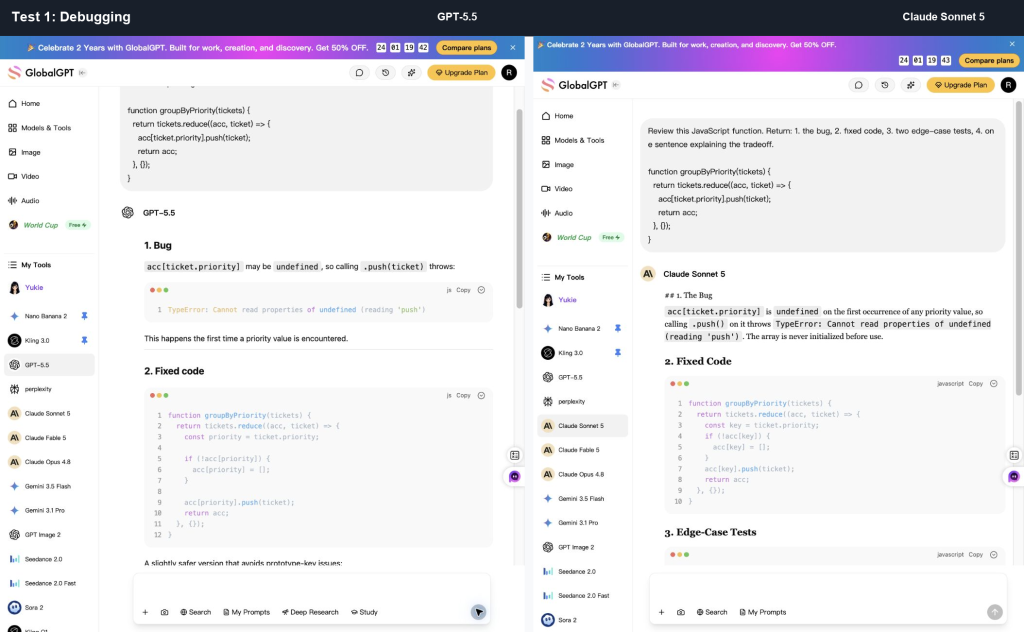
Hal-hal yang dilakukan ChatGPT dengan baik: GPT-5.5 menemukan bug tersebut, memberikan kode yang sudah diperbaiki, menambahkan pengujian untuk kasus-kasus khusus, dan menyertakan pendekatan yang lebih defensif Object.create(null) varian. Detail implementasi tambahan tersebut berguna ketika kunci objek berpotensi bertabrakan dengan properti yang diwarisi.
Hal-hal yang dilakukan Claude dengan baik: Claude Sonnet 5 menemukan bug yang sama dan memberikan jawaban yang lebih tepat. Hal itu juga mengungkap kasus tepi dengan prioritas yang tidak ditentukan, yang merupakan jenis batasan praktis yang harus dipertimbangkan oleh seorang peninjau.
Pemenang: Seri, dengan ChatGPT sedikit unggul dalam hal nuansa implementasi. Claude lebih rapi; GPT-5.5 lebih lengkap.
Tes 2: Refactoring dan Kemudahan Pemeliharaan
Perintah kedua meminta refaktorisasi untuk meningkatkan keterbacaan tanpa mengubah perilaku program. Ini merupakan ujian yang baik karena banyak jawaban pemrograman berbasis AI yang melakukan refaktorisasi berlebihan pada utilitas kecil dan menghasilkan lebih banyak komponen yang bergerak daripada yang sebenarnya dibutuhkan oleh kode aslinya.
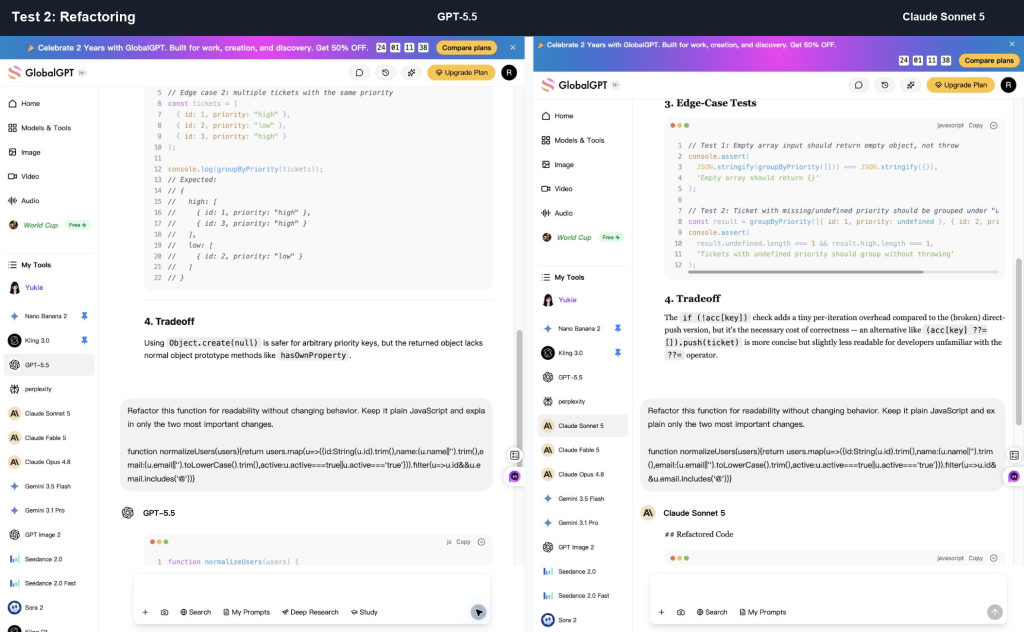
Hal-hal yang dilakukan ChatGPT dengan baik: GPT-5.5 mempertahankan struktur yang mendekati aslinya, memperkenalkan nilai-nilai perantara yang diberi nama, dan mengikuti instruksi “hanya dua perubahan penting” dengan rapi. Hal itu sangat berguna ketika pengguna menginginkan refaktorisasi yang konservatif.
Hal-hal yang dilakukan Claude dengan baik: Claude Sonnet 5 memisahkan fungsi-fungsi pembantu seperti normalizer dan validator. Hasilnya membuat teks tersebut lebih mudah dipindai, tetapi perubahan strukturnya lebih signifikan dibandingkan yang dilakukan oleh GPT-5.5.
Pemenang: ChatGPT untuk pengendalian; Claude untuk keterbacaan yang modular. Jika Anda membutuhkan refaktorisasi minimal yang aman, mulailah dengan ChatGPT. Jika Anda menginginkan penamaan domain yang lebih jelas, mintalah Claude untuk melakukan tinjauan lanjutan.
Tes 3: Penalaran dan Perencanaan Berbasis Beberapa Berkas
Tugas ketiga menyajikan struktur direktori Next.js yang sederhana dan sebuah laporan bug: pengguna yang sudah masuk dapat mengunggah berkas berukuran kecil, tetapi berkas yang ukurannya melebihi 8MB akan gagal tanpa pemberitahuan setelah bilah kemajuan mencapai 100%.
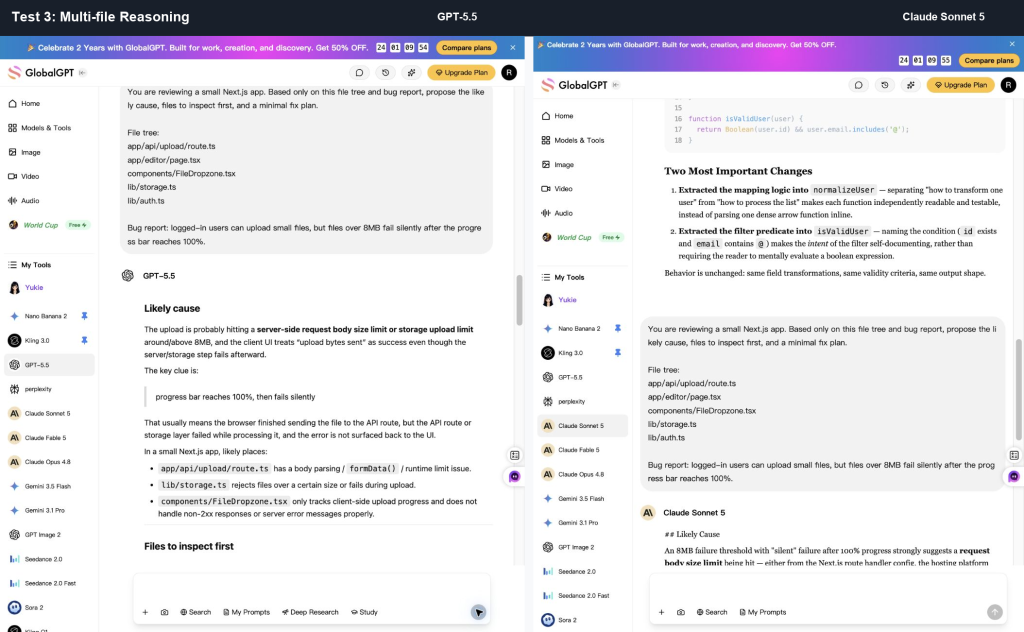
Hal-hal yang dilakukan ChatGPT dengan baik: GPT-5.5 menghasilkan rencana terperinci yang berorientasi pada implementasi. Rencana tersebut mencakup pemeriksaan ukuran server, penanganan respons klien, dan penyebaran kesalahan penyimpanan.
Hal-hal yang dilakukan Claude dengan baik: Claude Sonnet 5 langsung menyoroti batas 8MB—kemungkinan terkait batasan platform atau ukuran file, mekanisme bilah kemajuan, serta jalur verifikasi 7MB/8MB/9MB. Isinya terasa lebih seperti catatan tinjauan dari pihak senior.
Pemenang: Claude. Sistem ini lebih cepat mengidentifikasi penyebab yang paling mungkin dan memberikan alur pemeriksaan minimal yang lebih terarah.
Tes 4: Uji Unit dan Verifikasi
Perintah keempat meminta kedua model untuk menulis uji unit TypeScript untuk fungsi bantu yang mengembalikan batas kuota unggahan dan akses Codex. Hal ini bertujuan untuk menguji apakah model tersebut mampu melindungi logika percabangan dari regresi di masa mendatang.
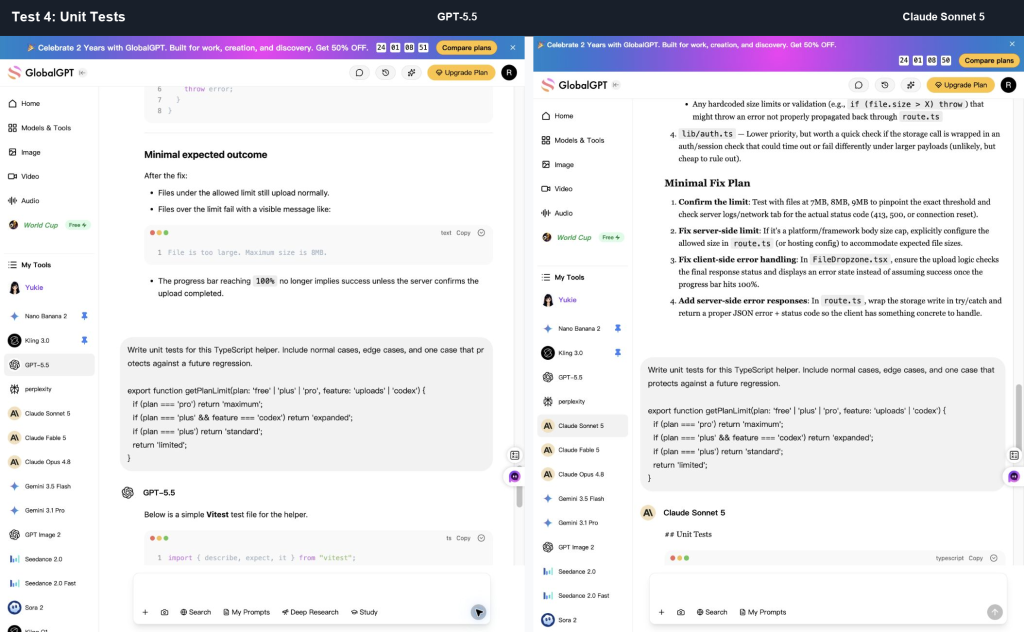
Hal-hal yang dilakukan ChatGPT dengan baik: GPT-5.5 menyertakan impor kerangka kerja pengujian dan menghasilkan berkas Vitest yang tampak siap dijalankan. Berkas tersebut mencakup semua kombinasi yang diharapkan dan membuat hasilnya mudah disalin ke dalam proyek.
Hal-hal yang dilakukan Claude dengan baik: Claude Sonnet 5 menjelaskan risiko regresi yang sebenarnya dengan lebih baik: pro + kodeks harus dilakukan terlebih dahulu sebelum pemeriksaan yang spesifik terhadap fitur. Jawaban tersebut didasarkan pada alasan yang lebih kuat, meskipun kurang praktis untuk langsung digunakan sebagai berkas.
Pemenang: Claude untuk analisis tes; ChatGPT untuk pembuatan berkas awal. Dalam praktiknya, gunakan ChatGPT untuk draf tes pertama dan Claude untuk mengevaluasi apakah tes-tes tersebut memastikan perilaku yang benar.
Uji Coba 5: Tinjauan Keamanan dan Keandalan
Pertanyaan kelima meminta kedua model untuk menganalisis titik akhir webhook Express. Jawaban yang baik harus mencakup verifikasi tanda tangan, persyaratan isi pesan mentah, idempotensi, validasi, penanganan kesalahan basis data, dan batasan ukuran permintaan.
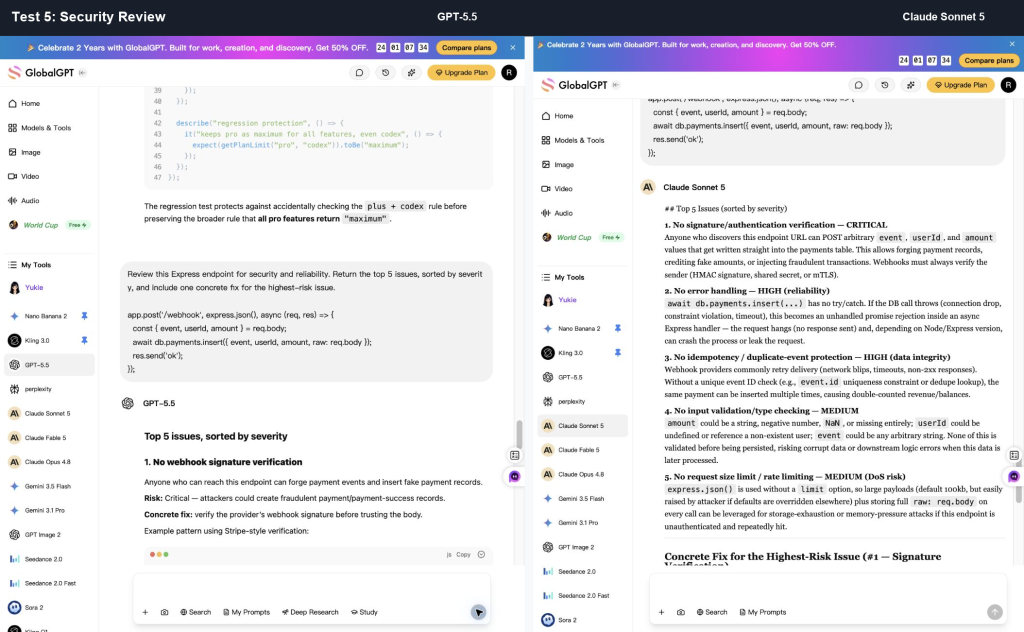
Hal-hal yang dilakukan ChatGPT dengan baik: GPT-5.5 memberikan solusi ala penyedia layanan, termasuk yang mirip Stripe express.raw() pola. Hal ini berguna ketika langkah selanjutnya adalah mengimplementasikan penangan webhook yang konkret.
Hal-hal yang dilakukan Claude dengan baik: Claude Sonnet 5 memberikan penalaran ketat yang lebih jelas dan menyertakan detail perbandingan tanda tangan yang lebih aman dengan memanfaatkan konsep perbandingan waktu konstan. Hal itu membuat peringkat risiko terasa lebih akurat.
Pemenang: Seri, dengan keunggulan tipis bagi Claude dalam hal penjelasan keamanan. Kedua model tersebut cukup andal untuk digunakan, tetapi tidak ada satu pun jawaban yang seharusnya menggantikan tinjauan keamanan yang sesungguhnya terhadap alur pembayaran atau otentikasi.
Claude Code vs ChatGPT Codex
Hasil obrolan hanyalah salah satu aspek dari pengambilan keputusan dalam pemrograman. Claude Code dan Codex adalah alur kerja pengembangan berbasis agen yang terpisah untuk tugas-tugas yang melibatkan berkas, perintah, pengujian, permintaan pull, atau perubahan pada basis kode yang lebih luas.
| Alur kerja | Paling cocok | Batas yang penting |
|---|---|---|
| Obrolan Claude | Penalaran, pemecahan masalah, peninjauan, penjelasan, dan perencanaan. | Sistem ini hanya mengenali konteks yang Anda berikan, kecuali jika terhubung dengan alat-alat atau alur kerja yang lebih luas. |
| Obrolan ChatGPT | Draf implementasi, pengujian, contoh, dan pertanyaan seputar penggunaan API. | Bahkan jawaban yang meyakinkan pun tetap perlu diverifikasi dalam proyek Anda. |
| Kode Claude | Penulisan kode yang memperhatikan repositori, navigasi basis kode, pengujian, dan perencanaan tugas berskala besar. | Periksa izin, kebijakan keamanan, dan perbedaan yang diusulkan sebelum menyetujui perubahan. |
| Kodeks | Implementasi yang mendukung Repo, debugging, pengujian, tinjauan, serta alur kerja pemrograman yang terintegrasi dengan OpenAI. | Ketentuan akses, penggunaan, dan ketersediaan model berbeda dari layanan obrolan biasa dan dapat berubah seiring waktu. |
Pendekatan praktis: gunakan model obrolan untuk proses berpikir, penjelasan, dan tugas-tugas kecil; gunakan Claude Code atau Codex ketika pekerjaan tersebut memerlukan konteks repositori dan langkah-langkah yang dapat dieksekusi.
Harga: Claude, ChatGPT, Codex, dan GlobalGPT
Mulailah dengan menanyakan apa yang Anda bayar. Paket obrolan mencakup bantuan pemrograman interaktif harian. Alur kerja agen pemrograman mencakup tugas-tugas yang terkait dengan repositori, seperti CLI, IDE, web, tugas cloud, atau integrasi. Penetapan harga API dihitung per juta token. Ruang kerja multi-model memungkinkan peralihan yang lebih mudah antara Claude, GPT, Gemini, Perplexity, dan model lainnya dalam satu tempat.
Harga yang diperiksa pada tanggal 27 September 2026 dinyatakan dalam dolar AS sebelum pajak yang berlaku. Tabel ini memisahkan langganan konsumen, tarif token API standar, dan paket tahunan milik GlobalGPT sendiri. Halaman harga Claude Setara dengan $17 per bulan dalam program tahunan Rounds Pro; pembayaran di muka sebesar $200 setara dengan $16,67 per bulan.
| Produk atau paket | Harga yang tertera | Apa artinya hal ini bagi pemrograman |
|---|---|---|
| Konsumen · Claude Gratis | $0 | Cukup untuk pertanyaan-pertanyaan pemrograman ringan dan mencoba gaya Claude sebelum membayar. |
| Konsumen · Claude Pro | $20 per bulan; $200 per tahun dibayarkan di muka (setara dengan $16,67 per bulan) | Kode Claude sudah termasuk; fitur obrolan dan penggunaan paket berbayar Kode Claude. |
| Konsumen · Maks. Claude | Mulai dari $100 per bulan | Opsi penggunaan yang lebih tinggi; termasuk Kode Claude. Penagihan melalui API Console dilakukan secara terpisah. |
| Konsumen · ChatGPT Gratis | $0 per bulan | Obrolan ringan; Akses desktop GPT-6 Luna berbeda dari fitur Obrolan biasa. |
| Konsumen · ChatGPT Go | $8 per bulan dalam referensi asli AS; harga di pasar lokal mungkin berbeda-beda | Langganan bulanan; silakan periksa halaman harga lokal untuk mengetahui tarif di wilayah Anda. |
| Konsumen · ChatGPT Plus | $20 per bulan, ditagih setiap bulan | Prompt pemrograman rutin dan akses ke Codex/Work bagi pengguna yang memenuhi syarat; biaya penggunaan API ditagihkan secara terpisah. |
| Konsumen · ChatGPT Pro | $100 per bulan; langganan yang sudah ada sebesar $200 per bulan tetap berlaku | Pendaftaran baru dan peningkatan paket $200 akan ditangguhkan mulai 10 September 2026. Langganan $100 tetap tersedia. |
| API · Claude Soneta 5 | Masukan $2/M; keluaran $10/M | Tarif API standar untuk alat pemrograman dan alur kerja dengan konteks besar. |
| API · Claude Opus 5,5 | Masukan $4/M; Keluaran $20/M | Kecepatan standar. Mode cepat memiliki input $8/M dan output $40/M. |
| API · GPT-6 Astra | Masukan $10/M; Keluaran $50/M | Tarif API standar; terpisah dari paket ChatGPT. |
| API · GPT-6 Sol / Luna | Sol: masukan $2/M, keluaran $10/M; Luna: masukan $0.10/M, keluaran $0.50/M | Tagihan pengembang terpisah; gunakan ID model dan tarif yang tepat. |
| Platform · GlobalGPT Dasar | Setara dengan $5,80 per bulan; $69,60 ditagihkan per tahun | Cara yang hemat biaya untuk membandingkan berbagai keluarga model dalam rangka tugas pemrograman sehari-hari dan penelitian. |
| Platform · GlobalGPT Pro | Setara dengan $10,80 per bulan; $129,60 ditagihkan per tahun | Lebih sesuai saat Anda berpindah-pindah di antara beberapa keluarga model selama pekerjaan sehari-hari. |
| Platform · GlobalGPT Tanpa Batas | Setara dengan $25 per bulan; $300 ditagihkan setiap tahun | Untuk perbandingan multi-model yang sering dilakukan dalam satu ruang kerja. Paket-paket ini tidak mencakup kredit API resmi maupun langganan Claude Code/Codex bawaan. |
Bagi sebagian besar pengembang perorangan, pertimbangannya bukanlah “perusahaan mana yang paling murah?”, melainkan “harga mana yang sesuai dengan alur kerja?”. Jika Anda kebanyakan hanya mengajukan pertanyaan dan menyalin potongan kode, Claude Pro atau ChatGPT Plus Mungkin sudah cukup. Jika Anda menginginkan implementasi yang mendukung repo, bandingkan akses Claude Code dan Codex. Jika Anda membandingkan beberapa model setiap hari, GlobalGPT bisa menjadi ruang kerja harian yang lebih ringkas karena biayanya terikat pada satu paket multi-model, bukan beberapa langganan terpisah.
Untuk alat pemrograman yang sangat bergantung pada API, membandingkan harga langganan bukanlah cara yang tepat. Penetapan harga berbasis token justru lebih penting karena konteks kode yang sangat luas. Claude Soneta 5 Membutuhkan $2/M untuk input dan $10/M untuk output, sedangkan Opus 5.5 membutuhkan $4/M dan $20/M pada kecepatan standar. Satu juta token masukan ditambah satu juta token keluaran oleh karena itu memerlukan biaya $12 pada Sonnet 5 atau $24 pada Opus 5.5. Untuk OpenAI, penggunaan yang sama membutuhkan biaya sebesar $60 di Astra, $12 di Sol, atau $0,60 di Luna dengan tarif standar. Ini adalah biaya API, bukan kuota yang termasuk dalam langganan ChatGPT, Claude, atau GlobalGPT.
Pengaturan Pemrograman Mana yang Harus Anda Pilih?
Jangan hanya memilih berdasarkan nama modelnya saja. Pilihlah berdasarkan jenis pekerjaan pemrograman yang sebenarnya Anda lakukan. Seseorang bisa saja menggunakan ChatGPT untuk implementasi awal, Claude untuk peninjauan, Codex untuk pekerjaan repositori yang dapat dieksekusi, dan GlobalGPT untuk pemeriksaan model secara cepat dan berdampingan dalam aktivitas sehari-hari.
Pemula yang sedang belajar pemrograman: Mulailah dengan ChatGPT. Biasanya, metode ini memberikan lebih banyak contoh, lebih banyak panduan, dan jalur yang lebih mudah dilalui dari “Saya tidak mengerti kesalahan ini” hingga “inilah bentuk yang benar.”
Pengembang pemula yang sedang memperbaiki bug: Mulailah dengan Claude jika masalahnya belum jelas. Claude sangat handal dalam mempersempit kemungkinan penyebab, menentukan hal apa yang harus diperiksa terlebih dahulu, dan menjaga agar penjelasannya tetap fokus. Gunakan ChatGPT setelah itu jika Anda membutuhkan solusi konkret, kasus uji, atau contoh implementasi.
Insinyur senior yang meninjau suatu perubahan: Mulailah dengan Claude. Model ini lebih cocok untuk pertimbangan kompromi, penentuan tingkat keparahan, masalah arsitektur, dan kritik yang ringkas. Untuk tugas-tugas yang melibatkan basis kode yang lebih besar, alihkan percakapan ke Claude Code atau Codex agar model dapat bekerja dengan berkas dan perintah, bukan sekadar potongan kode yang disisipkan.
Pengembang frontend atau pembuat antarmuka pengguna: Mulailah dengan ChatGPT untuk tahap awal. ChatGPT cenderung menghasilkan kode komponen yang lebih lengkap, penanganan state, dan kerangka kerja pengujian. Kemudian, gunakan Claude untuk meninjau aksesibilitas, batasan komponen, penamaan, serta apakah kode tersebut terlalu rumit untuk desainnya.
Pengelola basis kode berskala besar: Pilihlah Claude Code atau Codex sesuai dengan stack, akses akun, kebijakan keamanan, dan alur kerja yang Anda inginkan. Begitu suatu tugas melibatkan beberapa berkas, alur kerja agen biasanya lebih penting daripada jawaban obrolan mana yang terdengar lebih baik.
Pendiri tunggal atau tim kecil: Gunakan kedua keluarga model tersebut jika anggaran memungkinkan. Pengaturan yang praktis adalah menggunakan GlobalGPT untuk perbandingan model harian dan perintah "ide-ke-kode", ditambah Claude Code atau Codex ketika suatu tugas memerlukan akses ke repositori dan langkah-langkah yang dapat dieksekusi.
| Jenis pengembang | Pilihan pertama yang terbaik | Mengapa |
|---|---|---|
| Pemula yang sedang belajar pemrograman | ChatGPT | Lebih banyak contoh, penjelasan yang lebih lengkap, dan panduan yang ramah bagi pemula. |
| Pengembang pemula yang memperbaiki bug | Claude pertama | Pemikiran yang lebih jelas mengenai akar masalah serta panduan “periksa ini terlebih dahulu” yang lebih baik. |
| Insinyur senior yang meninjau suatu perubahan | Claude | Lebih cocok untuk analisis trade-off, penentuan peringkat risiko, dan kritik yang ringkas. |
| Pengembang Frontend/UI | ChatGPT dulu, Claude kemudian | ChatGPT menyusun draf komponen tersebut; Claude memeriksa aksesibilitas, struktur, dan kemudahan pemeliharaannya. |
| Pengelola basis kode berskala besar | Claude Code atau Codex, tergantung pada tumpukan dan akses | Berkas, perintah, pengujian, dan izin jauh lebih penting daripada satu jawaban dalam obrolan. |
| Pendiri Solo | Keduanya, seringkali melalui satu ruang kerja multi-model | Penyusunan draf yang cepat, peninjauan yang cermat, dan pergantian model yang cepat—semuanya itu penting ketika satu orang bertanggung jawab atas produk tersebut. |
Jika Anda sedang mempertimbangkan antara keluarga model Claude dan GPT yang lebih baru, perbandingan antara Claude Opus 5.5 dan GPT-6 Sol memberikan konteks yang lebih spesifik mengenai masing-masing model. Jika Anda sedang mempertimbangkan paket berbayar OpenAI, maka ChatGPT Plus vs Pro Perbandingan ini dapat membantu menentukan apakah penggunaan yang lebih intensif sepadan.
Mengapa Banyak Pengembang Masih Menggunakan Keduanya
Menggunakan Claude dan ChatGPT secara bersamaan bukanlah bentuk keragu-raguan. Hal itu justru merupakan siklus pengendalian kualitas yang lebih baik.
- Rencanakan bersama Claude, terapkan bersama ChatGPT: Berguna jika Anda ingin menggunakan Claude untuk meminimalkan risiko dan ChatGPT untuk menghasilkan implementasi awal.
- Buat drafnya dengan ChatGPT, periksa hasilnya dengan Claude: Berguna saat Anda membutuhkan kode yang cepat tetapi ingin mendapatkan masukan yang lebih teliti.
- Tanyakan kedua hal tersebut sebelum memulai produksi: berguna untuk pembayaran, otentikasi, pengunggahan, migrasi, penyimpanan dalam cache, dan perubahan basis data yang bersifat menghapus data.
- Gunakan agen jika tugas tersebut memerlukan berkas: Claude Code atau Codex bisa jadi lebih penting daripada obrolan biasa ketika model membutuhkan konteks repositori.
GlobalGPT sesuai dengan pola “gunakan keduanya” ketika tugasnya berupa perbandingan prompt, bantuan pemrograman sehari-hari, perencanaan, atau penelitian. Model ini sangat berguna untuk perbandingan model harian, iterasi draf, pendapat kedua yang cepat, serta pemilihan gaya model yang paling sesuai untuk pekerjaan berikutnya.
Jika akses ke Claude adalah satu-satunya hal yang Anda pertimbangkan, maka alternatif AI Claude terbaik Daftar ini merupakan panduan alternatif yang lebih luas.
PERTANYAAN YANG SERING DIAJUKAN
Manakah yang lebih baik untuk pemrograman pada tahun 2026, Claude atau ChatGPT?
Pilihlah Claude terlebih dahulu untuk tinjauan kode, debugging yang ambigu, perencanaan arsitektur, dan penalaran dengan konteks yang panjang. Pilih ChatGPT terlebih dahulu untuk draf implementasi, contoh, pekerjaan frontend, dan kerangka kerja pengujian. Jika tugas tersebut memerlukan akses ke repositori, perintah, pengujian, atau pengeditan beberapa berkas, bandingkan Claude Code dengan Codex daripada hanya mengandalkan obrolan saja.
Apakah Claude lebih baik daripada ChatGPT untuk proses debugging?
Claude sering kali lebih unggul sebagai langkah debugging awal karena cenderung memprioritaskan penyebab yang paling mungkin dan menjelaskan alur kegagalan dengan jelas. Dalam pengujian JavaScript dan Next.js kami, Claude Sonnet 5 terbukti sangat unggul dalam memberikan diagnosis yang ringkas. Sementara itu, ChatGPT tetap unggul ketika perbaikan memerlukan detail implementasi yang lebih lengkap.
Apakah ChatGPT Codex lebih baik daripada Claude Code?
Tidak ada yang secara otomatis lebih baik untuk setiap tim. ChatGPT Codex cocok untuk alur kerja yang berpusat pada OpenAI dan tugas-tugas agen yang membutuhkan banyak implementasi. Claude Code unggul ketika pekerjaan tersebut diuntungkan oleh gaya perencanaan, peninjauan, dan penalaran konteks jangka panjang yang dimiliki Claude. Pilihan yang lebih baik bergantung pada akses repositori, harga, stack, izin, dan kebijakan tim.
Mana yang lebih baik untuk basis kode yang besar?
Untuk basis kode yang besar, alur kerja agen lebih penting daripada model obrolan itu sendiri. Gunakan Claude Code atau Codex ketika asisten perlu memeriksa berkas, menjalankan perintah, melakukan pengujian, atau melacak perilaku di seluruh modul. Pastikan tetap ada tinjauan manusia terkait izin, perintah berisiko, dan hasil perbandingan akhir.
Mana yang lebih baik bagi pemula yang sedang belajar pemrograman?
ChatGPT biasanya lebih mudah bagi pemula karena cenderung memberikan lebih banyak contoh, penjelasan yang lebih lengkap, dan potongan kode yang siap dijalankan. Claude bisa jadi lebih baik ketika pemula mengalami kebuntuan dalam memahami mengapa sesuatu gagal dan membutuhkan penjelasan konseptual yang lebih jelas.
Mana yang lebih baik untuk kode HTML dan UI frontend?
ChatGPT sering kali lebih unggul dalam menghasilkan draf awal HTML, CSS, atau komponen. Claude berguna untuk meninjau struktur, menyederhanakan tata letak, serta mendeteksi masalah aksesibilitas atau kemudahan pemeliharaan. Untuk hasil kerja frontend yang rapi, gunakan ChatGPT untuk membuat draf dan Claude untuk meninjaunya.
Model mana yang lebih baik untuk menulis tes?
ChatGPT lebih cocok jika Anda menginginkan berkas uji lengkap yang sudah mencakup pernyataan `import` dan memiliki struktur yang tampak siap dijalankan. Claude lebih cocok jika Anda ingin memahami perilaku mana yang perlu dilindungi dan mengapa uji regresi itu penting. Alur kerja yang efektif adalah membuat uji coba menggunakan ChatGPT, lalu menanyakan kepada Claude kasus-kasus tepi apa saja yang terlewatkan.
Apakah uji perbandingan seperti SWE-Bench dapat membuktikan asisten pemrograman mana yang lebih baik?
Tidak. SWE-Bench, SWE-Bench Pro, dan Terminal-Bench merupakan indikator yang berharga, terutama untuk alur kerja pengkodean berbasis agen, namun indikator-indikator tersebut tidak sepenuhnya dapat memprediksi bantuan pengkodean sehari-hari. Tolok ukur mengukur lingkungan yang terkendali; pengembang sungguhan juga membutuhkan penalaran yang jelas, kode yang praktis, perubahan yang mudah dipelihara, dan langkah-langkah verifikasi yang baik.
Haruskah para pengembang menggunakan Claude dan ChatGPT secara bersamaan?
Ya, terutama untuk pekerjaan yang serius. Gunakan Claude untuk perencanaan, tinjauan risiko, dan diagnosis. Gunakan ChatGPT untuk draf implementasi, contoh, dan kerangka kerja pengujian. Kemudian jalankan kode tersebut, periksa perbedaannya, dan verifikasi perilakunya di proyek Anda sendiri.
Bisakah saya membandingkan Claude dan ChatGPT di GlobalGPT?
Ya. GlobalGPT berguna untuk membandingkan jawaban Claude dan ChatGPT dalam satu ruang kerja jika model-model yang dibutuhkan tersedia di sana. Alat ini berfungsi dengan baik untuk pertanyaan-pertanyaan seputar kode sehari-hari, perencanaan, penelitian, dan pendapat kedua. Alat ini tidak menggantikan Claude Code, Codex, IDE, API resmi, atau alat tingkat repositori.





