快速回答: 一份可靠的Kling 3.0提示应描述观众应看到和听到的内容:主体、可见动作、摄像机运动、场景、灯光和音效。请将其视为一份实用的检查清单,而非僵化的官方公式。对于多镜头片段,请为每个镜头标注名称并注明时间范围。.
然而,如果直接在视频生成器中通过猜测来摸索这个公式,会迅速耗尽昂贵的积分。每当你的提示语失败或被严格的安全过滤器拦截时,你不仅会损失金钱,还会打断你的创作势头。.
一个模糊的提示虽然仍可能产生一帧引人注目的画面,但它为Kling提供的关于动作、连续性、对话和声音的线索却更少。理解如何 AI 视频片尾字幕功能 这使得为已准备好进行测试的提示词预留付费生成配额变得更加容易。.
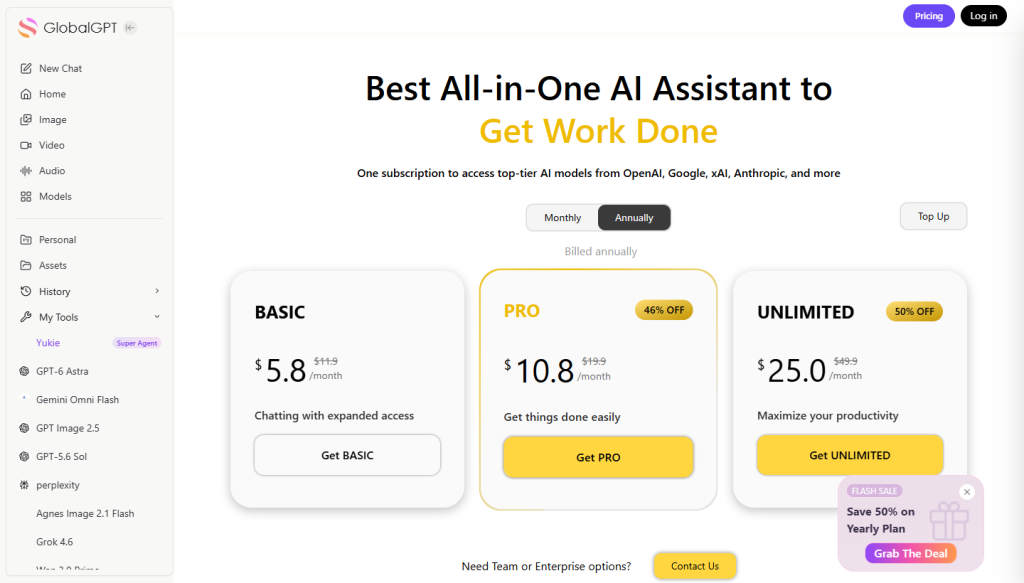
GlobalGPT 将规划和生成步骤整合在一个工作区中。您可以使用 GPT-5.6 Sol 要优化镜头清单,请使用受支持的图像模型创建参考图像,然后使用 Kling 3.0 对其进行动画制作。 GlobalGPT 列出的 Pro 计划价格为按年计费每月 $10.8;价格和信用规则可能会发生变化,因此订阅前请查看订购页面。.

Kling 3.0 提示指南:更好的人工智能视频:什么是 “导演思维”?
所谓“导演思维”,是指在撰写文本提示时,要仿佛是在真实的电影片场向摄影师和演员下达具体指令,而不是仅仅描述一幅画的样子。.
- 摆脱依赖图片提示的习惯: 诸如“美女、4K、杰作、细节丰富”之类的描述虽然可以描述外观,但并未说明随着时间推移会发生什么变化。请添加一个明确的动作和一条摄像机指令。.
- 优先采取可见的行动: 不要写“地板上有一块碎玻璃”,而要写“一个玻璃杯从桌子上掉下来,摔得满地都是”。具体的动词能为模型提供一个需要呈现的场景。这 Kling AI 相机移动指南 在选择该事件发生时的镜头处理方式时,这很有用。.
- 尽早确立主题: 在添加背景细节之前,先确定主要人物或物体。这样可以提高画面将观众注意力集中在预期主体上的概率,尽管无法保证完全一致。.
如何构建一个有力的 Kling 3.0 提示词?
一个实用的单镜头提示可以遵循五部分的主干结构:镜头 + 场景 + 主体动作 + 视角/光线 + 音效。这是一个实用的写作框架,并非仅适用于 Kling 的正式规则。如果你想要更长的镜头序列,可以改用标注镜头的方式,而不是强行将每条指令都塞进一句话里。工作流程在 如何像专家一样使用 Kling 3.0 展示了这些选择如何融入完整的生成流程。.
- 先从相机说起: 画面构图与运动,例如“静态特写”或“缓慢向前推的推车镜头”。除非过渡场景必不可少,否则每个镜头应仅包含一种主要运动。.
- 设定场景和情节: 请描述场景、人物以及该人物当前的动作:“在东京一条雾气弥漫的街道上,一位赛博朋克侦探举起纸杯,凝视着街上的车流。”
- 以视觉和听觉效果收尾: 添加可以描绘出的光线、氛围和可听见的细节:“霓虹灯的倒影、雨夜、远处车流声、雨点敲打遮阳篷的声音。”
- 根据镜头的需求,尽可能提供详细信息: 并没有经过验证的“20-50个词”的黄金区间。应删除矛盾之处和冗余的修饰性内容,但要保留那些涉及时间、对话、声音或连续性的细节。.
单次拍摄模板:
[镜头与构图]。[主体]在[场景]中进行[可见动作]。[灯光与视觉风格]。音频:[对话、环境音和音效]。确保[重要的连续性细节]保持一致。.多帧模板:
镜头1(0-2秒),[构图/运动]:[主体和动作]。
镜头2(2-5秒),[构图/运动]:[后续动作和对话]。
音频:[环境音效]、[特定音效]、[发言者及语调]。
连续性:确保两个镜头中[面部表情/服装/道具/场景布局/光线方向]保持一致。.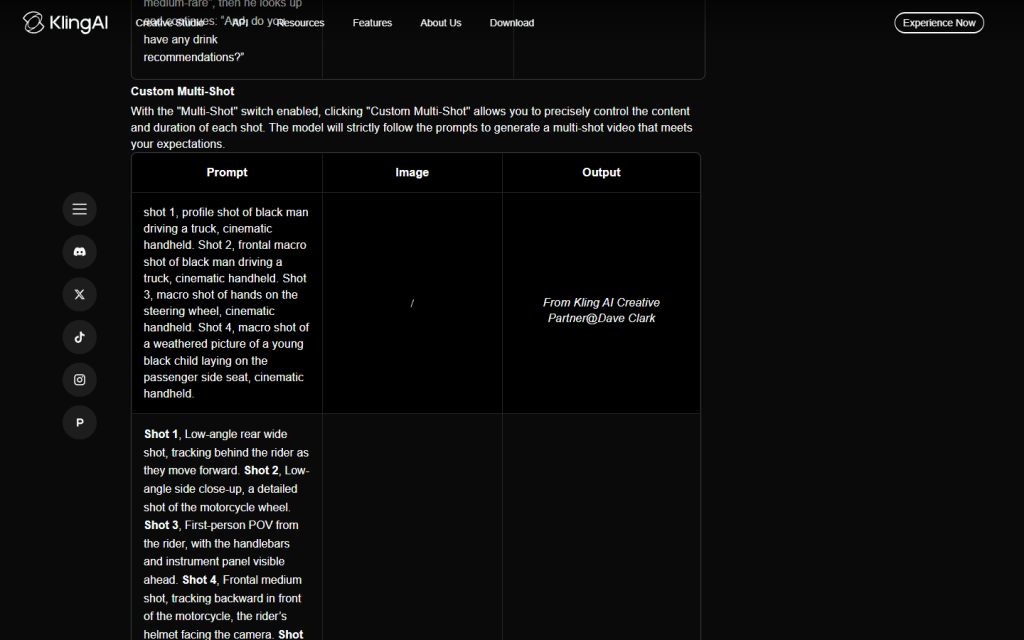
摄像机移动和原生音频的最佳提示是什么?
最适合描述镜头运动的提示词应使用“跟拍”或“摇摄”等传统好莱坞术语,而原声效果则需通过将对话用引号标出并描述音效来实现。.
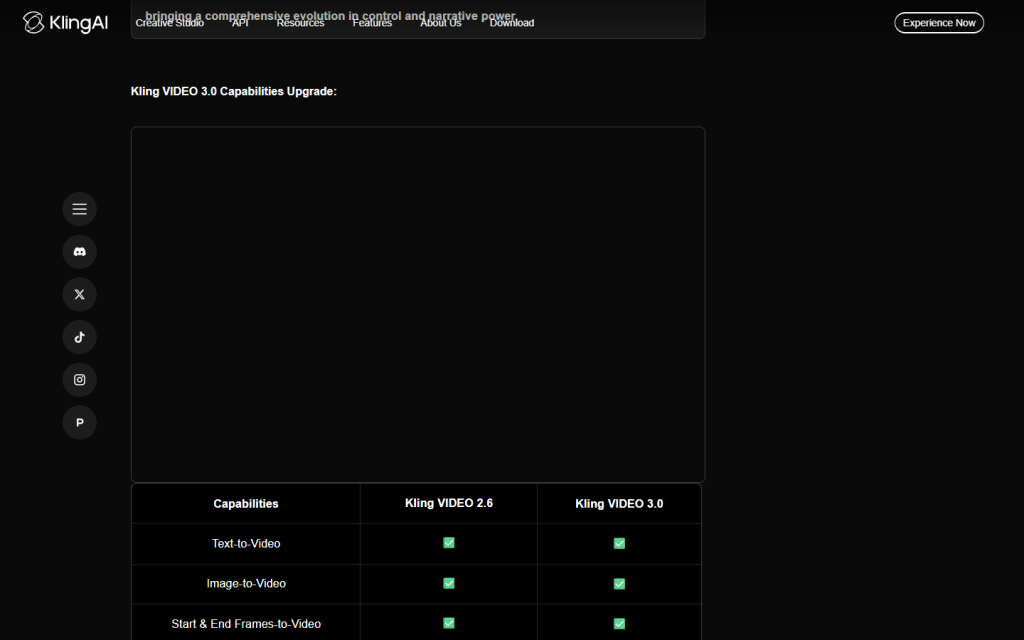
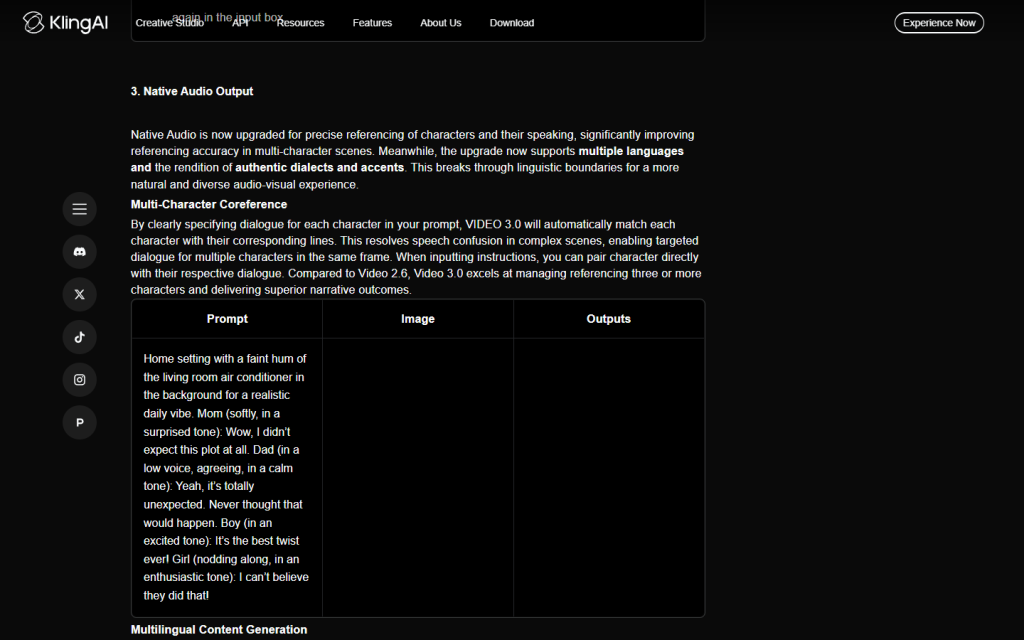
为了更清晰地描述声音来源,请指出说话者、发声方式、环境音和音效。根据 官方 Kling 视频 3.0 指南, VIDEO 3.0 支持原生音频和自定义多帧生成;原生音频不仅限于 Omni 模型。.
- 使用准确的相机术语: “跟拍”是指让摄像机跟随拍摄对象移动。“无人机俯拍”是指从高空俯瞰的视角。“三脚架静态拍摄”是指在画面内发生动作时,摄像机保持静止不动。.
- 给每个镜头分配一个任务: 如果你需要一个广角镜头和一个特写镜头,请将它们分别设为“镜头1”和“镜头2”。这样比要求在同一时刻拍摄广角镜头和特写镜头要清晰明了。.
- 环境音效名称: 添加可感知的声效,例如“湿砾石上沉重的脚步声”、“雨滴敲打帆布的 steady 声”或“远处的雷声”。对于以质感为主的场景,同样的原则也适用于一个 Kling ASMR 视频制作流程.
- 为角色分配台词: 请写下角色名、原话以及台词的表达方式:
那名士兵用低沉而疲惫的声音轻声说道:"我们终于要回家了。" - 请选择一种受支持的对话语言: Kling的《VIDEO 3.0》指南中列出了中文、英语、日语、韩语和西班牙语,其中中文和英语还标注了多种口音或方言。.
专业级 Kling 3.0 提示模板(复制和粘贴)
[动作与对话提示]
静态特写镜头,一名疲惫的士兵躺在泥泞的战壕中,仰望着天空,大雨倾盆而下,他低声说道:"我们终于要回家了。"画面采用电影式的暗调光影,氛围沉重。.
[物理与运动提示]
慢动作跟拍镜头:一辆跑车在山路急转弯处漂移,轮胎冒着烟,碎石飞溅向镜头,午后阳光明媚,逼真的8K画质。.[多镜头对话提示]
第一镜头(0-2秒),静态特写:一名疲惫的士兵躺在泥泞的战壕里,大雨顺着他的头盔流下,他缓缓抬起头。 镜头2(2-5秒),轻柔的手持推近镜头:他呼出一口气,目光仍注视着天空,用低沉而疲惫的声音轻声说道:"我们终于要回家了。"音效:雨水稳稳地打在帆布上,远处传来雷声,布料轻微的摆动声。电影式的低调布光,氛围沉郁。 两个镜头中,面部、军装、战壕布局及雨势方向应保持一致。.参考图像如何提高AI视频的一致性?
参考图片为 Kling 提供了关于面部、服装、道具和风格的视觉参考点。它们可以提高一致性并减少重复的视觉描述,但不会永久锁定每个细节。优质的参考图片配合针对性的动作提示效果最佳。有关更多连贯性技巧,请参阅以下说明: Kling 人工智能角色一致性.
- 删除重复的外观细节: 一旦附上了合适的角色形象,请在提示中更多地着重描述动作、镜头运镜和声音,而不是重复描述头发、衣服和面部特征。.
- 描述与该来源相符的运动: 特写镜头适合表现克制的面部表情;全身镜头则能为模特提供更多关于走姿或肢体动作的表现空间。这 Kling 图像转视频工作流 更详细地介绍了源图像的准备工作。.
- 重申连续性优先事项: 如果人物面部、服装、道具或光线方向最为关键,请明确指出。参考信息有助于提高连贯性;但并不能完全避免形态变化或场景偏移。.
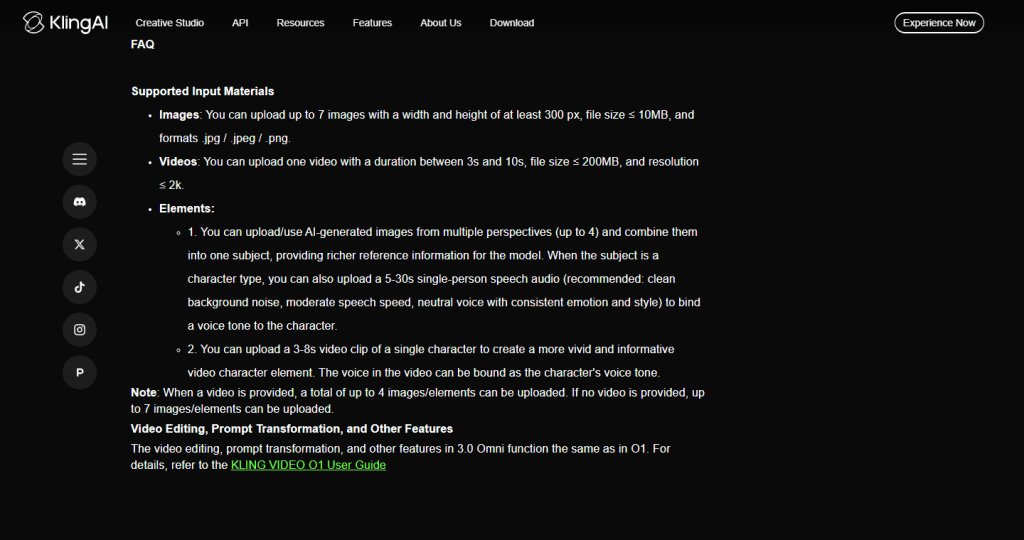
"(《世界人权宣言》) 官方《VIDEO 3.0 Omni》指南 支持上传最多七张图片或一段时长为3至10秒的视频。若上传视频,指南规定附加图片/元素的数量上限为四张。此外还需遵守文件大小和最小尺寸的规定,因此在准备大量文件前,请先查看当前的上传面板。.
| 输入 | 最适合用于 | 提示重点 | 主要注意事项 |
|---|---|---|---|
| 仅限文本 | 概念探索与没有固定角色的场景 | 拍摄对象、动作、摄像机、场景、灯光、音效 | 必须描述更多的视觉细节 |
| 参考图片 | 已知的角色、物品、服装或视觉风格 | 动作、摄影、表演、声音 | 一致性有所提高,但无法保证 |
| Omni 中的参考视频 | 现有片段中的运动或连续性线索 | 哪些应该保留,哪些应该改变 | 现行时长限制和同伴参与限制依然适用 |
如何建立多模型工作流程以节省世代积分?
您可以使用快速文本人工智能编写脚本,使用高质量图像人工智能生成参考图片,最后只使用 Kling 人工智能制作实际动画,从而构建一个多模型工作流程,大大减少了工作时间。 功亏一篑.
虽然具体节省的费用因项目而异,但这种流程安排将成本较低的修改环节提前到了视频生成之前。在该工作流中,同样的准备逻辑也体现在 将图片转化为电影般的Kling视频.
- 撰写镜头简报: 请让 GPT-5.6 Sol 或其他功能强大的文本模型指出存在矛盾的叙事框架、对话归属不明确、过渡句缺失以及镜头堆砌等问题。请将该草稿视为一名剪辑师,而非 Kling 当前限制方面的权威。.
- 创建引用: 生成或选择一张图片,该图片应清晰展示该动作所需的主题、服装、道具和构图。.
- 在 Kling 3.0 中制作动画: 添加参考资料后,请主要将提示词用于动作、镜头、时机和音效。在扩展场景之前,先生成一个受控的变体。.
- 审查可观察到的故障: 注意角色形象偏离、动作遗漏、镜头运动错误、音频平衡以及连续性问题。每次只修改一个原因。.
观看:如何像导演一样提示人工智能视频
在本深入浅出的教程中,您将看到专业的人工智能电影制作人如何使用特定的电影提示和参考图像来控制复杂的摄像机运动:
如何纠正常见的人工智能提示错误和幻觉?
首先,删除相互冲突的指令,并确定哪种失败情况最为关键。有些平台提供了“负面提示”字段,有些则没有;即使有该字段,它也能减少不需要的模式,但无法强制实现干净的渲染。如果你既要比较模型的行为,又要比较提示词,那么这 Seedance 2.0 与 Kling 3.0 对比 提供了有用的背景信息。.
| 问题 | 可能的原因 | 推荐尝试 |
|---|---|---|
| 变形的框架 | 该提示要求同时呈现相互矛盾的视角,例如极度特写和全身镜头 | 为每个镜头选择一种画幅尺寸,或将不同视角划分为标有标签的镜头 |
| 错过的动作 | 在短时间内有太多动作同时进行 | 每个镜头保持一个主要动作节奏,将次要动作移至下一个镜头 |
| 情感淡漠 | 该提示词指出了某种情绪,但并未展现出来 | 描述可见的行为,例如手在颤抖、低头不语或脸颊上流着泪 |
| 扬声器选错 | 对话内容未明确指定 | 指出说话者是谁,引用确切的台词,并描述其表达方式 |
| 字符漂移 | 外观细节或参考优先权尚不明确 | 使用清晰的引用,并仅重复最重要的连续性细节 |
| 背景模糊或抖动 | 快速运动、镜头复杂性或场景切换频繁 | 简化操作;如果界面提供了否定提示,请描述具体的成果,而不要期待任何保证 |
常见问题
Kling 3.0 的最佳提示格式是什么?
最佳格式是结构化的电影公式:镜头移动 + 场景描述 + 主体动作 + 照明/氛围 + 音频/时间标记。.
如何让克林人工智能角色开口说话?
请写出角色名字,将对话原文用引号标出,并描述其说话方式。Kling VIDEO 3.0 和 VIDEO 3.0 Omni 均支持原生音频;当前的 VIDEO 3.0 指南中列出的对话语言包括中文、英语、日语、韩语和西班牙语。.
一个 Kling VIDEO 3.0 视频片段最长可以有多长?
Kling 当前的《VIDEO 3.0》和《VIDEO 3.0 Omni》指南中列出的生成时长为 3 至 15 秒。可选选项可能因所选模式和平台界面而异。.
Kling VIDEO 3.0 与 VIDEO 3.0 Omni 之间有什么区别?
这两款模型均支持原生音频和多帧工作流。VIDEO 3.0 Omni 新增了一项一体化参考工作流,可在其当前输入限制范围内,将文本与图像、视频及可复用元素相结合。.
我可以在 Kling VIDEO 3.0 Omni 上添加多少个参考点?
Omni官方指南规定,最多可使用七张图片或一段时长为3至10秒的视频。若提供视频,则可额外使用最多四张图片或元素。请查阅当前界面以了解文件大小和尺寸要求。.
为什么我的 Kling AI 视频会出现变形或融化的现象?
视频翘曲通常是由于您的提示中包含了太多的指令、相互矛盾的镜头移动,或者缺乏一个稳定的参考图像来固定角色的身体细节。.
参考图片比纯文本提示更好吗?
当角色身份、服装、道具或视觉风格必须保持可辨识时,参考图会很有帮助。纯文本提示在概念探索阶段依然有用。参考图可以提高一致性,但并不能保证角色形象被完美锁定。.
我可以在 Kling 3.0 到 GlobalGPT 之间使用吗?
是的。GlobalGPT 提供了一个 Kling 3.0 视频工作区,其中包含参考、原生音频、时长和分辨率控制功能。平台定价和积分规则可能会发生变化,因此在生成大量批次之前,请确认当前设置。.
结论
更好的 Kling 3.0 提示不应过分依赖“魔法关键词”,而应侧重于引导可观察的选择。 明确主题,为每个镜头设定清晰的动作和摄像机任务,分配对话,并在视觉风格至关重要时使用参考素材。分阶段的工作流程可以减少可避免的重拍,而最终审核仍应检查连续性、画面瑕疵和音效。在发布客户作品之前,还应审阅当前关于 Kling 人工智能商业应用.