Muse Spark 1.2 combineert een ongewoon lage tokenprijs met een contextvenster van 1 miljoen tokens, en het heeft alle drie de coderingstaken voor basismodellen in onze API-suite bij de eerste poging met succes doorlopen. Meta heeft het model gelanceerd op 5 augustus 2026, met een contextvenster van 1 miljoen tokens, twee tariefniveaus voor de API en een aparte terminalagent genaamd Muse Code. De benchmarkresultaten van Meta zijn veelbelovend; onafhankelijke openbare ranglijsten voor programmeerprestaties hebben dezelfde combinaties van modellen en agents nog niet geverifieerd.
In deze beoordeling wordt een onderscheid gemaakt tussen het model en de agent, tussen officiële scores en onafhankelijk bewijs, en tussen standaardprijzen en de afweging tussen dataverbruik en kosten in het Contributor-niveau. Tijdens onze tests voltooide het model een Python-idempotentie-correctie, een TypeScript-refactor waarbij de compatibiliteit behouden bleef, en een repository-brede JSONL-functie zonder herhalingspogingen. De uitvoering van de Muse Code-agent is niet getest, evenmin als de betrouwbaarheid van het aanroepen van tools. Als u eerst het bredere veld wilt vergelijken, raadpleeg dan onze gids voor de beste AI-modellen voor codering geeft een breder beeld van de concurrentiesituatie.
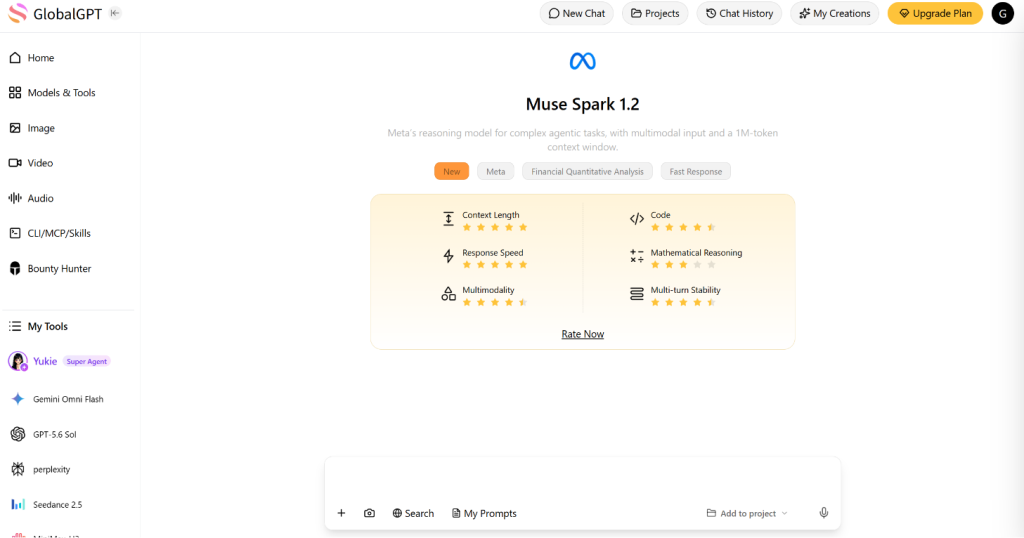
Recensie van de Muse Spark 1.2: kort en bondig
De korte versie: Muse Spark 1.2 is een op programmeren gericht Meta-model met een venster van 1 miljoen tokens, toegang tot een API die compatibel is met de OpenAI SDK, en een opvallend Contributor-niveau. Het sterkste publieke argument is de prijs-kwaliteitverhouding: $0,10 input en $0,20 output per miljoen tokens voor het Contributor-model. Dat niveau kan worden gebruikt om Meta-producten te verbeteren, terwijl het duurdere standaardmodel niet voor dat doel wordt gebruikt.
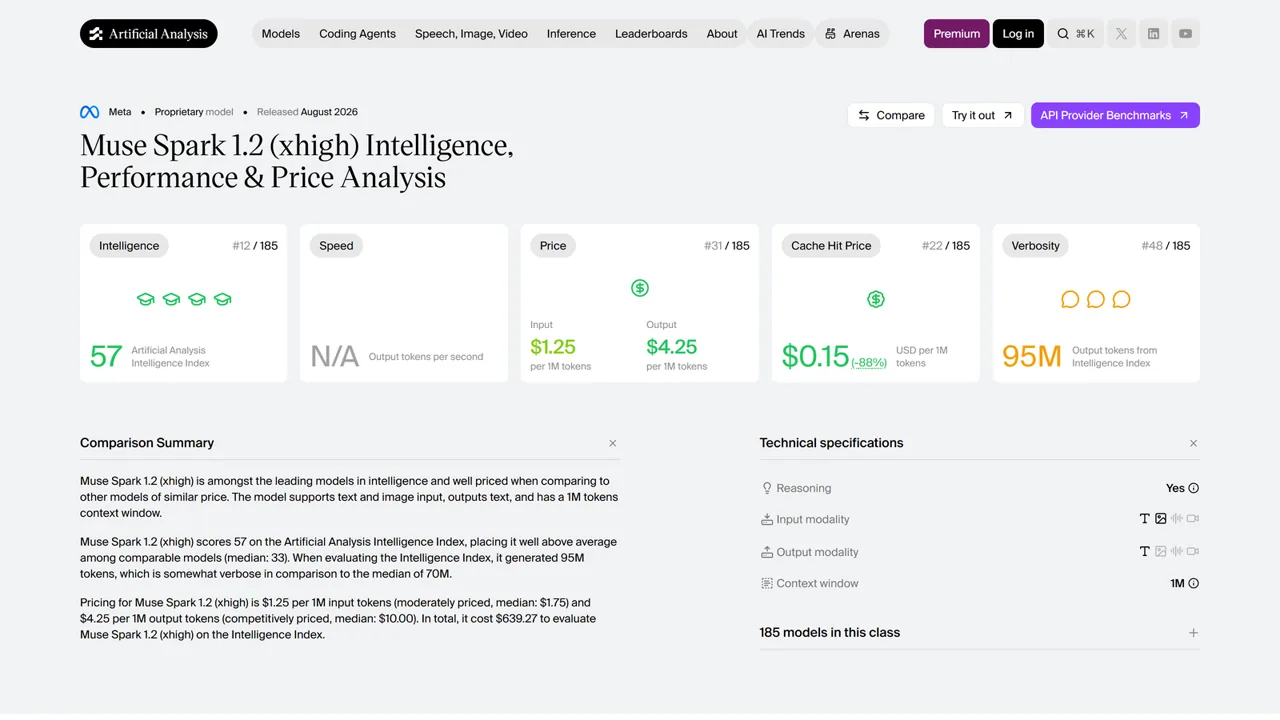
De prestatiecijfers moeten met enige terughoudendheid worden bekeken. Meta rapporteert 82,91 TP40T op Terminal-Bench 2.1 voor Muse Spark 1.2 met Muse Code en 59,31 TP40T op DeepSWE. Dit zijn resultaten die door Meta zijn verkregen. Op de openbare Terminal-Bench- en DeepSWE-lijsten stond Muse Spark 1.2 op 26 augustus 2026 nog steeds niet vermeld. Kunstmatige analyse biedt een onafhankelijke controle: de Intelligence Index blijft op 57 staan, boven de mediaan van 35 voor vergelijkbare modellen.
- De beste reden om het nu eens te proberen: voordelige tarieven voor bijdragers, een uitgebreide context en een API die het bekende OpenAI-clientpatroon volgt.
- De belangrijkste reden om voorzichtig te blijven: Drie gecontroleerde taken met het basismodel leveren geen bewijs voor de betrouwbaarheid van de Muse Code-agent, de kwaliteit van de tool-aanroepen of de prestaties binnen een grote productierepository.
- Belangrijke keuze met betrekking tot privacy: Gebruik het standaardmodel voor code of prompts die je niet wilt gebruiken om Meta-producten te verbeteren.
Muse Spark 1.2 in een oogopslag
Geverifieerde specificaties
Meta beschrijft Muse Spark 1.2 als een model met een hogere nauwkeurigheid bij het coderen bij de eerste poging en een betrouwbaardere aanroep van tools dan Muse Spark 1.1. Dit zijn beweringen van de aanbieder uit de officiële modelpagina van Muse Spark, en geen conclusies uit onze eigen codeersessie.
Muse Spark 1.2 versus Muse Code
Muse Spark 1.2 is het model. Muse Code is een afzonderlijke bèta-terminalagent die op dat model is gebaseerd. Dit onderscheid is van belang omdat een agent functies als planning, coördinatie van tools, navigatie door de repository, isolatie van de werkboom, logboekregistratie en herhalingsgedrag kan toevoegen aan het onderliggende model.
Houd de lagen gescheiden
Muse Spark 1.2
Context, redenering, API-gedrag, facturering op basis van tokens, uitvoer en beslissingen over het aanroepen van tools.
Model-ID's1M contextAPI-prijzen
Muse-code
Terminal-gebruikerservaring, subagenten, Git-werkbomen, gebeurtenislogboek, voortzetting van de workflow, gebundelde vaardigheden en orkestratie.
Workflow van de agentResultaten van het Meta-run-systeem
De officiële Muse Code-pagina noemt het product een bèta-coderingsmiddel. Daardoor zijn vergelijkingen met producten zoals Claude Code en Codex zinvoller dan te doen alsof elk waargenomen verschil in de workflow voortkomt uit een ‘bare model call’. Onze Vergelijking tussen Codex en Claude-code legt uit waarom de omringende omgeving de ervaring van de ontwikkelaar net zo sterk kan beïnvloeden als het model zelf.
Muse Spark 1.2-benchmarks: wat de scores werkelijk laten zien
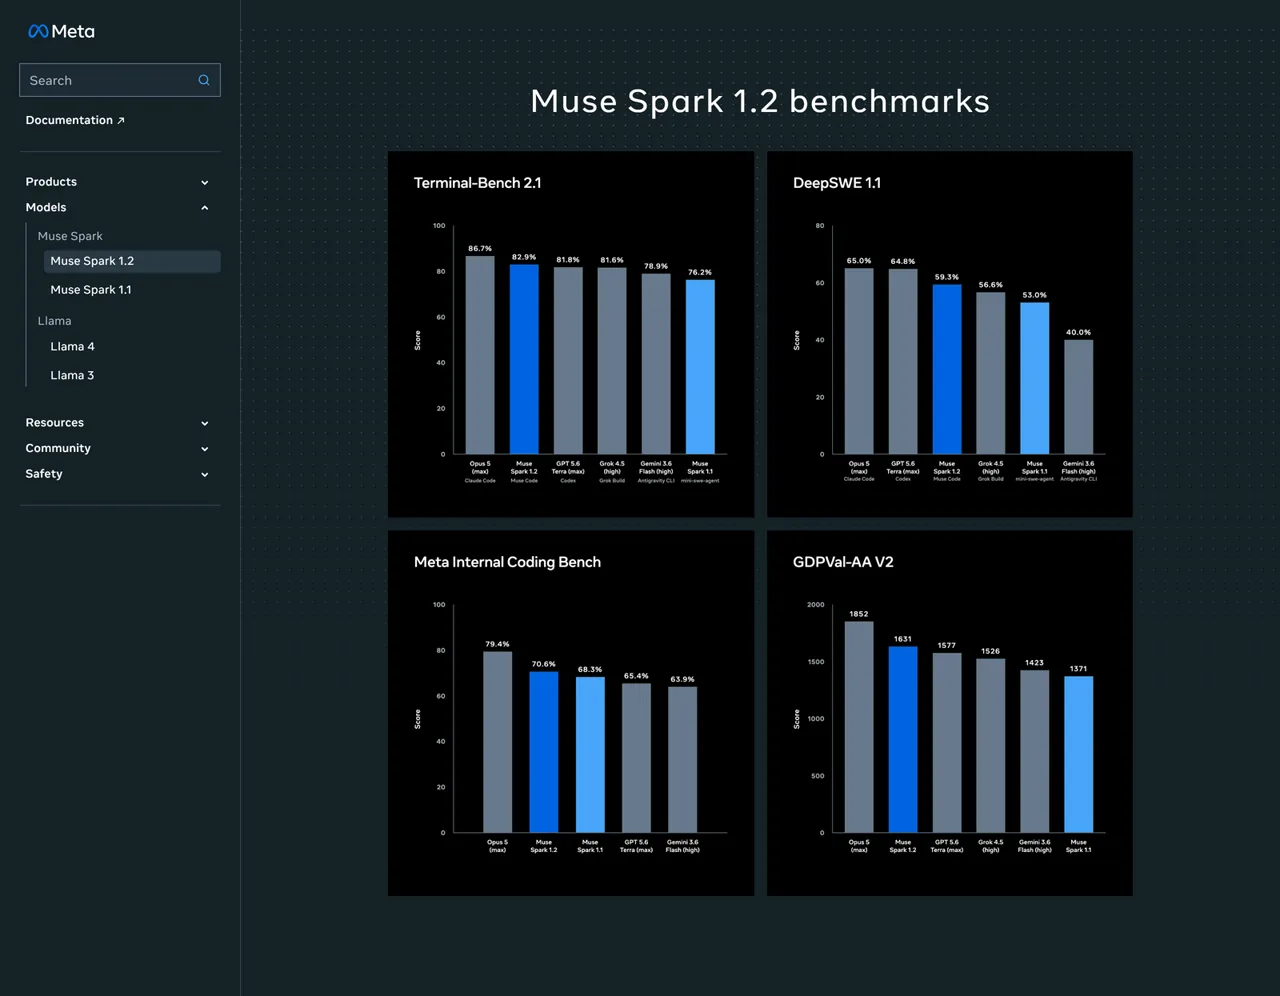
Volgens de benchmarkgrafiek van Meta staat Muse Spark 1.2 in verschillende programmeerevaluaties in de top. De cijfers zijn het bekijken waard, maar ze vormen geen eenduidige ranglijst van de pure kwaliteit van het model. Het model, de agent, het testraamwerk, de redeneerkracht en het taakprotocol kunnen allemaal samen veranderen.
Meta-gerapporteerde Terminal-Bench 2.1
Meta-benchmarkpanel
Terminal-Bench 2.1
Alle 89 taken · geslaagd@1 na vijf pogingen · geselecteerde combinaties van modellen en agenten
Het cijfer 82,9% is een Resultaat van de meta-run van de Muse-code. De openbaar klassement van Terminal-Bench 2.1 heeft Muse Spark 1.2 op 26 augustus 2026 niet in de lijst opgenomen, dus het is geen geverifieerde vermelding op het openbare klassement. Op het openbare bord stond Muse Spark 1.1 met mini-SWE-agent vermeld bij 76,2% ±1,2%.
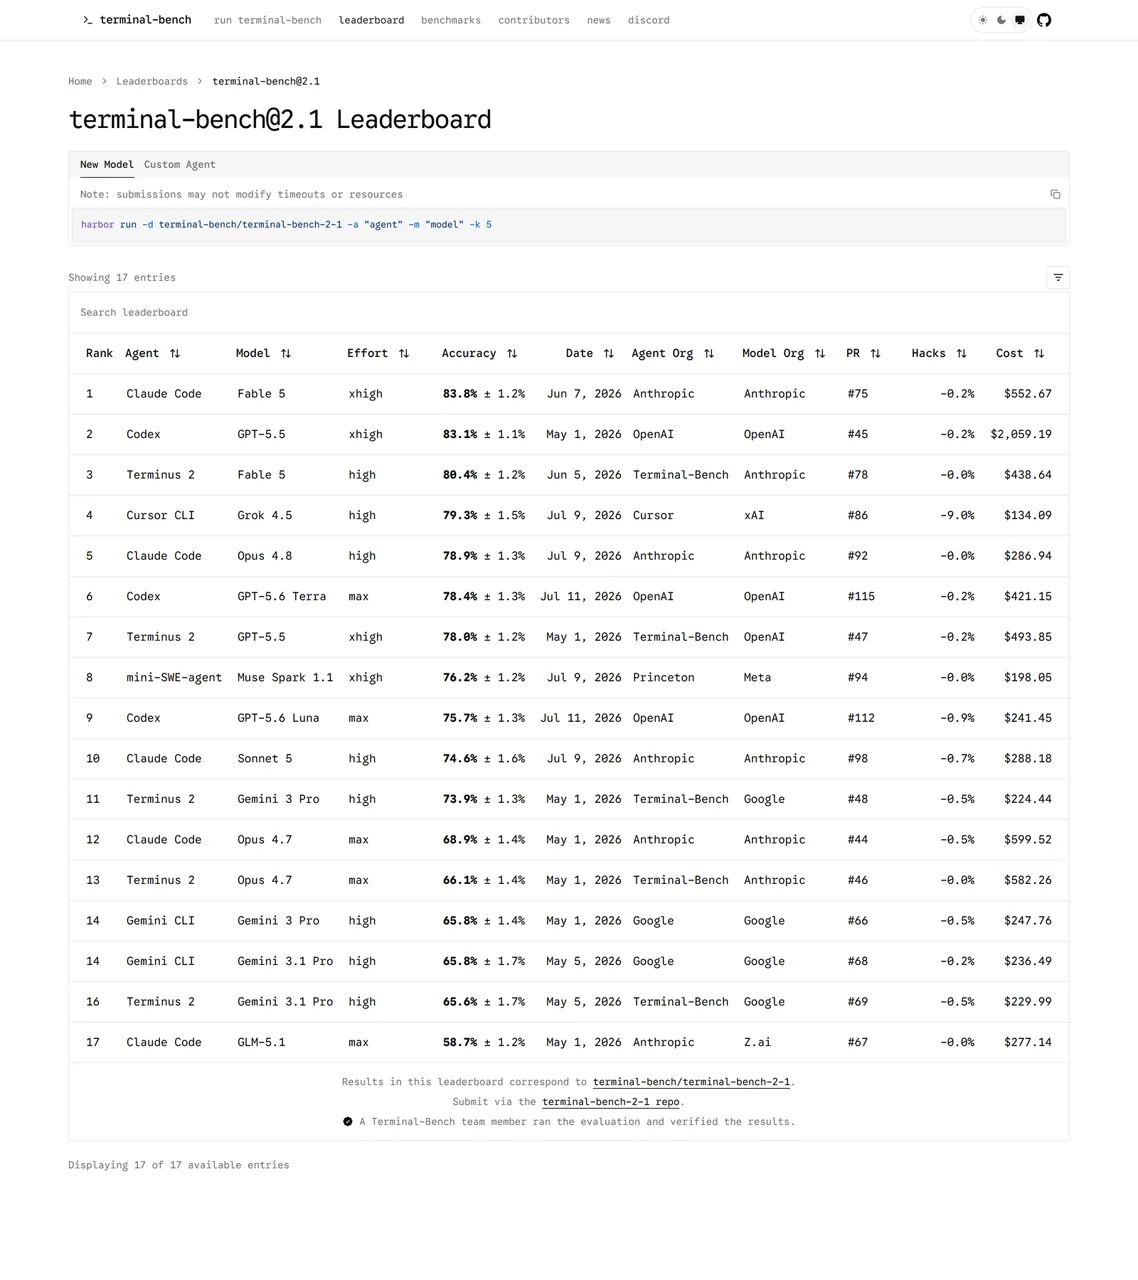
Meta-rapportage DeepSWE 1.1
Meta-benchmarkpanel
DeepSWE 1.1
113 taken · 91 repositories · vijf talen · geslaagd bij de eerste poging na vijf pogingen
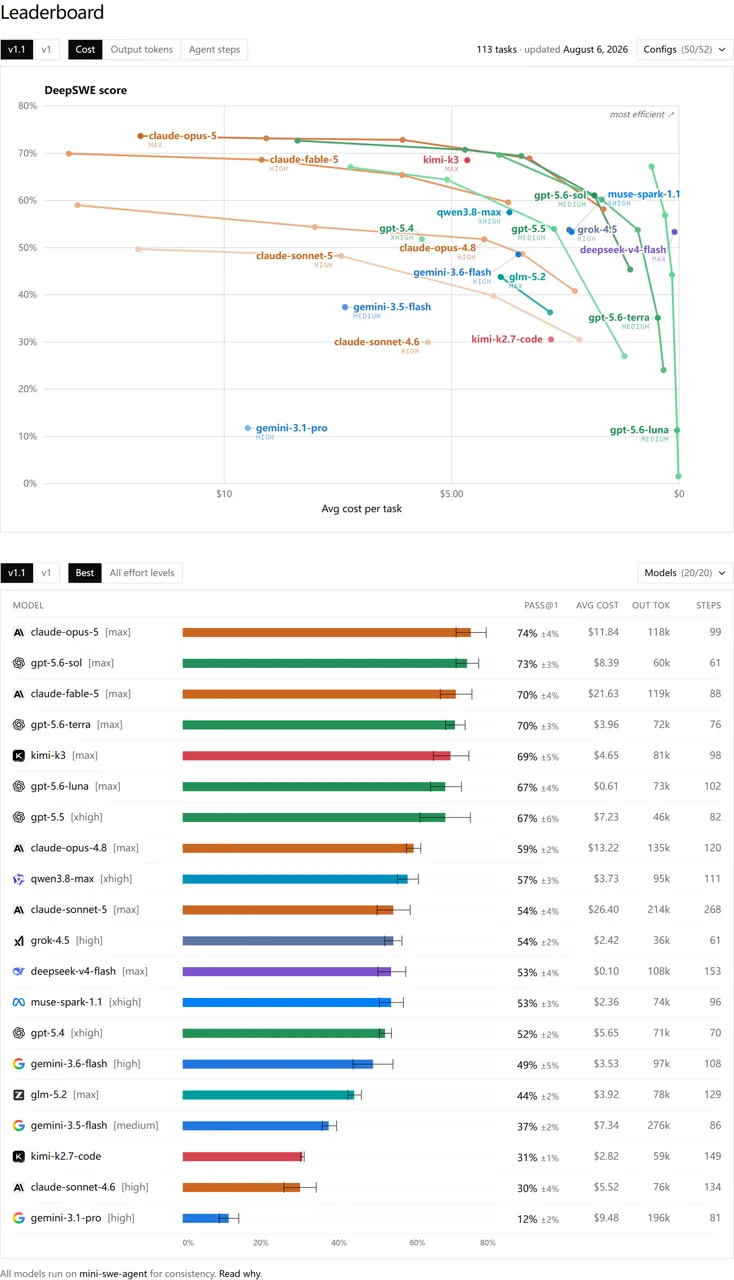
De openbaar DeepSWE v1.1-klassement gebruikt mini-swe-agent voor al zijn vermelde modellen omwille van de consistentie. Op het moment van controle was Muse Spark 1.2 nog niet toegevoegd; Muse Spark 1.1 stond vermeld als 53%. Het resultaat van Meta (59,3%) is gebaseerd op Muse Code, dus de twee getallen zijn niet identiek wat betreft de testopstelling.
De interne en algemene agentbeoordelingen van Meta
Twee verschillende beoordelingsschalen
Meta Interne codeerwerkbank
440 interne taken · twee pogingen per taak
| Model | Score |
|---|---|
| Opus 5 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3,6 Flash | 63.9% |
| Grok 4,5 | Niet afgebeeld |
GDPVal-AA v2
Algemene evaluatie van agentische taken · Waarden in Elo-stijl
| Model | Score |
|---|---|
| Opus 5 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4,5 | 1526 |
| Gemini 3,6 Flash | 1423 |
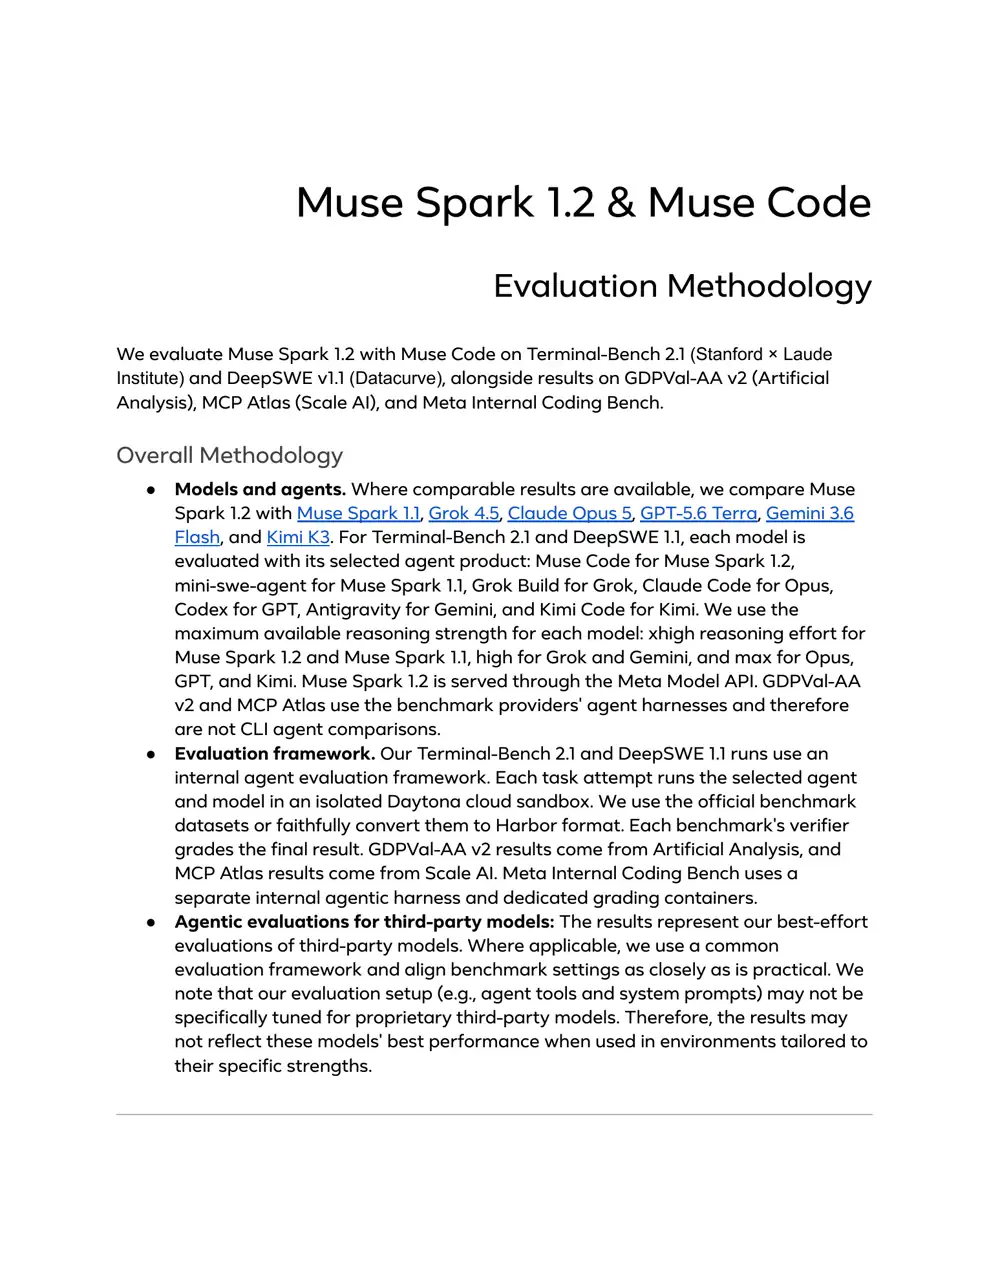
Meta’s evaluatiemethode Volgens Terminal-Bench worden alle 89 taken uitgevoerd en wordt bij vijf pogingen een pass@1 behaald. DeepSWE bestrijkt 113 taken verspreid over 91 repositories en vijf talen, en behaalt eveneens een pass@1 bij vijf pogingen. Meta merkt ook op dat de opzet mogelijk niet optimaal is afgestemd op modellen van derden. Zie voor een actuele vergelijking met concurrenten, gebaseerd op echte productbeslissingen, Claude Opus 5 tegen GPT-5.6.
De methodologie verandert de betekenis
Model + geselecteerde agent
89 taken, vijf pogingen, verschillende instellingen voor het maximale redeneervermogen, en het systeem van Meta is mogelijk niet in gelijke mate afgestemd op systemen van derden.
Geverifieerde vermeldingen
Muse Spark 1.2 ontbrak bij controle. De configuraties en de verificatiestatus van het bord moeten afzonderlijk worden afgelezen uit de tabel van Meta.
Veelgebruikte mini-swe-agent
113 taken verspreid over 91 repositories en vijf talen. Muse Spark 1.2 ontbrak; Muse Spark 1.1 stond vermeld bij 53%.
Kunstmatige analyse: nuttige onafhankelijke context
De Pagina met het kunstmatige analysemodel geeft Muse Spark 1.2 een intelligentie-index van 57, boven de mediaan van vergelijkbare modellen van 35, zoals vastgesteld op 26 augustus 2026. De prestaties van het harnas bedragen 80% op Terminal-Bench v2.1, 57% genormaliseerd op GDPVal-AA v2, 56% op SciCode en 83% bij de AA-LCR-evaluatie met lange context.
Afwijkingen in de versie van de kunstmatige analyse
De praktische les is simpel: Muse Spark 1.2 lijkt concurrerend, maar geen enkele score kan het model op zichzelf beoordelen. Beschouw de grafiek van Meta als bewijs voor het Muse Code-systeem, openbare ranglijsten als een afzonderlijke controle, en Artificial Analysis als een onafhankelijke maar anders geconfigureerde evaluatie.
Muse Spark 1.2: afwegingen tussen prijs en privacy
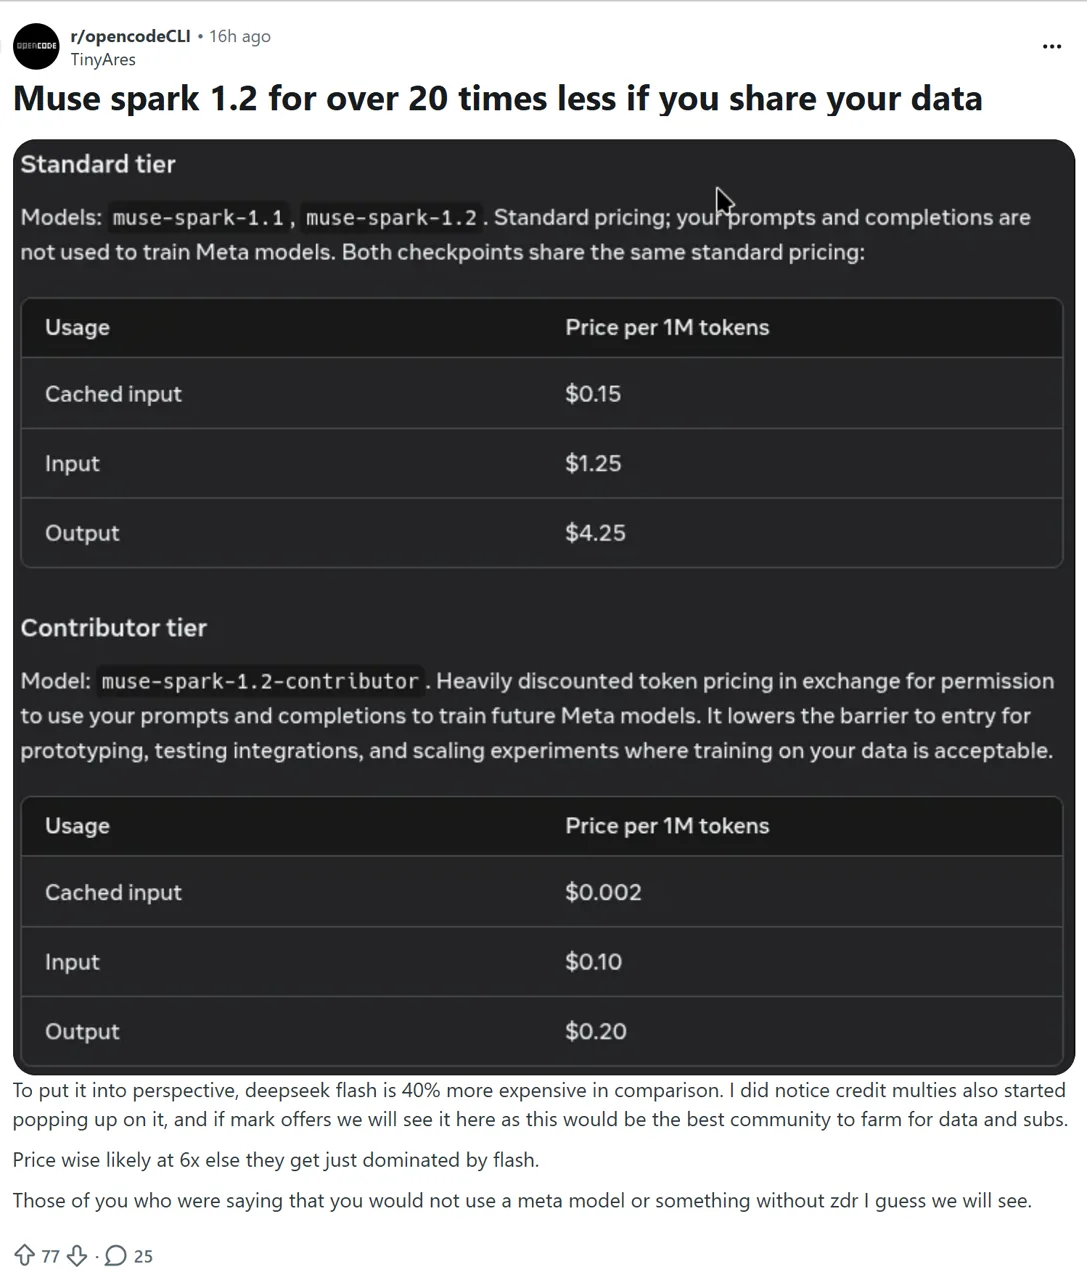
Meta biedt twee API-model-ID’s aan met sterk uiteenlopende prijzen. De goedkopere optie is niet zomaar een korting: het heeft gevolgen voor de manier waarop de ingediende gegevens mogen worden gebruikt.
USD per miljoen tokens · 1M-context
Wordt niet gebruikt voor productverbetering
Wordt niet gebruikt om Meta-producten te verbeteren
Goedkoper, maar met een afweging ten aanzien van het dataverbruik
Gegevens kan worden gebruikt om Meta-producten te verbeteren
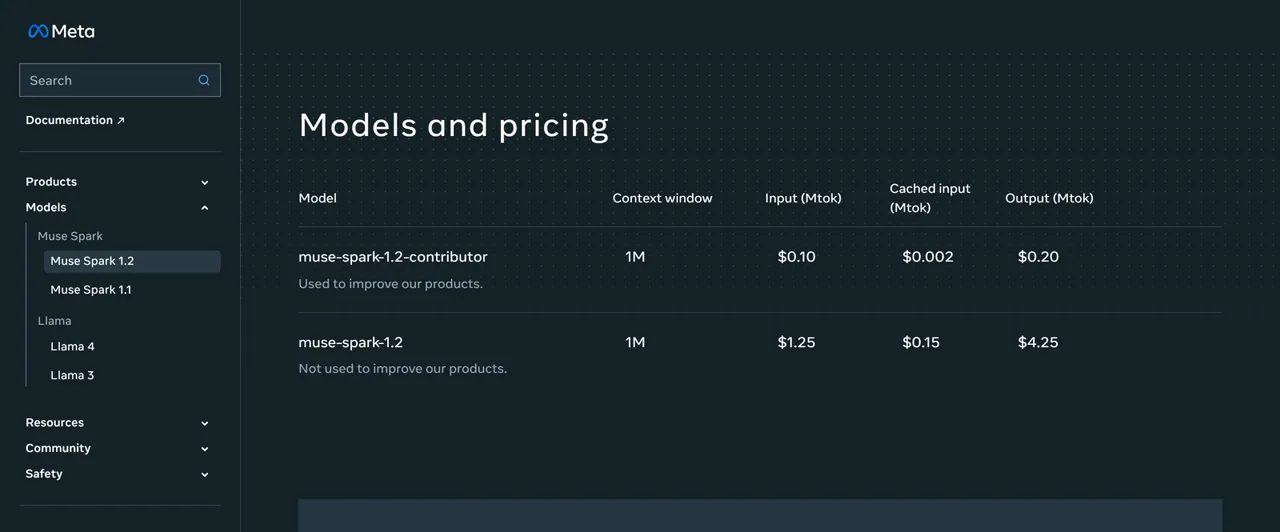
De tarieven voor bijdragers zijn 12,5× goedkoper voor invoer, 75× goedkoper voor in de cache opgeslagen invoer en 21,25× goedkoper voor uitvoer dan het standaardtarief. Er is geen eenduidig kortingspercentage dat voor elk type token geldt.
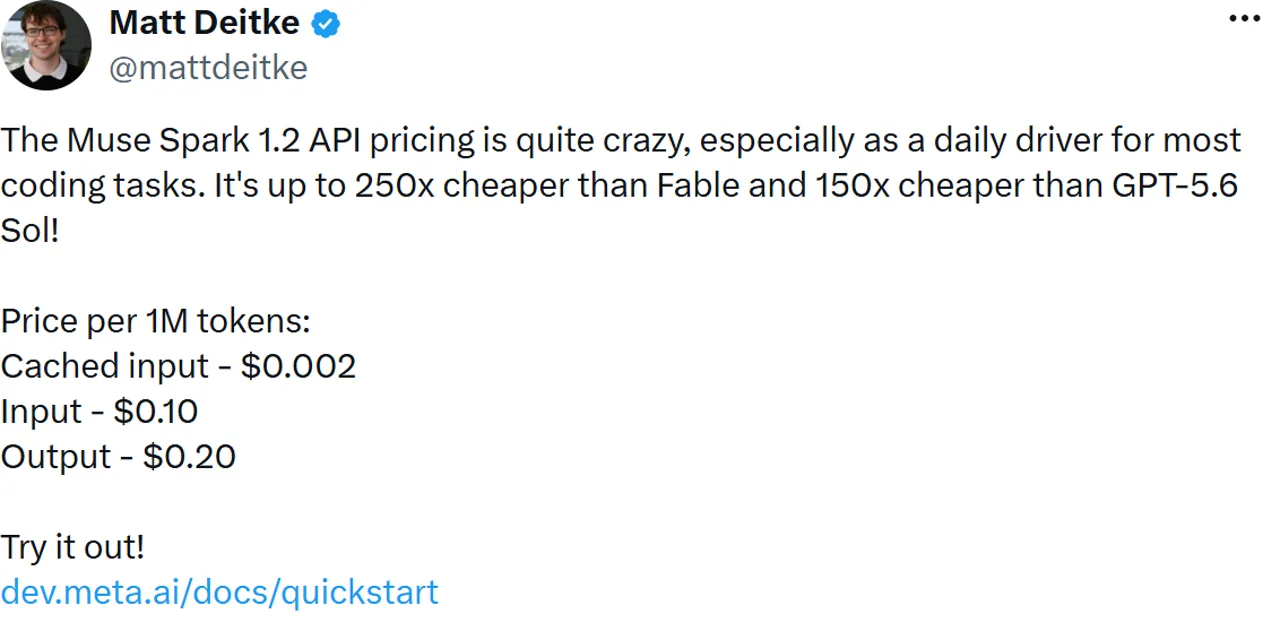
Een onderzoeker bij Meta prees het Contributor-niveau aan als “tot 250× goedkoper” dan Fable en “150× goedkoper” dan GPT-5.6 Sol. Dat sociale vergelijking maakt gebruik van de Contributor-tarieven, niet van het standaardmodel, en moet altijd vergezeld gaan van de vermelding over het dataverbruik. Lezers die de huidige kosten van concurrenten willen vergelijken, kunnen gebruikmaken van onze aparte Prijsgids GPT-5.6 en Claude: uitsplitsing van de prijsopbouw.
Voor openbare repositories, synthetische taken of tijdelijke evaluatieomgevingen kan het Contributor-niveau aantrekkelijk zijn. Voor privécode, klantgegevens, inloggegevens of eigen architectuur is het standaardniveau de veiligere standaardkeuze. Meta geeft ook aan dat het nu verzoeken om geen gegevens te bewaren via de verkoopafdeling begint te accepteren; dit is een apart toegangstraject in plaats van de standaard selfservice-instelling.
Muse Spark 1.2: API-toegang en voorbeeld
Drie officiële toegangswegen
Officiële basis-URL van het kookboek: https://api.meta.ai/v1 · 1.2 verzoek in deze evaluatie: niet uitgevoerd
De Meta Model API ondersteunt een OpenAI SDK-compatibele workflow. In het officiële handboek van Meta wordt de basis-URL gebruikt https://api.meta.ai/v1 en leest de sleutel uit MODEL_API_KEY. Op de productpagina wordt ook ‘search grounding’ beschreven, terwijl het kookboek onderwerpen behandelt als het aanvullen van chatberichten, streaming, het aanroepen van tools, gestructureerde uitvoer, het in de cache opslaan van prompts, redeneerfuncties, beeldverwerking, lange context, herhalingspogingen en zoekrecepten.
Voorbeeld van een officieel kookboek — vastgelegde versie: De officieel GitHub-handboek gebruikt nog steeds muse-spark-1.1. Dit toont de structuur van de client en de basis-URL aan, niet dat het voorbeeld is bijgewerkt voor versie 1.2.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)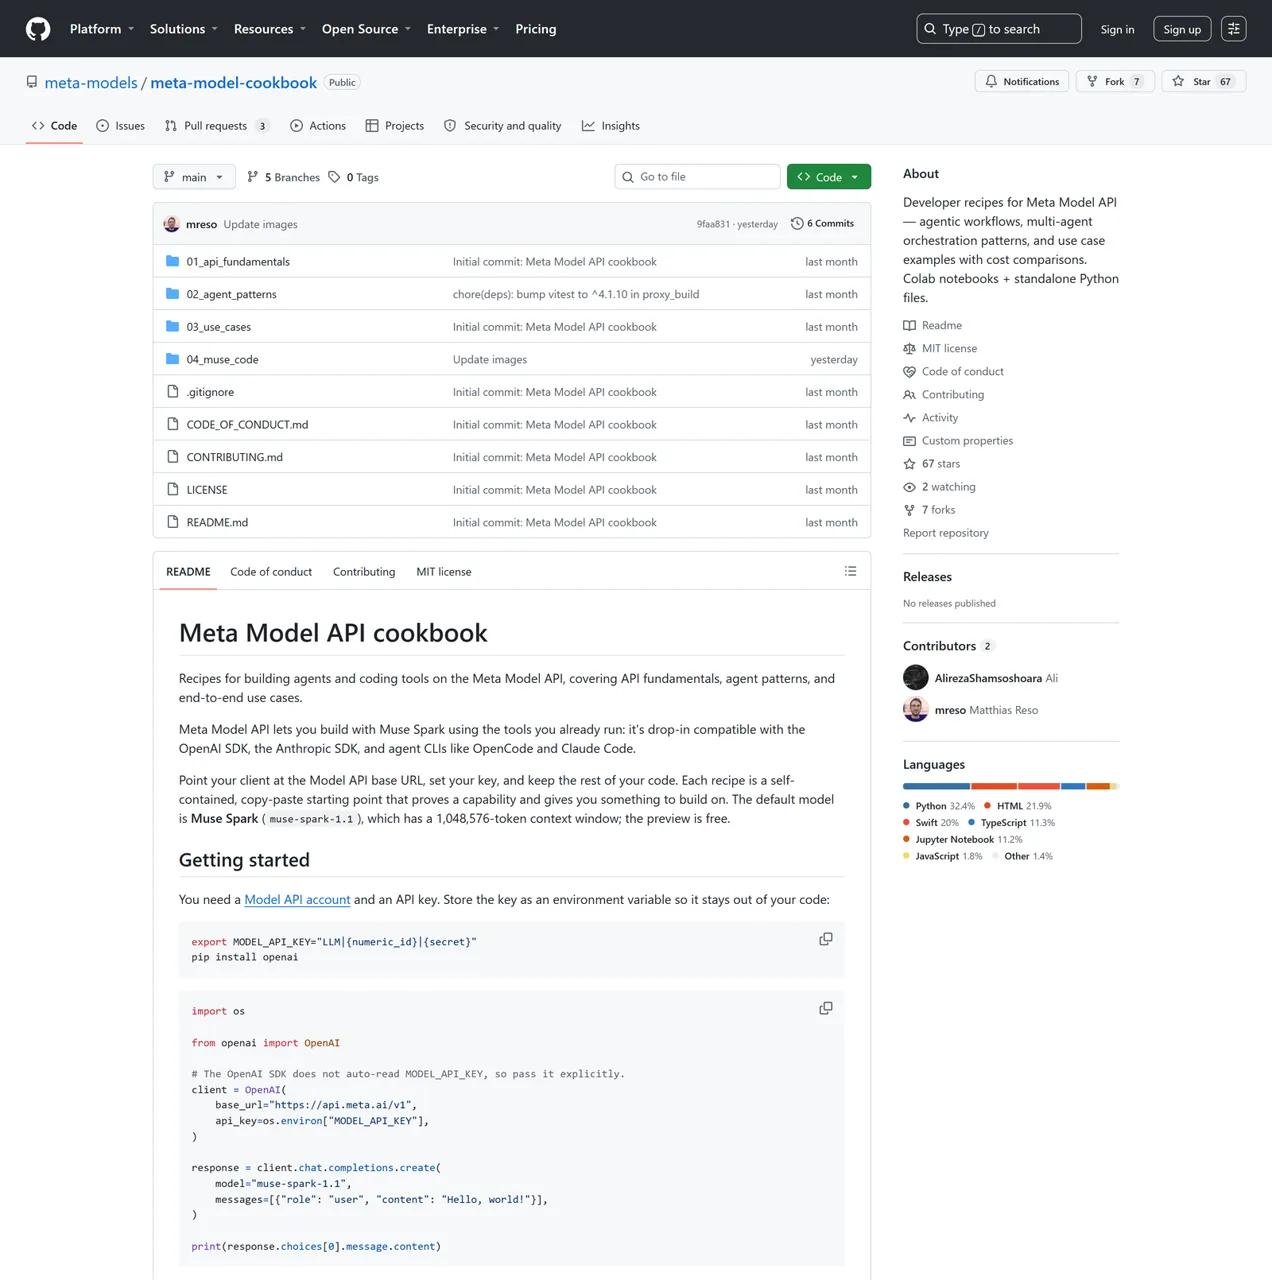
Aangepast volgens documentatie — niet uitgevoerd: Meta vermeldt afzonderlijk muse-spark-1.2 als standaardmodel-ID 1.2. De onderstaande minimale vervanging combineert twee officiële feiten, maar tijdens deze beoordeling is er geen betaald verzoek verzonden.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Spark is een redeneermodel, en redeneringstokens worden als output in rekening gebracht. Daardoor is de standaarduitvoersnelheid van $4,25 belangrijker dan op het eerste gezicht lijkt: een ogenschijnlijk kort antwoord kan toch een verborgen redenering bevatten. De werkelijke latentie, de tijd tot het eerste token, de herhalingsfrequentie en de kosten per taak worden hier nog niet gemeten.
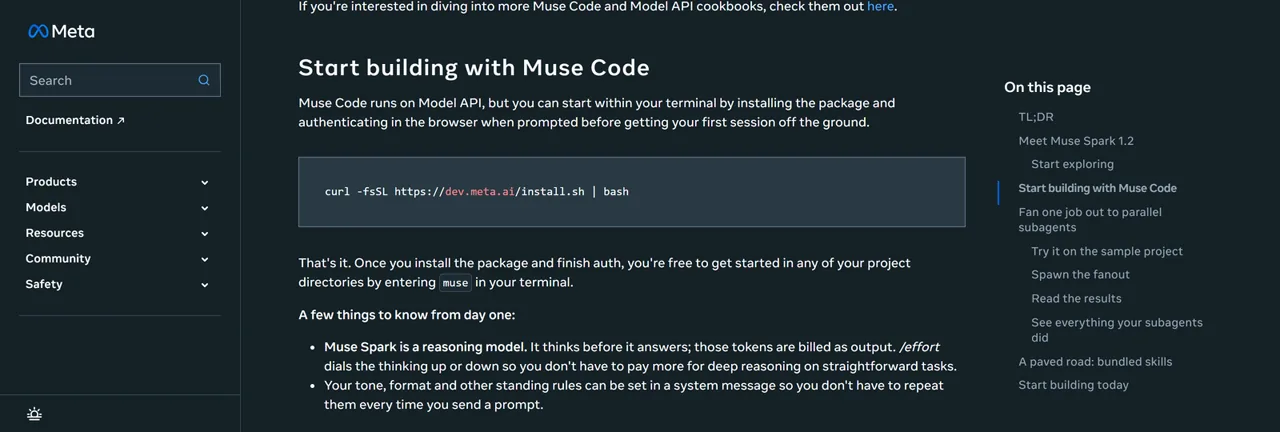
/inspanning Het commando past de redeneringsdiepte aan. Bron: Meta-ontwikkelaarsgids.Wat Muse Code te bieden heeft
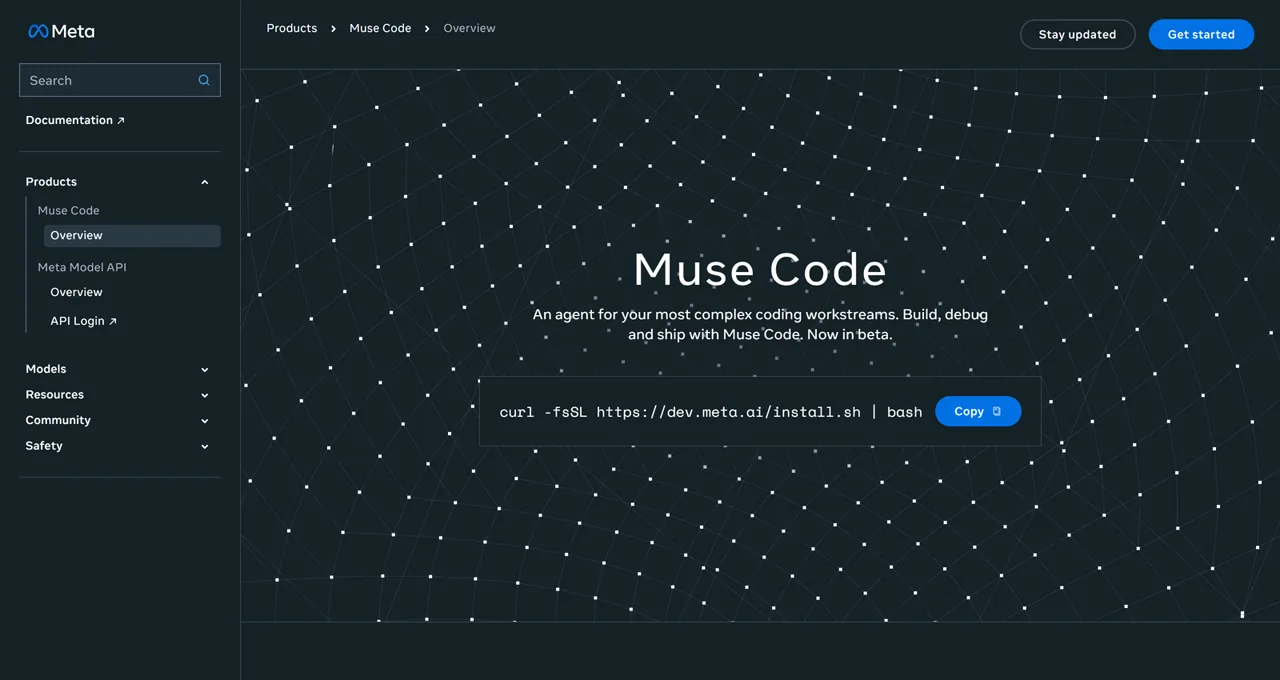
Muse Code wordt via de terminal geïnstalleerd en integreert Muse Spark 1.2 in een agent-workflow. Meta’s een diepgaande blik op de ontwikkelaar beschrijft een aantal gedragingen die niet bij een ‘naakte’ API-aanroep horen:
- Parallelle agents: taken kunnen in geïsoleerde Git-werkbomen worden uitgevoerd.
- Gebeurtenislogboek dat alleen kan worden aangevuld: Sessies en acties worden opgeslagen in een lokaal JSONL-bestand voor auditdoeleinden en om ze later te kunnen afspelen.
- Vervolg van het cv:
CV van Musekunnen onderbroken sessies voortzetten. - Controle van de redenering: de
/inspanningMet dit commando kun je de sterkte van de redenering aanpassen. - Concrete vaardigheden: Metanamen
/smaak,/barbecueën,/grill-met-documentatie, en/plan.
Productkenmerken van de agent
Subagenten
Onafhankelijke taken kunnen zich vertakken.
Werkbomen
De branches blijven gescheiden tijdens het parallel werken.
JSONL-logboek
Lokale gebeurtenissen die alleen kunnen worden aangevuld, ondersteunen het opnieuw afspelen.
CV
CV van Muse zet de onderbroken sessies voort.
Vaardigheden
/smaak, /barbecueën, /grill-met-documentatie, /plan.
Dankzij die functies is Muse Code relevant voor de bredere markt voor programmeeragenten, waar planning, isolatie, herhaling en het consequent gebruik van tools net zo belangrijk zijn als de intelligentie van het model. De OpenClaw versus Claude: gids voor Code versus OpenCode biedt nuttige achtergrondinformatie over die verschillen op productniveau.
Lanceringsclaims en eerste reacties uit de community
Een reactie is geen bevestiging
Opleiding + langetermijnvisie
Meer rekenkracht voor het programmeren, diversiteit in de omgeving, co-training en een stresstest met meer dan 1.000 tool-aanroepen.
Prijs en OpenCode
Een Reddit-gebruiker prees een vroege programmeerervaring en de waarde daarvan.
Privacy + betrouwbaarheid
Andere gebruikers uitten hun bezorgdheid over het dataverbruik, de standaardprijs, de beschikbaarheid en de betrouwbaarheid in het begin.
Volgens de AI-afdeling van Meta heeft Muse Spark 1.2 meer rekenkracht gekregen voor programmeertraining, meer gevarieerde omgevingen, meer nadruk op het genereren en debuggen van volledige repositories, en co-training met Muse Code. Een afzonderlijke startdiscussie beschrijft een stresstest van maximaal 24 uur met meer dan 1.000 tool-aanroepen op NVIDIA Hopper-GPU’s.
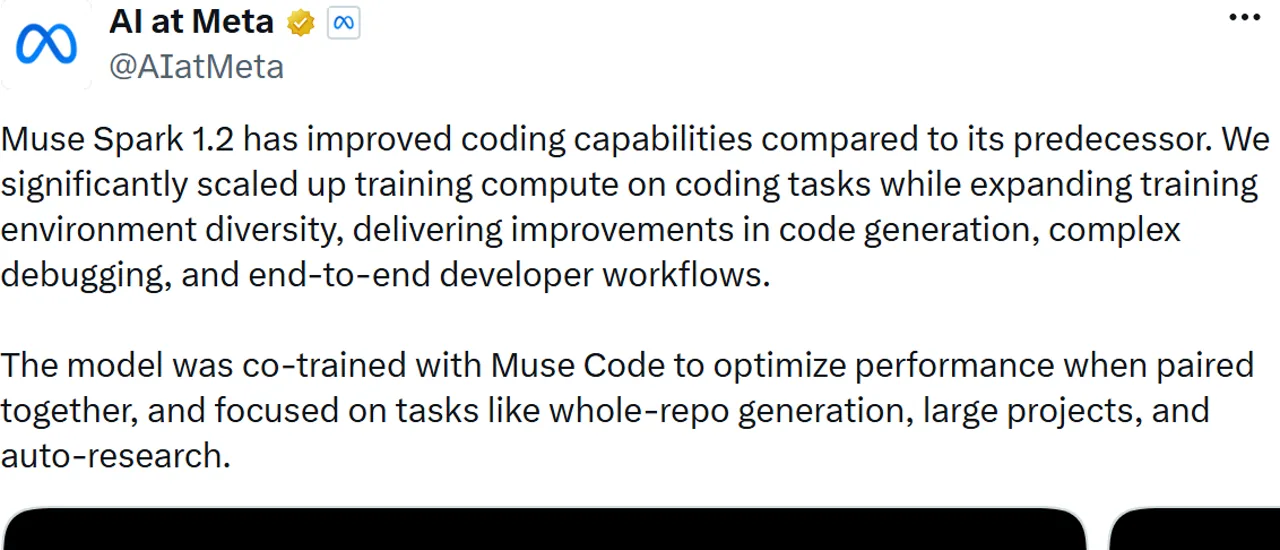
Dat is een indrukwekkende demonstratie, maar het is geen gemeten algemeen succespercentage. Het geeft geen uitsluitsel over hoe vaak de agent het juiste hulpmiddel heeft gekozen, fouten heeft hersteld, dubbele oproepen heeft voorkomen of een normale repository-taak heeft voltooid zonder sturing.
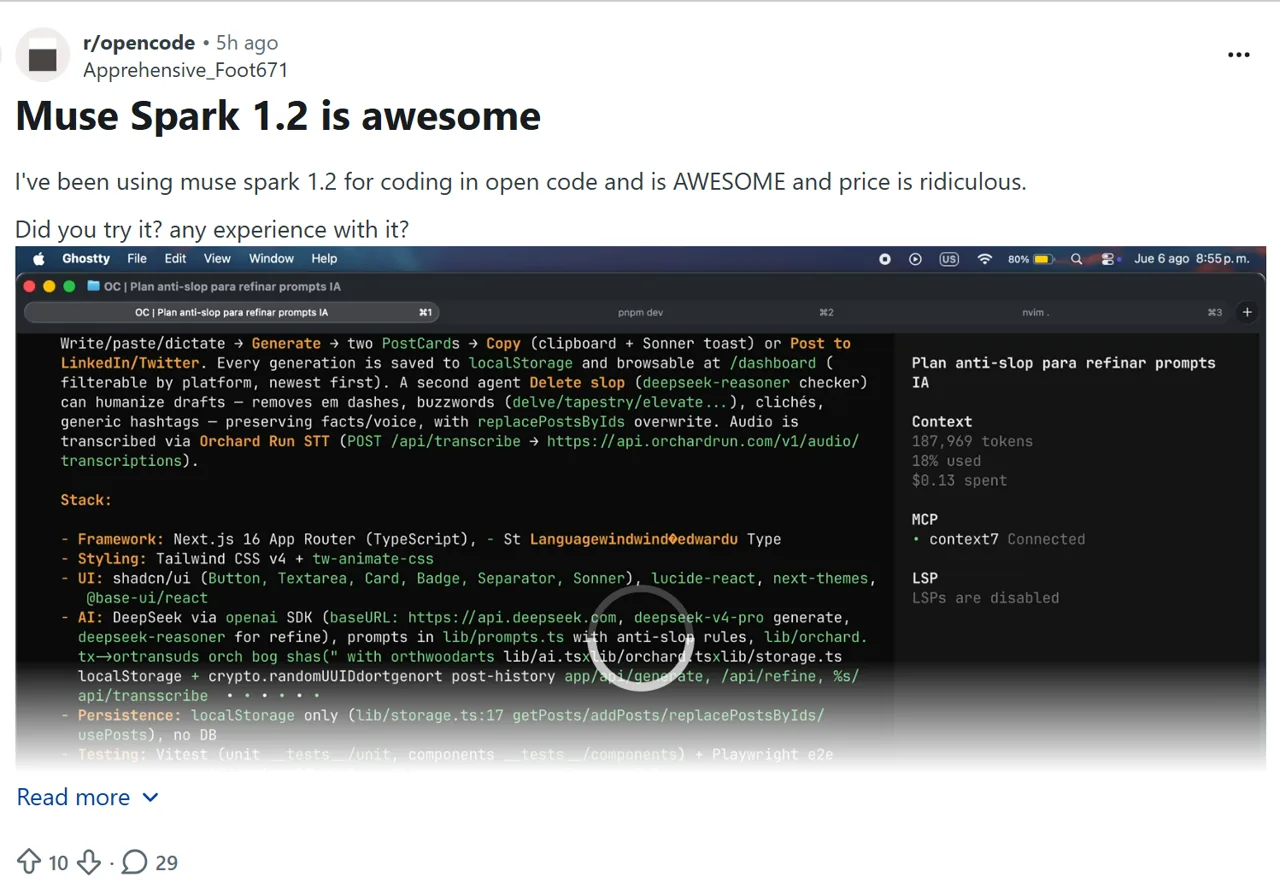
De vroege berichten op Reddit zijn eveneens gemengd. Eén Een gebruiker van r/opencode heeft een positieve ervaring met OpenCode gemeld en was te spreken over de prijs. Een afzonderlijke Discussie over de prijsstelling voor bijdragers er werden vragen gesteld over het toegenomen dataverbruik, de kosten van het standaardpakket, de beschikbaarheid en de betrouwbaarheid. Dit zijn individuele reacties, geen consensus binnen de gemeenschap.
Muse Spark 1.2-programmeertests: 3 van de 3 opdrachten geslaagd
Tijdens onze tests heeft het basismodel Muse Spark 1.2 drie gecontroleerde programmeertaken uitgevoerd via een OpenAI-compatibele API voor het aanvullen van chatberichten. Voor elke taak was één poging toegestaan, zonder herhalingen en zonder menselijke tussenkomst. We hebben de teruggestuurde bestanden in tijdelijke opslagplaatsen beoordeeld aan de hand van openbare en verborgen controles. De uitvoering van de Muse Code-agent is niet getest, evenmin als de betrouwbaarheid van het aanroepen van tools; deze resultaten mogen dan ook niet worden beschouwd als een benchmark voor de agent.
Resultaat na één poging
In de antwoorden werden 6.618 redeneringstokens gebruikt. De drie redenen voor de einduitslag waren stop, en in het veld ‘provider’ werd ‘Meta’ vermeld.
Test 1: Bugfix voor idempotentie in Python — Geslaagd
Voorkom dubbele overboekingen zonder de openbare API te wijzigen
Het model heeft de ontbrekende beveiliging voor het verzoek-ID opgespoord, de kleinst mogelijke veilige oplossing toegevoegd en een regressietest geleverd, waarbij de atomaire balansupdates behouden bleven.
De oorspronkelijke verborgen evaluator vereiste ten onrechte een dubbele aanroep om terug te keren Onjuist, hoewel de opdracht alleen vereiste dat de afzender niet tweemaal in rekening werd gebracht. Nadat we die verzonnen eis met betrekking tot de retourwaarde hadden gecorrigeerd, doorstond het ongewijzigde eerste antwoord alle zes de tests. We hebben de modeluitvoer niet opnieuw geprobeerd of aangepast.
Test 2: Refactoring van meerdere TypeScript-bestanden — Geslaagd
Afzonderlijke validatie, persistentie en auditlogging
De teruggestuurde bestanden behielden het openbare routecontract, strikte TypeScript-regels en de enkele transactie die zowel de order- als de audit-schrijfbewerkingen omvat. Daarnaast werden er gerichte validatietests toegevoegd zonder afhankelijkheid van de runtime.
De eerste beoordelaar vergeleek voorwerpen met ruwe JSON.stringify, waardoor gelijkwaardige objecten met een verschillende volgorde van sleutelinvoeging er ongelijk uitzagen; de Windows-versie npx Ook de start mislukte vóór de typecontrole. Met een vergelijkingsfunctie die niet op volgorde let en een Windows-veilige opdrachtuitvoering doorstond het oorspronkelijke antwoord alle controles. Ook hier vond er geen modelherpoging plaats.
Test 3: JSONL-repository-functie — Geslaagd
Instructies die voor de gehele repository gelden
JSONL toevoegen zonder de CSV te verstoren
Het model beschikte over uitbreidingsdetectie, op één gebaseerde fouten bij onjuist opgebouwde regels, atomaire uitvoer, veiligheid bij droogdraaien, gerichte tests, helptekst en een voorbeeld in het README-bestand.
Wat uit de tests blijkt: Muse Spark 1.2 kan in één keer bruikbare patches voor meerdere bestanden genereren, rekening houden met compatibiliteitsbeperkingen, tests toevoegen en een bescheiden, repository-brede functie verwerken. De gemiddelde gerapporteerde kosten bedroegen ongeveer $0.0151 per taak, maar deze testcases waren klein van omvang en mogen niet worden gebruikt om de kosten voor een grote codebase te voorspellen.
Voor wie is Muse Spark 1.2 bedoeld?
Beslissingsgids
Gecontroleerde evaluatie
Openbare of synthetische code, meetbare taken, behoeften in een brede context en een veelbelovend 3/3-resultaat voor het basismodel.
Bewijs van makelaardij vereist
Het gedrag van Muse Code, stabiele limieten voor het aantal verzoeken, herhaalde aanroepen van tools of uitgebreide benchmarks van repositories vormen beslissingscriteria.
Gevoelige code of hoge output
Gebruik het standaardniveau of vergelijk alternatieven wanneer privacy en de kosten van redeneringstokens doorslaggevend zijn.
Gebruik het standaardmodel voor gevoelige code, tenzij uw organisatie de voorwaarden voor bijdragers afzonderlijk heeft goedgekeurd. Als de standaarduitvoerprijs invloed heeft op de berekening van de waarde, vergelijk deze dan met de huidige Prijzen volgens de Codex, de Claude-code en andere kosten voor coderingsmiddelen, voordat u een workflow vastlegt.
Muse Spark 1.2: conclusie van de review
Muse Spark 1.2 heeft een plaats op de shortlist voor de evaluatie veroverd, maar dit betekent niet dat het automatisch wordt aanbevolen voor productie. De context van het 1M-token, de vertrouwde API-structuur, de lage prijzen voor bijdragers, de mogelijkheid om drie keer in één keer te programmeren en de hoge scores van Muse Code bij Meta-run maken het moeilijk om dit te negeren. Meta heeft bovendien, in vergelijking met veel andere lanceringen, de details van de methodologie beter bekendgemaakt.
De kanttekeningen zijn al even concreet. De tarieven voor bijdragers gaan gepaard met een afweging ten aanzien van het dataverbruik. Standaard-output- en redeneringstokens kunnen de werkelijke kosten opdrijven. De beste programmeerresultaten van Meta zijn niet gereproduceerd als overeenkomende vermeldingen op de openbare Terminal-Bench- of DeepSWE-borden, en onze praktische steekproef omvat drie basismodeltaken in plaats van de uitvoering door Muse Code-agenten.
Het is verstandig om eerst een gecontroleerde test uit te voeren op niet-gevoelige code, waarbij de ruwe gebruiksgegevens en lokale verificatieresultaten worden opgeslagen. Beschouw de gemeten kosten en latentie als een steekproef op basis van kleine taken, en test vervolgens de omvang van je eigen repository, het herstel na storingen en de workflow van de agent voordat je deze oplossing voor productieomgevingen kiest.
Veelgestelde vragen over Muse Spark 1.2
Wat is Muse Spark 1.2?
Muse Spark 1.2 is het op programmeren gerichte model van Meta, dat op 5 augustus 2026 werd gelanceerd, met een contextvenster van 1 miljoen tokens en toegang via Muse Code, de Meta Model API en OpenRouter.
Is Muse Spark 1.2 hetzelfde als Muse Code?
Nee. Muse Spark 1.2 is het model; Muse Code is een aparte bèta-terminalagent die hierop is gebaseerd. Muse Code voegt productfuncties toe zoals subagenten, geïsoleerde Git-werkbomen, gebeurtenislogging, hervatten en gebundelde vaardigheden.
Hoeveel kost de Muse Spark 1.2 API?
Het standaardmodel kost $1,25 input, $0,15 cached input en $4,25 output per miljoen tokens. Het Contributor-model kost $0,10 input, $0,002 cached input en $0,20 output.
Gebruikt Meta gegevens van de Muse Spark API voor het trainen van modellen?
Meta geeft aan dat gegevens van het standaardniveau niet worden gebruikt om Meta-producten te verbeteren. Gegevens van het bijdragerniveau kunnen wel worden gebruikt om Meta-producten te verbeteren; daarom moet voor privé- of eigen code de standaardroute worden gevolgd, tenzij een organisatie anders beslist.
Staat Muse Spark 1.2 op de openbare ranglijsten van Terminal-Bench of DeepSWE?
Toen dit op 7 augustus 2026 werd gecontroleerd, stond het op geen van beide openbare borden vermeld. Meta rapporteert 82,91 TP40T op Terminal-Bench 2.1 met Muse Code en 59,31 TP40T op DeepSWE, maar dat zijn resultaten die door Meta zelf zijn uitgevoerd.
Is Muse Spark 1.2 in deze recensie in de praktijk getest?
Ja. In drie tests met het basismodel, waarbij telkens één poging werd gedaan, slaagde Muse Spark 1.2 voor een Python-bugfix, een TypeScript-refactor en een JSONL-repository-functie. De gemiddelde latentie bedroeg 12,98 seconden en de totale gerapporteerde kosten waren $0,045362. De betrouwbaarheid van de Muse Code-agent en het aanroepen van tools werd niet getest.
Hoe krijgen ontwikkelaars toegang tot Muse Spark 1.2?
Meta noemt drie manieren: de Muse Code beta-terminalagent, de Meta Model API en OpenRouter. In het officiële handboek wordt gebruikgemaakt van een OpenAI SDK-compatibele client met de basis-URL https://api.meta.ai/v1.