Een verkennend GlobalGPT-onderzoek naar het delegeren van taken, outputvereisten en gebruikerscontrole.
Gegevensbron en toestemming: In dit onderzoek is gebruikgemaakt van gegevens van gebruikers die in augustus vrijwillig hun gegevens met GlobalGPT hebben gedeeld en toestemming hebben gegeven voor het gebruik ervan in dit onderzoek. Voorbeelden zijn gegeneraliseerd om de privacy te beschermen. Exacte totalen van activiteiten, aantallen accounts, steekproefgroottes en observatiedata worden niet openbaar gemaakt.
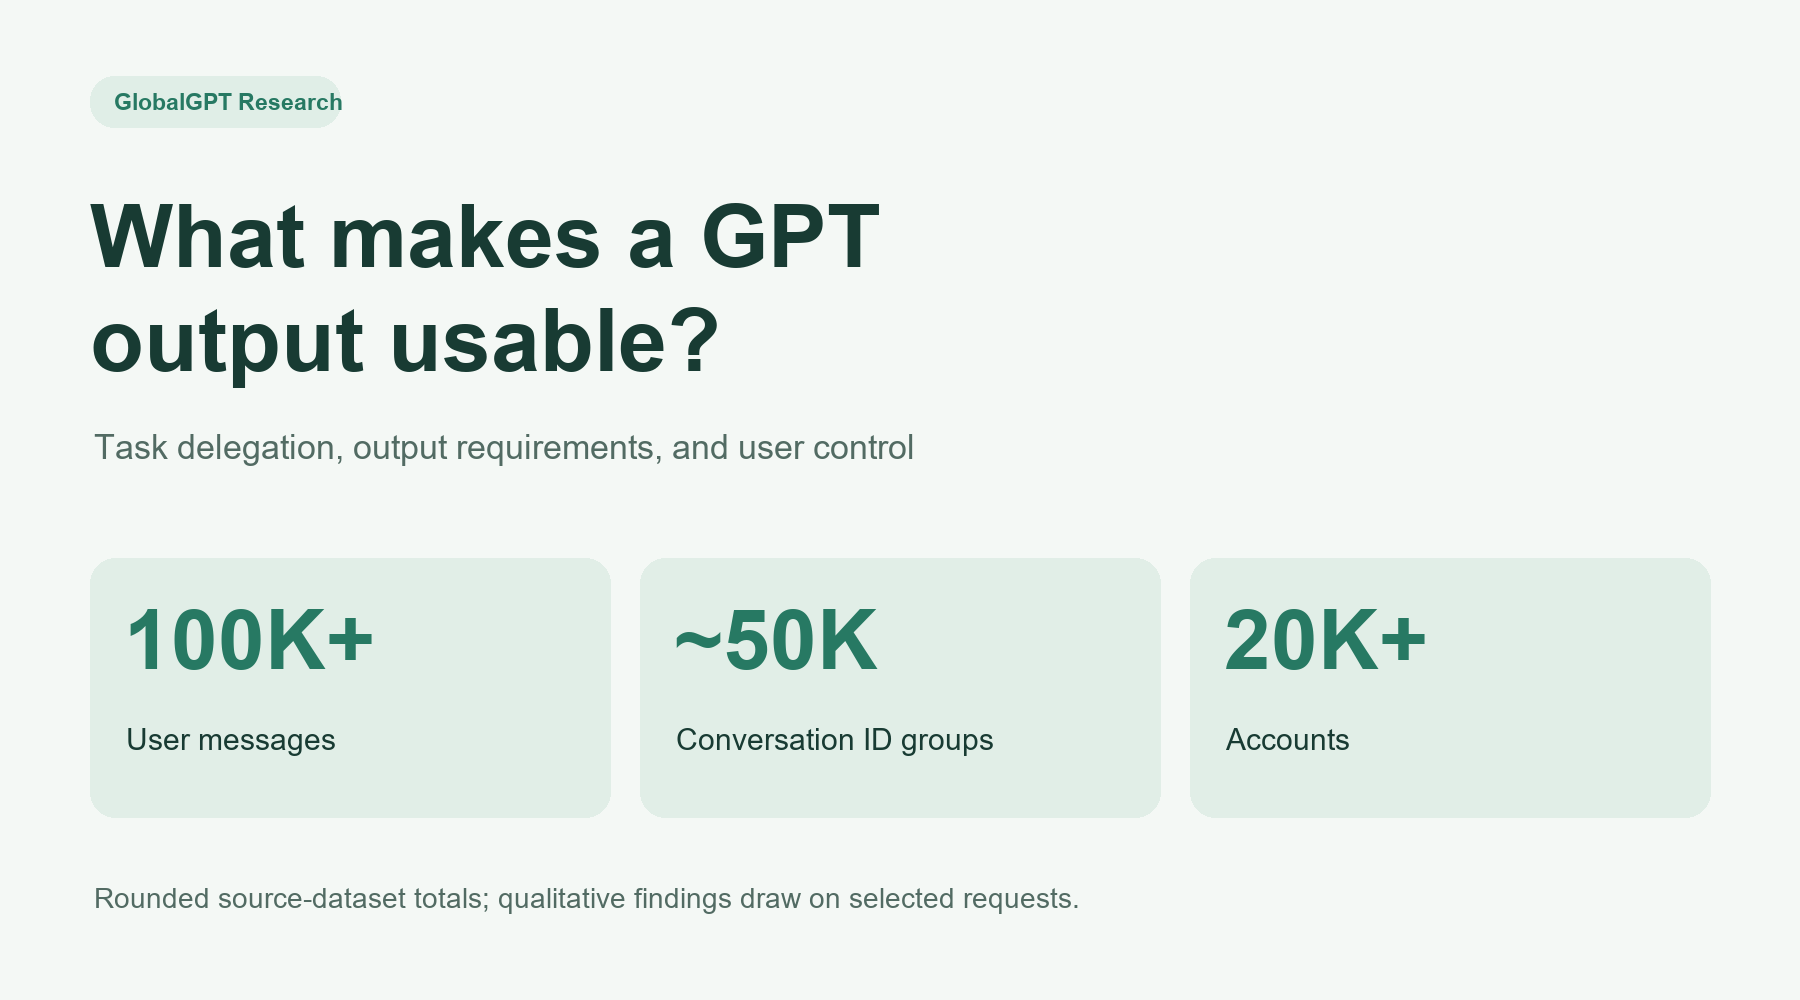
De onderzoeksgegevens in één oogopslag: Meer dan 100.000 gebruikersberichten, ongeveer 50.000 groepen met gespreks-ID’s en meer dan 20.000 accounts. Deze afgeronde totalen hebben betrekking op de brondataset, niet op het aantal verzoeken dat in de kwalitatieve analyse is onderzocht.
Samenvatting
Achtergrond: In onderzoeken naar conversatie-AI wordt een onderscheid gemaakt tussen de onderwerpen waarover mensen praten en hun intentie om informatie te verkrijgen of taken te delegeren. Bij gedelegeerde taken kunnen er echter eisen gelden die verder gaan dan het produceren van relevante inhoud: een bruikbaar formaat, trouw aan het aangeleverde materiaal, onderbouwing of de mogelijkheid om de opdracht voorafgaand aan de uitvoering te controleren.
Onderzoeksvragen: Hoe wordt in aanvraagdocumenten aangegeven onder welke voorwaarden een output bruikbaar zou zijn? Hoe worden in vervolgverzoeken de eisen inzake levering en controle verwoord? Welke verschillen blijven verborgen achter taaklabels die alleen op het onderwerp betrekking hebben?
Methoden: In het onderzoek wordt gebruikgemaakt van een door AI ondersteunde kwalitatieve analyse van geselecteerde fragmenten uit het geautoriseerde materiaal. Tabellen voor primaire taken, diagnostiek en vervolgbeoordeling maakten het mogelijk om vergelijkingen te maken op het gebied van outputvereisten, brongetrouwheid, bewijsmateriaal, behouden controle en platformtoegang. De tabellen werden afzonderlijk geanalyseerd; de thematische bevindingen beschrijven het onderzochte materiaal en niet de prevalentie binnen de populatie.
Bevindingen: In de onderzochte verzoeken wordt een onderscheid gemaakt tussen het produceren van inhoud en het leveren van een bruikbaar eindproduct. Sommige verzoeken specificeren bewerkbare of downloadbare formaten; andere leggen beperkingen op aan wijzigingen in het bronmateriaal, vragen om bewijsstukken of behouden zich het recht voor om de inhoud te beoordelen alvorens deze te implementeren. Vragen over platformnavigatie en aanwijzingen die bedoeld zijn voor andere tools, maken een beschrijving die zich uitsluitend op het onderwerp richt nog ingewikkelder. Tussenliggende gevallen zijn onder meer directe feitelijke vragen, verzoeken om advies zonder uitvoering en input met onvoldoende context.
Vertaling: Het delegeren van taken en gebruikerscontrole kunnen binnen hetzelfde verzoek naast elkaar bestaan. De bevindingen ondersteunen een analytisch onderscheid tussen de aangevraagde bewerking en de voorwaarden die aan het resultaat daarvan zijn verbonden. Ze leveren echter geen bewijs voor de prevalentie van deze patronen, een succesvolle uitvoering, verminderde inspanning of een causaal effect van het gebruik van het model.
1. Inleiding
In dit rapport worden geselecteerde verzoeken uit vrijwillig gedeelde, geautoriseerde GlobalGPT-gegevens onder de loep genomen om een vraag te onderzoeken waarop het gebruiksvolume alleen geen antwoord kan geven: Wat moet een gebruiker doen voordat een door AI gegenereerd resultaat klaar is voor gebruik?
Een verzoek om uitleg over een spreadsheet en een verzoek om een bewerkbare spreadsheet terug te sturen kunnen betrekking hebben op hetzelfde onderwerp, maar toch om verschillende werkzaamheden vragen. Evenzo kan het herzien van een document betekenen dat de formulering ervan wordt gecorrigeerd zonder de feiten te wijzigen, of dat er vrijelijk een nieuwe versie wordt ontwikkeld. Beide kunnen worden aangemerkt als schrijven, maar de toegestane rol van het model en de acceptatiecriteria van de gebruiker verschillen.
In dit onderzoek wordt nagegaan hoe gebruikers het werk dat ze door GPT willen laten uitvoeren, en de voorwaarden die aan het resultaat zijn verbonden, verwoorden. Het onderzoek, dat deel uitmaakt van het onderzoek naar mens-computerinteractie, gaat in op het delegeren van taken aan de hand van geformuleerde eisen op het gebied van oplevering, nauwkeurigheid, bewijsvoering en controle.
Uit grootschalig gebruiksonderzoek is een nuttig onderscheid naar voren gekomen tussen gespreksonderwerpen en de intentie van de gebruiker. Chatterji et al. maken in hun onderzoek naar ChatGPT [1] onderscheid tussen ‘Vragen’, ‘Doen’ en ‘Uitdrukken’. Dit roept een verdere vraag op: wat blijft er, binnen verzoeken om iets te doen, over voor de gebruiker om te specificeren, te controleren of goed te keuren? Een uitvoer kan relevant zijn voor een onderwerp zonder te voldoen aan het gevraagde formaat of zonder het bronmateriaal te behouden zoals aangegeven.
GlobalGPT, een abonnementsplatform voor AI met meerdere modellen, biedt een omgeving waarin verzoeken zowel betrekking kunnen hebben op een externe taak als op de manier waarop deze wordt uitgevoerd. De geselecteerde records bevatten vragen over inhoud, bestanden, modelmogelijkheden en toegang tot eerder werk. Dit zijn met GPT gelabelde records op GlobalGPT, geen steekproef van de gebruikers van de officiële ChatGPT-applicatie.
We stellen drie vragen:
- RQ1 — Gebruiksvoorwaarden: Welke specifieke eisen stellen de onderzochte verzoeken aan de gewenste resultaten?
- RQ2 — Delegeren en controle: Hoe worden in het eerste verzoek en in de vervolgverzoeken de levering, herziening, bewijsvoering en de grens tussen advies en uitvoering vastgelegd?
- RQ3 — Meting: Welke van deze onderscheiden gaan verloren wanneer verzoeken uitsluitend worden beschreven aan de hand van een primair onderwerplabel?
Deze bijdrage biedt een kader om te begrijpen hoe gebruikers bepalen wat een bruikbare AI-uitvoer is. Door de gevraagde handeling te onderscheiden van de leveringsvereisten en de behouden controle, brengt de analyse verschillen aan het licht die van belang zijn voor het ontwerpen en evalueren van AI-ondersteund werk.
2. Gerelateerd onderzoek en analytische benadering
2.1 Onderwerp, doel en economische activiteit
Hoe mensen ChatGPT gebruiken onderzoekt de waargenomen ChatGPT-activiteit van consumenten aan de hand van meerdere classificaties [1]. De primaire classificatiedataset bestaat uit steekproeven van gesprekken en één bericht per geselecteerd gesprek, waarbij de steekproefgewichten zijn aangepast om rekening te houden met variërende percentages in de onderliggende brontabel. Bij de classificatie wordt gebruikgemaakt van de context van het voorafgaande gesprek, in plaats van elk kort bericht als op zichzelf staand te beschouwen.
In dit artikel wordt een onderscheid gemaakt tussen onderwerp en intentie. ‘Vragen’ heeft betrekking op informatie of advies; ‘Doen’ betreft de door het model geproduceerde output; ‘Uiten’ omvat uitspraken die noch een verzoek om informatie, noch een opdracht zijn. Een technische vraag kan om een uitleg of om werkende code vragen, terwijl een schrijfverzoek om een direct bruikbaar concept kan vragen. Het onderscheid is daarom niet te herleiden tot het onderwerp.
In dat onderzoek wordt ook een onderscheid gemaakt tussen grootschalige classificatie en validatie. In bijlage B worden de modelclassificaties vergeleken met menselijke beoordelingen van openbaar WildChat-materiaal, worden overeenstemmingsmaatstaven gerapporteerd en wordt gebruikgemaakt van een afzonderlijke ontwikkelingsset. De regressieanalyse in de demografische analyse richt zich op verschillen die verband houden met gemeten kenmerken. Deze procedures zijn afgestemd op specifieke vraagstellingen en gegevensstructuren; noch de grote steekproef, noch de opzet van de regressieanalyse is toepasbaar op het onderhavige pakket.
Onze vraag betreft de vereisten die aan gedelegeerde output worden gesteld. We gebruiken het onderscheid tussen informatie en actie als interpretatief uitgangspunt, zonder de NBER-classificatie toe te passen of een gelijkwaardige validatie te claimen. Uit de onderzochte verzoeken blijkt dat “Doing” verder kan worden beschreven in termen van wat er bewaard moet blijven, hoe een output moet worden geleverd en wanneer de gebruiker deze wil inzien.
2.2 Van categorisering naar vergelijking
Kwalitatieve analyse kan meer opleveren dan alleen een lijst met categorieën, door te vergelijken wat soortgelijke verzoeken vereisen en door gevallen te onderzoeken die een interpretatie ter discussie stellen. Gale et al. beschrijven de waarde van een vergelijking per categorie, een expliciet analytisch kader en aandacht voor tegenstrijdige gevallen [2]. Zij waarschuwen ook dat een matrix doelbewust geselecteerd materiaal niet statistisch representatief maakt.
De onderhavige analyse maakt gebruik van die vergelijkende logica. Er wordt niet beweerd dat de Framework-methode volledig is toegepast: er was geen multidisciplinair coderingsteam, geen uitputtende codering regel voor regel van de volledige brontekst, noch een onafhankelijke beoordeling door kwalitatieve onderzoekers. Het materiaal is heterogeen en de vergelijking beperkt zich tot één gemeenschappelijk kenmerk: expliciete vereisten die aan een AI-systeem worden gesteld. We noemen deze procedure ‘verkennende kwalitatieve inhoudsanalyse’, ondersteund door een thematische bewijsmatrix.
2.3 Werkbegrippen
Delegeren van taken betekent een expliciet verzoek aan het systeem om een bewerking uit te voeren of een resultaat te genereren. Gebruiksvoorwaarden worden de vereisten voor dat resultaat genoemd, zoals bewerkbaarheid, brongetrouwheid, onderbouwing, geschiktheid voor de doelgroep of presentatie. Behoud van zeggenschap verwijst naar expliciete beperkingen op wat het systeem op dit moment mag doen, waaronder het verzoek om een plan of ontwerp voor te leggen alvorens verder te gaan.
Deze begrippen hebben betrekking op de tekst van vragen. Een gedetailleerde instructie is niet automatisch een teken van wantrouwen, deskundigheid, frustratie of een grotere werkdruk. Een verzoek om een bron is geen bewijs dat het voorgaande antwoord onjuist was. Bij de analyse worden deze mogelijke verklaringen losgehouden van wat er daadwerkelijk wordt gezegd.
3. Methoden
3.1 Opzet en gegevensbron
Dit is een retrospectieve, verkennende analyse van bestaande gegevens van gebruikers die in augustus vrijwillig hun gegevens met GlobalGPT hebben gedeeld en toestemming hebben gegeven voor het gebruik ervan in dit onderzoek. Augustus geeft aan wanneer de gebruikers de gegevens hebben gedeeld; deze maand wordt niet gepresenteerd als de volledige observatieperiode. Voor dit onderzoek zijn geen nieuwe deelnemers geworven, is er geen interventie toegewezen en is er geen aanvullende gegevensverzameling uit de database uitgevoerd.
De geleverde extractie bevatte niet-lege, niet-verwijderde rijen met gebruikersberichten, met niet-lege conversatie-ID’s en model labels die overeenkomen met het opgegeven GPT-filter. De routering, geschiktheid en grenzen van volledige conversaties zijn niet onafhankelijk geverifieerd. Exacte extractiedata, activiteitstotalen en het aantal accounts worden achtergehouden om commercieel gevoelige informatie te beschermen.
De kwalitatieve bevindingen zijn gebaseerd op geselecteerd materiaal uit het onderzoek. Het onderzoek is geen analyse waarbij elk afzonderlijk dossier van de volledige gegevensverzameling is onderzocht, en de bevoegde bijdragers worden niet beschouwd als een representatieve steekproef van alle gebruikers van het platform.
3.2 Beschikbaar studiemateriaal en onderdelen
| Materiaal | Gebruik in deze analyse |
|---|---|
| Overzichtstabel primaire taken | Beoordeling van de intentie en verkennende hercodering van restcategorieën |
| Diagnostische beoordelingstabel | Vergelijking van uitvoervoorwaarden, expliciete regeling en contrasterende gevallen |
| Tabel met vervolgbeoordelingen | Overzicht van fragmenten uit het oorspronkelijke en het daaropvolgende verzoek |
| Tabellen met geaggregeerde resultaten | Interne controles op de winning; exacte cijfers worden niet openbaar gemaakt |
De diagnostische tabel bevat onzekere labels en inhoudelijke taakcategorieën. De samenstelling ervan staat niet in verhouding tot de gegevensuitwinning. Bij de selectie is de nadruk gelegd op onzekere classificaties, en er zijn geen opnamekansen vastgesteld.
Sommige inleidende teksten komen in de verschillende evaluatietabellen terug. Identieke tekst betekent niet dat het om dezelfde gebruikers of gesprekken gaat, maar het maakt het wel onmogelijk om de tabellen te beschouwen als aantoonbaar onafhankelijke, elkaar bevestigende steekproeven. Hun noemers zijn niet samengevoegd en de hercodeerde percentages zijn niet geëxtrapoleerd naar de gegevensverzameling.
De kwalitatieve eenheid is een identificeerbaar verzoek binnen een onderzocht veld of een vervolgfragment. Een opgeslagen rij kan geplakte documenten of ingebedde geschiedenis bevatten; het gaat niet automatisch om een natuurlijke gespreksbeurt. De exacte omvang van de beoordelingstabellen wordt niet openbaar gemaakt, wat een externe beoordeling van de reikwijdte van de analyse bemoeilijkt.
3.3 Procedure voor het aflezen en interpreteren
Bij de eerste beoordeling werden betekenisdragende openingen uit de tabel met primaire taken en geselecteerde eindes van lange of dubbelzinnige velden onderzocht. Aan records die eerder als ‘overig’ waren aangemerkt, werden verkennende categorieën toegewezen. Eerste en daaropvolgende fragmenten uit de vervolgtabel werden onderzocht op uitgedrukte gedragingen, zonder dat de frequentie daarvan werd geschat.
Bij de daaropvolgende controle werden de begin- en, bij langere velden, de eindgedeelten in de diagnostische tabel doorgenomen. Materiaal dat door het afkappen van de uitvoer verborgen was gebleven, werd opnieuw gelezen. Het betrof hier een controle van relevante fragmenten, en geen volledige doorlezing van elk ingesloten contract, elk onderzoeksfragment, elke biografie of elke codegeschiedenis. Bijlagen waarnaar werd verwezen en externe links werden niet geopend.
Het vergelijkingskader maakte onderscheid tussen invoermateriaal, gevraagde bewerking, uitvoervorm, acceptatievoorwaarden, behouden controle en platformtoegang. Het werd ontwikkeld na bestudering van de gegevens en op basis van de literatuur; het was niet vooraf geregistreerd. De oorspronkelijke classificatielabels bleven zichtbaar.
In de analyse werden tegenstrijdige vormen met elkaar vergeleken: directe productie versus uitleg; behoud versus vrije herziening; onmiddellijke uitvoering versus eerst plannen; externe taakvereisten versus navigatie binnen het platform. Dubbelzinnige bronpassages, begroetingen, instructies met vaste antwoorden en ingebed rollenmateriaal werden behouden als beperkingen voor de interpretatie, in plaats van dat ze in inhoudelijke categorieën werden gedwongen.
De beoordeling en interpretatie werden uitgevoerd door één enkele AI-assistent. Er waren geen onafhankelijke menselijke codeurs, geen geblindeerde labels, geen arbitrage en er was geen sprake van aantoonbare thematische verzadiging. De conceptuele dimensies werden niet uitputtend als binaire labels aan elke rij toegewezen. De bevindingenmatrix beschrijft patronen en tegenvoorbeelden, niet de prevalentie of de frequentie van gelijktijdig voorkomen.
3.4 Beschrijvende en statistische analyse
De aggregatieberekeningen en de verkennende categorietellingen zijn intern gecontroleerd. Exacte aantallen, percentages, gemiddelden en de duur van de observatieperiodes worden niet gepubliceerd, omdat deze commercieel gevoelige schaalgegevens zouden kunnen onthullen. Het openbare rapport bevat afgeronde totalen uit de brondataset en kwalitatieve vergelijkingen. Het bevat geen opgeschaalde of afgeronde schattingen van de categoriefrequenties.
Bij de hercodering op basis van primaire taken werd aan elk beoordeeld restrecord een verkennende categorie toegekend. Het betrof boekhouding voor een geselecteerde subgroep, en geen steekproefgewogen schatting van de populatie. De structuur van opgeslagen rijen en de grenzen van de gegevenswinning maken het bovendien onmogelijk om interne groepssamenvattingen te beschouwen als follow-upkansen voor voltooide gesprekken of natuurlijke beurtlengtes.
Er zijn geen hypothesetests, regressies, betrouwbaarheidsintervallen voor populaties of overgangskansen berekend. Onbekende opnamekansen, herhaalde tekst, onvolledige koppeling van gesprekken en niet-gevalideerde labels beperken de statistische conclusies. Het opnieuw bemonsteren van geselecteerde rijen zou het selectieproces niet corrigeren. Er wordt geen statistiek voor interbeoordelaarsovereenstemming gerapporteerd, omdat er geen onafhankelijke beoordelingen waren.
3.5 Privacy en reflexiviteit
In het rapport wordt gebruikgemaakt van algemene beschrijvingen in plaats van persoonlijke citaten, specifieke geschiedenissen, accountgegevens of contactgegevens. Verwijzingen naar persoonlijke omstandigheden worden niet beschouwd als geverifieerde identiteiten of kenmerken. Er worden geen demografische profielen afgeleid uit de taal of de inhoud van berichten.
GlobalGPT beheert het bronplatform en heeft een commercieel belang bij het gebruik ervan. Het rapport is tot stand gekomen in het kader van inhoudelijk onderzoek, waardoor het risico bestaat dat de nadruk komt te liggen op aantrekkelijke verhalen over productiviteit of vraag. Om die interpretatie te beperken, bevat de analyse contrasterende voorbeelden en wordt een verzoek niet gelijkgesteld aan een succesvolle uitvoering. Toestemming van de gebruiker om gegevens te delen houdt geen onafhankelijke ethische toetsing of menselijke validatie van de analyse in; hier wordt ook geen aanspraak op gemaakt.
4. Bevindingen
4.1 RQ1: Voor een bruikbaar resultaat is mogelijk meer nodig dan alleen relevante inhoud
Sommige verzoeken hebben betrekking op een concreet product in plaats van alleen op een antwoord. Er wordt gevraagd om een bewerkbaar werkblad, een presentatie, een afbeelding die kan worden gedownload of een document dat geschikt is voor een volgende productiestap. In deze gevallen zijn de inhoud en het leveringsformaat afzonderlijke vereisten. Een uitleg over hoe een bestand moet worden gemaakt, zou op zichzelf niet voldoen aan het uitdrukkelijke verzoek om dat bestand te ontvangen.
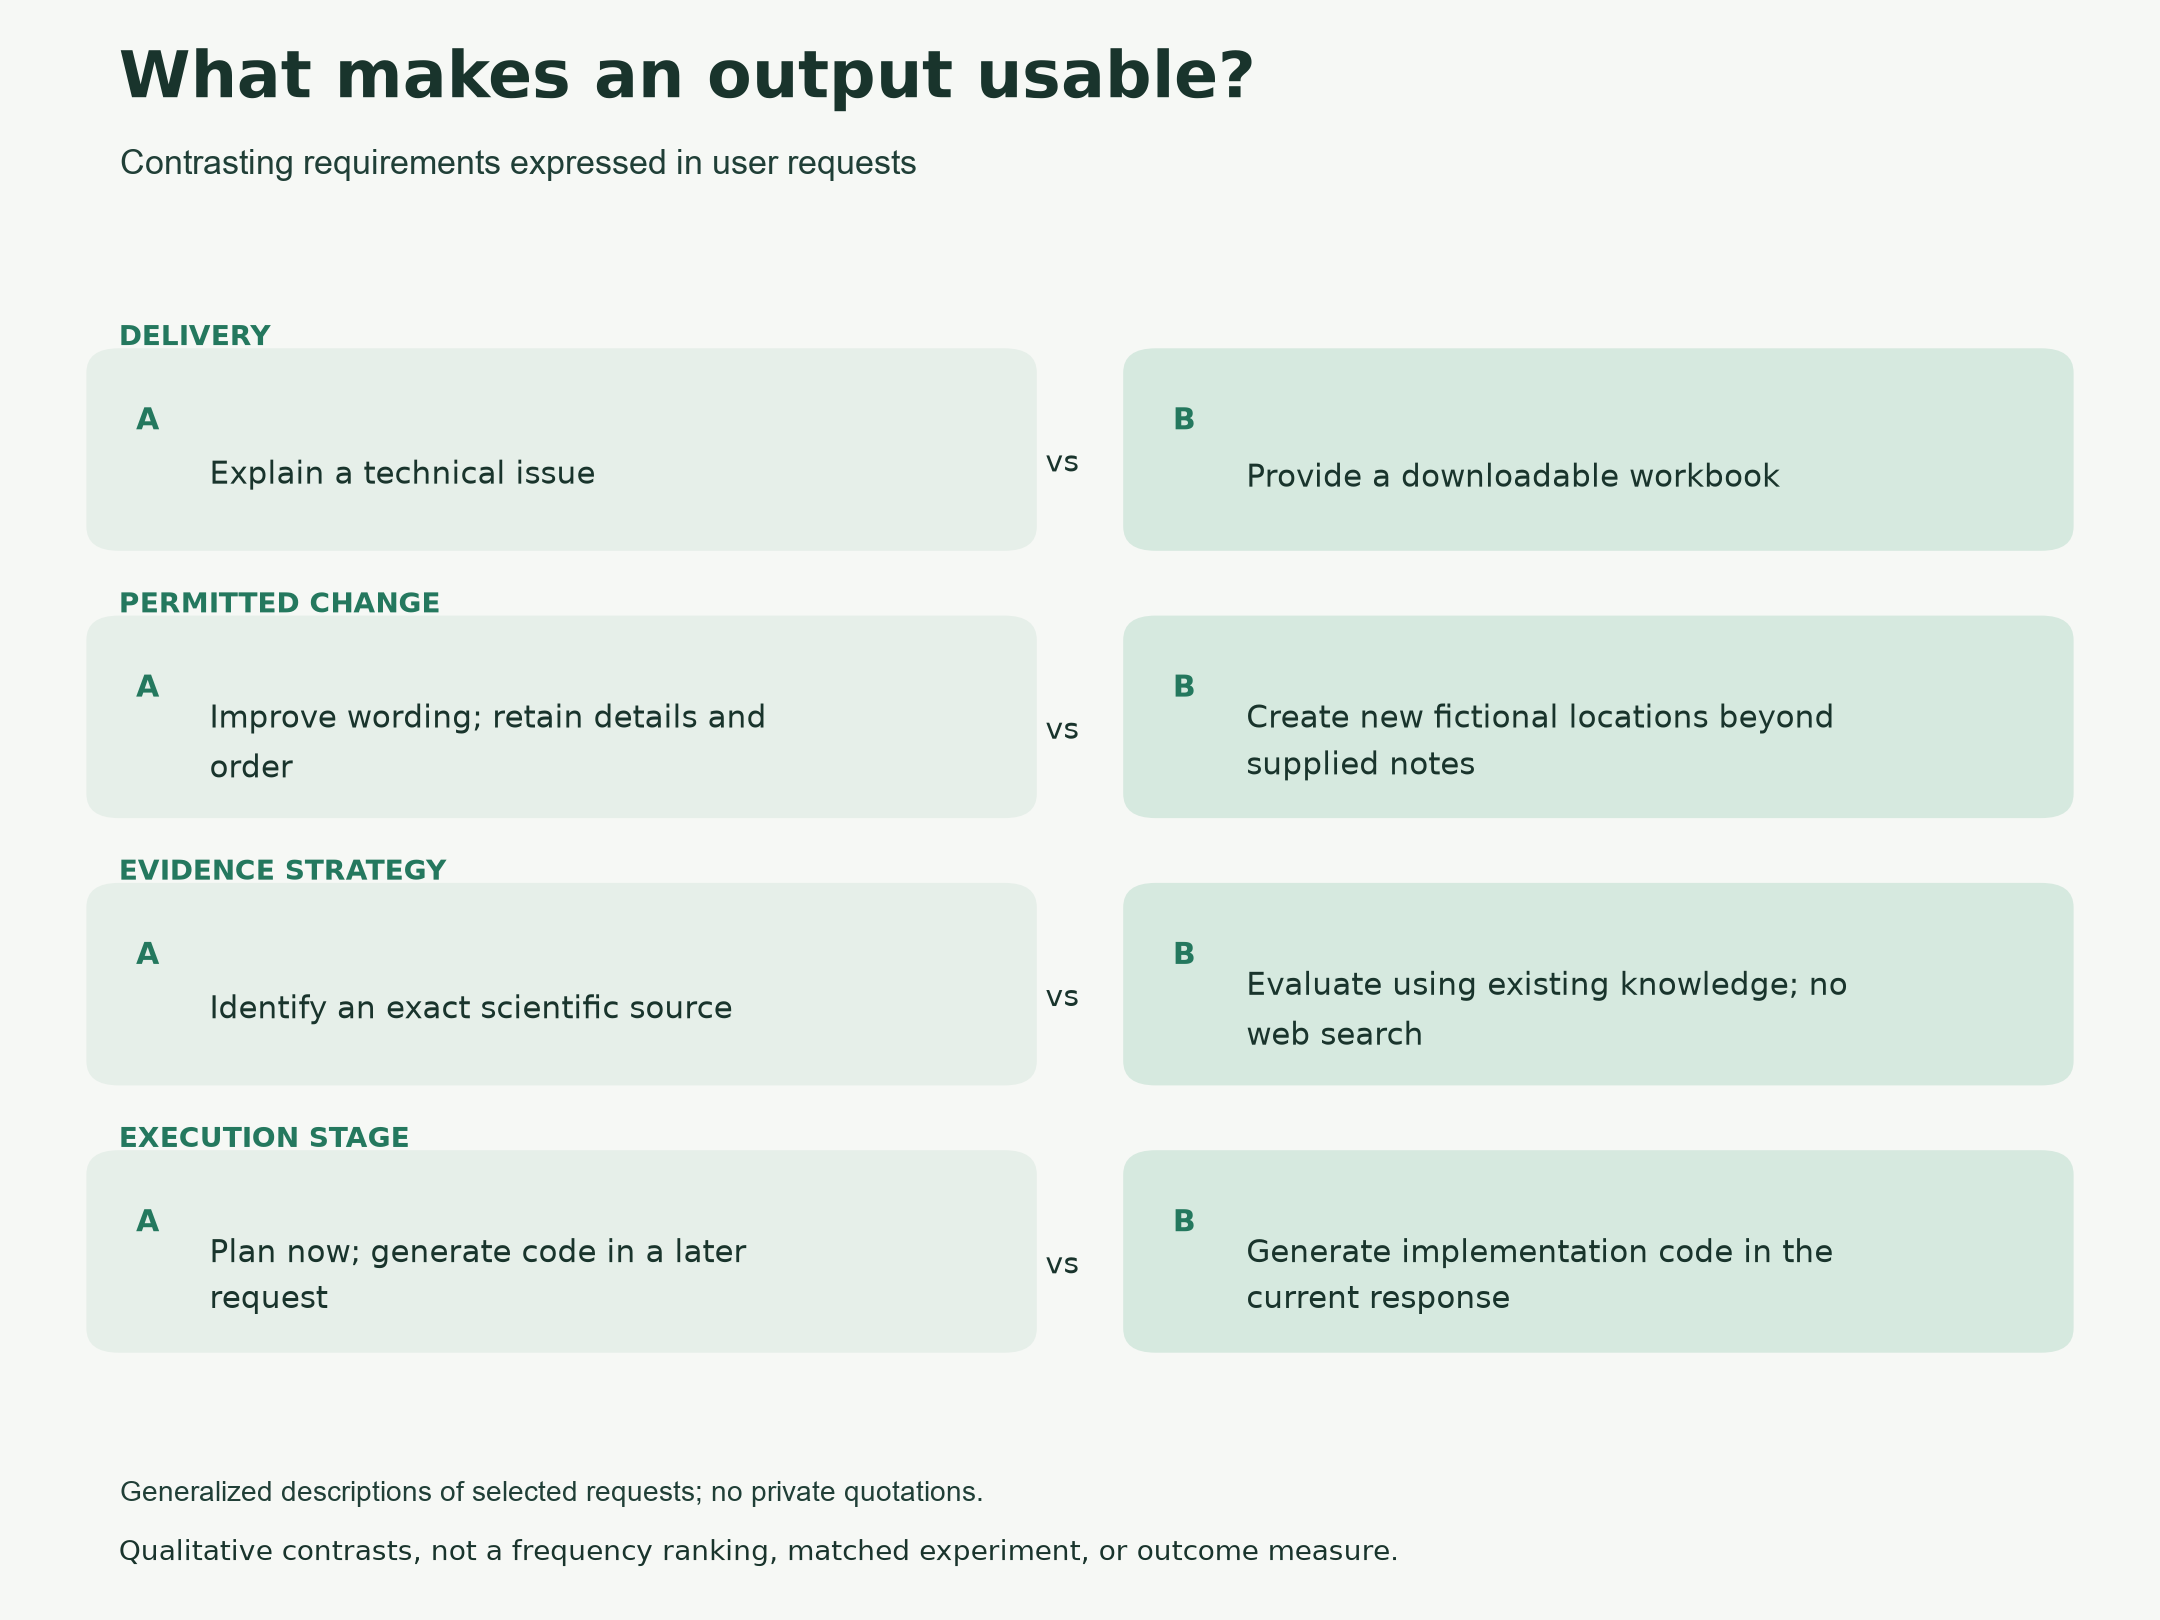
De onderstaande vergelijkingen zijn een parafrase van geselecteerde verzoeken om verschillen in de geformuleerde eisen te illustreren; het zijn geen letterlijke citaten of schattingen van de prevalentie. Elke A en B beschrijft één bronrecord. De vergelijkingen hebben betrekking op taakomstandigheden bij verschillende verzoeken, niet op vergelijkbare experimenten of veranderingen bij dezelfde gebruiker.
Vergelijking 1 — Een technisch probleem uitleggen en een bestand aanleveren.
Verzoek A — algemeen: Een gebruiker vraagt of het omzetten tussen getalformaten tot een underflow kan leiden. Het doel is een technische uitleg; er wordt niet om een bestand gevraagd. Verzoek B — algemeen: Een andere gebruiker levert code aan voor het maken van een werkboek en vraagt om een spreadsheet die daarmee is gemaakt en die kan worden gedownload. Het gevraagde eindpunt is het bestand zelf, niet een uitleg van de aangeleverde code.
Het verschil zit hem in de levering: A kan worden behandeld in een tekstueel antwoord, terwijl B expliciet een artefact vereist dat de gebruiker kan verkrijgen. Ondanks hun verschillende onderwerpen ondersteunt dit paar het onderscheid dat in RQ1 wordt gemaakt tussen het beantwoorden van een inhoudelijke vraag en het voldoen aan een vereiste met betrekking tot het uitvoerformaat. Het bewijst niet dat de spreadsheet is gegenereerd of gedownload, noch dat een van beide reacties aan de behoeften van de gebruiker voldeed.
Andere verzoeken stellen voorwaarden aan de bewerking. Ze vragen om een verbetering van de taal, terwijl feiten, details of de volgorde van de uitleg ongewijzigd blijven. Het bronmateriaal is daarom niet louter achtergrondinformatie: het kan een grens aangeven voor wat er mag worden gewijzigd. Een onderwerplabel zoals ‘schrijven’ maakt die grens niet duidelijk.
Vergelijking 2 — Een document bewaren en een fictieve setting uitbreiden.
Verzoek A — algemeen: Een gebruiker vraagt om grammaticale en stilistische verbeteringen aan een aangeleverd rapport, waarbij de details en de volgorde van de uitleg behouden moeten blijven. Verzoek B — algemeen: Een gebruiker levert aantekeningen aan voor het opbouwen van een fictieve wereld en vraagt om aanvullende locaties met korte beschrijvingen, waarbij hij expliciet uitnodigt tot ideeën die verder gaan dan de aangeleverde achtergrondinformatie, maar die wel relevant blijven voor de setting.
Bij beide verzoeken gaat het om het produceren van tekst op basis van bestaand materiaal, maar de bron dient verschillende doelen. Bij A vormt de behouden inhoud een beperking voor de herziening; bij B wordt de aangereikte context beschouwd als uitgangspunt voor nieuwe creativiteit. Dit ondersteunt RQ1 en RQ3: een schrijflabel alleen geeft geen uitsluitsel over de toegestane mate van wijziging. De vergelijking bevestigt de feitelijke beweringen van het rapport niet en toont evenmin aan dat een van beide uitkomsten de instructies naleefde; de creatieve vrijheid van B blijft beperkt tot fictieve toevoegingen.
Bewijs is een andere gevraagde eigenschap. Sommige documenten vragen om een precieze bronvermelding, om controle van feitelijke beweringen of om een onderscheid tussen onzekerheden en vaststaande informatie. Dit geeft niet aan of het uiteindelijke antwoord betrouwbaar was. Het geeft wel aan dat de gebruiker bewijs expliciet als onderdeel van het gevraagde resultaat heeft opgenomen.
Vergelijking 3 — Een bron identificeren en het zoeken buiten de database beperken.
Verzoek A — algemeen: Een gebruiker vraagt om de exacte wetenschappelijke bronvermelding die bij een bijgevoegde afbeelding hoort, opgemaakt als een academische bronvermelding. Verzoek B — algemeen: Een andere gebruiker vraagt om een beknopte technische vergelijking van materialen op basis van de bestaande kennis van het model en sluit het zoeken op internet uitdrukkelijk uit om credits te besparen.
Het verschil zit hem in de bewijsvereiste en de toegestane manieren om de vraag te beantwoorden. A vereist een identificeerbare bron; B stelt een expliciete beperking aan het opzoeken van informatie uit externe bronnen. A schrijft geen verplichte zoekprocedure voor, en de beperking van B doet niets af aan de noodzaak van nauwkeurigheid. Samen ondersteunen ze de benadering van RQ1, waarin de bewijsstrategie als taakspecifiek wordt beschouwd. De afbeelding en de ingevulde antwoorden zijn hier niet beoordeeld, dus er is geen sprake van succesvolle bronidentificatie noch van betrouwbaar technisch advies.
Het verschil tussen deze gevallen is van belang. Bij een directe feitelijke vraag hoeft geen specifiek dossier te worden genoemd. Sommige verzoeken zijn gericht op een oordeel of een toelichting, en bij één van de onderzochte soorten wordt extern onderzoek expliciet beperkt. De bevindingen wijzen dan ook op meerdere vormen van bruikbaarheid, en niet op een algemene voorkeur voor het produceren van artefacten of maximaal onderzoek.
4.2 RQ2: Door delegatie kan een expliciete grens bij de uitvoering behouden blijven
Het materiaal bevat verzoeken om een conceptplan, om een eerste versie nog voordat er een presentatieklare samenvatting is, en om advies over in hoeverre een proces geautomatiseerd moet worden. Met deze verzoeken wordt een deel van het werk gedelegeerd, terwijl een definitieve beslissing voor later wordt uitgesteld. In andere documenten wordt gevraagd om directe uitvoering of om onmiddellijk een volledig eindproduct.
Vergelijking 4 — Nu plannen en nu code schrijven.
Verzoek A — algemeen: Een gebruiker beschrijft een softwareproject, maar vraagt het systeem uitdrukkelijk om zich bij het huidige antwoord te concentreren op onderzoek en implementatieplanning, en het genereren van code uit te stellen tot een latere prompt. Verzoek B — algemeen: Een andere gebruiker vraagt om de broncode voor de implementatie van een bepaalde geautomatiseerde routine, met configureerbare instellingen en werkingsregels.
Beide hebben betrekking op softwareontwikkeling, maar hun huidige uitvoeringsgrenzen verschillen. A definieert een toekomstig implementatiedoel, terwijl de huidige taak beperkt blijft tot planning; B vraagt om implementatie in het huidige antwoord. Dit ondersteunt RQ2: het delegeren van een project geeft niet automatisch toestemming voor elke volgende stap in één keer. Het paar bewijst niet dat de latere codeerfase van A heeft plaatsgevonden, dat het programma van B werkte, of dat planning de resultaten in eerste instantie verbeterde. Dit zijn afzonderlijke verzoeken, geen waargenomen voor-en-na-reeks.
Dit contrast nuanceert een eenvoudig onderscheid tussen vragen en doen. Een verzoek kan betrekking hebben op de uiteindelijke productie, terwijl het systeem wordt gevraagd om nu in een tussenstadium te stoppen. Als dit zou worden behandeld als een onbeperkte uitvoering, zou een expliciet aangegeven controlegrens over het hoofd worden gezien.
Vervolgfragmenten bieden een ander perspectief. Gebruikers vragen om een andere formulering, vullen ontbrekende context aan, vragen om een andere indeling, zoeken naar bronlinks of vragen hoe ze toegang kunnen krijgen tot een resultaat. Dit zijn verschillende interactie-eisen. Ze kunnen niet allemaal worden gecodeerd als foutherstel: een nieuwe eis kan een uitbreiding van de taak zijn in plaats van een reactie op een fout.
Ook kunnen deze fragmenten geen algemeen vaststaand verloop aantonen van vraag naar concept naar definitief dossier. Het dossier biedt geen volledig, onafhankelijk geverifieerd overzicht van de reacties. We zien aanvraagformulieren en enkele lokale vervolgstappen, maar geen algemeen procesmodel of overgangskansen.
4.3 Onderzoeksvraag 2: Een deel van het onderzoek richt zich op de toegang tot en de overdracht tussen tools
In sommige berichten wordt gevraagd waar eerder werk te vinden is, hoe materiaal kan worden geüpload, welk model geschikt is voor een voorgestelde taak, of hoe een integratie moet worden gebruikt. Deze verzoeken hebben betrekking op de omgeving waarin het werk wordt uitgevoerd. Ze verschillen van de externe inhoudstaak, ook al zijn ze noodzakelijk om die taak uit te voeren.
Bij andere records wordt gevraagd om een prompt voor een afzonderlijke afbeelding, presentatie of onderzoekstool. Hier is de prompt zelf bedoeld als tussentijds resultaat. Het kan deel uitmaken van een bredere workflow, maar uit het record blijkt niet dat de daaropvolgende tool daadwerkelijk is gebruikt of dat er daadwerkelijk een modelwisseling heeft plaatsgevonden.
De analytische conclusie is dat een AI-verzoek van een gebruiker betrekking kan hebben op ten minste drie verschillende aspecten: de taak, het resultaat ervan en de toegang tot de middelen om dat resultaat te genereren of op te halen. Vragen over het platform wijzen op uitgesproken navigatiebehoeften; ze tonen op zichzelf echter geen interfacefouten of ontbrekende functionaliteiten aan.
4.4 RQ3: Onderwerplabels vatten verschillen samen die bij verschillende taken voorkomen
Bij de eerdere hercodering van de categorie ‘overige’ werden onder de records die oorspronkelijk als ‘overige’ waren aangemerkt, de volgende activiteiten geïdentificeerd: visuele productie, het opzoeken van informatie, schrijven, praktisch advies, softwarehulp, gestructureerde documenten, codering, leren en navigatie op het platform. De aanvullende tabel bevat ook expliciete verzoeken waarvan de strekking niet goed wordt beschreven door het bestaande onderwerplabel. Sommige lange bronvelden eindigen met de concrete instructie om te vertalen, samen te vatten of een document op te stellen.
Hieruit vloeien twee meetproblemen voort. Ten eerste kan een classificatiesysteem reageren op het onderwerp van het geplakte materiaal in plaats van op de handeling die van het model wordt gevraagd. Ten tweede kan zelfs bij een juiste toewijzing van het onderwerp de indeling, de nauwkeurigheid, het bewijs of de goedkeuringsvoorwaarden worden weggelaten die het ene verzoek van het andere onderscheiden.
| Afmeting | Bewijsmateriaal in het onderzochte materiaal | Wat een label dat alleen op het onderwerp is gebaseerd, over het hoofd ziet | Grensgeval |
|---|---|---|---|
| Levering | Verzoeken om bewerkbare of downloadbare resultaten | Of tekst alleen al voldoende zou zijn om aan het verzoek te voldoen | Directe uitleg zonder dat er een bestand nodig is |
| Trouw | Aanwijzingen voor het vastleggen van feiten, volgorde of bronvermeldingen | In hoeverre zijn aanpassingen toegestaan? | Generatie zonder beperkingen |
| Bewijs | Verzoeken om referenties of feitelijke verificatie | De aangegeven grond voor het toewijzen van een vordering | Expliciete beperkingen op extern onderzoek |
| Besturing | Planning of evaluatie voorafgaand aan de implementatie | Wat het systeem in die fase mag doen | Verzoeken om onmiddellijke levering |
| Overdracht | Opdrachten die bedoeld zijn voor een andere tool | De tussenschakelrol van de gevraagde output | Uitvoer die bedoeld is voor gebruik binnen het gesprek |
| Toegang | Vragen over modellen, uploaden, geschiedenis en integratie | Werk gericht op de dienstverleningsomgeving | Externe taken waarin geen melding wordt gemaakt van platformbeheer |
Deze dimensies kunnen elkaar overlappen. Ze vormen een interpretatief kader, geen nieuw gevalideerde, uitputtende classificatie. De tabel geeft een overzicht van de verschillen in het onderzochte materiaal en bevat geen rangschikking op basis van frequentie.
4.5 Documenten die zich niet laten interpreteren in inhoudelijke zin
De primaire beoordelingstabel bevat herhaalde of vaste patronen van korte antwoorden. De herkomst hiervan is onbekend; ze kunnen het gevolg zijn van normaal gebruik, evaluaties, connectiviteitscontroles, overgenomen voorbeelden of een ander proces. Ze zijn niet stilzwijgend verwijderd en zijn evenmin aangemerkt als bevestigd testverkeer.
Andere velden bevatten ingebedde rolverklaringen, toolmarkeringen of geplakte gespreksgeschiedenis. Een dergelijke opbouw bemoeilijkt het toewijzen van een zin aan het huidige verzoek van de gebruiker. Sommige records bevatten alleen bronmateriaal of een fragment waarvan het doel niet kan worden vastgesteld zonder de ontbrekende context.
Deze gevallen zijn analytisch gezien nuttig omdat ze de bewering relativeren. De dataset is geen transparante weergave van onafhankelijke, volledig geobserveerde delegatiegevallen. Betere taakcategorieën alleen kunnen de onzekerheid over wat een opgeslagen gegevensrecord precies weergeeft, niet wegnemen.
5. Bespreking
5.1 Het uitbesteden van de productie is niet hetzelfde als het afstaan van de zeggenschap
De belangrijkste interpretatie is dat verzoeken een bewerking kunnen delegeren met behoud van voorwaarden ten aanzien van het resultaat en het proces. Een gebruiker kan het systeem vragen om een concept op te stellen met behoud van feiten, om de implementatie te plannen alvorens code te genereren, of om bewijsmateriaal te verstrekken voordat een beslissing wordt genomen. Dit is in overeenstemming met het delegeren van taken en vormt geen uitzondering daarop.
Hiermee wordt het onderscheid tussen het zoeken naar informatie en het produceren ervan uitgebreid tot het niveau van de geformuleerde eisen. Het leidt niet tot een nieuwe universele theorie over de samenwerking tussen mens en AI. Het materiaal is voldoende om aan te tonen waarom een enkel intentielabel mogelijk aanvullende dimensies nodig heeft, maar niet om in te schatten hoe vaak elke combinatie voorkomt.
5.2 Het genereren van output en de levering van bruikbare output zijn afzonderlijke beoordelingsdoelstellingen
Een evaluatie die alleen nagaat of een reactie betrekking heeft op een bepaald onderwerp, kan expliciete leveringsvoorwaarden over het hoofd zien. Voor de onderzochte artefactverzoeken zou een zinvolle beoordeling ook moeten nagaan of het gevraagde formulier is geleverd, waar nodig bewerkbaar is gebleven, de opgegeven broninhoud heeft behouden en de fasering van de goedkeuringsprocedure in acht heeft genomen.
Dit zijn voorgestelde evaluatiecriteria die zijn afgeleid uit verzoeken, en geen gemeten prestatieresultaten. Op basis van de huidige gegevens kunnen we de daadwerkelijke naleving niet beoordelen. Niettemin helpt dit onderscheid om een nauwkeurigere maatstaf voor toekomstige resultaten te formuleren dan het aantal berichten of het loutere feit dat er een vervolgactie heeft plaatsgevonden.
5.3 Wat uit de bevindingen niet blijkt met betrekking tot de coördinatie
Het vaststellen van eisen, het controleren van bewijsmateriaal en het opzoeken van een dossier kunnen worden gezien als coördinerende activiteiten rondom gedelegeerd werk. Dit roept een diepere vraag op: zorgt AI ervoor dat de totale inspanning afneemt, of wordt deze juist verlegd naar het vaststellen van eisen en het controleren?
Dit onderzoek geeft geen antwoord op die vraag. Er ontbreken een vergelijkingsgroep, tijdmetingen, volledige resultaten en onafhankelijke beoordelingen van het succes van de taak. Een vervolgonderzoek zou kunnen duiden op nuttige samenwerking, vermijdbare wrijving, een gewijzigd doel of een gebruikelijke volgende stap. Door het aantal te tellen, kan geen onderscheid worden gemaakt tussen deze verklaringen.
Toekomstige hypothesen zouden kunnen onderzoeken of expliciete leveringsvoorwaarden latere formaatwijzigingen voorspellen, of dat gefaseerde goedkeuringsverzoeken gepaard gaan met minder ongewenste acties. Om deze hypothesen te toetsen, zijn gekoppelde episodes, gevalideerde labels en een passende verwerking van herhaalde waarnemingen bij gebruikers nodig. Het blijft bij onderzoeksvragen; het zijn geen bevindingen uit dit rapport.
6. Beperkingen
Selectie en afhankelijkheid. De overzichtstabellen zijn verstrekt voor diagnostische doeleinden, zonder dat de waarschijnlijkheid van opname bekend is. Sommige oorspronkelijke teksten komen zowel binnen als tussen de tabellen voor. De gegevens bieden geen onderbouwing voor beweringen over prevalentie in de populatie of onafhankelijke replicatie.
Vertaling. Eén AI-assistent heeft de analyse uitgevoerd terwijl de oorspronkelijke labels zichtbaar waren. Er is geen sprake van onafhankelijke menselijke validatie of een schatting van de interbeoordelaarsbetrouwbaarheid. Het analytisch kader is ontwikkeld na bestudering van de gegevens en kan de verwachtingen van de analist weerspiegelen.
Onvolledige tekst en context. De controle was gericht op de beginzinnen, geselecteerde eindzinnen en de daaropvolgende fragmenten. Lange passages uit de bron, bijlagen waarnaar werd verwezen en de volledige antwoorden van de assistenten zijn niet grondig onderzocht. Mogelijk zijn sommige instructies of tegenvoorbeelden over het hoofd gezien.
Extractiegrenzen. In rijen met GPT-labels kunnen eerdere, latere of tussentijdse activiteiten ontbreken. De modelrouting is niet onafhankelijk geverifieerd. Opgeslagen rijen kunnen ingebedde geschiedenisgegevens bevatten; het aantal rijen komt niet noodzakelijkerwijs overeen met natuurlijke bewerkingen.
Resultaten. Verzoeken vormen geen bewijs van levering, juistheid, tevredenheid, productiviteit, conversie of de superioriteit van een model. Uit de inhoud van de verzoeken worden in dit onderzoek geen gevoelige persoonlijke kenmerken afgeleid.
Overdraagbaarheid en commerciële context. De bevindingen hebben betrekking op geselecteerde gegevens van één platform dat meerdere modellen ondersteunt. Ze zijn niet representatief voor het officiële gebruik van ChatGPT of voor het bredere publiek. Bij de interpretatie van deze bijdrage dient rekening te worden gehouden met de commerciële belangen van het platform en het ontbreken van een onafhankelijke wetenschappelijke toetsing.
7. Conclusie
In de onderzochte verzoeken wordt een onderscheid gemaakt tussen de aan GPT gedelegeerde taak en de voorwaarden die aan een bruikbaar resultaat zijn verbonden. Deze voorwaarden hebben onder meer betrekking op het leveringsformaat, de getrouwheid ten opzichte van het bronmateriaal, bewijsmateriaal en de mogelijkheid tot controle voordat verdere stappen worden ondernomen. Toegang tot het platform en aanwijzingen voor andere hulpmiddelen voegen vereisten toe die niet louter uit de onderwerplabels blijken.
Het bewijsmateriaal ondersteunt een gerichte stelling: delegatie en behoud van controle kunnen binnen één verzoek naast elkaar bestaan. Om die relatie te beschrijven, moet aandacht worden besteed aan wat de gebruiker wil dat er wordt geproduceerd, wat ongewijzigd moet blijven en wat er vervolgens van het systeem wordt gevraagd. De onderhavige analyse brengt deze verschillen in kaart; zij geeft geen schatting van de frequentie ervan in de populatie en toont evenmin aan dat zij de resultaten verbeteren.
Bronvermeldingen
- Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). Hoe mensen ChatGPT gebruiken. NBER-werkdocument nr. 34255. https://doi.org/10.3386/w34255. Officieel document: https://www.nber.org/papers/w34255. Een werkdocument wordt hier niet weergegeven als een door vakgenoten beoordeeld tijdschriftartikel.
- Gale, N. K., Heath, G., Cameron, E., Rashid, S., & Redwood, S. (2013). Toepassing van de frameworkmethode voor de analyse van kwalitatieve gegevens in multidisciplinair gezondheidsonderzoek. BMC Medical Research Methodology, 13, 117. https://doi.org/10.1186/1471-2288-13-117. Volledige tekst: https://pmc.ncbi.nlm.nih.gov/articles/PMC3848812/.
Bijlage A. Overzicht van kwalitatieve categorieën
Uit de verkennende hercodering kwamen de volgende onderwerpen naar voren: visuele productie, instructies met vaste reacties, het opzoeken van informatie, schrijven, praktisch advies, navigatie op het platform, dubbelzinnige invoer, het oplossen van softwareproblemen, gestructureerde deliverables, coderen, leren, muziek, het bedenken van ideeën, het herstructureren van lange bronnen en het verpakken van rollen en geschiedenis.
Deze inventarisatie beschrijft de categorieën die in het geselecteerde materiaal voorkomen. Het aantal categorieën en de totalen worden niet vermeld; de lijst is noch een rangschikking op basis van frequentie, noch een schatting van de vraag op het platform.
Informatie over onderzoek
AI-ondersteuning: Een AI-assistent heeft de vermelde fragmenten onderzocht, de verkennende interpretatie opgesteld, de beschrijvende controles berekend en het manuscript opgesteld. Er wordt geen aanspraak gemaakt op overeenstemming met onafhankelijke menselijke labels.
Beschikbaarheid van gegevens: Het onderliggende pakket bevat vertrouwelijke gegevens die vrijwillig zijn gedeeld door bevoegde bijdragers en wordt niet weergegeven. Exacte cijfermatige overzichten en waarnemingsdata worden eveneens achtergehouden. Dit rapport geeft geen toestemming voor het verder verspreiden van afzonderlijke berichten of sjablonen. Alle voorbeelden in de bevindingen zijn algemene beschrijvingen, geen vertrouwelijke citaten.