Met één model kan het hele geluidsbeeld worden gecreëerd.
Seed Audio 1.0 kan stemmen, foley-geluiden, omgevingsgeluiden, timing en instrumentale muziek combineren. Uit onze tests bleek dat het programma een ongewoon hoog creatief potentieel heeft — maar ook een probleem met de herhaalbaarheid dat je niet mag negeren.
Seed Audio 1.0 is een van de eerste audiomodellen die ik heb getest en die de indruk wekt te zijn ontworpen rond een complete scène in plaats van rond één specifiek uitvoertype. Het kan spreken, acteren, sfeergeluiden toevoegen, foley-geluiden creëren, dialogen op een tijdlijn plaatsen en instrumentale muziek produceren op basis van één enkele opdracht.
Het korte oordeel: Seed Audio 1.0 biedt ongewoon veel mogelijkheden voor geïntegreerde audioproductie, met name voor gesynchroniseerde dialogen en filmische geluidsscènes. Het zwakke punt is de herhaalbaarheid. Een goede uitvoering kan opvallend compleet klinken, terwijl een andere uitvoering op basis van dezelfde opdracht vervormde spraak kan bevatten, een gebeurtenis kan overslaan of de gevraagde stem kan wijzigen.
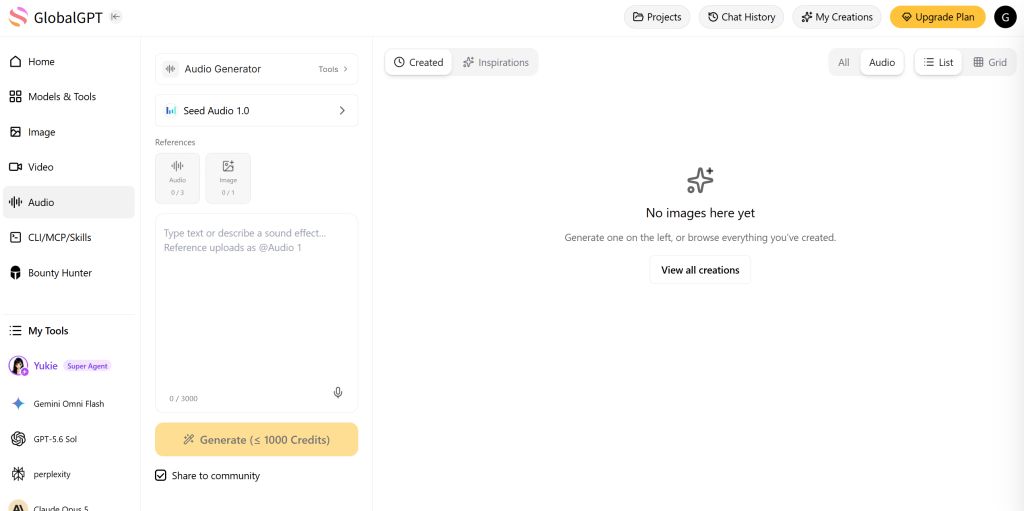
Ik heb 23 beoordeelde voorbeelden gegenereerd via de Anywhere/BrolyAI-testomgeving. Deze omvatten samen: vertelstem, dialogen tussen twee personages, spraak met tijdsaanduiding, sequenties met uitsluitend geluidseffecten, scènes met stem en muziek, op zichzelf staande muziek, meertalige uitvoeringen, monologen van twee minuten en het voortzetten van referentie-audio.
Recensie Seed Audio 1.0: het korte oordeel
| Categorie | Resultaten van onze tests |
|---|---|
| Expressieve stem | Hoogwaardige kwaliteit bij de beste run, maar wisselend bij herhalingen |
| Dialoog tussen meerdere sprekers | Nauwkeurige scripts en een duidelijke scheiding tussen de sprekers |
| Timing van de dialogen | Het meest betrouwbare onderdeel in onze testreeks |
| Geluidseffecten | Realistische weergave van ruimte en volgorde van gebeurtenissen; minder nauwkeurig bij het tellen van het exacte aantal gebeurtenissen |
| Stem + geluidseffecten + muziek | Overtuigende, complete scènes waarin elke verwachte gebeurtenis precies klopt |
| Op zichzelf staande muziek | Presteerde beter dan verwacht; leverde gestructureerde signalen van 30 seconden op |
| Meertalige spraak | Een uitstekend scenario, maar in één van de twee runs werd er onterecht extra tekst toegevoegd |
| Geluidsfragment van twee minuten | Een sterke stemidentiteit en samenhang in het verhaal in beide reeksen |
| Referentie-audio | Op onze testlocatie bleek het apparaat onbetrouwbaar; de stemgelijkenis was slecht |
Geschikt voor: makers die hoorspelen, gamescènes, podcastconcepten, filmische prototypes en storyboards met de nadruk op audio maken.
Minder geschikt voor: taken waarbij een deterministische formulering, exacte tellingen van herhaalde gebeurtenissen of betrouwbare stemklonen uit één onbemande generatie vereist zijn.
Wat is Seed Audio 1.0?
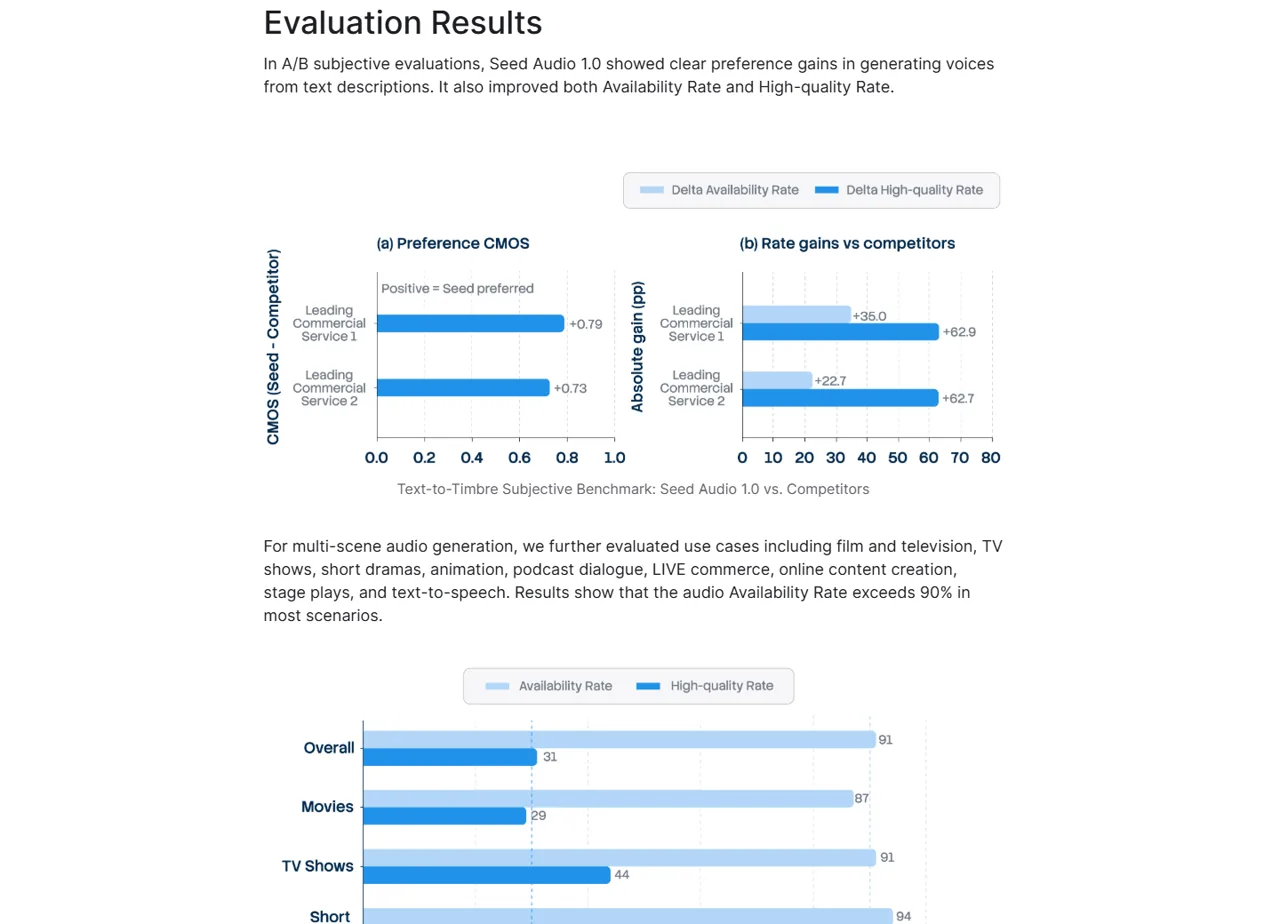
Seed Audio 1.0 is het geïntegreerde model voor het genereren van tekst-naar-audio van ByteDance Seed. In plaats van spraak, omgevingsgeluiden, effecten en muziek als afzonderlijke taken te behandelen, kan het deze samen genereren als één geluidsscène. Volgens de officiële productpagina ondersteunt het de timing van dialogen met intervallen van 100 milliseconden en kan het in één keer tot twee minuten genereren.
Dat samenhangende ontwerp is de echte aantrekkingskracht. Een prompt kan beschrijven wie er spreekt, hoe die persoon klinkt, wat er in de kamer gebeurt, welke geluidseffecten er later bijkomen en wat voor soort muziek de scène begeleidt. Als het goed gaat, klinkt het resultaat als een samenhangend geheel in plaats van als een aaneenreeks van losse stukjes.
Er is echter een belangrijk verschil. Volgens de eigen roadmap van ByteDance richt de gedetailleerde timing zich momenteel vooral op de dialogen van de personages. Nauwkeurigere controle over geluidseffecten, omgevingsgeluiden en muziek is nog een gebied dat verder ontwikkeld moet worden. Onze tests bevestigden dat onderscheid: de timing van de dialogen was uitstekend, terwijl de exacte timing van de Foley-geluiden minder betrouwbaar was.
Officiële bronnen, gecontroleerd op 6 augustus 2026:
- Productpagina van Seed Audio 1.0
- Introductie van ByteDance Seed
- BytePlus Audio 1.0 API-documentatie
- Prijzen voor BytePlus Audio 1.0
Hoe we Seed Audio 1.0 hebben getest
We hebben negen taken ontworpen en 23 beoordeelde generaties uitgevoerd. Bij de meeste capaciteitstests werd twee of drie keer herhaald, omdat één geoptimaliseerd exemplaar maar weinig zegt over de betrouwbaarheid in de productie.
| Test | Taak | Runs |
|---|---|---|
| T01 | Expressieve Engelse vertelling | 3 |
| T02 | Radiodialoog met twee personages | 3 |
| T03 | Dialoog op 0, 4 en 9 seconden | 3 |
| T04 | Een gangscène met uitsluitend geluidseffecten | 2 |
| T05 | Stem, omgevingsgeluiden, geluidseffecten en muziek | 3 |
| T06 | Op zichzelf staande instrumentale muziek | 3 |
| T07 | Eén teken in het Engels, Japans en Duits | 2 |
| T08 | Podcastmonoloog van 120 seconden | 2 |
| T09 | Vervolg van een referentiestem | 2 |
De 23 geplande outputs bevatten ongeveer 12,5 minuten aan gegenereerde audio en er werd $1.7504 aan upstream-generatiekosten gerapporteerd via de testomgeving. Seed Audio heeft geen gegevens over het gebruik van teksttokens teruggestuurd. De facturering was gebaseerd op het aantal gegenereerde seconden, dus generatietokens zijn geregistreerd als ‘niet van toepassing’.
Alle beoordeelde outputbestanden waren 40 kHz, 16-bit, stereo PCM WAV-bestanden. Wanneer directe geautomatiseerde weergave niet beschikbaar was, ontving Gemini 3.6 Flash de WAV-bestanden als audio-input en leverde het gestructureerde transcripties, gebeurteniscontroles, timingramingen en opmerkingen over artefacten. Deze beoordelingen zijn geautomatiseerde luisterevaluaties, geen door mensen toegekende MOS-scores.
Stemweergave: indrukwekkende hoge tonen, wisselende herhaalbaarheid
T01 · Expressieve vertelstijl
Grote variatieDe ene tekst klonk alsof er iets extra’s was toegevoegd, de andere klonk gekunsteld, en de derde klonk natuurlijk en compleet.
Gebruikte prompt
Een rustige vrouwelijke vertelster spreekt twee exacte zinnen uit, waarbij haar toon verandert van bezorgdheid naar zelfvertrouwen. Geen muziek of geluidseffecten.In de opdracht voor de vertelstem werd aan één rustige vrouwelijke spreekstem gevraagd om twee exacte zinnen uit te spreken, waarbij ze van ingehouden bezorgdheid naar groeiend zelfvertrouwen moest overgaan, zonder achtergrondgeluid.
De drie runs vertoonden zeer uiteenlopend gedrag:
- Ronde 1: sprak de gevraagde zin uit en ging vervolgens enkele seconden door met een onverstaanbare, geïmproviseerde toespraak.
- Ronde 2: sprak de exacte tekst uit, maar klonk traag en schokkerig.
- Ronde 3: heeft het volledige script op natuurlijke wijze voorgelezen, met een uitstekend tempo en een consistente stem.
Dit is de kern van deze recensie. Seed Audio 1.0 kan een krachtige spraakuitvoer produceren, maar één doorloop is niet voldoende voor werk waarbij de formulering cruciaal is. Genereer alternatieven en luister de hele uitvoer goed door voordat je deze publiceert.
Het model heeft zich in alle drie de vertelrondes aan de negatieve instructies gehouden: er werd geen muziek, geen geluidseffecten en geen ongewenste achtergrondgeluiden gedetecteerd.
Dialogen met meerdere personages en sprekeronderscheiding
T02 · Hoorspel met twee personages
3/3 exacte scriptsAlle drie de scripts waren identiek. De omgevingsgeluiden en de lengte van de inleiding varieerden per opname.
Gebruikte prompt
Maya fluistert, Eli antwoordt kalm, en het zoemgeluid van een koelkast klinkt op de achtergrond tijdens drie vaste dialoogwisselingen.In onze scène in de supermarkt kwamen twee volwassen personages en drie vaste dialogen voor. Maya moest gespannen fluisteren, terwijl Eli probeerde kalm te klinken. De enige achtergrondgeluid die gevraagd werd, was het zachte gezoem van een koelkast.
Bij alle drie de afspeelrondes werden de dialogen in de juiste volgorde weergegeven met twee duidelijk te onderscheiden stemmen. De beste afspeelronde combineerde exacte tekst, een heldere scheiding tussen de sprekers, overtuigende emotie en een continu zoemend geluid van de koelkast.
De andere opnames vertoonden kleinere problemen op scèneniveau. Bij één opname werd ongeveer de eerste helft van de 30 seconden besteed aan omgevingsgeluid, voordat de dialoog begon. Bij een andere opname ontbrak het gevraagde zoemgeluid van de koelkast. Geen van beide fouten maakte de gesproken scène onbruikbaar, maar beide verminderen de efficiëntie van de montage.
Wat audiodrama betreft, is het praktische resultaat bemoedigend: Seed Audio begrijpt karakterveranderingen en stemcontrasten. Het kan echter nog steeds nodig zijn om lange inleidingen in te korten of de opname opnieuw te genereren om de juiste omgevingsgeluiden te verkrijgen.
De timing van de dialogen was het beste resultaat
T03 · Timing op promptniveau
Meest betrouwbaarBij alle drie de runs lagen de lijnen in de buurt van de gevraagde punten, binnen de tijdsonzekerheid van de evaluator.
Gebruikte prompt
Plaats drie radiolijnen op 0,0, 4,0 en 9,0 seconden met een mannelijke, vrouwelijke en mannelijke spreker.
Voor de timingtest waren drie radioverbindingen nodig:
- “Eenheid zeven, meld je.” op 0,0 seconden.
- “Noordelijke ingang beveiligd.” na 4,0 seconden.
- “Positie behouden.” na 9,0 seconden.
In alle drie de runs waren de regels, de volgorde en het patroon van mannelijke-vrouwelijke-mannelijke sprekers correct. De audioschattingen van Gemini gaven aan dat de beginmomenten van de herhaalde runs rond 0,1, 4,0 en 9,0 seconden lagen. De eerste run werd geschat op ongeveer 0,1, 3,9 en 8,9 seconden.
Deze metingen mogen niet worden gepresenteerd als bewijs van laboratoriumkwaliteit met een nauwkeurigheid van 100 milliseconden – de beoordelaar gaf zelf aan dat er een onzekerheid van ongeveer 0,1 seconde bestond. Zelfs met dat voorbehoud was dit de meest herhaalbare prestatie die we hebben getest. Als je dialoog op posities dicht bij geplande tijdlijnposities wilt invoegen, is Seed Audio 1.0 buitengewoon veelbelovend.
SFX-generatie: realistische scènes, onvolmaakte telling
T04 · Gang met alleen geluidseffecten
Het tellen is misluktDe ruimte en de volgorde waren overtuigend, maar de twee reeksen leverden vier voetstappen en twee voetstappen op.
Gebruikte prompt
Sleutels, een zware deur, precies drie voetstappen, donder, en een laatste klap. Geen stemmen of muziek.De prompt, die uitsluitend uit geluidseffecten bestond, beschreef een kleine, betegelde gang: sleutels naast de microfoon, een zware houten deur die openging, drie langzame voetstappen die zich verwijderden, verre donder en een laatste dichtslaande deur. Spraak en muziek waren verboden.
Beide uitgangen zorgden voor een geloofwaardige akoestische ruimte, behielden de volgorde van de gebeurtenissen en voorkwamen dat stemmen of muziek naar buiten lekten. De effecten werden als realistisch beoordeeld, met een goede afstand en consistentie in de ruimte.
Geen van beide reeksen volgde de exacte telling. De ene bestond uit vier voetstappen, de andere uit twee. Daardoor is Seed Audio handig voor het genereren van een overtuigend Foley-concept, maar minder betrouwbaar wanneer een editor precies drie klappen, stoten, voetstappen of schoten nodig heeft.
De beste werkwijze is om voor het creëren van sfeereffecten en snelle prototyping gebruik te maken van SFX-generatie in één doorloop, en vervolgens gebeurtenissen waarbij het aantal tellen van belang is te vervangen of te bewerken in een DAW.
Stem, omgevingsgeluiden, geluidseffecten en muziek in één scène
T05 · Volledige filmische mix
2/3 voltooidBij twee van de drie pogingen werd elke stoot voltooid. Bij één poging miste men de laatste metalen klap.
Gebruikte prompt
Regen in de steeg, verkeer, sirene, fluisterende rechercheur, strijkersritme, snelle voetstappen en een metaalachtige klap.
De test met de complete scène was bewust druk opgezet. Er moest een natte steeg bij nacht in voorkomen, waterdruppels, verkeer, een ronkende politiesirene, een gefluisterde zin van een rechercheur, ingetogen strijkers, snelle voetstappen en een metalen deur die dichtsloeg.
Bij twee van de drie afspeelrondes kwam de volledige reeks gebeurtenissen aan bod. De dialogen bleven duidelijk hoorbaar boven de omgevingsgeluiden en de muziek uit, en de scène voelde ruimtelijk samenhangend aan, in plaats van alsof er losse fragmenten over elkaar heen waren gelegd. Bij één afspeelronde ontbrak de laatste metalen klap, hoewel de juiste sfeer en de exacte gesproken tekst verder wel goed werden weergegeven.
Dit is waar het geïntegreerde model zijn kracht het best laat zien. Bij het maken van storyboards en het bedenken van creatieve ideeën is het sneller en expressiever om vanuit één opdracht een complete, samengestelde scène te genereren dan om elk onderdeel afzonderlijk te moeten zoeken. Voor de uiteindelijke productie moeten belangrijke eindsignalen nog steeds worden gecontroleerd.
Kan Seed Audio 1.0 muziek genereren?
T06 · Zelfstandige muziek
MuziekstukkenAlle drie maakten ze gestructureerde muziek. Bij één daarvan was de gedempte piano moeilijk te onderscheiden.
Gebruikte prompt
Een suspense-fragment van 72 BPM met een cello-ostinato, gedempte piano, analoge drone, een opbouw en een open einde.
Ja. Uit onze tests bleek dat Seed Audio 1.0 herkenbare, op zichzelf staande instrumentale muziek produceerde, in plaats van alleen maar een vage ambient-textuur.
De opdracht vroeg om een suspense-fragment van 30 seconden bij 72 BPM met een laag cello-ostinato, gedempte pianopulsen, een zachte analoge drone, een duidelijke opbouw en een onopgelost slotakkoord. Alle drie de versies vormden een samenhangend muzikaal fragment met het gevraagde tempogevoel en de gevraagde afsluiting. Twee daarvan bevatten alle gevraagde elementen; in één versie was de gedempte piano moeilijk te onderscheiden.
Dit betekent niet automatisch dat Seed Audio een vervanging is voor een speciale nummergenerator. Onze opdracht betrof een korte instrumentale filmmuziek, geen nummer met coupletten en refreinen en songtekst. Toch zijn de muzikale mogelijkheden ruimschoots toereikend voor het ondersteunen van gamescènes, trailers, podcasts en previsualisatie – vooral wanneer de muziek in dezelfde generatie moet samenspelen met spraak en geluidsontwerp.
Meertalige prestaties: uitstekend in het beste geval, zwak in het slechtste geval
T07 · Eén stem, drie talen
1/2 schoonDe ene run verliep vlekkeloos; bij de andere kwam er herhaald en verwarde spraak voor rond het moment van de taalwisseling.
Gebruikte prompt
Een vrouwelijk personage spreekt Engels, Japans en Duits met dezelfde zelfverzekerdheid en kalme emotie.
Bij de meertalige opdracht moest een vrouwelijk personage dezelfde rol in de opnamestudio in het Engels, Japans en Duits uitspreken. Twee opnames gaven tegengestelde indrukken.
De betere uitvoering bracht alle drie de zinnen nauwkeurig over, behield dezelfde stem, bleef emotioneel beheerst en maakte gebruik van duidelijke pauzes. De mindere uitvoering begon correct in het Engels, maar herhaalde en vervormde de spraak rond het Japanse gedeelte en verpestte de Duitse inleiding. De waargenomen consistentie van de stem tussen de verschillende talen nam sterk af.
Dit betekent dat Seed Audio 1.0 overtuigende meertalige personageprestaties kan leveren, maar dat deze functie meerdere kandidaten en een taalbewuste beoordeling vereist. Keur een meertalige uitvoer niet goed door alleen de eerste taal te controleren.
Generatie binnen twee minuten en stabiliteit van lange spraakfragmenten
T08 · Monoloog van 120 seconden
2/2 stabielBeide bestanden duurden 120 seconden en werden met een stabiele stem ingesproken. Bij één ervan was er een korte hapering in de uitspraak.
Gebruikte prompt
Een mannelijke podcastpresentator vertelt een gestructureerd verhaal over een weerstation, met drie ontdekkingen en zonder achtergrondinformatie.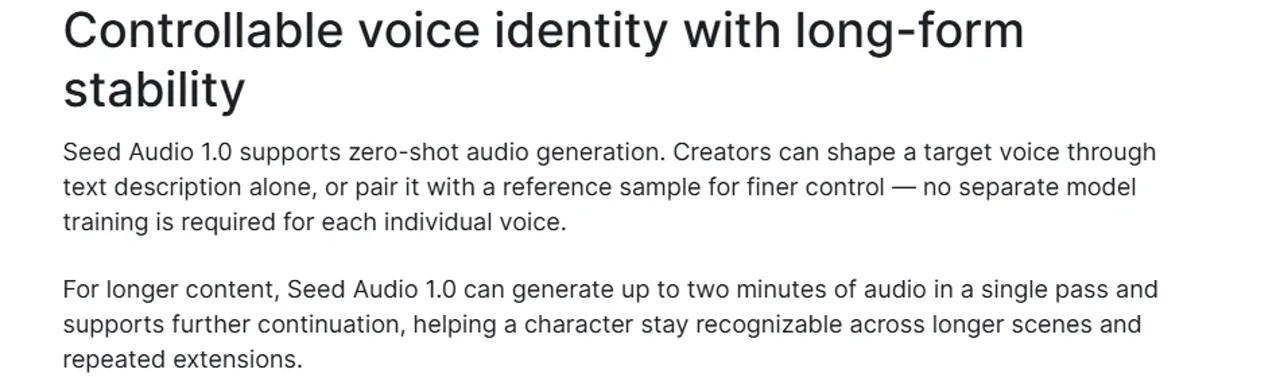
Beide langere opdrachten leverden WAV-bestanden op van precies 120 seconden. Bij beide werd gebruikgemaakt van één mannelijke podcastpresentator met een neutraal studiogeluid, zonder muziek en zonder geluidseffecten.
De eerste versie behield van begin tot eind één vertelstem en een samenhangende onderzoeksstructuur: een duidelijke inleiding, drie chronologische ontdekkingen, een ontwikkeling van nieuwsgierigheid naar onbehagen, en een laatste onbeantwoorde vraag. Er werden geen duidelijke afwijkingen in de vertelstem of onduidelijke fragmenten geconstateerd.
De tweede opname was eveneens samenhangend en stabiel, met één kort struikelblok in de uitspraak rond 1:31. Dat is een sterk resultaat voor een monoloog van twee minuten die in één keer is opgenomen. Het wijst erop dat de bewering van Seed Audio over ‘long-form’ niet louter een beperking in duur is; het model kan de identiteit en de verhaalstructuur gedurende de volledige opname in stand houden.
Bij het controleren van de continuïteit van de referentie-audio is voorzichtigheid geboden
T09 · Voortzetting van de referentie
Route onzekerDe tekst was correct, maar de stemgelijkenis was slecht; bij één uitkomst werd de stem veranderd in een mannenstem en werden geluidseffecten toegevoegd.
Gebruikte prompt
Ga verder vanuit een geautoriseerde vrouwelijke referentie, met behoud van de stemidentiteit en de intieme opnamestijl.Bij de referentietest werd het sterkste vertelvoorbeeld als goedgekeurde input gebruikt en werd gevraagd om een vervolg in dezelfde algemene vrouwelijke identiteit en intieme opnamestijl.
Beide uitvoerresultaten spraken de gevraagde voortzetting exact uit, maar geen van beide kwam goed overeen met het referentiemateriaal. De eerste ging over in een ademend, zacht gefluister en kreeg een bescheiden stemgelijkenisscore van 2/5. De tweede werd beoordeeld als een mannelijke stem, scoorde 1/5 voor gelijkenis en voegde ongeveer 17 seconden ongewenste geluidseffecten toe voordat er werd gesproken.
Er is hier een belangrijke beperking wat betreft de locatie. Het Anywhere-taakeindpunt accepteerde het referentieveld, maar gaf geen bevestiging terug waaruit bleek hoe het upstream-model die referentie verwerkte. Deze resultaten tonen aan dat de continuïteit van de referentie via onze testroute onbetrouwbaar was; ze bewijzen niet dat de native API van BytePlus zich altijd op dezelfde manier gedraagt.
Prijzen en beperkingen van Seed Audio 1.0
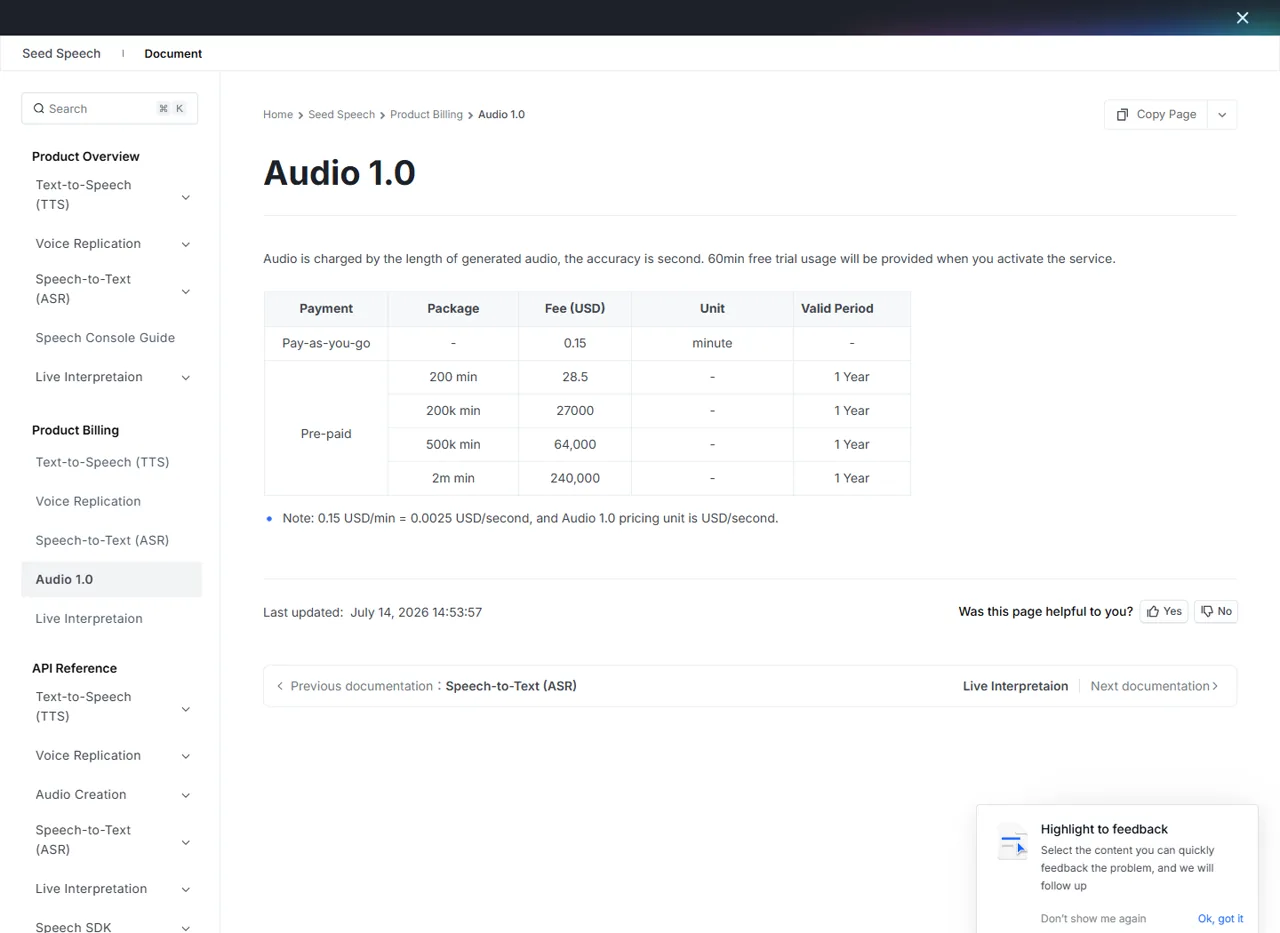
Er wordt per seconde gefactureerd, met 60 gratis proefminuten bij activering van de dienst.
maximaal vermogen
prompttekens
audiofragmenten
referentieafbeelding
BytePlus vermeldt de officiële prijs voor prepaitaanbiedingen op $0,15 per gegenereerde minuut, per seconde gefactureerd, met 60 gratis proefminuten wanneer de dienst wordt geactiveerd. In de API-documentatie wordt een Maximaal vermogen gedurende 120 seconden, ondersteunt prompts tot 3.000 tekens, maakt het mogelijk om maximaal drie referentie-geluidsfragmenten, en accepteert één referentieafbeelding.
Elk referentie-geluidsfragment mag maximaal 30 seconden duren en 10 MB groot zijn. De maximale grootte voor een referentieafbeelding is 10 MB. Dit zijn de standaardlimieten van BytePlus; platforms van derden kunnen een kleiner invoerformulier aanbieden of andere tarieven hanteren.
Onze testroute met Anywhere/BrolyAI rapporteerde de upstream-kosten afzonderlijk; het gemiddelde bedroeg ongeveer $0.14 per gegenereerde minuut. Dit veld in de testomgeving mag niet worden verward met de retailprijzen van BytePlus of de uiteindelijke prijs van een ander platform.
Voordelen en nadelen van Seed Audio 1.0
Waar het uitblinkt
- Gecombineerde stemmen, geluidseffecten, omgevingsgeluiden en muziek
- Uitstekende timing van de dialogen
- Een sterke, diepgaande identiteit
- Handige filmmuziek
Waar het breekt
- Grote variatie tussen de afnames
- Af en toe onverstaanbare spraak
- Exacte SFX-telling met lage nauwkeurigheid
- Onbetrouwbare doorlopendheid van de verwijzingen op onze route
Voordelen
- Genereert stemmen, omgevingsgeluiden, foley-geluiden en muziek in één keer.
- Uitstekende timing van de dialogen tijdens onze herhaalde tests.
- Duidelijke scheiding tussen de twee luidsprekers en nauwkeurige weergave van de dialoog.
- Levert nuttige, op zichzelf staande filmmuziek op.
- Behoudt gedurende twee minuten de stemidentiteit en de samenhang in het verhaal.
- Levert een zuivere 40 kHz stereo-WAV-uitvoer via ons testtraject.
Nadelen
- Herhalingsruns kunnen sterk verschillen wat betreft natuurlijkheid en betrouwbaarheid.
- Af en toe hallucinerende of onverstaanbare spraak.
- Exacte SFX-aantallen zijn onbetrouwbaar.
- Bij sommige volledige scènes ontbreekt een laatste vereiste gebeurtenis.
- Meertalige prestaties moeten zorgvuldig worden geëvalueerd.
- De continuïteit van de referentiestem was in onze testomgeving slecht.
- Een groot aantal gelijktijdige inzendingen leidde tot fouten in de upstream-concurrency, hoewel er geen kosten in rekening werden gebracht voor mislukte taken.
Voor wie is Seed Audio 1.0 bedoeld?
Seed Audio 1.0 is bij uitstek geschikt voor audiomakers die in scènes denken in plaats van in losse elementen. Het is met name handig voor hoorspelen, dialogen in games, filmische prototypes, audio-storyboards, podcastconcepten en korte spanningsfragmenten.
Als systeem voor definitieve oplevering met één muisklik is het minder overtuigend. Als de exacte bewoordingen, de stemidentiteit of het aantal gebeurtenissen juridisch of creatief van cruciaal belang zijn, moet je rekening houden met herhaalde generaties en menselijke controle. Het model werkt het beste wanneer je het beschouwt als een snelle audioregisseur met meerdere takes – niet als een deterministische renderer.
Veelgestelde vragen
Is Seed Audio 1.0 een tekst-naar-spraakmodel?
Kan Seed Audio 1.0 geluidseffecten genereren zonder spraak?
Kan Seed Audio 1.0 muziek genereren?
Hoe lang kan Seed Audio 1.0 geluid genereren?
Ondersteunt Seed Audio 1.0 referentieaudio?
Hoeveel kost Seed Audio 1.0?
Eindoordeel
Seed Audio 1.0 is een werkelijk interessant, geïntegreerd audiomodel. De mogelijkheid om op basis van één prompt overtuigende spraak, foley-geluiden, omgevingsgeluiden en muziek te genereren, is niet zomaar een marketingclaim: uit onze tests met gemengde scènes en muziek is gebleken dat de verschillende elementen goed samenwerken.
Het sterkste punt was de timing van de dialogen. Het grootste zwakke punt was de consistentie. Bij 23 voorbeelden liet het model herhaaldelijk een uitstekend resultaat zien in het beste geval, maar ook een merkbaar zwakkere alternatieve versie.
Bij creatief prototypen is die afweging gemakkelijk te accepteren. Genereer verschillende versies, houd de sterkste variant aan en bekijk elk einde. Bij deterministische productie, exacte stemherkenning of werk waarbij het aantal gebeurtenissen van belang is, moet je een fase voor menselijke controle en redactie in de workflow behouden.
Algemeen oordeel: Seed Audio 1.0 is een van de meest veelzijdige audiogeneratoren op scèneniveau die we hebben getest, maar het programma komt het best tot zijn recht als creatief hulpmiddel voor meerdere opnames, in plaats van als renderprogramma voor een eenmalige definitieve uitvoer.