2026年7月7日に行ったテストでは、コードレビュー、根本原因分析、アーキテクチャ計画、および長期的な文脈に基づく推論において、Claude Sonnet 5がより優れた初期結果を示しました。 一方、完全な実装草案、実行可能なテストの骨組み、またはそのままコピーして使えるサンプルが必要な場合には、GPT-5.5の方が最初の検討段階として適していました。リポジトリレベルの作業については、チャットウィンドウだけを見て各社を評価するのではなく、Claude CodeとCodexを比較検討してください。.
有用な区分は、単に「Claudeが勝つ」や「ChatGPTが勝つ」といった単純なものではありません。 2026年9月27日現在、Anthropicのラインナップには、Claude Fable 5.1、Opus 5.5、Sonnet 5、およびHaiku 4.5が含まれています。 OpenAIのGPT-6ファミリーには、Astra、Sol、Lunaが含まれています。製品のアクセス権は重要です。SolとLunaはChatGPTのWork、Codex、およびAPIでリリースされましたが、その発表では通常のChatが明示的に除外されていました。 以下の実機テストセクションは、2026年7月7日に同じプロンプトを用いてテストされた、Claude Sonnet 5とGPT-5.5の比較であり、現在は古くなっています。最新の比較については、以下を参照してください。 Claude Opus 5.5 対 GPT-6 Sol.
個別のサブスクリプションを切り替えずにモデルを比較したい場合、GlobalGPTはGPT-6 Astraや Claude Opus 5.5 モデルセレクターから利用可能です。コーディング解答の比較、計画立案、執筆、調査などに役立ちますが、Claude Code、Codex、公式API、IDE、あるいはリポジトリを意識した開発ワークフローの代わりになるものではありません。.

目次
- コーディングにおけるクロード対ChatGPT:簡単な回答
- 2026年に何が変わったのか
- 現在のコーディングモデルのラインナップ
- ベンチマークの概要:SWE-Bench、Terminal-Bench、およびそれらの意味
- ClaudeとChatGPTのコーディング機能をどのようにテストしたか
- テスト1:デバッグと根本原因の分析
- テスト 2:リファクタリングと保守性
- テスト3:複数ファイルを用いた推論と計画立案
- テスト4:単体テストと検証
- テスト5:セキュリティおよび信頼性の検証
- 「クロード・コード」と「コーデックス」:チャットだけでは物足りないとき
- 価格:Claude、ChatGPT、Codex、GlobalGPT
- どのコーディング環境を選べばよいでしょうか?
- なぜ多くの開発者が依然として両方を併用しているのか
- よくあるご質問
プログラミングにおけるクロード対ChatGPT:簡単な答え
7月7日に実施した同一プロンプトを用いたチャットテストでは、問題が曖昧な場合、Claude Sonnet 5の方が最初の回答として優れていました。このモデルは、可能性の高い原因を優先し、不要な情報を排除し、リスクを明確に説明していました。 一方、次のステップがインポートやテスト用スケルトン、より詳細なコードを含む本格的な実装草案である場合には、GPT-5.5の方が優れた結果を示しました。これらの観察結果は、当該テストにおけるものであり、将来のすべてのモデルリリースに当てはまるわけではありません。.
日常的な開発においては、通常、次のようなワークフローが最適です:
- まずはクロードを使ってみよう コードレビュー、バグの優先順位付け、アーキテクチャの決定、そして「まずどこをチェックすべきか?」といった質問について。.
- まずはChatGPTを使ってみましょう 初期実装の生成、テストの骨組みの作成、例の作成、そして計画をコードへと落とし込むために。.
- 両方を使う 移行処理、セキュリティに影響を及ぼす変更、支払い、認証、ファイルのアップロード、および本番環境のデータを破損させる可能性のあるあらゆる処理について。.
| コーディングの必要性 | より良い1巡目指名 | なぜ |
|---|---|---|
| 厄介なバグのデバッグ | クロードが最初 | 当社のテストでは、Claudeが最も可能性の高い原因を優先的に特定し、故障の経路を明確に説明しました。. |
| 完全な実装草案の作成 | ChatGPTを最初に | 我々のテストでは、GPT-5.5の方がより充実したコードと、すぐに使えるスキャフォールディングを提供しました。. |
| セキュリティまたは信頼性に関するリスクの見直し | まずはクロード、その次にChatGPT | Claudeは深刻度を明確にランク付けしました。ChatGPTは具体的な実装パターンを追加しました。. |
| リポジトリ全体のファイルを変更する | Claude コードまたはコーデックス | リポジトリのコンテキスト、コマンドの実行、テスト、および差分情報は、単なるチャット形式の回答よりも重要です。. |
もし、全体としてコーディングにはどのモデルファミリーが最適かというのが主な質問であるなら、より広い観点から言えば、 コーディングに最適なAIモデル この比較記事は、次に読むのに役立つでしょう。もし主な検討対象がOpenAIエコシステム内にあるのであれば、「コーディングガイドに最適なChatGPTモデル」という記事で、GPTモデルの選定についてさらに詳しく解説されています。.
2026年に何が変わったのか
2026年の比較を意味のあるものにするには、3つの変化を考慮に入れる必要がある。.
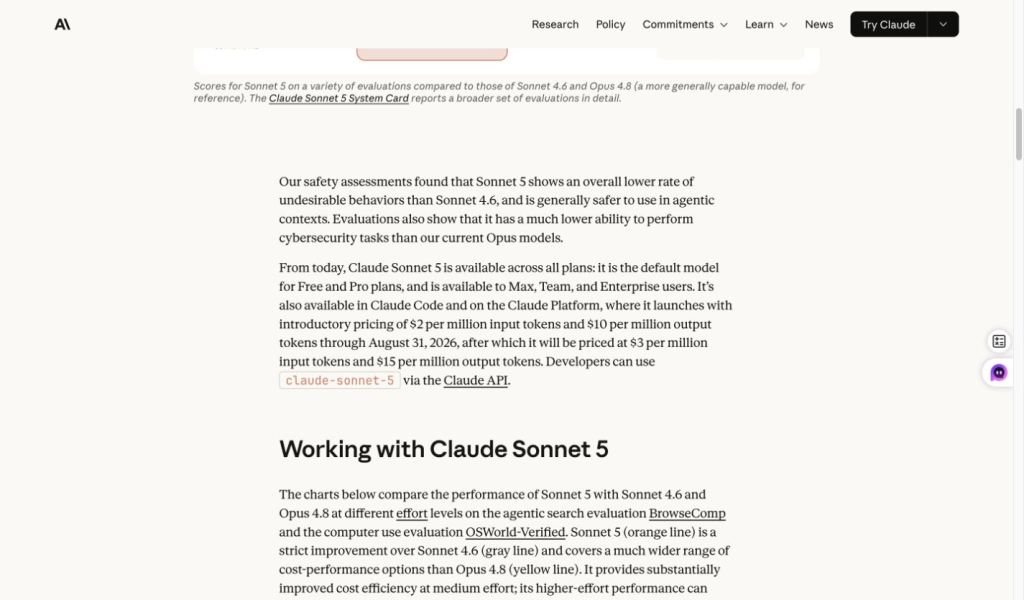
まず、『クロード・ソネット5』によって、決定におけるクロード側の立場が変わった。. Anthropicでは、Sonnet 5がすべてのプランで利用可能であり、Claudeコードとしても提供され、開発者はClaudeプラットフォームにアクセスできると説明されています。これは重要な点です。なぜなら、Claudeはもはやコーディングの説明を行うだけのチャットアシスタントではなく、Anthropicのコーディングエージェントワークフローの一部となっているからです。.
第二に、GPT-6は現在、OpenAIにおけるコーディング作業向けのモデルファミリーとなっています。. Astraは複雑なソフトウェア開発をターゲットにしており、SolとLunaはより低コストの選択肢を提供している。. OpenAIの9月22日リリース発表 ChatGPT WorkおよびCodex for Plus、Pro、Business、Enterprise、Eduには「Sol」と「Luna」が掲載されており、デスクトップアプリではFreeおよびGoユーザーも「Luna」を利用できます。これらのモデルは現時点ではChatでは利用できないことが明記されています。APIへのアクセスは別途課金されます。.
第三に、チャットアシスタントとコーディングエージェントは、業務の異なる部分を担っています。. プレーンチャットは、コードの断片、デバッグ、説明、計画立案などに役立ちます。. Claude コードとコーデックス これらは、ファイルの検査、コマンドの実行、変更点のテスト、および大規模なタスクにわたる作業を行うように設計された、リポジトリを意識したワークフローです。公正な比較を行うには、チャットの出力品質とコーディングエージェント製品の機能とを区別する必要があります。.
現在のコーディングモデルのラインナップ
2026年9月27日現在、コーディングの比較は、単なる「Claude対ChatGPT」という一対一の対決ではなく、ラインナップ全体の決定事項となっています:
| サイド | 検討すべき現行モデル | コーディングの最適な活用法 |
|---|---|---|
| クロード | Claude Fable 5.1、Claude Opus 5.5、Claude Sonnet 5、および Claude Haiku 4.5 | 長期的な視点でのレビュー、計画立案、デバッグ、主体的なコーディング、およびClaudeコードのワークフロー。. |
| ChatGPT / OpenAI | GPT-6 アストラ, 、GPT-6 Sol、およびGPT-6 Luna。利用状況は、ChatGPT Work、Chat、Codex、APIによって異なります。 | 実装、フロントエンド作業、テスト、ツールを活用したワークフロー、およびCodex関連のタスク。. |
| グローバルGPT | GPT-6 アストラ および Claude Opus 5.5(GlobalGPT で検証済み)。これは別のプラットフォームサブスクリプションです。 | プロンプトの並列比較、日常的なコードに関する質問、調査、およびアプローチの評価。. |
Claudeへのアクセス状況やプランの詳細を追跡している場合は、別の Claude AIの2026年計画 ガイドおよび、より詳細な「Claude AI 価格ガイド」です。OpenAI プランを比較される場合は、「ChatGPT サブスクリプションプラン 2026 内訳」の方が、よりわかりやすい参考資料となります。.
ベンチマークの概要:SWE-Bench、Terminal-Bench、そしてそれらの意味
ベンチマークは、制御されたコーディングタスクにおいてモデルがどのように動作するかを示してくれるため有用です。重要なのは、各ベンチマークが実際に何を測定しているのかを正しく理解することです。リポジトリのイシューベンチマーク、ターミナルエージェントベンチマーク、そして公式のモデルリリース表は、それぞれ異なる指標であるため、以下の実践的なテストと併せて活用すべきです。.
GPT-5.5:試験日からのコーディング根拠
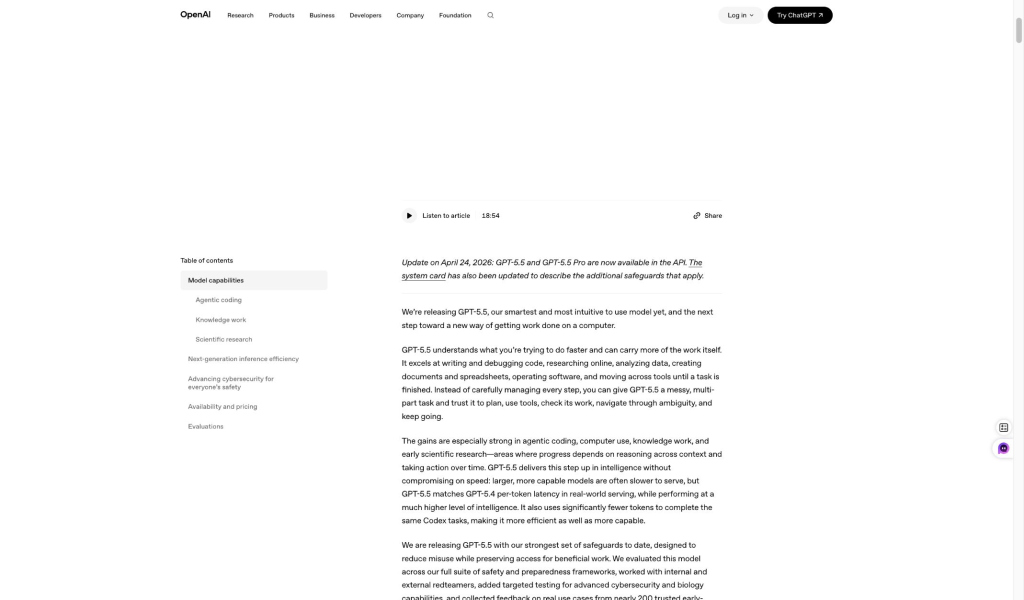
以下のGPT-5.5に関する記述は、7月7日の実機比較で使用されたモデルと一致するため、そのまま残しています。 これは、テストセクションにおける実装に重点を置いた観察結果を裏付けるものですが、現在のOpenAIモデルラインナップとして解釈すべきではありません。現在、GPT-6が主要なシリーズとなっており、アクセス方法はChatGPT Work、通常のChat、Codex、およびAPIによって異なります。.
SWE-Bench:リポジトリの問題の解決
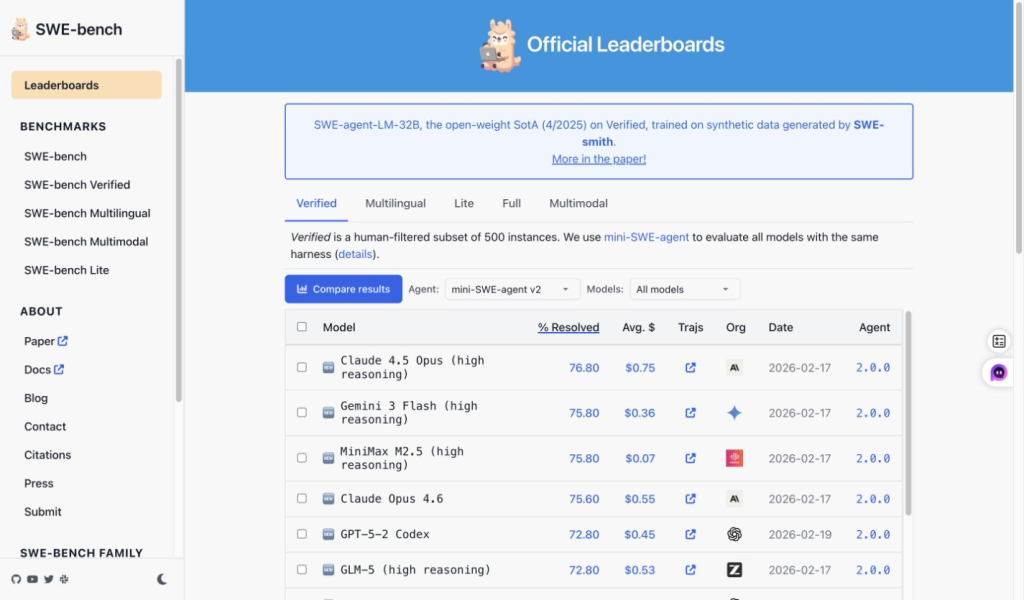
SWE-Bench これは、短いコードスニペットのプロンプトよりも実際のソフトウェア保守に近いという点で有用です。リポジトリのイシューを分析し、モデルがそのタスクを解決する変更を生成できるかどうかを判断します。 ClaudeとChatGPTを比較する場合、これはソフトウェアエンジニアリングの能力についてある程度の示唆を与えてくれますが、説明の質やレビューの判断、あるいはチャットワークフローにおいてその回答がどれほど役立つと感じられるかといった点については、依然として全体像を捉えているとは言えません。.
SWE-Bench Pro:難易度の高いコーディング課題と正答率
Scaleの「SWE-Bench Pro」公開リーダーボード この指標は、より難易度の高いリポジトリ作業に焦点を当て、解決率を主な評価指標としているため、より厳格な指標となっています。これは、コーディングエージェントの真の実力を重視する場合に特に有用です。つまり、モデルがバグの原因を説明できるかどうかだけでなく、ベンチマーク条件下でリポジトリを正常に動作する修正へと導けるかどうかが問われるのです。.
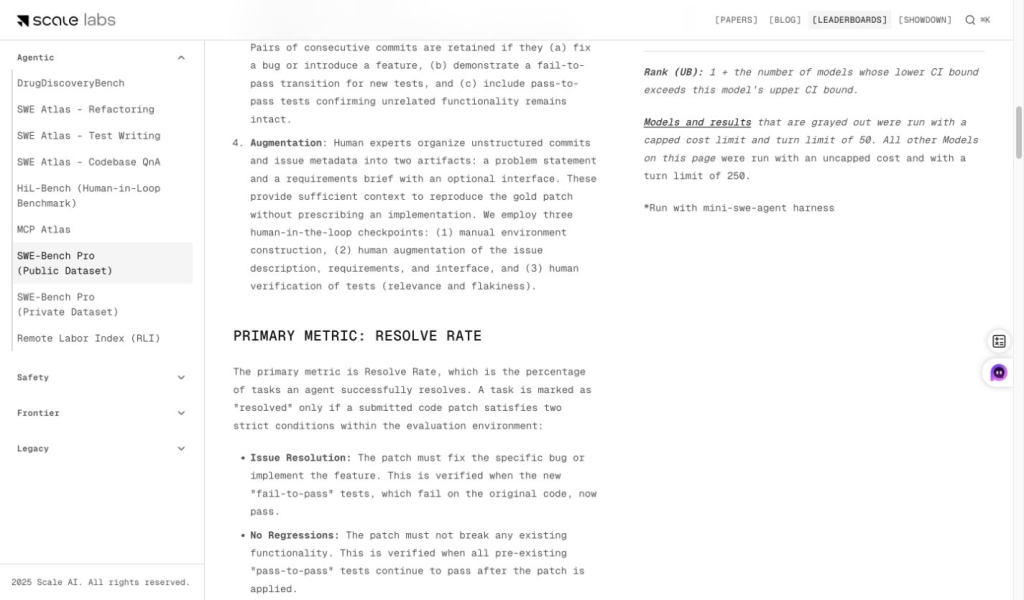
Terminal-Bench:コマンドラインおよびエージェントのワークフロータスク
ターミナル・ベンチ 2.1 SWE-Benchとは異なり、エージェントやモデルの設定によるターミナルおよびコマンドライン上のタスクの完了に焦点を当てています。そのため、単なる「この関数を書いてください」といったチャットプロンプトよりも、Claude CodeやChatGPT Codexスタイルのワークフローとの関連性が高くなります。 リポジトリレベルやコマンドラインでの作業向けのコーディングアシスタントを選定する際は、このベンチマークを判断材料の一つに含めるべきです。.
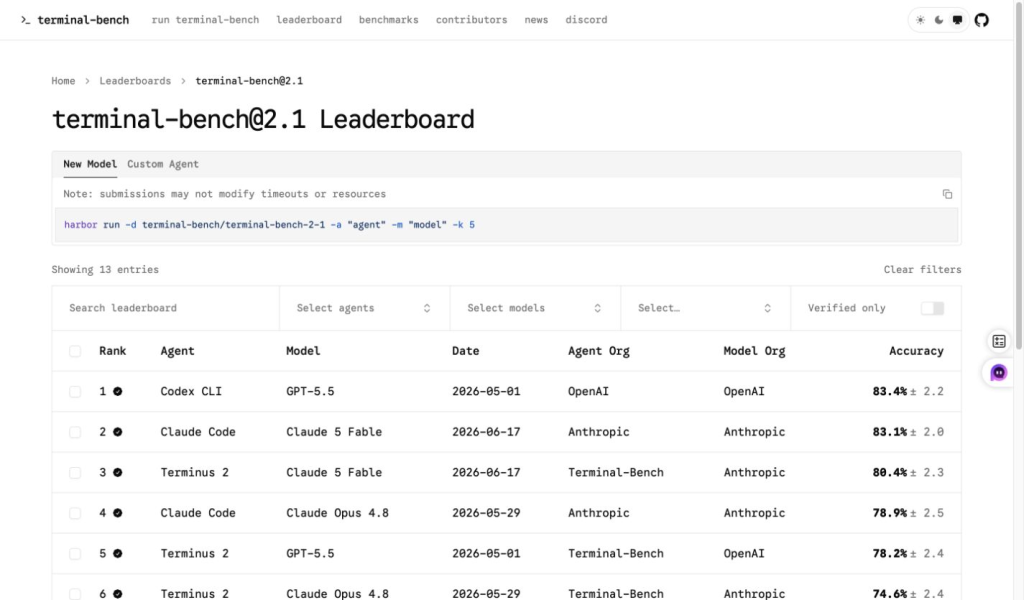
| 証拠 | おすすめの一冊 | 実践的なポイント |
|---|---|---|
| OpenAI GPT-5.5 プログラミング教材 | GPT-5.5によるコーディングと、主体性のあるソフトウェア工学における位置づけ。. | 実装作業を主とするコーディングアシスタントとしてのChatGPTに対する支持は強い。. |
| SWE-Bench | リポジトリの課題解決およびソフトウェアの保守業務。. | コーディング能力を測る上で良い指標となる。特に、リポジトリの文脈が重要となる場合にはなおさらである。. |
| SWEベンチ・プロ | リポジトリ関連タスクの難易度と解決率の比較。. | 本格的な能動的コーディング能力を評価するのに役立つ。. |
| ターミナル・ベンチ 2.1 | ターミナルでの作業、コマンドの実行、およびエージェント/モデルの設定。. | 単なるチャットプロンプトよりも、クロード・コードやコーデックスのワークフローに密接に関連しています。. |
ベンチマークの結果から、どちらのモデルファミリーも信頼できるコーディングの選択肢であることがわかりますが、それだけでは日々のワークフローにおける選択は決まりません。以下のセクションでは、デバッグ、リファクタリング、計画立案、単体テスト、セキュリティレビューについて同じプロンプトを使用しているため、実際の運用において回答がどこで異なったかを確認することができます。.
ClaudeとChatGPTのコーディング能力をどのようにテストしたか
2026年7月7日、GlobalGPTにおいて、GPT-5.5とClaude Sonnet 5を、同じインターフェースと同じプロンプトを使用してテストしました。 その目的は、IDEエージェントの包括的なベンチマークを再現することではなく、デバッグ、リファクタリング、複数ファイルにわたる推論、テスト作成、セキュリティレビューといった、日常的なコーディング支援機能を比較することでした。.
評価基準はシンプルでした。正確性、根本原因の推論、保守性、エッジケースの網羅性、検証、そして指示の順守です。これにより、開発者が実際にAIコーディングアシスタントをどのように利用しているかという実態に近い比較が可能になります。.
テスト 1:デバッグと根本原因の分析
最初のプロンプトでは、両方のモデルに対し、優先度ごとにチケットをグループ化するJavaScript関数を検証するよう求めました。このバグは些細ですがよくあるものです。この関数は、 acc[ticket.priority] その配列が存在するようになる前に。.
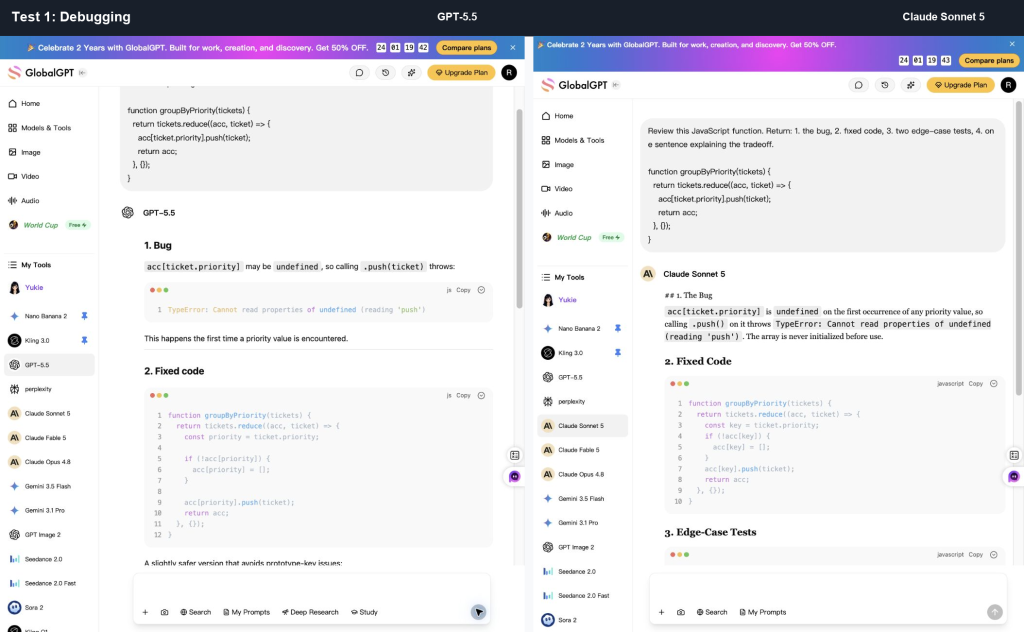
ChatGPTがうまくできた点: GPT-5.5はバグを発見し、修正済みのコードを提供し、エッジケースのテストを追加し、より保守的な Object.create(null) バリエーション。この追加の実装上の工夫は、オブジェクトのキーが継承されたプロパティと衝突する可能性がある場合に役立ちます。.
クロードの良かった点: Claude Sonnet 5も同じバグを発見し、より的確な回答を提示しました。また、優先順位が未定義というエッジケースも指摘しており、これはレビュー担当者が考慮すべき実用上の境界事例と言えます。.
優勝だ: 引き分け。実装のニュアンスという点では、ChatGPTがわずかに優れていた。Claudeの方がすっきりしていたが、GPT-5.5の方が完成度が高かった。.
テスト 2:リファクタリングと保守性
2つ目の課題では、動作を変更せずに可読性を高めるリファクタリングが求められました。これは良いテストとなります。というのも、AIによるコーディング回答の多くは、小さなユーティリティ関数を過剰にリファクタリングし、元のコードが必要とする以上に複雑な構造を作り出してしまうからです。.
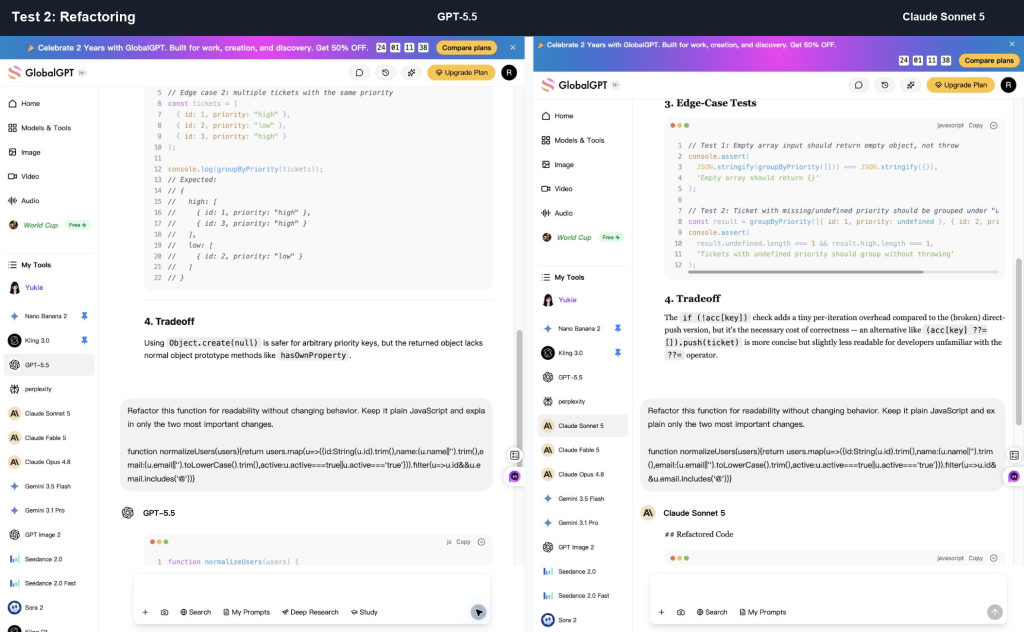
ChatGPTがうまくできた点: GPT-5.5は、構造をオリジナルに忠実に保ち、名前付きの中間値を導入し、「重要な変更は2つだけ」という指示をきっちりと守りました。これは、ユーザーが控えめなリファクタリングを希望する場合に有用です。.
クロードの良かった点: Claude Sonnet 5は、ノーマライザーやバリデータなどのヘルパー関数を抽出しました。その結果、インテントの読み取りは容易になりましたが、GPT-5.5よりも構造が大きく変更されました。.
優勝だ: ChatGPTは抑制力、Claudeはモジュール性の向上に役立ちます。安全で最小限のリファクタリングが必要な場合は、まずChatGPTから始めてください。ドメイン名の命名を一層明確にしたい場合は、Claudeに再チェックを依頼しましょう。.
テスト3:複数ファイルを用いた推論と計画立案
3つ目の課題では、Next.jsの小さなファイルツリーとバグ報告が提示されました。ログイン済みのユーザーは小さなファイルをアップロードできますが、8MBを超えるファイルは、プログレスバーが「100%」に達すると、エラー表示なしにアップロードに失敗します。.
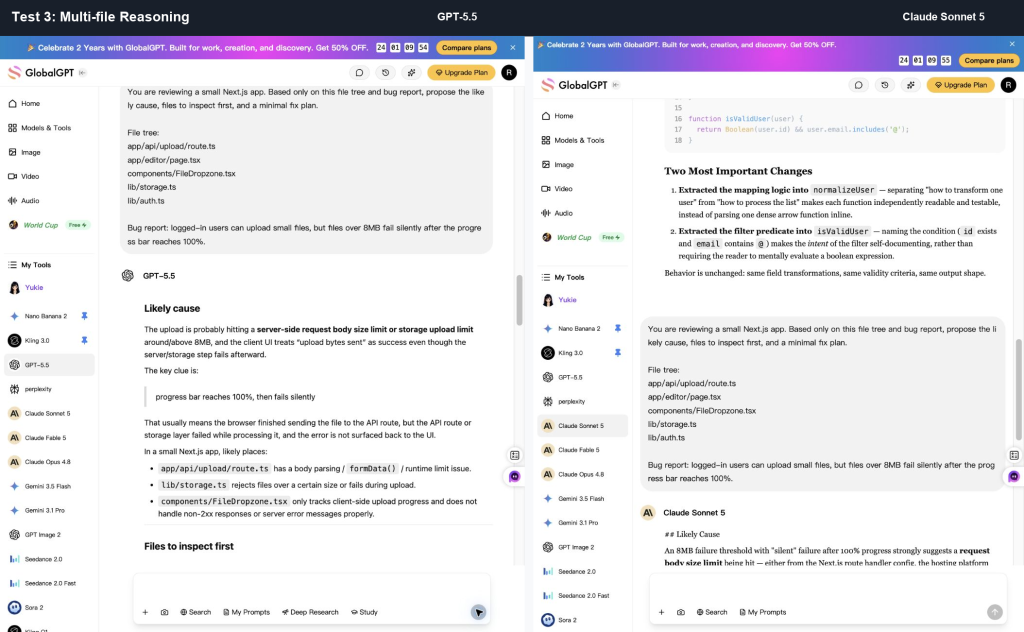
ChatGPTがうまくできた点: GPT-5.5は、実装に重点を置いた詳細な計画を提示しました。その中には、サーバーサイズの確認、クライアントからの応答処理、およびストレージエラーの伝播について言及されていました。.
クロードの良かった点: 「Claude Sonnet 5」は、8MBという閾値(おそらくプラットフォームや本体サイズの制限)、進行状況バーのセマンティクス、そして7MB/8MB/9MBの検証パスを即座に焦点に据えました。これは、むしろ上級者向けのレビューノートのような印象を受けました。.
優勝だ: クロード。これにより、考えられる原因をより迅速に絞り込み、より的確な最小限の点検手順を提示することができた。.
テスト 4:単体テストと検証
4つ目の課題では、両方のモデルに対し、アップロードおよびCodexへのアクセスに関するプランの制限値を返すヘルパー関数のTypeScriptユニットテストを作成するよう求めました。これは、モデルが分岐ロジックを将来の回帰から保護できるかどうかを検証するものです。.
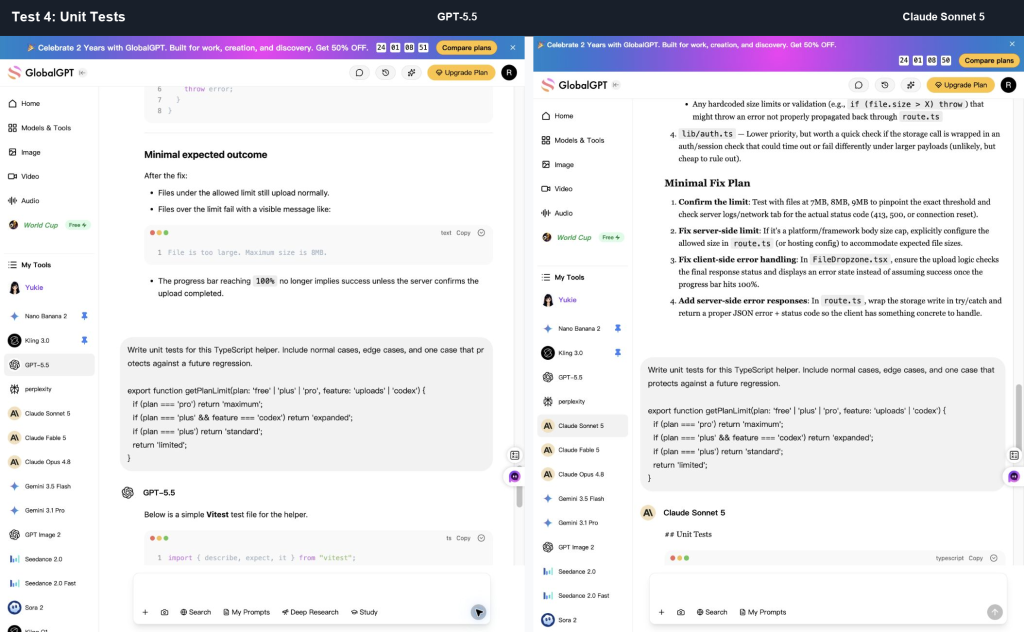
ChatGPTがうまくできた点: GPT-5.5はテストフレームワークのインポートを含めており、実行可能そうなVitestファイルを生成しました。期待される組み合わせを網羅しており、そのコードをプロジェクトに貼り付けるのも簡単でした。.
クロードの良かった点: クロード・ソネット5は、実際の回帰リスクについてより的確に説明していた: pro + codex 機能固有のチェックが行われる前に、必ず短絡処理が行われる必要がある。ファイルとしての「そのまま使える」利便性は低かったものの、理屈としてはより説得力のある回答だった。.
優勝だ: テストの推論にはClaudeを、スターターファイルの生成にはChatGPTを使用します。実際には、最初のテスト草案の作成にはChatGPTを使い、そのテストが正しい動作を確実にカバーしているかどうかを検証するにはClaudeを使用します。.
テスト5:セキュリティおよび信頼性の検証
5番目のプロンプトでは、両方のモデルに対し、ExpressのWebhookエンドポイントを検証するよう求めました。適切な回答には、署名の検証、Raw-Bodyの要件、冪等性、バリデーション、データベースエラーの処理、およびリクエストサイズの制限について言及されている必要があります。.
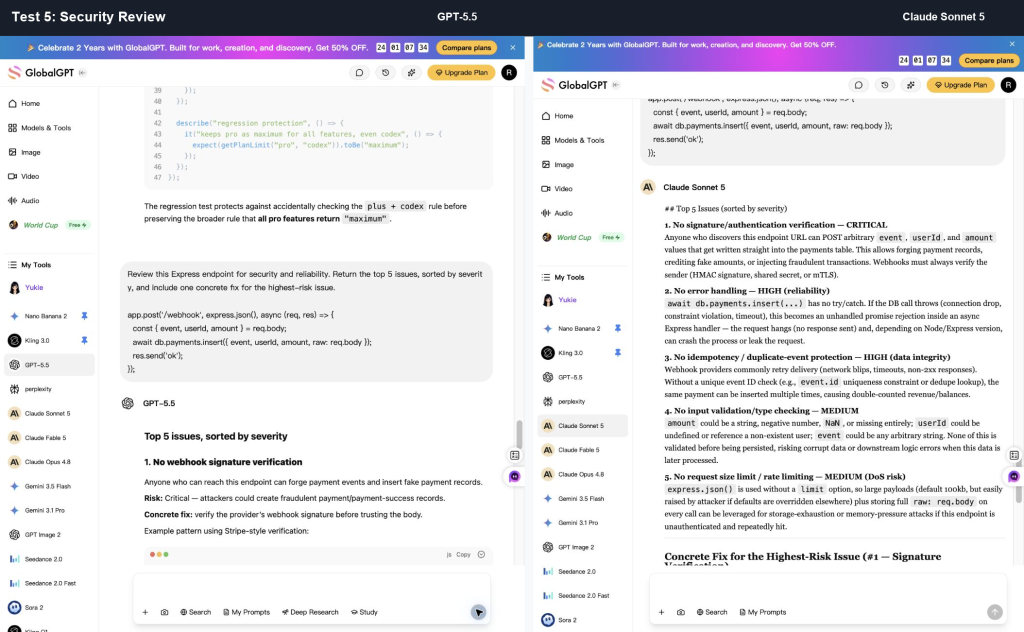
ChatGPTがうまくできた点: GPT-5.5は、Stripeのような機能を含む、プロバイダー形式の解決策を提示しました。 express.raw() パターン。これは、次のステップとして具体的なWebhookハンドラを実装する場合に役立ちます。.
クロードの良かった点: Claude Sonnet 5 では、より明快で厳密な推論が行われ、定数時間比較の考え方を用いた、より確実な署名比較の詳細が含まれていました。これにより、リスクのランク付けがより的確になったと感じられました。.
優勝だ: 引き分けですが、セキュリティの説明という点ではクロードがわずかに優れています。どちらのモデルも実用的なほど優れていましたが、支払いフローや認証フローに関する実際のセキュリティレビューの代わりとなるものではありません。.
Claude Code 対 ChatGPT Codex
チャットの出力は、コーディングに関する意思決定の一部に過ぎません。Claude CodeとCodexは、ファイル、コマンド、テスト、プルリクエスト、あるいはより広範なコードベースの変更を伴うタスクのための、それぞれ独立したエージェント開発ワークフローです。.
| ワークフロー | ベストフィット | 重要な境界 |
|---|---|---|
| クロード・チャット | 推論、デバッグ、レビュー、説明、および計画。. | ツールやより広範なワークフローと連携していない限り、この機能はユーザーが指定したコンテキストのみを認識します。. |
| ChatGPTのチャット | 実装の草案、テスト、サンプル、およびAPIの使用に関する質問。. | たとえ説得力のある回答であっても、プロジェクト内で検証を行う必要があります。. |
| クロード・コード | リポジトリを意識したコーディング、コードベースのナビゲーション、テスト、および大規模なタスクの計画。. | 変更を承認する前に、権限、セキュリティポリシー、および提案された差分を確認してください。. |
| コーデックス | Repoを意識した実装、デバッグ、テスト、レビュー、およびOpenAIと統合されたコーディングワークフロー。. | プランへのアクセス、利用状況、およびモデルの利用可能性は、通常のチャットとは異なり、時間の経過とともに変化する場合があります。. |
実用的なアプローチ:思考、説明、および簡単なタスクにはチャットモデルを使用し、リポジトリのコンテキストや実行可能な手順が必要な作業には、Claude Code または Codex を使用する。.
価格:Claude、ChatGPT、Codex、GlobalGPT
まずは、何に対して料金を支払っているのかを確認しましょう。 チャットプランは、日々の対話型コーディングサポートに対する料金です。コーディングエージェントのワークフローは、CLI、IDE、Web、クラウドタスク、統合など、リポジトリを認識した作業に対する料金です。APIの料金体系は、100万トークンごとに課金されます。マルチモデルワークスペースは、Claude、GPT、Gemini、Perplexity、その他のモデルを1か所で簡単に切り替えて利用できる機能に対する料金です。.
2026年9月27日時点で確認した価格は、適用される税抜きで米ドル建てです。この表では、一般ユーザー向けサブスクリプション、標準APIトークン料金、およびGlobalGPT独自の年間プランを分けて表示しています。. Claudeの価格ページ rounds Proの年間利用料は、$17/月相当です。$200を前払いした場合、$16.67/月となります。.
| 製品またはプラン | 表示価格 | コーディングにとっての意味 |
|---|---|---|
| 一般ユーザー・Claude 無料 | $0 | 軽いコーディングの質問や、購入前にClaudeのスタイルを試してみるには十分な内容です。. |
| コンシューマー · Claude Pro | $20/月、$200/年(前払い、$16.67/月に相当) | Claudeコードが含まれています。チャットおよびClaudeコードによる有料プランの利用が可能です。. |
| コンシューマー・Claude Max | $100/月より | より大容量のプラン;Claudeコードが含まれています。APIコンソールの課金は別途となります。. |
| 一般ユーザー・ChatGPT 無料 | $0/月 | 軽量版チャット。GPT-6 Lunaのデスクトップ版へのアクセスは、通常のチャットとは異なります。. |
| 消費者 · ChatGPT Go | 米国の原資料では「$8/月」と記載されていますが、地域によって価格は異なる場合があります | 月額サブスクリプション。お住まいの地域の料金については、現地の価格ページをご確認ください。. |
| 消費者 · ChatGPT Plus | $20/月、毎月請求 | 定期的なコーディングプロンプトと、対象となるCodex/Workへのアクセス権。APIの利用料は別途請求されます。. |
| 消費者 · ChatGPTプロ | $100/月;既存の$200/月の契約は継続されます | 2026年9月10日より、$200の新規登録およびアップグレードの受付を一時停止いたします。$100のサブスクリプションについては、引き続きご利用いただけます。. |
| API · クロード・ソネット第5番 | $2/M 入力;$10/M 出力 | コーディングツールおよび大規模コンテキストのワークフロー向けの標準API料金。. |
| API · Claude Opus 5.5 | $4/M 入力;$20/M 出力 | 標準速度。「高速モード」は、入力が$8/M、出力が$40/Mとなります。. |
| API · GPT-6 アストラ | $10/M 入力;$50/M 出力 | 標準API料金。ChatGPTプランとは別です。. |
| API · GPT-6 Sol / Luna | Sol:$2/M入力、$10/M出力;Luna:$0.10/M入力、$0.50/M出力 | 開発者向けの請求を別途行う。その際、正確なモデルIDと料金を設定すること。. |
| プラットフォーム · GlobalGPT ベーシック | $5.80/月相当;$69.60は年額請求 | 日常的なコーディング課題や研究において、複数のモデルファミリーを比較するための、費用対効果の高い方法。. |
| プラットフォーム · GlobalGPT Pro | $10.80/月相当;$129.60(年額請求) | 日常業務で複数のモデルファミリーを切り替える際に、より使いやすくなります。. |
| プラットフォーム · GlobalGPT 無制限 | $25/月相当;$300は年額請求 | 1つのワークスペース内で頻繁に複数のモデルを比較する場合に最適です。これらのプランには、公式APIクレジットやネイティブのClaude Code/Codexサブスクリプションは含まれていません。. |
ほとんどの開発者にとって、重要なのは「どの会社が最も安いのか」ではなく、「どの価格が自分のワークフローに合っているか」です。もし、主に質問をしたりコードスニペットを貼り付けたりすることが多いのであれば、Claude Pro または ChatGPT Plus これで十分かもしれません。リポジトリを意識した実装をご希望の場合は、ClaudeのコードおよびCodexへのアクセス機能を比較してみてください。毎日複数のモデルを比較する場合は、GlobalGPTの方が、コストが複数の個別のサブスクリプションではなく1つのマルチモデルプランにまとめられるため、日常のワークスペースとしてよりすっきりとした環境になるでしょう。.
APIを多用するコーディングツールの場合、サブスクリプション料金は適切な比較基準ではありません。コードのコンテキストが広範囲に及ぶため、トークン単位の料金体系の方が重要になります。. クロード・ソネット第5番 標準速度では、コストは入力で$2/M、出力で$10/Mであるのに対し、Opus 5.5では$4/Mおよび$20/Mとなる。 したがって、入力トークン100万個と出力トークン100万個の場合、Sonnet 5では$12、Opus 5.5では$24のコストがかかります。 OpenAI の場合、同じ使用量に対して、標準料金では Astra では $60、Sol では $12、Luna では $0.60 のコストがかかります。 これらはAPI利用料であり、ChatGPT、Claude、またはGlobalGPTのサブスクリプションに含まれる利用枠ではありません。.
どのコーディング環境を選ぶべきか?
モデル名だけで選ぶのはやめましょう。実際に担当しているコーディング作業の種類に合わせて選びましょう。同じ人でも、日常業務では、最初の実装にはChatGPTを、レビューにはClaudeを、実行可能なリポジトリ作業にはCodexを、そしてモデルを並べて素早く比較確認するにはGlobalGPTを使うといった具合に、状況に応じて使い分けることがあります。.
プログラミングを学び始めた初心者: まずは ChatGPT から始めてみてください。通常、この資料にはより多くの例や手引きが掲載されており、「このエラーが理解できない」という状態から「これでうまくいく形」へとたどり着くための、より分かりやすい道筋が示されています。“
バグを修正している新人開発者: 問題が不明確な場合は、まずClaudeから始めましょう。Claudeは、考えられる原因を絞り込み、最初に確認すべき点を特定し、説明を的を絞ってまとめるのが得意です。その後、具体的なパッチ、テストケース、または実装例が必要な場合は、ChatGPTを利用してください。.
変更内容をレビューしているシニアエンジニア: まずはClaudeから始めましょう。トレードオフの検討、深刻度のランク付け、アーキテクチャ上の課題、そして簡潔な批評には、こちらの方が適しています。大規模なコードベースに関するタスクの場合は、チャットからClaude CodeまたはCodexに移行してください。そうすることで、モデルは貼り付けられたコード断片ではなく、ファイルやコマンドを直接処理できるようになります。.
フロントエンドまたはUIビルダー: まずはChatGPTを使って最初の草案を作成します。ChatGPTは、より充実したコンポーネントコード、状態管理、テストの骨組みを生成する傾向があります。その後、Claudeを使って、アクセシビリティ、コンポーネントの境界、命名規則、そしてコードが設計に対して過剰に凝りすぎているかどうかを確認します。.
大規模なコードベースのメンテナー: スタック、アカウントへのアクセス権限、セキュリティポリシー、および希望するワークフローに応じて、「Claude Code」または「Codex」のいずれかを選択してください。タスクが複数のファイルにまたがる場合、どのチャットの回答がより適切かという点よりも、エージェントのワークフローの方が通常は重要になります。.
単独の創業者か、少人数のチームか: 予算が許すなら、両方のモデルファミリーを活用しましょう。実用的な構成としては、日々のモデル比較や「アイデアからコードへ」のプロンプティングにはGlobalGPTを、リポジトリへのアクセスや実行可能な手順が必要なタスクにはClaude CodeやCodexを使用するのが良いでしょう。.
| 開発者の種類 | 第一候補として最適 | なぜ |
|---|---|---|
| プログラミングを学び始めた初心者 | チャットGPT | さらに多くの例や、より詳しい解説、そして初心者にもわかりやすい学習の足掛かり。. |
| バグを修正しているジュニア開発者 | クロードが最初 | 根本原因の分析をより明確にし、「まずこれを確認する」という指針をより充実させる。. |
| 変更内容をレビューしているシニアエンジニア | クロード | トレードオフの検討、リスクの優先順位付け、および簡潔な批評において、より適している。. |
| フロントエンド/UIビルダー | まずはChatGPT、その次にClaude | ChatGPTが構成案を作成し、Claudeがアクセシビリティ、構造、保守性を確認します。. |
| 大規模なコードベースのメンテナー | スタックやアクセス方法によって、「Claude Code」または「Codex」のいずれかとなる | ファイル、コマンド、テスト、権限は、チャットでの単一の回答よりも重要です。. |
| Soloの創業者 | その両方が、多くの場合、1つのマルチモデルワークスペースを通じて行われます | 1人の担当者が製品全体を統括する場合、迅速な草案作成、入念なレビュー、そして素早いモデル切り替えがすべて重要になります。. |
新しいClaudeとGPTのモデルファミリーのどちらを選ぶか迷っている場合は、「Claude Opus 5.5 vs GPT-6 Sol」の比較記事が、各モデルに関するより具体的な情報を提供しています。有料のOpenAIプランを検討している場合は、 ChatGPT Plus vs Pro 比較を行うことで、利用頻度を高めることがそれだけの価値があるかどうかを判断する手がかりになります。.
なぜ多くの開発者が依然として両方を併用しているのか
ClaudeとChatGPTの両方を使うことは、優柔不断というわけではありません。それは、より優れた品質管理のサイクルなのです。.
- クロードと計画を立て、ChatGPTで実行する: リスクを絞り込むためにClaudeを、最初の実装を作成するためにChatGPTを使用したい場合に便利です。.
- ChatGPTで下書きし、Claudeで校正する: 高速なコードが必要だが、より厳格なセカンドオピニオンも得たい場合に役立ちます。.
- 本番環境に触れる前に、次の2点を確認してください: 支払い、認証、アップロード、データ移行、キャッシュ、およびデータベースへの破壊的な変更に役立ちます。.
- タスクでファイルが必要な場合は、エージェントを使用してください: モデルがリポジトリのコンテキストを必要とする場合、クロード・コード(Claude Code)やコーデックス(Codex)は、単なるチャットよりも重要になることがあります。.
GlobalGPTは、タスクがプロンプトの比較、日常的なコーディングのサポート、計画立案、あるいは調査である場合に、「両方を使う」というパターンに当てはまります。特に、日々のモデル比較、ドラフトの反復修正、手っ取り早いセカンドオピニオンの取得、そして次の作業に最適なモデルスタイルの選択に役立ちます。.
もし、Claudeへのアクセスだけが評価対象であるならば、 クロードAIの代替品 このリストは、より広範な代替案のガイドです。.
よくあるご質問
2026年、コーディングにはクロードとChatGPTのどちらが優れているでしょうか?
コードレビュー、曖昧なデバッグ、アーキテクチャの計画、および長文の文脈に基づく推論には、まず Claude を選択してください。 実装の草案、サンプルコード、フロントエンド作業、テストの骨組み作成には、まずChatGPTを選択してください。リポジトリへのアクセス、コマンド、テスト、または複数ファイルの編集が必要なタスクの場合は、チャットだけに頼るのではなく、Claude CodeとCodexを比較検討してください。.
デバッグに関しては、クロードの方がChatGPTより優れているのでしょうか?
Claudeは、最初のデバッグ段階では往々にしてより優れています。なぜなら、原因となりそうな箇所を優先的に特定し、失敗の経緯を明確に説明してくれる傾向があるからです。JavaScriptやNext.jsのテストでは、Claude Sonnet 5が特に簡潔な診断に長けていました。一方、修正に実装の詳細がより多く必要な場合でも、ChatGPTは依然として優れた性能を発揮しました。.
ChatGPT CodexはClaude Codeより優れているのでしょうか?
どちらがすべてのチームにとって自動的に優れているというわけではありません。ChatGPT Codexは、OpenAIを中心としたワークフローや、実装作業の多いエージェントタスクに適しています。Claude Codeは、Claudeの計画、レビュー、および長期的な文脈に基づく推論スタイルが業務に有効な場合に強みを発揮します。 どちらが適しているかは、リポジトリへのアクセス権、価格、スタック、権限、およびチームのポリシーによって異なります。.
大規模なコードベースにはどちらが適していますか?
大規模なコードベースの場合、チャットモデル単体よりもエージェントのワークフローの方が重要になります。アシスタントがファイルの確認、コマンドの実行、テストの実行、あるいはモジュール間の動作の追跡を行う必要がある場合は、Claude Code または Codex を使用してください。権限、リスクの高いコマンド、および最終的な差分については、人間によるレビューを維持してください。.
プログラミングを学び始めた初心者には、どちらが適していますか?
ChatGPTは、例や詳しい説明、すぐに使えるコードスニペットを多く提供してくれる傾向があるため、初心者にとっては一般的に使いやすいです。一方、初心者が「なぜうまくいかないのか」という点で行き詰まり、より明確な概念的な説明が必要な場合には、Claudeの方が適している場合があります。.
フロントエンドのHTMLやUIコードには、どちらが適していますか?
HTML、CSS、またはコンポーネントの最初の草案を作成するには、ChatGPTの方が得意な場合が多いです。一方、Claudeは構造の確認、レイアウトの簡素化、アクセシビリティや保守性の問題の発見に役立ちます。洗練されたフロントエンド作業を行う際は、ChatGPTで草案を作成し、Claudeでレビューを行うとよいでしょう。.
テストを書くには、どちらのモデルが適していますか?
インポートや実行可能そうな構造を備えた完全なテストファイルが必要な場合は、ChatGPTの方が適しています。どの挙動を保護すべきか、また回帰テストがなぜ重要なのかを理解したい場合は、Claudeの方が適しています。ChatGPTでテストを生成し、その後Claudeに「どのようなエッジケースが抜け落ちているか」を尋ねるのが、効果的なワークフローです。.
SWE-Benchのようなベンチマークは、どのコーディングアシスタントが優れているかを証明できるのでしょうか?
SWE-Bench、SWE-Bench Pro、Terminal-Benchは、特にエージェント型コーディングのワークフローにおいて有用な指標ですが、日々のコーディング支援を完全に予測できるわけではありません。ベンチマークは制御された環境下でのパフォーマンスを測定するものであり、実際の開発者には、明確な推論、実用的なコード、保守性の高い変更、そして適切な検証手順も必要となります。.
開発者は、ClaudeとChatGPTの両方を使うべきでしょうか?
そうですね、特に本格的な作業の際にはそうです。計画、リスク評価、診断にはClaudeを使い、実装の草案、例、テストの骨組みにはChatGPTを使いましょう。その後、コードを実行し、差分を確認して、自分のプロジェクトで動作を検証してください。.
GlobalGPTで、ClaudeとChatGPTを比較することはできますか?
はい。GlobalGPTは、必要なモデルが1つのワークスペースに揃っている場合、そのワークスペース内でClaudeとChatGPTの回答を比較するのに役立ちます。日常的なコードに関する質問、計画立案、調査、セカンドオピニオンなどには非常に有効です。 ただし、Claude Code、Codex、IDE、公式API、あるいはリポジトリレベルのツールの代わりになるものではありません。.