GPT Image 2.6 vs 2.5: test, prezzi e risultati reali
Sei coppie di prompt originali confrontano GPT Image 2.6 e 2.5 su persone, storyboard, etichette bilingui, layout e posizionamento degli oggetti, con valutazioni a stelle, tempo e token di output.
 Chloe Murphy

GPT Image 2.6 è un aggiornamento significativo del flusso di lavoro piuttosto che un semplice aggiornamento del punteggio di qualità. OpenAI documenta una famiglia 2.6 con gpt-image-2.6-sunburst per lavori visivi dettagliati e gpt-image-2.6-flare per un'iterazione più rapida. La stessa documentazione aggiunge il controllo esplicito della complessità, modifiche guidate da markup, output SVG e output GIF animato.
La famiglia di modelli ChatGPT include strumenti per scrivere un brief creativo e generare i relativi elementi visivi; si tratta di fasi separate di un flusso di lavoro di produzione.
Abbiamo scritto sei brief di lavoro per packaging, design dell'informazione, nature morte commerciali, fotografia di moda, pubblicità e storyboard cinematografici. Ciascuno è stato inviato invariato a entrambe le route dei modelli. I dodici output originali mostrano errori specifici e successi utili; non stabiliscono una classifica complessiva dei modelli. La generazione ha utilizzato alias Broly/Anywhere, senza mappatura delle varianti native verificata in modo indipendente.
GPT Image 2.6 vs 2.5: risposta rapida
- Cosa è cambiato: 2.6 offre Sunburst e Flare, così come 2.5. La sua documentazione aggiunge controlli di complessità e flussi di lavoro SVG/GIF; l'editing guidato da markup copre anche i modelli 2.5 supportati.
- Cosa mostrano i test abbinati: 2.6 segue meglio la sovrapposizione pubblicitaria specificata; 2.5 preserva il numero di oggetti nella natura morta affollata. Entrambi posizionano i bottoni di moda sul lato sbagliato e interrompono la continuità del lato borsa nello storyboard.
- Cosa non è cambiato: Il prezzo ufficiale della generazione di immagini è basato su token, con la stessa tariffa principale di output delle immagini di 30 $ per 1 milione di token immagine nella documentazione sui prezzi verificata.
- Migliore scelta pratica: Scegliete 2.6 quando i suoi controlli documentati si adattano al vostro flusso di lavoro, ma controllate ogni oggetto ed etichetta. Queste tre coppie non giustificano un aggiornamento basandosi solo sull'accuratezza dell'immagine.
Il confronto delle immagini è un piccolo campione, non un benchmark ufficiale o una classifica di qualità universale.
GPT Image 2.6 vs 2.5: Modelli e impostazioni di test
| Impostazione | Opzioni del modello ufficiali | Usato nel nostro confronto |
|---|---|---|
| Modello 2.6 | Sunburst: lavoro visivo dettagliato; Flare: iterazione rapida | gpt-image-2.6 Alias di terze parti; Sunburst/Flare non divulgato |
| Modello 2.5 | Sunburst e Flare | gpt-image-2.5 Alias di terze parti; Sunburst/Flare non divulgato |
| Qualità di rendering | basso, medio, alto, molto alto, max | basso richiesto per entrambi i percorsi |
| Complessità | 2.6: basso, medio, alto; impostazione predefinita ufficiale alta | Non inviato; impostazione effettiva di terze parti non restituita |
| Canvas e input | Dipende dal modello e dalla richiesta | 1024 × 1024 richiesto; solo testo, nessun seed o immagine di riferimento |
Queste immagini non stabiliscono prestazioni Sunburst contro Sunburst o Flare contro Flare. Le risposte delle attività salvate identificano solo alias di versione generici. Inoltre, qualità=bassa è qualità di rendering, non prova di bassa complessità o di un modello Flare. Definizioni ufficiali di modello e complessità.
GPT Image 2.6 vs 2.5: funzionalità e controlli di modifica
Scelta del modello
Sunburst e Flare
gpt-image-2.6-sunburst è posizionato per lavori visivi dettagliati. gpt-image-2.6-flare è posizionato per un'iterazione più rapida. La route del provider corrispondente utilizzava un alias generico 2.6, quindi non è chiaro se abbia selezionato uno dei modelli nativi.
Controllo
La complessità è esplicita
La guida documenta low, medium, e high complessità, con alta come predefinita quando omessa. OpenAI afferma che l'impostazione non comporta costi aggiuntivi.
Output e modifiche
Markup, SVG e GIF
La guida 2.6 evidenzia modifiche guidate da markup, output SVG e output GIF animati insieme a input di testo e immagini. Trattali come capacità documentate e convalida la forma esatta della risposta nel tuo SDK.
Il rendering del testo rimane un'attività di revisione: La guida di OpenAI avverte che testi complessi, caratteri ricorrenti e composizioni strutturate possono ancora fallire.
Il modello a token rimane centrale: Le dimensioni dell'output, la qualità, la lunghezza del prompt, le immagini di riferimento e l'uso della cache influiscono sull'utilizzo; la denominazione del modello non crea un prezzo fisso per immagine.
Gli ID nativi contano: La rotta ufficiale utilizza l'ID esatto del modello Sunburst o Flare. Un servizio di terze parti può esporre un alias come
gpt-image-2.6, che dovrebbe essere etichettato come alias di rotta.
Un'etichetta commerciale richiede diritti di uso commerciale e verifiche indipendenti dei fatti del prodotto, nonché una leggibilità del lettering.
Le stelle di tempo e output confrontano solo queste due risposte dei provider all'interno di ciascuna attività: meno secondi o token di output immagine guadagnano più stelle. Stelle = 5 × il valore più basso ÷ questo valore, arrotondato, minimo 1. Si tratta di valutazioni relative di campioni, non di punteggi ufficiali di efficienza del modello; le varianti e alcune dimensioni restituite differiscono.
Tempo = invio dell'attività del provider fino al completamento, incluso il tempo di coda; non la pura latenza di inferenza del modello. Token = token di output immagine riportati dal provider, escluso l'input del prompt. Diverse route dei provider e varianti native non divulgate impediscono una classifica ufficiale di velocità o efficienza dei token.
GPT Image 2.6 vs 2.5: test di testo, layout e spaziali più difficili
Abbiamo scritto tre brief di lavoro impegnativi: packaging bilingue con tabelle numeriche, un poster a nove pannelli con un percorso di connettori prescritto e dodici oggetti con occlusione a strati. Ogni prompt è stato inviato una volta a ciascuna route. Tutte e sei le prime uscite sono mostrate; nessuna è stata rigenerata o ritoccata.
Impostazioni richieste: prompt identico all'interno di ogni coppia, 1024 × 1024, bassa qualità, PNG, nessuna immagine di riferimento. Le impostazioni restituite differivano: tutte le immagini 2.6 e la griglia 2.5 sono 1024 × 1024; le immagini di packaging e spaziali 2.5 sono 1254 × 1254. Confrontiamo la conformità ai vincoli, non la nitidezza del testo piccolo o la superiorità della risoluzione. Non è stato fornito alcun seed e gli alias di route non sono verificati in modo indipendente come varianti native OpenAI.
| Attività / Metrica | GPT Image 2.6 | GPT Image 2.5 |
|---|---|---|
| Etichetta bilingue Qualità | ★★★★★Testo e numeri mantenuti | ★★★★★Testo e numeri mantenuti |
| Tempo | ★★★★★26 s | ★★★☆☆39 s |
| Output | ★★★★★1.758 token | ★★★★☆2.058 token |
| Layout a nove pannelli Qualità | ★★★★★Ordine dei pannelli e frecce corrette | ★★★★★Ordine dei pannelli e frecce corrette |
| Tempo | ★★★★★26 s | ★★★★☆29 s |
| Output | ★☆☆☆☆1.758 token | ★★★★★213 token |
| Scena con 12 oggetti Qualità | ★★☆☆☆Marmo extra; nastro tagliato | ★★★☆☆Testo chiave; nastro tagliato |
| Tempo | ★★★★★18 s | ★★★☆☆36 s |
| Output | ★★★★★1.758 token | ★★★★★1.650 token |
Valutazioni editoriali di questi singoli output: ★★★★★ nessun problema visibile nei controlli esaminati; ★★★★☆ correzione minore; ★★★☆☆ correzione importante; ★★☆☆☆ correzione maggiore; ★☆☆☆☆ inutilizzabile. Non è un benchmark complessivo del modello. L'allineamento esatto dei pixel e la nitidezza del testo piccolo non vengono valutati.
1. Confezione bilingue e fedeltà numerica
Prompt esatto utilizzato per entrambi i modelli
Create one square print-ready flat back-label design for a fictional tea brand on ivory paper, black type and dark green rules. No mockup, perspective, extra text or illustrations. Use a clear two-column grid, English left and Simplified Chinese right. At top render exactly: MOSS & KETTLE / 山苔茶室. Below render exactly: JASMINE GREEN TEA / 茉莉绿茶. Render these paired rows, preserving every number and punctuation: NET WT 80 g / 净含量80克; INGREDIENTS: green tea, jasmine flowers / 配料:绿茶、茉莉花; ORIGIN: Fujian, China / 产地:中国福建; BREW: 3 g + 180 ml / 冲泡:3克+180毫升; WATER: 80°C / 水温:80°C; STEEP: 2 min / 浸泡:2分钟. Add a lower-left boxed table titled BREWING SCHEDULE with columns ROUND | WATER | TIME and exactly these three rows: 1 | 180 ml | 120 s; 2 | 180 ml | 90 s; 3 | 180 ml | 150 s. To its right put a distinct warning box reading exactly: KEEP DRY. RESEAL AFTER OPENING. / 避光干燥保存,开封后密封。 Across the bottom render exactly: LOT JG-0418 | BEST BEFORE 2028-04-18. Keep every line legible, no invented barcode, seal, logo, extra claims or watermark.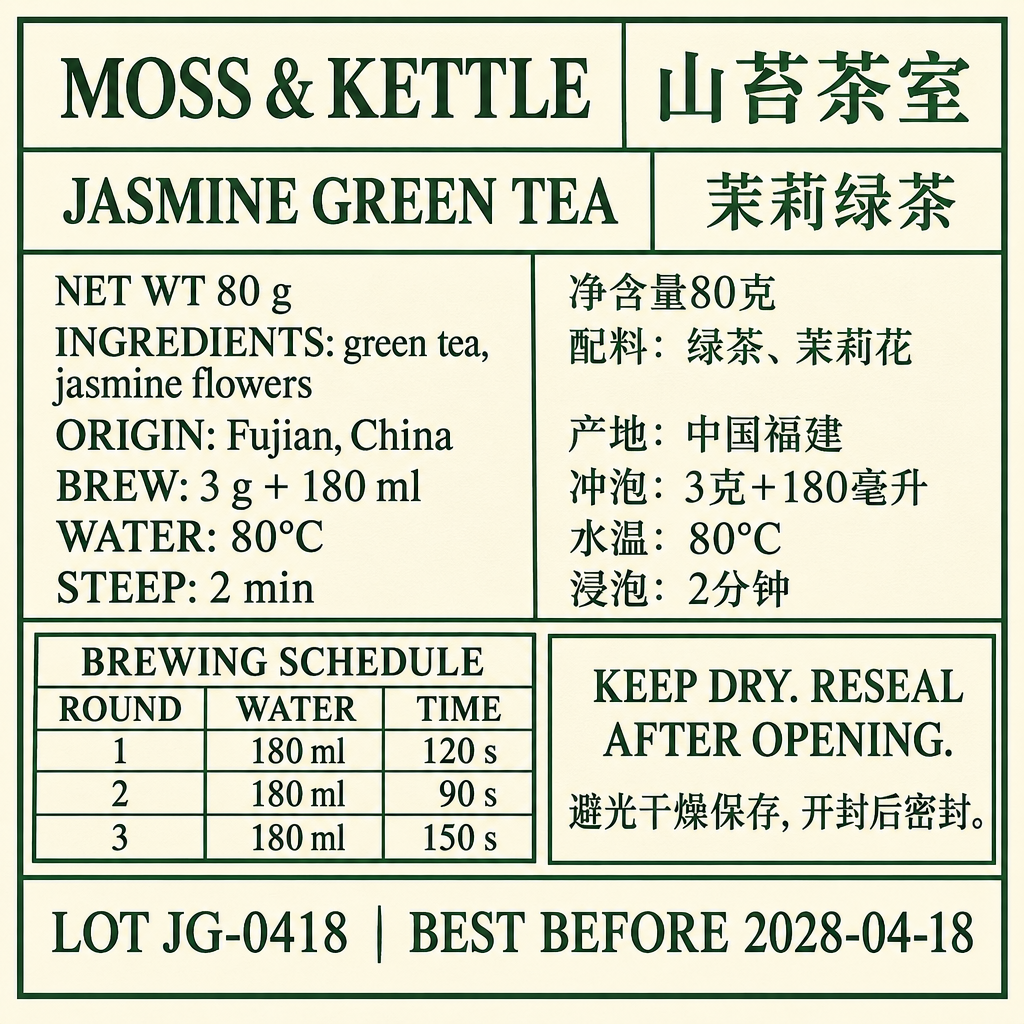
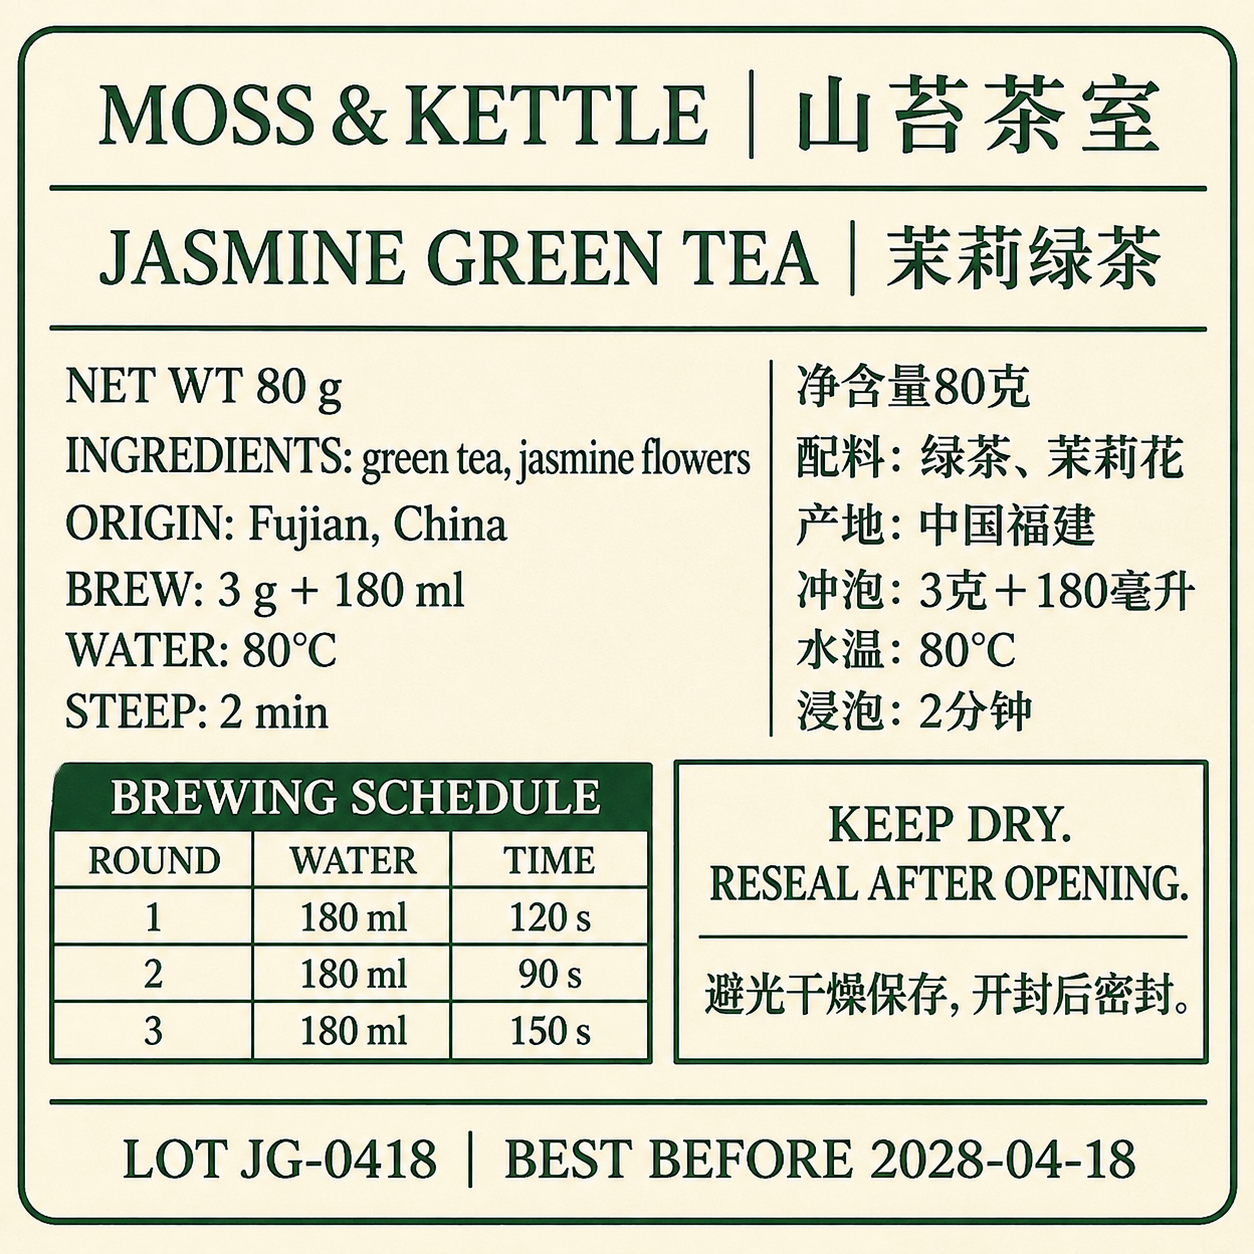
Differenza chiave: Entrambi mantengono il contenuto bilingue principale e la tabella numerica; il canvas 2.5 restituito più grande impedisce un verdetto di nitidezza comparabile.
2. Layout a nove pannelli con vincoli tra pannelli
Prompt esatto utilizzato per entrambi i modelli
Create a square editorial information poster with a precisely aligned 3 by 3 grid of nine equal rectangular panels, read left to right then top to bottom. White background, black type, thin gray dividers; no perspective, extra words, logos or watermark. Put one large title above the grid exactly: NINE STEPS TO A BETTER LAUNCH. Panels must contain exactly the following numbered headings and second lines: top-left 01 BRIEF / One goal; top-center 02 AUDIENCE / Three interviews; top-right 03 RESEARCH / Five sources; middle-left 04 SKETCH / Two directions; center 05 BUILD / One prototype; middle-right 06 TEST / Six participants; bottom-left 07 REVISE / Fix the top issue; bottom-center 08 LAUNCH / Publish once; bottom-right 09 LEARN / Review after 7 days. Each panel contains one minimal black line icon appropriate to its heading, with identical icon size. Color only the center panel pale coral; leave the other eight white. Draw exactly eight teal connector arrows following this continuous snake path: 01 right to 02, 02 right to 03, 03 down to 06, 06 left to 05, 05 left to 04, 04 down to 07, 07 right to 08, 08 right to 09. Do not renumber panels to follow the snake. Align heading baselines within each row and icon centers within each column. Add exactly one footer below the grid: SMALL TESTS. CLEAR DECISIONS. Keep all text and arrows separate and readable.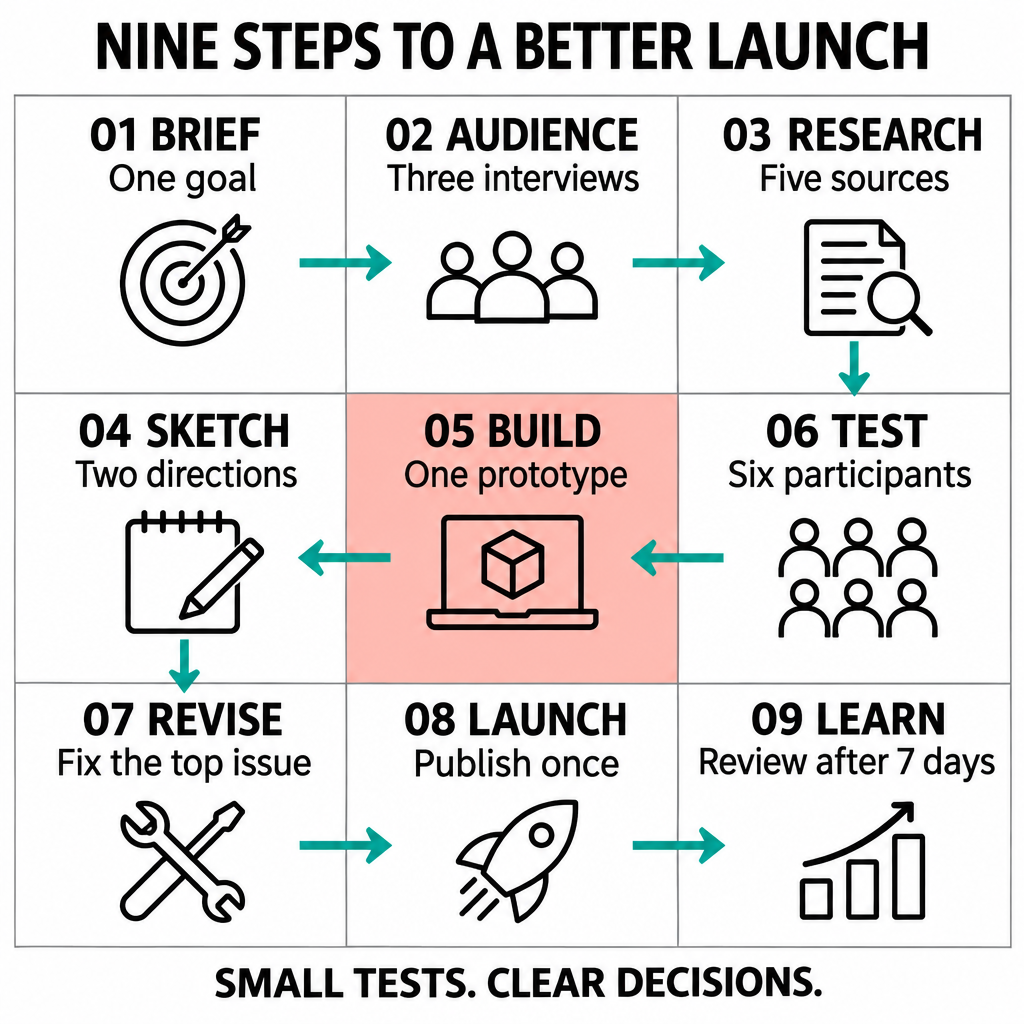
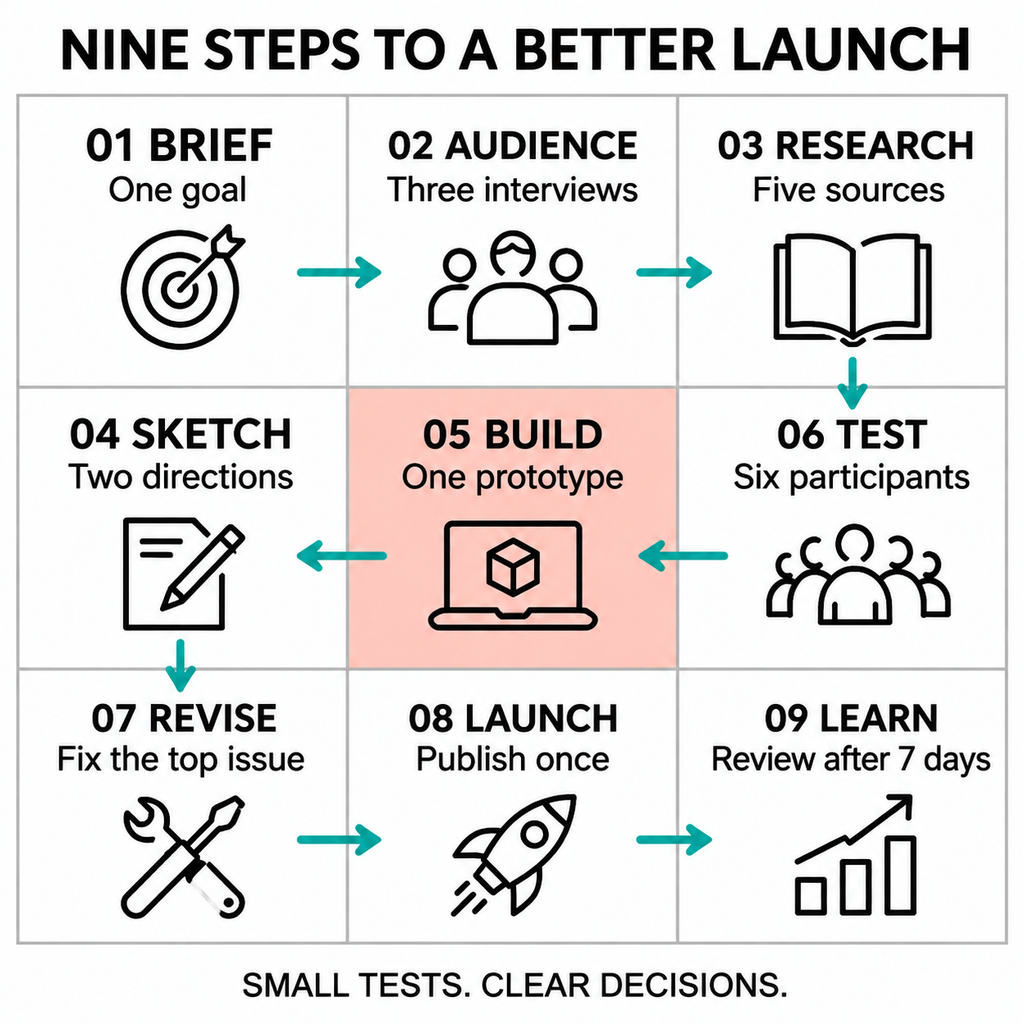
Differenza chiave: Entrambi mantengono nove posizioni dei pannelli e il serpente a otto frecce. Nessun vincitore di accuratezza strutturale in questa coppia.
3. Dodici oggetti, distinzioni di materiali e occlusione
Prompt esatto utilizzato per entrambi i modelli
Create a square photorealistic top-down still life on a plain matte ivory tabletop. Show exactly twelve objects total: one red ceramic mug, one blue glass tumbler, one green metal tin, one whole yellow lemon, one silver teaspoon, one closed black notebook, one orange pencil, one brass key, one white seashell, one purple ribbon strip, one clear glass marble, and one folded pink paper triangle. Arrange the first nine in a three-by-three grid: top row red mug, blue tumbler, green tin; middle row lemon, teaspoon, black notebook; bottom row brass key, white seashell, pink triangle. The teaspoon bowl points toward the blue tumbler and its handle points down toward the seashell. The orange pencil lies diagonally across the notebook from lower-left to upper-right, with both ends extending beyond the notebook. The purple ribbon runs horizontally behind the lemon and teaspoon but in front of the notebook: it must disappear under the lemon and spoon, then remain visibly on top of the notebook. The single glass marble is inside the blue tumbler and visible through its transparent side. The mug is empty; the tin is closed. Exactly those twelve objects, no saucers, lids as separate objects, duplicates, decorative marks, letters, logos or watermark. Keep all objects inside the frame, with realistic contact shadows and visibly distinct ceramic, glass, metal, paper and fabric materials.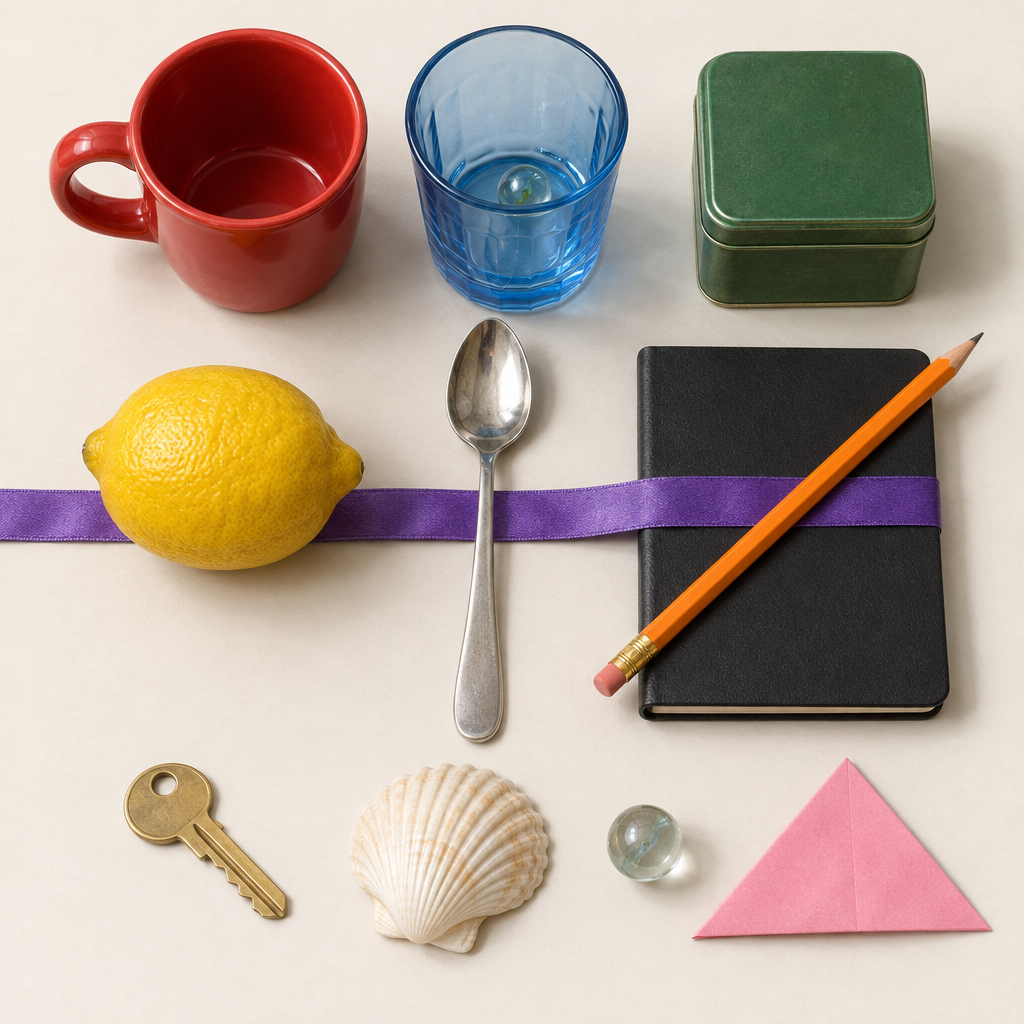
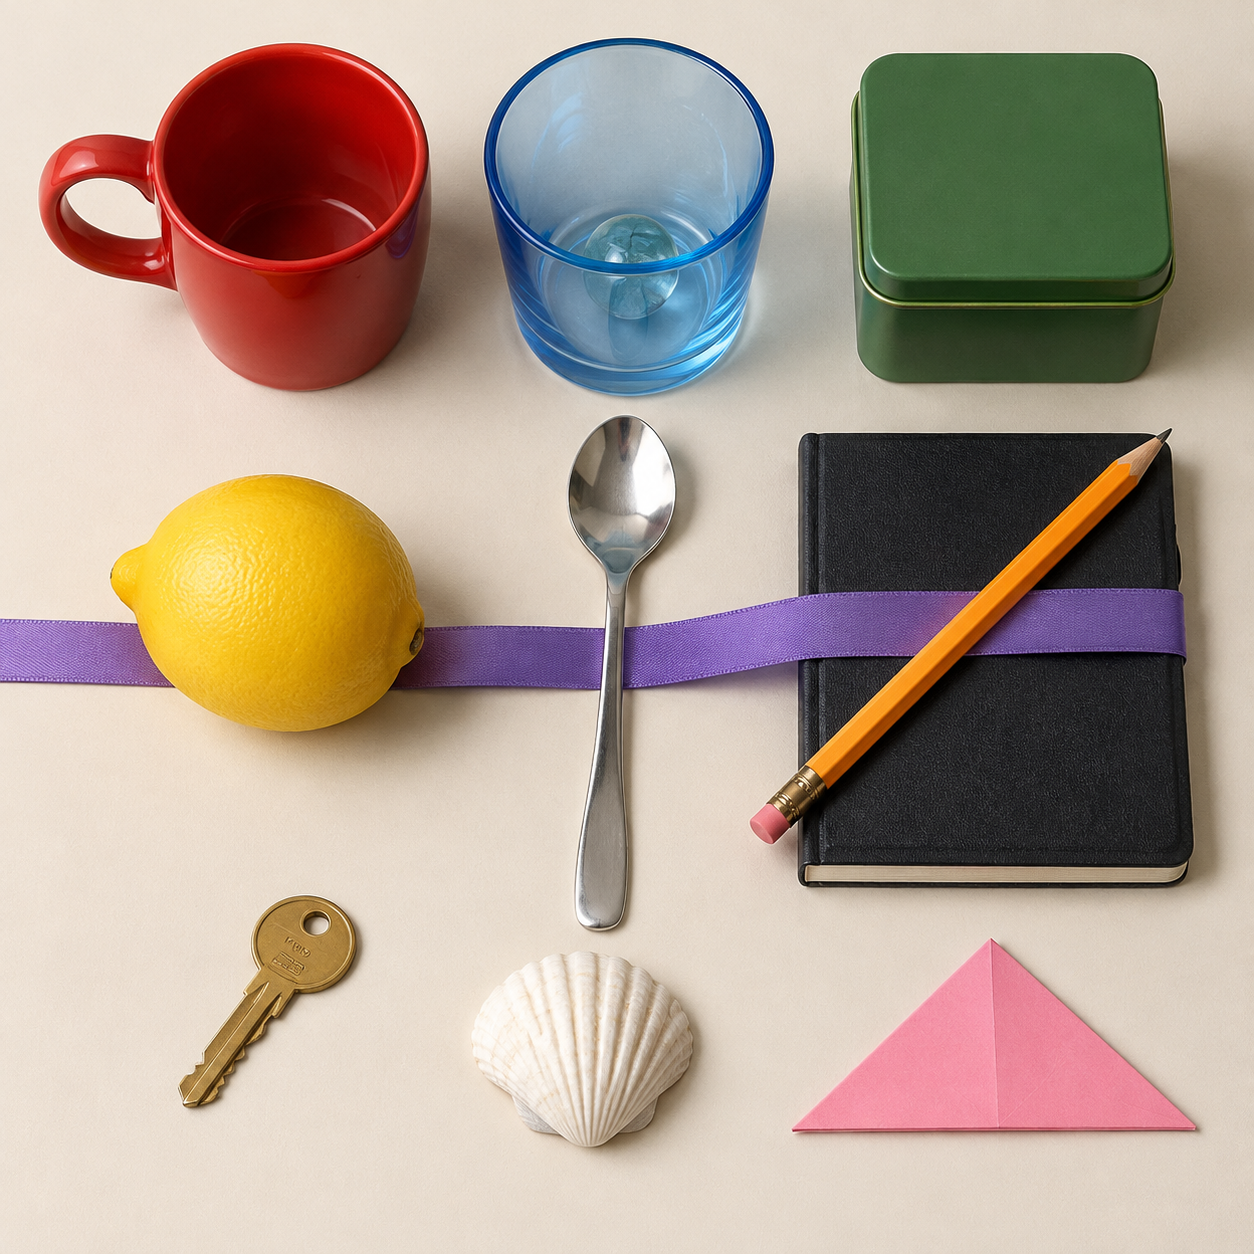
Differenza chiave: 2.6 aggiunge una seconda biglia; 2.5 mantiene dodici oggetti ma aggiunge lettere chiave. Entrambi ritagliano il nastro.
Etichette bilingui dense e instradamento dei connettori non separano i modelli sull'accuratezza in questi campioni. La natura morta affollata espone una specifica differenza di conteggio. Un output per brief non può stabilire l'affidabilità su lavori ripetuti.
GPT Image 2.6 vs 2.5 per le persone: moda, pubblicità e storyboard
Questi tre brief simulano il lavoro per un fotografo e-commerce, un direttore artistico pubblicitario e un team di preproduzione cinematografica. Abbiamo controllato i dettagli che possono forzare una revisione della produzione: costruzione degli indumenti, mani che interagiscono con gli oggetti di scena, sovrapposizioni richieste e continuità dei costumi tra le angolazioni della telecamera.
Ogni prompt originale è stato inviato una volta per ciascuna rotta del modello con le stesse impostazioni PNG 1024 × 1024 a bassa qualità richieste e senza immagini di riferimento. Tutte e sei le prime uscite sono incluse senza ritocchi. Questo testa la continuità del personaggio guidata dal prompt all'interno di una singola immagine a quattro pannelli, non la conservazione dell'identità basata su riferimenti tra richieste indipendenti.
| Attività / Metrica | GPT Image 2.6 | GPT Image 2.5 |
|---|---|---|
| Catalogo di moda Qualità | ★★★☆☆Bottoni sul lato sbagliato | ★★★☆☆Bottoni sul lato sbagliato |
| Tempo | ★★★★★20 s | ★★☆☆☆58 s |
| Output | ★☆☆☆☆1.758 token | ★★★★★199 token |
| Annuncio con tre persone Qualità | ★★★★☆Sovrapposizione corretta; pollice parzialmente nascosto | ★★★☆☆Sovrapposizione mancante; pollice parzialmente nascosto |
| Tempo | ★★★★★10 s | ★★☆☆☆24 s |
| Output | ★☆☆☆☆1.758 token | ★★★★★201 token |
| Storyboard del personaggio Qualità | ★★☆☆☆Continuità lato borsa interrotta | ★★☆☆☆Continuità lato borsa interrotta |
| Tempo | ★★★★★25 s | ★★★★★27 s |
| Output | ★★★★★1.758 token | ★★★★☆2.058 token |
Valutazioni editoriali di questi singoli output: ★★★★★ nessun problema visibile nei controlli esaminati; ★★★★☆ correzione minore; ★★★☆☆ correzione importante; ★★☆☆☆ correzione maggiore; ★☆☆☆☆ inutilizzabile. Non è un benchmark complessivo del modello. L'allineamento esatto dei pixel e la nitidezza del testo piccolo non vengono valutati.
4. E-commerce: moda a figura intera e dettaglio delle mani
Prompt esatto utilizzato per entrambi i modelli
Square professional e-commerce fashion photograph, one fictional adult female model age 30, full body head to shoes fully inside frame, neutral light gray studio background, soft even lighting, realistic skin texture. She has a short dark curly bob and wears an open rust-orange tailored blazer over a plain ivory crew-neck shirt, dark navy straight-leg trousers, and white low-top sneakers. The blazer has exactly two black front buttons on the model's right side and one flap pocket on each side. Her right hand holds the curved wooden handle of exactly one closed dark green umbrella pointing down beside her right leg; the umbrella tip touches the floor. Her left hand is raised to chest height with palm facing camera and all five fingers naturally spread and individually visible. No hand in a pocket, no jewelry, no handbag, no extra person, no text, no logo, no watermark. Natural anatomy, two arms and two legs, no merged fingers. Leave visible space around the head and both shoes. The photograph must let an online shopper inspect fabric, seams, buttons, the umbrella grip and the open palm.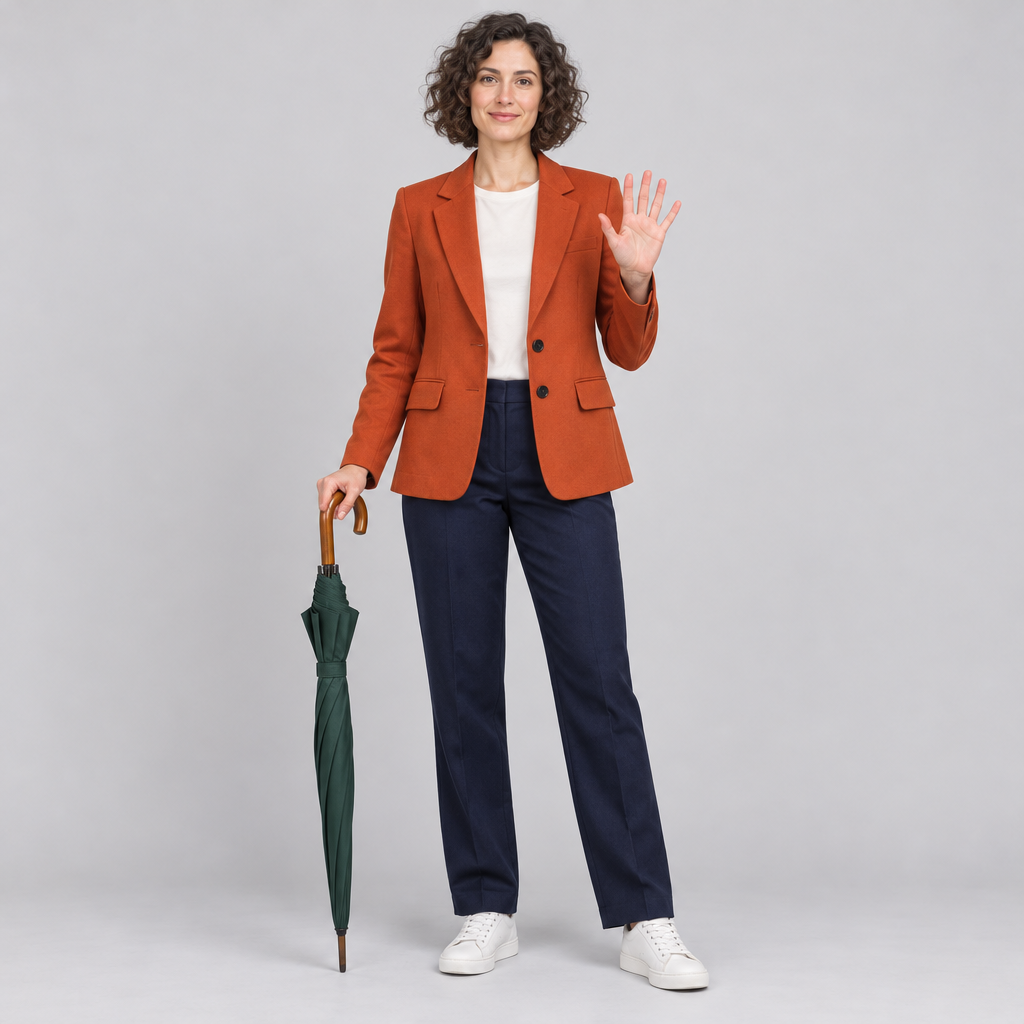
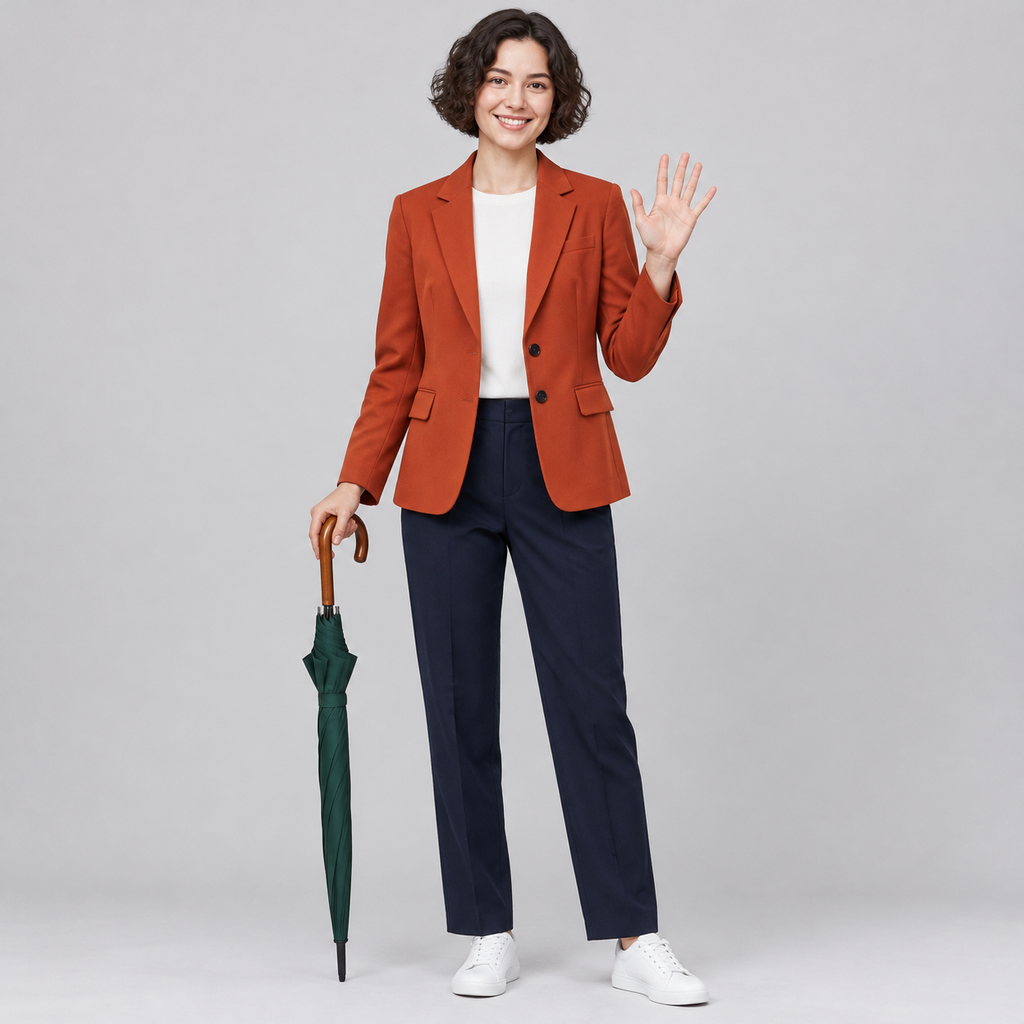
Differenza chiave: Entrambi mostrano la posa richiesta ma mettono i bottoni sul lato sbagliato. Nessuno dei due è pronto come immagine di catalogo accurata per il prodotto.
Una fotografia di modella convincente richiede ancora modifiche precise dell'immagine quando la costruzione dell'indumento differisce dal prodotto venduto. Pelle e tessuto attraenti non compensano il posizionamento errato dei bottoni.
5. Pubblicità: collaborazione a tre e occlusione
Prompt esatto utilizzato per entrambi i modelli
Square photorealistic lifestyle advertisement for an unbranded design studio. Exactly three fictional adults age 25 to 55 sit behind a rectangular light oak table, all faces and relevant hands visible. Left: a Black woman with short natural hair wearing a mustard-yellow sweater, holding exactly one red ceramic mug in both hands. Center: an East Asian man with round black glasses wearing a pale blue shirt, pointing with his right index finger at a blank cream paper sheet lying at the exact center of the table; his left hand rests flat on the table with all five fingers visible. Right: a white woman with shoulder-length auburn hair wearing a forest-green shirt, writing on that same sheet with exactly one black pencil in her right hand. The pointing finger must not touch the pencil or merge with the writer's hand. Put exactly one closed cobalt-blue notebook in the foreground, partially hiding the bottom edge of the paper but not the hands. Exactly these tabletop objects: one mug held by left person, one paper sheet, one pencil held by right person, one closed notebook. No laptops, phones, extra cups, text, logos or watermark. Coherent eye lines toward the shared paper, plausible wrists, distinct fingers, natural skin texture and soft window light. No extra or duplicated people or limbs.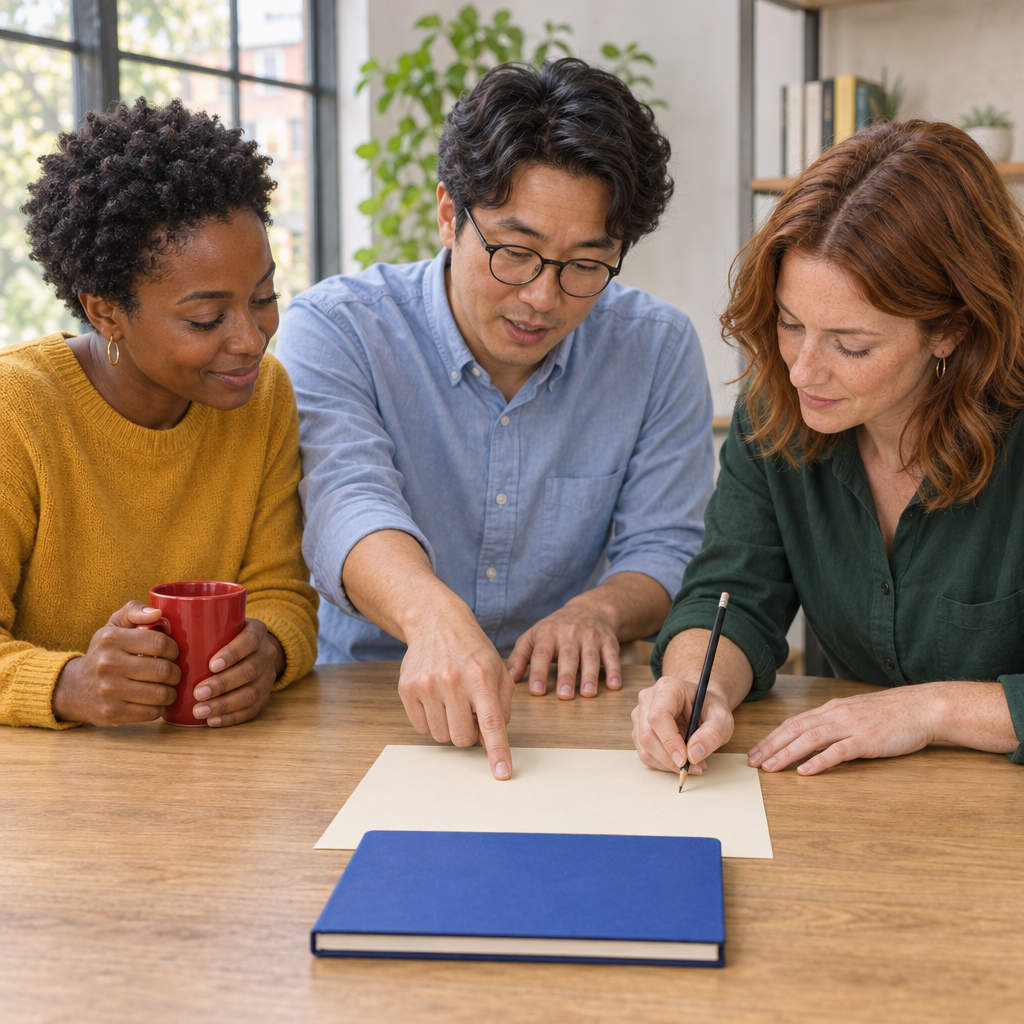
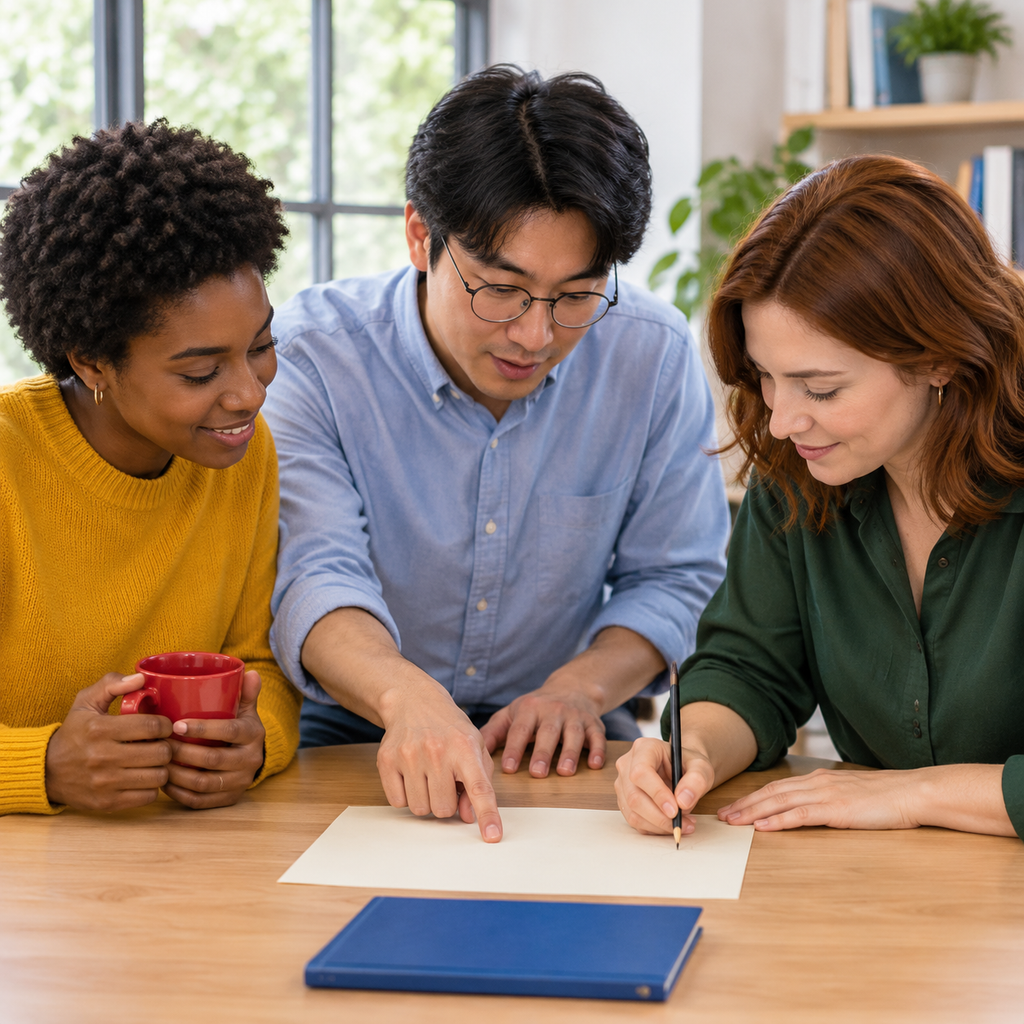
Differenza chiave: 2.6 segue la sovrapposizione del taccuino sulla carta; 2.5 lascia uno spazio. La differenza conta quando il posizionamento fa parte del brief pubblicitario.
I brief che dipendono da prodotti o persone esistenti introducono una sfida separata: combinare immagini di riferimento preservando identità e posizionamento. Questi output solo testuali non stabiliscono tale capacità.
6. Preproduzione cinematografica: continuità del personaggio in quattro pannelli
Prompt esatto utilizzato per entrambi i modelli
Create a square photorealistic cinematic storyboard, exactly four equal panels in a precise 2 by 2 grid with thin white gutters. No text, captions, letters, numbers, logos or watermark. All four panels show the SAME fictional adult woman age 35: warm brown skin, short black bob ending at jawline, one distinctive white streak over her LEFT temple, a small round silver stud in each ear, mustard-yellow raincoat with exactly three black buttons, red knitted scarf, dark charcoal trousers, and a small teal crossbody bag with strap running from her RIGHT shoulder to her LEFT hip. Consistent facial identity, costume, white streak placement, bag color and strap direction in every panel. Scene: one quiet brick train platform in soft overcast daylight. Top-left: full-body front view, she stands facing camera holding a folded cream paper ticket in her right hand, left hand at her side. Top-right: waist-up three-quarter view from her right side, she looks at the same ticket held in right hand. Bottom-left: waist-up front view, she hands the ticket with right hand to a station attendant's left hand entering only from the right edge; show no attendant face or body. Bottom-right: full-body rear three-quarter view, she walks away along the same platform, empty right hand visible; the teal bag remains on left hip and the scarf and coat remain unchanged. Exactly one main character in each panel, and the single additional entering hand only in bottom-left. Natural anatomy and coherent light. Do not mirror the character or move the white streak to the opposite temple.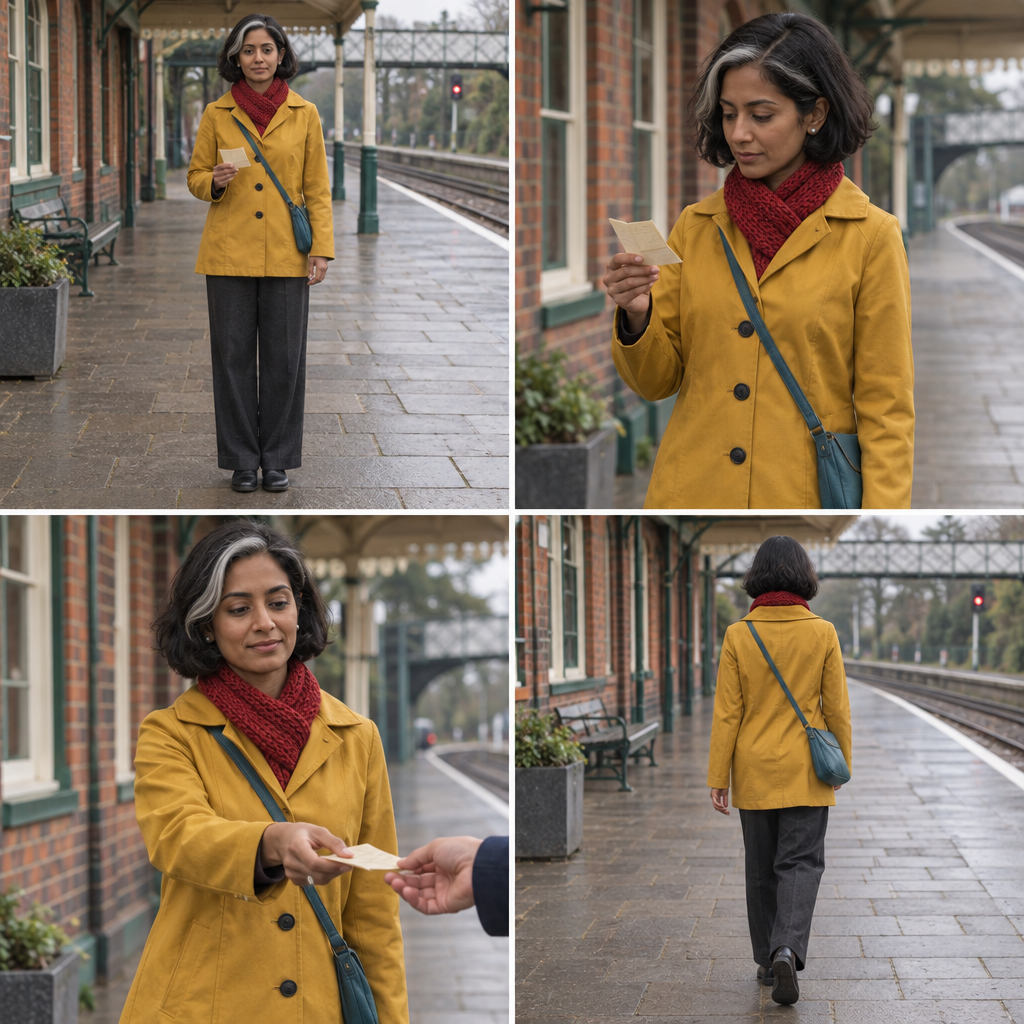
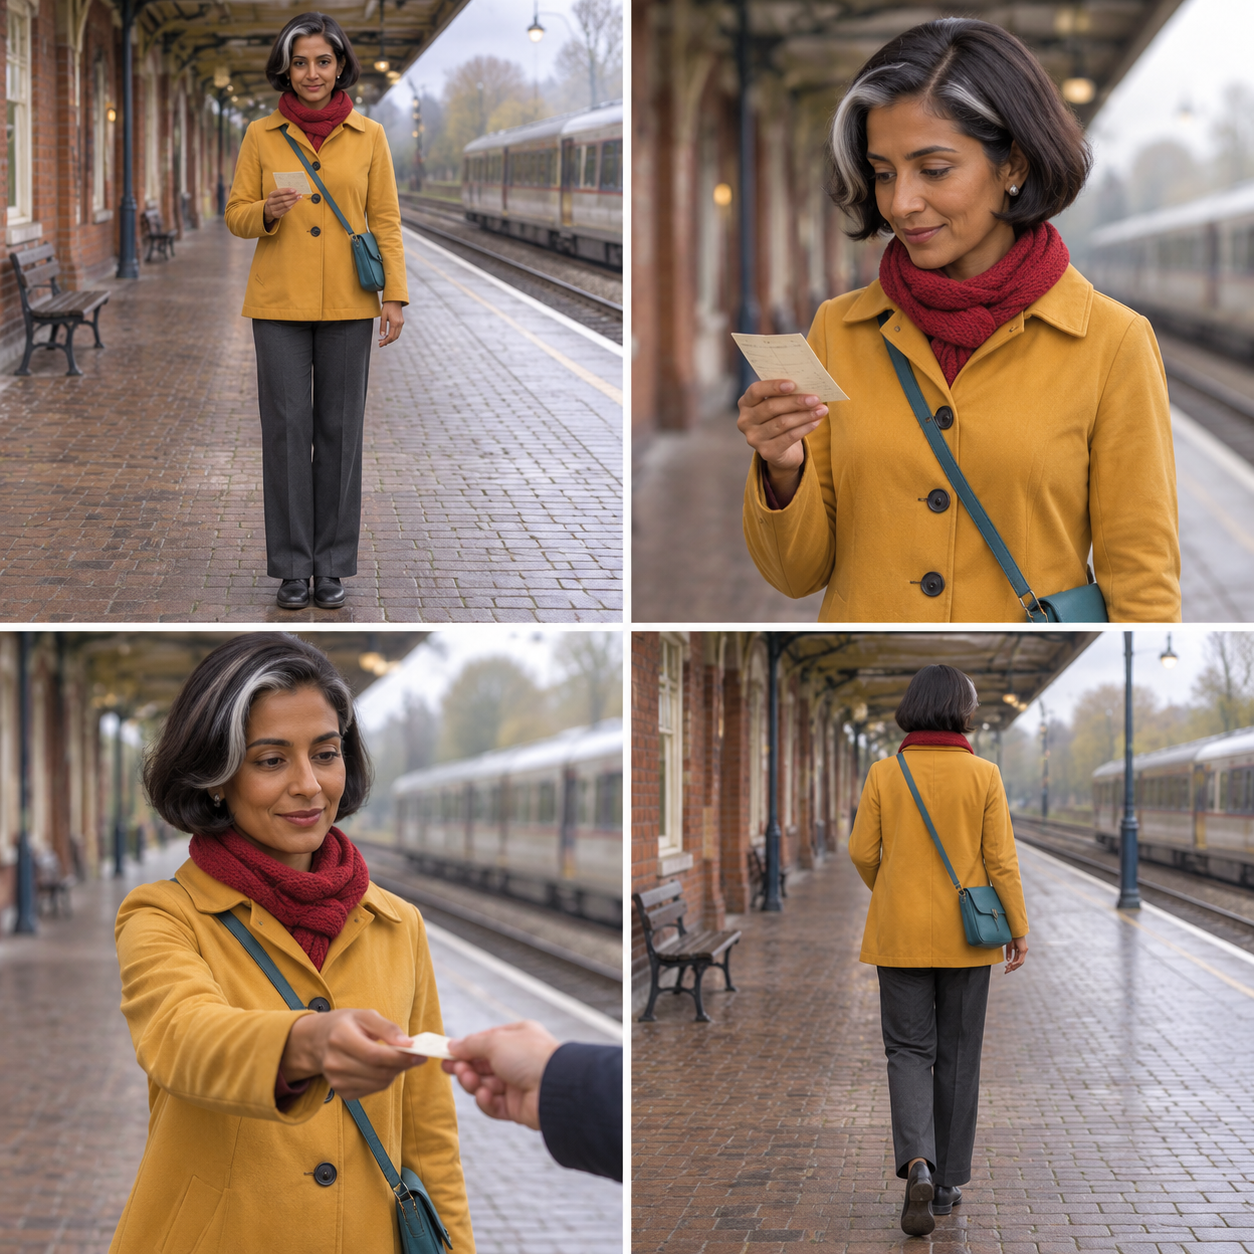
Differenza chiave: Entrambi cambiano il lato della borsa nel pannello posteriore e mancano il lato con la striscia bianca richiesto. Nessuno dei due supera la rigorosa continuità del costume.
Per un team di produzione che considera alternative a ChatGPT Images 2.5, la continuità dei personaggi ricorrenti merita un proprio controllo di accettazione piuttosto che essere dedotta da un ritratto attraente.
Una correzione localizzata può essere specificata con maschere immagine e istruzioni di modifica, ma cambiare una borsa o un indumento richiede comunque di verificare che il viso e il costume circostante rimangano intatti.
GPT Image 2.6 vs 2.5: Confronto prezzi ufficiale
Le quattro varianti ufficiali hanno le stesse tariffe token standard. GPT Image 2.6 non ha un sovrapprezzo per token elencato rispetto a 2.5; tariffe uguali non garantiscono lo stesso costo per immagine generata.
| Modello ufficiale | Input di testo / 1M | Input immagine / 1M | Output immagine / 1M |
|---|---|---|---|
| GPT Image 2.6 Sunburst | $5 | $8 | $30 |
| GPT Image 2.6 Flare | $5 | $8 | $30 |
| GPT Image 2.5 Sunburst | $5 | $8 | $30 |
| GPT Image 2.5 Flare | $5 | $8 | $30 |
USD, tariffe standard, non prezzi Batch o abbonamento GlobalGPT. Le tariffe cache sono $1,25/M di testo e $2/M di token immagine ove applicabile; il prezzo degli input in cache per 2.5 si applica allo strumento immagine di Responses, non alle richieste dirette a Images. Il costo di output è token immagine fatturabili × $30 ÷ 1.000.000; dimensioni, qualità e consumo di token specifico del modello modificano il totale. La complessità non ha costi separati. Prezzi ufficiali · Condizioni di costo e fatturazione.
GPT Image 2.6 vs 2.5: quale scegliere?
Non c'è un vincitore assoluto in questi campioni. 2.6 gestisce meglio una sovrapposizione pubblicitaria; 2.5 preserva il conteggio degli oggetti affollati. Entrambi mancano i vincoli lato indumento e continuità dello storyboard. Scegli in base agli errori che contano per il tuo lavoro e confronta le varianti esplicite Sunburst o Flare prima di stilare una classifica ufficiale dei modelli.
Fedeltà del testo, preservazione dei riferimenti e materiali realistici sono criteri separati nella scelta tra generatori di immagini AI; un numero di versione più recente non risolve ogni compromesso.
FAQ GPT Image 2.6 vs 2.5
GPT Image 2.6 è un modello completamente nuovo?
OpenAI documenta GPT Image 2.6 come una famiglia con gli ID modello Sunburst e Flare. La documentazione pubblica enfatizza i controlli del flusso di lavoro e il posizionamento del modello; questo articolo non deduce alcun cambiamento di architettura non documentato.
Quali sono gli ID modello ufficiali di GPT Image 2.6?
gpt-image-2.6-sunburst è documentato per lavori visivi dettagliati, e gpt-image-2.6-flare è documentato per iterazioni rapide.
GPT Image 2.6 costa di più di 2.5?
Le tariffe standard sono identiche per tutte e quattro le varianti Sunburst/Flare: 5 $/M per input di testo, 8 $/M per input di immagini e 30 $/M per token di output di immagini. Il costo effettivo dell'immagine può differire perché il consumo di token è diverso.
Il test ha dimostrato che 2.6 è migliore?
No. In sei brief di lavoro, 2.6 ha seguito meglio una sovrapposizione pubblicitaria, mentre 2.5 ha preservato il conteggio della natura morta affollata. Entrambi hanno mancato le istruzioni sul lato dell'indumento e sulla continuità dello storyboard. Un output per modello per brief non può stabilire una superiorità complessiva.
Sono questi i nostri prompt e le immagini generate?
Sì. Abbiamo scritto sei brief e li abbiamo inviati invariati a entrambe le route dei provider. Le dodici immagini di confronto provengono da quelle attività registrate. Non sono incluse immagini ufficiali di vetrina.
Questo articolo verifica la fatturazione nativa di OpenAI o una mappatura Sunburst/Flare dietro l'alias del provider?
No. Registra le risposte restituite dal provider; gli addebiti effettivi sull'account e la fatturazione nativa di OpenAI non sono stati verificati. La fatturazione nativa di OpenAI e la mappatura alias-modello rimangono non verificate qui.
GPT Image 2.6 vs 2.5: fonti e limiti dei test
Guida alla generazione di immagini di OpenAI — controlli 2.6, esempi e note sul flusso di lavoro.
Pagina del modello GPT Image 2.6 Sunburst — ID modello ufficiale e posizionamento.
Pagina del modello GPT Image 2.6 Flare — ID modello ufficiale e posizionamento.
Prezzi per la generazione di immagini di OpenAI — riferimento sui prezzi; nessuna classifica dei costi misurata.
Limite delle prove: questo articolo non rivendica la generazione di account OpenAI nativi, una mappatura alias-Sunburst/Flare verificata, una fatturazione OpenAI effettiva, una conservazione CDN a lungo termine o una classifica di qualità universale. Riporta solo output locali riusciti e le fonti ufficiali documentate sopra.
GPT Image 2.6 vs 2.5: Verdetto finale
Nessuna delle due strade vince in ogni compito. Usa le coppie di immagini per giudicare i vincoli richiesti dal tuo lavoro; la mappatura Sunburst/Flare non divulgata impedisce una classifica ufficiale delle varianti.