
GPT-6.1 Sol est le modèle équilibré de OpenAI destiné à la programmation complexe, à l'utilisation de l'informatique et au travail professionnel. Il conserve la fenêtre de contexte de 1 050 000 tokens et le plafond de sortie de 128 000 tokens de GPT-6 Astra, mais le tarif de l’API Standard passe à $2 par million de tokens d’entrée et à $10 par million de tokens de sortie. Cela représente un cinquième des tarifs actuels d’Astra par jeton. Le compromis est simple : Astra reste le produit phare, tandis que Sol vise à offrir suffisamment de ses capacités aux équipes qui accordent de l’importance au coût par tâche accomplie.
Ce guide fait la distinction entre ce qui Documents OpenAI pour GPT-6.1 Sol d'après les observations faites par des créateurs indépendants lors des premiers tests. Il présente également la règle de tarification « long-context », des exemples de coûts réalistes, un modèle fonctionnel d'API « Responses », ainsi qu'une méthode pratique pour choisir entre Sol, Astra, Luna et l'ancienne version GPT-6 Sol.
Qu'est-ce que GPT-6.1 Sol ?
GPT-6.1 Sol est le dernier modèle Sol de la gamme GPT-6 de OpenAI. La description officielle le présente comme un modèle destiné au codage complexe, à l'utilisation d'ordinateurs et aux tâches professionnelles, offrant des performances proches de celles d'Astra à un coût moindre. Dans la hiérarchie de la gamme, Astra est le choix le plus performant, Luna est le choix le plus économique, et Sol représente la voie intermédiaire pour les tâches suffisamment complexes pour nécessiter un raisonnement poussé, mais suffisamment fréquentes pour que le coût unitaire soit un facteur important.
L'identifiant du modèle est gpt-6.1-sol. Cette chaîne de caractères précise revêt une importance particulière dans les appels API, les journaux de test, les relevés de facturation et la configuration de déploiement. L'ancienne gpt-6-sol reste un modèle différent, même si ses prix d’entrée et de sortie non mis en cache coïncident. La page de OpenAI consacrée à l’ancien modèle redirige désormais les lecteurs vers la nouvelle version, tandis que notre Analyse de GPT-6 Sol et limites de l'API fournit la référence historique.
La raison la plus évidente de s’intéresser à cette mise à jour ne réside pas dans un simple chiffre du classement. C’est plutôt la combinaison d’une fenêtre contextuelle de taille « frontier », d’une large prise en charge des outils, de cinq niveaux d’effort de raisonnement et d’un prix qui incite à une utilisation plus généralisée qu’Astra. Un modèle légèrement moins performant, mais suffisamment abordable pour être utilisé dans tous les projets sérieux de rédaction, de révision de code ou de workflow en plusieurs étapes, peut apporter davantage de valeur qu’un modèle haut de gamme réservé à de rares occasions.
Ce positionnement doit encore être testé par rapport à vos propres tâches. OpenAI’s conseils pour la sélection d'un modèle recommande expressément de comparer Sol et Astra sur un même travail. Un workflow de documents juridiques, une refonte de référentiel, un agent de navigateur et une présentation sur tableau peuvent mettre en évidence différentes capacités. Considérez l'étiquette du modèle comme une hypothèse de départ, puis évaluez la justesse, le nombre de révisions, la latence et le coût total par résultat accepté.
Caractéristiques techniques du GPT-6.1 Sol
Le catalogue officiel des modèles énumère les entrées de type texte et image, ainsi que les sorties de type texte. L'audio et la vidéo ne sont pas des modalités d'entrée ou de sortie prises en charge par le modèle lui-même. Cette distinction est utile lors de la conception d'un produit : vous pouvez transmettre des captures d'écran, des schémas, des pages numérisées ou d'autres images, mais la transcription audio et la compréhension vidéo nécessitent un composant ou un outil distinct.
Sa capacité d’entrée maximale est inférieure à celle de la fenêtre de contexte indiquée, car la sortie et le traitement interne nécessitent de l’espace au sein du budget total. Le plafond de sortie de 128 000 tokens est généreux, mais demander une réponse très longue est rarement la meilleure approche. Les sorties longues coûtent plus cher, prennent plus de temps à vérifier et peuvent présenter des écarts. Pour la plupart des travaux logiciels, des sorties structurées plus courtes, comportant des points de contrôle, sont plus faciles à valider.
Aides au raisonnement faible, moyen, élevé, xhigh, et max; « medium » est la valeur par défaut. Le aucun et minimal Ces paramètres ne sont pas disponibles. Optez pour un niveau d'effort minimal pour les transformations courantes et n'augmentez-le que lorsque le coût en erreurs ou la complexité d'une tâche justifie l'utilisation de jetons supplémentaires et le temps supplémentaire nécessaire. L'objectif pratique est de trouver le paramètre le plus léger qui permette tout de même de réussir vos tests d'acceptation.
Les développeurs qui souhaitent comparer l'évolution historique des prix et le comportement des jetons peuvent utiliser notre Exemples de tarifs et de coûts du GPT-6 Sol à titre de référence. Le principal changement au niveau des spécifications ne concerne pas la taille du contexte, qui reste identique pour tous les modèles GPT-6 abordés ici. Il s’agit plutôt du positionnement mis à jour du « Sol » et d’une entrée mise en cache moins coûteuse.
Performances : ce que révèlent les données officielles
Selon le communiqué de lancement de OpenAI, GPT-6.1 Sol apporte des améliorations substantielles par rapport à GPT-6 Sol dans le cadre de tâches professionnelles complexes telles que l’écriture et le débogage de code, la compréhension de documents et l’exécution de workflows métier en plusieurs étapes. L’entreprise affirme que ce modèle se rapproche de GPT-6 Astra dans plusieurs évaluations, tout en étant moins coûteux. Il s’agit là d’affirmations issues d’évaluations officielles, et non d’une garantie que chaque requête donnera des résultats proches de ceux d’Astra.
Le Addendum à la fiche du système solaire GPT-6.1 Cela pose une limite importante : les évaluations ont été réalisées dans l’environnement de recherche de OpenAI ou via l’API, et la version de production ChatGPT peut présenter des différences, car les invites du système, les outils disponibles et les paramètres d’effort ne sont pas identiques. C’est pourquoi un article rigoureux doit distinguer clairement les résultats officiels des tests de performance des tests effectués par un créateur et des évaluations internes d’une entreprise.
HealthBench en est un exemple concret. Dans le tableau publié, GPT-6.1 Sol affiche des scores ajustés en fonction de la longueur de 64,2 sur HealthBench Professional, 58,5 sur HealthBench, 36,2 sur HealthBench Hard et 96,0 sur HealthBench Consensus. Les scores Astra correspondants sont respectivement de 64,7, 58,3, 36,6 et 95,5. OpenAI indique que les écarts entre ces modèles ne dépassent pas 0,5 point de pourcentage sur ces quatre évaluations.
Ce résultat corrobore l’expression “ près d’Astra ” au sein de cette famille d’évaluations. Il ne prouve toutefois pas une qualité équivalente en matière d’ingénierie logicielle, de fiabilité du navigateur ou de style de sortie. Un benchmark de santé mesure une capacité différente de celle consistant à corriger une condition de concurrence ou à coordonner des outils. Pour un examen plus approfondi du profil de test plus large du produit phare, consultez le Test et essais pratiques du GPT-6 Astra.
L'interprétation pratique la plus plausible est nuancée : GPT-6.1 Sol fait partie des candidats à privilégier pour les tâches exigeantes, en particulier lorsque le prix d'Astra risquerait d'en limiter l'utilisation. Il mérite une évaluation comparative, et non une promotion automatique. Mesurez le taux de réussite, le nombre de corrections humaines, les erreurs de l'outil, le nombre de tokens générés et le temps nécessaire pour obtenir un résultat acceptable. Ces indicateurs transforment la comparaison des modèles en une décision commerciale.
Programmation : ce que GPT-6.1 Sol est capable de faire
GPT-6.1 Sol dispose des fonctionnalités essentielles attendues d’un modèle de programmation moderne : traitement en continu, sorties structurées, appel de fonctions, recherche de fichiers, saisie d’images, recherche sur le Web et mise en cache des invites. Via l’API Responses, OpenAI propose également un interpréteur de code, un shell hébergé, l’application de correctifs, des compétences, l’utilisation d’un ordinateur, le MCP et la recherche d’outils. Cela rend le modèle adapté aux workflows qui inspectent des fichiers, proposent des modifications, exécutent des commandes et renvoient des résultats vérifiés par machine.
La prise en charge des fonctionnalités ne signifie pas que chaque environnement expose automatiquement tous les outils. C'est toujours votre application qui décide quels outils existent, quelles autorisations leur sont accordées, comment les résultats sont renvoyés au modèle et quelles actions nécessitent une confirmation. La fonctionnalité « Chat Completions » fonctionne avec GPT-6.1 Sol sans appel d'outil, tandis que OpenAI redirige les applications utilisant des outils vers « Responses ». Les nouveaux systèmes agentiques devraient considérer cette limite de l'API comme un choix architectural, et non comme une simple différence syntaxique.
Au moment de la publication, le modèle exact n'était pas indiqué dans le catalogue de discussion du site de test ; ce guide ne prétend donc pas établir une nouvelle référence interne pour les quatre tâches de codage prévues. L'évaluation du codage repose sur des données officielles de performances et sur des exécutions publiques identifiées. Cela s'avère plus utile que de remplacer discrètement Astra ou l'ancien Sol et d'associer un nom de modèle erroné au résultat.
Une évaluation rigoureuse doit inclure un débogage accompagné de tests de régression, une fonctionnalité multi-fichiers bien délimitée, un audit de sécurité et une décision d'ingénierie respectant les contraintes du schéma. Ces tâches ne se limitent pas à tester la génération de code. Elles permettent de vérifier si le modèle préserve une API, prend en compte les cas limites, respecte les contraintes de sortie et indique ce qu’il n’a pas pu vérifier. Notre Guide des meilleurs modèles d'IA pour la programmation en 2026 explique pourquoi le meilleur choix varie en fonction du flux de travail.
Identifiez le plus petit défaut, préservez l'API et ajoutez des tests exécutables.
Respecter la concurrence, l'ordre d'exécution, la validation et le comportement en cas d'échec.
Hiérarchiser les vecteurs d'exploitation, proposer un correctif minimal et éviter les allégations infondées concernant les cadres de référence.
Lorsque vous exécutez une commande comme celle-ci, évaluez le résultat de manière systématique. La valeur zéro est-elle conservée ? Les doublons sont-ils supprimés ? Le tri numérique est-il correct ? Les tests s'exécutent-ils avec node --test? Une explication bien formulée ne saurait compenser une affirmation erronée. Ce principe s'applique également au travail sur les dépôts : définissez les conditions d'acceptation avant de choisir le modèle, puis examinez le correctif plutôt que de vous fier à la qualité rédactionnelle.
Tarifs du GPT-6.1 Sol
Le page officielle des tarifs de l'API Mesure les tarifs GPT-6.1 Sol par million de jetons. L'entrée coûte $2, l'entrée mise en cache coûte $0,10, les écritures dans le cache coûtent $2,50 et la sortie coûte $10. L'entrée mise en cache représente donc 5% du taux d'entrée non mise en cache, tandis que l'écriture d'un nouveau contenu dans le cache coûte 1,25 fois le coût d'une entrée ordinaire. Les frais spécifiques à l'outil peuvent être ajoutés séparément ; le calcul des jetons ne représente donc qu'une partie du coût global d'une charge de travail impliquant l'utilisation d'un outil.
Le détail le plus important concernant la tarification est le seuil de 272 000. Dès que le volume d'entrée dépasse 272 000 jetons, la requête dans son ensemble passe à un débit d'entrée et de mise en cache deux fois plus élevé, et à un débit de sortie 1,5 fois plus élevé. Il ne s'agit pas d'une surtaxe marginale appliquée uniquement aux jetons dépassant ce seuil. Les applications qui se situent régulièrement près de cette limite devraient compter le nombre de jetons avant l'envoi et envisager le fractionnement, la récupération ou la compaction.
Le mode « Fast » double les prix « Standard ». Les modes « Batch » et « Flex » réduisent les tarifs « Standard » de 50%, tandis que le traitement régional ajoute une majoration de 10% lorsqu'il est disponible. Ces modes répondent à des besoins différents : le mode « Fast » compense la latence, le mode « Batch » privilégie le coût au détriment de l’immédiateté, le mode « Flex » privilégie le coût au détriment de la prévisibilité de la planification, et le traitement régional répond aux besoins liés à l’emplacement des données. Ne comparez pas leurs prix sans tenir compte de leurs contraintes opérationnelles.
Les tarifs standard d'Astra s'élèvent à $10 en entrée et $50 en sortie par million de jetons, soit exactement cinq fois les tarifs de référence de Sol. Le Tarifs et limites de jetons de l'API GPT-6 Astra Ce guide examine cette prime plus en détail. Sol et la version précédente, GPT-6 Sol, partagent les mêmes prix d'entrée et de sortie non mis en cache, mais GPT-6.1 Sol réduit la quantité d'entrées mises en cache, qui passe de $0,20 à $0,10 par million de jetons.
Exemples de coûts réels
Les tarifs des jetons sont plus faciles à évaluer lorsqu'ils sont convertis en requêtes complètes. Les exemples ci-dessous se basent sur un traitement standard, sans frais d'appel d'outil, sans majoration régionale et sans données d'entrée mises en cache, sauf indication contraire. La longueur réelle de la sortie influe souvent davantage sur la facture que ne le prévoient les développeurs, car la sortie coûte cinq fois plus cher que les données d'entrée ordinaires sur GPT-6.1 Sol.
Pour la révision du code comportant 100 000 lignes d'entrée et 5 000 lignes de sortie, les coûts d'entrée s'élèvent à $0,20 et ceux de sortie à $0,05, ce qui donne une estimation de $0,25. Si l'intégralité des 100 000 entrées est mise en cache, la partie relative aux entrées tombe à $0,01 et le total passe à $0,06. Si l’application doit d’abord écrire ce préfixe de 100 000 dans le cache, la partie relative à l’écriture dans le cache s’élève à 1 TP41T0,25 avant la sortie.
L'exemple avec 300 000 entrées dépasse le seuil. Les entrées sont facturées au tarif effectif de $4 par million ; ainsi, 300 000 entrées coûtent $1,20. Les sorties sont facturées au tarif effectif de 1 TP41T15 par million ; ainsi, 10 000 coûtent 1 TP41T0,15. Le total s'élève à 1 TP41T1,35. Une requête dépassant légèrement le seuil peut donc coûter bien plus cher qu'une autre se situant juste en dessous, même avant la prise en compte des outils.
Les modes « Batch » ou « Flex » réduiraient de moitié le total « Standard » éligible, tandis que le mode « Fast » le doublerait. Dans le premier exemple, cela correspondrait à environ $0,125 en mode « Batch » ou « Flex » et à $0,50 en mode « Fast ». Les équipes qui utilisent encore d'anciens modèles GPT-5.6 peuvent comparer ces hypothèses avec nos Tarification GPT-5.6 et crédits Codex détail.
Comment utiliser GPT-6.1 Sol
La méthode la plus simple pour les développeurs est l'API Responses. Installez la dernière version du SDK OpenAI, fournissez la clé API via votre environnement, puis configurez modèle à gpt-6.1-sol. Le guide officiel de génération de textes recommande l'utilisation de « Responses » pour les requêtes directes vers le modèle, et la page du modèle l'exige pour l'appel des outils.
1. Commencez par une requête API Responses simple
Veillez à ce que la première requête reste simple. Vérifiez que l'identifiant exact du modèle est disponible pour votre projet, enregistrez les champs « modèle » et « utilisation » renvoyés, et stockez suffisamment de métadonnées pour pouvoir reproduire l'exécution. Ne commencez pas par une chaîne d'outils trop complexe. Une requête simple permet de distinguer les problèmes d'accès au modèle des problèmes liés à la définition des outils, aux autorisations et à l'orchestration.
2. Ajouter des outils uniquement via l'API Responses
Lorsque le workflow nécessite une recherche de fichiers, une recherche sur le Web, l'exécution de code, un accès au shell, l'utilisation d'un ordinateur, MCP ou des fonctions personnalisées, définissez l'ensemble d'outils le plus restreint possible. Limitez la portée des fichiers et du réseau, validez les arguments des outils et déterminez quelles actions nécessitent une confirmation humaine. Le modèle peut proposer et appeler des outils, mais votre application reste responsable de leur exécution et de l'application des autorisations.
3. Adapter l'effort de raisonnement en fonction d'une évaluation
Commencez par le niveau « moyen », qui est le réglage par défaut. Exécutez un ensemble d'évaluation représentatif, puis comparez les niveaux « faible », « élevé » ou « très élevé » en fonction du taux d'acceptation, du nombre de tokens générés, de la latence et du nombre de révisions. Le niveau « effort maximal » peut s'avérer utile pour les tâches les plus difficiles, mais son utilisation systématique risque d'annuler l'avantage en termes de coût qui a fait l'attrait de Sol. Conservez le réglage le plus léger qui permette d'obtenir des résultats fiables.
4. Utilisez GlobalGPT pour une comparaison interactive
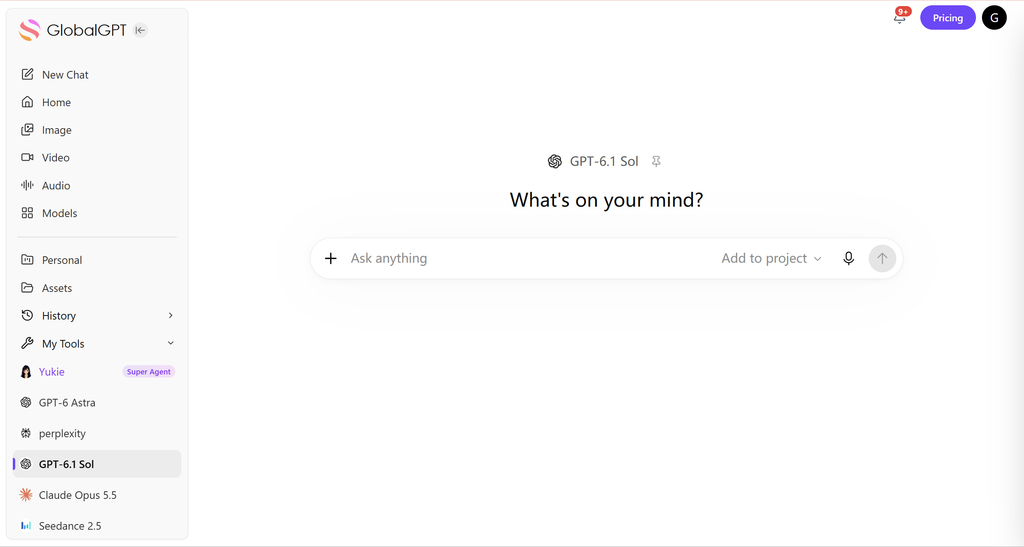
Pour les exercices interactifs, ouvrez L'espace de travail multimodèle de GlobalGPT et sélectionnez « GPT-6.1 Sol » lorsqu'il apparaît dans le menu de sélection de votre compte. Cette méthode est pratique pour comparer des réponses sans avoir à gérer plusieurs onglets ni abonnements distincts. Elle ne remplace pas les contrôles de déploiement de l'API, l'automatisation du référentiel, Codex ni un IDE. Notre guide sur Choix des modèles ChatGPT pour le codage aborde ces différences de flux de travail.
GPT-6.1 Sol vs GPT-6 Sol, Astra et Luna
Les quatre modèles comparés ici acceptent du texte et des images, génèrent du texte et disposent d'une fenêtre de contexte de 1 050 000 tokens avec une sortie maximale de 128 000 tokens. Les différences significatives concernent la position, le prix, la date limite, les paramètres de raisonnement et le niveau de qualité observé lors d'une tâche réelle. Le tableau utilise les prix officiels actuels des tokens Standard, vérifiés le 1er octobre 2026.
| Modèle | Meilleure adéquation | Entrée / 1M | En cache / 1 Mo | Sortie / 1M | Seuil |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Travaux complexes avec maîtrise des coûts | $2 | $0.10 | $10 | 30 avril 2026 |
| GPT-6 Astra | Un travail très exigeant où la qualité prime | $10 | $1 | $50 | 30 avril 2026 |
| GPT-6 Sol | Anciennes intégrations Sol existantes | $2 | $0.20 | $10 | 20 avril 2026 |
| GPT-6 Luna | Tâches ciblées et à fort volume | $0.10 | $0.01 | $0.50 | 18 mai 2026 |
Optez pour Astra lorsque la tâche est suffisamment difficile pour qu’un léger gain de qualité permette d’éviter des retouches manuelles coûteuses. Optez pour GPT-6.1 Sol lorsque le travail reste complexe mais fréquent, en particulier si la réduction liée à la mise en cache des entrées s’avère utile. Optez pour Luna lorsque le volume et la latence sont les facteurs prépondérants et que la tâche est clairement définie. Ne conservez l’ancienne version de Sol que lorsque le risque lié à la migration, les évaluations existantes ou les travaux de compatibilité rendent un changement immédiat peu intéressant.
L'écart de prix de cinq fois entre Sol et Astra est important, mais le prix par jeton n'est pas synonyme de prix par résultat accepté. Un modèle plus performant peut utiliser moins de jetons de sortie, faire appel à moins d’outils ou nécessiter moins de révisions. À l’inverse, Sol peut l’emporter même avec une révision supplémentaire si le prix unitaire d’Astra compense largement cette différence. Il convient de comparer les traces complètes des tâches plutôt que de multiplier la longueur d’une seule invite.
Les lecteurs qui se demandent si le passage à la version « phare » en vaut la peine peuvent utiliser le Comparaison entre le GPT-6 Astra et le GPT-5.6 Sol pour replacer cela dans le contexte des niveaux précédents. Pour la branche la moins coûteuse de la famille actuelle, la Avis sur le GPT-6 Luna et ses meilleures utilisations indique les limites de l'API concernées et l'adéquation avec la charge de travail.
Ce qu'en disent les critiques
OpenAI a présenté GPT-6.1 Sol lors de son discours d’ouverture du DevDay du 29 septembre 2026, parallèlement à d’autres lancements de produits. Cette vidéo officielle précise la date de lancement et le positionnement du produit ; elle ne constitue pas une preuve indépendante. Les réactions externes les plus pertinentes proviennent des créateurs qui exposent une tâche, un ensemble de comparaison, une méthode de calcul des coûts et les échecs rencontrés, plutôt que de se contenter de reprendre le discours officiel de lancement.
Est-ce qu'il sait programmer ? a fait état d'un exécution de Sol nettement moins coûteuse et plus rapide lors d'un test comparatif en trois phases entre Blender et Godot, mais a indiqué que la qualité du jeu s'était dégradée au fil des phases.
Matt Johnston a indiqué un score pondéré de 96 et un coût de la suite de tests de $2,63 pour sa configuration à neuf tests, tout en mentionnant clairement l'échec de la tâche « pingouin ».
Duncan Rogoff a comparé Sol à Sonnet 5.5 sur six versions et a suivi le temps, les jetons et le coût final.
En La vidéo en trois manches de ’ Can It Code ? », les tâches sont passées d'un kit de donjon « low-poly » réalisé sous Blender à des personnages modélisés et animés, puis à un jeu jouable sous Godot. Le créateur a estimé que Sol avait nécessité $29,17 et 7 heures 5 minutes sur l’ensemble des manches, un temps bien inférieur à celui des tests de comparaison, mais il a jugé le jeu final moins agréable et a déclaré que Sol s’était dégradé à chaque manche. La conclusion porte sur le coût et la rapidité, avec une mise en garde quant à la qualité, et non sur un classement global.
Bilan des neuf tests de Matt Johnston Il indique un score pondéré de 96, à égalité avec Sonnet 5.5 dans son tableau Stonelabs, et un coût global de $2,63, contre environ $14 pour Astra et $12 pour Opus 5.5. Il souligne également un échec concernant la tâche « pingouin ». Ces chiffres relèvent de sa conception de référence et de sa comptabilité analytique ; ils devraient être reproduits avant d’être utilisés pour les achats.
Comparaison des six versions de Duncan Rogoff couvre les pages d'atterrissage, les jeux 3D sur navigateur, les scènes Blender, les vidéos explicatives interactives et les présentations destinées aux investisseurs. La description publique indique que le test mesure le temps de compilation, l'utilisation des jetons et le coût final. En attendant l'examen complet des résultats visibles, ce guide utilise la vidéo comme illustration d'une méthode de comparaison pratique, et non comme preuve de la supériorité d'un modèle par rapport à l'autre.
Ces premières critiques s'accordent sur une question pertinente : le prix modique de Sol tient-il la route face à un projet abouti ? Leurs réponses varient en fonction de la tâche. Un créateur a constaté un excellent rapport coût-efficacité, mais une qualité finale du jeu moins bonne ; un autre a fait état d'un score élevé et d'un coût de la suite réduit ; un troisième a conçu un jeu de confrontation à grande échelle. Cette diversité est plus révélatrice qu'une phrase de synthèse exprimant un consensus.
À qui s'adresse GPT-6.1 Sol ?
GPT-6.1 Sol convient aux équipes qui disposent déjà d’un travail concret et d’un cycle d’évaluation. Il s’avère particulièrement intéressant lorsque le même contexte volumineux est réutilisé grâce à la mise en cache des prompts, lorsqu’un déploiement d’Astra serait trop coûteux à mettre à l’échelle, ou lorsque Luna n’offre pas suffisamment de profondeur pour la tâche. Ce modèle s'avère moins intéressant lorsqu'une tâche d'extraction ou de classification légère fonctionne déjà de manière fiable sur un niveau de service moins coûteux.
- Codage à l'échelle du référentiel
- Livrables professionnels complexes
- Analyse de contexte étendu avec mise en cache
- Flux de travail utilisant des outils avec des évaluations
- Décisions critiques pour la sécurité
- Tâches pouvant entraîner des erreurs coûteuses
- Travaux à proximité du seuil des 272 000
- Flux sensibles à la latence
- Étiquetage simple
- Transformations déterministes courtes
- Extraction à haut volume et à faible risque
- Tâches déjà résolues par Luna
Les équipes logicielles devraient envisager d'utiliser Sol lorsqu'elles ont besoin d'un modèle pour effectuer des raisonnements sur plusieurs fichiers, générer des tests, examiner des problèmes de sécurité ou exploiter des outils sous supervision. Les analystes peuvent l'utiliser pour la synthèse de plusieurs documents et la production de livrables structurés. Les équipes opérationnelles peuvent s'en servir pour des workflows combinant données, règles et contexte métier. Dans tous les cas, le workflow nécessite des critères d'acceptation explicites et une étape de vérification, qu'elle soit humaine ou automatisée.
Les utilisateurs individuels et les petites équipes peuvent préférer disposer d'un espace de travail interactif multimodèle avant de mettre en place une intégration via une API. Cela permet de comparer concrètement Sol et Astra sans avoir à se prononcer sur l'architecture de l'application. Si vous hésitez encore entre différents fournisseurs et modalités, consultez notre guide sur Choisir un modèle d'IA en fonction de la tâche, des outils et du coût permet d'obtenir une liste de présélection plus large.
Limites et modes de défaillance
Une fenêtre contextuelle d’un million de tokens, c’est une capacité, pas une mémoire parfaite. Des instructions importantes peuvent tout de même être noyées parmi des documents bruyants, des règles redondantes ou des éléments contradictoires. Structurez les entrées longues, identifiez les sources faisant autorité et demandez au modèle de citer le fichier ou le passage à l’origine des conclusions importantes. La récupération et la compression peuvent s’avérer plus efficaces que d’envoyer l’intégralité des données à chaque itération.
Le pas de tarification basé sur le contexte étendu constitue un deuxième risque. Une requête comportant 273 000 jetons d’entrée est facturée au tarif le plus élevé applicable à l’intégralité de la requête, et non uniquement aux mille derniers jetons. Cela peut entraîner des factures inattendues dans les applications qui construisent le contexte de manière dynamique. Il convient d’ajouter un comptage des jetons et des contrôles de budget avant la requête, et d’enregistrer quels documents ont fait dépasser la limite.
L'utilisation d'outils élargit les capacités et la surface d'attaque. Considérez les pages Web, les fichiers récupérés et les résultats générés par les outils comme des données non fiables. Vérifiez les arguments des fonctions, isolez l'exécution du code, limitez les chemins d'accès aux fichiers et l'accès au réseau, et exigez une confirmation pour les actions à fort impact. Le fait que le modèle prenne en charge l'utilisation d'un shell hébergé ou d'un ordinateur ne justifie pas l'octroi d'autorisations étendues.
Enfin, les premiers tests réalisés par les créateurs peuvent être instructifs sans pour autant être définitifs. Des consignes, des outils, des structures d’aide, des limites de temps et des grilles d’évaluation différents peuvent renverser la situation au profit d’un candidat qui semblait pourtant gagnant. Utilisez les tests publics pour concevoir votre propre évaluation, et non pour vous en passer. Un modèle qui excelle dans la création d’un jeu visuel peut tout de même échouer lors de votre plan de migration, et l’inverse est tout aussi possible.
Questions fréquemment posées
Ces réponses résument les informations officielles relatives à l'API ainsi que les éléments pratiques à prendre en compte pour la prise de décision, abordés ci-dessus.
Qu'est-ce que GPT-6.1 Sol ?
GPT-6.1 Sol est un modèle de raisonnement OpenAI destiné au codage complexe, à l'utilisation de l'informatique et aux activités professionnelles. La formule OpenAI le situe entre le niveau Luna, économique, et le niveau Astra, haut de gamme, en offrant des capacités proches de celles d'Astra à un tarif API inférieur.
Combien coûte GPT-6.1 Sol ?
La tarification standard de l'API est de $2 par million de jetons d'entrée, $0,10 par million de jetons d'entrée mis en cache, $2,50 par million de jetons d'écriture en cache et $10 par million de jetons de sortie. Les invites longues, le mode rapide, le traitement régional, le traitement par lots et le mode Flex peuvent modifier le tarif effectif.
Qu'est-ce que la fenêtre de contexte de GPT-6.1 Sol ?
OpenAI présente une fenêtre de contexte de 1 050 000 tokens, une entrée maximale de 922 000 tokens et jusqu’à 128 000 tokens en sortie. Une fenêtre de grande taille permet au modèle d’analyser un volume important de données, mais elle ne garantit pas un rappel parfait et ne rend pas nécessairement chaque requête volumineuse rentable.
Le GPT-6.1 Sol est-il adapté à la programmation ?
Il est conçu pour le codage complexe et prend en charge les sorties structurées, l'appel de fonctions, l'interpréteur de code, le shell hébergé, l'application de correctifs, les compétences, MCP et d'autres outils via l'API Responses. Les équipes de production doivent toutefois continuer à effectuer des tests spécifiques au référentiel avant de modifier un workflow critique.
Dois-je utiliser le GPT-6.1 Sol ou le GPT-6 Astra ?
Optez pour Sol lorsque le coût est un facteur déterminant et que votre propre évaluation montre que cette solution répond aux critères de qualité requis. Optez pour Astra pour les tâches les plus exigeantes, lorsque la qualité marginale justifie un tarif standard cinq fois plus élevé. Testez les deux solutions sur les mêmes tâches représentatives avant de prendre votre décision.
Que se passe-t-il lorsqu'une requête dépasse les 272 000 tokens d'entrée ?
Selon OpenAI, la requête complète est facturée au double des taux normaux d'entrée et de mise en cache, et à 1,5 fois le taux normal de sortie dès que le volume d'entrée dépasse 272 000 tokens. Ce changement radical peut s'avérer plus déterminant que la taille annoncée de la fenêtre contextuelle dans les applications traitant des documents volumineux.
GPT-6.1 Sol prend-il en charge l'API « Chat Completions » ?
Oui, la fonctionnalité « Chat Completions » est prise en charge pour les requêtes ne faisant pas appel à des outils. La version OpenAI oriente les développeurs vers l'API « Responses » pour l'appel d'outils ; par conséquent, les nouvelles applications de type « agentic » ou utilisant des outils devraient normalement commencer par l'API « Responses » plutôt que de s'appuyer sur l'ancienne interface.
GPT-6.1 Sol peut-il accepter des images ?
Oui. La page officielle du modèle mentionne la prise en charge de l'entrée de texte et d'images, ainsi que la sortie de texte. L'audio et la vidéo ne font pas partie des modalités prises en charge par le modèle ; toutefois, une application peut recourir à d'autres services ou outils associés au modèle lorsque ces types de médias sont nécessaires.
Comment puis-je utiliser GPT-6.1 Sol sur GlobalGPT ?
Ouvrez GlobalGPT, lancez une nouvelle conversation, puis sélectionnez « GPT-6.1 Sol » lorsqu'il apparaît dans la liste des modèles disponibles pour votre compte. GlobalGPT est un espace de travail multimodèle pratique ; les clés API, les contrôles de déploiement et l'automatisation des référentiels restent des flux de travail distincts pour les développeurs.
Verdict final
GPT-6.1 Sol est l’option GPT-6 la plus intéressante pour les acheteurs qui ont besoin de capacités de raisonnement et de programmation avancées, mais qui ne peuvent pas justifier l’utilisation d’Astra à chaque exécution. Il offre les mêmes limites en termes de contexte et de volume de sortie qu’Astra, utilise la même date de coupure des connaissances (30 avril 2026) et coûte cinq fois moins cher par token d’entrée et de sortie non mis en cache aux tarifs Standard. La réduction accordée pour les entrées mises en cache est également plus importante que celle de la version précédente de GPT-6 Sol.
Ce modèle n’est pas forcément le meilleur choix. Luna reste nettement moins cher pour les tâches ciblées, et Astra peut encore permettre de réduire le nombre de révisions sur les tâches les plus complexes. La comparaison pertinente porte sur le coût total par résultat accepté, mesuré avec la même consigne, les mêmes outils, les mêmes données et les mêmes règles de notation. Au-delà de 272 000 tokens d’entrée, tenez compte du multiplicateur de prix avant de prendre votre décision.
Ouvrez GlobalGPT, sélectionnez « GPT-6.1 Sol » lorsqu’il est disponible, puis comparez-le à « Astra » ou « Luna » à l’aide d’une tâche réelle et d’une liste de contrôle de réception.
Ouvert GlobalGPTPour le déploiement de l'API, commencez par la page officielle du modèle et une petite requête à l'API « Responses ». Pour une comparaison interactive, utilisez la route « multi-modèle » ci-dessus. Dans tous les cas, conservez les résultats, l'historique d'utilisation, les paramètres et les échecs. La promesse de GPT-6.1 Sol ne se limite pas à des jetons moins chers ; elle offre une meilleure opportunité d’exécuter des raisonnements performants suffisamment souvent pour qu’ils s’intègrent au flux de travail.









