Le choix des meilleurs modèles d’IA à retenir dépend du travail que vous devez accomplir. Pour le texte, le codage et le raisonnement, comparez les familles actuelles GPT, Claude, Gemini, Grok, DeepSeek et Qwen. Pour les images, envisagez les modèles GPT Image, Nano Banana et Midjourney ; pour la vidéo, commencez par les fonctionnalités de génération et de montage dont votre projet a besoin. Un assistant de recherche a également besoin de fonctions de recherche et de sources fiables, et pas seulement d’un modèle linguistique puissant.
Commencez par votre tâche récurrente la plus difficile, puis choisissez la solution la moins coûteuse qui permette de la mener à bien de manière fiable. Un modèle capable de rédiger un paragraphe convaincant peut tout de même mal interpréter un document, inventer une référence ou générer du code défaillant. Les recommandations ci-dessous s'appuient sur la documentation officielle des modèles et sur des critères de sélection pratiques ; il s'agit d'une liste restreinte classée par tâche, et non d'un classement par notes.
GlobalGPT réunit plusieurs familles de modèles et des fonctionnalités d'IA au sein d'un seul abonnement, ce qui vous permet de passer de la recherche et de la rédaction à la création d'images et de vidéos au sein d'un même espace de travail. C'est une option pratique et économique lorsque votre semaine comprend plusieurs types de tâches et que vous souhaitez réduire le nombre d'abonnements distincts à gérer.
Répertoires officiels des modèles consultés le 15 septembre 2026. Les exemples historiques sont identifiés par leur modèle d'origine.
Quel modèle d'IA devriez-vous choisir en premier ?
Une liste pratique classée par tâche
| Votre mission | Candidats à comparer | Quels sont les critères qui devraient déterminer ce choix ? |
|---|---|---|
| Texte et programmation au quotidien | GPT-5.6 Terra ; Claude Sonnet 5 ; Gemini 3,8 Flash | Le respect des consignes, la pertinence des résultats et le niveau d'intervention nécessaire. |
| Raisonnement complexe ou codage étendu | GPT-6 Astra ; Claude Opus 5 ou Fable 5.1 ; Qwen3.8 | Réussissez à résoudre vos dossiers les plus complexes, grâce aux outils et aux autorisations nécessaires. |
| Documents volumineux et données mixtes | Aperçu de la version 3.1 Pro de Gemini ; modèles GPT et Claude actuels | Prise en charge des fichiers, recherche précise et références aux sources — et pas seulement la capacité. |
| Nouvelles recherches | Un assistant doté d'une fonctionnalité de recherche ; Perplexity ; Grok avec des outils de recherche | La qualité des sources, les dates de publication et la pertinence des références pour étayer la réponse. |
| Travaux liés aux API à grand volume | GPT-5.6 Luna ; DeepSeek V4.1 Flash ; un modèle Qwen plus petit adapté | Coût par résultat accepté, auquel s'ajoutent les exigences en matière de latence et de déploiement. |
| Création et retouche d'images | GPT Image 2.5 ; famille Nano Banana ; Midjourney | Précision du texte, contrôle de l'image de référence, style visuel et reproductibilité. |
| Production vidéo | Veo 3.1 et des outils vidéo dotés des commandes dont vous avez besoin | Mouvement, continuité, audio, flux de travail modifiable et exportation pratique. |
Commencez par vérifier que les compétences et les outils requis correspondent, puis comparez les candidats sur la base d'un travail concret que vous pouvez évaluer.
N’achetez pas systématiquement le modèle le plus performant pour chaque demande. Les tâches courantes d’extraction, de réécriture de courte durée et de mise en forme ont souvent un critère de réussite ou d’échec clairement défini. Réservez un modèle de raisonnement plus performant aux cas où une option moins coûteuse ne permet pas d’atteindre cet objectif. Pour une tâche ponctuelle, le choix de l’application la plus simple et la plus pratique peut s’avérer plus important qu’une légère différence de coût de l’API.
Les modèles d'IA, les applications et les abonnements constituent différentes options
Un modèle d’IA est le système qui génère un résultat à partir de vos données d’entrée. Une application apporte l’environnement de travail : téléchargement de fichiers, recherche, conversations enregistrées, outils d’image ou connexions à d’autres logiciels. Un abonnement détermine vos modalités d’accès à cet environnement ainsi que vos limites d’utilisation. GPT est une famille de modèles, ChatGPT est un produit, et un forfait ChatGPT correspond à une décision d’achat. La même distinction s’applique aux modèles Claude et à Claude Pro.
GlobalGPT est une plateforme multimodèle ; elle s'inscrit donc dans le cadre des discussions sur les flux de travail et l'accès. Dans cette comparaison, Perplexity est avant tout un produit axé sur la recherche ; ses modèles d'API et ses services pour développeurs constituent une couche distincte. Regrouper tous ces noms dans un seul classement du “ meilleur modèle ” complique la décision d'achat, car ces solutions répondent à des problèmes différents.

- Choisissez un application lorsque vous recherchez une interface prête à l'emploi pour gérer vos fichiers, vos conversations ou vos projets créatifs.
- Choisissez un API lorsqu'un logiciel doit envoyer des requêtes automatiquement et traiter les résultats.
- Choisissez un déploiement en poids libre lorsque l'exploitation du modèle par vos propres moyens fait partie des exigences. Tenez compte des aspects liés au matériel, à la maintenance et à la sécurité dans cette décision.
Un modèle prenant en charge les images en entrée ne génère pas automatiquement des images en sortie. De même, une fenêtre de contexte étendue ne signifie pas que l'application de chat accepte des fichiers de n'importe quelle taille. Assurez-vous que le modèle, les fonctionnalités du produit et la formule choisie correspondent à vos besoins avant de comparer les prix.
Modèles de texte, de codage et de raisonnement méritant d'être présélectionnés
OpenAI : GPT-6 Astra et la gamme GPT-5.6
Catalogue des modèles OpenAI recommande le modèle GPT-6 Astra pour le raisonnement complexe et le codage, le modèle GPT-5.6 Terra pour un bon compromis entre performances et coût, et le modèle GPT-5.6 Luna pour les tâches à fort volume où le coût est un critère déterminant. Le modèle GPT-5.6 Sol est également recommandé pour les tâches professionnelles complexes. Il s’agit là de choix différents en fonction du budget et des tâches au sein d’une même gamme, et non de raisons de choisir automatiquement le modèle le plus cher.
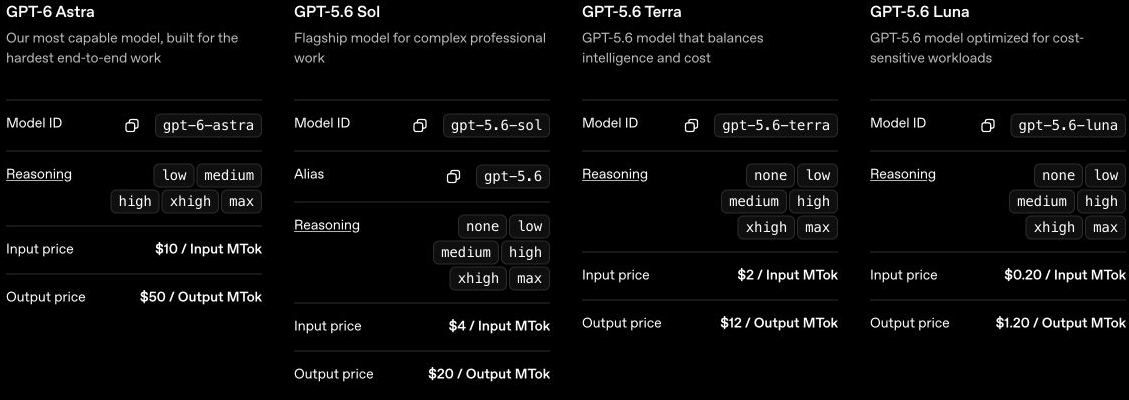
Pour un développeur, une comparaison utile consiste à comparer, chez deux candidats, une même fonction défaillante, une même suite de tests et des critères d’acceptation identiques. Pour un analyste, il convient d’utiliser les mêmes documents sources et de demander aux deux modèles d’identifier les éléments qui étayent chaque conclusion. Une explication fluide ne suffit pas si le code ne fonctionne pas ou si le document cité indique autre chose.
- Commencez par ici pour : un mélange de texte, d'exercices structurés, de raisonnement et d'exercices de programmation.
- Comparez : Terra ou Luna pour les charges de travail courantes ; Sol ou Astra lorsque les cas plus complexes justifient le surcoût.
- Accès : Les tarifs de l'API indiqués ci-dessous correspondent aux frais liés aux jetons de développeur. Ils sont distincts des abonnements ChatGPT et des frais spécifiques aux outils.
Claude : Sonnet 5, Opus 5 et Fable 5.1
La gamme actuelle de Anthropic comprend Claude Sonnet 5, Opus 5, Fable 5.1 et Haiku 4.5. Anthropic recommande Opus 5 pour la plupart des charges de travail et Fable 5.1 pour les tâches de raisonnement exigeantes ou les tâches agentiques à long terme, lorsque les évaluations sur Opus s’avèrent encore insuffisantes. Il s’agit là d’une règle de mise à niveau utile : opter pour le modèle le plus performant après avoir identifié un véritable échec, plutôt qu’avant même d’avoir tenté la tâche.
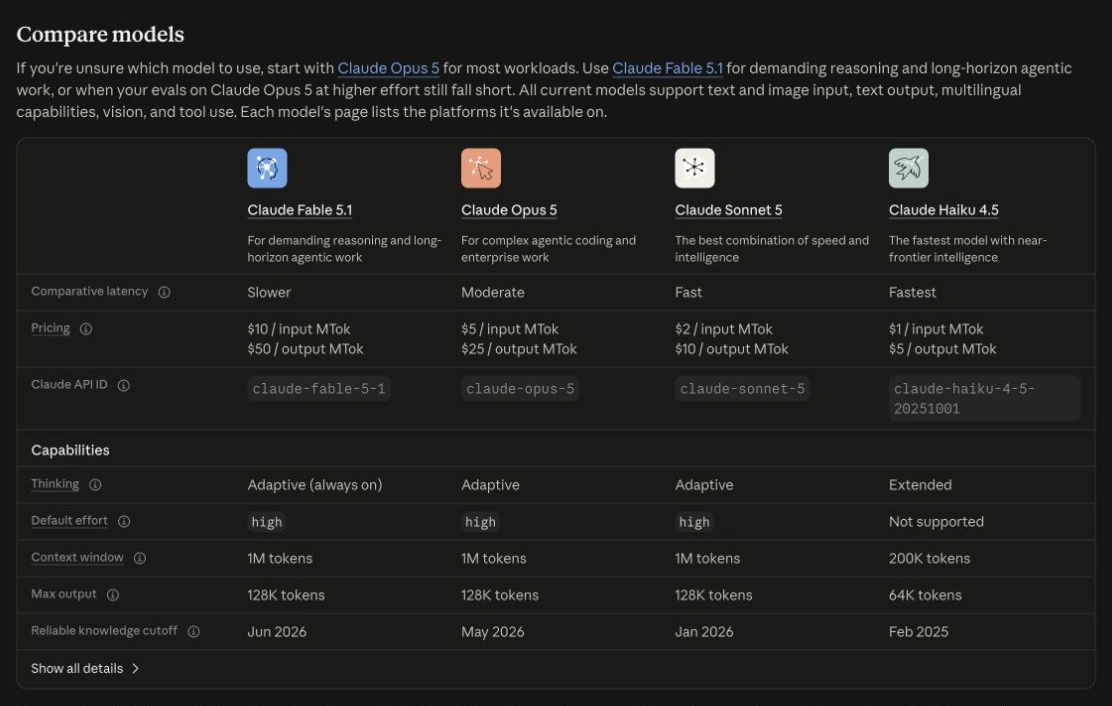
En matière de rédaction, évaluez si le modèle respecte vos données factuelles, votre ton et vos contraintes au fil de plusieurs cycles de révision. En matière de programmation, évaluez les modifications qu’il génère et les tests qu’il réussit. Une réponse longue peut être impressionnante, mais coûteuse à examiner. Demandez le livrable complet le plus succinct possible : une section révisée, un correctif fonctionnel ou une décision étayée par des arguments vérifiables.
- Commencez par ici pour : rédactions longues, révision de code et projets nécessitant une utilisation rigoureuse des ressources fournies.
- Comparez : Sonnet 5 pour la configuration de base ; Opus 5 ou Fable 5.1 pour les tâches exigeantes. Il s'agit d'une séquence de sélection, et non d'un classement de qualité indépendant.
- Accès : Les abonnements à l'application Claude et la facturation des API sont deux choses différentes. Comparez-les. Plans Claude et le API et répartition des utilisations pour le trajet que vous comptez acheter.
Si vous devez choisir entre ces deux écosystèmes, le Comparaison entre les modèles Claude et ChatGPT traite des aspects liés aux produits. Ne transposez pas la position de référence d'un ancien modèle à une nouvelle version portant un nom similaire.
Gemini : Aperçu de Flash 3.8 et Pro 3.1
Répertoire des modèles de Google Il présente Gemini 3.8 Flash comme un modèle stable et Gemini 3.1 Pro comme une version préliminaire. Il décrit la version 3.8 Flash en termes d’ingénierie logicielle, d’agents autonomes et de flux de travail d’entreprise complexes ; la version 3.1 Pro reste quant à elle une solution potentielle pour la résolution de problèmes complexes. “ Flash ” et “ Pro ” sont des appellations génériques ; la version exacte et le statut de publication importent donc davantage que l’appellation seule.
Gemini mérite de figurer parmi les finalistes lorsqu'une tâche implique des données mixtes, comme un rapport accompagné d'images ou une vidéo accompagnée d'une transcription. Vérifiez si la réponse fait référence à la bonne page, à la bonne image ou au bon passage. Cela permet de détecter une erreur courante liée au contexte étendu : le modèle accepte le contenu, mais en extrait un détail erroné.

Google tableau de référence original fournit la comparaison entre les deux anciennes versions présentée ci-dessus. Elle est utile pour comprendre les conditions des tests de performance. Les lignes utilisant des outils et celles qui n'en utilisent pas répondent à des questions différentes. La section “ contexte étendu ” distingue également une moyenne de 128 Ko d'un résultat point par point de 1 Mo. Gardez ces distinctions à l’esprit lorsque vous évaluez une affirmation concernant un “ meilleur raisonnement ” ou une « mémoire plus longue ».”
Pour toute question relative à l'achat et à la configuration, consultez Options d'abonnement à Gemini et Configuration de l'abonnement Gemini. Le Comparaison entre le Gemini 3.1 Pro et le Claude Opus 4.6 Il s'agit d'une comparaison entre différentes versions, et non d'une indication concernant la nouvelle gamme Claude.
Grok 4.6 : séparer le modèle de la recherche en production
Documentation relative au modèle Grok indique un score de Grok de 4,6 pour les tâches liées au code et au texte général, avec une fenêtre de contexte de 500 000 tokens. Il précise également une limite essentielle : un modèle ne connaît pas l'actualité au-delà de ses données d'entraînement, à moins que les outils de recherche ne soient activés. Pour obtenir des informations récentes, il est préférable d'opter pour « Web Search » ou « X Search », et non pas simplement pour le nom « Grok ».

Dans le cadre d’un processus de suivi de l’actualité ou des tendances, vérifiez si l’assistant parvient à trouver l’article original, à distinguer sa date de celle d’une republication et à relier l’affirmation à sa source. La recherche peut permettre de retrouver des informations sans pour autant garantir la justesse de l’interprétation finale. Pour les tâches de rédaction de contenu intemporel ou de codage, comparez le résultat à vos critères d’acceptation au lieu de supposer que l’association « recherche sociale » rend Grok inadapté.
DeepSeek : options actuelles de l'API et maîtrise des coûts
Tableau des API de DeepSeek cartes deepseek-flash vers la version DeepSeek V4.1 Flash et deepseek-v4-pro vers DeepSeek V4 Pro 0813. Ce même tableau indique que le modèle Flash prend en charge la fonction « Vision », contrairement au modèle Pro mentionné. Un nom qui semble plus prestigieux ne garantit donc pas la prise en charge de votre source d'entrée.
DeepSeek est une API intéressante et économique, mais il convient de comparer l'ensemble des conditions de facturation. Ses tarifs indiqués font la distinction entre les accès au cache et les échecs de cache, ainsi qu'entre les heures de pointe et les heures creuses. Un prix minimum indiqué peut correspondre à une requête mise en cache pendant une période donnée, et non au coût d'une requête ordinaire non mise en cache.
- Commencez par ici pour : les charges de travail API récurrentes pour lesquelles le prix et la compatibilité de déploiement sont des critères importants.
- À vérifier en premier lieu : mappage précis du modèle, prise en charge des images en entrée et exigences en matière de sortie.
- Établissez correctement votre budget : Utilisez les débits d'entrée et de sortie sans mise en cache pour obtenir une première estimation prudente ; n'appliquez la mise en cache ou les gains de temps que lorsque votre charge de travail remplit les conditions requises.
Qwen : une gamme de modèles ouverte, disponible en plusieurs tailles
Dépôt officiel de Qwen couvre la série de modèles ouverts Qwen3.5, y compris la version 3.6 et les versions plus récentes Qwen3.8. Il répertorie les modèles Qwen3.8-27B et Qwen3.8-2,4T-A95B, tandis que les tailles 3,5 antérieures comprennent les modèles 0,8B, 2B, 4B et 9B. Ces désignations correspondent à des exigences de déploiement très différentes ; un petit modèle local et un grand modèle phare ne sont pas interchangeables.

La question pertinente pour le travail en local est la suivante : “ Qu’est-ce que mon matériel est capable de faire fonctionner correctement ? ” Tenez compte des poids du modèle, de la surcharge d’exécution et de la mémoire utilisée par une conversation qui s’allonge. La quantification peut faciliter l’exécution d’un modèle, mais son impact sur votre tâche doit être évalué dans le cadre de l’évaluation. Le référentiel documente les options de framework locales, notamment llama.cpp et MLX ; lisez attentivement la fiche technique du modèle et la licence avant le déploiement.
Pour vos recherches, choisissez des sources et des outils de recherche, ainsi qu'un modèle
Perplexity est un outil de recherche et d'analyse qui associe des réponses à des références bibliographiques. Ses formules destinées aux particuliers déterminent l'accès aux outils de recherche, aux modèles et aux téléchargements ; les services Sonar et l'API pour développeurs constituent une option distincte. Une réponse riche en références bibliographiques n'est utile que si les sources citées viennent effectivement étayer ses affirmations principales.
Pour des recherches ponctuelles, commencez par la version gratuite : recherches de base, sélection automatique de modèles et nombre limité de fichiers à télécharger. La Comparaison des plans officiels, consultée le 15 septembre 2026, indique que 3 recherches « Pro Search » par jour et 1 requête « Research » par mois sont gratuites, sans modèles d’IA avancés ni génération d’images. La version Pro ajoute des modèles avancés, une fonctionnalité « Pro Search » étendue et des limites de téléchargement et d’analyse plus élevées. Le quota de « Pro Search » est soumis à des limites hebdomadaires et celui de « Research » à des limites mensuelles ; le tableau destiné aux particuliers ne précise pas le nombre exact de recherches Pro.
Perplexité Page des tarifs individuels, consulté le 15 septembre 2026, indique les tarifs suivants : « Free » à $0/mois, « Pro » à $20/mois et « Max » à $200/mois. Il s'agit des prix mensuels affichés, et non des montants annuels ni des montants totaux TTC à la caisse. Essayez la version gratuite sur une requête de recherche représentative, puis envisagez un forfait payant si ses modèles avancés ou ses limites d’utilisation plus élevées répondent à un besoin récurrent.
Préparez une petite liste de contrôle des sources avant d'accepter une réponse. Consultez la source d'une information importante ; vérifiez s'il s'agit d'un article de première main ; confirmez la date de publication ; et distinguez les citations directes de l'interprétation de l'assistant. Pour les informations susceptibles d'évoluer, telles que les prix et l'accessibilité des produits, la documentation actuelle du fournisseur constitue une référence plus fiable qu'un article de synthèse.
- Pour une revue de la littérature, demandez des articles originaux et identifiez la question de recherche abordée dans chaque article.
- Avant de prendre une décision d'achat, demandez à connaître le détail exact de l'offre, les modalités de facturation et la date de validité des conditions proposées.
- Pour les actualités récentes, comparez le communiqué d'origine avec les articles parus par la suite.
- Pour une question controversée, demandez-vous sur quels points les sources s'accordent et lesquels restent incertains.
Utilisation Les modèles et modes de Perplexity pour comprendre les modes de fonctionnement disponibles, et Plans d'abonnement à la perplexité pour la décision d'achat. Un modèle de raisonnement plus coûteux ne peut pas compenser un ensemble de sources qui omet le document pertinent.
Modèles d'image : choisissez entre le contrôle de l'édition, la précision du texte ou le style visuel
GPT Image : création et retouche pratiques
Le catalogue actuel de OpenAI propose GPT Image 2.5 Sunburst pour la création et la retouche d’images, ainsi que GPT Image 2.5 Flare pour une création quotidienne plus rapide. Comparez les deux solutions sur une même publicité, un même schéma ou un même brief d’image de produit, en tenant compte des modifications que vous prévoyez d’apporter.
Pour une image d'entreprise, précisez le texte exact, la mise en page et les éléments requis. Vérifiez ensuite le résultat à sa taille d'affichage finale. Une infographie très réussie peut contenir une légende mal orthographiée ou un chiffre plausible mais erroné. Si le visuel communique des faits, vérifiez ces faits indépendamment de l'aspect visuel de l'image.

Nano Banana : création et retouche d'images à partir d'une référence
Le catalogue de Google distingue les modèles Nano Banana Pro, Nano Banana 2 et Nano Banana 2 Lite. Le modèle Nano Banana Pro correspond à gemini-3-pro-image; Nano Banana 2 à gemini-3.1-image-flash; et Lite vers gemini-3.1-flash-lite-image. Optez pour une approche précise lorsque vous comparez les comportements de génération et d'édition, plutôt que de considérer le surnom comme un modèle immuable.

Les retouches de référence nécessitent un examen différent de celui de la génération d'images ponctuelles. La modification demandée a-t-elle bien été effectuée ? L'arrière-plan, les vêtements, le visage ou les détails du produit ont-ils été modifiés par inadvertance ? Une petite retouche qui préserve le reste de l'image peut s'avérer plus utile qu'une refonte radicale. Voir Premiers pas avec Nano Banana Pro, voies d'accès et Tarifs du Nano Banana Pro pour les prochaines étapes.
Midjourney : évaluer le style par rapport au cahier des charges
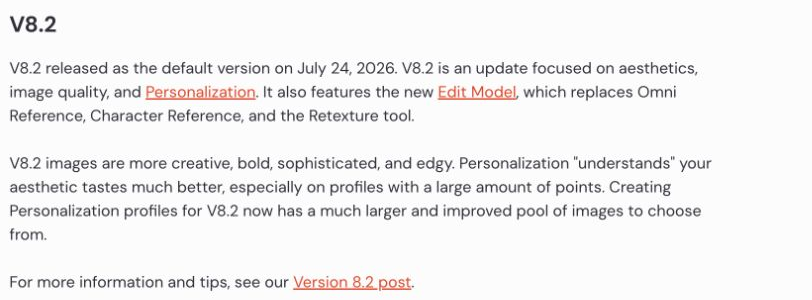
Midjourney’s guide officiel de la version, consulté le 15 septembre 2026, indique que la version par défaut est la V8.2, sortie le 24 juillet. Cette mise à jour met l’accent sur l’esthétique et la personnalisation, et introduit un outil « Edit Model » qui remplace les fonctions « Omni Reference », « Character Reference » et « Retexture ». Pensez-y pour vos moodboards, vos illustrations conceptuelles ou pour créer un traitement visuel original pour une campagne. Une esquisse de concept doit présenter un style convaincant ; un schéma de produit annoté doit comporter un contenu précis. Comparez le résultat et ses révisions par rapport à ce cahier des charges.

Pour que le test soit pertinent, veillez à ce que le sujet, la composition requise et le format d'exportation restent les mêmes. Vérifiez si vous pouvez modifier l'orientation choisie sans devoir tout recommencer. Si la précision du texte ou la préservation de l'identité sont essentielles, prévoyez des critères de réussite ou d'échec explicites à cet égard. Le Comparaison entre le Nano Banana Pro et le Midjourney offre une autre façon d'envisager cette décision.
Modèles vidéo : évaluez l'ensemble du clip, et non une seule image attrayante
Veo 3.1 et le processus de production
Documentation de Google sur le modèle Veo décrit la spécification Veo 3.1 pour la génération de vidéos avec des commandes créatives et de l'audio. Ses exemples incluent des images de référence, l'extension de scène et des workflows portant sur la première et la dernière image. Ces commandes sont importantes si vous avez besoin de plusieurs plans s'inscrivant dans une même histoire, plutôt que d'un simple clip isolé.
Testez l’élément de production le plus difficile à corriger par la suite : la cohérence d’un personnage, un produit qui conserve sa forme, une signalétique lisible ou des dialogues synchronisés. Regardez l’extrait complet à vitesse normale et examinez attentivement chaque transition délicate. Un modèle peut offrir un premier plan très réussi, mais présenter des défauts lorsque la caméra se déplace.
L'accès, l'utilisation et les exportations dépendent du parcours du produit ; comparez donc les Veo 3.1 Options d'abonnement et d'utilisation en plus des options de personnalisation. Ne comparez pas directement un tarif API par seconde à un forfait mensuel sans tenir compte du volume d'utilisation inclus et du type de sortie.
Sora : expliquer la fermeture annoncée du service
L'équipe d'OpenAI Avis d'arrêt de la commercialisation de Sora, publié le 11 septembre 2026, indiquait que les services Web et l'application avaient cessé de fonctionner le 26 avril et annonçait la fermeture de l'API pour le 24 septembre 2026. Considérez Sora comme une question de migration pour un projet existant, plutôt que comme un point de départ pour un nouveau flux de travail vidéo. Consultez l’avis pour connaître les éventuelles dates révisées et les instructions d’exportation en vigueur.

Le Processus de création du storyboard dans Sora, Présentation de Sora 2 Pro et Guide de durée de Sora par version décrire les caractéristiques historiques. Utilisez-les pour déterminer ce qu'un projet existant doit préserver, puis comparez Alternatives à Sora par rapport à ces exigences. Conservez ensemble le message d'invite, les documents de référence et le résultat complet afin de pouvoir évaluer un remplacement sur la base du même cahier des charges.
Comparer les coûts des API pour une même charge de travail
L'API facture les jetons d'entrée et de sortie ; un abonnement utilisateur donne accès à un forfait. Veillez à bien séparer ces budgets. Le calcul ci-dessous se base sur 100 requêtes, chacune comportant 10 000 jetons d’entrée non mis en cache et 1 000 jetons de sortie facturés : soit un total de 1 million de jetons d’entrée et 100 000 jetons de sortie. Il s’agit d’une charge de travail à titre d’exemple, et non d’une facture réelle ni d’un critère de référence de qualité.
USD, taux standard des jetons cotés, vérifiés le 15 septembre 2026. Demandes courtes telles que spécifiées ; sans remise de cache, remise sur volume, niveau de priorité, taxes ni outils payants. Le quota de sortie inclut les jetons de raisonnement facturés, le cas échéant. Sources : Catalogue des modèles OpenAI, Présentation du modèle Anthropic, Modèles et tarifs de la série Grok.
Le modèle le moins cher n’est utile que si les résultats satisfont à vos critères de vérification. Si un modèle moins cher nécessite des tentatives répétées ou des corrections manuelles importantes, comparez le coût par résultat accepté. Commencez par un modèle moins coûteux pour les tâches simples et répétitives, puis transférez les cas difficiles vers un modèle plus performant lorsque le premier résultat échoue.
Les taux utilisés pour le calcul
| Modèle | Données d'entrée / 1 million de jetons | Résultat / 1 million de jetons |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haïku 4.5 | $1.00 | $5.00 |
| Grok 4,6 | $2.00 | $6.00 |
| Claude Sonnet 5 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
Il s'agit de tarifs d'API, et non de frais d'abonnement mensuels. Le scénario ci-dessus fixe la taille des données d'entrée et la taille facturée des données de sortie ; il ne suppose pas que la longueur, la précision ou la vitesse des données de sortie correspondent à celles observées en conditions réelles.
Le modèle DeepSeek applique un tarif différencié en fonction de l'heure. Son tableau Flash V4.1 actuel indique des coûts d’entrée non mis en cache de $0,15 en heures creuses ou $0,30 en heures de pointe, et des coûts de sortie de $0,60 en heures creuses ou $1,20 en heures de pointe, par million de jetons. V4 Pro indique $0,66/$1,32 pour les entrées non mises en cache et $1,98/$3,96 pour les sorties. Les périodes de pointe documentées sont de 01 h 00 à 04 h 00 et de 06 h 00 à 10 h 00 UTC, du lundi au vendredi. Utilisez le tarif en vigueur au moment de l’exécution de la tâche ; les tarifs d’entrée en cache doivent faire l’objet d’un calcul distinct.
Pour un flux de travail mixte au quotidien, L'abonnement multimodèle de GlobalGPT offre un moyen plus simple de gérer à la fois la recherche, la rédaction, l'aide au codage et la création de contenu. Comparez cette facilité d'utilisation et cette polyvalence à la gestion de plusieurs abonnements ou à la mise en place d'un flux de travail API par vos propres moyens. Un tableau des tarifs de l'API ne précise ni le prix de l'abonnement ni les conditions d'utilisation.
En mode « open-weight » ou hébergé : choisissez le niveau d'intervention que vous souhaitez
Les poids ouverts vous offrent une option de déploiement : exécuter un modèle dans un environnement que vous contrôlez. Ils ne rendent pas automatiquement l'ensemble du flux de travail gratuit, privé ou sans restriction. Vérifiez la licence associée au modèle en question, le matériel requis pour l'exécuter et la destination vers laquelle l'application associée envoie les fichiers ou les journaux.
- Choisissez une application hébergée lorsque vous souhaitez vous lancer rapidement et que vous n'avez pas besoin de faire fonctionner le modèle.
- Choisissez une API hébergée lorsque vous avez besoin d'une automatisation sans avoir à gérer de matériel d'inférence.
- Envisager un déploiement sur site lorsque le travail hors ligne, la gestion de l’infrastructure ou une exigence spécifique en matière de traitement des données le justifient.
- Comparez les modèles plus petits sur votre matériel avant de conclure qu'un modèle phare comportant davantage de paramètres constitue le choix le plus judicieux.
Un modèle local peut réduire les transferts de données externes, mais le reste du système reste important : récupération, plug-ins, télémétrie, historiques enregistrés et sauvegardes. Pour une équipe, il vaut mieux considérer cela comme une analyse du déploiement plutôt que comme une promesse sous-entendue par le mot “ ouvert ”. Le Guide sur la protection des données dans le domaine de l'IA permet de mettre en perspective les exigences en matière de traitement des données.
Faut-il utiliser un seul modèle d'IA ou plusieurs ?
Un modèle suffit s’il gère efficacement vos tâches récurrentes. Ajoutez-en un autre lorsqu’il comble une lacune spécifique : un meilleur accès aux sources, un type de données d’entrée requis, une retouche d’images plus contrôlable ou un traitement par lots moins coûteux. Gérer plusieurs abonnements sans attribuer de tâche à chacun d’entre eux entraîne davantage de décisions et de transferts de responsabilité.

Mettre en place un processus de travail autour du livrable
| Travail | Séquence utile | Contrôle de réception |
|---|---|---|
| Marketing | Recherche de sources → rédaction d'un premier jet → création d'illustrations → vérification des affirmations | Les arguments avancés par la campagne sont étayés, et le texte ainsi que les visuels vont dans le même sens. |
| Développement de logiciels | Comprendre le problème → modifier le code → exécuter les tests → examiner les différences | Cette modification répond à l'exigence sans entraîner de conséquences imprévues ailleurs. |
| Création de contenu | Plan → scénario → images de référence → prises de vue → montage | Les personnages, les détails sur les produits et le récit restent cohérents. |
| Opérations de démarrage | Synthétiser les contributions → dégager les décisions → rédiger un plan de suivi | Les décisions sont attribuées à des responsables et assorties de dates, et aucun fait non étayé ne figure dans le dossier. |
| Activités de l'entreprise | Sélectionner un environnement approuvé → traiter les données autorisées → vérifier les résultats | Ce processus répond aux exigences de l'organisation en matière d'accès, de données et de révision. |
Commencez par un livrable finalisé. Conservez ses notes sources et ses contrôles de conformité avec le travail à mesure qu’il passe d’un outil à l’autre.
GlobalGPT s'inscrit dans une approche en plusieurs étapes en regroupant les familles de modèles et les fonctions créatives en un seul et même endroit. Conservez les notes de référence utiles, le cahier des charges et les critères d'acceptation avec votre travail lorsque vous passez d'une tâche à l'autre. Le Présentation des modèles d'IA « tout-en-un » C'est une lecture utile à consulter ensuite si le choix principal porte sur l'étendue de l'espace de travail plutôt que sur un modèle spécialisé unique.
Comment choisir : une méthode d'évaluation en cinq étapes que vous pouvez répéter
- Définissez un livrable. Par exemple, un résumé de 500 mots avec des références de pages, un correctif qui réussit trois tests, ou une image de produit comportant deux étiquettes identiques.
- Choisissez deux candidats plausibles. Commencez par mettre en adéquation les données d'entrée et les outils requis. Ne comparez pas un assistant doté d'une fonctionnalité de recherche à un modèle dépourvu de tout outil de recherche, puis qualifiez cette différence d'« intelligence du modèle ».
- Utilisez le même cahier des charges et les mêmes données. Notez le modèle, le produit, les réglages et la date. Enregistrez le premier résultat complet plutôt que de ne sélectionner que la prise la plus réussie.
- Vérifiez d'abord l'exactitude, puis le style. Vérifier les citations, effectuer les tests de code nécessaires et examiner les détails des images ou des vidéos. Noter les corrections manuelles requises.
- Revoyez les cas difficiles. Si le choix est serré ou si les résultats ne sont pas cohérents, refaites ces cas et conservez les résultats supplémentaires à part. Faites votre choix en fonction des résultats acceptés, de l'effort requis et du coût total.
En matière de rédaction, un bon moyen de vérifier la qualité de votre travail consiste à voir si tous les faits fournis résistent à une réécriture. Pour l'extraction d'informations, comparez le résultat obtenu avec un petit corrigé. Pour la recherche, consultez les pages citées. Pour les vidéos, enregistrez et regardez le clip dans son intégralité. Le Méthodologie de test du modèle GlobalGPT fournit des informations complémentaires permettant d'établir des comparaisons.
Évitez ces quatre écueils : vous laisser influencer par des arguments de popularité, comparer des unités de prix non comparables, considérer un seul critère de référence comme représentant l'ensemble de la tâche, et négliger le temps d'analyse requis par un résultat. Aucun de ces problèmes n'est résolu par le simple fait de choisir le modèle le plus récent. Une évaluation reproductible est plus utile, car elle peut être réexécutée lorsqu'un modèle évolue.
Foire aux questions
Quel est le meilleur modèle d'IA à l'heure actuelle ?
Il n'y a pas de solution universelle. Commencez par examiner les options GPT actuelles (Claude, Gemini, Grok, DeepSeek ou Qwen) pour le texte et le code, puis affinez votre choix en fonction de votre tâche, des outils requis, des données d'entrée et de votre budget. Utilisez un modèle dédié aux images ou à la vidéo lorsque le résultat attendu l'exige.
Quel modèle d'IA devrais-je essayer pour le codage ?
Choisissez des candidats qui s'adaptent à votre processus de développement, comme les modèles GPT, Claude, Gemini ou Qwen actuels. Comparez-les sur un même problème, une même base de code et les mêmes tests. Une modification validée qui nécessite peu de travail de révision constitue un meilleur critère de sélection qu'une explication convaincante.
Une fenêtre de contexte plus grande est-elle toujours préférable ?
Une fenêtre contextuelle plus grande permet d'inclure davantage d'informations dans une requête, mais cela ne garantit pas une recherche précise ni un raisonnement correct sur l'ensemble de ces informations. Vérifiez si le modèle est capable de localiser le passage, la page ou l'image exacts nécessaires à votre réponse.
Les modèles d'IA à poids ouvert sont-ils gratuits ?
Les modèles peuvent être disponibles sous licence, mais leur utilisation peut nécessiter du matériel, un hébergement et une maintenance. Vérifiez les modalités exactes de la licence et le coût de déploiement. Un déploiement local nécessite également une analyse de l'application associée et de la manière dont elle traite les données.
Le Grok détecte-t-il automatiquement les informations en direct ?
Non. La documentation de l'API Grok précise que les informations actuelles nécessitent des outils de recherche tels que Web Search ou X Search. Les connaissances utilisées pour l'entraînement d'un modèle et les sources récupérées lors d'une requête sont deux choses distinctes.
Puis-je comparer les tarifs de l'API avec ceux d'un abonnement mensuel à l'IA ?
Ce n'est qu'après avoir défini la charge de travail et le contenu de chaque parcours que cela devient possible. Les tarifs des API sont généralement facturés à l'unité (tokens) ou en fonction du volume de données transmises, tandis qu'un abonnement donne accès au service selon les conditions d'utilisation spécifiques au forfait. Comparez le coût total du workflow que vous envisagez, à l'instar des prix annoncés.
Le modèle d'IA le plus populaire est-il forcément le meilleur pour moi ?
Non. La popularité d’un modèle ne permet pas de savoir s’il prend en charge vos fichiers, s’il respecte vos contraintes ou s’il correspond à votre budget. Utilisez la documentation actuelle pour établir une liste de présélection, puis comparez les résultats concrets à une tâche que vous pouvez vérifier.
Choisissez le modèle qui vous permettra de mener à bien votre prochain projet en minimisant les corrections évitables. Commencez modestement, notez ce qui fonctionne, et n’ajoutez un autre modèle que s’il résout clairement un problème. Si votre travail touche à la fois à la recherche, à la rédaction et à la création, Essayez ce workflow dans la version GlobalGPT et jugez le résultat final.