Los mejores modelos de IA que debes tener en cuenta dependen del trabajo que necesites realizar. Para texto, programación y razonamiento, compara las familias actuales GPT, Claude, Gemini, Grok, DeepSeek y Qwen. Para imágenes, ten en cuenta GPT Image, Nano Banana y Midjourney; para vídeo, empieza por los controles de generación y edición que necesite tu proyecto. Un asistente de investigación también necesita herramientas de búsqueda y fuentes fiables, no solo un potente modelo lingüístico.
Empieza por tu tarea recurrente más difícil y, a continuación, elige la configuración más económica que te permita llevarla a cabo de forma fiable. Un modelo capaz de redactar un párrafo convincente puede, aun así, interpretar mal un documento, inventarse una cita o generar código que no funcione. Las recomendaciones que figuran a continuación se basan en la documentación oficial de los modelos y en criterios de selección prácticos; se trata de una lista de candidatos preseleccionados por tarea, no de una clasificación por puntuaciones.
GlobalGPT Reúne varias familias de modelos y funciones de IA en una sola suscripción, para que puedas pasar de la investigación y la redacción a las imágenes y los vídeos en el mismo espacio de trabajo. Es una opción práctica y económica cuando tu semana abarca varios tipos de trabajo y quieres tener que gestionar menos suscripciones independientes.
Directorios oficiales de modelos consultados el 15 de septiembre de 2026. Los ejemplos históricos se identifican con sus modelos originales.
¿Qué modelo de IA deberías elegir primero?
Una lista práctica organizada por tareas
| Tu tarea | Candidatos para comparar | ¿Qué debería determinar la elección? |
|---|---|---|
| Texto y programación cotidianos | GPT-5.6 Terra; Claude Sonnet 5; Gemini 3,8 Flash | El cumplimiento de las instrucciones, los resultados útiles y el nivel de edición que necesites. |
| Razonamiento complejo o programación extensa | GPT-6 Astra; Claude Opus 5 o Fable 5.1; Qwen3.8 | Resuelve con éxito tus propios casos difíciles, con las herramientas y los permisos necesarios. |
| Documentos extensos y entradas mixtas | Avance de Gemini 3.1 Pro; modelos actuales GPT y Claude | Compatibilidad con archivos, recuperación precisa y referencias a las fuentes: no solo capacidad. |
| Investigación reciente | Un asistente con función de búsqueda; Perplexity; Grok con herramientas de búsqueda | La calidad de las fuentes, las fechas de publicación y si las citas respaldan la respuesta. |
| Trabajo con API de gran volumen | GPT-5.6 Luna; DeepSeek V4.1 Flash; un modelo Qwen más pequeño adecuado | Coste por resultado aceptado, más los requisitos de latencia y despliegue. |
| Creación y edición de imágenes | GPT Image 2.5; familia Nano Banana; Midjourney | Precisión del texto, control de la imagen de referencia, estilo visual y repetibilidad. |
| Producción de vídeos | Veo 3.1 y herramientas de vídeo con los controles que necesitas | Movimiento, continuidad, audio, flujo de trabajo editable y exportación práctica. |
En primer lugar, comprueba que se cumplan los requisitos de recursos y herramientas necesarios; a continuación, compara a los candidatos basándote en un resultado concreto que puedas evaluar.
No compres el modelo más sofisticado para cada solicitud. Las tareas rutinarias de extracción de datos, las pequeñas reescrituras y el formateo suelen tener un objetivo claro de «aprobado/suspenso». Reserva un modelo de razonamiento más potente para los casos en los que una opción más económica no pueda alcanzar ese objetivo. Para una tarea puntual, la aplicación más sencilla que funcione puede ser más importante que una pequeña diferencia en el coste de la API.
Los modelos de IA, las aplicaciones y las suscripciones son opciones diferentes
Un modelo de IA es el sistema que genera un resultado a partir de los datos que se le introducen. Una aplicación aporta el entorno de trabajo: subida de archivos, búsqueda, conversaciones guardadas, herramientas de imagen o conexiones con otro software. Una suscripción determina cómo se accede a ese entorno y cuáles son los límites de uso. GPT es una familia de modelos, ChatGPT es un producto y un plan ChatGPT es una decisión de compra. La misma distinción se aplica a los modelos Claude y a Claude Pro.
GlobalGPT es una plataforma multimodelo, por lo que debe incluirse en el debate sobre flujos de trabajo y acceso. Perplexity es, en esta comparación, un producto orientado principalmente a la investigación; sus modelos de API y servicios para desarrolladores constituyen una capa independiente. Incluir todos estos nombres en una única clasificación del “mejor modelo” dificulta la decisión de compra, ya que cada uno de ellos resuelve problemas diferentes.

- Elige un aplicación cuando necesites una interfaz lista para usar para gestionar archivos, conversaciones o trabajos creativos.
- Elige un API cuando el software tiene que enviar solicitudes de forma automática y gestionar los resultados.
- Elige un despliegue con peso libre cuando uno de los requisitos es gestionar el modelo por cuenta propia. Ten en cuenta el hardware, el mantenimiento y las tareas de seguridad a la hora de tomar esa decisión.
Un modelo que admite imágenes como entrada no genera automáticamente imágenes como salida. Del mismo modo, una ventana de contexto amplia no significa que la aplicación de chat acepte archivos de cualquier tamaño. Comprueba que el modelo, las características del producto y el plan se ajusten a tus necesidades antes de comparar precios.
Modelos de texto, programación y razonamiento que merecen ser preseleccionados
OpenAI: GPT-6 Astra y la familia GPT-5.6
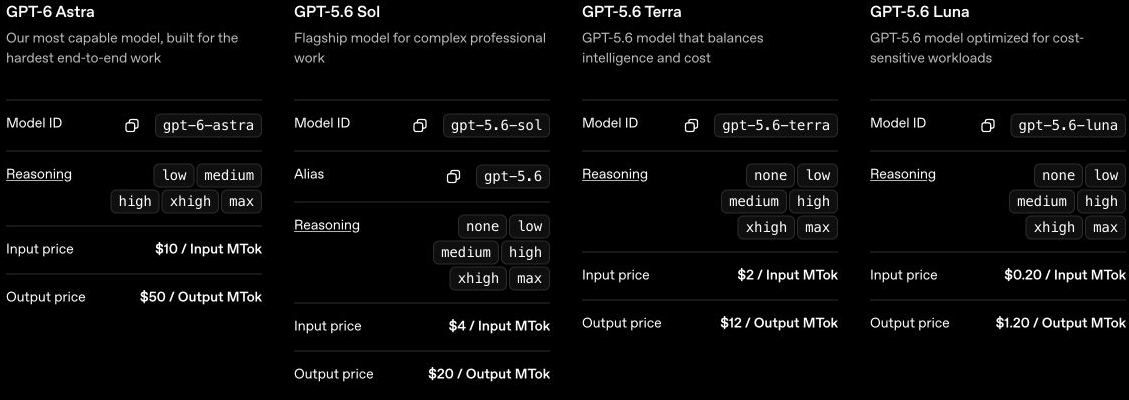
Catálogo de modelos de OpenAI Recomienda GPT-6 Astra para el razonamiento complejo y la programación, GPT-5.6 Terra para equilibrar la inteligencia y el coste, y GPT-5.6 Luna para trabajos de gran volumen en los que el coste es un factor determinante. GPT-5.6 Sol también figura en la lista para trabajos profesionales complejos. Se trata de diferentes opciones en función del presupuesto y la tarea dentro de una misma familia, más que de razones para seleccionar automáticamente el modelo más caro.
Para un desarrollador, una comparación útil consiste en aplicar la misma función defectuosa, el mismo conjunto de pruebas y los mismos criterios de aceptación a dos candidatos. Para un analista, utiliza los mismos documentos de referencia y pide a ambos modelos que identifiquen las pruebas en las que se basa cada conclusión. Una explicación fluida no es suficiente si el código no funciona o si el documento citado dice otra cosa.
- Empieza por aquí para: una combinación de texto, ejercicios estructurados, razonamiento y tareas de programación.
- Compara: Terra o Luna para las cargas de trabajo habituales; Sol o Astra cuando los casos más complejos justifiquen el coste adicional.
- Acceso: Los precios de la API que se indican a continuación corresponden a los cargos por los tokens de desarrollador. Son independientes de las suscripciones a ChatGPT y de los cargos específicos de cada herramienta.
Claude: Sonnet 5, Opus 5 y Fable 5.1
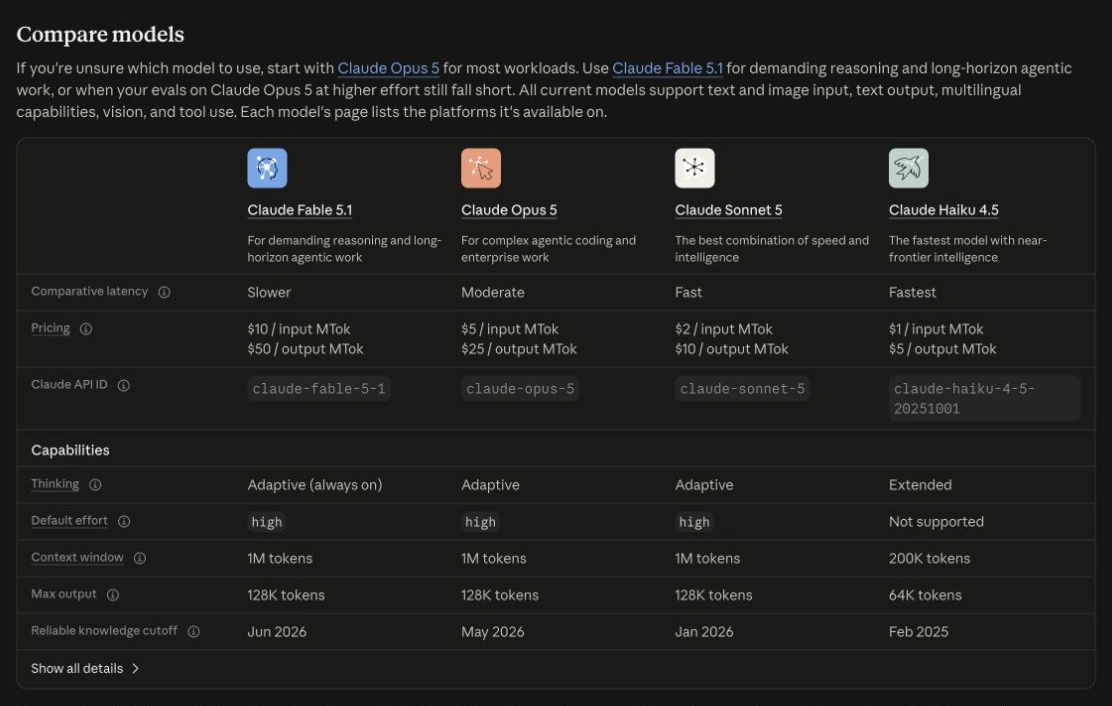
La gama actual de Anthropic Incluye Claude Sonnet 5, Opus 5, Fable 5.1 y Haiku 4.5. Anthropic recomienda Opus 5 para la mayoría de las cargas de trabajo y Fable 5.1 para tareas de razonamiento exigentes o trabajo de agentes a largo plazo, cuando las evaluaciones en Opus siguen siendo insuficientes. Esa es una regla de actualización útil: invertir en el modelo más complejo tras identificar un fallo real, en lugar de hacerlo antes de intentar la tarea.
En cuanto a la redacción, evalúa si el modelo conserva los datos, el tono y las restricciones a lo largo de varias rondas de edición. En cuanto a la programación, evalúa los cambios que genera y las pruebas que supera. Una respuesta extensa puede resultar impresionante, pero su revisión puede resultar costosa. Solicita el resultado final más pequeño posible: una sección revisada, un parche que funcione o una decisión con justificación trazable.
- Empieza por aquí para: redacciones extensas, revisión de código y proyectos que requieren un uso cuidadoso del material facilitado.
- Compara: Sonnet 5 como referencia básica; Opus 5 o Fable 5.1 para trabajos exigentes. Se trata de una secuencia de selección, no de una clasificación de calidad independiente.
- Acceso: Las suscripciones a la aplicación Claude y la facturación de la API son cosas distintas. Compara Planes Claude y el API y desglose de uso para la ruta que desea adquirir.
Si tienes que elegir entre los dos ecosistemas, el Comparación entre el Claude y el ChatGPT aborda aspectos relacionados con los productos. No transfieras la posición de referencia de un modelo anterior a una nueva versión con un nombre similar.
Gemini: Vista previa de Flash 3.8 y Pro 3.1
Directorio de modelos de Google Enumera Gemini 3.8 Flash como modelo estable y Gemini 3.1 Pro como versión preliminar. Describe la versión 3.8 Flash en relación con la ingeniería de software, los agentes autónomos y los flujos de trabajo empresariales complejos; la versión 3.1 Pro sigue siendo una opción para la resolución de problemas complejos. “Flash” y “Pro” son denominaciones de la familia de productos, por lo que la versión exacta y el estado de lanzamiento son más importantes que la propia denominación.
Gemini merece un lugar en la lista de finalistas cuando una tarea implica datos mixtos, como un informe con imágenes o un vídeo con una transcripción. Comprueba si la respuesta se refiere a la página, el fotograma o el pasaje correctos. De este modo se detecta un error habitual en contextos largos: el modelo acepta el material, pero extrae de él un detalle erróneo.

Google tabla de referencia original ofrece la comparación anterior entre las dos versiones anteriores. Resulta útil para interpretar las condiciones de las pruebas de rendimiento. Las filas en las que se utilizan herramientas y las que no responden a preguntas diferentes. La sección de contexto ampliado también distingue entre una media de 128 K y un resultado punto por punto de 1 M. Ten en cuenta estas distinciones a la hora de evaluar una afirmación sobre un “mejor razonamiento” o una “memoria más duradera”.”
Si tienes dudas relacionadas con la compra y la configuración, consulta Opciones de suscripción a Gemini y Configuración de la suscripción a Gemini. El Comparación entre el Gemini 3.1 Pro y el Claude Opus 4.6 Se trata de una comparación específica de cada versión, no de una indicación sobre la nueva gama Claude.
Grok 4.6: separar el modelo de la búsqueda en tiempo real
Documentación del modelo Grok Indica que Grok 4.6 es adecuado para tareas de código y texto general, con una ventana de contexto de 500 000 tokens. También señala una limitación fundamental: un modelo no conoce los acontecimientos de actualidad más allá de sus datos de entrenamiento, a menos que se activen las herramientas de búsqueda. Para obtener información actualizada, la opción más práctica incluye «Web Search» o «X Search», y no simplemente el nombre «Grok».

En el caso de un flujo de trabajo de seguimiento de noticias o tendencias, evalúa si el asistente encuentra la noticia original, distingue su fecha de la de una republicación y vincula la afirmación a la fuente. La búsqueda puede recuperar material sin que la interpretación final sea correcta. En el caso de tareas de redacción de contenido atemporal o de código, compara el resultado con tus criterios de aceptación en lugar de dar por sentado que la asociación de búsqueda en redes sociales hace que Grok no sea una buena opción.
DeepSeek: opciones actuales de la API y controles de costes
Tabla de API de DeepSeek mapas deepseek-flash a DeepSeek V4.1 Flash y deepseek-v4-pro a DeepSeek V4 Pro 0813. En la misma tabla se indica que Flash es compatible con Vision, mientras que la ruta Pro indicada no lo es. Por lo tanto, un nombre que suene más impresionante no garantiza la compatibilidad con la entrada que tienes.
DeepSeek es una opción útil de API con un coste competitivo, pero compara todas las condiciones de facturación. Sus tarifas publicadas distinguen entre aciertos y fallos de caché, así como entre horas punta y horas valle. El precio mínimo indicado puede referirse a una entrada almacenada en caché durante un periodo concreto, y no al coste de una solicitud normal no almacenada en caché.
- Empieza por aquí para: cargas de trabajo recurrentes de API en las que el precio y la compatibilidad de implementación son factores importantes.
- Comprueba primero: correspondencia exacta de modelos, compatibilidad con entradas de imagen y requisitos de salida.
- Elabora un presupuesto adecuado: Utiliza las tasas de entrada y salida sin almacenamiento en caché para obtener una primera estimación conservadora; aplica el almacenamiento en caché o el ahorro de tiempo solo cuando tu carga de trabajo cumpla los requisitos.
Qwen: una familia de modelos abierta con varios tamaños
Repositorio oficial de Qwen Abarca la serie de modelos abiertos Qwen3.5, incluidas las versiones 3.6 y la más reciente Qwen3.8. En él figuran los modelos Qwen3.8-27B y Qwen3.8-2,4T-A95B, mientras que los tamaños anteriores de la serie 3.5 incluyen los modelos 0,8B, 2B, 4B y 9B. Estos nombres representan requisitos de implementación muy diferentes; un modelo local pequeño y un modelo insignia de gran tamaño no son intercambiables.

La pregunta clave para el trabajo local es: “¿Qué puede ejecutar correctamente mi hardware?”. Ten en cuenta los pesos del modelo, la sobrecarga de ejecución y la memoria que consume una conversación cada vez más extensa. La cuantificación puede facilitar la ejecución de un modelo, pero su efecto en tu tarea debe evaluarse. El repositorio documenta las opciones de marcos locales, incluidos llama.cpp y MLX; lee detenidamente la ficha del modelo y la licencia antes de la implementación.
Para la investigación, elige fuentes y herramientas de búsqueda, así como un modelo
Perplexity es un producto de búsqueda e investigación que combina respuestas con citas. Sus planes para consumidores determinan el acceso a las herramientas de búsqueda, los modelos y las subidas de contenido; los servicios de Sonar y la API para desarrolladores son una opción independiente. Una respuesta rica en citas solo resulta útil cuando las fuentes enlazadas respaldan realmente sus afirmaciones clave.
Si vas a realizar búsquedas de forma ocasional, empieza con la versión gratuita: búsquedas básicas, selección automática de modelos y número limitado de archivos que puedes subir. El comparación de planes oficiales, consultada el 15 de septiembre de 2026, indica que se ofrecen 3 búsquedas «Pro» al día y 1 consulta de «Research» al mes de forma gratuita, sin modelos avanzados de IA ni generación de imágenes. La versión Pro añade modelos avanzados, una función «Pro Search» ampliada y límites más altos de carga y análisis. Su cuota de «Pro Search» tiene límites semanales y la de «Research», límites mensuales; la tabla para consumidores no indica las cifras exactas de la versión Pro.
Perplejidad Página de precios individuales, consultado el 15 de septiembre de 2026, indica que el plan Free cuesta $0 al mes, el Pro, $20 al mes, y el Max, $200 al mes. Estos son los precios mensuales que se muestran, no los totales anuales ni los importes finales con impuestos incluidos. Prueba la versión gratuita con una pregunta de investigación representativa y, a continuación, plantéate contratar un plan de pago si sus modelos avanzados o sus límites de uso más elevados satisfacen una necesidad recurrente.
Elabora una breve lista de comprobación de las fuentes antes de aceptar una respuesta. Consulta la fuente de una cifra importante; comprueba si se trata de una información de primera mano; confirma la fecha de publicación; y distingue entre una cita directa y la interpretación del asistente. En el caso de datos sujetos a cambios, como los precios y la disponibilidad de productos, la documentación actual del proveedor constituye una referencia más fiable que un artículo de resumen.
- Para una revisión bibliográfica, solicita artículos originales e identifica la pregunta de investigación que aborda cada uno de ellos.
- Antes de tomar una decisión de compra, solicita el plan exacto, la base de facturación y la fecha de vigencia de las condiciones indicadas en el presupuesto.
- En el caso de las noticias recientes, compara el comunicado original con la información publicada posteriormente al respecto.
- En el caso de una cuestión controvertida, pregúntate en qué aspectos coinciden las fuentes y cuáles siguen siendo inciertos.
Utilice Modelos y modos de Perplexity para conocer los modos de funcionamiento disponibles, y Planes de suscripción de perplejidad para la decisión de compra. Un modelo de razonamiento más costoso no puede compensar un conjunto de fuentes que omita el documento relevante.
Modelos de imagen: elige entre el control de edición, la precisión del texto o el estilo visual
Imágenes GPT: generación y edición prácticas
El catálogo actual de OpenAI incluye GPT Image 2.5 Sunburst para la generación y edición de imágenes, y GPT Image 2.5 Flare para una generación más rápida en el día a día. Compara ambas opciones con el mismo anuncio, diagrama o brief de imagen de producto, incluyendo las revisiones que preveas realizar.
Para una imagen corporativa, especifica el texto exacto, el diseño y los elementos necesarios. A continuación, comprueba el resultado en su tamaño de visualización final. Una infografía muy atractiva puede contener una etiqueta con un error ortográfico o una cifra plausible pero incorrecta. Si el elemento visual transmite datos, verifica dichos datos independientemente del aspecto de la imagen.

Nano Banana: creación y edición de imágenes basadas en referencias
El directorio de Google distingue entre Nano Banana Pro, Nano Banana 2 y Nano Banana 2 Lite. Nano Banana Pro se corresponde con gemini-3-pro-image; Nano Banana 2 a gemini-3.1-imagen-flash; y Lite a gemini-3.1-flash-lite-image. A la hora de comparar el comportamiento de generación y edición, elige la ruta exacta en lugar de considerar el apodo como un modelo inmutable.

Las modificaciones de referencia requieren una revisión diferente a la de la generación de imágenes puntuales. ¿Se ha aplicado el cambio solicitado? ¿Han cambiado sin querer los detalles del fondo, la ropa, el rostro o el producto? Una pequeña modificación que conserve el resto de la imagen puede resultar más útil que una reelaboración drástica. Véase Primeros pasos con Nano Banana Pro, vías de acceso y Precios del Nano Banana Pro para los siguientes pasos.
Midjourney: evaluar el estilo en función del pliego de condiciones
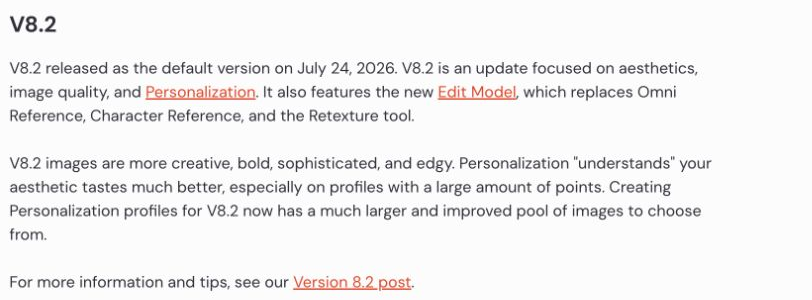
Midjourney’s Guía oficial de la versión, consultado el 15 de septiembre de 2026, indica que la versión predeterminada es la V8.2, lanzada el 24 de julio. Su actualización se centra en la estética y la personalización, e introduce una función «Editar modelo» que sustituye a «Omni Reference», «Character Reference» y «Retexture». Ténlo en cuenta para crear tableros de inspiración, arte conceptual o un tratamiento publicitario distintivo. Un boceto conceptual necesita un estilo convincente; un diagrama de producto etiquetado necesita un contenido exacto. Compara el resultado y sus revisiones con ese briefing.

Para que la prueba resulte útil, mantén la coherencia en cuanto al tema, la composición requerida y el formato de exportación. Comprueba si puedes modificar la orientación elegida sin tener que empezar de cero. Si es imprescindible preservar con precisión el texto o la identidad, establece comprobaciones explícitas de «aprobado/suspenso». El Comparación entre el Nano Banana Pro y el Midjourney ofrece otra forma de enfocar esa decisión.
Modelos de vídeo: evalúa el vídeo completo, no solo un fotograma llamativo
Veo 3.1 y el flujo de trabajo de producción
Documentación de Google sobre Veo Describe Veo 3.1 para la generación de vídeo con controles creativos y audio. Entre sus ejemplos se incluyen imágenes de referencia, la ampliación de escenas y flujos de trabajo relacionados con el primer y el último fotograma. Estos controles son importantes si necesitas que varias tomas formen parte de una misma historia, en lugar de un clip aislado.
Comprueba el aspecto de la producción que resulte más difícil de corregir a posteriori: un personaje coherente, un producto que mantenga su forma, una señalización legible o un diálogo sincronizado. Mira el clip completo a velocidad normal y analiza cualquier transición complicada. Un modelo puede ofrecer un primer fotograma impactante, pero fallar a medida que la cámara se desplaza.
El acceso, el uso y las exportaciones dependen de la ruta del producto, así que compara las Veo 3.1: Opciones de suscripción y uso junto con los controles creativos. No compares directamente una tarifa de API por segundo con un plan mensual sin tener en cuenta el uso incluido y el tipo de salida.
Sora: dar explicaciones sobre el cierre anunciado
OpenAI Aviso de retirada del mercado de Sora, publicado el 11 de septiembre de 2026, indicaba que los servicios web y de la aplicación habían dejado de estar disponibles el 26 de abril y fijaba el cierre de la API para el 24 de septiembre de 2026. Considera Sora como una cuestión de migración para un proyecto ya existente, más que como un punto de partida para un nuevo flujo de trabajo de vídeo. Consulta el aviso para ver si hay fechas modificadas e instrucciones de exportación actualizadas.

En Flujo de trabajo del storyboard de Sora, Guía explicativa de Sora 2 Pro y Guía de duración de Sora específica para cada versión Describe las características históricas. Utilízalas para identificar qué es lo que debe conservarse en un proyecto ya existente y, a continuación, compara Alternativas a Sora en relación con esos requisitos. Guarda el mensaje de solicitud, el material de referencia y el resultado completo juntos para poder evaluar una propuesta alternativa basada en las mismas instrucciones.
Compara los costes de las API con la misma carga de trabajo
La API cobra por los tokens de entrada y salida; una suscripción de usuario permite acceder al servicio en el marco de un plan. Mantenga estos presupuestos separados. El cálculo que figura a continuación se basa en 100 solicitudes, cada una con 10 000 tokens de entrada no almacenados en caché y 1 000 tokens de salida facturados: un total de 1 millón de tokens de entrada más 100 000 tokens de salida. Se trata de una carga de trabajo ilustrativa, no de una factura real ni de un punto de referencia de calidad.
USD, tarifas estándar de los tokens cotizados, consultadas el 15 de septiembre de 2026. Solicitudes cortas según lo especificado; sin descuento por caché, descuento por lote, nivel de prioridad, impuestos ni herramientas de pago. La asignación de salida incluye los tokens de razonamiento facturados, cuando proceda. Fuentes: Catálogo del modelo OpenAI, Descripción general del modelo Anthropic, Modelos y precios de la serie Grok.
El modelo más económico solo resulta útil si los resultados superan tus comprobaciones. Si un modelo más barato requiere intentos repetidos o correcciones manuales importantes, compara el coste por resultado aceptado. Empieza con un modelo más económico para tareas claras y repetitivas, y luego deriva los casos difíciles a un modelo más capaz cuando el primer resultado falle.
Las tasas en las que se basa el cálculo
| Modelo | Entrada / 1 millón de tokens | Salida / 1 millón de tokens |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| Grok 4,6 | $2.00 | $6.00 |
| Claude Soneto 5 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
Se trata de tarifas de la API, no de cuotas de suscripción mensuales. La carga de trabajo anterior mantiene fijos el tamaño de los datos de entrada y el tamaño de los datos de salida facturados; no da por sentado que la longitud, la precisión o la velocidad de los datos de salida en condiciones reales sean las mismas.
DeepSeek utiliza una tarifa diferente en función de la hora. Su tabla Flash actual (V4.1) indica una entrada sin caché de $0,15 en horas valle o $0,30 en horas punta, y una salida de $0,60 en horas valle o $1,20 en horas punta, por cada millón de tokens. V4 Pro indica $0,66/$1,32 para la entrada sin caché y $1,98/$3,96 para la salida. Los periodos de máxima actividad documentados son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes. Utiliza la tarifa que se aplique en el momento en que se ejecute el trabajo; los precios de entrada en caché deben incluirse en un cálculo aparte.
Para un flujo de trabajo mixto diario, La suscripción multimodelo de GlobalGPT Ofrece una forma más sencilla de gestionar de forma conjunta la investigación, la redacción, la ayuda con la codificación y la generación creativa. Compara esa comodidad y amplitud con la gestión de varias suscripciones o con la creación por tu cuenta de un flujo de trabajo mediante API. Una tabla de precios de la API no describe el precio de la suscripción ni las condiciones de uso.
De peso abierto o alojado: decide cuánto quieres gestionar
Los «open weights» te ofrecen una opción de implementación: ejecutar un modelo en un entorno que tú controlas. No implican automáticamente que todo el flujo de trabajo sea gratuito, privado o sin restricciones. Consulta la licencia asociada al modelo concreto, el hardware necesario para ejecutarlo y dónde envía la aplicación asociada los archivos o los registros.
- Elige una aplicación alojada cuando quieras ponerte en marcha rápidamente y no necesites manejar el modelo.
- Elige una API alojada cuando necesitas automatización sin tener que mantener hardware de inferencia.
- Plantéate la posibilidad de una implementación local cuando el trabajo sin conexión, el control de la infraestructura o un requisito específico de tratamiento de datos lo justifiquen.
- Compara modelos más pequeños en tu equipo antes de dar por hecho que un modelo insignia con más parámetros sea la opción más práctica.
Un modelo local puede reducir la transferencia de datos externos, pero el resto del sistema sigue siendo importante: la recuperación, los complementos, la telemetría, los historiales guardados y las copias de seguridad. Para un equipo, es mejor que se trate de una revisión de la implementación en lugar de una promesa que se deduzca de la palabra “abierto”. El Guía sobre la privacidad de los datos en la IA ofrece un contexto para comparar los requisitos en materia de tratamiento de datos.
¿Es mejor utilizar un modelo de IA o varios?
Un modelo es suficiente si gestiona bien tus tareas recurrentes. Añade otro cuando resuelva una carencia concreta: un mejor acceso a las fuentes, un tipo de entrada necesario, una edición de imágenes más controlable o una carga de trabajo por lotes más económica. Acumular suscripciones sin asignar una tarea a cada una de ellas genera más decisiones y más traspasos de responsabilidad.

Crea un flujo de trabajo en torno al producto final
| Trabajo | Secuencia útil | Comprobación de aceptación |
|---|---|---|
| Marketing | Fuentes de investigación → borrador → creación de elementos visuales → revisión de las afirmaciones | Las afirmaciones de la campaña están bien fundamentadas, y tanto el texto como las imágenes transmiten el mismo mensaje. |
| Desarrollo de software | Comprender el problema → modificar el código → ejecutar las pruebas → revisar las diferencias | El cambio cumple con el requisito sin provocar efectos imprevistos en otros ámbitos. |
| Creación de contenidos | Esquema → guion → imágenes de referencia → tomas de vídeo → montaje | Los personajes, los detalles del producto y la trama se mantienen coherentes. |
| Operaciones iniciales | Resumir las aportaciones → extraer conclusiones → elaborar un borrador de seguimiento | Las resoluciones tienen sus autores y sus fechas, y no se incluyen en el expediente hechos que no estén respaldados por pruebas. |
| Trabajo empresarial | Seleccionar un entorno autorizado → procesar los datos permitidos → revisar el resultado | El flujo de trabajo cumple con los requisitos de la organización en materia de acceso, datos y revisión. |
Empieza con un producto finalizado. Conserva las notas de origen y los controles de aceptación junto con el trabajo a medida que este se va trasladando de una herramienta a otra.
GlobalGPT se adapta al modelo de múltiples pasos al reunir en un solo lugar las familias de modelos y las funciones creativas. Conserva las notas de referencia útiles, el resumen y los criterios de aceptación junto con el trabajo mientras cambias de tarea. El Resumen de los modelos de IA «todo en uno» Es una lectura recomendada si la decisión principal se centra en la amplitud del ámbito de trabajo, más que en un único modelo especializado.
Cómo elegir: una evaluación en cinco pasos que puedes repetir
- Define un resultado final. Por ejemplo, un resumen de 500 palabras con referencias bibliográficas, un parche que supere tres pruebas o una imagen de un producto con dos etiquetas exactas.
- Elige dos candidatos plausibles. En primer lugar, compara los datos de entrada y las herramientas necesarias. No compares un asistente con función de búsqueda con un modelo al que no se le hayan proporcionado herramientas de recuperación y califiques la diferencia como «inteligencia del modelo».
- Utiliza el mismo pliego de condiciones y los mismos datos. Anota el modelo, el producto, los ajustes y la fecha. Guarda el primer resultado completo, en lugar de seleccionar solo el intento que mejor te quede.
- Comprueba que esté correcto antes de preocuparte por el estilo. Verifica las citas, realiza las pruebas de código pertinentes e inspecciona los detalles de las imágenes o los vídeos. Anota las correcciones que haya que hacer manualmente.
- Repasa los casos difíciles. Si la decisión es reñida o el resultado es contradictorio, repite esos casos y mantén los resultados adicionales por separado. Elige en función del resultado aceptado, el esfuerzo y el coste total.
En el caso de la redacción, una forma útil de comprobarlo es ver si todos los datos aportados se mantienen tras una reescritura. En el caso de la extracción de información, compara el resultado con una pequeña clave de respuestas. En el caso de la investigación, abre las páginas citadas. En el caso de los vídeos, guarda el clip completo y míralo. El Metodología de prueba de modelos GlobalGPT ofrece información adicional para realizar comparaciones de registros.
Evita cuatro errores comunes: basarte en la popularidad, comparar unidades de precio que no son comparables, considerar un único punto de referencia como si fuera la tarea completa e ignorar el tiempo de revisión que requiere un resultado. Ninguno de estos problemas se soluciona simplemente eligiendo el nombre del modelo más reciente. Una evaluación repetible resulta más útil, ya que puede volver a realizarse cuando cambia un modelo.
Preguntas frecuentes
¿Cuál es el mejor modelo de IA en este momento?
No hay una opción que sea la mejor para todos los casos. Empieza por las opciones actuales de GPT, Claude, Gemini, Grok, DeepSeek o Qwen para texto y código, y luego reduce las opciones en función de tu tarea, las herramientas necesarias, los datos de entrada y tu presupuesto. Utiliza un modelo específico para imágenes o vídeo cuando el resultado final lo requiera.
¿Qué modelo de IA debería probar para programar?
Elige candidatos que se adapten a tu flujo de trabajo de desarrollo, como los modelos actuales GPT, Claude, Gemini o Qwen. Compáralos utilizando el mismo problema, el mismo código y las mismas pruebas. Un cambio que se apruebe con un esfuerzo de revisión mínimo es un mejor criterio de selección que una explicación convincente.
¿Es siempre mejor una ventana de contexto más grande?
Una ventana de contexto más amplia permite incluir más material en una solicitud, pero no garantiza una recuperación precisa ni un razonamiento adecuado sobre dicho material. Comprueba si el modelo es capaz de localizar el pasaje, la página o el fotograma exactos que se necesitan para dar respuesta a tu pregunta.
¿Son gratuitos los modelos de IA de peso abierto?
Es posible que los modelos estén disponibles bajo una licencia, pero su ejecución puede requerir hardware, alojamiento y mantenimiento. Comprueba el modelo exacto de licencia y el coste de implementación. Una implementación local también requiere un análisis de la aplicación en la que se integra y de su gestión de datos.
¿El Grok detecta automáticamente las noticias en directo?
No. La documentación de la API Grok indica que la información actual requiere herramientas de búsqueda como Web Search o X Search. Los conocimientos de entrenamiento de un modelo y las fuentes recuperadas durante una solicitud son cosas diferentes.
¿Puedo comparar los precios de la API con los de una suscripción mensual a la IA?
Solo después de definir la carga de trabajo y lo que incluye cada ruta. Las tarifas de las API suelen calcularse por tokens o por volumen de salida multimedia, mientras que una suscripción ofrece acceso según las condiciones de uso específicas de cada plan. Compara el coste total del flujo de trabajo que tienes previsto, al igual que harías con los precios anunciados.
¿El modelo de IA más popular tiene por qué ser el mejor para mí?
No. La popularidad no indica si un modelo gestiona tus archivos, cumple tus restricciones o se ajusta a tu presupuesto. Utiliza la documentación actual para elaborar una lista de candidatos y, a continuación, compara los resultados reales con una tarea que puedas verificar.
Elige el modelo que permita completar el próximo trabajo con el menor número posible de correcciones evitables. Empieza poco a poco, toma nota de lo que funciona y añade otro modelo solo cuando resuelva un problema concreto. Si tu trabajo abarca la investigación, la redacción y la creación, Prueba ese flujo de trabajo en GlobalGPT y evalúa el resultado final.