
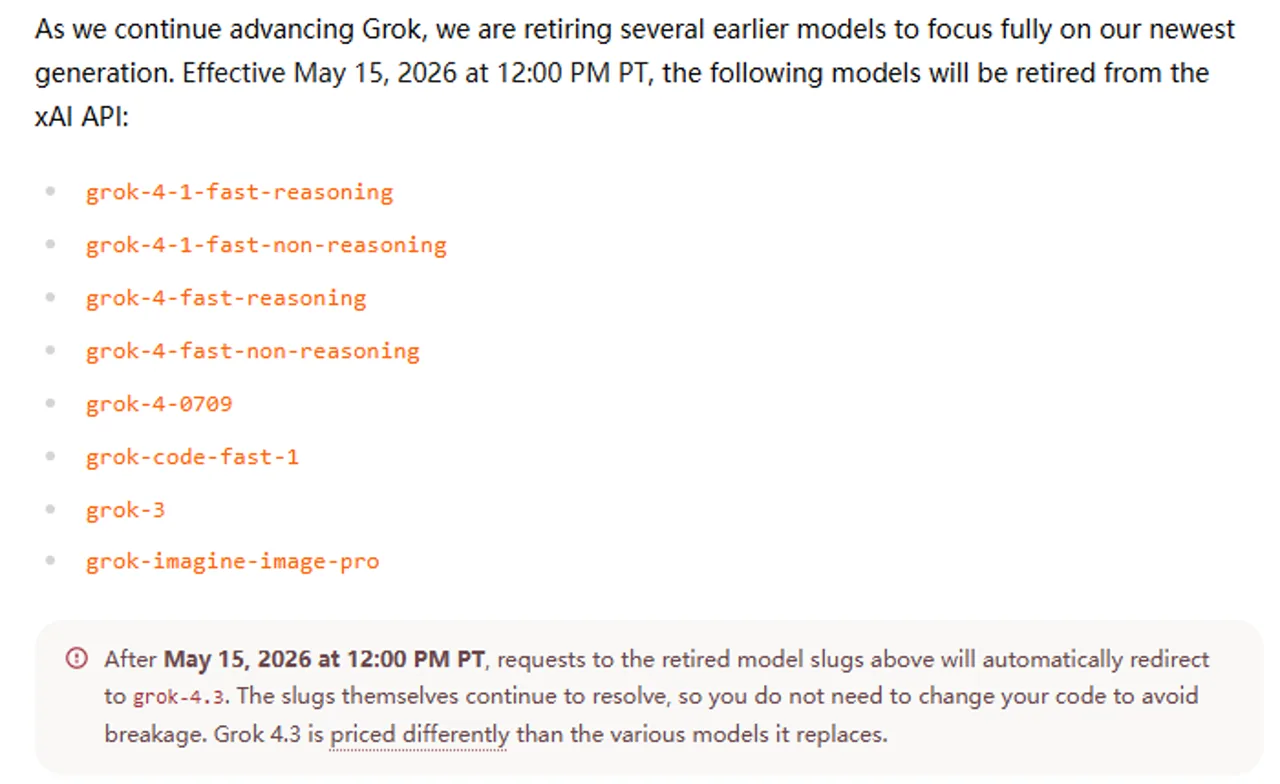
Eine App entwickeln oder das Budget für einen Agenten planen? Beginnen Sie mit dem Modell, das Sie tatsächlich einsetzen werden. Das Mitteilung zur Umstellung am 15. Mai 2026 Es heißt, dass die ursprüngliche ID „Grok 4“ nun mit geringem Argumentationsaufwand zu „Grok 4.3“ aufgelöst wird. Ein erfolgreicher Aufruf einer alten ID beweist nicht mehr, dass das ursprüngliche Modell diese bereitgestellt hat.
Die API-Nutzung wird unabhängig von den Verbraucherabonnements von Grok abgerechnet. Preise für Abonnements und Zugangsrechte für Grok umfasst die Chat-Tarife; bei diesen monatlichen Gebühren handelt es sich nicht um Guthaben für eine direkte xAI-Integration.
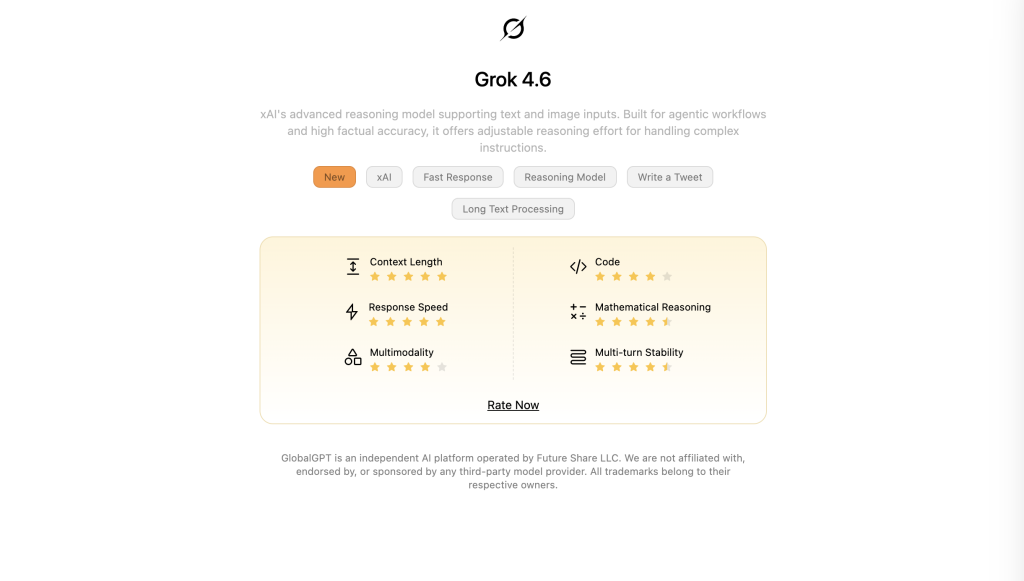
Möchten Sie eine Eingabeaufforderung ausprobieren, bevor Sie sie in eine App integrieren? Probieren Sie Grok 4.6 auf GlobalGPT aus für einen chatbasierten Workflow. Verwenden Sie einen xAI-API-Schlüssel für Ihre eigene Integration und die direkte Abrechnung über xAI. Dieser Artikel wurde von GlobalGPT veröffentlicht; Produktlinks enthalten Empfehlungs-Tracking.
Grok 4 API-Preise: aktuelle Tarife und die außer Kraft gesetzte ursprüngliche Fassung
In der folgenden Tabelle werden xAI-Listenpreise, überprüft am 8. September 2026. Jeder Betrag ist in US-Dollar pro einer Million Token angegeben. Eingabe, zwischengespeicherte Eingabe und Ausgabe sind separate Abrechnungskategorien, sodass ein einziger gemischter “Preis pro Million” die tatsächlichen Kosten der Arbeitslast verschleiert.
USD pro 1 Mio. Token · Standardabwicklung
grok-4.3
Original Grok 4 – Weiterleitungsziel
Kontext: 1.000.000 Token
Eingabe < 200.000
- Eingabe
- $1.25
- Zwischengespeicherte Eingabe
- $0.20
- Ergebnis / Begründung
- $2.50
Eingabe >= 200K
- Eingabe
- $2.50
- Zwischengespeicherte Eingabe
- $0.40
- Ergebnis / Begründung
- $5.00
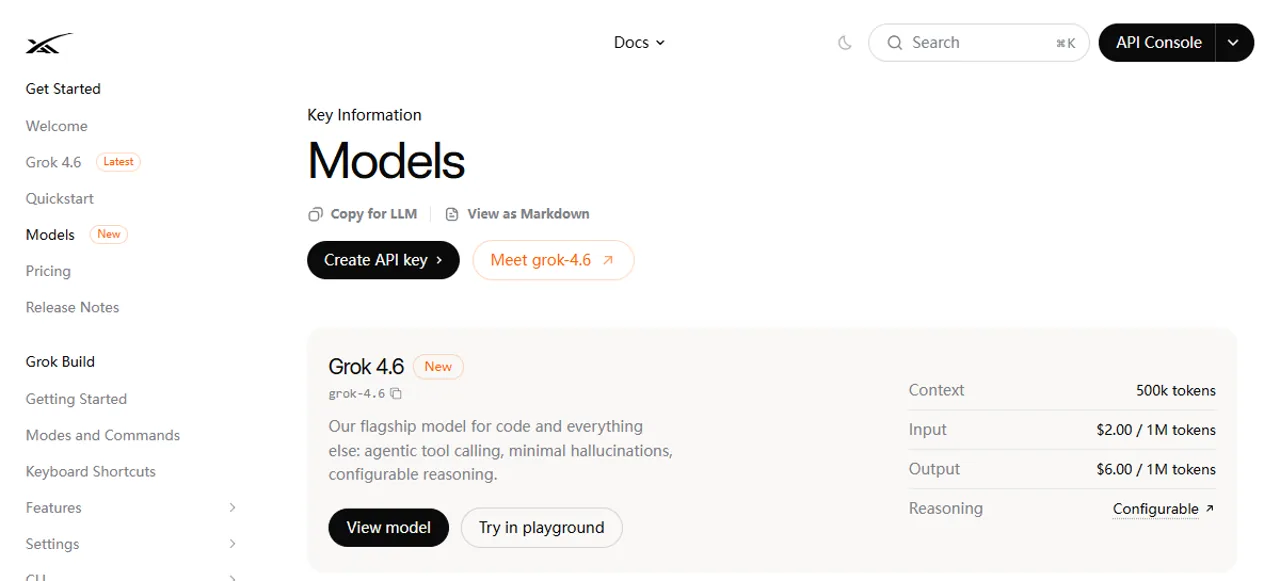
grok-4.6
Aktuelles Flaggschiff
Kontext: 500.000 Token
Eingabe < 200.000
- Eingabe
- $2.00
- Zwischengespeicherte Eingabe
- $0.50
- Ergebnis / Begründung
- $6.00
Eingabe >= 200K
- Eingabe
- $4.00
- Zwischengespeicherte Eingabe
- $1.00
- Ergebnis / Begründung
- $12.00
grok-4.5
Frühere Option der aktuellen Generation
Kontext: 500.000 Token
Eingabe < 200.000
- Eingabe
- $2.00
- Zwischengespeicherte Eingabe
- $0.30
- Ergebnis / Begründung
- $6.00
Eingabe >= 200K
- Eingabe
- $4.00
- Zwischengespeicherte Eingabe
- $0.60
- Ergebnis / Begründung
- $12.00
Sobald die Eingabe 200.000 Token erreicht, gelten für alle Token in dieser Anfrage die Tarife für lange Kontexte, einschließlich der Ausgabe.
Die weiteren aufgeführten Grok-4-Familien-IDs lauten grok-4.20-0309-reasoning, grok-4.20-0309-ohne-Schlussfolgerungen und grok-4.20-multi-agent-0309. Jede verfügt über ein Kontextfenster von 1 Mio. Token und weist dieselben aufgeführten Kurz-/Lang-Token-Sätze auf wie Grok 4.3. Der übereinstimmende Stückpreis bedeutet nicht zwangsläufig einen übereinstimmenden Gesamt-Token-Verbrauch, insbesondere bei Arbeiten mit mehreren Agenten.
Für eine programmierungsspezifische Alternative, grok-build-0.1 verfügt über ein Kontextfenster von 256K und Eingabe-/Cache-/Ausgabegeschwindigkeiten bei kurzem Kontext von $1,00/$0,20/$2,00, die bei der 200K-Prompt-Schwelle auf $2,00/$0,40/$4,00 ansteigen. Weitere Informationen zum allgemeinen Verhalten und zu Anwendungsfällen finden Sie in unserem Grok 4.6 Bewertung.
Was ist mit dem ursprünglichen Preis für $3 / $15 passiert?
Ältere Quellen, darunter auch unsere Grok 4 – Leitfaden zur API-Integration, Preisangabe $3 pro Million Eingabe-Token und $15 pro Million Ausgabe-Token für das ursprüngliche Modell Grok 4. Betrachten Sie dies als historische Preisangabe und nicht als die heutige Rechnung für ein auslaufendes Modell. Die alte offizielle Modell-URL führt nun zum allgemeinen Modellkatalog; es handelt sich also nicht um ein neu verifiziertes Archiv-Preislistenblatt.
Die Original Grok 4 – Ankündigung bezieht sich auf ein Kontextfenster mit 256.000 Token. Diese historische Kapazität sowie ältere Preise oder Schwellenwerte des Fast-Modells dürfen nicht in ein Budget für den Ersatz übernommen werden. Die genaue Regel für grok-4-0709 beträgt nun Grok 4.3 bei geringem Denk- und Arbeitsaufwand und wird zu den Sätzen von Grok 4.3 abgerechnet.
Grok 4 ist eine Modellgeneration, während Grok zugleich der Name eines Verbraucherprodukts ist. Unser Erläuterung dazu, was Grok 4 ist liefert diese Produktinformationen. Wählen Sie bei neuem Code explizit ein unterstütztes Modell aus, anstatt sich auf eine Weiterleitung bei Auslauf des Modells zu verlassen oder davon auszugehen, dass der Alias eines Anbieters unverändert bleibt.
Wie sich Eingaben, zwischengespeicherte Eingaben und Schlussfolgerungen auf die Rechnung auswirken
Eine Anfrage, drei symbolische Gebühren
Nicht zwischengespeicherte Eingabe
(I – C) × Zufuhrrate
I = alle Prompt-Token; C = zwischengespeicherte Prompt-Token.
Zwischengespeicherte Eingabe
C × Cache-Rate
Zwischengespeicherte Tokens sind Teil der Eingabe und keine zusätzliche Eingabe.
Abrechnungsfähige Leistung
O × Ausbringungsrate
O berücksichtigt die Begründung, wenn der Endpunkt diese in der Ausgabe angibt.
Geschätzter Token-Wert in USD = [(I – C) × Eingangsrate + C × zwischengespeicherte Eingangsrate + O × Ausgangsrate] / 1.000.000. Fügen Sie anschließend die entsprechenden Werkzeug-, Lager- oder sonstigen Kosten hinzu. Wählen Sie vor der Berechnung die Tarife für den langen Kontext anhand der Gesamtabfrage aus, einschließlich der zwischengespeicherten Token.
Zu den Eingaben gehören die Nachrichten, Anweisungen und der Konversationsverlauf, die an das Modell gesendet wurden. Beim Caching wird ein identisches Startpräfix für alle Anfragen wiederverwendet; dies geschieht automatisch, und xAI empfiehlt die Verwendung einer Konversations-ID, um die Wiederverwendbarkeit zu verbessern. Eine ähnlich aussehende Eingabeaufforderung garantiert keinen Cache-Treffer. Die Dokumentation zum Prompt-Caching erklärt das Abgleichverhalten.
Lesen Sie unter „Chat-Vervollständigungen“ prompt_tokens_details.cached_tokens; unter „Antworten“ steht input_tokens_details.cached_tokens. Das Übersicht über Cache-Nutzung und Preise Rechnungen werden mit der vollen Fertigstellungsrate abgerechnet. Wenn die Gesamtsumme bereits die Berechnung enthält, wird durch Hinzufügen Argumentations-Token würde es erneut doppelt zählen.
Grok 4.6 unterstützt die Stufen „niedrig“, „mittel“, „hoch“ und „xhoch“ für den Kombinationsaufwand; die dokumentierte Standardeinstellung ist „hoch“, und die Kombinationsfunktion kann nicht deaktiviert werden. Grok 4.3 unterstützt die Stufen „keine“, „niedrig“, „mittel“ und „hoch“. Daher lohnt es sich, Grok 4.3 mit der Einstellung „none“ für strenge Extraktionsaufgaben in Betracht zu ziehen, während Grok 4.6 möglicherweise mehr Tokens verbraucht, selbst wenn die sichtbare Antwort kurz ist. Siehe die Einstellungen für die Schlussfolgerung sowie den obenstehenden Modelleintrag für Grok 4.3.
Tool-Aufrufe, Stapelverarbeitung und Prioritätsanfragen
Gemäß der Offizielle Preisliste für Werkzeuge, Websuche, X-Suche und Codeausführung kosten jeweils $5 pro 1.000 Aufrufe bzw. $0,005 pro Aufruf, zuzüglich des Tokenverbrauchs. Eine Anfrage kann Tools mehrmals aufrufen. Zehn Suchaufrufe erhöhen die Kosten um $0,05 vor den Modell-Token; die Aktivierung eines Tools gibt keinen Aufschluss darüber, wie oft es verwendet wird.
Die Suche nach Dateianhängen kostet $10 pro 1.000 Abfragen; die Suche nach Sammlungen kostet $2,50 pro 1.000. Für gespeicherte Dateien und Sammlungen fallen zudem tägliche Speicher- und Downloadgebühren an. Für Bilder und Videos gelten eigene Preiseinheiten; berücksichtigen Sie diese daher nicht bei einer Schätzung auf Basis von reinen Text-Tokens. Unsere Anleitung zum Bild- und Video-Workflow mit Grok umfasst diesen separaten Erzeugungsweg.
Die Batch-API bietet einen Rabatt von 20%-Token für Grok 4.3 und die drei aufgeführten Grok 4.20-Varianten. Der Rabatt gilt für Eingabe-, zwischengespeicherte Eingabe-, Ausgabe- und Schlussfolgerungstoken. Auf der Modellseite von Grok 4.6 ist die Batch-API als nicht unterstützt gekennzeichnet. Wenden Sie keinen pauschalen 50%-Rabatt an und gehen Sie nicht davon aus, dass jedes aufgeführte Modell die Stapelverarbeitung unterstützt.
Vorrangige Bearbeitung kostet das Doppelte der Standard-Token-Sätze, einschließlich Cache- und Reasoning-Token, wenn die zurückgegebene Service-Stufe bestätigt Priorität. Bei einem Rückgriff auf die Standardstufe gelten die Standardtarife. Die Priorität gilt für Chat-Abschlüsse und Antworten, nicht für die Batch-API.
Drei Beispiele für transparente API-Kosten
Es handelt sich hierbei um geschätzte Listenpreise, nicht um tatsächliche Rechnungsbeträge. Alle unten aufgeführten Anfragen werden standardmäßig verarbeitet: nur Text, keine Tools, kein Speicherplatz, keine Wiederholungsversuche und keine Steuern. “Ausgabe” umfasst jegliche abrechnungsfähige Begründung. Bei den ersten beiden Workloads wird von Eingaben mit weniger als 200.000 Tokens ausgegangen.
Kosten pro Anfrage und pro 10.000 Anfragen
Grok 4.3 · kein Cache
$0.005 / Anfrage
2.000 Eingänge × $1,25 + 1.000 Ausgänge × $2,50, geteilt durch 1 Mio. 10.000 Anfragen = $50.
Grok 4,6 · kein Cache
$0.010 / Anfrage
2.000 Eingänge × $2 + 1.000 Ausgänge × $6, geteilt durch 1M. 10.000 Anfragen = $100.
Grok 4,6 · 90% im Cache gespeichert
$0.0073 / Anfrage
200 nicht zwischengespeichert × $2 + 1.800 zwischengespeichert × $0,50 + 1.000 Ausgabe × $6, geteilt durch 1 Mio. 10.000 Anfragen = $73.
Eine hohe Cache-Trefferquote ist vor allem dann von Vorteil, wenn die Eingabe den Großteil der Arbeitslast ausmacht. In diesem Beispiel mit Grok 4.6 spart das Caching $0,0027 pro Aufruf oder 27% der Gesamtsumme ein, obwohl 90% der Eingabetoken zwischengespeichert sind. Die Ausgabekosten bleiben bei $0,006. Bewerten Sie die Einsparungen im Verhältnis zur gesamten Anfrage, nicht nur zum zwischengespeicherten Teil.
Der Schwellenwert von 200.000 Zeichen kann die gesamte Anfrage verändern.
Ein weiteres Input-Token überschreitet die Preisschwelle
199.999 Prompt-Token
$0.459998
Grok 4,6: (199.999 × $2 + 10.000 Ausgänge × $6) / 1M. Kein Cache.
200.000 Prompt-Token
$0.920000
Grok 4,6: (200.000 × $4 + 10.000 Ausgang × $12) / 1M. Kein Cache.
Das Wichtigste In der Preistabelle wird ausdrücklich “Langer Kontext >= 200.000 Token” verwendet.” und besagt, dass für alle Token der höhere Tarif gilt, sobald die Abfrage den Schwellenwert erreicht. In einem Text mit Modelldetails heißt es, dass 200.000 “überschritten” werden. Für die Budgetierung bei genau 200.000 sollten Sie die explizite Grenze der Preistabelle verwenden; gehen Sie nicht davon aus, dass der günstigere Tarif weiterhin gilt.
Für eine monatliche Prognose sollten Sie das voraussichtliche Anforderungsvolumen für jede Arbeitslast, jedes Kontextband, jedes Cache-Treffermuster und jede Schlussfolgerungseinstellung separat schätzen. Rechnen Sie die erwarteten Wiederholungsversuche und Tool-Aufrufe hinzu. Vergleichen Sie diese Schätzung anschließend mit Ihren eigenen Kostendaten, die Sie nach einem kleinen Pilotprojekt erhalten haben. Ein Wert in Cent pro Aufruf ist nur dann aussagekräftig, wenn die zugrunde liegenden Annahmen mit den tatsächlichen Produktionsbedingungen übereinstimmen.
Kontext, Ausgabe, Ratenbegrenzungen und Ausgabenobergrenzen unterscheiden sich voneinander
Vier Grenzwerte, die vor der Skalierung zu überprüfen sind
Kontextfenster
Auf Anfrage
Grok 4.3: 1 Million Token. Grok 4.6: 500.000. Dabei handelt es sich nicht um ein monatliches Kontingent.
Ausgabenbudget
Pro Antwort
Legen Sie eine unterstützte Ausgangsleistung fest. Die Kontextkapazität garantiert nicht, dass eine entsprechend hohe sichtbare Leistung erzielt wird.
RPS / TPM
Durchsatz
Anfragen pro Sekunde und Token pro Minute. Beide Werte müssen innerhalb der Team-Stufe bleiben.
Ausgabenkontrolle
Geld
Das Guthaben auf Prepaid-Karten, die automatische Aufladung und die Rechnungslimits steuern das jeweilige Aufladeverhalten.
Die Öffentlichkeit Ratenbegrenzungstabelle Für Grok 4.3 werden in der Liste Tier 0 mit 37 Anfragen pro Sekunde und 10 Millionen Tokens pro Minute angegeben; für Grok 4.6 sind 150 Anfragen pro Sekunde und 50 Millionen Tokens pro Minute aufgeführt. Hierbei handelt es sich um veraltete, veröffentlichte Tier-Einträge und nicht um eine Zusicherung, dass jeder Schlüssel über die gleiche nutzbare Kapazität verfügt. Die Konsole Ihres Teams ist maßgeblich für den aktuellen Modellzugriff und die aktuellen Limits.
Die Stufen richten sich nach den kumulierten API-Ausgaben seit dem 1. Januar 2026: $0, $50, $250, $1.000 und $5.000 für die Stufen 0 bis 4. Anfragen werden pro Sekunde gedrosselt, indem das pro Minute verfügbare Anfragebudget durch 60 geteilt wird; somit können Sie die Zuteilung einer ganzen Minute nicht in einem einzigen Durchgang aufbrauchen. Eingabe-, Ausgabe-, Schlussfolgerungs- und zwischengespeicherte Token werden alle auf das TPM angerechnet, auch wenn einige davon weniger kosten.
Auf den geprüften Modellseiten zu den Modellen Grok 4.3 und 4.6 werden Kontextgrößen ohne separaten festen Maximalwert für die Ausgabeleistung angegeben. Der aktuelle Referenz zum Endpunkt „Responses“ definiert max_output_tokens als kombiniertes Budget für Ausgabe und Schlussfolgerung: Der Standardwert beträgt 128.000, wenn dieser Parameter nicht festgelegt ist, und es können höhere Werte für längere Generationen angegeben werden. Dieser Standardwert garantiert weder 128.000 sichtbare Antwort-Token noch eine unbegrenzte Kontextlänge. Legen Sie ein explizites Budget fest und überprüfen Sie unvollständige Antworten.
xAI-Abrechnungsdokumentation trennt Prepaid-Guthaben von der monatlichen Rechnungsabrechnung, die standardmäßig deaktiviert ist. Durch die automatische Aufladung kann das Prepaid-Guthaben aufgefüllt werden; hierfür gelten eigene Schwellenwerte und ein monatliches Kontingent. Ein Rechnungslimit regelt die Nutzung im Postpaid-Bereich; dies ist nicht dasselbe wie eine einheitliche Pauschalobergrenze für Prepaid-Käufe, Aufladungen und Anfragen.
Beginnen Sie bei Ihrer ersten Integration mit einem begrenzten Prepaid-Guthaben und prüfen Sie alle Einstellungen für die automatische Aufladung sorgfältig. Für den täglichen Chat-Zugang ohne Programmierung der Integration steht die separate Anleitung zur Verwendung des Grok umfasst den Produkt-Workflow. Ein Chat-Abonnement und ein API-Team verfügen über unterschiedliche Steuerungsmöglichkeiten.
Zwei echte Grok-4.6-Aufgaben: Was die Nutzungsdaten verraten
Wir haben zwei abgeschlossene Tests vom 7. September 2026 über die Broly-Aggregations-API unter https://anywhere.broly.ai/v1, unter Verwendung von Chat-Vervollständigungen. Sowohl angefordert als auch zurückgegeben grok-4.6; die Identität des vorgelagerten Modells wurde nicht unabhängig überprüft. Es handelt sich hierbei um Ergebnisse des Grok 4.6-Gateways, nicht um die ursprünglichen Grok 4-Tests oder einen Vergleich zwischen verschiedenen Modellen.
Jede Aufgabe wurde einmal ausgeführt mit Temperatur=0, max_tokens=2048 und stream=false. Es wurden weder Hilfsmittel noch explizite Vorgaben zum Denkprozess übermittelt. Für beide Anfragen wurde dieselbe Systemanweisung verwendet:

