GPT-6 Astra und Claude Fable 5.1 haben zwar denselben API-Listenpreis, zeigten jedoch in unseren Kompatibilitäts-API-Tests unterschiedliche Ergebnisse. Astra lieferte in den Bereichen logisches Denken, Schreiben, Programmieren, Abruf von Langtextkontexten und Strategie insgesamt mehr verwertbare Ergebnisse. Fable erzielte im Test zur Genauigkeit bei Langtextkontexten das gleiche Ergebnis wie Astra und verfasste überzeugende Werbetexte, doch bei dieser speziellen Aufgabe waren mehrere Durchläufe unvollständig oder leer.

Kurzfazit
GPT-6 Astra · 43/50
Abfrage im langen Kontext · jeweils 10/10
Das Kompatibilitäts-Routing könnte die leeren Ausgaben von Fable erklären.
Entscheiden Sie sich für GPT-6 Astra, wenn Sie eine zuverlässige Erstantwort für gemischte analytische und technische Aufgaben benötigen. Entscheiden Sie sich für Claude Fable 5.1, wenn Ihr eigener Endpunkt für die Verarbeitung sichtbarer Ausgaben validiert wurde und Sie dessen Interpretation langer Kontexte oder seine wohlabgewogene Ausdrucksweise schätzen. Dies ist keine allgemeine Modellrangliste: Es handelt sich um einen kontrollierten Durchlauf über Broly Anywhere am 8. September 2026.
GPT-6 Astra vs. Claude Fable 5.1 auf einen Blick
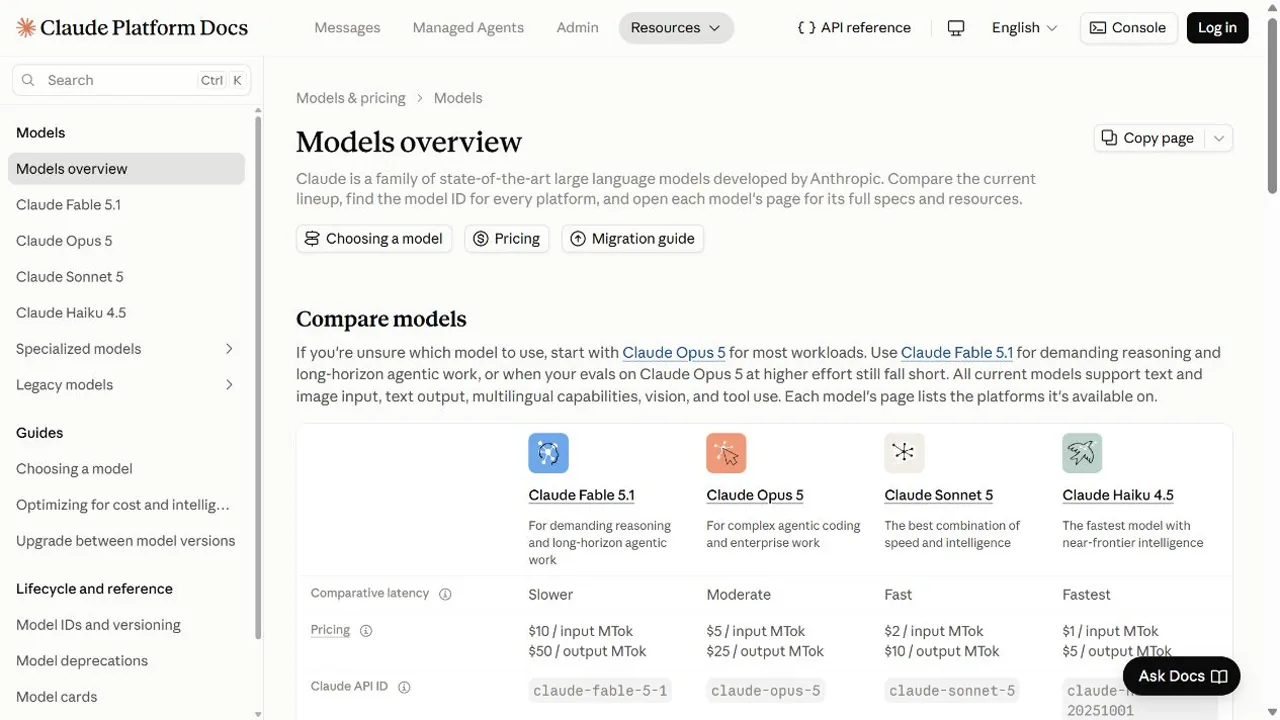
| Feld | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| API-ID | gpt-6-astra | claude-fable-5-1 |
| Kontext | 1,05 Mio. Token | 1 Million Token |
| Maximale Leistung | 128K Token | 128K Token |
| Basis-Eingabe | $10 / 1M | $10 / 1M |
| Zwischengespeicherte Eingabe / Treffer | $1 / 1M | $0,25 / 1M |
| Ausgabe | $50 / 1M | $50 / 1M |
| Charge | 50% gemäß Norm | $5 Eingang / $25 Ausgang pro 1M |
| Begründung | Konfigurierbarer Aufwand für die Schlussfolgerung | Adaptives Denken, stets aktiv; hohe Standardstufe |
| Ermittelte Testergebnisse | 43/50 | 19/50 |
Weitere Informationen zum Modell finden Sie in unserem Testbericht zum GPT-6 Astra, Claude Fable 5.1-Anleitung, und Modellvergleich Claude.
Preisgestaltung, Zwischenspeicherung, Kontext und Beschränkungen
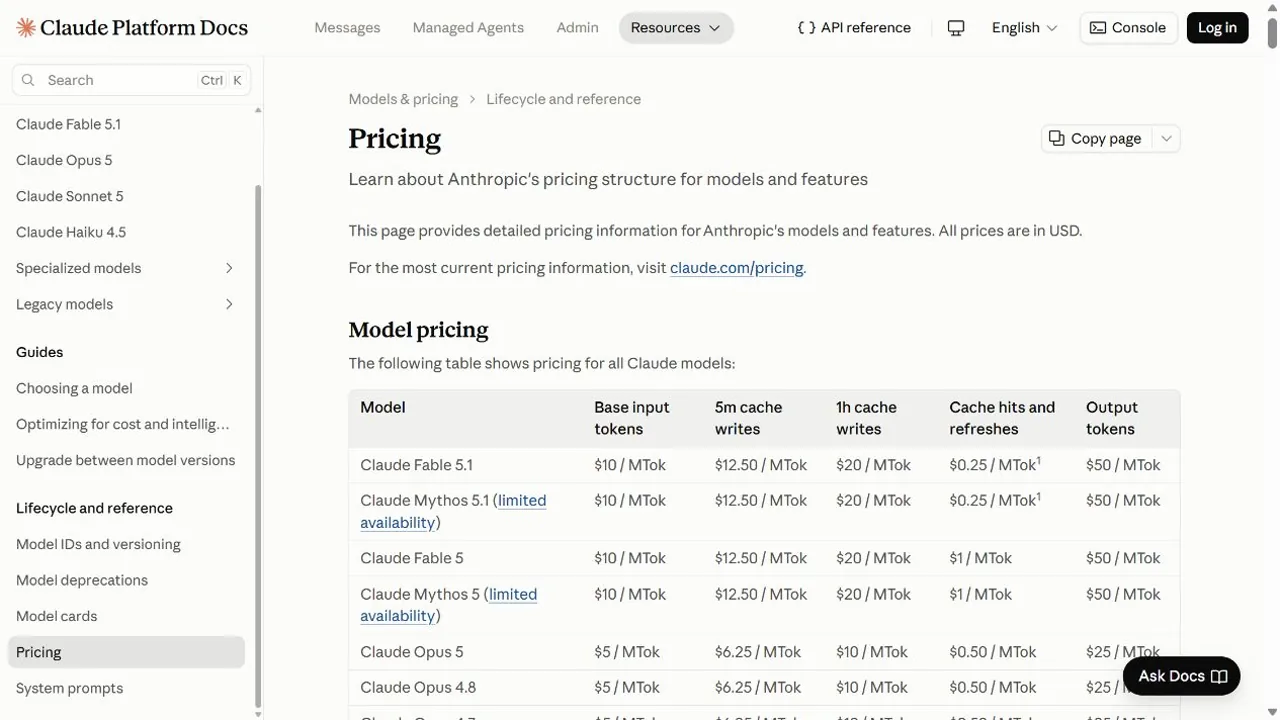
Beide Modelle weisen $10 pro Million Eingabe-Tokens und $50 pro Million Ausgabe-Tokens auf. Der operative Unterschied liegt im Caching. GPT-6 Astra weist $1 pro Million zwischengespeicherter Eingabe-Tokens und eine Cache-Schreibrate von $12,50 auf. Fable 5.1 gibt $0,25 Cache-Treffer, $12,50 Schreibvorgänge pro fünf Minuten und $20 Schreibvorgänge pro Stunde pro Million Token an. Anthropic gibt an, dass der vollständige 1-M-Kontext weiterhin zum Standardpreis berechnet wird; Astra wendet höhere Preise an, sobald die Eingabe 272.000 Token überschreitet.
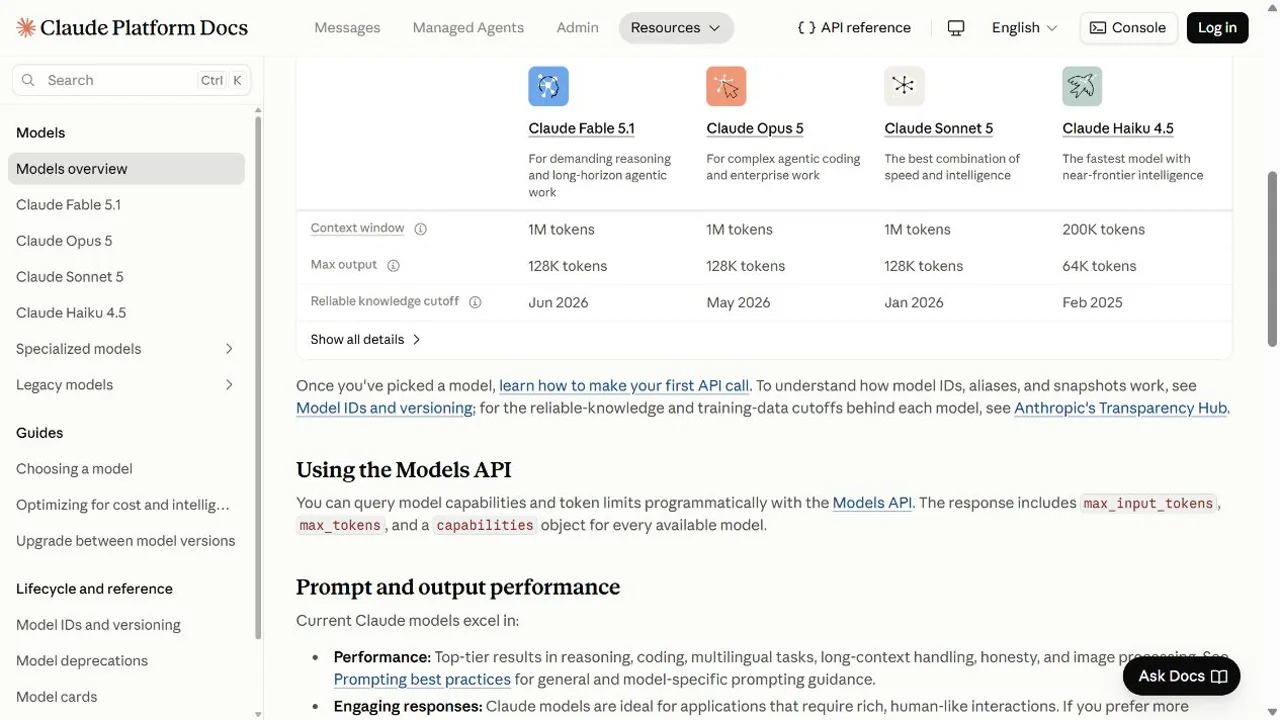
Lesen Sie den vollständigen Artikel Preisaufschlüsselung für GPT-6 Astra oder vergleichen Sie es mit unserem Claude Fable-Preisübersicht. Die Listenpreise der Anbieter entsprechen nicht automatisch den GlobalGPT-Gutschriften oder der Abrechnung über die Kompatibilitätsschicht.
Fünf übereinstimmende API-Tests
Wir haben dieselbe Aufgabe über denselben OpenAI-kompatiblen Endpunkt an jede Modell-ID gesendet. Bei den Tests 1–4 waren bis zu 2.000 Ausgabetoken zulässig. Bei Test 5 wurden jeweils 1.200 verwendet, nachdem das Gateway längere Nicht-Streaming-Anfragen nach etwa 30 Sekunden abgebrochen hatte. Jede Bewertung basiert auf fünf vor dem Test festgelegten Regeln. Ein leeres Ergebnis wird für unsichtbare Arbeit nicht gewertet.
Begründung: Entscheidung über SaaS-Kosten
Astra hat das Finanzmodell fertiggestellt; Fable ist bei den Annahmen ins Stocken geraten.
Genaue Aufgabe anzeigen
HTTP 200 · 28,98 s · 242 Eingaben · 1.427 abgeschlossene Aufgaben · Bewertung 10/10
HTTP 200 · 26,01 s · 357 Eingaben · 2.000 abgeschlossene Aufgaben · Punktzahl 1/10
Text: Überarbeitung zur Produkteinführung
Beide lieferten brauchbare Texte, doch „Fable“ fügte Details hinzu, die in den Notizen fehlten.
Genaue Aufgabe anzeigen
HTTP 200 · 15,47 s · 165 Eingaben · 500 abgeschlossen · Bewertung 10/10
HTTP 200 · 26,01 s · 263 Eingaben · 1.881 abgeschlossene Aufgaben · Bewertung 8/10
Programmierung: Parallelität in TypeScript
Astra lieferte eine aussagekräftige Diagnose und Teilergebnisse; Fable lieferte auf diesem Weg keine sichtbaren Ergebnisse.
Genaue Aufgabe anzeigen
HTTP 200 · 41,54 s · 181 Eingaben · 2.000 abgeschlossene Aufgaben · Bewertung 9/10
HTTP 200 · 29,44 s · 277 Eingaben · 2.000 abgeschlossene Aufgaben · Punktzahl 0/10
Umfassender Kontext: eingefügte Änderung
Beide haben die maßgebliche Änderung von § 417 gefunden und zitiert.
Genaue Aufgabe anzeigen
HTTP 200 · 14,96 s · 99.495 Eingaben · 244 abgeschlossene Aufgaben · Bewertung 10/10
HTTP 200 · 22,24 s · 295.912 Eingaben · 1.053 abgeschlossene Aufgaben · Bewertung 10/10
Strategie: 90-Tage-Plan für die Markteinführung
Astra startete einen fundierten Plan, der jedoch vorzeitig abgebrochen wurde; Fable lieferte keine erkennbare Antwort.
Genaue Aufgabe anzeigen
HTTP 200 · 34,27 s · 210 Eingaben · 1.200 Abschlüsse · Bewertung 4/10
HTTP 200 · 21,09 s · 338 Eingaben · 1.200 Abschlüsse · Punktzahl 0/10
Für welches Modell sollten Sie sich entscheiden?
- Argumentation und operative Entscheidungen: Astra hat in diesem Durchgang eine deutlich rundere Leistung gezeigt.
- Schreiben: Beide waren brauchbar; Astra hielt sich genauer an die Notenvorlage, während Fable zwar ausgefeilt klang, aber bestimmte Details der Notensätze frei interpretierte.
- Codierung: Astra lieferte die aussagekräftigere visuelle Diagnose. Vergleichen Sie die umfassenderen Muster in unserer Leitfaden zur Kodierung von Claude und ChatGPT.
- Lange Dokumente: Beide haben den Widerspruch genau erkannt. Die Token-Abrechnung wies erhebliche Unterschiede auf, prüfen Sie daher die Kosten anhand Ihrer eigenen Unterlagen.
- Agentische Strategie: Keiner von beiden hat die Aufgabe unter den vorgegebenen Bedingungen innerhalb der Frist abgeschlossen; Astra hat dennoch brauchbare Teilergebnisse geliefert.
Einen weiteren Benchmark-Frame finden Sie unter GPT-6 Astra vs. GPT-5.6 Sol oder Claude Fable 5 gegen GPT-5.5.
So vergleicht man beide in GlobalGPT
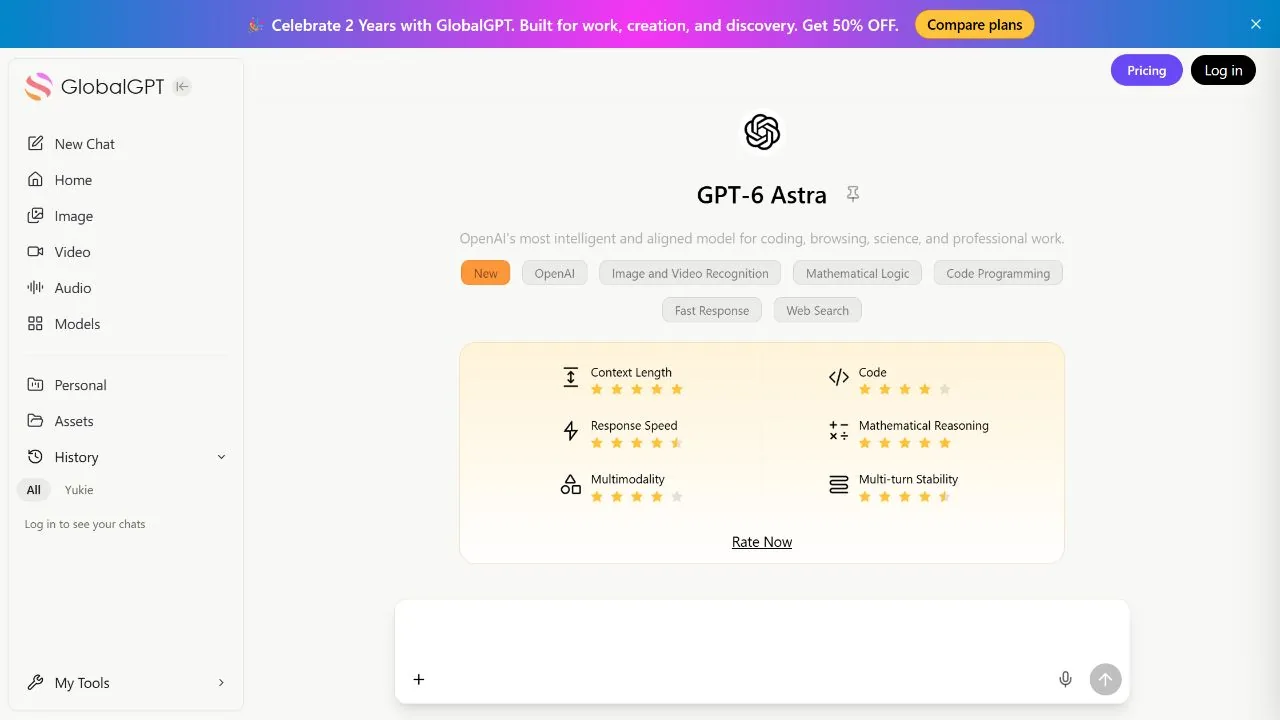
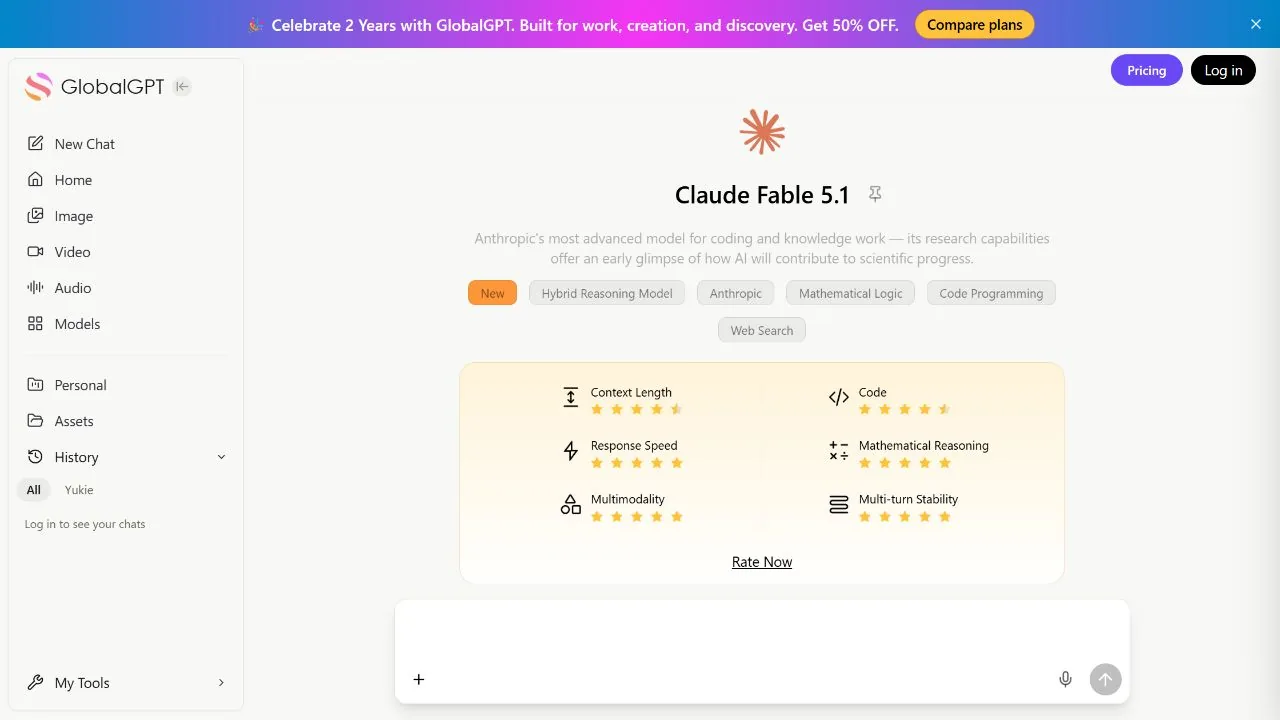
GlobalGPT stellt für beide Modelle separate Ausgabewege bereit. Verwenden Sie dieselbe Eingabeaufforderung, dieselbe Ausgabebeschränkung und dasselbe Ausgangsmaterial und bewerten Sie zunächst die sichtbare Korrektheit, bevor Sie den Stil beurteilen. Erfassen Sie die Latenz und die Token-Verwendung, sofern diese von der Schnittstelle oder der API zurückgegeben werden. Bei langen Dokumenten sollten Sie jeden Ausgabeweg separat messen, da identischer Text unterschiedlich tokenisiert werden kann.
Häufig gestellte Fragen
Ist GPT-6 Astra günstiger als Claude Fable 5.1?
Ihre Basis-Listenpreise für Ein- und Ausgänge sind identisch. Die Preisgestaltung bei Cache-Treffern und die Regeln für lange Kontexte unterscheiden sich, während bei der GlobalGPT-Abrechnung möglicherweise separate Gutschriften verwendet werden.
Welches Modell hat das größere Kontextfenster?
GPT-6 Astra listet 1,05 Mio. Token auf, Claude Fable 5.1 listet 1 Mio. auf. Beide geben eine maximale Ausgabe von 128.000 an.
Was war besser zum Programmieren?
GPT-6 Astra lieferte in unserem einzelnen TypeScript-Test das überzeugendere sichtbare Ergebnis. Fable gab über diesen Kompatibilitätsweg keinen sichtbaren Inhalt zurück, daher handelt es sich hierbei nicht um ein an den Anbieter gebundenes Ergebnis.
Was war besser für das Abrufen langer Kontexte?
Es stand 10:10 unentschieden, da beide denselben vorab eingefügten Änderungsantrag gefunden und zitiert hatten. Fable meldete fast dreimal so viele Eingabe-Token für dasselbe Dossier.
Warum hat „Fable“ eine niedrigere Punktzahl erzielt?
Bei mehreren Fable-Aufrufen wurden Abschluss-Token verbraucht, es wurde jedoch ein abgeschnittener oder leerer sichtbarer Inhalt zurückgegeben. Dies könnte auf ein Problem mit der Kompatibilitätsschicht oder der Ausgabeserialisierung zurückzuführen sein.
Kann ich beide Modelle in GlobalGPT verwenden?
Ja. Beide dedizierten GlobalGPT-Strecken waren bei der Überprüfung am 8. September 2026 in Betrieb.
Endgültiges Urteil
GPT-6 Astra ist die sicherere Standardwahl aus diesem Testsatz: Es lieferte vollständigere, brauchbarere Ergebnisse und erzielte 43 von 50 Punkten gegenüber 19 von 50. Claude Fable 5.1 konnte bei der Aufgabe zur Genauigkeit bei langen Kontexten immer noch mit Astra mithalten und produzierte solide Marketingtexte. Bevor Sie Fable verwerfen, wiederholen Sie die Tests über Ihren Produktions-Endpunkt; zwei leere Ausgaben sind ebenso sehr ein Hinweis auf das Integrationsverhalten wie auf das Modellverhalten.