
GPT-6.1 Sol ist das ausgewogene Modell von OpenAI für komplexe Programmieraufgaben, den Einsatz am Computer und berufliche Tätigkeiten. Es behält das Kontextfenster von 1.050.000 Token und die Ausgabegrenze von 128.000 Token von GPT-6 Astra bei, doch die Preise der Standard-API sinken auf $2 pro Million Eingabetoken und $10 pro Million Ausgabetoken. Das entspricht einem Fünftel der aktuellen Token-Preise von Astra. Der Kompromiss ist einfach: Astra bleibt das Flaggschiff, während Sol darauf abzielt, Teams, denen die Kosten pro abgeschlossener Aufgabe wichtig sind, einen ausreichenden Teil seiner Leistungsfähigkeit zur Verfügung zu stellen.
In diesem Leitfaden wird unterschieden, was OpenAI-Dokumente für GPT-6.1 Sol basierend auf den Beobachtungen unabhängiger Entwickler in frühen Tests. Außerdem werden die Preisregel für lange Kontexte, realistische Kostenbeispiele, ein funktionierendes Muster für die Responses-API sowie ein praktischer Ansatz zur Entscheidung zwischen Sol, Astra, Luna und dem früheren GPT-6 Sol vorgestellt.
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist das neuere Sol-Modell in der GPT-6-Familie von OpenAI. In der offiziellen Beschreibung wird es als Modell für komplexe Programmierung, Computernutzung und professionelle Arbeit bezeichnet, dessen Leistung der von Astra nahekommt, jedoch zu geringeren Kosten. In der Hierarchie der Modellfamilie ist Astra die Wahl mit der höchsten Leistungsfähigkeit, Luna die Wahl mit dem besten Preis-Leistungs-Verhältnis und Sol der Mittelweg für Aufgaben, die anspruchsvoll genug sind, um starkes logisches Denken zu erfordern, aber häufig genug anfallen, sodass die Stückkosten eine wichtige Rolle spielen.
Die Modell-ID lautet gpt-6.1-sol. Genau diese Zeichenfolge spielt bei API-Aufrufen, Testprotokollen, Abrechnungsunterlagen und der Bereitstellungskonfiguration eine Rolle. Die ältere gpt-6-sol bleibt ein anderes Modell, auch wenn die nicht zwischengespeicherten Eingangs- und Ausgangspreise übereinstimmen. Die Seite von OpenAI für das ältere Modell verweist die Leser nun auf die neuere Version, während unsere GPT-6 Sol – Testbericht und API-Beschränkungen bildet die historische Grundlage.
Der wichtigste Grund, sich für dieses Update zu interessieren, ist nicht eine einzelne Zahl in der Rangliste. Es ist vielmehr die Kombination aus einem Kontextfenster in „Frontier“-Größe, umfassender Tool-Unterstützung, fünf Stufen für den Aufwandsgrad der Schlussfolgerungen und einem Preis, der zu einer breiteren Nutzung einlädt als bei Astra. Ein Modell, das zwar etwas schwächer ist, aber erschwinglich genug, um bei jedem ernsthaften Entwurf, jeder Codeüberprüfung oder jedem mehrstufigen Arbeitsablauf eingesetzt zu werden, kann mehr Nutzen bieten als ein Flaggschiff-Modell, das nur für seltene Anlässe reserviert ist.
Diese Positionierung muss noch anhand Ihrer eigenen Aufgaben überprüft werden. OpenAI’s Leitfaden zur Modellauswahl empfiehlt ausdrücklich, Sol und Astra bei derselben Aufgabe miteinander zu vergleichen. Ein Workflow für Rechtsdokumente, eine Refaktorisierung eines Repositorys, ein Browser-Agent und eine Präsentation vor dem Vorstand können unterschiedliche Fähigkeiten auf die Probe stellen. Betrachten Sie die Modellbezeichnung als Ausgangshypothese und messen Sie anschließend die Korrektheit, die Anzahl der Überarbeitungen, die Latenzzeit und die Gesamtkosten pro akzeptiertem Ergebnis.
Technische Daten des GPT-6.1 Sol
Die Offizieller Modellkatalog listet Text- und Bildeingaben sowie Textausgaben auf. Audio- und Videodaten werden vom Modell selbst weder als Eingabe- noch als Ausgabemedium unterstützt. Diese Unterscheidung ist bei der Produktentwicklung hilfreich: Sie können Screenshots, Diagramme, gescannte Seiten oder andere Bilder übermitteln, während für die Transkription von Audioaufnahmen und das Verstehen von Videos eine separate Komponente oder ein separates Tool erforderlich ist.
Die maximale Eingabe liegt unterhalb des im Titel genannten Kontextfensters, da für die Ausgabe und die interne Verarbeitung innerhalb des Gesamtbudgets Platz benötigt wird. Die Obergrenze von 128.000 Token für die Ausgabe ist großzügig bemessen, doch die Anforderung einer enormen Antwort ist selten die beste Lösung. Lange Ausgaben sind kostspieliger, ihre Überprüfung dauert länger und sie können von der Intention abweichen. Bei den meisten Softwareaufgaben lassen sich kleinere, strukturierte Ausgaben mit Kontrollpunkten leichter validieren.
Unterstützung bei der Argumentation niedrig, mittel, hoch, xhoch, und max; „medium“ ist die Standardeinstellung. Die keine und minimal Die Einstellungen sind nicht verfügbar. Verwenden Sie für Routinetransformationen einen geringeren Aufwand und erhöhen Sie diesen nur dann, wenn die Fehlerkosten oder die Komplexität einer Aufgabe den zusätzlichen Token- und Zeitaufwand rechtfertigen. Das praktische Ziel ist die leichteste Einstellung, mit der Ihre Abnahmetests noch bestanden werden.
Entwickler, die ältere Preisentwicklungen und das Token-Verhalten vergleichen möchten, können unseren Preise und Kostenbeispiele für GPT-6 Sol als Anhaltspunkt. Die wesentliche Änderung bei den Spezifikationen betrifft nicht die Kontextgröße, die bei allen hier behandelten GPT-6-Modellen einheitlich bleibt. Es handelt sich vielmehr um die aktualisierte Positionierung des neueren Sol sowie um kostengünstigere zwischengespeicherte Eingaben.
Leistung: Was die offiziellen Belege zeigen
Laut den Angaben zum Start von OpenAI verbessert GPT-6.1 Sol GPT-6 Sol bei komplexen professionellen Aufgaben wie dem Schreiben und Debuggen von Code, dem Verstehen von Dokumenten und der Ausführung mehrstufiger Geschäftsabläufe erheblich. Das Unternehmen gibt an, bei mehreren Bewertungen GPT-6 Astra zu geringeren Kosten zu erreichen. Dabei handelt es sich um offizielle Bewertungsangaben, nicht um eine Garantie, dass jede Eingabe ähnlich gut wie bei Astra ausfällt.
Die Nachtrag zur GPT-6.1-Sonnensystemkarte stellt eine wichtige Einschränkung dar: Die Auswertungen wurden in der Forschungsumgebung von OpenAI oder über die API durchgeführt, während die Produktionsumgebung von ChatGPT davon abweichen kann, da die Systemaufforderungen, die verfügbaren Tools und die Aufwandseinstellungen nicht identisch sind. Aus diesem Grund sollte ein fundierter Artikel offizielle Benchmark-Ergebnisse klar von den Tests eines Autors und von internen Bewertungen eines Unternehmens trennen.
Ein konkretes Beispiel ist HealthBench. In der veröffentlichten Tabelle erreicht GPT-6.1 Sol längenanpasste Werte von 64,2 bei HealthBench Professional, 58,5 bei HealthBench, 36,2 bei HealthBench Hard und 96,0 bei HealthBench Consensus. Die entsprechenden Astra-Werte lauten 64,7, 58,3, 36,6 und 95,5. OpenAI beschreibt die Modelle als innerhalb einer Abweichung von 0,5 Prozentpunkten über diese vier Bewertungen hinweg liegend.
Dieses Ergebnis untermauert die Bezeichnung “nahe Astra” innerhalb dieser Bewertungsfamilie. Es ist jedoch kein Beweis für eine gleichwertige Software-Engineering-Qualität, Browser-Zuverlässigkeit oder einen vergleichbaren Ausgabestil. Ein Leistungs-Benchmark misst eine andere Fähigkeit als die Behebung einer Race Condition oder die Koordination von Tools. Einen tieferen Einblick in das umfassendere Testprofil des Flaggschiffmodells finden Sie unter GPT-6 Astra: Testbericht und Praxistests.
Die stichhaltigste praktische Interpretation ist bedingt: GPT-6.1 Sol gehört in die engere Auswahl für anspruchsvolle Aufgaben, insbesondere wenn der Preis von Astra die Nutzung einschränken würde. Es verdient einen direkten Vergleich, keine automatische Beförderung. Messen Sie die Erfolgsquote, die Anzahl der manuellen Korrekturen, Tool-Fehler, die Anzahl der ausgegebenen Tokens und die Zeit bis zur Erstellung eines akzeptierten Artefakts. Diese Kennzahlen machen aus einem Modellvergleich eine geschäftliche Entscheidung.
Programmierung: Was GPT-6.1 Sol leisten kann
GPT-6.1 Sol verfügt über die Bausteine, die man von einem modernen Programmiermodell erwartet: Streaming, strukturierte Ausgaben, Funktionsaufrufe, Dateisuche, Bildeingabe, Websuche und Prompt-Caching. Über die Responses-API listet OpenAI zudem Code-Interpreter, gehostete Shell, Patch-Anwendung, Skills, Computernutzung, MCP und Werkzeugsuche auf. Damit eignet sich das Modell für Arbeitsabläufe, bei denen Dateien überprüft, Änderungen vorgeschlagen, Befehle ausgeführt und maschinell geprüfte Ergebnisse zurückgegeben werden.
Die Unterstützung von Funktionen bedeutet nicht, dass jede Umgebung automatisch alle Tools bereitstellt. Ihre Anwendung entscheidet weiterhin, welche Tools vorhanden sind, welche Berechtigungen sie erhalten, wie Ergebnisse an das Modell zurückgegeben werden und welche Aktionen einer Bestätigung bedürfen. „Chat Completions“ funktioniert für GPT-6.1 Sol ohne Aufruf von Tools, während OpenAI Anwendungen, die Tools verwenden, an „Responses“ weiterleitet. Neue agentische Systeme sollten diese API-Grenze als architektonische Entscheidung betrachten und nicht als geringfügigen syntaktischen Unterschied.
Zum Zeitpunkt der Veröffentlichung war das genaue Modell im Chat-Katalog des Testveranstalters nicht offengelegt worden, weshalb dieser Leitfaden keinen neuen internen Benchmark für die vier geplanten Programmieraufgaben beansprucht. Die Bewertung der Programmierleistung stützt sich auf offizielle Leistungsdaten und namentlich genannte öffentliche Durchläufe. Das ist sinnvoller, als heimlich Astra oder das ältere Sol einzusetzen und dem Ergebnis den falschen Modellnamen zuzuordnen.
Eine fundierte Bewertung sollte das Debugging mit Regressionstests, eine Funktion zur Verarbeitung einer begrenzten Anzahl von Dateien, eine Sicherheitsüberprüfung sowie eine durch das Schema bedingte technische Entscheidung umfassen. Diese Aufgaben testen mehr als nur die Codegenerierung. Sie zeigen auf, ob das Modell eine API beibehält, Randfälle erfasst, Ausgabebeschränkungen einhält und angibt, was es nicht überprüfen konnte. Unser Leitfaden zu den besten KI-Modellen für die Programmierung im Jahr 2026 erklärt, warum sich die beste Wahl je nach Arbeitsablauf ändert.
Finden Sie den kleinsten Fehler, behalten Sie die API bei und fügen Sie lauffähige Tests hinzu.
Beachten Sie Parallelität, Reihenfolge, Validierung und das Verhalten bei Fehlern.
Priorisieren Sie Exploit-Pfade, stellen Sie eine minimale Korrektur bereit und vermeiden Sie Behauptungen über erfundenen Rahmenbedingungen.
Wenn Sie einen solchen Befehl ausführen, werten Sie das Ergebnis systematisch aus. Bleibt die Null erhalten? Werden Duplikate entfernt? Ist die numerische Sortierung korrekt? Werden die Tests mit node --test? Eine ausgefeilte Erklärung kann eine fehlerhafte Behauptung nicht ausgleichen. Das Gleiche gilt für die Arbeit am Repository: Definieren Sie zunächst die Akzeptanzkriterien, bevor Sie sich für ein Modell entscheiden, und prüfen Sie dann den Patch, anstatt sich auf die Überzeugungskraft des Textes zu verlassen.
Preise für GPT-6.1 Sol
Die Offizielle API-Preisseite Misst die GPT-6.1-Sol-Raten pro einer Million Token. Die Eingabekosten betragen $2, die Kosten für zwischengespeicherte Eingaben $0,10, die Kosten für Cache-Schreibvorgänge $2,50 und die Ausgabekosten $10. Der zwischengespeicherte Input entspricht somit 5% der Rate für den nicht zwischengespeicherten Input, während das Schreiben neuer Cache-Inhalte das 1,25-Fache des normalen Inputs kostet. Tool-spezifische Gebühren können separat hinzugerechnet werden, sodass die Token-Berechnung nur einen Teil der durch den Einsatz eines Tools entstehenden Arbeitslast ausmacht.
Das wichtigste Detail bei der Preisgestaltung ist der Schwellenwert von 272.000. Sobald die Eingabe 272.000 Token überschreitet, gelten für die gesamte Anfrage die doppelte Eingabe- und Cache-Rate sowie die 1,5-fache Ausgaberate. Es handelt sich nicht um einen marginalen Aufschlag, der nur auf Token oberhalb dieser Grenze angewendet wird. Anwendungen, die regelmäßig nahe an dieser Grenze liegen, sollten die Token vor dem Senden zählen und eine Aufteilung in Blöcke, den Abruf oder die Komprimierung in Betracht ziehen.
Im „Fast“-Modus verdoppeln sich die Standardpreise. Die Modi „Batch“ und „Flex“ senken die Standardtarife um 50%, und bei regionaler Verarbeitung wird, sofern verfügbar, ein Aufschlag von 10% erhoben. Diese Modi lösen unterschiedliche Probleme: „Fast“ kompensiert Latenzzeiten, „Batch“ tauscht Unmittelbarkeit gegen Kosten ein, „Flex“ tauscht Planbarkeit gegen Kosten ein und die regionale Verarbeitung berücksichtigt Anforderungen hinsichtlich des Datenstandorts. Vergleichen Sie deren Preise nicht, ohne zuvor die jeweiligen betrieblichen Einschränkungen zu berücksichtigen.
Die Standardpreise von Astra betragen $10 als Eingabe und $50 als Ausgabe pro Million Token, was genau dem Fünffachen der von Sol angegebenen Sätze entspricht. Die Preise und Token-Limits der GPT-6 Astra-API In diesem Leitfaden wird dieser Aufschlag näher beleuchtet. Sol und die Vorgängerversion GPT-6 Sol verwenden dieselben nicht zwischengespeicherten Eingabe- und Ausgabepreise, doch bei GPT-6.1 Sol wird die Zwischenspeicherung der Eingabedaten von $0,20 auf $0,10 pro Million Token reduziert.
Beispiele für tatsächliche Kosten
Die Preise für Token lassen sich leichter einschätzen, wenn sie in vollständige Anfragen umgerechnet werden. In den folgenden Beispielen wird die Standardverarbeitung verwendet; es fallen keine Tool-Aufrufe, keine regionalen Aufschläge und keine zwischengespeicherten Eingaben an, sofern nicht anders angegeben. Die tatsächliche Ausgabelänge wirkt sich oft stärker auf die Kosten aus, als Entwickler erwarten, da die Ausgabe bei GPT-6.1 Sol fünfmal so viel kostet wie gewöhnliche Eingaben.
Bei der Code-Überprüfung mit 100.000 Eingaben und 5.000 Ausgaben betragen die Eingabekosten $0,20 und die Ausgabekosten $0,05, was zu einer Schätzung von $0,25 führt. Wenn die gesamten 100.000 Eingaben als zwischengespeichert gelten, sinkt der Eingabeanteil auf $0,01 und der Gesamtwert beträgt $0,06. Muss die Anwendung dieses 100K-Präfix zunächst in den Cache schreiben, beträgt der Cache-Schreibanteil vor der Ausgabe $0.25.
Das Beispiel mit 300.000 Eingaben überschreitet den Schwellenwert. Eingaben werden mit einem effektiven Preis von $4 pro Million abgerechnet, sodass 300.000 Eingaben $1,20 kosten. Die Ausgabe wird mit einem effektiven Preis von $15 pro Million abgerechnet, sodass 10.000 $0,15 kosten. Die Gesamtsumme beträgt $1,35. Eine Anfrage, die nur geringfügig über dem Schwellenwert liegt, kann daher deutlich mehr kosten als eine, die knapp darunter liegt – noch bevor Tools hinzukommen.
„Batch“ oder „Flex“ würden die zulässige Standard-Gesamtsumme halbieren, während „Fast“ sie verdoppeln würde. Für das erste Beispiel bedeutet das etwa $0,125 bei „Batch“ oder „Flex“ und $0,50 bei „Fast“. Teams, die noch ältere GPT-5.6-Modelle verwenden, können diese Annahmen mit unseren Preise für GPT-5.6 und Codex-Credits Aufschlüsselung.
So verwenden Sie GPT-6.1 Sol
Der einfachste Weg für Entwickler ist die Responses-API. Installieren Sie das aktuelle OpenAI-SDK, geben Sie den API-Schlüssel über Ihre Umgebung an und legen Sie Modell zu gpt-6.1-sol. Das Offizieller Leitfaden zur Texterstellung empfiehlt „Responses“ für direkte Modellanfragen, und die Modellseite benötigt dies für den Aufruf von Tools.
1. Beginnen Sie mit einer einfachen Anfrage an die Responses-API
Halten Sie die erste Anfrage einfach. Vergewissern Sie sich, dass die genaue Modell-ID in Ihrem Projekt verfügbar ist, erfassen Sie die zurückgegebenen Modell- und Nutzungsfelder und speichern Sie genügend Metadaten, um den Lauf reproduzieren zu können. Beginnen Sie nicht gleich mit einer umfangreichen Toolkette. Eine einfache Anfrage trennt Probleme beim Modellzugriff von Problemen hinsichtlich Tool-Definition, Berechtigungen und Orchestrierung.
2. Fügen Sie Tools ausschließlich über die Responses-API hinzu
Wenn der Workflow Dateisuche, Websuche, Codeausführung, Shell-Zugriff, Computernutzung, MCP oder benutzerdefinierte Funktionen erfordert, legen Sie den kleinsten erforderlichen Tool-Satz fest. Schränken Sie den Datei- und Netzwerkbereich ein, validieren Sie Tool-Argumente und legen Sie fest, welche Aktionen eine Bestätigung durch den Benutzer erfordern. Das Modell kann Tools vorschlagen und aufrufen, doch Ihre Anwendung bleibt für deren Ausführung und die Durchsetzung von Berechtigungen verantwortlich.
3. Den Aufwand für das logische Denken anhand einer Bewertung anpassen
Beginnen Sie mit der Einstellung „medium“ (Standard). Führen Sie einen repräsentativen Testlauf durch und vergleichen Sie dann die Einstellungen „low“, „high“ oder „xhigh“ hinsichtlich Akzeptanzrate, Ausgabe-Token, Latenz und Anzahl der Überarbeitungen. Die Einstellung „Max Effort“ kann bei den schwierigsten Aufgaben hilfreich sein, doch wenn Sie sie überall einsetzen, kann dies den Kostenvorteil zunichte machen, der Sol so attraktiv gemacht hat. Behalten Sie die leichteste Einstellung bei, die zuverlässig zum Erfolg führt.
4. Verwenden Sie GlobalGPT für einen interaktiven Vergleich
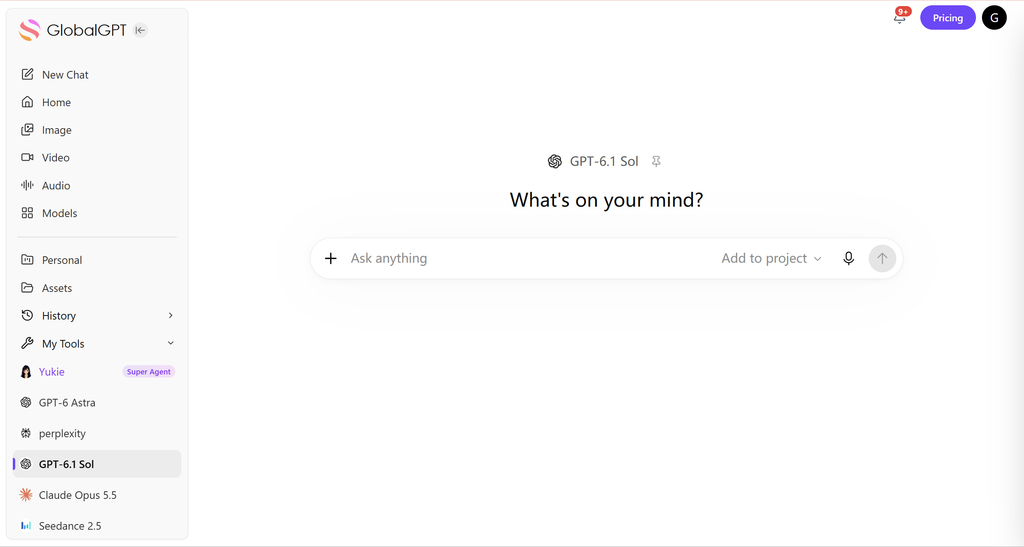
Für interaktive Aufgaben öffnen Sie Der Multi-Modell-Arbeitsbereich von GlobalGPT und wählen Sie „GPT-6.1 Sol“ aus, sobald es in der Auswahlliste Ihres Kontos verfügbar ist. Diese Vorgehensweise eignet sich gut zum Vergleichen von Antworten, ohne dass separate Registerkarten und Abonnements verwaltet werden müssen. Sie ersetzt jedoch nicht die API-Bereitstellungskontrollen, die Repository-Automatisierung, Codex oder eine IDE. Unser Leitfaden zu Auswahlmöglichkeiten für das ChatGPT-Modell zur Kodierung behandelt diese Unterschiede im Arbeitsablauf.
GPT-6.1 Sol im Vergleich zu GPT-6 Sol, Astra und Luna
Alle vier Modelle in diesem Vergleich akzeptieren Text und Bilder, geben Text zurück und weisen ein Kontextfenster von 1.050.000 Token mit einer maximalen Ausgabegröße von 128.000 auf. Die wesentlichen Unterschiede liegen in der Position, dem Preis, dem Stichtag, den Einstellungen für die Argumentation und dem Qualitätsniveau, das Sie bei einer realen Aufgabe beobachten können. Die Tabelle basiert auf den aktuellen offiziellen Standard-Token-Preisen, die am 1. Oktober 2026 überprüft wurden.
| Modell | Beste Passform | Eingang / 1M | Zwischengespeichert / 1M | Leistung / 1M | Grenzwert |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Komplexe Arbeit mit Kostenkontrolle | $2 | $0.10 | $10 | 30. April 2026 |
| GPT-6 Astra | Äußerst anspruchsvolle Arbeit, bei der Qualität an erster Stelle steht | $10 | $1 | $50 | 30. April 2026 |
| GPT-6 Sol | Bestehende ältere Sol-Integrationen | $2 | $0.20 | $10 | 20. April 2026 |
| GPT-6 Luna | Zielgerichtete Aufgaben mit hohem Arbeitsaufkommen | $0.10 | $0.01 | $0.50 | 18. Mai 2026 |
Entscheiden Sie sich für Astra, wenn die Aufgabe so anspruchsvoll ist, dass bereits eine geringe Qualitätssteigerung kostspielige manuelle Nachbearbeitung verhindern kann. Wählen Sie GPT-6.1 Sol, wenn die Aufgabe zwar immer noch komplex, aber häufig anzutreffen ist – insbesondere, wenn der Rabatt für zwischengespeicherte Eingaben von Vorteil ist. Entscheiden Sie sich für Luna, wenn Datenvolumen und Latenz die entscheidenden Faktoren sind und der Aufgabenumfang klar definiert ist. Behalten Sie das ältere Sol nur dort bei, wo Migrationsrisiken, bestehende Evaluierungen oder Kompatibilitätsarbeiten einen sofortigen Wechsel unattraktiv machen.
Die fünffache Preisdifferenz zwischen Sol und Astra ist groß, doch der Preis pro Token ist nicht gleichbedeutend mit dem Preis pro akzeptiertem Ergebnis. Ein leistungsfähigeres Modell verwendet möglicherweise weniger Ausgabetoken, ruft weniger Tools auf oder benötigt weniger Überarbeitungen. Umgekehrt kann Sol selbst mit einer zusätzlichen Überarbeitung gewinnen, wenn der Stückpreis von Astra diesen Unterschied mehr als ausgleicht. Vergleichen Sie vollständige Aufgabenverläufe, anstatt lediglich die Länge einer einzelnen Eingabe zu multiplizieren.
Leser, die abwägen, ob sich der Umstieg auf das Flaggschiff-Modell lohnt, können die Vergleich zwischen GPT-6 Astra und GPT-5.6 Sol für den Kontext früherer Stufen. Für den kostengünstigsten Zweig der aktuellen Familie gilt, dass der GPT-6 Luna: Testbericht und beste Anwendungsmöglichkeiten gibt die entsprechenden API-Beschränkungen und die Eignung für die jeweilige Arbeitslast an.
Was Kritiker sagen
OpenAI stellte GPT-6.1 Sol im Rahmen seiner DevDay-Keynote am 29. September 2026 zusammen mit anderen Produktveröffentlichungen vor. Dieses offizielle Video legt den Zeitpunkt der Markteinführung und die Positionierung fest; es stellt jedoch keinen eigenständigen Beweis dar. Die aussagekräftigen externen Reaktionen stammen von Entwicklern, die eine Aufgabe, einen Vergleichssatz, eine Kostenmethode und Fehlschläge offenlegen, anstatt lediglich die Aussagen zur Markteinführung zu wiederholen.
Kann es programmieren? berichtete in einem dreirundigen Vergleich zwischen Blender und Godot von einem deutlich kostengünstigeren und schnelleren Sol-Lauf, merkte jedoch an, dass die Spielqualität im Laufe der Runden nachließ.
Matt Johnston Er gab in seinem Testaufbau mit neun Tests eine gewichtete Punktzahl von 96 und Kosten von $2,63 an, wobei er eine nicht bestandene Pinguin-Aufgabe eindeutig benannte.
Duncan Rogoff Wir haben Sol mit Sonnet 5.5 in sechs Builds verglichen und dabei die Zeit, die Token und die endgültigen Kosten erfasst.
Unter Das Video zu ’Can It Code?“ in drei Runden, verlagerten sich die Aufgaben von einem Low-Poly-Dungeon-Bausatz in Blender hin zu modellierten und animierten Charakteren und schließlich zu einem spielbaren Godot-Spiel. Der Entwickler schätzte den Zeitaufwand für Sol über alle Runden hinweg auf $29.17 und 7 Stunden 5 Minuten – weit unter den Vergleichsläufen –, bewertete das fertige Spiel jedoch als weniger unterhaltsam und meinte, Sol werde mit jeder Runde schlechter. Die Erkenntnis lautet: Kosten und Geschwindigkeit mit einem Qualitätsvorbehalt, nicht eine Gesamtbewertung.
Matt Johnstons Rückblick auf neun Testspiele Er gibt in seiner Stonelabs-Tabelle eine gewichtete Punktzahl von 96 an, was einem Gleichstand mit Sonnet 5.5 entspricht, sowie Kosten in Höhe von $2,63 für die Suite – im Vergleich zu etwa $14 bei Astra und $12 bei Opus 5.5. Er weist zudem auf ein Fehlresultat bei der „Penguin“-Aufgabe hin. Diese Zahlen stammen aus seinem Benchmark-Entwurf und seiner Kostenrechnung; sie sollten vor der Verwendung für die Beschaffung reproduziert werden.
Duncan Rogoffs Vergleich von sechs Baufahrzeugen umfasst Landingpages, 3D-Browsergames, Blender-Szenen, interaktive Erklärvideos und Investorenpräsentationen. Der öffentlichen Beschreibung zufolge werden bei den Testläufen die Erstellungszeit, der Token-Verbrauch und die endgültigen Kosten erfasst. Bis das vollständige, sichtbare Ergebnis geprüft wurde, dient das Video in diesem Leitfaden als Beleg für eine praktische Vergleichsmethode und nicht als Beweis dafür, dass eines der beiden Modelle gewonnen hat.
Diese ersten Bewertungen sind sich in einer wichtigen Frage einig: Hält der niedrige Preis von Sol auch bei einem vollständigen Projekt stand? Ihre Antworten hängen von der jeweiligen Aufgabe ab. Ein Entwickler stellte eine beeindruckende Kosteneffizienz bei geringerer Qualität des fertigen Spiels fest; ein anderer berichtete von einer hohen Punktzahl und niedrigen Entwicklungskosten; ein dritter entwarf ein breit angelegtes Kopf-an-Kopf-Spiel. Diese Vielfalt ist aufschlussreicher als ein pauschaler Konsens.
Für wen ist GPT-6.1 Sol geeignet?
GPT-6.1 Sol eignet sich für Teams, die bereits über sinnvolle Arbeitsabläufe und einen Bewertungszyklus verfügen. Es ist besonders attraktiv, wenn derselbe umfangreiche Kontext durch Prompt-Caching wiederverwendet wird, wenn eine Astra-Bereitstellung zu kostspielig wäre, um sie zu skalieren, oder wenn Luna nicht genügend Tiefe für die jeweilige Aufgabe bietet. Das Modell ist weniger überzeugend, wenn eine einfache Extraktions- oder Klassifizierungsaufgabe bereits zuverlässig auf einer kostengünstigeren Stufe funktioniert.
- Programmierung auf Repository-Ebene
- Komplexe fachliche Arbeitsergebnisse
- Langzeit-Überprüfung mit Zwischenspeicherung
- Workflows mit Tool-Nutzung und Auswertungen
- Sicherheitskritische Entscheidungen
- Aufgaben, bei denen Fehler teuer zu stehen kommen
- Arbeiten in der Nähe der 272K-Schwelle
- Latenzempfindliche Datenflüsse
- Einfaches Tagging
- Kurze deterministische Transformationen
- Extraktion in großem Umfang bei geringem Risiko
- Von Luna bereits gelöste Aufgaben
Softwareteams sollten Sol in Betracht ziehen, wenn sie ein Modell benötigen, um über mehrere Dateien hinweg Schlussfolgerungen zu ziehen, Tests zu erstellen, Sicherheitsprobleme zu überprüfen oder Tools unter Aufsicht zu betreiben. Analysten können es für die Synthese mehrerer Dokumente und strukturierte Ergebnisse nutzen. Betriebsteams können es für Arbeitsabläufe einsetzen, die Daten, Regeln und geschäftlichen Kontext miteinander verknüpfen. In jedem Fall benötigt der Arbeitsablauf explizite Akzeptanzkriterien und einen manuellen oder automatisierten Verifizierungsschritt.
Einzelanwender und kleine Teams ziehen es möglicherweise vor, zunächst einen interaktiven, modellübergreifenden Arbeitsbereich zu nutzen, bevor sie eine API-Integration erstellen. So lässt sich der Vergleich zwischen Sol und Astra konkretisieren, ohne sich bereits auf eine Anwendungsarchitektur festlegen zu müssen. Wenn Sie sich noch nicht für einen Anbieter oder eine Modalität entschieden haben, bietet unser Leitfaden zu Auswahl eines KI-Modells nach Aufgabe, Tools und Kosten liefert eine umfangreichere Auswahlliste.
Grenzwerte und Fehlermodi
Ein Kontextfenster mit einer Million Token ist eine Kapazität, kein perfektes Gedächtnis. Wichtige Anweisungen können dennoch durch irrelevante Dokumente, doppelte Regeln oder widersprüchliche Belege verwässert werden. Strukturieren Sie lange Eingaben, identifizieren Sie maßgebliche Quellen und bitten Sie das Modell, die Datei oder Passage zu zitieren, auf der wesentliche Schlussfolgerungen beruhen. Das Abrufen und Komprimieren kann sinnvoller sein, als bei jedem Schritt alles zu übermitteln.
Ein zweites Risiko stellt der Preissprung bei langem Kontext dar. Eine Anfrage mit 273.000 Eingabetoken wird zum höheren Tarif für die gesamte Anfrage berechnet, nicht nur für die letzten tausend Token. Dies kann in Anwendungen, die den Kontext dynamisch zusammenstellen, zu unerwartet hohen Rechnungen führen. Führen Sie daher vor der Anfrage eine Token-Zählung und Budgetprüfungen durch und protokollieren Sie, welche Dokumente einen Aufruf über die Grenze hinausgetrieben haben.
Der Einsatz von Tools erweitert die Funktionsmöglichkeiten und vergrößert die Angriffsfläche. Behandeln Sie Webseiten, abgerufene Dateien und die Ausgabe von Tools als nicht vertrauenswürdige Daten. Überprüfen Sie Funktionsargumente, isolieren Sie die Codeausführung, schränken Sie Dateipfade und den Netzwerkzugriff ein und verlangen Sie eine Bestätigung für Aktionen mit erheblichen Auswirkungen. Die Unterstützung des Modells für gehostete Shells oder die Nutzung von Computern ist kein Grund, weitreichende Berechtigungen zu erteilen.
Schließlich können frühe Tests durch die Entwickler zwar aufschlussreich sein, sind aber nicht endgültig. Unterschiedliche Systemaufforderungen, Werkzeuge, Hilfestellungen, Zeitlimits und Bewertungsrubriken können das Ergebnis zugunsten eines anderen Kandidaten kippen. Nutzen Sie öffentliche Tests, um Ihre eigene Bewertung zu gestalten, und nicht, um diese zu überspringen. Ein Modell, das sich bei der Erstellung visueller Spiele hervorhebt, kann dennoch an Ihrem Migrationsplan scheitern – und umgekehrt ist dies ebenso möglich.
Häufig gestellte Fragen
Diese Antworten fassen die offiziellen API-Angaben und die oben behandelten praktischen Entscheidungsaspekte zusammen.
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist ein OpenAI-Modell für komplexe Programmieraufgaben, Computeranwendungen und berufliche Tätigkeiten. Mit der OpenAI-Konfiguration reiht es sich zwischen der kostengünstigen Luna-Stufe und der Flaggschiff-Stufe Astra ein und bietet Leistungen, die denen von Astra nahekommen, zu einem niedrigeren API-Preis.
Wie viel kostet GPT-6.1 Sol?
Die Standardpreise für die API betragen $2 pro Million Eingabetoken, $0,10 pro Million zwischengespeicherte Eingabetoken, $2,50 pro Million Cache-Schreib-Token und $10 pro Million Ausgabetoken. Lange Eingabeaufforderungen, der Schnellmodus, regionale Verarbeitung, Batch-Verarbeitung und Flex können den effektiven Preis beeinflussen.
Was ist das Kontextfenster von GPT-6.1 Sol?
OpenAI gibt ein Kontextfenster von 1.050.000 Token, eine maximale Eingabe von 922.000 Token und bis zu 128.000 Ausgabe-Token an. Ein großes Fenster ermöglicht es dem Modell, umfangreiche Datenmengen zu analysieren, garantiert jedoch weder eine perfekte Wiederauffindbarkeit noch macht es jede umfangreiche Anfrage wirtschaftlich.
Eignet sich GPT-6.1 Sol zum Programmieren?
Es ist für komplexe Programmieraufgaben konzipiert und unterstützt strukturierte Ausgaben, Funktionsaufrufe, einen Code-Interpreter, eine gehostete Shell, das Anwenden von Patches, Skills, MCP und weitere Tools über die Responses-API. Produktionsteams sollten dennoch repositoryspezifische Tests durchführen, bevor sie einen kritischen Workflow umstellen.
Soll ich GPT-6.1 Sol oder GPT-6 Astra verwenden?
Entscheiden Sie sich für Sol, wenn die Kosten eine Rolle spielen und Ihre eigene Bewertung ergibt, dass es die Qualitätsanforderungen erfüllt. Wählen Sie Astra für die anspruchsvollsten Aufgaben, bei denen eine geringfügig höhere Qualität den fünffachen Standard-Token-Satz rechtfertigt. Testen Sie beide an denselben repräsentativen Aufgaben, bevor Sie eine Entscheidung treffen.
Was passiert, wenn eine Eingabe 272K Eingabetoken überschreitet?
Laut OpenAI wird die gesamte Anfrage mit dem Doppelten der normalen Eingabe- und Cache-Rate sowie dem 1,5-Fachen der normalen Ausgaberate abgerechnet, sobald die Eingabe 272.000 Token überschreitet. Diese sprunghafte Änderung kann bei Anwendungen mit langen Dokumenten eine größere Rolle spielen als die angegebene Größe des Kontextfensters.
Unterstützt GPT-6.1 Sol die Chat Completions API?
Ja, „Chat Completions“ wird für Anfragen ohne Tool-Aufruf unterstützt. OpenAI verweist Entwickler für Tool-Aufrufe auf die Responses-API; daher sollten neue agentenbasierte oder Tool-basierte Anwendungen in der Regel mit Responses beginnen, anstatt sich auf die ältere Schnittstelle zu stützen.
Kann GPT-6.1 Sol Bilder verarbeiten?
Ja. Auf der offiziellen Modellseite werden Text- und Bildeingaben mit Textausgabe aufgeführt. Audio- und Videodateien werden von diesem Modell nicht unterstützt; eine Anwendung kann jedoch andere Dienste oder Tools rund um das Modell nutzen, wenn diese Medientypen benötigt werden.
Wie kann ich GPT-6.1 Sol auf GlobalGPT nutzen?
Öffnen Sie GlobalGPT, starten Sie einen neuen Chat und wählen Sie „GPT-6.1 Sol“ aus, sobald es in der Modellauswahl für Ihr Konto angezeigt wird. GlobalGPT ist ein praktischer Arbeitsbereich für mehrere Modelle; API-Schlüssel, Bereitstellungssteuerung und Repository-Automatisierung bleiben separate Entwickler-Workflows.
Endgültiges Urteil
GPT-6.1 Sol ist die interessanteste GPT-6-Option für Käufer, die hohe Anforderungen an logisches Denken und Programmierfähigkeiten stellen, aber nicht bei jedem Durchlauf die Kosten für Astra rechtfertigen können. Es entspricht den von Astra angegebenen Kontext- und Ausgabebeschränkungen, nutzt denselben Wissens-Cutoff vom 30. April 2026 und kostet bei Standardtarifen pro nicht zwischengespeichertem Eingabe- und Ausgabetoken nur ein Fünftel so viel. Der Rabatt für zwischengespeicherte Eingaben ist zudem höher als beim vorherigen GPT-6 Sol.
Das Modell ist nicht automatisch die beste Wahl. Luna ist für gezielte Aufgaben nach wie vor deutlich günstiger, und Astra kann bei den schwierigsten Aufgaben möglicherweise immer noch den Nachbearbeitungsaufwand reduzieren. Der richtige Vergleichsmaßstab sind die Gesamtkosten pro akzeptiertem Ergebnis, gemessen unter Verwendung derselben Eingabe, derselben Tools, derselben Daten und derselben Bewertungsregeln. Bei mehr als 272.000 Eingabetoken sollten Sie den Preismultiplikator berücksichtigen, bevor Sie eine Entscheidung treffen.
Öffnen Sie GlobalGPT, wählen Sie „GPT-6.1 Sol“, sobald es verfügbar ist, und vergleichen Sie es anhand einer realen Aufgabe und einer Abnahmeliste mit „Astra“ oder „Luna“.
Geöffnet GlobalGPTFür die API-Bereitstellung beginnen Sie mit der offiziellen Modellseite und einer kleinen Anfrage an die Responses-API. Für einen interaktiven Vergleich nutzen Sie die oben genannte Multi-Modell-Route. Behalten Sie in jedem Fall die Ausgaben, die Nutzung, die Einstellungen und die Fehler bei. Das Versprechen von GPT-6.1 Sol besteht nicht nur in günstigeren Tokens, sondern in einer besseren Möglichkeit, leistungsfähige Schlussfolgerungen so oft auszuführen, dass sie Teil des Arbeitsablaufs werden.









