Welche KI-Modelle Sie in die engere Wahl ziehen sollten, hängt von der Aufgabe ab, die Sie erledigen müssen. Für Text, Programmierung und logisches Denken sollten Sie die aktuellen Modellfamilien GPT, Claude, Gemini, Grok, DeepSeek und Qwen vergleichen. Für Bilder sollten Sie GPT Image, Nano Banana und Midjourney in Betracht ziehen; bei Videos sollten Sie mit den Generierungs- und Bearbeitungsfunktionen beginnen, die Ihr Projekt benötigt. Ein wissenschaftlicher Mitarbeiter benötigt zudem Suchfunktionen und zuverlässige Quellen, nicht nur ein leistungsstarkes Sprachmodell.
Beginnen Sie mit Ihrer schwierigsten wiederkehrenden Aufgabe und wählen Sie dann die kostengünstigste Lösung, die diese zuverlässig erledigt. Selbst ein Modell, das einen überzeugenden Absatz verfassen kann, kann ein Dokument falsch interpretieren, eine Quellenangabe erfinden oder fehlerhaften Code erzeugen. Die folgenden Empfehlungen basieren auf der offiziellen Modelldokumentation und praktischen Auswahlkriterien; es handelt sich um eine Auswahlliste nach Aufgaben, nicht um eine Rangliste nach Punktzahlen.
GlobalGPT vereint mehrere Modellfamilien und KI-Funktionen in einem Abonnement, sodass Sie im selben Arbeitsbereich von Recherche und Texterstellung zu Bildern und Videos wechseln können. Das ist eine praktische und kostengünstige Option, wenn Ihre Arbeitswoche verschiedene Aufgabenbereiche umfasst und Sie weniger separate Abonnements verwalten möchten.
Offizielle Modellverzeichnisse, Stand: 15. September 2026. Historische Beispiele sind mit ihren ursprünglichen Modellen gekennzeichnet.
Welches KI-Modell sollten Sie als Erstes wählen?
Eine praktische Auswahlliste nach Aufgaben
| Deine Aufgabe | Zu vergleichende Kandidaten | Was sollte die Entscheidung beeinflussen? |
|---|---|---|
| Alltags-Text und Programmierung | GPT-5.6 Terra; Claude Sonnet 5; Gemini 3,8 Flash | Einhaltung der Anweisungen, aussagekräftige Ergebnisse und der Umfang der erforderlichen Bearbeitung. |
| Komplexe Schlussfolgerungen oder umfangreiche Programmierung | GPT-6 Astra; Claude Opus 5 oder Fable 5.1; Qwen3.8 | Erfolg bei Ihren eigenen schwierigen Fällen – mit den erforderlichen Werkzeugen und Berechtigungen. |
| Umfangreiche Dokumente und gemischte Eingaben | Gemini 3.1 Pro Vorschau; aktuelle GPT- und Claude-Modelle | Dateiunterstützung, präziser Abruf und Quellenangaben – nicht nur die Speicherkapazität allein. |
| Aktuelle Forschungsergebnisse | Ein Assistent mit Suchfunktion; Perplexity; Grok mit Suchwerkzeugen | Qualität der Quellen, Veröffentlichungsdaten und ob die Zitate die Antwort stützen. |
| API-Arbeiten mit hohem Arbeitsaufkommen | GPT-5.6 Luna; DeepSeek V4.1 Flash; ein geeignetes kleineres Qwen-Modell | Kosten pro akzeptiertem Ergebnis sowie Anforderungen hinsichtlich Latenz und Bereitstellung. |
| Erstellung und Bearbeitung von Bildern | GPT Image 2.5; Nano Banana-Familie; Midjourney | Textgenauigkeit, Kontrolle anhand von Referenzbildern, visueller Stil und Wiederholbarkeit. |
| Videoproduktion | Veo 3.1 und Videotools mit den Funktionen, die Sie benötigen | Bewegung, Kontinuität, Ton, editierbarer Arbeitsablauf und praktischer Export. |
Stimmen Sie zunächst die erforderlichen Voraussetzungen und Werkzeuge ab und vergleichen Sie die Kandidaten dann anhand eines Ergebnisses, das Sie überprüfen können.
Kaufen Sie nicht für jede Anforderung das leistungsstärkste Modell. Routinemäßige Datenextraktion, kurze Überarbeitungen und Formatierungen haben oft ein klares „Bestanden/Nicht bestanden“-Ziel. Heben Sie sich ein leistungsfähigeres Modell für die Fälle auf, in denen eine kostengünstigere Option dieses Ziel nicht erreichen kann. Bei einer einmaligen Aufgabe kann die einfachste brauchbare App wichtiger sein als ein geringer Unterschied bei den API-Kosten.
KI-Modelle, Apps und Abonnements sind verschiedene Optionen
Ein KI-Modell ist das System, das aus Ihrer Eingabe eine Ausgabe generiert. Eine App ergänzt die Arbeitsumgebung um Funktionen wie Datei-Uploads, Suchfunktion, gespeicherte Unterhaltungen, Bildbearbeitungswerkzeuge oder Anbindungen an andere Software. Ein Abonnement legt fest, wie Sie auf diese Umgebung zugreifen und welche Nutzungslimits gelten. GPT ist eine Modellfamilie, ChatGPT ist ein Produkt und ein ChatGPT-Tarif ist eine Kaufentscheidung. Die gleiche Unterscheidung gilt für Claude-Modelle und Claude Pro.
GlobalGPT ist eine Multi-Modell-Plattform und gehört daher in die Diskussion über Workflows und Zugriffsmöglichkeiten. Perplexity ist in diesem Vergleich in erster Linie ein forschungsorientiertes Produkt; seine API-Modelle und Entwicklerdienste bilden eine separate Ebene. All diese Namen in einer einzigen Rangliste der “besten Modelle” zusammenzufassen, erschwert die Kaufentscheidung, da die einzelnen Angebote unterschiedliche Probleme lösen.

- Wählen Sie ein app wenn Sie eine sofort einsatzbereite Benutzeroberfläche für Dateien, Chats oder kreative Arbeit benötigen.
- Wählen Sie ein API wenn Software automatisch Anfragen senden und die Ergebnisse verarbeiten muss.
- Wählen Sie ein Einsatz mit offenem Gewicht wenn der eigenständige Betrieb des Modells Teil der Anforderungen ist. Berücksichtigen Sie bei dieser Entscheidung auch die Kosten für Hardware, Wartung und Sicherheit.
Ein Modell, das Bilder als Eingabe akzeptiert, erzeugt nicht automatisch Bilder als Ausgabe. Ebenso bedeutet ein großes Kontextfenster nicht, dass die Chat-App Dateien beliebiger Größe akzeptiert. Prüfen Sie, ob das Modell, die Produktfunktionen und der Tarif zu Ihren Anforderungen passen, bevor Sie Preise vergleichen.
Modelle für Text, Programmierung und logisches Denken, die in die engere Auswahl kommen sollten
OpenAI: GPT-6 Astra und die GPT-5.6-Familie
Der Modellkatalog von OpenAI empfiehlt GPT-6 Astra für komplexe Schlussfolgerungen und Programmieraufgaben, GPT-5.6 Terra für ein ausgewogenes Verhältnis zwischen Leistungsfähigkeit und Kosten sowie GPT-5.6 Luna für kostensensible Aufgaben mit hohem Arbeitsaufkommen. GPT-5.6 Sol wird ebenfalls für komplexe fachliche Aufgaben aufgeführt. Es handelt sich hierbei um unterschiedliche Budget- und Aufgabenoptionen innerhalb einer Produktfamilie und nicht um Gründe, automatisch das teuerste Modell zu wählen.
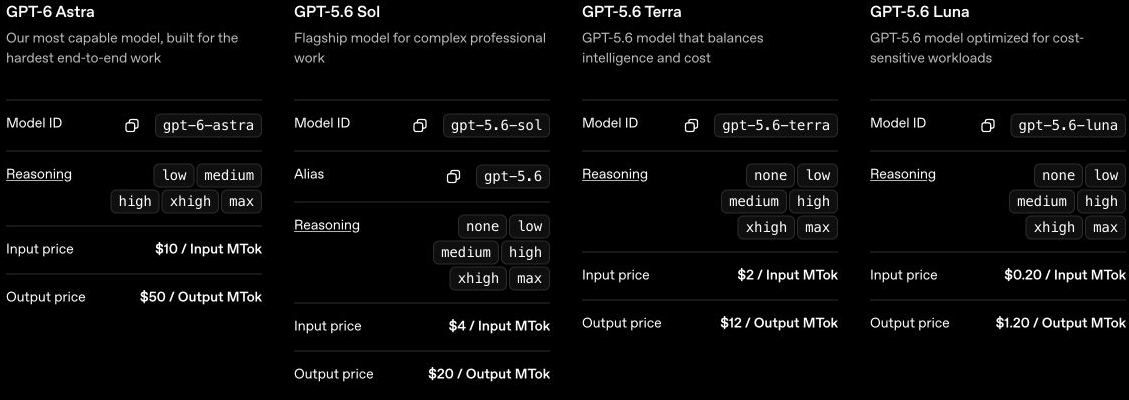
Für einen Entwickler ist es hilfreich, bei zwei Kandidaten dieselbe fehlerhafte Funktion, dieselbe Testsuite und dieselben Abnahmekriterien zu vergleichen. Als Analyst sollten Sie dieselben Quelldokumente verwenden und beide Modelle auffordern, die Belege für jede Schlussfolgerung zu benennen. Eine flüssige Erklärung reicht nicht aus, wenn der Code nicht läuft oder das zitierte Dokument etwas anderes aussagt.
- Hier geht es los für: eine Mischung aus Text, strukturierten Aufgaben, logischen Überlegungen und Programmieraufgaben.
- Vergleiche: Terra oder Luna für Routineaufgaben; Sol oder Astra, wenn die höheren Kosten aufgrund komplexerer Fälle gerechtfertigt sind.
- Zugang: Bei den unten aufgeführten API-Preisen handelt es sich um Gebühren für Entwickler-Token. Diese sind unabhängig von ChatGPT-Abonnements und toolspezifischen Gebühren.
Claude: Sonnet 5, Opus 5 und Fable 5.1
Das aktuelle Sortiment von Anthropic Umfasst Claude Sonnet 5, Opus 5, Fable 5.1 und Haiku 4.5. Anthropic empfiehlt Opus 5 für die meisten Arbeitslasten und Fable 5.1 für anspruchsvolle Schlussfolgerungen oder agentische Aufgaben mit langem Zeithorizont, wenn die Bewertungen auf Opus noch zu wünschen übrig lassen. Das ist eine nützliche Upgrade-Regel: Man sollte erst dann in das leistungsstärkere Modell investieren, wenn ein tatsächlicher Fehlschlag festgestellt wurde, und nicht bereits vor dem Versuch, die Aufgabe zu lösen.
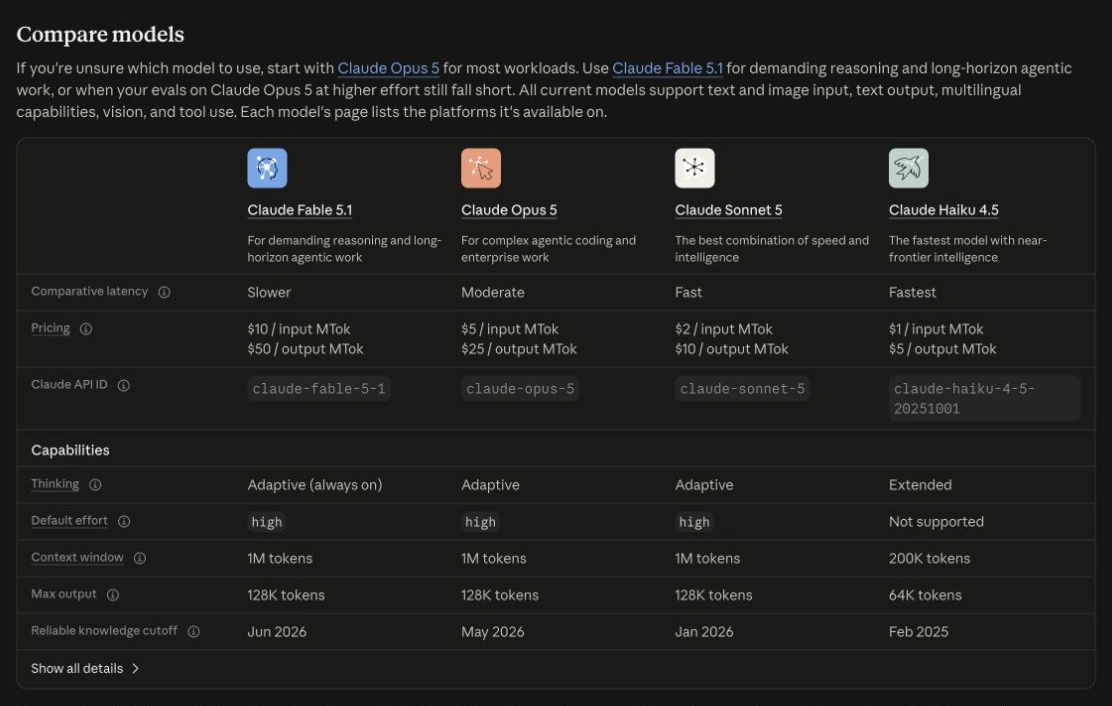
Beim Schreiben sollten Sie beurteilen, ob das Modell Ihre Fakten, Ihren Stil und Ihre Vorgaben über mehrere Überarbeitungsrunden hinweg beibehält. Beim Programmieren sollten Sie die dadurch erzielten Änderungen und die Tests, die das Modell besteht, bewerten. Eine ausführliche Antwort kann zwar beeindruckend sein, ist aber aufwendig zu prüfen. Bitten Sie um das kleinstmögliche vollständige Ergebnis: einen überarbeiteten Abschnitt, einen funktionierenden Patch oder eine Entscheidung mit nachvollziehbarer Begründung.
- Hier geht es los für: umfangreiche schriftliche Arbeiten, Code-Reviews und Projekte, die einen sorgfältigen Umgang mit den bereitgestellten Materialien erfordern.
- Vergleiche: Sonnet 5 als Standardkonfiguration; Opus 5 oder Fable 5.1 für anspruchsvolle Aufgaben. Hierbei handelt es sich um eine Auswahlreihenfolge, nicht um eine eigenständige Qualitätsrangliste.
- Zugang: Claude-App-Abonnements und die API-Abrechnung unterscheiden sich voneinander. Vergleichen Sie Claude-Pläne und die API und Aufschlüsselung der Nutzung für die Strecke, die Sie kaufen möchten.
Wenn Sie sich zwischen den beiden Ökosystemen entscheiden müssen, dann ist das Vergleich zwischen Claude und ChatGPT befasst sich mit Überlegungen auf Produktebene. Übertragen Sie die Benchmark-Position eines älteren Modells nicht auf eine neue Version mit ähnlichem Namen.
Gemini: Vorschau auf Flash 3.8 und Pro 3.1
Das Modellverzeichnis von Google Führt Gemini 3.8 Flash als stabiles Modell und Gemini 3.1 Pro als Vorschau auf. Es beschreibt 3.8 Flash im Zusammenhang mit Softwareentwicklung, autonomen Agenten und komplexen Unternehmensabläufen; 3.1 Pro bleibt ein Kandidat für die Lösung komplexer Probleme. “Flash” und “Pro” sind Produktfamilienbezeichnungen, daher sind die genaue Version und der Veröffentlichungsstatus wichtiger als die Bezeichnung allein.
Gemini verdient einen Platz auf der Auswahlliste, wenn eine Aufgabe gemischte Eingaben umfasst, wie beispielsweise einen Bericht plus Bilder oder ein Video plus ein Transkript. Prüfen Sie, ob sich die Antwort auf die richtige Seite, den richtigen Bildausschnitt oder die richtige Passage bezieht. Dadurch lässt sich ein häufiger Fehler im Zusammenhang mit langen Kontexten erkennen: Das Modell akzeptiert das Material, greift jedoch auf das falsche Detail daraus zurück.

Google's ursprüngliche Vergleichstabelle liefert den oben gezeigten Vergleich der beiden älteren Versionen. Er ist hilfreich, um die Benchmark-Bedingungen nachzuvollziehen. Zeilen, in denen Tools zum Einsatz kommen, und Zeilen ohne Tools geben Aufschluss über unterschiedliche Aspekte. Der Abschnitt mit dem erweiterten Kontext unterscheidet zudem zwischen einem Durchschnittswert von 128K und einem punktweisen Ergebnis von 1M. Behalten Sie diese Unterscheidungen im Auge, wenn Sie eine Behauptung über “bessere Schlussfolgerungen” oder “längeres Gedächtnis” bewerten.”
Bei Fragen zum Kauf und zur Einrichtung siehe Gemini-Abonnementoptionen und Einrichtung des Gemini-Abonnements. Das Vergleich zwischen Gemini 3.1 Pro und Claude Opus 4.6 ist ein versionsspezifischer Vergleich und kein Hinweis auf die neuere Claude-Produktreihe.
Grok 4.6: Das Modell von der Live-Suche trennen
Die Dokumentation zum Modell Grok Gibt für Code- und allgemeine Textaufgaben einen Wert von Grok 4,6 an, bei einem Kontextfenster von 500.000 Token. Außerdem wird eine entscheidende Einschränkung genannt: Ein Modell kennt keine aktuellen Ereignisse, die über seine Trainingsdaten hinausgehen, es sei denn, Suchwerkzeuge sind aktiviert. Für aktuelle Informationen sind in der Praxis „Web Search“ oder „X Search“ die richtige Wahl, nicht einfach nur der Name „Grok“.

Bei einem Workflow zur Nachrichten- oder Trendbeobachtung sollten Sie prüfen, ob der Assistent den Originalbericht findet, dessen Datum von einem Repost unterscheidet und die Behauptung mit der Quelle verknüpft. Die Suche kann zwar Material abrufen, ohne dass die endgültige Interpretation korrekt ist. Bei der Erstellung von Evergreen-Texten oder Programmieraufgaben sollten Sie das Ergebnis mit Ihren Akzeptanzkriterien vergleichen, anstatt davon auszugehen, dass die Verknüpfung mit sozialen Suchergebnissen Grok ungeeignet macht.
DeepSeek: Aktuelle API-Optionen und Kostenkontrolle
Die API-Tabelle von DeepSeek Karten deepseek-flash auf DeepSeek V4.1 Flash und deepseek-v4-pro zu DeepSeek V4 Pro 0813. Aus derselben Tabelle geht hervor, dass „Flash“ Vision unterstützt, während dies bei der aufgeführten „Pro“-Variante nicht der Fall ist. Ein imposanter klingender Name ist daher keine Garantie dafür, dass Ihr Anschluss unterstützt wird.
DeepSeek ist ein nützlicher, kostenbewusster API-Kandidat, doch sollten Sie die vollständigen Abrechnungsbedingungen vergleichen. In den angegebenen Tarifen wird zwischen Cache-Treffern und Cache-Fehlern sowie zwischen Spitzen- und Nebenzeiten unterschieden. Ein angegebener Mindestpreis bezieht sich möglicherweise auf eine zwischengespeicherte Eingabe während eines bestimmten Zeitraums und nicht auf die Kosten einer gewöhnlichen, nicht zwischengespeicherten Anfrage.
- Hier geht es los für: wiederkehrende API-Workloads, bei denen Preis und Kompatibilität bei der Bereitstellung eine Rolle spielen.
- Zuerst prüfen: Genaue Modellzuordnung, Unterstützung für Bilddaten als Eingabe und Anforderungen an die Ausgabe.
- Richtig budgetieren: Verwenden Sie für eine vorsichtige erste Schätzung die Eingabe- und Ausgaberaten ohne Caching; nutzen Sie Caching oder Zeitersparnisse durch Timing erst dann, wenn Ihre Arbeitslast die Voraussetzungen dafür erfüllt.
Qwen: eine offene Modellreihe mit verschiedenen Größen
Das offizielle Repository von Qwen umfasst die offene Baureihe Qwen3.5, einschließlich der Versionen 3.6 und der neueren Qwen3.8. Darin sind die Modelle Qwen3.8-27B und Qwen3.8-2.4T-A95B aufgeführt, während zu den früheren 3.5-Größen die Modelle 0.8B, 2B, 4B und 9B gehören. Diese Bezeichnungen stehen für sehr unterschiedliche Einsatzanforderungen; ein kleines lokales Modell und ein großes Flaggschiff sind nicht austauschbar.

Die entscheidende Frage für die lokale Verarbeitung lautet: “Was lässt sich auf meiner Hardware gut ausführen?” Berücksichtigen Sie dabei Modellgewichte, den Laufzeit-Overhead und den Speicherbedarf einer sich ausweitenden Konversation. Durch Quantisierung lässt sich ein Modell möglicherweise leichter ausführen, doch ihre Auswirkungen auf Ihre Aufgabe sollten im Rahmen der Bewertung berücksichtigt werden. Das Repository dokumentiert lokale Framework-Optionen wie „llama.cpp“ und „MLX“; lesen Sie vor der Bereitstellung die genaue Modellbeschreibung und die Lizenzbedingungen sorgfältig durch.
Wählen Sie für Ihre Recherche Quellen und Suchwerkzeuge sowie ein Modell aus
Perplexity ist ein Such- und Rechercheprodukt, das Antworten mit Quellenangaben kombiniert. Die Zugangsrechte zu Suchwerkzeugen, Modellen und Uploads richten sich nach den jeweiligen Verbraucher-Tarifen; Sonar und die API-Dienste für Entwickler sind separat erhältlich. Eine Antwort mit zahlreichen Quellenangaben ist nur dann nützlich, wenn die verlinkten Quellen die darin enthaltenen Kernaussagen tatsächlich untermauern.
Für gelegentliche Recherchen beginnen Sie mit der kostenlosen Version: einfache Suchanfragen, automatische Modellauswahl und begrenzte Upload-Möglichkeiten. Die Vergleich der offiziellen Pläne, Stand: 15. September 2026, listet 3 „Pro Search“-Suchanfragen pro Tag und 1 „Research“-Abfrage pro Monat kostenlos auf, ohne erweiterte KI-Modelle oder Bildgenerierung. Die Pro-Version bietet erweiterte Modelle, eine erweiterte Pro-Suche sowie höhere Upload- und Analyse-Limits. Das Kontingent für die Pro-Suche unterliegt wöchentlichen Limits, das für „Research“ monatlichen Limits; die Tabelle für Privatkunden enthält keine genauen Angaben zu den Pro-Kontingenten.
Perplexität Seite mit individuellen Preisen, Stand: 15. September 2026, listet „Free“ mit $0/Monat, „Pro“ mit $20/Monat und „Max“ mit $200/Monat auf. Dabei handelt es sich um die angezeigten monatlichen Preise, nicht um Jahrespreise oder Endbeträge inklusive Steuern. Testen Sie die kostenlose Version anhand einer repräsentativen Suchanfrage und ziehen Sie dann einen kostenpflichtigen Tarif in Betracht, wenn die erweiterten Modelle oder höheren Nutzungslimits einem wiederkehrenden Bedarf entsprechen.
Erstellen Sie eine kurze Checkliste zur Quellenprüfung, bevor Sie eine Antwort akzeptieren. Öffnen Sie die Quelle für eine wichtige Zahl; prüfen Sie, ob es sich um eine Primärquelle handelt; überprüfen Sie das Veröffentlichungsdatum; und unterscheiden Sie zwischen einem direkten Zitat und der Interpretation des Mitarbeiters. Bei sich ändernden Fakten wie Preisen und Produktverfügbarkeit ist die aktuelle Dokumentation eines Anbieters eine zuverlässigere Quelle als ein zusammenfassender Artikel.
- Für eine Literaturrecherche sollten Sie nach Originalartikeln suchen und die Forschungsfrage ermitteln, mit der sich der jeweilige Artikel befasst.
- Um eine Kaufentscheidung treffen zu können, erkundigen Sie sich nach dem genauen Tarif, der Abrechnungsgrundlage und dem Gültigkeitszeitraum des Angebots.
- Um aktuelle Nachrichten zu vergleichen, vergleichen Sie die zugrunde liegende Meldung mit den anschließend veröffentlichten Berichten.
- Bei einer umstrittenen Frage solltest du dich fragen, in welchen Punkten sich die Quellen einig sind und welche Punkte weiterhin unklar sind.
Verwenden Sie Die Modelle und Modi von Perplexity um die verfügbaren Betriebsmodi zu verstehen, und Perplexity-Abonnementpläne für die Kaufentscheidung. Ein teureres Schlussfolgerungsmodell kann eine Quellenauswahl, bei der das relevante Dokument fehlt, nicht ausgleichen.
Bildvorlagen: Wählen Sie zwischen Bearbeitungsmöglichkeiten, Textgenauigkeit oder visuellem Stil
GPT-Bild: Praktische Erstellung und Bearbeitung
Der aktuelle Katalog von OpenAI enthält „GPT Image 2.5 Sunburst“ für die Erstellung und Bearbeitung von Bildern sowie „GPT Image 2.5 Flare“ für eine schnellere tägliche Bilderstellung. Vergleichen Sie die beiden Programme anhand derselben Werbeanzeige, desselben Diagramms oder desselben Produktbild-Briefings und berücksichtigen Sie dabei auch die Änderungen, die Sie voraussichtlich vornehmen werden.
Geben Sie für eine Unternehmensgrafik den genauen Text, das Layout und die erforderlichen Objekte an. Überprüfen Sie anschließend das Ergebnis in seiner endgültigen Darstellungsgröße. Selbst eine ansprechende Infografik kann eine falsch geschriebene Beschriftung oder eine plausibel wirkende, aber falsche Zahl enthalten. Wenn die Grafik Fakten vermittelt, überprüfen Sie diese Fakten unabhängig vom Erscheinungsbild der Grafik.

Nano Banana: Erstellung und Bearbeitung von Bildern anhand von Vorlagen
Im Google-Verzeichnis werden die Modelle Nano Banana Pro, Nano Banana 2 und Nano Banana 2 Lite unterschieden. Nano Banana Pro entspricht gemini-3-pro-image; Nano Banana 2 bis gemini-3.1-flash-image; und Lite zu gemini-3.1-flash-lite-image. Wählen Sie beim Vergleich des Generierungs- und Bearbeitungsverhaltens den genauen Pfad aus, anstatt den Spitznamen als ein unveränderliches Modell zu betrachten.

Bearbeitungen anhand von Referenzbildern erfordern eine andere Überprüfung als die einmalige Bildgenerierung. Wurde die gewünschte Änderung vorgenommen? Haben sich der Hintergrund, die Kleidung, das Gesicht oder Produktdetails unbeabsichtigt verändert? Eine kleine Bearbeitung, bei der der Rest des Bildes erhalten bleibt, kann sinnvoller sein als eine drastische Neugestaltung. Siehe Erste Schritte mit Nano Banana Pro, Zugangswege und Kosten für Nano Banana Pro für die nächsten Schritte.
Midjourney: Den Stil anhand der Vorgaben bewerten
Midjourney’s Offizieller Leitfaden, abgerufen am 15. September 2026, nennt V8.2 als Standardversion, die am 24. Juli veröffentlicht wurde. Das Update konzentriert sich auf Ästhetik und Personalisierung und führt ein „Edit Model“ ein, das „Omni Reference“, „Character Reference“ und „Retexture“ ersetzt. Ziehen Sie es für Moodboards, Konzeptkunst oder eine unverwechselbare Kampagnengestaltung in Betracht. Eine Konzeptskizze benötigt einen überzeugenden Stil; ein beschriftetes Produktdiagramm erfordert exakte Inhalte. Vergleichen Sie das Ergebnis und seine Überarbeitungen mit diesem Briefing.
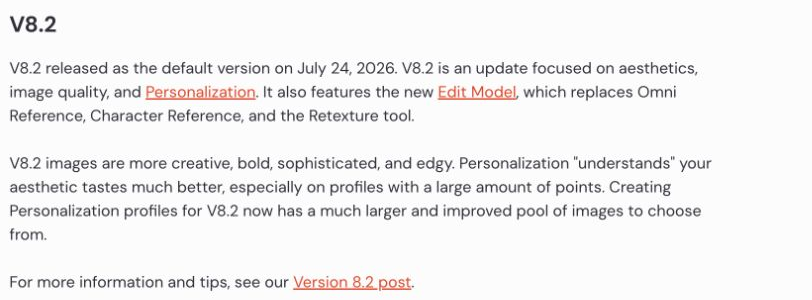

Um einen aussagekräftigen Test durchzuführen, sollten Sie das Thema, die gewünschte Zusammensetzung und das Exportformat einheitlich halten. Prüfen Sie, ob Sie die gewählte Ausrichtung anpassen können, ohne von vorne beginnen zu müssen. Wenn die exakte Beibehaltung von Text oder Identität unerlässlich ist, führen Sie diesbezüglich explizite Erfolg/Misserfolg-Prüfungen durch. Die Vergleich zwischen Nano Banana Pro und Midjourney bietet eine weitere Möglichkeit, diese Entscheidung zu betrachten.
Videomodelle: Bewerten Sie den gesamten Clip, nicht nur ein einzelnes attraktives Bild
Veo 3.1 und der Produktionsablauf
Googles Dokumentation zu Veo beschreibt Veo 3.1 für die Videoproduktion mit kreativen Steuerungsmöglichkeiten und Audio. Zu den Beispielen gehören Referenzbilder, Szenenerweiterung sowie Workflows für das erste und letzte Bild. Diese Steuerungsmöglichkeiten sind wichtig, wenn mehrere Aufnahmen zu einer gemeinsamen Geschichte gehören sollen und es sich nicht nur um einen einzelnen, isolierten Clip handelt.
Testen Sie die Produktionsbeschränkung, die sich im Nachhinein am schwersten beheben lässt: eine konsistente Figur, ein Produkt, das seine Form behält, gut lesbare Beschilderung oder synchronisierte Dialoge. Sehen Sie sich den gesamten Clip in normaler Geschwindigkeit an und prüfen Sie alle schwierigen Übergänge. Ein Model kann zwar ein starkes Eröffnungsbild liefern, versagt aber möglicherweise, sobald sich die Kamera bewegt.
Zugriff, Nutzung und Exporte hängen vom Produktpfad ab; vergleichen Sie daher die Veo 3.1 Abonnement- und Nutzungsoptionen neben den kreativen Steuerungsmöglichkeiten. Vergleichen Sie eine API-Rate pro Sekunde nicht direkt mit einem Monatsabo, ohne dabei das inbegriffene Nutzungsvolumen und die Art der Ausgabe zu berücksichtigen.
Sora: Erklärung zur angekündigten Schließung
OpenAIs Mitteilung zur Einstellung von Sora, die am 11. September 2026 veröffentlicht wurde, hieß es, dass die Web- und App-Funktionen am 26. April eingestellt worden seien und die Abschaltung der API für den 24. September 2026 geplant sei. Betrachten Sie Sora eher als Migrationsfrage für ein bestehendes Projekt und nicht als Ausgangspunkt für einen neuen Video-Workflow. Überprüfen Sie die Mitteilung auf etwaige geänderte Termine und aktuelle Exportanweisungen.

Die Arbeitsablauf beim Storyboard für „Sora“, Sora 2 Pro – Erläuterung und Versionsspezifische Anleitung zur Dauer von „Sora“ Beschreiben Sie historische Merkmale. Nutzen Sie diese, um zu ermitteln, was bei einem bestehenden Projekt erhalten bleiben muss, und vergleichen Sie anschließend Sora Alternativen im Hinblick auf diese Anforderungen. Bewahren Sie die Eingabeaufforderung, das Referenzmaterial und die vollständige Ausgabe zusammen auf, damit Sie einen Ersatz anhand derselben Vorgaben bewerten können.
API-Kosten bei gleicher Arbeitslast vergleichen
Die API-Abrechnung erfolgt auf Basis von Eingabe- und Ausgabetoken; ein Verbraucherabonnement gewährt Zugriff im Rahmen eines Tarifs. Halten Sie diese Budgets getrennt. Die folgende Berechnung basiert auf 100 Anfragen mit jeweils 10.000 nicht zwischengespeicherten Eingabe-Tokens und 1.000 abrechnungsrelevanten Ausgabe-Tokens: insgesamt 1 Million Eingabe-Tokens plus 100.000 Ausgabe-Tokens. Es handelt sich um ein Beispielszenario, nicht um eine gemessene Rechnung oder einen Qualitäts-Benchmark.
USD, standardmäßige Token-Sätze, Stand: 15. September 2026. Kurzanfragen wie angegeben; ohne Cache-Rabatt, Mengenrabatt, Prioritätsstufe, Steuern oder kostenpflichtige Tools. Das Ausgabekontingent umfasst gegebenenfalls in Rechnung gestellte Reasoning-Token. Quellen: Modellkatalog OpenAI, Modellübersicht Anthropic, Grok-Modelle und Preise.
Das günstigste Modell ist nur dann sinnvoll, wenn die Ergebnisse Ihre Prüfungen bestehen. Wenn ein kostengünstigeres Modell wiederholte Versuche oder umfangreiche manuelle Korrekturen erfordert, vergleichen Sie die Kosten pro akzeptiertem Ergebnis. Beginnen Sie bei klaren, sich wiederholenden Aufgaben mit einem kostengünstigeren Modell und leiten Sie schwierige Fälle an ein leistungsfähigeres Modell weiter, wenn das erste Ergebnis fehlschlägt.
Die der Berechnung zugrunde liegenden Sätze
| Modell | Eingabe / 1 Mio. Token | Ausgabe / 1 Mio. Token |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| Grok 4,6 | $2.00 | $6.00 |
| Claude Sonett 5 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
Es handelt sich hierbei um API-Tarife, nicht um monatliche Abonnementgebühren. Bei dem oben genannten Workload bleiben die Eingabe- und die abgerechnete Ausgabegröße konstant; es wird nicht davon ausgegangen, dass Ausgabelänge, Genauigkeit oder Geschwindigkeit den realen Bedingungen entsprechen.
DeepSeek verwendet einen anderen zeitabhängigen Tarif. Die aktuelle Flash-Tabelle der Version 4.1 listet für den nicht zwischengespeicherten Eingang $0,15 in der Nebenzeite bzw. $0,30 in der Spitzenzeit und für den Ausgang $0,60 in der Nebenzeite bzw. $1,20 in der Spitzenzeit pro Million Token auf. V4 Pro listet $0.66/$1.32 für nicht zwischengespeicherte Eingaben und $1.98/$3.96 für Ausgaben auf. Die dokumentierten Spitzenzeiten sind Montag bis Freitag von 01:00 bis 04:00 Uhr und von 06:00 bis 10:00 Uhr UTC. Verwenden Sie den Tarif, der zum Zeitpunkt der Ausführung der Aufgabe gilt; Preise für zwischengespeicherte Eingaben sind in einer separaten Berechnung zu berücksichtigen.
Für einen gemischten Arbeitsablauf im Alltag, Das Multi-Modell-Abonnement von GlobalGPT bietet eine einfachere Möglichkeit, Recherche, Entwurf, Unterstützung bei der Programmierung und kreative Gestaltung gemeinsam zu bewältigen. Vergleichen Sie diesen Komfort und diese Bandbreite mit der Verwaltung mehrerer Abonnements oder der eigenständigen Einrichtung eines API-Workflows. Eine API-Preistabelle enthält keine Angaben zum Preis des Abonnements oder zu den Nutzungsbedingungen.
Open-Weight oder gehostet: Entscheiden Sie, wie viel Sie selbst verwalten möchten
Offene Gewichte bieten Ihnen eine Einsatzmöglichkeit: die Ausführung eines Modells in einer von Ihnen kontrollierten Umgebung. Sie machen den gesamten Arbeitsablauf jedoch nicht automatisch kostenlos, privat oder uneingeschränkt. Prüfen Sie die für das jeweilige Modell geltende Lizenz, die für dessen Ausführung erforderliche Hardware sowie die Speicherorte, an die die zugehörige Anwendung Dateien oder Protokolle sendet.
- Wählen Sie eine gehostete App aus wenn Sie schnell loslegen möchten und das Modell nicht bedienen müssen.
- Wählen Sie eine gehostete API aus wenn Sie Automatisierung benötigen, ohne Inferenz-Hardware warten zu müssen.
- Erwägen Sie eine lokale Bereitstellung wenn sich dies aufgrund von Offline-Arbeit, der Steuerung der Infrastruktur oder einer bestimmten Anforderung an die Datenverarbeitung lohnt.
- Vergleichen Sie kleinere Modelle auf Ihrer Hardware bevor man davon ausgeht, dass ein Flaggschiff-Modell mit mehr Parametern die praktischere Wahl ist.
Ein lokales Modell kann den Datenverkehr nach außen reduzieren, doch der Rest des Systems spielt weiterhin eine wichtige Rolle: Abruf, Plug-ins, Telemetrie, gespeicherte Verlaufsdaten und Backups. Für ein Team sollte dies eher eine Überprüfung der Bereitstellung sein als ein Versprechen, das sich aus dem Begriff “offen” ableiten lässt. Das Leitfaden zum Datenschutz bei KI bietet einen Kontext für den Vergleich der Anforderungen an die Datenverarbeitung.
Sollte man ein KI-Modell oder mehrere verwenden?
Ein Modell reicht aus, wenn es Ihre wiederkehrenden Aufgaben gut bewältigt. Fügen Sie ein weiteres hinzu, wenn es eine bestimmte Lücke schließt: besseren Zugriff auf Quellen, einen erforderlichen Eingabetyp, eine besser steuerbare Bildbearbeitung oder eine kostengünstigere Stapelverarbeitung. Das Sammeln von Abonnements, ohne jedem einzelnen eine Aufgabe zuzuweisen, führt zu mehr Entscheidungen und mehr Übergaben.

Entwickeln Sie einen Arbeitsablauf rund um das Ergebnis
| Arbeit | Nützliche Abfolge | Abnahmeprüfung |
|---|---|---|
| Marketing | Recherchequellen → Entwurf → Erstellung von Grafiken → Überprüfung der Aussagen | Die Aussagen der Kampagne werden untermauert, und sowohl der Text als auch die Bildmaterialien vermitteln dieselbe Botschaft. |
| Softwareentwicklung | Problem verstehen → Code ändern → Tests ausführen → Unterschiede überprüfen | Die Änderung erfüllt die Anforderung, ohne dass es an anderer Stelle zu unerwarteten Auswirkungen kommt. |
| Erstellung von Inhalten | Gliederung → Drehbuch → Referenzbilder → Videoaufnahmen → Schnitt | Die Figuren, Produktdetails und die Handlung bleiben konsistent. |
| Inbetriebnahme | Eingaben zusammenfassen → Entscheidungen ableiten → Folgemaßnahmen entwerfen | Entscheidungen sind mit Verantwortlichen und Datumsangaben versehen, und es werden keine unbegründeten Tatsachen in das Protokoll aufgenommen. |
| Unternehmensarbeit | Zugelassene Umgebung auswählen → zulässige Daten verarbeiten → Ausgabe überprüfen | Der Arbeitsablauf erfüllt die Anforderungen der Organisation hinsichtlich Zugriff, Daten und Überprüfung. |
Beginnen Sie mit einem fertigen Ergebnis. Bewahren Sie die Quellnotizen und Abnahmeprüfungen zusammen mit der Arbeit auf, während diese zwischen den verschiedenen Tools weitergeleitet wird.
GlobalGPT passt sich dem mehrstufigen Prozess an, indem es Modellfamilien und kreative Funktionen an einem Ort zusammenführt. Behalten Sie die nützlichen Quellnotizen, das Briefing und die Abnahmekriterien beim Wechsel zwischen verschiedenen Aufgaben stets im Blick. Das Übersicht über All-in-One-KI-Modelle ist eine empfehlenswerte Lektüre, wenn die Hauptentscheidung eher auf der Breite des Anwendungsbereichs als auf einem einzelnen Spezialmodell beruht.
So treffen Sie die richtige Wahl: Eine fünfstufige Bewertung, die Sie wiederholen können
- Definieren Sie ein Ergebnis. Zum Beispiel eine 500-Wort-Zusammenfassung mit Seitenangaben, ein Patch, der drei Tests besteht, oder ein Produktbild mit zwei exakten Beschriftungen.
- Wählen Sie zwei plausible Kandidaten aus. Stimmen Sie zunächst die erforderlichen Eingaben und Werkzeuge aufeinander ab. Vergleichen Sie keinen suchfähigen Assistenten mit einem Modell, dem keine Abrufwerkzeuge zur Verfügung stehen, und bezeichnen Sie den Unterschied nicht als Modellintelligenz.
- Verwenden Sie dieselbe Aufgabenstellung und dieselben Vorgaben. Notieren Sie sich das Modell, das Produkt, die Einstellungen und das Datum. Speichern Sie das erste vollständige Ergebnis, anstatt nur den vorteilhaftesten Versuch auszuwählen.
- Überprüfe zuerst die Richtigkeit, dann den Stil. Überprüfen Sie die Quellenangaben, führen Sie entsprechende Code-Tests durch und prüfen Sie die Bild- oder Videodaten. Halten Sie die erforderlichen manuellen Korrekturen fest.
- Wiederhole die schwierigen Fälle. Wenn die Entscheidung knapp ausfällt oder das Ergebnis uneinheitlich ist, wiederholen Sie diese Fälle und halten Sie die zusätzlichen Ergebnisse separat fest. Treffen Sie Ihre Entscheidung anhand der akzeptierten Leistung, des Aufwands und der Gesamtkosten.
Beim Schreiben ist es sinnvoll zu prüfen, ob alle angegebenen Fakten auch nach einer Überarbeitung noch Bestand haben. Bei der Extraktion sollten Sie die Ausgabe mit einem kurzen Lösungsschlüssel vergleichen. Bei der Recherche sollten Sie die zitierten Seiten öffnen. Bei Videos sollten Sie den gesamten Clip speichern und ansehen. Das Methodik zur Modellprüfung nach GlobalGPT bietet zusätzlichen Kontext für die Aufzeichnung von Vergleichen.
Vermeiden Sie vier Fehler: den Kauf aufgrund von Beliebtheitsversprechen, den Vergleich ungleicher Preiseinheiten, die Betrachtung eines einzelnen Benchmarks als die gesamte Aufgabe und das Ignorieren der Zeit, die die Auswertung eines Ergebnisses in Anspruch nimmt. Keines dieser Probleme lässt sich durch die Wahl des neuesten Modellnamens beheben. Eine wiederholbare Bewertung ist nützlicher, da sie bei einer Modelländerung erneut durchgeführt werden kann.
Häufig gestellte Fragen
Was ist derzeit das beste KI-Modell?
Es gibt keinen universellen Gewinner. Beginnen Sie mit den aktuellen Optionen GPT, Claude, Gemini, Grok, DeepSeek oder Qwen für Text und Code und grenzen Sie die Auswahl dann entsprechend Ihrer Aufgabe, den benötigten Tools, den Eingaben und Ihrem Budget ein. Verwenden Sie ein spezielles Bild- oder Videomodell, wenn das Endergebnis dies erfordert.
Welches KI-Modell sollte ich zum Programmieren ausprobieren?
Wählen Sie Kandidaten aus, die Ihren Entwicklungsworkflow unterstützen, beispielsweise aktuelle GPT-, Claude-, Gemini- oder Qwen-Modelle. Vergleichen Sie sie anhand desselben Issues, derselben Codebasis und derselben Tests. Eine erfolgreich durchgeführte Änderung mit geringem Überprüfungsaufwand ist ein besseres Auswahlkriterium als eine überzeugende Erklärung.
Ist ein größeres Kontextfenster immer besser?
Ein größeres Kontextfenster ermöglicht die Einbeziehung von mehr Material in eine Anfrage, garantiert jedoch keine präzise Suche oder Schlussfolgerungen über dieses Material hinweg. Prüfen Sie, ob das Modell die für Ihre Antwort benötigte Stelle, Seite oder den benötigten Rahmen genau ausfindig machen kann.
Sind KI-Modelle mit offenem Gewicht kostenlos?
Die Gewichte sind zwar möglicherweise unter einer Lizenz verfügbar, doch für deren Ausführung sind unter Umständen Hardware, Hosting und Wartung erforderlich. Prüfen Sie die genauen Lizenzbedingungen und die Kosten für die Bereitstellung. Bei einer lokalen Bereitstellung muss zudem die zugehörige Anwendung und deren Datenverarbeitung überprüft werden.
Erkennt Grok automatisch Live-Nachrichten?
Nein. In der API-Dokumentation zu Grok heißt es, dass für aktuelle Informationen Suchwerkzeuge wie „Web Search“ oder „X Search“ erforderlich sind. Das Trainingswissen eines Modells und die bei einer Anfrage abgerufenen Quellen sind zwei verschiedene Dinge.
Kann ich die API-Preise mit einem monatlichen KI-Abonnement vergleichen?
Erst nachdem Sie den Arbeitsaufwand und den Umfang der einzelnen Schritte festgelegt haben. API-Tarife werden in der Regel anhand von Tokens oder Medienausgabe abgerechnet, während ein Abonnement den Zugriff zu planspezifischen Nutzungsbedingungen ermöglicht. Vergleichen Sie die Gesamtkosten Ihres geplanten Workflows, ähnlich wie bei den Listenpreisen.
Muss das beliebteste KI-Modell auch das beste für mich sein?
Nein. Die Beliebtheit sagt nichts darüber aus, ob ein Modell Ihre Dateien verarbeiten kann, Ihre Vorgaben erfüllt oder in Ihr Budget passt. Erstellen Sie anhand der aktuellen Dokumentation eine Vorauswahl und vergleichen Sie dann die tatsächlichen Ergebnisse mit einer Aufgabe, die Sie überprüfen können.
Wählen Sie das Modell, mit dem sich die nächste Aufgabe mit den wenigsten vermeidbaren Korrekturen erledigen lässt. Fangen Sie klein an, notieren Sie sich, was gut funktioniert, und fügen Sie erst dann ein weiteres Modell hinzu, wenn es ein klares Problem löst. Wenn Ihre Arbeit die Bereiche Forschung, Text und kreatives Schaffen umfasst, Probieren Sie diesen Workflow in GlobalGPT aus und beurteilen Sie das Endergebnis.