GPT-6.1 Sol es el modelo equilibrado de OpenAI para la programación compleja, el uso de ordenadores y el trabajo profesional. Mantiene la ventana de contexto de 1 050 000 tokens y el límite máximo de salida de 128 000 tokens de GPT-6 Astra, pero el precio de la API estándar se reduce a $2 por millón de tokens de entrada y a $10 por millón de tokens de salida. Esto supone una quinta parte de las tarifas por token actuales de Astra. La compensación es sencilla: Astra sigue siendo el producto estrella, mientras que Sol pretende ofrecer la capacidad suficiente para aquellos equipos que se preocupan por el coste por tarea completada.
Esta guía distingue entre lo que Documentos OpenAI para GPT-6.1 Sol según lo observado por creadores independientes en las primeras pruebas. También muestra la regla de precios basada en contextos largos, ejemplos realistas de costes, un patrón funcional de la API de respuestas y una forma práctica de elegir entre Sol, Astra, Luna y el anterior GPT-6 Sol.
¿Qué es GPT-6.1 Sol?
GPT-6.1 Sol es el modelo Sol más reciente de la familia GPT-6 de OpenAI. La descripción oficial lo define como un modelo destinado a la programación compleja, el uso de ordenadores y el trabajo profesional, con un rendimiento similar al de Astra a un coste menor. En la jerarquía de la familia, Astra es la opción de mayor capacidad, Luna es la opción más eficiente y Sol es la vía intermedia para tareas lo suficientemente complejas como para requerir un razonamiento sólido, pero lo suficientemente frecuentes como para que el coste unitario sea un factor importante.
El ID del modelo es gpt-6.1-sol. Esa cadena concreta es importante en las llamadas a la API, los registros de pruebas, los registros de facturación y la configuración de la implementación. La antigua gpt-6-sol sigue siendo un modelo diferente, aunque los precios de entrada y salida no almacenados en caché coincidan. La página de OpenAI dedicada al modelo anterior ahora remite a los lectores a la versión más reciente, mientras que nuestra Análisis de GPT-6 Sol y límites de la API ofrece la referencia histórica.
La razón más clara para interesarse por esta actualización no es una simple cifra de la tabla de clasificación. Es la combinación de una ventana de contexto de gran tamaño, una amplia compatibilidad con herramientas, cinco niveles de esfuerzo de razonamiento y un precio que invita a un uso más generalizado que el de Astra. Un modelo ligeramente menos potente, pero lo suficientemente asequible como para utilizarlo en cualquier borrador importante, revisión de código o flujo de trabajo de varios pasos, puede aportar más valor que un producto estrella reservado para ocasiones excepcionales.
Aún hay que comprobar si esa configuración se adapta a tus propias tareas. OpenAI’s orientación sobre la selección de modelos Recomienda expresamente comparar Sol con Astra en el mismo trabajo. Un flujo de trabajo de documentos jurídicos, una refactorización de un repositorio, un agente de navegador y una presentación en pizarra pueden poner a prueba diferentes capacidades. Considera la etiqueta del modelo como una hipótesis inicial y, a continuación, mide la exactitud, el número de revisiones, la latencia y el coste total por resultado aceptado.
Especificaciones del GPT-6.1 Sol
En catálogo oficial de modelos Enumera las entradas de texto e imágenes con salida de texto. El audio y el vídeo no son modalidades de entrada ni de salida compatibles con el propio modelo. Esta distinción resulta útil a la hora de diseñar un producto: se pueden enviar capturas de pantalla, diagramas, páginas escaneadas u otras imágenes, pero la transcripción de audio y la comprensión de vídeo requieren un componente o una herramienta independientes.
Su entrada máxima es inferior a la ventana de contexto principal, ya que la salida y el procesamiento interno necesitan espacio dentro del presupuesto total. El límite máximo de salida de 128 000 tokens es generoso, pero solicitar una respuesta muy extensa rara vez es el mejor diseño. Las salidas largas cuestan más, tardan más en revisarse y pueden desviarse. Para la mayoría de los trabajos de software, las salidas estructuradas más pequeñas con puntos de control son más fáciles de validar.
Apoyo al razonamiento bajo, medio, alto, xalto, y máx.; «medium» es el valor predeterminado. El ninguno y mínimo Los ajustes no están disponibles. Utiliza un esfuerzo menor para las transformaciones rutinarias y auméntalo solo cuando el coste del error o la complejidad de una tarea justifiquen el gasto adicional de tokens y tiempo. El objetivo práctico es el ajuste más ligero que aún permita superar las pruebas de aceptación.
Los desarrolladores que deseen comparar los precios anteriores y el comportamiento de los tokens pueden utilizar nuestro Ejemplos de precios y costes de GPT-6 Sol como punto de referencia. El cambio clave en las especificaciones no es el tamaño del contexto, que se mantiene uniforme en todos los modelos GPT-6 que se tratan aquí. Se trata del posicionamiento actualizado del nuevo Sol y de una entrada en caché más económica.
Rendimiento: lo que revelan los datos oficiales
Según la presentación de lanzamiento de OpenAI, GPT-6.1 Sol mejora sustancialmente a GPT-6 Sol en tareas profesionales complejas, como escribir y depurar código, comprender documentos y ejecutar flujos de trabajo empresariales de varios pasos. La empresa afirma que, en varias evaluaciones, se acerca a GPT-6 Astra a un coste menor. Se trata de afirmaciones oficiales de evaluación, no de una garantía de que cada solicitud vaya a dar resultados similares a los de Astra.
En Anexo a la ficha del sistema solar GPT-6.1 Esto establece un límite importante: las evaluaciones se realizaron en el entorno de investigación de OpenAI o a través de la API, y el entorno de producción de ChatGPT puede diferir, ya que las indicaciones del sistema, las herramientas disponibles y los ajustes de esfuerzo no son idénticos. Por eso, un artículo riguroso debe mantener separada la evidencia oficial de las pruebas de rendimiento de las pruebas realizadas por el creador y de la evaluación interna de la empresa.
Un ejemplo concreto es HealthBench. En la tabla publicada, GPT-6.1 Sol registra puntuaciones ajustadas por longitud de 64,2 en HealthBench Professional, 58,5 en HealthBench, 36,2 en HealthBench Hard y 96,0 en HealthBench Consensus. Las puntuaciones correspondientes de Astra son 64,7; 58,3; 36,6 y 95,5. OpenAI describe que los modelos se sitúan en un margen de 0,5 puntos porcentuales en esas cuatro evaluaciones.
Ese resultado respalda la expresión “cerca de Astra” dentro de esa familia de evaluaciones. No demuestra que la calidad de la ingeniería de software, la fiabilidad del navegador o el estilo de presentación sean iguales. Una prueba de rendimiento de «salud» mide una capacidad distinta a la de corregir una condición de carrera o coordinar herramientas. Para un análisis más detallado del perfil de pruebas más amplio del modelo insignia, consulta el Reseña y pruebas prácticas del GPT-6 Astra.
La interpretación práctica más sólida es condicional: GPT-6.1 Sol forma parte del grupo de candidatos para tareas exigentes, especialmente cuando el precio de Astra limitaría su uso. Merece una evaluación comparativa, no una promoción automática. Hay que medir la tasa de aprobación, el número de correcciones humanas, los errores de la herramienta, los tokens generados y el tiempo necesario para obtener un resultado aceptado. Esas métricas convierten la comparación de modelos en una decisión empresarial.
Programación: lo que puede hacer GPT-6.1 Sol
GPT-6.1 Sol cuenta con los componentes básicos que se esperan de un modelo de programación moderno: procesamiento en tiempo real, salidas estructuradas, llamada a funciones, búsqueda de archivos, entrada de imágenes, búsqueda en la web y almacenamiento en caché de indicaciones. A través de la API de respuestas, OpenAI también incluye un intérprete de código, un shell alojado, la aplicación de parches, habilidades, uso de ordenadores, MCP y búsqueda de herramientas. Esto hace que el modelo sea adecuado para flujos de trabajo que inspeccionan archivos, proponen cambios, ejecutan comandos y devuelven resultados verificados por la máquina.
El soporte de capacidades no significa que todos los entornos expongan todas las herramientas automáticamente. Tu aplicación sigue decidiendo qué herramientas existen, qué permisos reciben, cómo se devuelven los resultados al modelo y qué acciones requieren confirmación. La función «Chat Completions» funciona con GPT-6.1 Sol sin necesidad de llamar a herramientas, mientras que OpenAI redirige las aplicaciones que utilizan herramientas a «Responses». Los nuevos sistemas de tipo «agente» deberían considerar ese límite de la API como una elección arquitectónica, no como una diferencia sintáctica menor.
En el momento de la publicación, el modelo exacto no figuraba en el catálogo del chat del centro de pruebas, por lo que esta guía no pretende establecer una nueva referencia interna para las cuatro tareas de programación previstas. La evaluación de la programación se basa en datos oficiales de capacidad y en ejecuciones públicas identificadas. Esto resulta más útil que sustituir discretamente a Astra o al antiguo Sol y atribuir al resultado un nombre de modelo erróneo.
Una evaluación sólida debe incluir la depuración con pruebas de regresión, una función de múltiples archivos acotada, una revisión de seguridad y una decisión de ingeniería sujeta a restricciones de esquema. Estas tareas van más allá de la mera generación de código. Revelan si el modelo conserva una API, detecta casos extremos, respeta las restricciones de salida e indica lo que no ha podido verificar. Nuestra Guía de los mejores modelos de IA para la programación en 2026 explica por qué la mejor opción varía en función del flujo de trabajo.
Encuentra el defecto más pequeño, mantén la API y añade pruebas ejecutables.
Respeta la concurrencia, el orden, la validación y el comportamiento ante fallos.
Prioriza las vías de explotación, ofrece una solución mínima y evita las afirmaciones inventadas sobre el marco de trabajo.
Cuando ejecutes un comando como este, evalúa el resultado de forma mecánica. ¿Se mantiene el cero? ¿Se eliminan los duplicados? ¿Es correcta la ordenación numérica? ¿Se ejecutan las pruebas con node --test? Una explicación bien redactada no puede compensar una afirmación errónea. La misma disciplina se aplica al trabajo con repositorios: define las condiciones de aceptación antes de elegir el modelo y, a continuación, revisa el parche en lugar de fiarte de la calidad del texto.
Precios de GPT-6.1 Sol
En página oficial de precios de la API Mide las tarifas de GPT-6.1 Sol por cada millón de tokens. La entrada cuesta $2, la entrada en caché cuesta $0,10, las escrituras en caché cuestan $2,50 y la salida cuesta $10. Por lo tanto, la entrada almacenada en caché supone el 5% de la tasa de entrada sin almacenar en caché, mientras que escribir nuevo contenido en la caché cuesta 1,25 veces la entrada ordinaria. Las tarifas específicas de cada herramienta pueden añadirse por separado, por lo que el cálculo de los tokens es solo una parte de la carga de trabajo que supone el uso de una herramienta.
El detalle más importante en cuanto a la tarificación es el umbral de 272K. Una vez que la entrada supera los 272 000 tokens, toda la solicitud pasa a tener el doble de las tasas de entrada y de caché, y 1,5 veces la tasa de salida. No se trata de un recargo marginal que se aplique únicamente a los tokens que superen ese umbral. Las aplicaciones que suelen situarse cerca de ese límite deberían contar los tokens antes de enviarlos y plantearse la posibilidad de dividirlos en bloques, recuperarlos o compactarlos.
El modo «Fast» duplica los precios del modo «Standard». Los modos «Batch» y «Flex» reducen las tarifas del modo «Standard» en un 50%, y el procesamiento regional añade un recargo del 10% cuando está disponible. Estos modos resuelven problemas distintos: el modo «Rápido» compensa la latencia; el modo «Por lotes» sacrifica la inmediatez a cambio de reducir el coste; el modo «Flex» sacrifica la previsibilidad de la programación a cambio de reducir el coste; y el procesamiento regional da respuesta a las necesidades de ubicación de los datos. No se deben comparar sus precios sin tener en cuenta sus limitaciones operativas.
Los precios estándar de Astra son de $10 de entrada y $50 de salida por cada millón de tokens, exactamente cinco veces las tarifas principales de Sol. El Precios y límites de tokens de la API de GPT-6 Astra Esta guía analiza esa prima con mayor detalle. Sol y la versión anterior, GPT-6 Sol, comparten los mismos precios de entrada y salida sin almacenar en caché, pero GPT-6.1 Sol reduce la entrada almacenada en caché de $0,20 a $0,10 por millón de tokens.
Ejemplos de costes reales
Los precios de los tokens resultan más fáciles de evaluar cuando se convierten en solicitudes completas. Los ejemplos que figuran a continuación utilizan el procesamiento estándar, sin comisiones por llamadas a herramientas, sin recargo regional y sin entradas almacenadas en caché, salvo que se indique lo contrario. La longitud real de la salida suele influir en el coste final más de lo que esperan los desarrolladores, ya que la salida cuesta cinco veces más que una entrada normal en GPT-6.1 Sol.
Para la revisión del código de 100 000 líneas de entrada y 5 000 de salida, la entrada cuesta $0,20 y la salida cuesta $0,05, lo que da lugar a una estimación de $0,25. Si la totalidad de las 100 000 entradas cumple los requisitos para ser almacenada en caché, su parte correspondiente a la entrada se reduce a $0,01 y el total pasa a ser $0,06. Si la aplicación debe escribir primero ese prefijo de 100 000 en la caché, la parte correspondiente a la escritura en caché es de $0,25 antes de la salida.
El ejemplo de 300 000 entradas supera el umbral. Las entradas se facturan a una tarifa efectiva de $4 por millón, por lo que 300 000 cuestan $1,20. Las salidas se facturan a una tarifa efectiva de $15 por millón, por lo que 10 000 cuestan $0,15. El total es de $1,35. Por lo tanto, una solicitud que solo supere ligeramente el umbral puede costar mucho más que otra que se sitúe justo por debajo de él, incluso antes de tener en cuenta las herramientas.
Los modos «Batch» o «Flex» reducirían a la mitad el total estándar admisible, mientras que el modo «Fast» lo duplicaría. En el primer ejemplo, eso supone aproximadamente $0,125 en los modos «Batch» o «Flex» y $0,50 en el modo «Fast». Los equipos que aún utilicen modelos GPT-5.6 más antiguos pueden comparar esas hipótesis con nuestro Precios de GPT-5.6 y créditos Codex desglose.
Cómo utilizar GPT-6.1 Sol
La forma más sencilla de desarrollar es mediante la API de respuestas. Instala el SDK OpenAI actual, introduce la clave de la API a través de tu entorno y configura modelo a gpt-6.1-sol. El Guía oficial para la generación de textos Recomienda utilizar «Respuestas» para las solicitudes directas al modelo, y la página del modelo lo requiere para la llamada a la herramienta.
1. Empieza con una solicitud sencilla a la API de Responses
Haz que la primera solicitud sea sencilla. Confirma que el ID exacto del modelo esté disponible para tu proyecto, captura los campos del modelo y de uso que se devuelvan, y almacena suficientes metadatos para poder reproducir la ejecución. No empieces con una cadena de herramientas demasiado compleja. Una solicitud sencilla permite separar los problemas de acceso al modelo de los relacionados con la definición de las herramientas, los permisos y la coordinación.
2. Añade herramientas únicamente a través de la API de Responses
Cuando el flujo de trabajo requiera la búsqueda de archivos, la búsqueda en la web, la ejecución de código, el acceso al shell, el uso del ordenador, MCP o funciones personalizadas, define el conjunto de herramientas más reducido posible. Limita el alcance de los archivos y la red, valida los argumentos de las herramientas y decide qué acciones requieren confirmación humana. El modelo puede proponer y llamar a herramientas, pero tu aplicación sigue siendo responsable de ejecutarlas y de hacer cumplir los permisos.
3. Ajustar el esfuerzo de razonamiento mediante una evaluación
Empieza con el nivel «medio», que es el predeterminado. Ejecuta un conjunto de evaluación representativo y, a continuación, compara los niveles «bajo», «alto» o «xalto» con la tasa de aceptación, los tokens de salida, la latencia y el recuento de revisiones. El nivel «máximo» puede resultar útil en las tareas más difíciles, pero utilizarlo en todas partes puede anular la ventaja en cuanto a costes que hacía que Sol resultara atractivo. Mantén la configuración más ligera que supere las pruebas de forma fiable.
4. Utiliza GlobalGPT para realizar una comparación interactiva
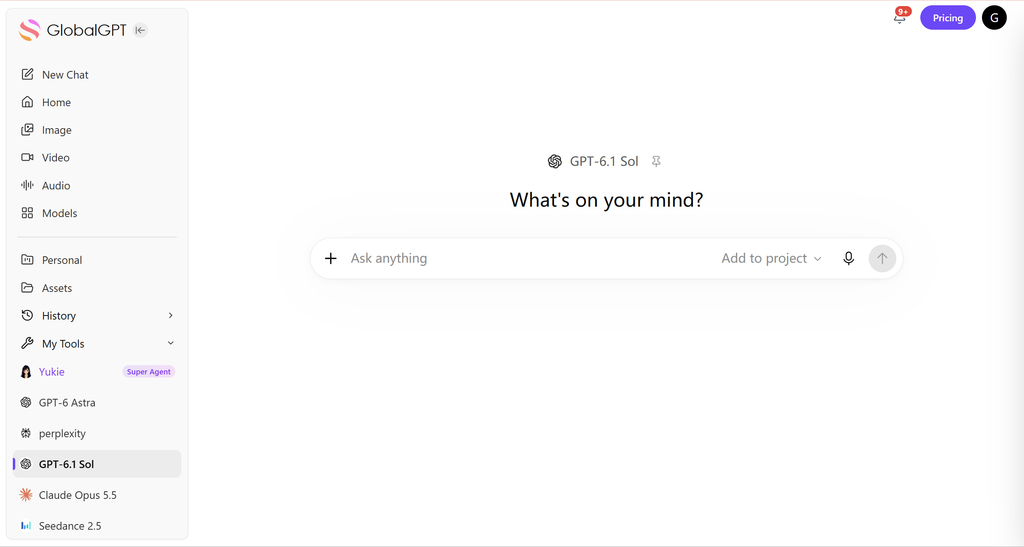
Para realizar ejercicios interactivos, abre El espacio de trabajo multimodelo de GlobalGPT y selecciona GPT-6.1 Sol cuando esté disponible en el selector de tu cuenta. Esta opción resulta útil para comparar respuestas sin necesidad de mantener pestañas ni suscripciones independientes. No sustituye a los controles de implementación de la API, la automatización de repositorios, Codex ni un IDE. Nuestra guía sobre Opciones del modelo ChatGPT para la codificación aborda esas diferencias en los flujos de trabajo.
GPT-6.1 Sol frente a GPT-6 Sol, Astra y Luna
Los cuatro modelos de esta comparación aceptan texto e imágenes, devuelven texto y cuentan con una ventana de contexto de 1 050 000 tokens, con una salida máxima de 128 000. Las diferencias significativas se encuentran en la posición, el precio, la fecha límite, la configuración del razonamiento y el nivel de calidad que se observa en una tarea real. La tabla utiliza los precios oficiales actuales por token «Standard», consultados el 1 de octubre de 2026.
| Modelo | Mejor ajuste | Entrada / 1M | En caché / 1 M | Salida / 1M | Límite |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Trabajos complejos con control de costes | $2 | $0.10 | $10 | 30 de abril de 2026 |
| GPT-6 Astra | Trabajos muy exigentes en los que prima la calidad | $10 | $1 | $50 | 30 de abril de 2026 |
| GPT-6 Sol | Integraciones antiguas existentes de Sol | $2 | $0.20 | $10 | 20 de abril de 2026 |
| GPT-6 Luna | Tareas específicas y de gran volumen | $0.10 | $0.01 | $0.50 | 18 de mayo de 2026 |
Elige Astra cuando la tarea sea lo suficientemente difícil como para que una pequeña mejora en la calidad pueda evitar costosas repeticiones del trabajo por parte de los humanos. Elige GPT-6.1 Sol cuando el trabajo siga siendo complejo pero frecuente, especialmente si resulta útil el descuento por entrada almacenada en caché. Elige Luna cuando el volumen y la latencia sean los factores determinantes y la tarea esté bien definida. Mantén la versión anterior de Sol solo cuando el riesgo de migración, las evaluaciones existentes o los trabajos de compatibilidad hagan que un cambio inmediato no resulte atractivo.
La diferencia de precio de cinco veces entre Sol y Astra es considerable, pero el precio por token no es lo mismo que el precio por resultado aceptado. Un modelo más capaz puede utilizar menos tokens de salida, recurrir a menos herramientas o necesitar menos revisiones. Por el contrario, Sol puede ganar incluso con una revisión adicional si el precio unitario de Astra compensa con creces esa diferencia. Es mejor comparar los historiales completos de las tareas en lugar de multiplicar la longitud de una sola indicación.
Los lectores que estén valorando si merece la pena dar el salto al modelo insignia pueden utilizar el Comparación entre el GPT-6 Astra y el GPT-5.6 Sol para conocer el contexto de los niveles anteriores. En el caso de la rama de menor coste de la familia actual, la Reseña de GPT-6 Luna y sus mejores usos indica los límites pertinentes de la API y la adecuación a la carga de trabajo.
Lo que dicen los críticos
OpenAI presentó GPT-6.1 Sol durante la ponencia principal del DevDay del 29 de septiembre de 2026, junto con otros lanzamientos de productos. Ese vídeo oficial establece el momento del lanzamiento y el posicionamiento del producto; no constituye una prueba independiente. La reacción externa más útil proviene de los creadores que revelan una tarea, un conjunto de comparación, un método de cálculo de costes y los fallos, en lugar de limitarse a repetir el comunicado de lanzamiento.
¿Sabe programar? Informó de que Sol funcionaba de forma mucho más económica y rápida en una comparación de tres rondas entre Blender y Godot, pero señaló que la calidad del juego se deterioraba a medida que avanzaban las rondas.
Matt Johnston registró una puntuación ponderada de 96 y un coste de $2,63 en su configuración de nueve pruebas, al tiempo que señaló claramente un fallo en la tarea del pingüino.
Duncan Rogoff Comparó Sol con Sonnet 5.5 en seis configuraciones y realizó un seguimiento del tiempo, los tokens y el coste final.
En El vídeo de tres rondas de ’Can It Code?», las tareas pasaron de un kit de mazmorras de Blender con modelos de baja poligonalidad a personajes modelados y animados, y posteriormente a un juego jugable en Godot. El creador calculó que Sol había tardado $29,17 y 7 horas y 5 minutos en todas las rondas, una cifra muy por debajo de las ejecuciones de comparación, pero consideró que el juego final era menos agradable y afirmó que Sol empeoraba en cada ronda. La conclusión se centra en el coste y la rapidez, con una advertencia sobre la calidad, y no en una clasificación general.
Resumen de las nueve pruebas de Matt Johnston Indica una puntuación ponderada de 96, empatado con Sonnet 5.5 en su tabla de Stonelabs, y un coste del paquete de $2.63 frente a aproximadamente $14 para Astra y $12 para Opus 5.5. También señala un error en la tarea del pingüino. Esas cifras corresponden a su diseño de referencia y a su contabilidad de costes; deberían reproducirse antes de utilizarlas para la adquisición.
Comparativa de seis modelos de Duncan Rogoff abarca páginas de destino, juegos en 3D para navegador, escenas de Blender, vídeos explicativos interactivos y presentaciones para inversores. Según la descripción pública, la prueba mide el tiempo de compilación, el uso de tokens y el coste final. Hasta que se revise el resultado completo, esta guía utiliza el vídeo como prueba de un método de comparación práctico, no como prueba de que uno de los modelos haya ganado.
Estas primeras reseñas coinciden en una pregunta útil: ¿se mantiene el bajo precio de Sol al aplicarlo a un proyecto completo? Sus respuestas dependen de la tarea en cuestión. Un creador observó una notable rentabilidad, aunque con una calidad final del juego más débil; otro señaló una puntuación alta y un bajo coste del paquete; un tercero diseñó un juego de competición general. Esa diversidad es más reveladora que una frase de consenso sintético.
¿Quién debería utilizar GPT-6.1 Sol?
GPT-6.1 Sol es ideal para equipos que ya cuentan con un trabajo significativo y un ciclo de evaluación. Resulta especialmente atractivo cuando se reutiliza el mismo contexto amplio mediante el almacenamiento en caché de las indicaciones, cuando una implementación de Astra resultaría demasiado costosa de escalar o cuando Luna no ofrece la profundidad suficiente para la tarea. El modelo resulta menos atractivo cuando una tarea ligera de extracción o clasificación ya funciona de forma fiable en un nivel más económico.
- Programación a escala de repositorio
- Resultados profesionales complejos
- Revisión de contexto extenso con almacenamiento en caché
- Flujos de trabajo con herramientas y evaluaciones
- Decisiones críticas para la seguridad
- Tareas en las que los errores salen caros
- Trabajar cerca del umbral de los 272 000
- Flujos sensibles a la latencia
- Etiquetado sencillo
- Transformaciones determinísticas cortas
- Extracción de gran volumen y bajo riesgo
- Tareas ya resueltas por Luna
Los equipos de software deberían plantearse utilizar Sol cuando necesiten un modelo para realizar razonamientos a través de varios archivos, generar pruebas, revisar problemas de seguridad o manejar herramientas bajo supervisión. Los analistas pueden utilizarlo para la síntesis de múltiples documentos y la elaboración de entregables estructurados. Los equipos de operaciones pueden utilizarlo para flujos de trabajo que combinan datos, reglas y contexto empresarial. En todos los casos, el flujo de trabajo requiere criterios de aceptación explícitos y un paso de verificación, ya sea manual o automatizado.
Es posible que los usuarios individuales y los equipos pequeños prefieran un espacio de trabajo interactivo multimodelo antes de desarrollar una integración mediante API. Esto permite comparar de forma concreta Sol y Astra sin tener que comprometerse con una arquitectura de aplicación concreta. Si aún estás sopesando diferentes proveedores y modalidades, nuestra guía sobre Elegir un modelo de IA en función de la tarea, las herramientas y el coste ofrece una lista de candidatos preseleccionados más amplia.
Límites y modos de fallo
Una ventana de contexto de un millón de tokens es una capacidad, no una memoria perfecta. Las instrucciones importantes pueden verse diluidas por documentos ruidosos, reglas duplicadas o pruebas contradictorias. Estructura las entradas largas, identifica las fuentes fidedignas y pide al modelo que cite el archivo o el pasaje en el que se basan las conclusiones importantes. La recuperación y la compactación pueden ser mejores que enviarlo todo en cada turno.
El incremento de precio por contexto extenso supone un segundo riesgo. Una solicitud con 273 000 tokens de entrada se cobra a la tarifa más alta correspondiente a la solicitud completa, y no solo a los últimos mil tokens. Esto puede generar facturas inesperadas en aplicaciones que generan el contexto de forma dinámica. Añade un recuento de tokens y comprobaciones de presupuesto antes de la solicitud, y registra qué documentos han superado el límite de la llamada.
El uso de herramientas amplía las capacidades y la superficie de ataque. Trata las páginas web, los archivos recuperados y los resultados de las herramientas como datos no fiables. Valida los argumentos de las funciones, aísla la ejecución de código, restringe las rutas de los archivos y el acceso a la red, y exige confirmación para las acciones de alto impacto. El hecho de que el modelo admita el uso de un shell alojado o de un ordenador no es motivo para conceder permisos amplios.
Por último, las primeras pruebas de los creadores pueden resultar informativas sin ser definitivas. Las diferentes indicaciones del sistema, herramientas, andamios, límites de tiempo y rúbricas de puntuación pueden dar la vuelta a un ganador aparente. Utiliza las pruebas públicas para diseñar tu propia evaluación, no para saltártela. Un modelo que destaque en la creación de un juego visual puede fracasar en tu plan de migración, y lo contrario es igualmente posible.
Preguntas frecuentes
Estas respuestas resumen la información oficial sobre la API y los aspectos prácticos para la toma de decisiones que se han tratado anteriormente.
¿Qué es GPT-6.1 Sol?
GPT-6.1 Sol es un modelo de razonamiento OpenAI diseñado para la programación compleja, el uso de ordenadores y el trabajo profesional. La configuración OpenAI lo sitúa entre el nivel Luna, de bajo coste, y el nivel Astra, el más avanzado, con una capacidad similar a la de Astra a un precio por API más bajo.
¿Cuánto cuesta GPT-6.1 Sol?
Los precios estándar de la API son $2 por cada millón de tokens de entrada, $0,10 por cada millón de tokens de entrada almacenados en caché, $2,50 por cada millón de tokens de escritura en caché y $10 por cada millón de tokens de salida. Las consultas largas, el modo rápido, el procesamiento regional, el procesamiento por lotes y la opción «Flex» pueden modificar la tarifa efectiva.
¿Qué es la ventana de contexto de GPT-6.1 Sol?
OpenAI indica una ventana de contexto de 1 050 000 tokens, una entrada máxima de 922 000 tokens y hasta 128 000 tokens de salida. Una ventana grande permite al modelo examinar una cantidad considerable de material, pero no garantiza una recuperación perfecta ni hace que todas las solicitudes de gran tamaño resulten rentables.
¿Es GPT-6.1 Sol adecuado para programar?
Está diseñado para la programación compleja y admite salidas estructuradas, llamadas a funciones, intérprete de código, shell alojado, aplicación de parches, habilidades, MCP y otras herramientas a través de la API de Responses. Los equipos de producción deben seguir ejecutando pruebas específicas del repositorio antes de cambiar un flujo de trabajo crítico.
¿Debería usar el GPT-6.1 Sol o el GPT-6 Astra?
Elige Sol cuando el coste sea un factor importante y tu propia evaluación demuestre que cumple con los requisitos de calidad. Elige Astra para los trabajos más exigentes, cuando una diferencia mínima en la calidad justifique una tarifa estándar cinco veces superior. Prueba ambas opciones en las mismas tareas representativas antes de decidirte.
¿Qué ocurre cuando una solicitud supera los 272 000 tokens de entrada?
Según OpenAI, la solicitud completa se factura al doble de las tasas normales de entrada y caché, y a 1,5 veces la tasa normal de salida, una vez que la entrada supera los 272 000 tokens. Este cambio brusco puede resultar más relevante que el tamaño de la ventana de contexto indicado en las aplicaciones con documentos largos.
¿Es compatible GPT-6.1 Sol con la API de «Chat Completions»?
Sí, la función «Chat Completions» es compatible con las solicitudes que no implican la llamada a herramientas. OpenAI remite a los desarrolladores a la API de respuestas para la llamada a herramientas, por lo que las nuevas aplicaciones de tipo «agentic» o que utilicen herramientas deberían, normalmente, empezar por la API de respuestas en lugar de depender de la interfaz anterior.
¿GPT-6.1 Sol admite imágenes?
Sí. En la página oficial del modelo se indican como entradas el texto y las imágenes, y como salida el texto. El audio y el vídeo no son modalidades compatibles con el modelo, aunque una aplicación puede utilizar otros servicios o herramientas relacionadas con el modelo cuando se requieran esos tipos de medios.
¿Cómo puedo utilizar GPT-6.1 Sol en GlobalGPT?
Abre GlobalGPT, inicia un nuevo chat y selecciona «GPT-6.1 Sol» cuando aparezca en el selector de modelos de tu cuenta. GlobalGPT es un práctico espacio de trabajo multimodelo; las claves de API, los controles de implementación y la automatización del repositorio siguen siendo flujos de trabajo independientes para los desarrolladores.
Veredicto final
GPT-6.1 Sol es la opción más interesante de GPT-6 para los compradores que necesitan una gran capacidad de razonamiento y programación, pero que no pueden permitirse utilizar Astra en cada ejecución. Iguala los límites máximos de contexto y salida de Astra, utiliza la misma fecha de corte de conocimientos (30 de abril de 2026) y cuesta una quinta parte por cada token de entrada y salida sin almacenar en caché, según las tarifas estándar. El descuento por entradas almacenadas en caché también es mayor que el del anterior GPT-6 Sol.
Este modelo no es necesariamente la mejor opción. Luna sigue siendo considerablemente más económica para tareas específicas, y Astra aún puede reducir el número de revisiones en las tareas más complejas. La comparación adecuada es el coste total por resultado aceptado, medido con el mismo prompt, las mismas herramientas, los mismos datos y las mismas reglas de puntuación. A partir de 272 000 tokens de entrada, hay que tener en cuenta el multiplicador de precio antes de tomar una decisión.
Abre GlobalGPT, selecciona GPT-6.1 Sol cuando esté disponible y compáralo con Astra o Luna utilizando una tarea real y una lista de comprobación de aceptación.
Abierto GlobalGPTPara la implementación de la API, empieza por la página oficial del modelo y una pequeña solicitud a la API de respuestas. Para una comparación interactiva, utiliza la ruta multimodelo anterior. En cualquier caso, conserva los resultados, el uso, la configuración y los errores. La promesa de GPT-6.1 Sol no se limita a ofrecer tokens más baratos, sino que ofrece una mejor oportunidad de llevar a cabo razonamientos eficaces con la frecuencia suficiente como para que se conviertan en parte del flujo de trabajo.