
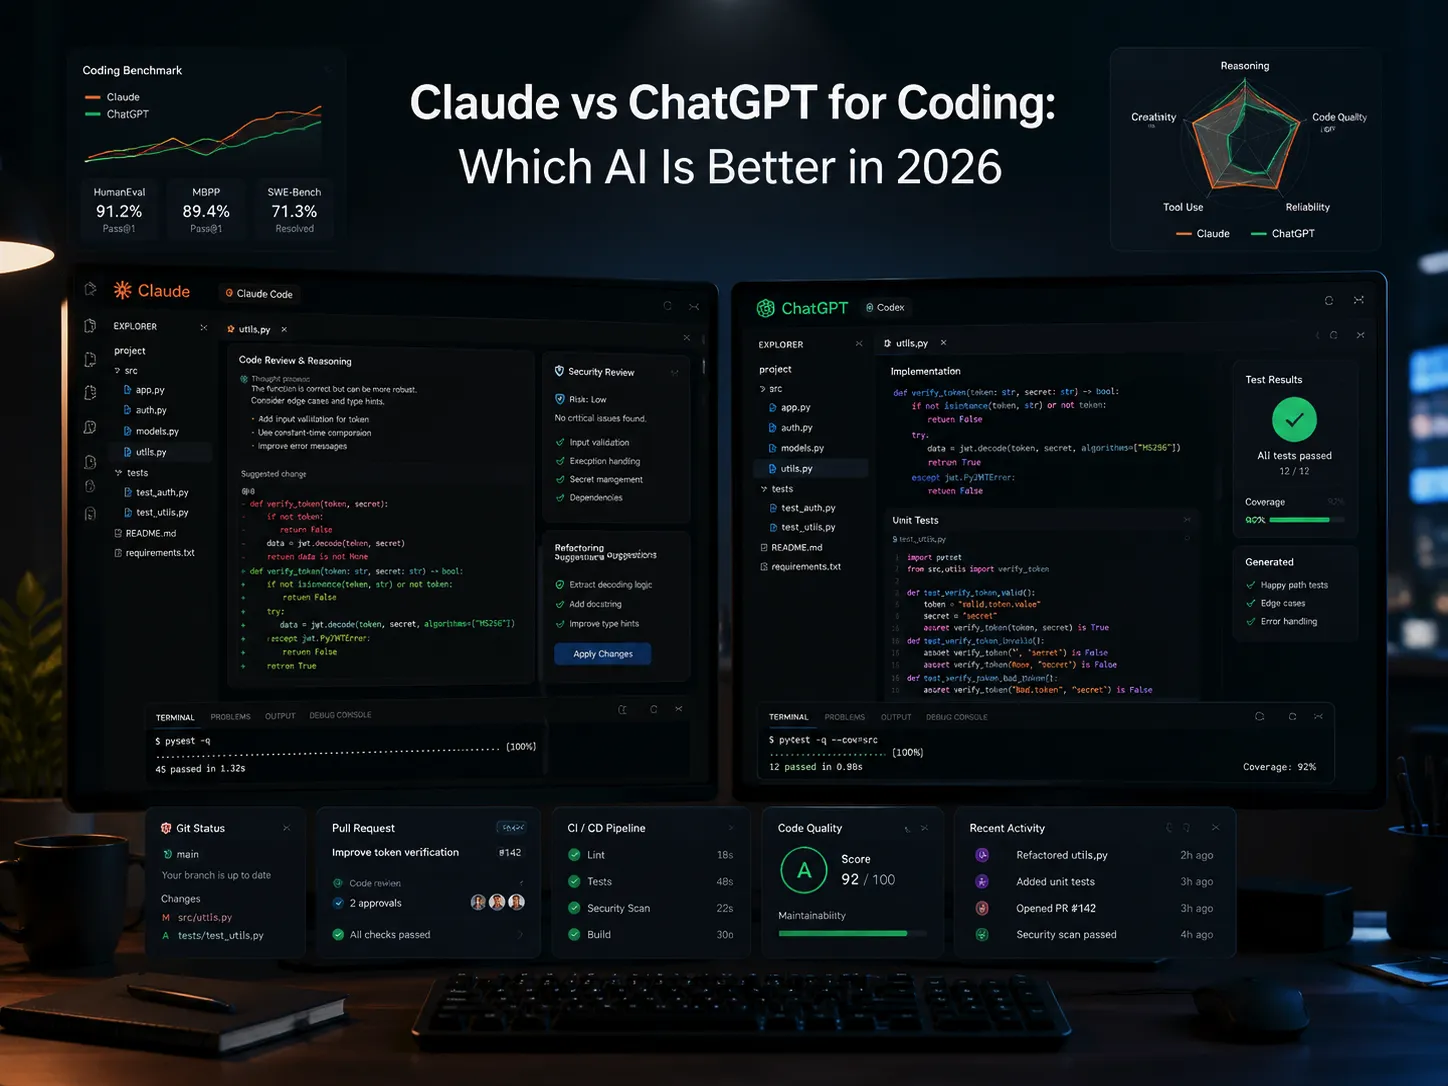
ในการทดสอบของเราเมื่อวันที่ 7 กรกฎาคม 2026 Claude Sonnet 5 เป็นตัวเลือกที่ดีกว่าในขั้นตอนแรกสำหรับการตรวจสอบโค้ด การวิเคราะห์สาเหตุหลัก การวางแผนสถาปัตยกรรม และการวิเคราะห์บริบทระยะยาว GPT-5.5 เป็นตัวเลือกที่ดีกว่าในขั้นตอนแรก เมื่อคุณต้องการร่างการนำไปใช้ที่สมบูรณ์ โครงสร้างการทดสอบที่สามารถรันได้ หรือตัวอย่างที่พร้อมคัดลอก สำหรับงานระดับรีโพสิตอรี ให้เปรียบเทียบ Claude Code กับ Codex แทนที่จะตัดสินบริษัทใดบริษัทหนึ่งจากหน้าต่างแชทเพียงอย่างเดียว.
การแบ่งประเภทที่มีประโยชน์นั้นไม่ใช่เพียงแค่ “Claude ชนะ” หรือ “ChatGPT ชนะ” เท่านั้น นับถึงวันที่ 27 กันยายน 2026 ชุดผลิตภัณฑ์ของ Anthropic ประกอบด้วย Claude Fable 5.1, Opus 5.5, Sonnet 5 และ Haiku 4.5; ตระกูล GPT-6 ของ OpenAI ประกอบด้วย Astra, Sol และ Luna การเข้าถึงผลิตภัณฑ์มีความสำคัญ: Sol และ Luna เปิดตัวใน ChatGPT Work, Codex และ API โดยประกาศดังกล่าวได้ระบุชัดเจนว่าไม่รวมถึง Chat ทั่วไป ส่วนการทดลองใช้งานด้านล่างนี้ยังคงเป็นการเปรียบเทียบที่ล้าสมัยระหว่าง Claude Sonnet 5 และ GPT-5.5 ซึ่งได้รับการทดสอบด้วยคำสั่งเดียวกันเมื่อวันที่ 7 กรกฎาคม 2026 สำหรับการเปรียบเทียบปัจจุบัน โปรดดู Claude Opus 5.5 เทียบกับ GPT-6 Sol.
หากคุณต้องการเปรียบเทียบโมเดลต่าง ๆ โดยไม่ต้องจัดการกับบริการสมัครสมาชิกหลายบัญชีพร้อมกัน GlobalGPT คือพื้นที่ทำงานแบบหลายโมเดลที่ใช้งานได้จริง พร้อมด้วย GPT-6 Astra และ Claude Opus 5.5 มีให้ใช้ในเครื่องมือเลือกโมเดลของมัน เครื่องมือนี้มีประโยชน์สำหรับการเปรียบเทียบคำตอบการเขียนโค้ด การวางแผน การเขียน และการวิจัย แต่ไม่สามารถแทนที่ Claude Code, Codex, API อย่างเป็นทางการ, IDE หรือกระบวนการพัฒนาที่สนับสนุนการจัดการรีโพสิตอรีได้.

สารบัญ
- Claude vs ChatGPT สำหรับการเขียนโค้ด: คำตอบแบบรวดเร็ว
- มีอะไรที่เปลี่ยนแปลงในปี 2026
- รายชื่อโมเดลการเข้ารหัสที่มีอยู่ในปัจจุบัน
- ภาพรวมของเกณฑ์มาตรฐาน: SWE-Bench, Terminal-Bench และความหมายของทั้งสอง
- วิธีที่เราทดสอบ Claude และ ChatGPT ในด้านการเขียนโค้ด
- การทดสอบ 1: การแก้ไขข้อผิดพลาดและการวิเคราะห์สาเหตุหลัก
- การทดสอบที่ 2: การปรับโครงสร้างโค้ดและการดูแลรักษา
- การทดสอบที่ 3: การวิเคราะห์และวางแผนสำหรับหลายไฟล์
- การทดสอบที่ 4: การทดสอบระดับหน่วยและการตรวจสอบ
- การทดสอบที่ 5: การตรวจสอบด้านความปลอดภัยและความน่าเชื่อถือ
- Claude Code และ Codex: เมื่อการสนทนาไม่เพียงพอ
- ราคา: Claude, ChatGPT, Codex และ GlobalGPT
- คุณควรเลือกชุดเครื่องมือพัฒนาโปรแกรมแบบใด?
- ทำไมนักพัฒนาหลายคนยังใช้ทั้งสองอย่าง
- คำถามที่พบบ่อย
Claude vs ChatGPT ในการเขียนโค้ด: คำตอบสั้นๆ
ในการทดสอบการสนทนาด้วยคำสั่งเดียวกันเมื่อวันที่ 7 กรกฎาคม Claude Sonnet 5 แสดงประสิทธิภาพที่ดีกว่าในรอบแรกเมื่อปัญหาไม่ชัดเจน: มันจัดลำดับความสำคัญของสาเหตุที่เป็นไปได้มากที่สุด, กรองข้อมูลที่ไม่จำเป็นออก และอธิบายความเสี่ยงได้อย่างชัดเจน GPT-5.5 แสดงประสิทธิภาพที่ดีกว่าเมื่อขั้นตอนต่อไปคือการจัดทำร่างการนำไปใช้ที่สมบูรณ์ยิ่งขึ้น ซึ่งรวมถึงการนำเข้าข้อมูล (imports), โครงสร้างการทดสอบ (test scaffolding) และรายละเอียดโค้ดเพิ่มเติม ข้อสังเกตเหล่านี้อธิบายผลการทดสอบดังกล่าวเท่านั้น ไม่ใช่ทุกเวอร์ชันของโมเดลที่จะปล่อยออกมาในอนาคต.
สำหรับการพัฒนาประจำวัน กระบวนการทำงานที่ดีที่สุดมักจะเป็นดังนี้:
- ใช้ Claude ก่อน สำหรับการตรวจสอบโค้ด การจัดประเภทข้อผิดพลาด การตัดสินใจเกี่ยวกับสถาปัตยกรรม และคำถามว่า “ควรตรวจสอบอะไรก่อน?”.
- ใช้ ChatGPT ก่อน เพื่อสร้างโค้ดต้นแบบ เขียนโครงสร้างการทดสอบ สร้างตัวอย่าง และแปลงแผนเป็นโค้ด.
- ใช้ทั้งสองอย่าง สำหรับการย้ายระบบ การเปลี่ยนแปลงที่เกี่ยวข้องกับความปลอดภัย การชำระเงิน การยืนยันตัวตน การอัปโหลดไฟล์ และทุกสิ่งที่อาจทำให้ข้อมูลในระบบผลิตเสียหาย.
| ความต้องการด้านการเขียนโค้ด | ตัวเลือกแรกที่ดีกว่า | ทำไม |
|---|---|---|
| การแก้ไขข้อผิดพลาดที่ซับซ้อน | โคลดเป็นคนแรก | ในการทดสอบของเรา Claude ได้จัดลำดับความสำคัญของสาเหตุที่เป็นไปได้ และอธิบายเส้นทางการเกิดข้อผิดพลาดอย่างชัดเจน. |
| การเขียนร่างการดำเนินการที่ครบถ้วน | ChatGPT ก่อน | ในการทดสอบของเรา GPT-5.5 ได้ให้โค้ดที่ครบถ้วนกว่าและโครงสร้างพื้นฐานที่พร้อมใช้งานมากขึ้น. |
| การประเมินความเสี่ยงด้านความปลอดภัยหรือความน่าเชื่อถือ | Claude ก่อน แล้วถึง ChatGPT | Claude ได้จัดอันดับระดับความรุนแรงอย่างชัดเจน; ChatGPT ได้เพิ่มรูปแบบการนำไปใช้ที่ชัดเจน. |
| การแก้ไขไฟล์ในรีโพสิตอรี | รหัส Claude หรือ Codex | บริบทของ Repo การดำเนินการคำสั่ง การทดสอบ และการเปรียบเทียบมีความสำคัญมากกว่าคำตอบที่เพียงแต่การสนทนาเท่านั้น. |
หากคำถามหลักของคุณคือกลุ่มรุ่นใดที่เหมาะที่สุดสำหรับการเขียนโค้ดโดยรวมแล้ว คำตอบที่กว้างขึ้นคือ โมเดล AI ที่ดีที่สุดสำหรับการเขียนโค้ด บทความเปรียบเทียบนี้เป็นบทความที่ควรอ่านต่อ หากการตัดสินใจหลักของคุณอยู่ในระบบนิเวศ OpenAI คู่มือการเขียนโค้ดสำหรับโมเดล ChatGPT ที่ดีที่สุดจะให้ข้อมูลรายละเอียดเพิ่มเติมเกี่ยวกับการเลือกโมเดล GPT.
อะไรที่เปลี่ยนไปในปี 2026
การเปรียบเทียบที่มีประโยชน์สำหรับปี 2026 ต้องพิจารณาถึงการเปลี่ยนแปลงสามประการ.
ก่อนอื่น Claude Sonnet 5 ได้เปลี่ยนมุมมองของ Claude ในการตัดสินใจ. Anthropic อธิบายว่า Sonnet 5 มีให้บริการในทุกแพ็กเกจและในรหัส Claude พร้อมทั้งการเข้าถึงแพลตฟอร์ม Claude สำหรับนักพัฒนา สิ่งนี้มีความสำคัญเพราะ Claude ไม่เพียงแต่เป็นผู้ช่วยสนทนาสำหรับการอธิบายการเขียนโค้ดอีกต่อไป แต่ยังเป็นส่วนหนึ่งของกระบวนการทำงานของเอเจนต์การเขียนโค้ดใน Anthropic.
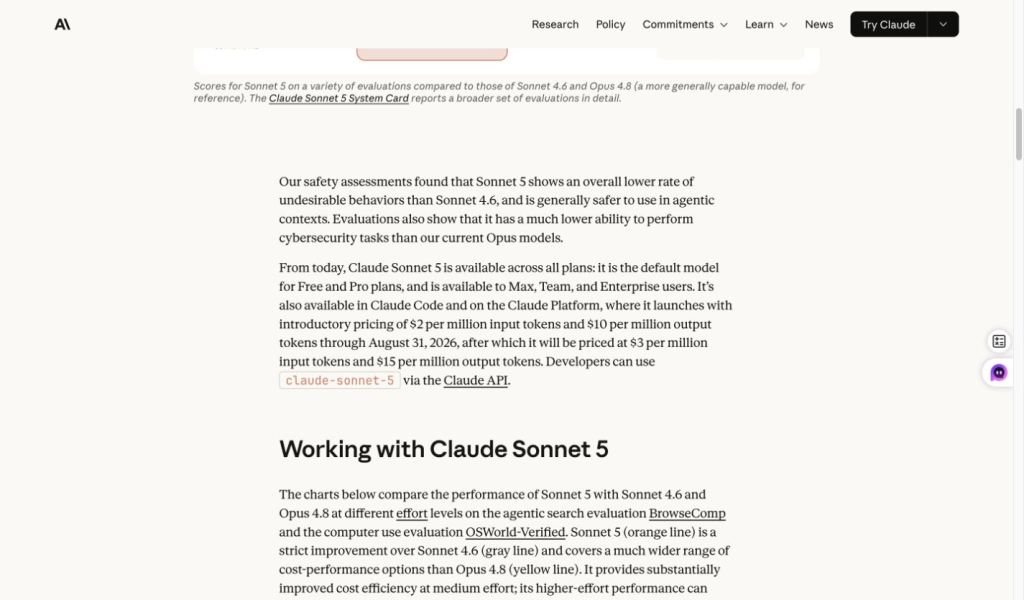
ประการที่สอง GPT-6 เป็นตระกูลโมเดลปัจจุบันของ OpenAI สำหรับงานเขียนโค้ด. Astra มุ่งเน้นด้านวิศวกรรมซอฟต์แวร์ที่ซับซ้อน ส่วน Sol และ Luna เพิ่มตัวเลือกที่มีราคาถูกกว่า. ประกาศการเปิดตัวของ OpenAI เมื่อวันที่ 22 กันยายน ระบุ Sol และ Luna ใน ChatGPT Work และ Codex สำหรับ Plus, Pro, Business, Enterprise และ Edu โดย Luna ยังสามารถใช้งานได้สำหรับผู้ใช้ Free และ Go ในแอปเดสก์ท็อปด้วย นอกจากนี้ยังระบุอย่างชัดเจนว่ารุ่นเหล่านี้ยังไม่มีให้บริการใน Chat การเข้าถึง API จะถูกคิดค่าบริการแยกต่างหาก.
ประการที่สาม ผู้ช่วยสนทนาและเอเย่นต์การเขียนโค้ดช่วยแก้ไขส่วนต่าง ๆ ของงาน. การสนทนาแบบธรรมดาเป็นประโยชน์สำหรับการเขียนโค้ดสั้นๆ การตรวจสอบข้อผิดพลาด การอธิบาย และการวางแผน. รหัส Claude และ Codex คือกระบวนการทำงานที่รองรับ repo ซึ่งออกแบบมาเพื่อตรวจสอบไฟล์ ดำเนินการคำสั่ง ทดสอบการเปลี่ยนแปลง และทำงานร่วมกับงานที่มีขนาดใหญ่กว่า การเปรียบเทียบที่ยุติธรรมจะแยกคุณภาพของผลลัพธ์การสนทนาออกจากความสามารถของผลิตภัณฑ์โค้ดดิ้งเอเจนต์.
รายชื่อรุ่นของโมเดลการเขียนโค้ดปัจจุบัน
นับตั้งแต่วันที่ 27 กันยายน 2569 การเปรียบเทียบการจัดทีมเป็นการตัดสินใจเกี่ยวกับรายชื่อผู้เล่นโดยรวม ไม่ใช่การเปรียบเทียบแบบตัวต่อตัวระหว่าง Claude กับ ChatGPT:
| ด้านข้าง | แบบจำลองปัจจุบันที่ควรพิจารณา | การใช้โค้ดที่ดีที่สุด |
|---|---|---|
| โคลด | Claude Fable 5.1, Claude Opus 5.5, Claude Sonnet 5 และ Claude Haiku 4.5 | การทบทวนในบริบทระยะยาว การวางแผน การแก้ไขข้อผิดพลาด การเขียนโค้ดแบบเอเจนต์ และกระบวนการทำงานของ Claude Code. |
| แชทจีพีที / โอเพนเอไอ | GPT-6 Astra, GPT-6 Sol และ GPT-6 Luna; ความพร้อมใช้งานแตกต่างกันระหว่าง ChatGPT Work, Chat, Codex และ API | การนำไปใช้จริง, งานด้าน frontend, การทดสอบ, กระบวนการทำงานที่ใช้เครื่องมือ และงานที่เกี่ยวข้องกับ Codex. |
| โกลบอลจีพีที | GPT-6 Astra และ Claude Opus 5.5, ได้รับการยืนยันใน GlobalGPT; นี่เป็นการสมัครสมาชิกแพลตฟอร์มที่แยกต่างหาก | การเปรียบเทียบคำสั่งแบบเคียงข้างกัน คำถามเกี่ยวกับโค้ดในชีวิตประจำวัน การวิจัย และการประเมินวิธีการ. |
หากคุณกำลังติดตามการเข้าถึง Claude และรายละเอียดแผน โปรดดูในส่วนที่แยกต่างหาก แผนงานของ Claude AI สำหรับปี 2026 คู่มือและคู่มือราคา AI Claude ที่ละเอียดยิ่งขึ้น หากคุณกำลังเปรียบเทียบแพ็กเกจ OpenAI การวิเคราะห์รายละเอียดแพ็กเกจสมัครสมาชิก ChatGPT ปี 2026 เป็นเอกสารประกอบที่เข้าใจง่ายกว่า.
ภาพรวมของเกณฑ์มาตรฐาน: SWE-Bench, Terminal-Bench และความหมายของทั้งสอง
เกณฑ์มาตรฐานมีประโยชน์เพราะมันแสดงให้เห็นว่าโมเดลทำงานอย่างไรในภารกิจเขียนโค้ดที่ได้รับการควบคุม จุดสำคัญคือต้องอ่านแต่ละเกณฑ์มาตรฐานเพื่อเข้าใจว่ามันวัดอะไรจริงๆ เกณฑ์มาตรฐานของปัญหาในรีโพซิทอรี เกณฑ์มาตรฐานของเทอร์มินัล-เอเจนต์ และตารางการเปิดตัวโมเดลอย่างเป็นทางการ ไม่ใช่สัญญาณเดียวกัน ดังนั้นจึงควรใช้ร่วมกับผลการทดสอบจริงที่กล่าวถึงด้านล่าง.
หลักฐานการเข้ารหัส GPT-5.5 จากวันที่ทดสอบ
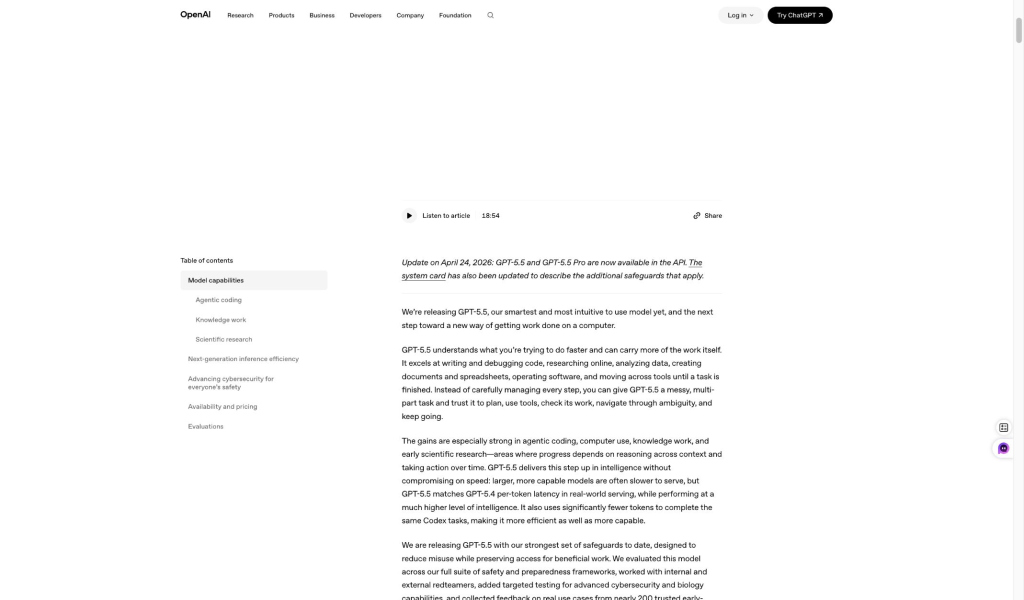
ข้อมูลเกี่ยวกับรุ่น GPT-5.5 ด้านล่างนี้ยังคงถูกเก็บไว้ เนื่องจากตรงกับรุ่นที่ใช้ในการเปรียบเทียบแบบปฏิบัติจริงเมื่อวันที่ 7 กรกฎาคม วัสดุนี้สนับสนุนการสังเกตการณ์ที่เน้นการนำไปใช้จริงของส่วนทดสอบ แต่ไม่ควรตีความว่าเป็นไลน์อัพของโมเดล OpenAI ในปัจจุบัน; GPT-6 เป็นตระกูลที่ใช้งานอยู่ปัจจุบัน โดยการเข้าถึงแตกต่างกันระหว่าง ChatGPT Work, Chat ทั่วไป, Codex และ API.
SWE-Bench: การแก้ไขปัญหาใน repositori
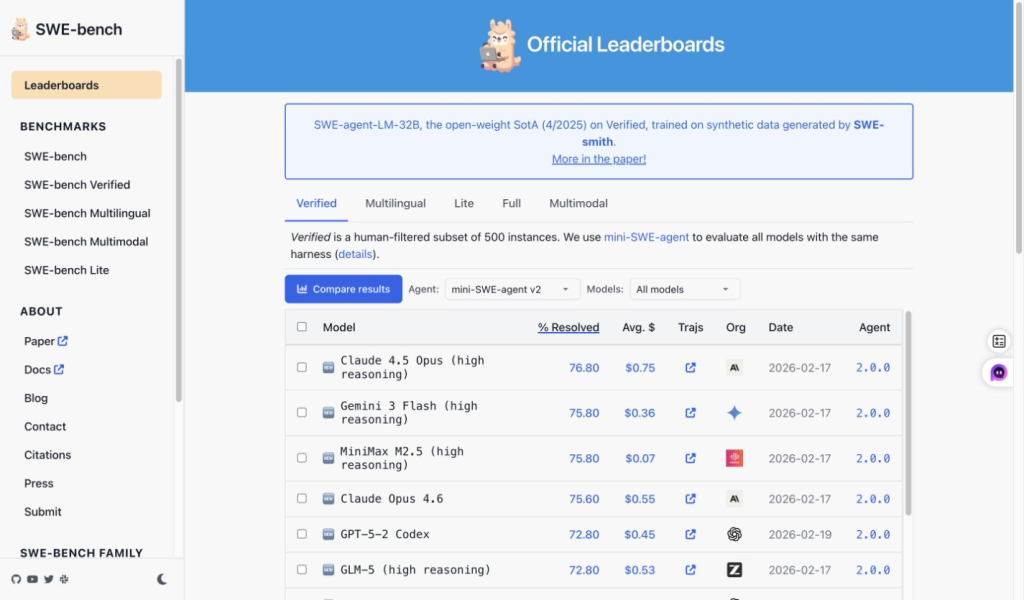
SWE-Bench มีประโยชน์เพราะมันใกล้เคียงกับการบำรุงรักษาซอฟต์แวร์จริงมากกว่าการให้คำสั่งด้วยโค้ดสั้นๆ มันจะตรวจสอบปัญหาในรีโพสิตอรี และพิจารณาว่าโมเดลสามารถสร้างการเปลี่ยนแปลงที่แก้ไขงานได้หรือไม่ สำหรับ Claude เทียบกับ ChatGPT สิ่งนี้ให้ข้อมูลบางอย่างเกี่ยวกับความแข็งแกร่งด้านวิศวกรรมซอฟต์แวร์ แต่ยังไม่สามารถบอกเล่าเรื่องราวทั้งหมดเกี่ยวกับคุณภาพการอธิบาย การประเมินผลในการตรวจสอบ หรือระดับความมีประโยชน์ของคำตอบในกระบวนการสนทนา.
SWE-Bench Pro: งานเขียนโค้ดที่ยากขึ้นและอัตราการแก้ไขปัญหา
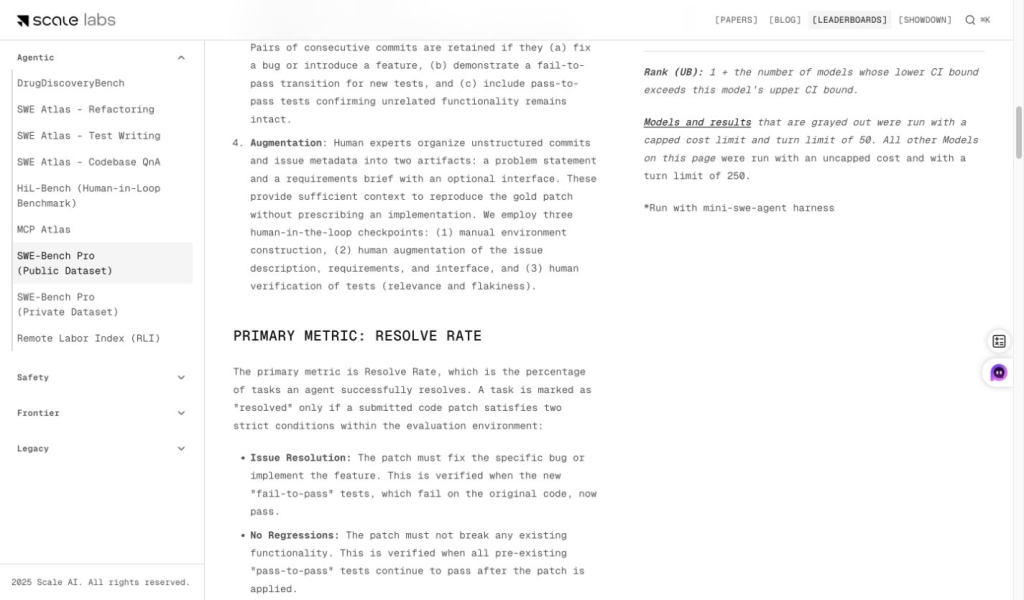
bảngจัดอันดับสาธารณะ SWE-Bench Pro ของ Scale เป็นสัญญาณที่ท้าทายกว่า เนื่องจากเน้นไปที่งานในรีโพสิตอรีที่มีความซับซ้อนมากขึ้น และใช้อัตราการแก้ไข (resolve rate) เป็นตัวชี้วัดหลัก สิ่งนี้มีประโยชน์มากที่สุดเมื่อคุณให้ความสำคัญกับความสามารถที่แท้จริงของเอเจนต์การเขียนโค้ด: ไม่เพียงแต่ว่าโมเดลสามารถอธิบายข้อผิดพลาดได้หรือไม่ แต่ยังรวมถึงว่าโมเดลสามารถนำรีโพสิตอรีไปสู่การแก้ไขที่ทำงานได้ภายใต้เงื่อนไขการทดสอบมาตรฐานได้หรือไม่.
Terminal-Bench: งานในกระบวนการทำงานผ่านบรรทัดคำสั่งและเอเจนต์
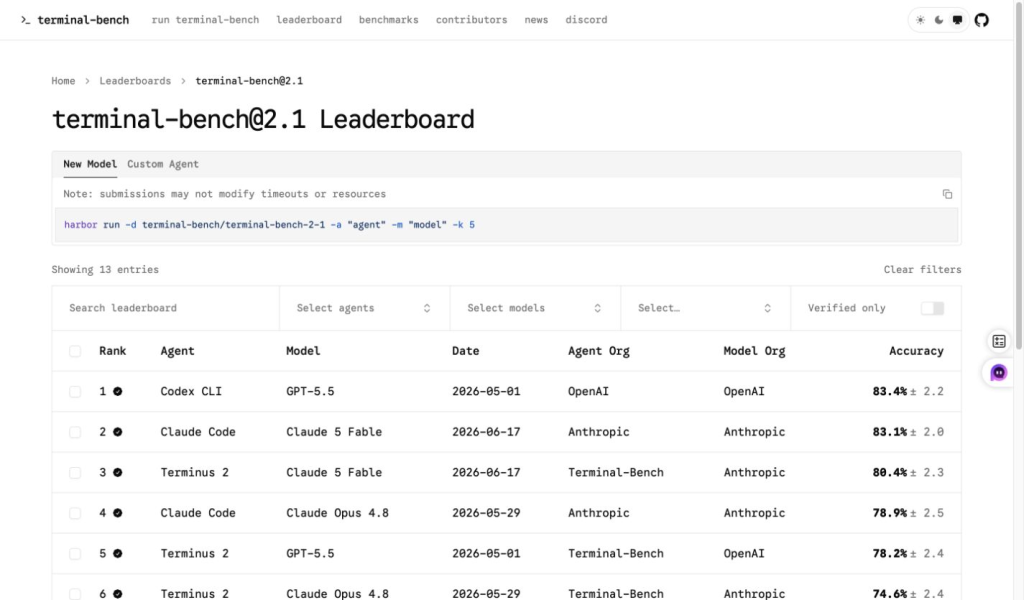
เทอร์มินอล-เบนช์ 2.1 แตกต่างจาก SWE-Bench เพราะมันเน้นไปที่การเสร็จสิ้นงานในเทอร์มินัลและบรรทัดคำสั่งผ่านระบบเอเจนต์/โมเดล ซึ่งทำให้มันมีความเกี่ยวข้องกับกระบวนการทำงานแบบ Claude Code และ ChatGPT Codex มากกว่าการให้คำสั่งแชทแบบธรรมดาที่ระบุว่า “เขียนฟังก์ชันนี้” หากคุณกำลังเลือกผู้ช่วยเขียนโค้ดสำหรับงานระดับรีโพสิตอรีหรือบนบรรทัดคำสั่ง มาตรฐานการวัดประสิทธิภาพนี้ควรเป็นส่วนหนึ่งในการตัดสินใจ.
| หลักฐาน | เหมาะที่สุดสำหรับ | ข้อสรุปที่สามารถนำไปใช้ได้จริง |
|---|---|---|
| เอกสารการเขียนโค้ด OpenAI GPT-5.5 | GPT-5.5 การเขียนโค้ดและการกำหนดตำแหน่งในวิศวกรรมซอฟต์แวร์แบบเอเจนต์. | มีความสนับสนุนอย่างเต็มที่ต่อ ChatGPT ในฐานะผู้ช่วยเขียนโค้ดที่เน้นการนำไปใช้จริง. |
| SWE-Bench | การแก้ไขปัญหาใน Repository และงานบำรุงรักษาซอฟต์แวร์. | เป็นสัญญาณที่ดีที่บ่งชี้ถึงความสามารถในการเขียนโค้ด โดยเฉพาะเมื่อบริบทของรีโพสิตอรีมีความสำคัญ. |
| SWE-Bench Pro | การเปรียบเทียบงานในรีโพสิตอรีที่ยากขึ้นและอัตราการแก้ไขปัญหา. | มีประโยชน์ในการประเมินความสามารถในการเข้ารหัสเชิงตัวแทนอย่างจริงจัง. |
| เทอร์มินอล-เบนช์ 2.1 | งานในเทอร์มินัล การดำเนินการคำสั่ง และการตั้งค่าเอเจนต์/โมเดล. | มีความเกี่ยวข้องกับกระบวนการทำงานของ Claude Code และ Codex มากกว่าคำสั่งในแชทแบบธรรมดา. |
เกณฑ์การเปรียบเทียบทำให้ทั้งสองตระกูลโมเดลเป็นตัวเลือกการเขียนโค้ดที่น่าเชื่อถือ แต่ยังไม่สามารถตัดสินการเลือกใช้ในกระบวนการทำงานประจำวันได้ ส่วนต่อไปนี้จะใช้คำสั่งเดียวกันสำหรับการดีบัก การรีแฟคเตอร์ การวางแผน การทดสอบหน่วย และการตรวจสอบความปลอดภัย เพื่อให้คุณเห็นได้ว่าคำตอบแตกต่างกันอย่างไรในทางปฏิบัติ.
วิธีที่เราทดสอบ Claude และ ChatGPT ในด้านการเขียนโค้ด
เราได้ทดสอบ GPT-5.5 และ Claude Sonnet 5 เมื่อวันที่ 7 กรกฎาคม 2026 ใน GlobalGPT โดยใช้หน้าผู้ใช้และคำสั่งที่เหมือนกัน เป้าหมายไม่ใช่เพื่อสร้างเกณฑ์วัดประสิทธิภาพของเอเจนต์ IDE แบบเต็มรูปแบบ แต่เพื่อเปรียบเทียบความช่วยเหลือในการเขียนโค้ดในชีวิตประจำวัน ได้แก่ การดีบัก การรีแฟคเตอร์ การวิเคราะห์หลายไฟล์ การเขียนเทสต์ และการตรวจสอบความปลอดภัย.
ระบบการให้คะแนนนั้นเรียบง่าย: ความถูกต้อง, การวิเคราะห์สาเหตุหลัก, ความสะดวกในการบำรุงรักษา, การครอบคลุมกรณีพิเศษ, การตรวจสอบ, และการปฏิบัติตามคำสั่ง ซึ่งทำให้การเปรียบเทียบนี้ใกล้เคียงกับวิธีที่นักพัฒนาใช้ผู้ช่วยเขียนโค้ด AI ในความเป็นจริง.
การทดสอบ 1: การแก้ไขข้อผิดพลาดและการวิเคราะห์สาเหตุหลัก
คำสั่งแรกขอให้ทั้งสองโมเดลตรวจสอบฟังก์ชัน JavaScript ที่จัดกลุ่มตั๋วตามระดับความสำคัญ ข้อผิดพลาดนี้อาจไม่ชัดเจนแต่พบได้บ่อย: ฟังก์ชันนี้พยายาม push เข้าสู่ acc[ticket.priority] ก่อนที่อาร์เรย์นั้นจะเกิดขึ้น.
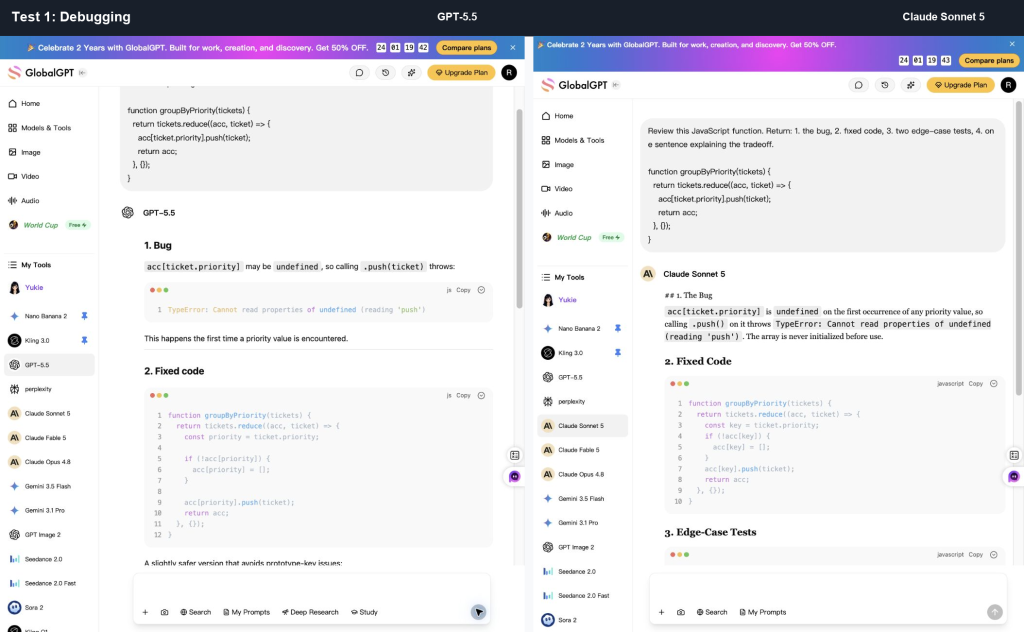
จุดแข็งของ ChatGPT: GPT-5.5 ได้ค้นพบข้อผิดพลาด ให้รหัสที่แก้ไขแล้ว เพิ่มการทดสอบสำหรับกรณีพิเศษ และรวมกลไกป้องกันที่เข้มงวดขึ้น Object.create(null) variant. รายละเอียดการดำเนินการเพิ่มเติมนี้มีประโยชน์เมื่อคีย์ของอ็อบเจ็กต์อาจเกิดการชนกันกับคุณสมบัติที่สืบทอดมา.
สิ่งที่โคลดทำได้ดี: Claude Sonnet 5 ได้พบข้อผิดพลาดเดียวกันและให้คำตอบที่ชัดเจนยิ่งขึ้น นอกจากนี้ยังชี้ให้เห็นกรณีขอบเขตที่มีระดับความสำคัญไม่ชัดเจน ซึ่งเป็นประเภทของข้อจำกัดในทางปฏิบัติที่ผู้ตรวจสอบควรพิจารณา.
ผู้ชนะ: ผลเสมอกัน โดย ChatGPT มีข้อได้เปรียบเล็กน้อยในด้านการปรับใช้ที่ละเอียดอ่อน Claude มีผลลัพธ์ที่ชัดเจนกว่า ส่วน GPT-5.5 มีผลลัพธ์ที่ครบถ้วนกว่า.
การทดสอบที่ 2: การปรับโครงสร้างโค้ดใหม่และความสะดวกในการดูแลรักษา
คำสั่งที่สองขอให้ปรับปรุงโครงสร้างโค้ดเพื่อเพิ่มความอ่านง่ายโดยไม่เปลี่ยนแปลงพฤติกรรม นี่เป็นการทดสอบที่ดี เพราะคำตอบจาก AI ในการเขียนโค้ดมักปรับปรุงโครงสร้างของยูทิลิตี้ขนาดเล็กมากเกินไป และสร้างส่วนที่เปลี่ยนแปลงได้มากขึ้นกว่าที่โค้ดต้นฉบับต้องการ.
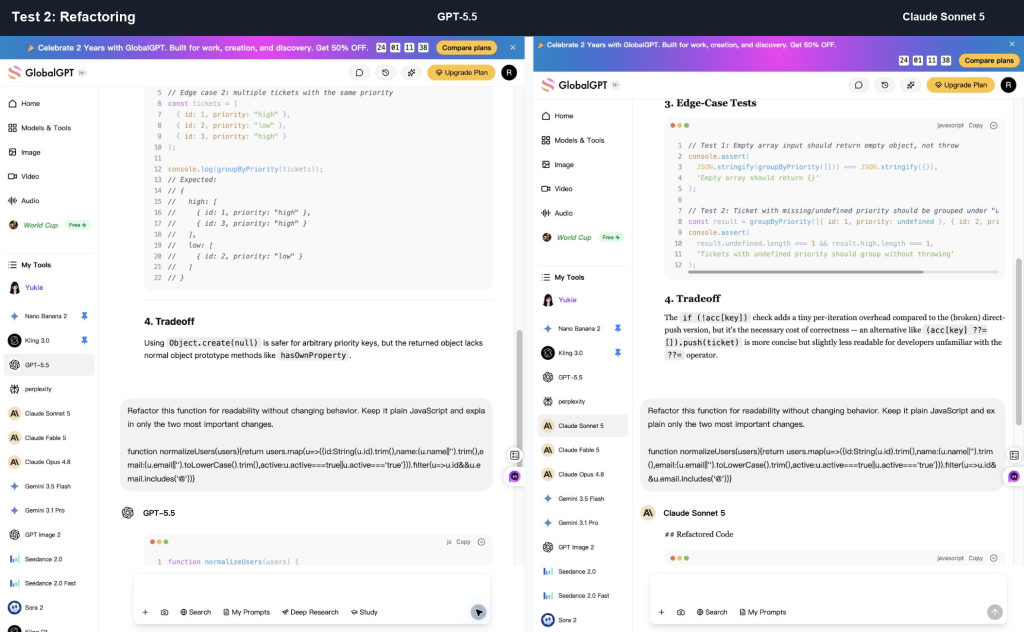
จุดแข็งของ ChatGPT: GPT-5.5 ได้รักษาโครงสร้างให้ใกล้เคียงกับต้นฉบับ นำค่ากลางที่มีชื่อมาใช้ และปฏิบัติตามคำสั่ง “เปลี่ยนแปลงสำคัญเพียงสองอย่าง” อย่างเคร่งครัด ซึ่งสิ่งนี้มีประโยชน์เมื่อผู้ใช้ต้องการการปรับโครงสร้างแบบระมัดระวัง.
สิ่งที่โคลดทำได้ดี: Claude Sonnet 5 ได้แยกฟังก์ชันช่วยเหลือ เช่น ฟังก์ชันปรับมาตรฐาน (normalizer) และฟังก์ชันตรวจสอบความถูกต้อง (validator) ผลลัพธ์ทำให้การสแกนเจตนา (intent) ง่ายขึ้น แต่กลับทำให้โครงสร้างเปลี่ยนแปลงไปมากกว่าที่ GPT-5.5 ทำ.
ผู้ชนะ: ChatGPT เพื่อความระมัดระวัง; Claude เพื่อความอ่านเข้าใจได้ง่ายในแบบโมดูลาร์ หากต้องการปรับโครงสร้างโค้ดแบบเรียบง่ายและปลอดภัย ให้เริ่มด้วย ChatGPT หากต้องการชื่อโดเมนที่ชัดเจนยิ่งขึ้น ให้ขอให้ Claude ตรวจสอบอีกครั้ง.
การทดสอบที่ 3: การวิเคราะห์และวางแผนสำหรับหลายไฟล์
โจทย์ข้อที่สามให้โครงสร้างไฟล์ Next.js ขนาดเล็กและรายงานข้อผิดพลาด: ผู้ใช้ที่เข้าสู่ระบบสามารถอัปโหลดไฟล์ขนาดเล็กได้ แต่ไฟล์ที่มีขนาดเกิน 8MB จะล้มเหลวโดยไม่มีข้อความแจ้งเตือนหลังจากแถบความคืบหน้าถึง 100%.
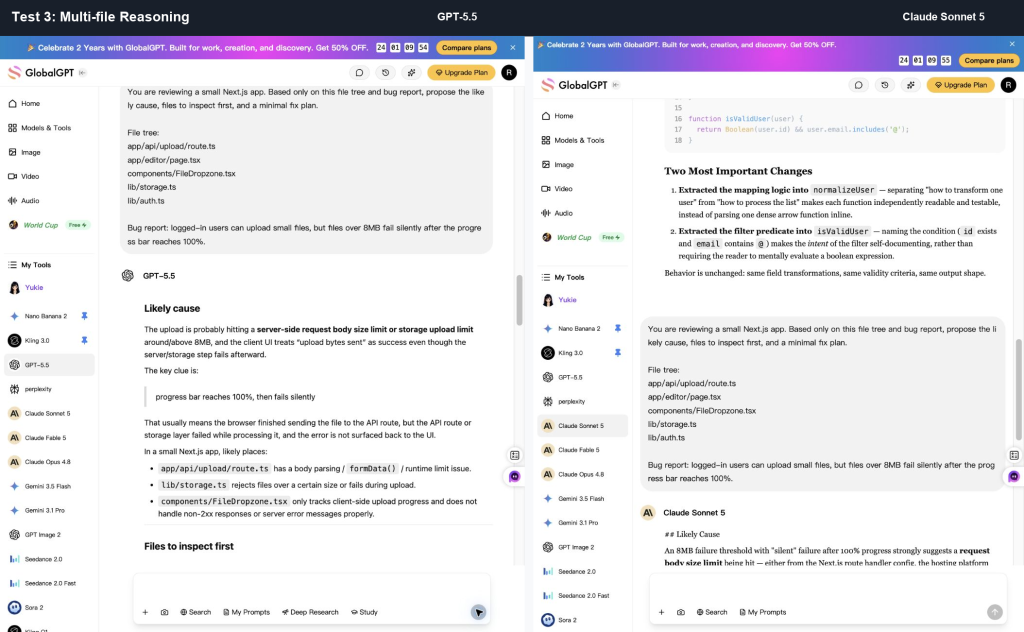
จุดแข็งของ ChatGPT: GPT-5.5 ได้สร้างแผนที่ละเอียดและเน้นการนำไปปฏิบัติจริง โดยกล่าวถึงการตรวจสอบขนาดเซิร์ฟเวอร์ การจัดการการตอบสนองจากลูกค้า และการแพร่กระจายข้อผิดพลาดในการจัดเก็บข้อมูล.
สิ่งที่โคลดทำได้ดี: Claude Sonnet 5 ได้กำหนดจุดศูนย์กลางที่ระดับ 8MB ทันที ซึ่งน่าจะเป็นข้อจำกัดของแพลตฟอร์มหรือขนาดตัวเครื่อง ความหมายของแถบความคืบหน้า และเส้นทางการตรวจสอบที่ 7MB/8MB/9MB ดูเหมือนเป็นบันทึกการทบทวนจากผู้อาวุโสมากกว่า.
ผู้ชนะ: Claude. ระบบนี้ช่วยกำหนดสาเหตุที่เป็นไปได้เป็นลำดับความสำคัญได้เร็วขึ้น และให้เส้นทางการตรวจสอบขั้นต่ำที่ชัดเจนยิ่งขึ้น.
การทดสอบที่ 4: การทดสอบระดับหน่วยและการตรวจสอบ
คำสั่งที่สี่ขอให้ทั้งสองโมเดลเขียนการทดสอบหน่วย (unit tests) ด้วย TypeScript สำหรับฟังก์ชันช่วยเหลือที่คืนค่าขีดจำกัดของแผนสำหรับการอัปโหลดและการเข้าถึง Codex การทดสอบนี้ใช้เพื่อตรวจสอบว่าโมเดลสามารถป้องกันตรรกะการแยกสาขา (branching logic) จากการถดถอยในอนาคตได้หรือไม่.
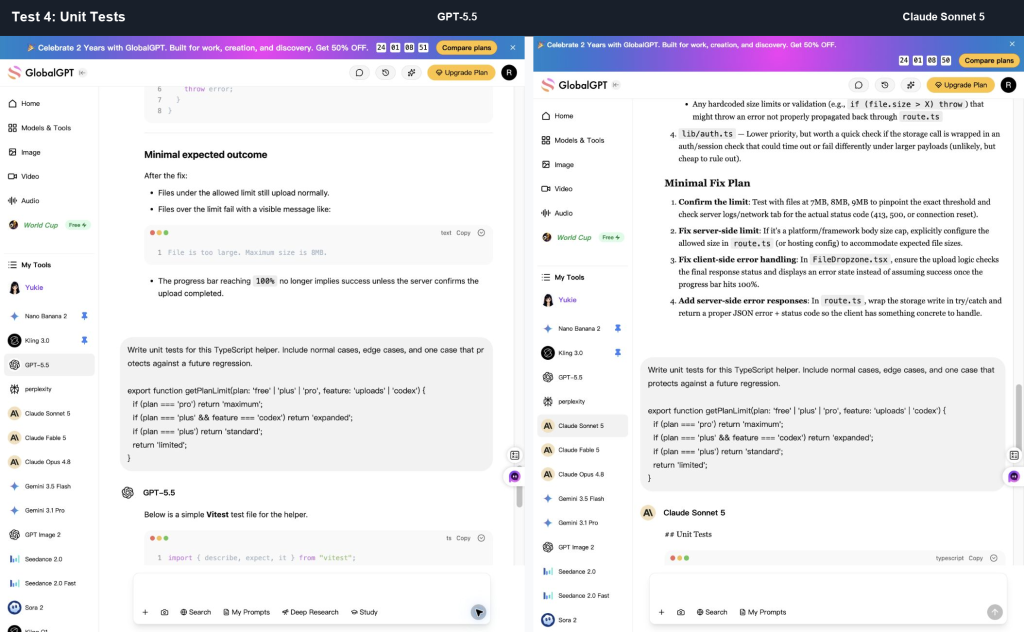
จุดแข็งของ ChatGPT: GPT-5.5 ได้รวมการนำเข้าเฟรมเวิร์กการทดสอบและสร้างไฟล์ Vitest ที่ดูเหมือนสามารถรันได้ มันครอบคลุมทุกชุดค่าที่คาดไว้ และทำให้คำตอบสามารถคัดลอกและวางลงในโครงการได้อย่างง่ายดาย.
สิ่งที่โคลดทำได้ดี: Claude Sonnet 5 ได้อธิบายความเสี่ยงของการถดถอยจริงได้ดีกว่า: pro + codex ต้องเกิดการลัดวงจรก่อนการตรวจสอบคุณสมบัติเฉพาะ แม้ว่าจะไม่ใช่ไฟล์ที่ใช้งานได้ทันที แต่คำตอบนี้มีความสมเหตุสมผลมากกว่า.
ผู้ชนะ: Claude สำหรับการวิเคราะห์เหตุผลของชุดทดสอบ; ChatGPT สำหรับการสร้างไฟล์เริ่มต้น ในทางปฏิบัติ ให้ใช้ ChatGPT เพื่อสร้างร่างชุดทดสอบฉบับแรก และใช้ Claude เพื่อวิเคราะห์ว่าชุดทดสอบดังกล่าวสามารถรับประกันพฤติกรรมที่ถูกต้องได้หรือไม่.
การทดสอบที่ 5: การตรวจสอบด้านความปลอดภัยและความน่าเชื่อถือ
คำสั่งที่ห้าขอให้ทั้งสองโมเดลตรวจสอบจุดปลายทาง webhook ของ Express คำตอบที่ดีควรครอบคลุมการตรวจสอบลายเซ็น ข้อกำหนดเกี่ยวกับเนื้อหาดิบ (raw body) ความเป็น idempotent การตรวจสอบความถูกต้อง การจัดการข้อผิดพลาดของฐานข้อมูล และข้อจำกัดขนาดคำขอ.
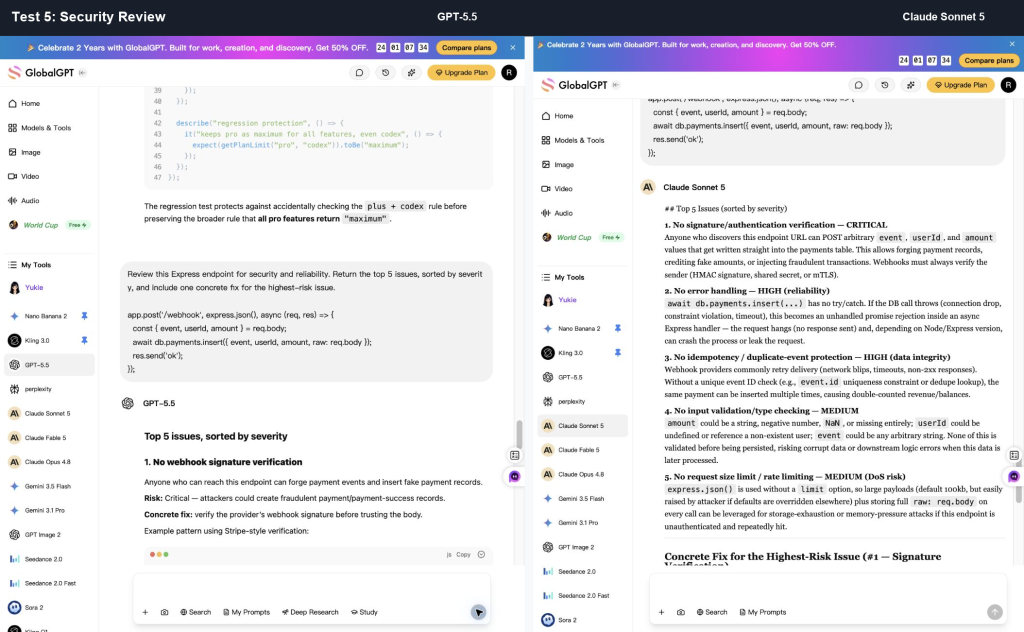
จุดแข็งของ ChatGPT: GPT-5.5 ได้เสนอวิธีแก้ไขแบบผู้ให้บริการ ซึ่งรวมถึงระบบที่คล้ายกับ Stripe express.raw() รูปแบบ ซึ่งจะมีประโยชน์เมื่อขั้นตอนต่อไปคือการสร้างตัวจัดการ webhook ที่เฉพาะเจาะจง.
สิ่งที่โคลดทำได้ดี: Claude Sonnet 5 ได้นำเสนอการวิเคราะห์ความรุนแรงที่ชัดเจนขึ้น และรวมรายละเอียดการเปรียบเทียบลายเซ็นที่ปลอดภัยยิ่งขึ้น โดยใช้แนวคิดการเปรียบเทียบในเวลาคงที่ ซึ่งทำให้การจัดอันดับความเสี่ยงดูชัดเจนขึ้น.
ผู้ชนะ: ทั้งสองมีคะแนนเท่ากัน แต่ Claude มีข้อได้เปรียบเล็กน้อยในส่วนการอธิบายด้านความปลอดภัย ทั้งสองโมเดลมีประสิทธิภาพเพียงพอที่จะนำไปใช้ประโยชน์ได้ แต่คำตอบใดก็ตามไม่ควรใช้แทนการตรวจสอบความปลอดภัยจริงสำหรับกระบวนการชำระเงินหรือการยืนยันตัวตน.
Claude Code เทียบกับ ChatGPT Codex
ผลลัพธ์การสนทนาเป็นเพียงส่วนหนึ่งของการตัดสินใจในการเขียนโค้ดเท่านั้น Claude Code และ Codex เป็นกระบวนการพัฒนาแบบเอเจนต์ที่แยกกัน สำหรับงานที่เกี่ยวข้องกับไฟล์ คำสั่ง การทดสอบ คำขอ pull หรือการเปลี่ยนแปลงฐานโค้ดในวงกว้าง.
| กระบวนการทำงาน | เหมาะสมที่สุด | ขอบเขตสำคัญ |
|---|---|---|
| Claude chat | การวิเคราะห์, การแก้ไขข้อผิดพลาด, การตรวจสอบ, การอธิบาย และการวางแผน. | มันจะเห็นเพียงบริบทที่คุณกำหนดไว้เท่านั้น เว้นแต่จะเชื่อมต่อกับเครื่องมือหรือกระบวนการทำงานที่กว้างขึ้น. |
| การสนทนาผ่าน ChatGPT | ร่างการนำไปใช้จริง การทดสอบ ตัวอย่าง และคำถามเกี่ยวกับการใช้งาน API. | แม้คำตอบจะชัดเจนเพียงใด ก็ยังจำเป็นต้องได้รับการตรวจสอบในโครงการของคุณ. |
| โคลด โค้ด | การเขียนโค้ดที่คำนึงถึง Repo, การนำทางในฐานโค้ด, การทดสอบ และการวางแผนงานขนาดใหญ่. | ตรวจสอบสิทธิ์การเข้าถึง นโยบายความปลอดภัย และส่วนที่เสนอให้แก้ไข ก่อนที่จะยอมรับการเปลี่ยนแปลง. |
| โคเด็กซ์ | การนำ Repo มาใช้ในกระบวนการพัฒนา การแก้ไขข้อผิดพลาด การทดสอบ การตรวจสอบ และกระบวนการเขียนโค้ดที่ผสานรวมกับ OpenAI. | แผนการเข้าถึง การใช้งาน และความพร้อมใช้งานของโมเดลนั้นแตกต่างจากบริการแชททั่วไป และอาจเปลี่ยนแปลงไปตามเวลา. |
วิธีปฏิบัติ: ใช้โมเดลแชทสำหรับการคิด การอธิบาย และงานเล็กๆ; ใช้ Claude Code หรือ Codex เมื่องานนั้นต้องการบริบทจากรีโพสิตอรีและขั้นตอนที่สามารถดำเนินการได้.
ราคา: Claude, ChatGPT, Codex และ GlobalGPT
เริ่มด้วยการถามว่าคุณกำลังจ่ายสำหรับอะไร แพ็กเกจแชทจะคิดค่าบริการตามความช่วยเหลือด้านการเขียนโค้ดแบบโต้ตอบรายวัน ส่วนเวิร์กโฟลว์ของโค้ดดิ้งเอเจนต์จะคิดค่าบริการตามงานที่เกี่ยวข้องกับรีโพสิตอรี เช่น CLI, IDE, เว็บ, งานบนคลาวด์ หรือการผสานระบบ ส่วนราคา API จะคิดค่าบริการต่อหนึ่งล้านโทเคน ส่วนพื้นที่ทำงานแบบหลายโมเดลจะคิดค่าบริการเพื่อให้สามารถสลับใช้งานระหว่าง Claude, GPT, Gemini, Perplexity และโมเดลอื่นๆ ได้อย่างสะดวกในที่เดียว.
ราคาที่ตรวจสอบเมื่อวันที่ 27 กันยายน 2026 เป็นราคาในดอลลาร์สหรัฐ ก่อนภาษีที่เกี่ยวข้อง ตารางนี้แบ่งออกเป็นบริการสมัครสมาชิกสำหรับผู้บริโภค อัตราค่าบริการโทเคน API มาตรฐาน และแผนรายปีของ GlobalGPT เอง. หน้าราคาของ Claude จำนวนรอบต่อปีของ Pro เทียบเท่ากับ $17 ต่อเดือน; $200 ที่จ่ายล่วงหน้าจะเท่ากับ $16.67 ต่อเดือน.
| ผลิตภัณฑ์หรือแพ็กเกจ | ราคาที่แสดง | ความหมายของสิ่งนี้ต่อการเขียนโค้ด |
|---|---|---|
| ผู้บริโภค · Claude ฟรี | $0 | เพียงพอสำหรับคำถามด้านการเขียนโค้ดระดับพื้นฐาน และลองสไตล์ของ Claude ก่อนที่จะจ่ายเงิน. |
| ผู้บริโภค · Claude Pro | $20 ต่อเดือน; $200 ต่อปี จ่ายล่วงหน้า (เทียบเท่า $16.67 ต่อเดือน) | รวมรหัส Claude; การใช้งานในแผนแบบชำระเงินสำหรับ chat และรหัส Claude จะถูกนับรวมกัน. |
| ผู้บริโภค · Claude Max | ตั้งแต่ $100/เดือน | ตัวเลือกการใช้งานระดับสูง; รวมรหัส Claude แล้ว การคิดค่าบริการของ API Console เป็นระบบแยกต่างหาก. |
| ผู้บริโภค · ChatGPT ฟรี | 1,000,000 บาทต่อเดือน | แชทแบบเบา; การเข้าถึง GPT-6 Luna บนเดสก์ท็อปนั้นแตกต่างจาก Chat ทั่วไป. |
| ผู้บริโภค · แชทจีพีที โก | $8/เดือน ตามข้อมูลอ้างอิงต้นฉบับจากสหรัฐอเมริกา; ราคาในท้องถิ่นอาจแตกต่างกัน | แพ็กเกจสมัครสมาชิกรายเดือน; โปรดตรวจสอบหน้าข้อมูลราคาท้องถิ่นเพื่อทราบราคาในตลาดของคุณ. |
| ผู้บริโภค · แชทจีพีที พลัส | $20 ต่อเดือน, เรียกเก็บรายเดือน | ได้รับคำแนะนำการเขียนโค้ดอย่างสม่ำเสมอ และสิทธิ์เข้าถึง Codex/Work ตามเงื่อนไขที่กำหนด; การใช้งาน API จะถูกคิดค่าบริการแยกต่างหาก. |
| ผู้บริโภค · แชทจีพีที โปร | $100/เดือน; แพ็กเกจ $200/เดือนที่มีอยู่จะยังคงมีผลต่อไป | การสมัครใหม่และการอัปเกรดแพ็กเกจ $200 จะถูกระงับตั้งแต่วันที่ 10 กันยายน 2026 ส่วนการสมัครแพ็กเกจ $100 ยังคงเปิดให้บริการอยู่. |
| API · โคลด โซเน็ต 5 | $2/M เป็นสัญญาณเข้า; $10/M เป็นสัญญาณออก | อัตรา API มาตรฐานสำหรับเครื่องมือการเขียนโค้ดและกระบวนการทำงานในบริบทขนาดใหญ่. |
| API · Claude Opus 5.5 | $4/M เป็นสัญญาณเข้า; $20/M เป็นสัญญาณออก | ความเร็วมาตรฐาน โหมดเร็วมีค่าอินพุต $8/M และค่าเอาต์พุต $40/M. |
| API · GPT-6 Astra | $10/M (เข้า); $50/M (ออก) | อัตราค่าบริการ API มาตรฐาน; แยกต่างหากจากแพ็กเกจ ChatGPT. |
| API · GPT-6 Sol / Luna | Sol: $2/M (เข้า), $10/M (ออก); Luna: $0.10/M (เข้า), $0.50/M (ออก) | แยกการเรียกเก็บเงินสำหรับนักพัฒนา; ใช้ ID ของโมเดลและอัตราค่าบริการที่ถูกต้อง. |
| แพลตฟอร์ม · GlobalGPT Basic | เทียบเท่า $5.80 ต่อเดือน; $69.60 ที่เรียกเก็บเงินรายปี | วิธีที่ประหยัดค่าใช้จ่ายในการเปรียบเทียบหลายตระกูลโมเดล สำหรับการเขียนโค้ดและวิจัยในชีวิตประจำวัน. |
| แพลตฟอร์ม · GlobalGPT Pro | เทียบเท่า $10.80/เดือน; $129.60 ที่เรียกเก็บเงินรายปี | เหมาะกว่าเมื่อคุณต้องเปลี่ยนไปใช้ระหว่างหลายกลุ่มรุ่นต่าง ๆ ในระหว่างการทำงานปกติ. |
| แพลตฟอร์ม · GlobalGPT ไม่จำกัด | เทียบเท่า $25/เดือน; $300 คิดค่าบริการรายปี | สำหรับการเปรียบเทียบหลายโมเดลอย่างบ่อยครั้งในพื้นที่ทำงานเดียว แผนบริการเหล่านี้ไม่รวมเครดิต API อย่างเป็นทางการ หรือการสมัครสมาชิก Claude Code/Codex แบบดั้งเดิม. |
สำหรับนักพัฒนาส่วนใหญ่ การตัดสินใจไม่ใช่ว่า “บริษัทไหนราคาถูกที่สุด?” แต่เป็น “ราคาไหนที่เหมาะกับกระบวนการทำงาน?” หากคุณส่วนใหญ่เพียงถามคำถามและคัดลอกโค้ดมาวาง Claude Pro หรือ แชทจีพีที พลัส อาจเพียงพอแล้ว หากคุณต้องการการใช้งานที่รองรับ repo ให้เปรียบเทียบระหว่าง Claude Code และ Codex access หากคุณเปรียบเทียบโมเดลหลายตัวทุกวัน GlobalGPT อาจเป็นพื้นที่ทำงานประจำวันที่เรียบง่ายกว่า เนื่องจากค่าใช้จ่ายผูกกับแผน multi-model เดียว แทนที่จะเป็นหลายแผนการสมัครสมาชิกแยกกัน.
สำหรับเครื่องมือเขียนโค้ดที่ใช้ API เป็นหลัก การเปรียบเทียบราคาตามแบบสมัครสมาชิกนั้นไม่เหมาะสม การกำหนดราคาตามโทเคนมีความสำคัญมากกว่า เนื่องจากบริบทของโค้ดมีขนาดใหญ่มาก. โคลด โซเน็ต 5 ใช้ทรัพยากร $2/M สำหรับข้อมูลเข้า และ $10/M สำหรับข้อมูลออก ส่วน Opus 5.5 ใช้ทรัพยากร $4/M และ $20/M ที่ความเร็วมาตรฐาน ดังนั้น การใช้โทเคนเข้า 1 ล้านโทเคน บวกกับโทเคนออก 1 ล้านโทเคน จะมีค่าใช้จ่าย $12 บน Sonnet 5 หรือ $24 บน Opus 5.5 สำหรับ OpenAI การใช้งานเดียวกันนี้จะมีค่าใช้จ่าย $60 บน Astra, $12 บน Sol หรือ $0.60 บน Luna ตามอัตราค่าบริการมาตรฐาน นี่คือค่าบริการ API ไม่ใช่โควตาที่รวมอยู่ในแพ็กเกจ ChatGPT, Claude หรือ GlobalGPT.
คุณควรเลือกชุดอุปกรณ์การเขียนโค้ดแบบใด?
อย่าเลือกเพียงจากชื่อโมเดลเท่านั้น แต่ควรเลือกตามประเภทงานเขียนโค้ดที่คุณทำจริง ๆ คนเดียวกันอาจใช้ ChatGPT สำหรับการพัฒนารุ่นแรก ใช้ Claude สำหรับการตรวจสอบ ใช้ Codex สำหรับงานใน repository ที่สามารถรันได้ และใช้ GlobalGPT สำหรับการตรวจสอบโมเดลแบบเปรียบเทียบอย่างรวดเร็วในระหว่างวันทำงานปกติ.
ผู้เริ่มต้นเรียนเขียนโปรแกรม: เริ่มด้วย ChatGPT โดยทั่วไปแล้วมันจะให้ตัวอย่างเพิ่มเติม โครงสร้างการเรียนรู้ที่ชัดเจนขึ้น และเส้นทางที่ง่ายกว่าจาก “ผมไม่เข้าใจข้อผิดพลาดนี้” ไปสู่ “นี่คือรูปแบบที่ทำงานได้”
นักพัฒนาขั้นต้นที่กำลังแก้ไขข้อผิดพลาด: เมื่อปัญหายังไม่ชัดเจน ให้เริ่มด้วย Claude ก่อน Claude มีความสามารถในการจำกัดสาเหตุที่เป็นไปได้ ระบุสิ่งที่ควรตรวจสอบก่อน และทำให้คำอธิบายยังคงตรงประเด็น หลังจากนั้น ให้ใช้ ChatGPT เมื่อต้องการโค้ดแก้ไขที่ชัดเจน กรณีทดสอบ หรือตัวอย่างการนำไปใช้.
วิศวกรระดับสูงกำลังตรวจสอบการเปลี่ยนแปลง: เริ่มด้วย Claude ก่อนครับ โมเดลนี้เหมาะกว่าสำหรับการหาจุดสมดุล การจัดอันดับความรุนแรง การพิจารณาด้านสถาปัตยกรรม และการวิจารณ์อย่างกระชับ สำหรับงานที่เกี่ยวข้องกับโค้ดเบสขนาดใหญ่ ให้ย้ายจากแชทไปยัง Claude Code หรือ Codex เพื่อให้โมเดลสามารถทำงานกับไฟล์และคำสั่งได้ แทนที่จะใช้โค้ดที่คัดลอกและวางมา.
เครื่องมือสร้างส่วนหน้าหรือ UI: เริ่มด้วย ChatGPT ในขั้นตอนแรก เนื่องจากมันมักสร้างโค้ดคอมโพเนนต์ที่ครบถ้วนยิ่งขึ้น รวมถึงการจัดการสถานะและโครงสร้างพื้นฐานสำหรับการทดสอบ จากนั้นใช้ Claude เพื่อตรวจสอบเรื่องความสามารถในการเข้าถึง ขอบเขตของคอมโพเนนต์ การตั้งชื่อ และว่าโค้ดนั้นมีความซับซ้อนเกินความจำเป็นสำหรับดีไซน์หรือไม่.
ผู้ดูแลฐานโค้ดขนาดใหญ่: เลือก Claude Code หรือ Codex ตามชุดเครื่องมือ (stack) ของคุณ สิทธิ์การเข้าถึงบัญชี นโยบายความปลอดภัย และกระบวนการทำงานที่คุณต้องการ เมื่อมีงานที่เกี่ยวข้องกับหลายไฟล์ กระบวนการทำงานของเอเจนต์มักมีความสำคัญมากกว่าการเลือกคำตอบในแชทที่ฟังดูดีกว่า.
ผู้ก่อตั้งคนเดียวหรือทีมขนาดเล็ก: หากงบประมาณเอื้ออำนวย ให้ใช้ทั้งสองตระกูลโมเดล การตั้งค่าที่ปฏิบัติได้จริงคือใช้ GlobalGPT สำหรับการเปรียบเทียบโมเดลประจำวันและการสร้างโค้ดจากไอเดีย พร้อมทั้งใช้ Claude Code หรือ Codex เมื่องานนั้นต้องการเข้าถึงรีโพสิตอรีและขั้นตอนที่สามารถดำเนินการได้.
| ประเภทผู้พัฒนา | ตัวเลือกแรกที่ดีที่สุด | ทำไม |
|---|---|---|
| ผู้เริ่มต้นเรียนเขียนโปรแกรม | แชทจีพีที | ตัวอย่างเพิ่มเติม คำอธิบายที่ละเอียดยิ่งขึ้น และโครงสร้างการเรียนรู้ที่เหมาะสำหรับผู้เริ่มต้น. |
| นักพัฒนาขั้นต้นที่กำลังแก้ไขข้อผิดพลาด | โคลดเป็นคนแรก | การวิเคราะห์สาเหตุหลักที่ชัดเจนยิ่งขึ้น และคำแนะนำที่ดีขึ้นเกี่ยวกับ “ตรวจสอบสิ่งนี้ก่อน”. |
| วิศวกรระดับสูงกำลังตรวจสอบการเปลี่ยนแปลง | โคลด | เหมาะยิ่งขึ้นสำหรับการวิเคราะห์การแลกเปลี่ยนผลประโยชน์ การจัดอันดับความเสี่ยง และการวิจารณ์อย่างกระชับ. |
| เครื่องมือสร้างส่วนหน้า/ส่วนติดต่อผู้ใช้ | ChatGPT ก่อน Claude ต่อมา | ChatGPT จะเขียนร่างส่วนนั้น ส่วน Claude จะตรวจสอบด้านความสะดวกในการใช้งาน โครงสร้าง และความง่ายในการดูแลรักษา. |
| ผู้ดูแลฐานโค้ดขนาดใหญ่ | Claude Code หรือ Codex ขึ้นอยู่กับสแต็กและวิธีการเข้าถึง | ไฟล์ คำสั่ง การทดสอบ และสิทธิ์การเข้าถึง มีความสำคัญมากกว่าคำตอบในแชทเพียงหนึ่งข้อความ. |
| ผู้ก่อตั้งคนเดียว | ทั้งสองอย่าง โดยมักผ่านพื้นที่ทำงานแบบหลายโมเดลเดียว | การร่างแบบอย่างรวดเร็ว การตรวจสอบอย่างละเอียด และการเปลี่ยนแบบจำลองอย่างรวดเร็ว ล้วนเป็นปัจจัยสำคัญเมื่อมีเพียงคนเดียวที่รับผิดชอบผลิตภัณฑ์. |
หากคุณกำลังตัดสินใจเลือกระหว่างตระกูลรุ่น Claude และ GPT รุ่นใหม่ การเปรียบเทียบระหว่าง Claude Opus 5.5 กับ GPT-6 Sol จะให้ข้อมูลที่เฉพาะเจาะจงกับรุ่นมากขึ้น หากคุณกำลังพิจารณาแผนบริการแบบเสียค่าใช้จ่ายของ OpenAI, ChatGPT Plus เทียบกับ Pro การเปรียบเทียบสามารถช่วยกำหนดได้ว่าการใช้อย่างหนักขึ้นนั้นคุ้มค่าหรือไม่.
ทำไมนักพัฒนาหลายคนยังใช้ทั้งสองอย่าง
การใช้ทั้ง Claude และ ChatGPT ไม่ใช่ความลังเล แต่เป็นวงจรการควบคุมคุณภาพที่ดีกว่า.
- วางแผนกับ Claude, ดำเนินการกับ ChatGPT: มีประโยชน์เมื่อคุณต้องการใช้ Claude เพื่อลดความเสี่ยง และ ChatGPT เพื่อสร้างเวอร์ชันแรก.
- เขียนร่างด้วย ChatGPT แล้วตรวจสอบด้วย Claude: มีประโยชน์เมื่อคุณต้องการเขียนโค้ดอย่างรวดเร็ว แต่ต้องการความเห็นเพิ่มเติมที่เข้มงวดขึ้น.
- ก่อนที่จะเริ่มผลิต ให้ถามทั้งสองฝ่ายก่อน: มีประโยชน์สำหรับการชำระเงิน การยืนยันตัวตน การอัปโหลดข้อมูล การย้ายข้อมูล การเก็บข้อมูลในแคช และการเปลี่ยนแปลงฐานข้อมูลที่ส่งผลให้ข้อมูลเดิมถูกลบ.
- ใช้ตัวแทนเมื่องานนั้นต้องการไฟล์: Claude Code หรือ Codex อาจมีความสำคัญมากกว่าการสนทนาทั่วไป เมื่อโมเดลต้องการบริบทจากแหล่งข้อมูล.
GlobalGPT เหมาะกับรูปแบบ “ใช้ทั้งสอง” เมื่องานนั้นเป็นการเปรียบเทียบแบบทันที การช่วยเหลือในการเขียนโค้ดประจำวัน การวางแผน หรือการวิจัย มันมีประโยชน์เป็นพิเศษสำหรับการเปรียบเทียบโมเดลประจำวัน การปรับปรุงร่าง การขอความคิดเห็นเพิ่มเติมอย่างรวดเร็ว และการเลือกสไตล์โมเดลที่เหมาะสมที่สุดสำหรับงานชิ้นต่อไป.
หากการเข้าถึง Claude เป็นสิ่งเดียวที่คุณกำลังประเมินอยู่, แล้ว ทางเลือกที่ดีที่สุดสำหรับ AI ของ Claude รายการนี้เป็นคู่มือทางเลือกที่ครอบคลุมมากขึ้น.
คำถามที่พบบ่อย
ในปี 2026 Claude หรือ ChatGPT จะดีกว่ากันสำหรับการเขียนโค้ด?
เลือก Claude เป็นอันดับแรกสำหรับการตรวจสอบโค้ด การแก้ไขข้อผิดพลาดที่ไม่ชัดเจน การวางแผนสถาปัตยกรรม และการวิเคราะห์ในบริบทที่กว้าง เลือก ChatGPT เป็นอันดับแรกสำหรับร่างการนำไปใช้จริง ตัวอย่าง งานด้าน frontend และการสร้างโครงสร้างการทดสอบ เมื่องานต้องการการเข้าถึงรีโพสิตอรี คำสั่ง การทดสอบ หรือการแก้ไขไฟล์หลายไฟล์ ให้เปรียบเทียบ Claude Code กับ Codex แทนที่จะพึ่งพาการสนทนาเพียงอย่างเดียว.
Claude ดีกว่า ChatGPT ในการแก้ไขข้อผิดพลาดหรือไม่?
Claude มักจะให้ผลลัพธ์ที่ดีกว่าในขั้นตอนการดีบักครั้งแรก เนื่องจากมันมักจะให้ความสำคัญกับสาเหตุที่เป็นไปได้มากที่สุด และอธิบายเส้นทางการเกิดข้อผิดพลาดได้อย่างชัดเจน ในการทดสอบ JavaScript และ Next.js ของเรา Claude Sonnet 5 แสดงประสิทธิภาพที่โดดเด่นเป็นพิเศษในการวินิจฉัยปัญหาอย่างกระชับ ส่วน ChatGPT ยังคงมีประสิทธิภาพดีเมื่อการแก้ไขต้องการรายละเอียดการดำเนินการที่ครบถ้วนมากขึ้น.
ChatGPT Codex ดีกว่า Claude Code หรือไม่?
ไม่มีตัวเลือกใดที่ดีกว่าโดยอัตโนมัติสำหรับทุกทีม ChatGPT Codex เหมาะกับกระบวนการทำงานที่เน้น OpenAI และงานของเอเจนต์ที่ต้องดำเนินการอย่างละเอียด ส่วน Claude Code จะมีความได้เปรียบเมื่องานนั้นได้รับประโยชน์จากสไตล์การวางแผน การทบทวน และการวิเคราะห์ในบริบทระยะยาวของ Claude การเลือกตัวเลือกที่เหมาะสมที่สุดขึ้นอยู่กับสิทธิ์การเข้าถึงรีโพสิตอรี ราคา ระบบเทคโนโลยี (stack) สิทธิ์การเข้าถึง และนโยบายของทีม.
ตัวเลือกใดดีกว่าสำหรับฐานโค้ดที่มีขนาดใหญ่?
สำหรับฐานโค้ดขนาดใหญ่ กระบวนการทำงานของเอเจนต์มีความสำคัญมากกว่าโมเดลแชทเพียงอย่างเดียว ให้ใช้ Claude Code หรือ Codex เมื่อผู้ช่วยจำเป็นต้องตรวจสอบไฟล์ ดำเนินการคำสั่ง ดำเนินการทดสอบ หรือติดตามพฤติกรรมระหว่างโมดูลต่าง ๆ ให้มีการตรวจสอบโดยมนุษย์ในส่วนที่เกี่ยวข้องกับสิทธิ์การเข้าถึง คำสั่งที่มีความเสี่ยง และผลลัพธ์การเปรียบเทียบ (diff) สุดท้าย.
อะไรดีกว่าสำหรับผู้เริ่มต้นที่อยากเรียนเขียนโปรแกรม?
ChatGPT มักจะเหมาะสำหรับผู้เริ่มต้นมากกว่า เพราะมันมักจะให้ตัวอย่างมากขึ้น คำอธิบายที่ละเอียดขึ้น และโค้ดตัวอย่างที่พร้อมใช้งานได้ทันที ส่วน Claude อาจเป็นตัวเลือกที่ดีกว่าเมื่อผู้เริ่มต้นติดขัดกับสาเหตุที่บางสิ่งไม่ทำงาน และต้องการคำอธิบายเชิงแนวคิดที่ชัดเจนยิ่งขึ้น.
ตัวไหนดีกว่าสำหรับโค้ด HTML และ UI ด้านหน้า?
ChatGPT มักมีความสามารถที่ดีกว่าในการสร้างร่างแรกของ HTML, CSS หรือคอมโพเนนต์ ส่วน Claude มีประโยชน์ในการตรวจสอบโครงสร้าง ทำให้การจัดวางเรียบง่ายขึ้น และตรวจหาปัญหาด้านความสามารถในการเข้าถึงหรือการบำรุงรักษา สำหรับงานส่วนหน้า (frontend) ที่ต้องการความสมบูรณ์แบบ ให้ใช้ ChatGPT เพื่อสร้างร่าง และใช้ Claude เพื่อตรวจสอบ.
รุ่นไหนเหมาะสำหรับการเขียนการทดสอบมากกว่า?
ChatGPT เหมาะกว่าเมื่อคุณต้องการไฟล์ทดสอบครบถ้วนที่มีคำสั่งนำเข้า (imports) และโครงสร้างที่ดูเหมือนสามารถรันได้ ส่วน Claude เหมาะกว่าเมื่อคุณต้องการเข้าใจว่าพฤติกรรมใดจำเป็นต้องได้รับการป้องกัน และทำไมการทดสอบการถดถอย (regression test) จึงสำคัญ กระบวนการทำงานที่มีประสิทธิภาพคือการสร้างการทดสอบด้วย ChatGPT แล้วถาม Claude ว่ามีกรณีขอบ (edge cases) ใดที่ยังขาดอยู่.
เครื่องมือวัดประสิทธิภาพอย่าง SWE-Bench สามารถพิสูจน์ได้หรือไม่ว่าเครื่องมือช่วยเขียนโค้ดตัวไหนดีกว่า?
ไม่ SWE-Bench, SWE-Bench Pro และ Terminal-Bench เป็นสัญญาณที่มีค่า โดยเฉพาะอย่างยิ่งสำหรับกระบวนการทำงานด้านการเขียนโค้ดแบบเอเจนต์ แต่พวกมันไม่สามารถคาดการณ์ได้อย่างครบถ้วนว่าจะมีประโยชน์ในการช่วยเขียนโค้ดในชีวิตประจำวันได้อย่างไร มาตรฐานการวัดประสิทธิภาพ (benchmarks) วัดผลจากชุดทดสอบที่ได้รับการควบคุมอย่างเคร่งครัด ส่วนนักพัฒนาจริงยังต้องการเหตุผลที่ชัดเจน โค้ดที่ใช้งานได้ การเปลี่ยนแปลงที่รักษาได้ง่าย และขั้นตอนการตรวจสอบที่ดี.
นักพัฒนาควรใช้ทั้ง Claude และ ChatGPT หรือไม่?
ใช่ครับ โดยเฉพาะอย่างยิ่งสำหรับงานที่จริงจัง ให้ใช้ Claude สำหรับการวางแผน การวิเคราะห์ความเสี่ยง และการวินิจฉัย ส่วน ChatGPT ให้ใช้สำหรับร่างการดำเนินการ ตัวอย่าง และโครงสร้างการทดสอบ จากนั้นให้รันโค้ด ตรวจสอบความแตกต่าง (diff) และตรวจสอบพฤติกรรมในโครงการของคุณเอง.
ผมสามารถเปรียบเทียบ Claude และ ChatGPT ใน GlobalGPT ได้ไหม?
ใช่ครับ GlobalGPT มีประโยชน์ในการเปรียบเทียบคำตอบของ Claude และ ChatGPT ในพื้นที่ทำงานเดียวกัน เมื่อมีโมเดลที่จำเป็นอยู่ในพื้นที่นั้น มันทำงานได้ดีสำหรับคำถามเกี่ยวกับโค้ดในชีวิตประจำวัน การวางแผน การวิจัย และการขอความคิดเห็นเพิ่มเติม มันไม่ได้มาแทนที่ Claude Code, Codex, IDE, API อย่างเป็นทางการ หรือเครื่องมือระดับรีโพสิตอรี.





