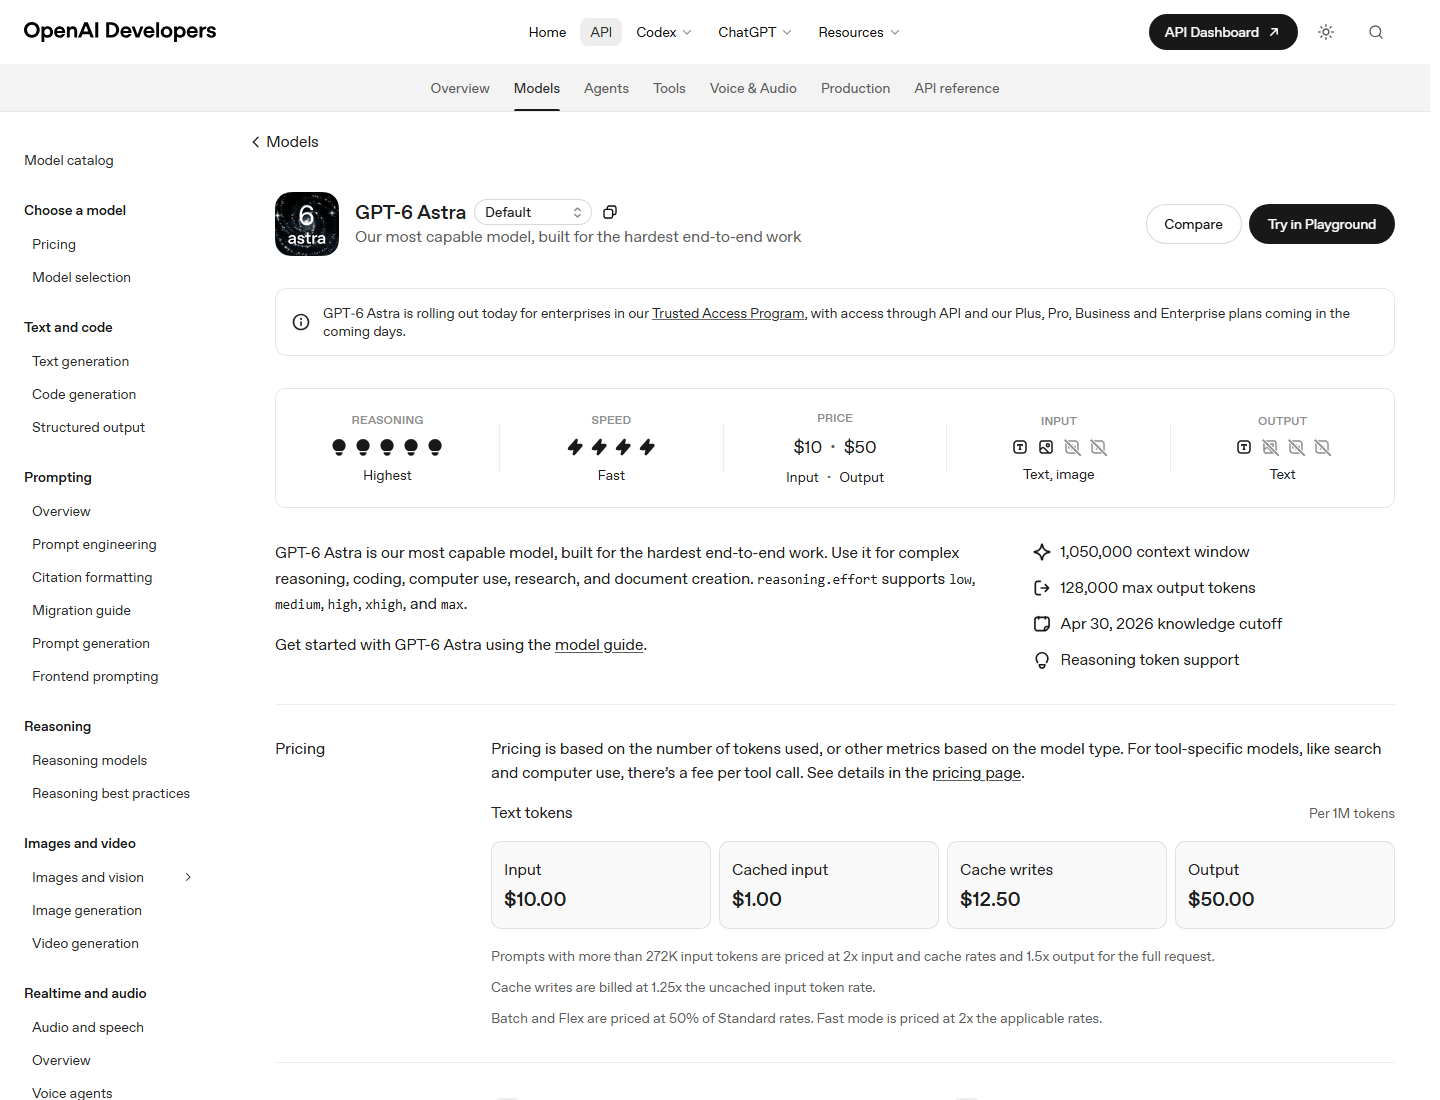
GPT-6.1 Sol — это значение по умолчанию; GPT-6 Astra — максимальный уровень качества. Оба предоставляют одинаковое контекстное окно объемом 1 050 000 токенов, ограничение на вывод результатов в 128 000 токенов, поддержку мультимодального ввода и широкий набор инструментов. Решающее отличие заключается в позиционировании и цене: Sol стоит $2 за миллион токенов ввода и $10 за миллион токенов вывода, тогда как Astra стоит $10 и $50. Другими словами, Astra должна создавать достаточную дополнительную ценность, чтобы оправдать в пять раз более высокую стоимость в токенах Standard.
Это не означает, что Sol — “та же модель, но по более низкой цене”. Компания OpenAI называет Astra своей самой мощной моделью для самых сложных задач от начала до конца и описывает Sol как устройство, обеспечивающее производительность, близкую к Astra, при выполнении сложных задач по более низкой цене. Таким образом, выбор правильного решения — это вопрос оценки, а не простой рейтинг брендов. В данном сравнении используются текущие Документация по GPT-6.1 Sol, , Страница модели GPT-6 Astra, а также идентичные сценарии затрат, проверенные 9 октября 2026 года.
GPT-6.1 Sol против GPT-6 Astra: краткое сравнение
Таблица упрощает принятие первоначального решения: если у вас пока нет данных, относящихся конкретно к данной задаче, Sol заслуживает первоочередного использования, поскольку сохраняет основные характеристики интерфейса и производительности, при этом значительно снижая затраты на токены. Astra становится рациональным выбором, когда задача необычайно сложна, последствия неправильного ответа значительны или её более точный результат позволяет избежать нескольких раундов корректировки со стороны человека или модели.
Это отличается от сравнения Sol с небольшой и быстрой моделью. Согласно текущим рекомендациям компании OpenAI, Sol занимает одно из лидирующих мест, а не находится в нижней ценовой категории. Читатели, выбирающие модель из всей линейки, также могут воспользоваться нашим руководство по лучшим моделям искусственного интеллекта и Обзор GPT-6 Luna чтобы понять, в каких случаях достаточно более легкой модели.
Что общего у GPT-6.1 Sol и GPT-6 Astra
На страницах обеих официальных моделей указаны одинаковые параметры: контекстное окно, максимальный объем входных данных, максимальный объем выходных данных и пороговое значение знаний. Обе модели принимают текст и изображения и генерируют текст. Ни на одной из страниц аудио или видео не указаны в качестве входных или выходных данных модели. У них также одинаковые уровни затрат на вывод: низкий, средний, высокий, очень высокий и максимальный, причем по умолчанию установлен средний. Такая симметрия упрощает A/B-тестирование, поскольку приложение может сохранять большинство параметров запроса неизменными, меняя только идентификатор модели.
Обе модели поддерживают структурированные выводы, вызов функций, веб-поиск, поиск файлов, генерацию изображений, интерпретатор кода, хостируемую оболочку, применение патчей, использование компьютера, MCP, навыки и поиск инструментов. В OpenAI вызов инструментов указан через API «Responses»; функция «Chat Completions» доступна в случаях, когда инструменты не задействованы. На страницах обеих моделей не поддерживается точная настройка. Речь идет о декларациях возможностей, а не о гарантиях того, что обе модели будут выбирать инструменты с одинаковой точностью.
Контекстное окно объемом в миллион токенов — это ограничение емкости, а не разрешение игнорировать механизмы извлечения информации. Очень длинные запросы требуют больше ресурсов, сложнее в отладке и подпадают под повышенную ставку при количестве входных токенов свыше 272K. Разбиение на фрагменты, извлечение информации, создание резюме и кэширование подсказок по-прежнему остаются важными. То же предупреждение относится и к ограничению на выходные данные в 128K: небольшие проверяемые артефакты обычно безопаснее, чем один огромный ответ.
Ценообразование: пятикратный разрыв
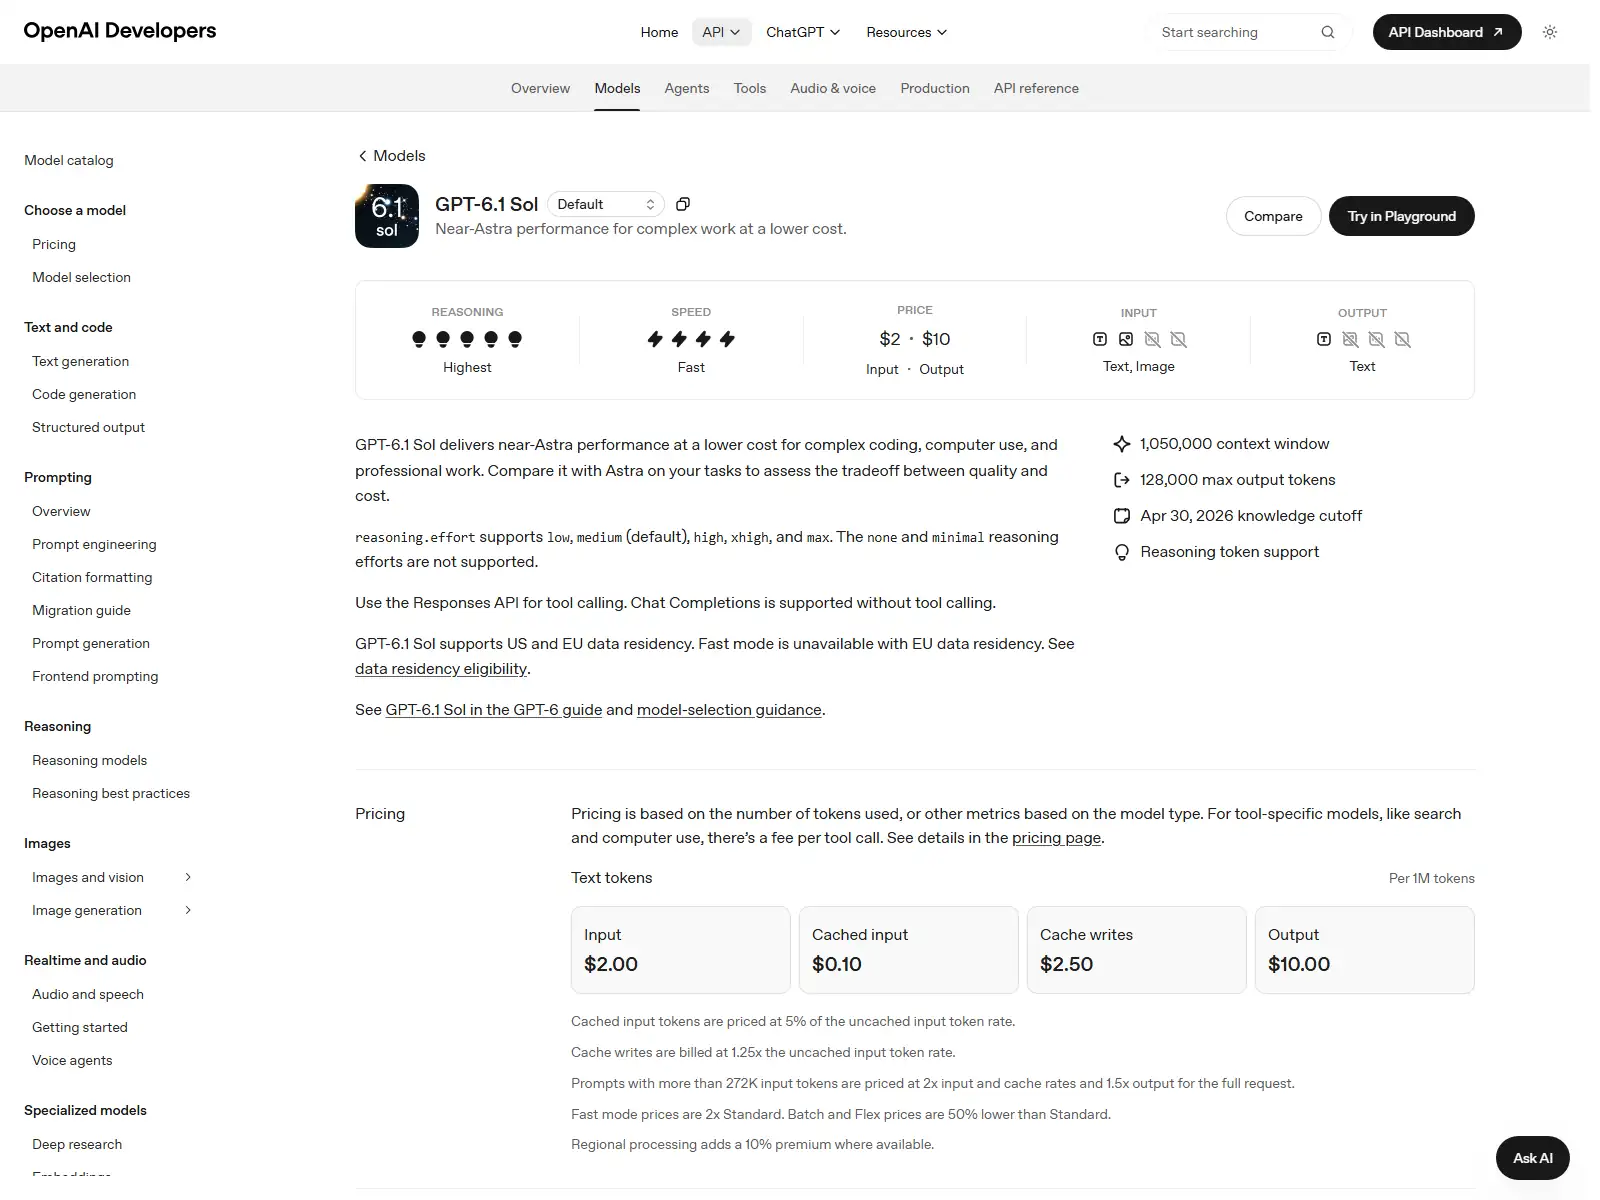
По стандартным тарифам GPT-6.1 Sol стоит $2 за миллион входных токенов без кэширования, $0.10 — за входные данные с кэшированием, $2.50 — за запись в кэш и $10 — за выходные данные. GPT-6 Astra стоит $10, $1, $12,50 и $50 соответственно. Sol в пять раз дешевле для входных данных без кэширования, записи в кэш и выходных данных; кэшированные входные данные обходятся в десять раз дешевле. Приведенные цифры взяты непосредственно со страниц модели OpenAI и Документация по ценообразованию API.
Указанный в заголовке коэффициент — это не вся картина. Как только запрос превышает 272K входных токенов, к полному запросу применяются коэффициенты OpenAI: вдвое превышающие стандартные скорости ввода и кэширования и в 1,5 раза превышающие стандартную скорость вывода. Стоимость тарифных планов «Batch» и «Flex» соответствует 50% в тарифе «Standard», а тариф «Fast» стоит в два раза дороже. Astra также предлагает тарифный план «Ultrafast». Сравнивайте сопоставимые варианты: запрос Sol Batch и запрос Astra Fast не раскрывают соотношение «модель-цена», лежащее в их основе.
Более подробную информацию о флагманском сегменте см. в нашем Руководство по ценам на GPT-6 Astra. Ранее Анализ цен на GPT-6 Sol Это полезно при планировании перехода с предыдущего поколения Sol, однако при расчете объемов производства следует использовать точный текущий идентификатор модели и актуальные коэффициенты.
Проектирование с учетом долгосрочного контекста: одинаковая мощность, разные экономические показатели
Одинаковое контекстное окно объемом 1 050 000 токенов может создать впечатление, что Sol и Astra взаимозаменяемы при работе с большими объемами документов, но емкость — это лишь первое ограничение. Запрос, приближающийся к пределу, по-прежнему должен находить нужные доказательства, отличать инструкции от цитируемого материала, сохранять связи между множеством файлов и возвращать результат, который может проверить человек или программа. Модель с более громким названием не устраняет необходимости в информационной архитектуре. Систематизируйте источники, обозначайте границы и требуйте ссылок на стабильные идентификаторы документов.
Благодаря более низкой стоимости Sol становится экономически целесообразным проводить эксперименты с длительным контекстом. Команда может протестировать несколько стратегий разбиения на фрагменты, пороговых значений извлечения и форматов резюме за стоимость одного запуска Astra. Такой расширенный поиск может улучшить систему, даже если Astra покажет лучшие результаты только для одного запроса. Astra становится более привлекательной после того, как рабочий процесс стабилизируется, а нерешенные ошибки действительно обусловлены ограничениями модели. На ранних этапах разработки потратить весь бюджет на несколько флагманских запросов может дать меньше результатов для обучения, чем проведение тщательной оценки Sol по множеству репрезентативных случаев.
Пороговое значение в 272K требует особого внимания. Запрос с 271K входных токенов и запрос с 273K имеют почти одинаковый размер, но второй из них переносит весь запрос в более высокий ценовой диапазон. Составьте предварительную оценку количества токенов и зафиксируйте, в каком диапазоне ценообразования использовался каждый запрос. Если объем входных данных лишь незначительно превышает пороговое значение, удаление дублирующихся шаблонных фрагментов, устаревшей истории диалога или малозначимых извлеченных фрагментов может существенно снизить затраты без ущерба для качества. Эта оптимизация применима к обеим моделям, хотя более высокие базовые тарифы Astra делают ошибки более дорогостоящими.
Кэширование подсказок наиболее эффективно, когда значительная часть префикса остается неизменной при разных вызовах. Примерами могут служить руководства по политикам, стандарты кодирования, каталог продукции или схема инструмента, используемая во многих задачах. Если поведение API при кэшировании поддерживает такую структуру, сначала размещайте стабильный контент, а затем — изменяющиеся инструкции. Затем измеряйте количество попаданий в кэш, а не делайте предположения. Преимущество Sol, связанное с кэшированными входными данными, особенно велико, но постоянно меняющийся префикс может свести его на нет. Проектирование кэша должно быть отражено в отчете о тестировании наряду с точностью и задержкой.
Для исследования и анализа документов используйте поэтапный рабочий процесс: извлеките вероятные доказательства, запросите у модели структурированную карту доказательств, проверьте ссылки и только после этого запросите синтез. Используйте Astra, если синтез остается слабым даже после того, как конвейер доказательств работает надежно, или когда набор источников содержит необычно тонкие противоречия. Это позволяет отделить сбои в поиске от сбоев в рассуждениях. Без такого разделения команды часто вынуждены приобретать более мощную модель, чтобы компенсировать проблему построения контекста, которую можно было бы избежать.
Программирование и использование инструментов
В контексте программирования полезный вопрос заключается не в том, “какая модель способна писать код?” — обе модели способны на это. Вопрос в том, в каких случаях дополнительные возможности Astra влияют на результат. Sol привлекателен для обычной работы с репозиториями: реализации функций с ограниченной областью действия, диагностики воспроизводимых ошибок, проверки пулл-реквестов, написания тестов, преобразования данных и запуска итеративных циклов инструментов. Его более низкая стоимость позволяет совершать больше попыток, проводить более тщательную проверку и использовать более обширные наборы данных для оценки при том же бюджете.
Astra лучше всего подходит для задач, в которых преобладают неоднозначность и необходимость координации: миграция в незнакомое монорепо, анализ архитектуры с учетом требований безопасности, использование компьютерного оборудования в долгосрочной перспективе, сложный перенос кода на другой язык или инцидент в производственной среде с неполными данными. Даже самая дорогая модель может окупиться, если один правильный план позволит избежать многочасовой переделки. Наш лучшая модель искусственного интеллекта для сравнения кода объясняет, почему тесты репозитория имеют большее значение, чем общие впечатления от кода.
- Функции с определённым объёмом и чёткими приёмными тестами
- Регулярная отладка и рецензирование кода
- Циклы агентов с большим объемом обработки
- Проекты миграций и рефакторинга
- Создание тестов и документация
- Серьёзные сбои после попытки выполнения команды Sol
- Изменения в системе безопасности или данных, сопряженные с высоким риском
- Неоднозначная межсистемная архитектура
- Длительные задачи, требующие автономной работы с компьютером
- Заключительная проверка, когда ошибки обходятся дорого
Не оценивайте ни одну из моделей на основании кода, который лишь выглядит правдоподобно. Предоставьте обеим одинаковый снимок репозитория, инструкции, инструменты, временной бюджет и тесты. Зафиксируйте процент успешного прохождения, исправления, внесённые человеком, сбои при вызове инструментов, количество токенов, задержку и стоимость. Модель, которая стоит в пять раз дороже, но сокращает количество неудачных попыток вдвое, может быть оправдана; модель, которая улучшает стиль, но не повышает уровень принятия, — нет.
Данные об эффективности: какие выводы можно сделать, а какие — нет
Позиционирование OpenAI даёт наиболее убедительное обоснование: Astra — самая мощная модель для самых сложных задач «от начала до конца», тогда как GPT-6.1 Sol нацелена на достижение производительности, близкой к Astra, при решении сложных задач с меньшими затратами. Эти утверждения подтверждают гипотезу о выборе, а не универсальный процентный разрыв. Ни один из общедоступных тестов не может предсказать производительность при работе с вашими собственными документами, инструментами, политиками или кодовой базой.
Презентационные видеоролики помогают понять, как компания позиционирует продукт, но они не являются независимыми оценками. Точно так же обзоры авторов демонстрируют реальные интерфейсы и полезные примеры, однако каждый обзор отражает конкретный набор заданий, настройки инструментов и сроки публикации. Рассматривайте положительную миниатюру или первое впечатление как отправную точку для вашего собственного плана тестирования, а не как доказательство того, что Astra или Sol выигрывают во всех категориях.
Официальное видео OpenAI, представленное выше, отражает реакцию на запуск Astra. На странице независимого автора Мэтта Вульфа, приведенной ниже, видно, что внимание сторонних наблюдателей быстро сосредоточилось на масштабах релиза. Ни один из этих скриншотов не используется здесь в качестве количественного ориентира. В статье намеренно избегается преобразование энтузиазма, количества просмотров или статуса автора в необоснованную оценку эффективности.
Для объективного сравнения следует использовать закрытый оценочный набор, который напоминает реальную эксплуатационную среду. Включите в него простые задачи, типичные задачи и дорогостоящие случаи сбоев. Скрывайте результаты, когда важны предпочтения человека. В случае агентов проверяйте завершение задачи и восстановление, а не первый ответ. OpenAI’s рекомендации по выбору модели также рекомендует сравнивать модели на одинаковых задачах и оставлять самую лёгкую модель и подход к выводу, которые позволяют преодолеть порог качества.
Как провести объективное сравнение Sol и Astra
Начните с определения решения, которое должна принять система оценки. Вопрос “Какая модель умнее?” слишком расплывчат. Полезным вопросом будет: “Какая модель должна обрабатывать рецензирование пулл-реквестов для этого репозитория при среднем уровне логического анализа?” или “Следует ли перенаправить синтез окончательного контракта из Sol в Astra?” Перед генерацией результатов определите семейство задач, уровень сервиса, уровень сложности рассуждений, инструменты, временные ограничения и критерии приемки. В противном случае положительный результат можно будет объяснить скорее настройками, чем самой моделью.
Сформируйте набор, достаточно большой, чтобы охватить как типичные случаи, так и значимые крайние случаи. Двадцать тщательно отобранных примеров могут выявить очевидные сбои, но для производственной политики маршрутизации обычно требуется больше. Возьмите выборку из недавних реальных проектов, удалив конфиденциальные данные, а затем пометьте каждый случай по уровню сложности и риска. Держите отдельный набор данных под замком, чтобы быстрая настройка не привела к постепенной переобученности на примерах, которые уже видели все. Управляйте версиями набора данных и средства оценки так же, как вы управляете версиями кода приложения.
По возможности используйте детерминированные проверки. Компилируйте код, запускайте тесты, проверяйте JSON на соответствие схеме, сравнивайте извлеченные поля с метками и проверяйте цитируемые фрагменты. Эксперты-оценщики должны сосредоточиться на качествах, которые автоматизация не может должным образом учесть, таких как ясность, способность к критическому суждению и соответствие рекомендации бизнес-контексту. Скрывайте идентичность модели и рандомизируйте порядок вывода результатов. Если оценщики знают, какой ответ был сгенерирован Astra, цена и репутация могут повлиять на оценку, даже если никто не стремится к предвзятости.
Отслеживайте степень серьезности, а не только средние показатели. Десять незначительных стилистических преимуществ не должны перевешивать одну критическую рекомендацию, связанную с потерей данных. Определите строгие критерии отклонения, такие как вымышленные ссылки, небезопасные команды, отсутствие обязательных полей или несоблюдение правовых ограничений. Составьте отчет о распределении по категориям сложности и риска. Sol может сравняться с Astra при выполнении обычных задач и отстать только в самых сложных пяти процентах случаев; этот результат убедительно свидетельствует в пользу использования маршрутизатора вместо полного перехода «всё или ничего».
Наконец, рассчитайте неопределенность и повторно запустите нестабильные случаи. Результаты модели могут варьироваться, поэтому однократное сравнение преувеличивает роль случайности. Повторите расчет для подмножества данных, изучите расхождения между оценщиками и сохраните исходные результаты для аудита. В окончательной рекомендации должны быть указаны дата тестирования, идентификаторы моделей, настройки, версия набора данных, использованные цены и известные пробелы. Пересматривайте её после обновления модели, изменения подсказки или значительного изменения рабочей нагрузки. Выбор модели — это постоянно обновляемое производственное решение, а не постоянный трофей.
Не допускайте, чтобы система оценки стала скрытой моделью принятия решений. Если автоматизированный судья явно отдаёт предпочтение одному из вариантов ответа, отоберите такие решения для экспертной проверки и сравните результаты судьи с фактическими данными о принятии решений. Разделяйте качество презентации и правильность выполнения задачи: изящное объяснение может скрывать несоответствие требованиям, в то время как лаконичный ответ может пройти все тесты. Также фиксируйте воздержавшиеся голоса и ничьи, вместо того чтобы навязывать победителя. Эти детали делают результат менее эффектным, но гораздо более полезным для планирования бюджета и распределения задач. Цель — создать воспроизводимое рабочее правило, которое другой член команды сможет проверить и повторить. Фиксируйте также отклоненные результаты; примеры неудач часто объясняют границы распределения задач гораздо яснее, чем таблица средних оценок.
Примеры реальных затрат
Рассмотрим запуск кодирующего агента с 200 000 некэшированных входных токенов и 20 000 выходных токенов. Стоимость Sol составляет примерно $0.60: $0.40 за входные данные и $0.20 за выходные данные. Стоимость Astra составляет примерно $3,00: $2,00 плюс $1,00. За 10 000 запусков разница составляет примерно $24 000 без учёта комиссий за использование инструментов, кэширования, региональных надбавок или корректировок уровня обслуживания.
Теперь рассмотрим запрос с длинным контекстом, содержащий 300 000 входных токенов и 30 000 выходных токенов. Поскольку объем входных данных превышает 272K, к всему запросу применяются более высокие тарифы. Эффективная скорость ввода Sol становится равной $4 на миллион, а скорость вывода — $15, что в сумме даёт примерно $1,65. Для Astra входная скорость составляет $20, а выходная — $75, что в сумме даёт примерно $8,25. Пятикратное соотношение сохраняется, но абсолютный разрыв увеличивается.
Кэширование может еще больше сместить расчет в сторону Sol, поскольку скорость поступления данных в его кэш составляет одну десятую от скорости Astra. Это имеет значение для стабильных системных инструкций, больших повторяющихся обращений и построения агентов. Однако запись в кэш по-прежнему имеет свою цену, а изменение префикса может снизить степень повторного использования. Делайте оценки на основе фактических журналов использования, а не исходя из предположения, что каждый токен будет обрабатываться со скоростью, характерной для кэшированных данных.
Как сравнивать модели в API
Используйте API Responses для приложений, работающих с инструментами, и сохраняйте одинаковую конфигурацию сравнения. Самый простой и эффективный набор тестов отправляет одинаковые входные данные на оба идентификатора моделей, записывает метаданные ответов и запускает один и тот же оцениватель. Не указывайте ключи API в исходном коде; используйте переменную среды и ваш обычный менеджер секретных данных.
Размер выборки специально выбран небольшим. Производственная тестовая среда должна сохранять идентификаторы запросов, версии оценивающих модулей, коммиты репозитория, трассировки инструментов, количество повторных попыток и результаты приемочных испытаний. Она также должна рассчитывать стоимость на основе фактически использованного уровня обслуживания и диапазона длительного контекста. Следует избегать ситуации, при которой одна модель получает обратную связь, которую не получила другая, за исключением случаев, когда вы явно тестируете последовательность маршрутизации.
Практическая стратегия маршрутизации от Sol до Astra
Двухступенчатый маршрутизатор учитывает наиболее весомый экономический аргумент в пользу Sol, не делая вид, что все запросы равноценны. Направляйте обычный трафик в Sol при среднем уровне обоснованности. Перенаправляйте запросы на более высокий уровень, если детерминированные тесты завершаются неудачей, модель сообщает о низкой степени уверенности, задача относится к категории высокого риска или человек явно запрашивает проверку флагманской системой. Обеспечьте прозрачность правил перенаправления, чтобы затраты не увеличивались незаметно.
Используйте те же самые инструкции, инструменты и приемочные тесты.
Тесты, уровень достоверности, класс риска и экспертная оценка.
Передавайте задачи, связанные с неудачами или высоким риском, в компанию «Астра».
Отслеживайте приемку, доработку, задержки и общую стоимость.
Маршрутизация также предоставляет командам возможность контролируемым образом обновлять настройки по умолчанию. Если показатель принятия задач у команды «Sol» улучшился в рамках определенного семейства задач, увеличьте долю этой команды. Если команда «Astra» неоднократно предотвращает дорогостоящие дефекты, направляйте задачи этой категории напрямую ей. Такое сравнение становится операционной политикой, подкрепленной данными, а не разовым обсуждением моделей. Для ознакомления с материалами предыдущего поколения см. GPT-6 Astra против GPT-5.6 Sol.
Задержка и надёжность должны учитываться в одной и той же политике маршрутизации. Модель может давать более точный ответ, но при этом оставаться неправильным выбором по умолчанию, если время её отклика нарушает интерактивный рабочий процесс или если длительность её рассуждений приводит к таймаутам заданий. Измеряйте задержку первого токена, общую продолжительность, время восстановления после вызова инструмента и количество успешных завершений в условиях реалистичной параллельности. Затем определите цель обслуживания для каждого класса задач. Sol может обрабатывать срочный производственный трафик, а Astra — асинхронную проверку; обратный подход может быть оправдан, если сложная задача регулярно завершается сбоем до эскалации. Решение модели носит операционный характер, а не просто редакционный.
Кому стоит выбрать Sol, а кому — Astra?
Выберите GPT-6.1 Sol для экономичного производства
Sol подходит для продуктовых команд, агентств, исследователей и разработчиков, которые выполняют значительные объемы сложной работы, но при этом имеют измеримые критерии приемки. Он особенно эффективен, когда итерации являются частью процесса: циклы «код-тестирование-исправление», доработка документации, извлечение данных с проверкой, обобщение результатов исследований и многоэтапные внутренние агенты. Благодаря более низкой цене вы получаете более широкий охват оценки и больше возможностей для повторных попыток.
Выбирайте GPT-6 Astra для самых сложных задач, требующих высокого качества
Astra подходит для команд, в которых самые сложные задачи сопряжены с высокими издержками в случае ошибок или слабой автоматической проверкой. Сложное архитектурное решение, итоговая проверка безопасности, задача, требующая новаторского научного анализа, или длительная последовательность вычислений могут оправдать затраты на флагманскую версию. Кроме того, это более оптимальный вариант по умолчанию на ранних этапах исследования, когда команда ещё не знает, что упускает меньшая модель, а стоимость не является непосредственным ограничивающим фактором.
Используйте оба варианта, когда уровень сложности заданий различается
В большинстве зрелых систем не следует навязывать одну и ту же модель для каждого запроса. Используйте Sol для широкого среднего диапазона задач, а Astra — в качестве уровня эскалации. Добавьте Luna или другую модель меньшего размера для предсказуемой классификации и преобразования. Такая многоуровневая архитектура отражает реальное разнообразие рабочих нагрузок и, как правило, является более экономичной, чем поиск единственного «безусловного победителя». Наша методология тестирования моделей представляет собой полезную основу для отделения подтверждаемых фактов от личных впечатлений.
Как использовать GPT-6.1 Sol и GPT-6 Astra на GlobalGPT
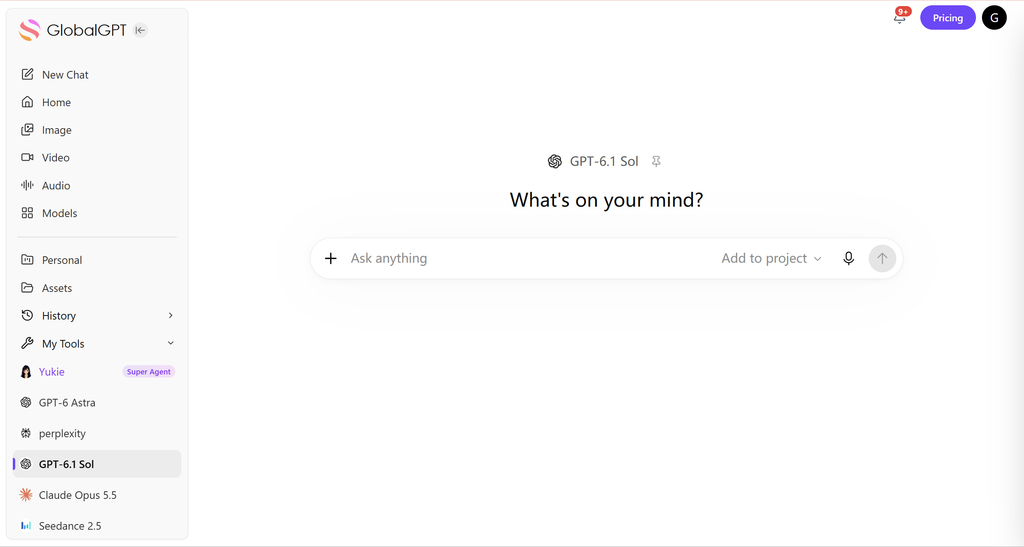
GlobalGPT предоставляет маршруты разработки продуктов в режиме реального времени для обеих моделей в рамках одного мультимодельного рабочего пространства. Откройте рабочую среду, начните новый диалог и выберите в списке доступных моделей GPT-6.1 Sol или GPT-6 Astra. Совместное использование обеих моделей в одном интерфейсе удобно для параллельного экспериментального анализа, тогда как оценка через API по-прежнему остается более подходящим способом для автоматизированной оценки, точного отслеживания использования и контроля развертывания.
Начните с Sol для первого прогона, затем запустите самый сложный запрос с помощью Astra и сравните, что существенно изменилось.
Открыть GlobalGPTЧтобы получить более подробную информацию по конкретной модели, ознакомьтесь с нашей Руководство по GPT-6.1 от Sol и Обзор GPT-6 Astra. На этих страницах подробно описаны все модели; на данной странице речь пойдет о том, как выбрать и приобрести одну из них.
Часто задаваемые вопросы
GPT-6.1 Sol лучше, чем GPT-6 Astra?
Не в абсолютном выражении. В рамках стратегии «OpenAI» модель GPT-6 Astra позиционируется как самая мощная, а GPT-6.1 Sol — как более доступная по цене модель, обеспечивающая производительность, близкую к Astra, при выполнении сложных задач. Sol станет более выгодным выбором, если она соответствует вашим требованиям к качеству; Astra же — более надежный вариант, ориентированный в первую очередь на качество, для самых сложных задач.
Насколько GPT-6.1 Sol дешевле, чем GPT-6 Astra?
По стандартным тарифам Sol стоит $2 за миллион входных токенов и $10 за миллион выходных токенов, тогда как у Astra эти показатели составляют $10 и $50. Таким образом, Sol в пять раз дешевле для входных и выходных данных без кэширования. Его цена за кэшированные входные данные — $0,10 — составляет одну десятую от ставки Astra, равной $1.
Имеют ли GPT-6.1 Sol и GPT-6 Astra одинаковое окно контекста?
Да. В документе OpenAI для обеих моделей указаны: контекстное окно размером 1 050 000 токенов, максимальный объем входных данных — 922 000 токенов и максимальный объем выходных данных — 128 000 токенов. При запросах с объемом входных данных свыше 272K токенов весь запрос перенаправляется на тарифы с более длинным контекстом.
Какая модель лучше подходит для программирования?
Astra — это лучший выбор с точки зрения качества для необычно сложных, неоднозначных или сопряженных с высоким риском задач, связанных с репозиторием. Sol — это практичный вариант по умолчанию для рутинной работы с функциями, отладки, рецензирования и циклов агентов, поскольку его более низкая стоимость позволяет проводить больше итераций. Перед принятием окончательного решения протестируйте обе системы на одном и том же наборе тестов репозитория.
Обе модели поддерживают ввод с помощью инструментов и изображений?
Да. На официальных страницах моделей перечислены следующие функции: ввод текста и изображений, вывод текста, структурированный вывод, вызов функций, поиск в Интернете, поиск файлов, интерпретатор кода, хостируемая оболочка, применение патчей, использование компьютера, MCP, навыки и поиск инструментов. Для вызова инструментов следует использовать API Responses.
Когда нужно оплатить GPT-6 Astra?
Используйте Astra в тех случаях, когда цена ошибки слишком высока, задача действительно относится к передовым технологиям или сравнительный анализ показывает, что её дополнительное качество позволяет сократить объём доработок настолько, что это оправдывает стоимость, в пять раз превышающую стоимость токена. К таким примерам относятся критически важные миграции, сложное использование автономных вычислительных систем и окончательная проверка результатов работы, от которых зависит многое.
Какой вид логического рассуждения мне выбрать?
Начните со среднего уровня — это задокументированное значение по умолчанию для обеих моделей. Уменьшайте уровень для простых преобразований и увеличивайте его только в тех случаях, когда этого требует сложность задачи или стоимость ошибки. Эффективная настройка — это минимальный уровень, при котором ваши приемочные тесты стабильно проходят успешно.
Можно ли использовать GPT-6.1 Sol и GPT-6 Astra на GlobalGPT?
В мультимодельном рабочем пространстве GlobalGPT доступны активные маршруты как для GPT-6.1 Sol, так и для GPT-6 Astra. Доступность может варьироваться в зависимости от учетной записи и интерфейса, поэтому перед началом рабочего процесса в производственной среде откройте рабочее пространство и проверьте текущий выбор модели.
Стоит ли направлять все запросы в одну модель?
Как правило, нет. Простой маршрутизатор может направлять обычные задачи в Sol, а случаи с низким уровнем достоверности, не прошедшие тестирование или сопряженные с высоким риском — в Astra. Это позволяет в полной мере использовать преимущество Sol в плане затрат, оставляя Astra для тех задач, где дополнительные возможности имеют ощутимую ценность.
Окончательный вердикт
GPT-6.1 Sol должна стать первой моделью, которую рассмотрят команды, ориентированные на экономию средств; GPT-6 Astra же должна оставаться целевой моделью для решения самых сложных задач. Общий контекст, ограничения на объем вывода, модальности, средства управления процессом рассуждений и каталог инструментов позволяют провести необычайно четкое сравнение. Sol обеспечивает экономическое преимущество. Astra обладает официально признанным преимуществом в функциональных возможностях.
Решающим показателем является не только цена токена или престиж модели. Оценивайте стоимость каждого принятого результата с учетом реальных эксплуатационных ограничений и бюджетов. Если Sol демонстрирует аналогичную скорость прохождения тестов, то его в пять раз более низкие скорости ввода и вывода данных без кэширования трудно игнорировать. Если Astra предотвращает сбои, сокращает необходимость экспертной проверки или решает задачи, с которыми Sol не справляется, то такая надбавка может быть оправданной. Начните с идентичных задач, по возможности проводите оценку вслепую и продвигайте только ту модель и тот подход к выводу, которые заслуживают этого.