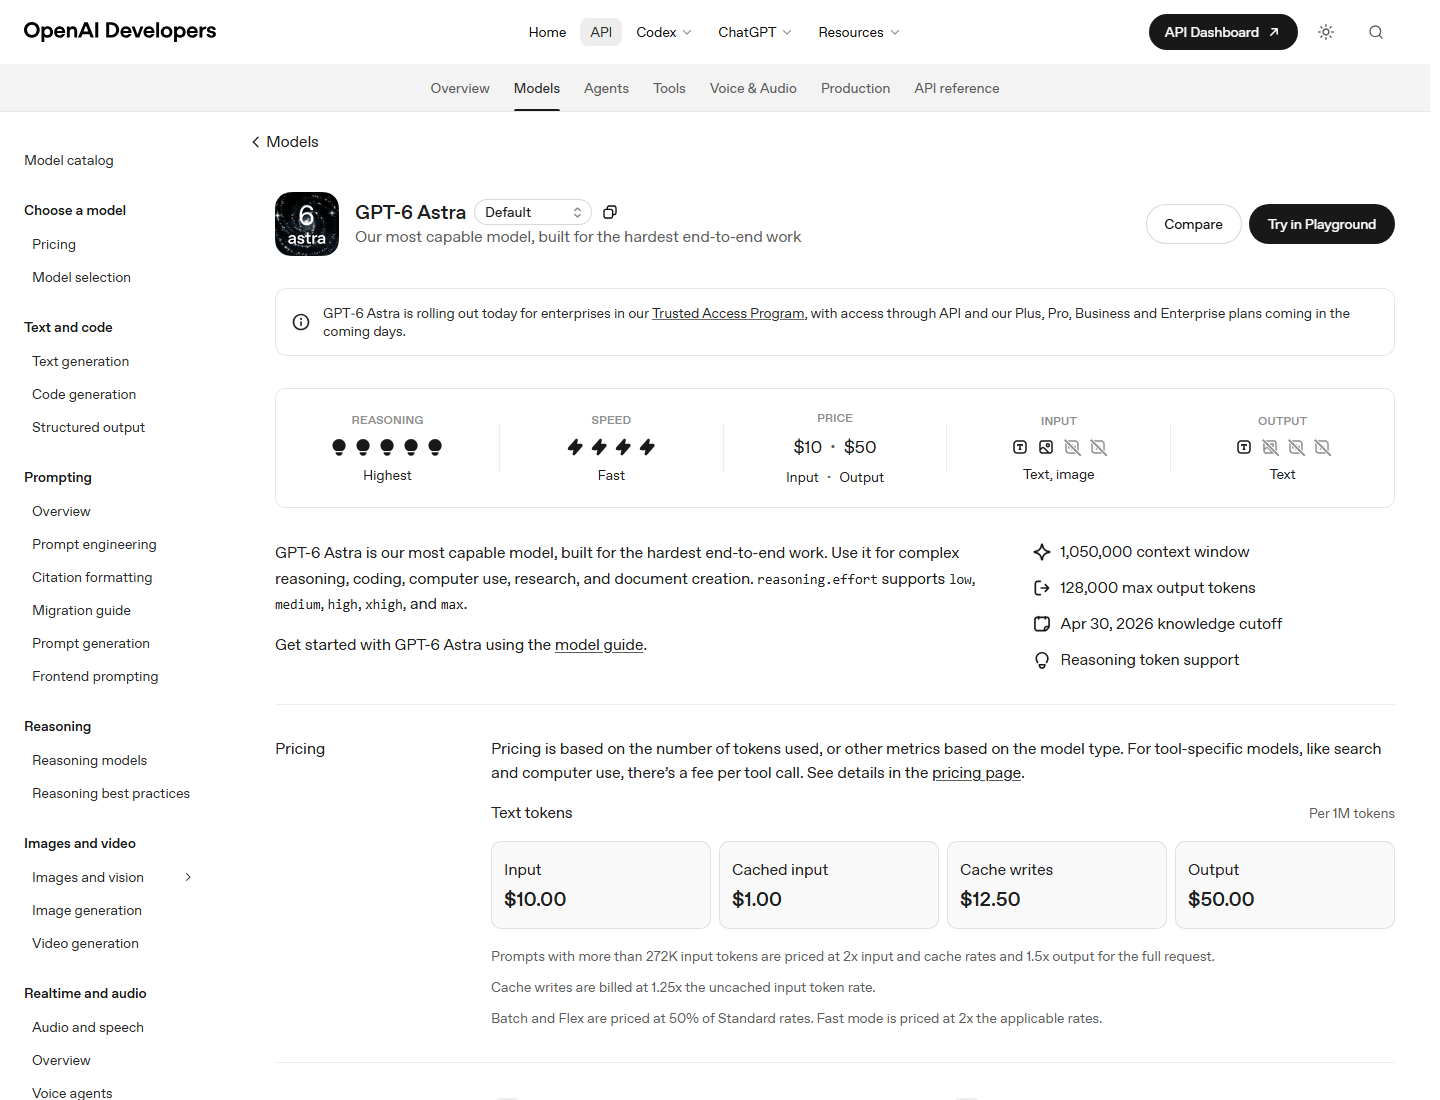
O GPT-6.1 Sol representa o valor padrão; o GPT-6 Astra representa o limite máximo de qualidade. Ambos apresentam a mesma janela de contexto de 1.050.000 tokens, o mesmo limite de saída de 128.000 tokens, entrada multimodal e um amplo conjunto de ferramentas. A diferença decisiva está no posicionamento e no preço: o Sol custa $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, enquanto o Astra custa $10 e $50. Em outras palavras, o Astra precisa gerar valor agregado suficiente para justificar um custo cinco vezes maior em tokens Standard.
Isso não significa que o Sol seja “o mesmo modelo por um preço menor”. A OpenAI considera o Astra seu modelo mais capaz para os trabalhos mais exigentes de ponta a ponta e descreve o Sol como tendo desempenho próximo ao do Astra para trabalhos complexos, a um custo menor. A decisão certa é, portanto, uma questão de avaliação, e não um exercício de classificação de marcas. Esta comparação utiliza os dados atuais Documentação do GPT-6.1 Sol, o Página do modelo GPT-6 Astra, e cenários de custo idênticos verificados em 9 de outubro de 2026.
GPT-6.1 Sol x GPT-6 Astra: comparação rápida
A tabela facilita a primeira decisão: se você ainda não tiver evidências específicas para a tarefa, o Sol merece ser testado primeiro, pois preserva as principais características de interface e capacidade, ao mesmo tempo em que reduz drasticamente o custo dos tokens. O Astra se torna a escolha racional quando o trabalho é excepcionalmente difícil, o risco de uma resposta errada é grande ou quando seu resultado mais robusto evita várias rodadas de revisão por parte de humanos ou do modelo.
Isso é diferente de comparar o Sol com um modelo pequeno e veloz. As orientações atuais da família OpenAI colocam o Sol entre os melhores, e não na faixa mais econômica. Os leitores que estiverem decidindo entre toda a linha também podem usar nosso guia dos melhores modelos de IA e o Análise do GPT-6 Luna para saber quando um modelo mais leve já é suficiente.
O que o GPT-6.1 Sol e o GPT-6 Astra têm em comum
As duas páginas oficiais dos modelos apresentam a mesma janela de contexto, entrada máxima, saída máxima e limite de conhecimento. Ambos aceitam texto e imagens e geram texto. Nenhuma delas lista áudio ou vídeo como entrada ou saída nativa do modelo. Elas também compartilham os níveis de esforço de raciocínio baixo, médio, alto, xalto e máximo, sendo o médio o padrão. Essa simetria simplifica os testes A/B, pois um aplicativo pode manter a maioria dos parâmetros de solicitação constantes, alterando apenas o ID do modelo.
Ambos os modelos oferecem suporte a saídas estruturadas, chamada de funções, pesquisa na web, pesquisa de arquivos, geração de imagens, interpretador de código, shell hospedado, aplicação de patch, uso do computador, MCP, habilidades e pesquisa de ferramentas. O OpenAI lista a chamada de ferramentas por meio da API de Respostas; o recurso “Chat Completions” está disponível quando não há ferramentas envolvidas. O ajuste fino não é suportado em nenhuma das páginas dos modelos. Trata-se de declarações de capacidade, e não de promessas de que os dois modelos escolherão ferramentas com precisão idêntica.
Uma janela de contexto de um milhão de tokens é uma capacidade, não uma permissão para ignorar o projeto de recuperação. Solicitações muito longas são mais caras, mais difíceis de depurar e estão sujeitas ao aumento de preço acima de 272 mil tokens de entrada. O particionamento, a recuperação, os resumos e o armazenamento em cache de prompts continuam sendo importantes. O mesmo aviso se aplica ao limite máximo de 128 mil tokens de saída: artefatos menores e verificáveis costumam ser mais seguros do que uma única resposta volumosa.
Preços: O abismo de cinco vezes
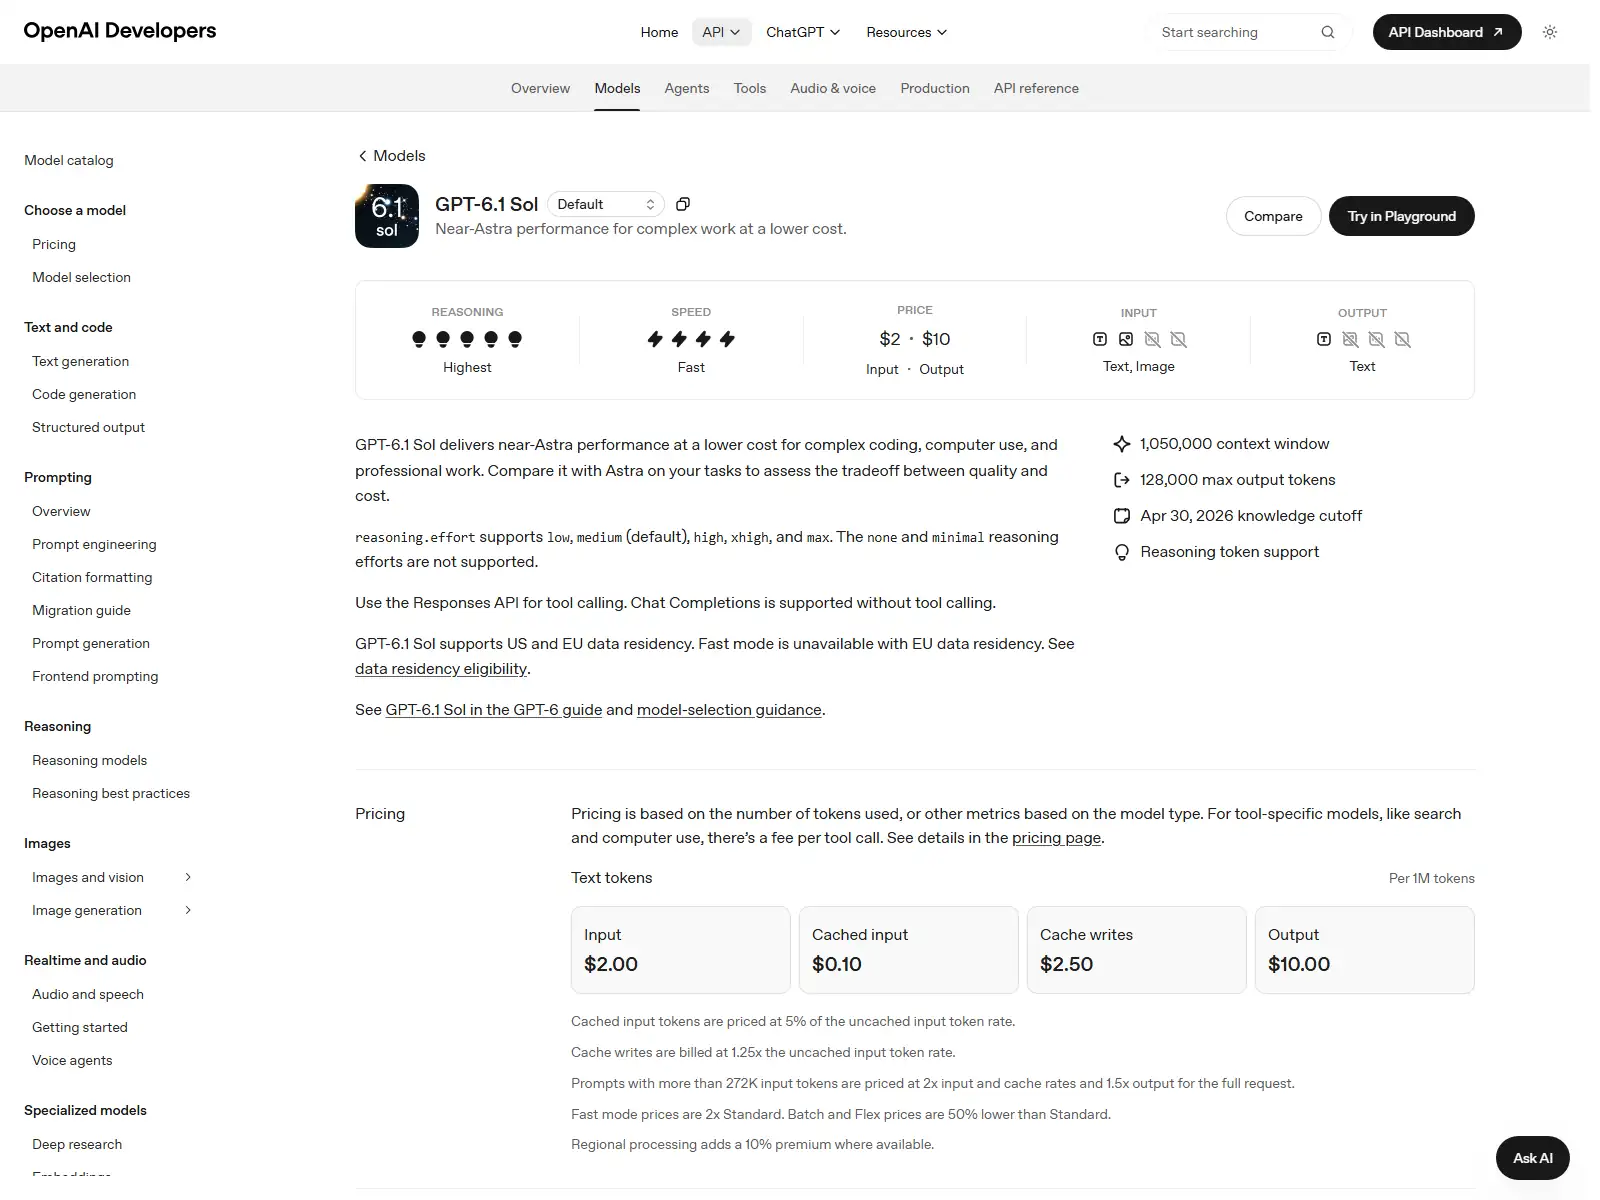
De acordo com as tarifas padrão, o GPT-6.1 Sol custa $2 por milhão de tokens de entrada não armazenados em cache, $0,10 para entradas armazenadas em cache, $2,50 para gravações em cache e $10 para saídas. O GPT-6 Astra custa $10, $1, $12,50 e $50, respectivamente. O Sol é cinco vezes mais barato para entradas não armazenadas em cache, gravações em cache e saídas; as entradas armazenadas em cache são dez vezes mais baratas. Os números atuais vêm diretamente das páginas do modelo do OpenAI e Documentação sobre preços da API.
A taxa de referência não representa o custo total. Quando uma solicitação ultrapassa 272 mil tokens de entrada, o plano OpenAI aplica o dobro das taxas normais de entrada e de cache e 1,5 vez a taxa normal de saída à solicitação completa. Os planos Batch e Flex têm preço de 50% do plano Standard, enquanto o plano Fast custa o dobro da tarifa aplicável. O Astra também oferece um plano Ultrafast. Compare o que é comparável: uma solicitação Sol Batch e uma solicitação Astra Fast não revelam a relação modelo-preço subjacente.
Para uma análise mais detalhada da categoria “flagship”, consulte nosso Guia de preços do GPT-6 Astra. O anterior Análise de preços do GPT-6 Sol É útil ao planejar uma migração da geração anterior do Sol, mas as estimativas de produção devem utilizar o ID exato do modelo atual e as taxas atuais.
Design de longo prazo: mesma capacidade, dinâmica econômica diferente
A janela de contexto idêntica de 1.050.000 tokens pode fazer com que o Sol e o Astra pareçam intercambiáveis para trabalhos com grande volume de documentos, mas a capacidade é apenas a primeira restrição. Uma consulta próxima ao limite ainda precisa localizar a evidência correta, distinguir instruções de material citado, preservar as relações entre vários arquivos e retornar um resultado que uma pessoa ou um programa possa verificar. O modelo com o nome mais pomposo não elimina a necessidade de uma arquitetura de informação. Organize as fontes, identifique os limites e solicite citações que remetam a identificadores estáveis de documentos.
A taxa mais baixa do Sol torna economicamente viáveis os experimentos de contexto longo. Uma equipe pode testar várias estratégias de agrupamento, limites de recuperação e formatos de resumo pelo custo de uma única execução do Astra. Essa busca mais ampla pode aprimorar o sistema, mesmo que o Astra tenha melhor desempenho em um único prompt. O Astra se torna mais atraente depois que o fluxo de trabalho se estabiliza e os erros não resolvidos são genuinamente limitados pelo modelo. No início do desenvolvimento, gastar todo o orçamento em algumas chamadas emblemáticas pode gerar menos aprendizado do que realizar uma avaliação disciplinada com o Sol em muitos casos representativos.
O limite de 272 mil merece um monitoramento específico. Uma solicitação com 271 mil tokens de entrada e outra com 273 mil têm tamanhos próximos, mas a segunda faz com que a solicitação inteira passe para a faixa de custo mais alta. Faça uma estimativa prévia do número de tokens e registre qual faixa cada tarefa utilizou. Se uma entrada estiver um pouco acima do limite, remover trechos repetitivos, histórico de conversas desatualizado ou passagens recuperadas de baixo valor pode reduzir significativamente o custo sem prejudicar a qualidade. Essa otimização se aplica a ambos os modelos, embora as taxas básicas mais altas do Astra tornem os erros mais caros.
O armazenamento em cache de prompts é mais útil quando um prefixo extenso permanece estável entre as chamadas. Exemplos incluem manuais de políticas, padrões de codificação, um catálogo de produtos ou um esquema de ferramentas compartilhado por muitas tarefas. Coloque o conteúdo estável em primeiro lugar e as instruções variáveis em segundo, quando o comportamento de cache da API permitir esse layout. Em seguida, avalie os acertos no cache, em vez de simplesmente presumí-los. A vantagem da entrada em cache do Sol é especialmente grande, mas um prefixo em constante mudança pode anulá-la. O projeto do cache deve constar no relatório de benchmark, juntamente com a precisão e a latência.
Para pesquisa e análise de documentos, utilize um fluxo de trabalho em etapas: recupere evidências prováveis, solicite ao modelo um mapa estruturado de evidências, valide as citações e, somente então, solicite a síntese. Utilize o Astra quando a síntese continuar fraca mesmo após o fluxo de evidências estar sólido, ou quando o conjunto de fontes contiver contradições excepcionalmente sutis. Isso separa as falhas de recuperação das falhas de raciocínio. Sem essa separação, as equipes muitas vezes acabam investindo em um modelo mais avançado para compensar um problema evitável de construção de contexto.
Codificação e uso de ferramentas
No que diz respeito à programação, a questão relevante não é “qual modelo é capaz de escrever código?”. Ambos são capazes. A questão é em que aspectos a capacidade adicional do Astra altera o resultado. O Sol é atraente para tarefas comuns em repositórios: implementar funcionalidades com escopo definido, diagnosticar bugs reproduzíveis, revisar pull requests, escrever testes, transformar dados e executar ciclos iterativos de ferramentas. Sua taxa mais baixa permite mais tentativas, mais verificações e conjuntos de avaliação maiores com o mesmo orçamento.
É melhor reservar o Astra para tarefas em que a ambiguidade e a coordenação são predominantes: uma migração para um monorepo desconhecido, uma revisão de arquitetura com questões de segurança, o uso de computadores em um horizonte de longo prazo, uma portabilidade entre linguagens complexa ou um incidente em produção com evidências incompletas. O modelo mais avançado pode valer o seu preço quando um plano correto evita horas de retrabalho. Nosso melhor modelo de IA para comparação de códigos explica por que os testes do repositório são mais importantes do que impressões genéricas sobre a programação.
- Recursos definidos com escopo e testes de aceitação claros
- Depuração de rotina e revisão de código
- Loops de agentes de alto volume
- Rascunhos de migrações e refatorações
- Geração e documentação de testes
- Falhas graves após uma tentativa do Sol
- Alterações de alto risco relacionadas à segurança ou aos dados
- Arquitetura ambígua entre sistemas
- Tarefas prolongadas de uso autônomo do computador
- Revisão final quando os erros custam caro
Não avalie nenhum dos modelos com base em um código que apenas pareça plausível. Forneça a ambos o mesmo instantâneo do repositório, as mesmas instruções, ferramentas, tempo disponível e testes. Registre a taxa de aprovação, as correções feitas por humanos, as falhas nas chamadas de ferramentas, os tokens, a latência e o custo. Um modelo que custa cinco vezes mais, mas reduz pela metade o número de tentativas malsucedidas, pode ser justificado; um modelo que melhora o estilo sem melhorar a aceitação, não.
Evidências de desempenho: o que podemos e o que não podemos concluir
O posicionamento do OpenAI oferece o resumo mais sólido e defensável: o Astra é o modelo mais capaz para as tarefas de ponta a ponta mais complexas, enquanto o GPT-6.1 Sol busca um desempenho próximo ao do Astra em tarefas complexas, a um custo menor. Essas afirmações sustentam uma hipótese de seleção, e não uma diferença percentual universal. Nenhum benchmark público isolado é capaz de prever o desempenho em seus documentos, ferramentas, políticas ou código-fonte proprietários.
Os vídeos de lançamento são valiosos para entender como uma empresa apresenta um produto, mas não constituem avaliações independentes. Da mesma forma, as análises de criadores mostram interfaces reais e exemplos úteis, mas cada análise reflete um conjunto específico de instruções, uma configuração de ferramentas e um prazo de publicação. Considere uma miniatura atraente ou um veredicto inicial positivo como uma pista para seu próprio plano de testes, e não como prova de que o Astra ou o Sol vencem em todas as categorias.
O vídeo oficial do OpenAI acima documenta a cobertura do lançamento do Astra. A página independente de Matt Wolfe, abaixo, mostra que a atenção do público em geral rapidamente se concentrou na magnitude do lançamento. Nenhuma das capturas de tela é usada aqui como referência numérica. O artigo evita intencionalmente converter entusiasmo, visualizações ou o título de um criador em uma pontuação de desempenho sem fundamento.
Uma comparação válida utiliza um conjunto de avaliação privado que se assemelhe ao ambiente de produção. Inclua tarefas fáceis, tarefas típicas e casos de falha que acarretem alto custo. Ocultem os resultados quando a preferência humana for relevante. Para os agentes, testem a conclusão e a recuperação, em vez da primeira resposta. OpenAI’s orientações para a seleção de modelos da mesma forma, recomenda-se comparar modelos em tarefas idênticas e optar pelo modelo mais leve e pelo esforço de raciocínio que atinja o padrão de qualidade exigido.
Como realizar uma avaliação imparcial entre Sol e Astra
Comece definindo a decisão que a avaliação irá tomar. “Qual modelo é mais inteligente?” é uma pergunta muito vaga. Uma pergunta útil seria: “Qual modelo deve lidar com as revisões de pull requests para este repositório em nível médio de raciocínio?” ou “A síntese final do contrato deve ser transferida do Sol para o Astra?” Defina a família de tarefas, o nível de serviço, o esforço de raciocínio, as ferramentas, o prazo e os critérios de aceitação antes de gerar resultados. Caso contrário, um resultado favorável poderá ser explicado pela configuração, e não pelo modelo.
Crie um conjunto grande o suficiente para abranger casos comuns e casos extremos significativos. Vinte exemplos cuidadosamente selecionados podem revelar falhas óbvias, mas uma política de roteamento em produção geralmente precisa de mais. Selecione exemplos de trabalhos reais recentes após remover dados confidenciais e, em seguida, classifique cada caso por dificuldade e risco. Mantenha um conjunto de teste isolado e protegido para que o ajuste do prompt não acabe, gradualmente, se adaptando excessivamente aos exemplos que todos já viram. Controle as versões do conjunto de dados e do avaliador da mesma forma que você controla as versões do código do aplicativo.
Prefira verificações determinísticas sempre que a tarefa permitir. Compile o código, execute testes, valide JSON em relação a um esquema, compare campos extraídos com rótulos e verifique passagens citadas. Os avaliadores humanos devem se concentrar em qualidades que a automação não consegue captar bem, como clareza, discernimento e se uma recomendação respeita o contexto de negócios. Ocultem a identidade do modelo e randomizem a ordem dos resultados. Se os avaliadores souberem qual resposta veio do Astra, o preço e a reputação podem influenciar a pontuação sem que haja intenção de parcialidade por parte de ninguém.
Acompanhe a gravidade, não apenas as médias. Dez vantagens menores de estilo não devem superar uma recomendação crítica relacionada à perda de dados. Defina vetos rígidos, como citações inventadas, comandos inseguros, campos obrigatórios ausentes ou descumprimento de uma restrição legal. Relate a distribuição por categoria de dificuldade e risco. O Sol pode empatar com o Astra no trabalho normal e ficar atrás apenas nos 5% mais difíceis; esse resultado corrobora fortemente a escolha de um roteador em vez de uma migração do tipo “tudo ou nada”.
Por fim, calcule a incerteza e reexecute os casos instáveis. Os resultados do modelo podem variar; portanto, uma comparação única exagera o fator sorte. Repita um subconjunto, investigue divergências entre os avaliadores e preserve os resultados brutos para fins de auditoria. A recomendação final deve indicar a data do teste, os IDs dos modelos, as configurações, a versão do conjunto de dados, os preços utilizados e as lacunas conhecidas. Reavalie-a após uma atualização do modelo, uma mudança no prompt ou uma alteração significativa na carga de trabalho. A escolha de um modelo é uma decisão de produção que requer manutenção, não um troféu permanente.
Não permita que o avaliador se torne o modelo decisório oculto. Se um juiz automatizado demonstrar forte preferência por um resultado, selecione essas decisões para análise por especialistas e compare o juiz com resultados concretos de aceitação. Separe a qualidade da apresentação da correção da tarefa: uma explicação bem elaborada pode ocultar um requisito não atendido, enquanto uma resposta sucinta pode ser aprovada em todos os testes. Relate também as abstenções e os empates, em vez de forçar a escolha de um vencedor. Esses detalhes tornam o resultado menos dramático, mas muito mais útil para o orçamento e o encaminhamento. O objetivo é uma regra operacional repetível que outro membro da equipe possa inspecionar e reproduzir. Registre também os resultados rejeitados; exemplos de falhas costumam explicar os limites do encaminhamento com mais clareza do que uma tabela de notas médias.
Exemplos de custo real
Considere uma execução do agente de codificação com 200.000 tokens de entrada não armazenados em cache e 20.000 tokens de saída. O Sol custa cerca de $0,60: $0,40 para a entrada e $0,20 para a saída. O Astra custa cerca de $3,00: $2,00 mais $1,00. Em 10.000 execuções, a diferença é de aproximadamente $24.000 antes das taxas de ferramentas, armazenamento em cache, aumentos regionais ou ajustes de nível de serviço.
Agora, considere uma solicitação de contexto longo com 300.000 tokens de entrada e 30.000 tokens de saída. Como a entrada ultrapassa 272 mil, as taxas mais altas se aplicam à solicitação inteira. A taxa efetiva de entrada do Sol passa a ser $4 por milhão e a de saída, $15, resultando em cerca de $1,65. No caso do Astra, a taxa de entrada passa a ser de $20 e a de saída, de $75, resultando em cerca de $8,25. A relação de cinco vezes permanece, mas a diferença absoluta aumenta.
O armazenamento em cache pode deslocar o cálculo ainda mais em direção ao Sol, pois sua taxa de entrada em cache é um décimo da do Astra. Isso é importante para instruções estáveis do sistema, referências repetidas em grande volume e estruturação de agentes. No entanto, as gravações no cache ainda têm um custo, e alterar o prefixo pode reduzir a reutilização. Faça uma estimativa com base em registros reais de uso, em vez de presumir que todos os tokens receberão a taxa de cache.
Como comparar os modelos na API
Utilize a API de Respostas para aplicativos que utilizam ferramentas e mantenha a configuração de comparação idêntica. O ambiente de teste mais simples e útil envia a mesma entrada para ambos os IDs de modelo, registra os metadados da resposta e executa o mesmo avaliador. Não exponha chaves de API no código-fonte; utilize uma variável de ambiente e seu gerenciador de segredos habitual.
A amostra é deliberadamente pequena. Um ambiente de produção deve armazenar os IDs das solicitações, as versões do avaliador, os commits do repositório, os rastros das ferramentas, o número de tentativas e os resultados da aceitação. Também deve calcular o preço com base no nível de serviço e na faixa de contexto longo efetivamente utilizados. Evite que um modelo tenha acesso a feedback que o outro não tenha recebido, a menos que você esteja testando explicitamente uma sequência de roteamento.
Uma estratégia prática de roteamento do Sol para o Astra
Um roteador de duas etapas identifica o argumento econômico mais forte a favor do Sol, sem fingir que todas as solicitações são iguais. Envie o tráfego normal para o Sol com um nível médio de raciocínio. Escale quando testes determinísticos falharem, o modelo indicar baixa confiança, a tarefa se enquadrar em uma categoria de alto risco ou um humano solicitar explicitamente uma revisão por especialistas. Mantenha as regras de escalonamento transparentes para que os custos não aumentem silenciosamente.
Use o mesmo prompt, as mesmas ferramentas e os mesmos testes de aceitação.
Testes, confiança, classe de risco e análise humana.
Envie os casos de falha ou trabalhos de alto risco para a Astra.
Acompanhe a aceitação, o retrabalho, a latência e o custo total.
O direcionamento também oferece às equipes uma maneira controlada de atualizar os padrões. Se a taxa de aceitação do Sol melhorar em uma família de tarefas, amplie sua participação. Se o Astra evitar repetidamente defeitos onerosos, direcione essa categoria diretamente. A comparação passa a ser uma política operacional respaldada por dados, em vez de um debate pontual sobre modelos. Para uma referência de geração anterior, consulte GPT-6 Astra x GPT-5.6 Sol.
A latência e a confiabilidade devem fazer parte da mesma política de roteamento. Um modelo pode produzir uma resposta mais robusta, mas ainda assim ser a opção padrão incorreta se seu tempo de resposta prejudicar um fluxo de trabalho interativo ou se seu raciocínio mais demorado causar tempo limite de espera nas tarefas. Meça a latência do primeiro token, a duração total, a recuperação após chamadas de ferramentas e a conclusão bem-sucedida em condições realistas de concorrência. Em seguida, defina um objetivo de serviço para cada classe de tarefa. O Sol pode ser responsável pelo tráfego de produção sensível ao tempo, enquanto o Astra lida com a revisão assíncrona; ou o contrário pode ser justificado se uma tarefa difícil falhar rotineiramente antes da escalação. A decisão do modelo é operacional, não meramente editorial.
Quem deve escolher o Sol e quem deve escolher a Astra?
Escolha o GPT-6.1 Sol para uma produção com foco nos custos
O Sol é ideal para equipes de produto, agências, pesquisadores e desenvolvedores que lidam com volumes substanciais de trabalho complexo, mas que ainda assim possuem critérios de aceitação mensuráveis. É especialmente atraente quando a iteração faz parte do processo: ciclos de codificação-teste-correção, revisão de documentos, extração com validação, síntese de pesquisas e agentes internos com várias etapas. Seu preço mais baixo permite maior cobertura de avaliação e mais recursos para novas tentativas.
Escolha o GPT-6 Astra para os trabalhos mais exigentes e que exigem alta qualidade
O Astra é ideal para equipes cujas tarefas mais complexas envolvem altos custos de erro ou verificações automatizadas insuficientes. Uma decisão arquitetônica difícil, uma revisão final de segurança, uma tarefa de raciocínio científico inovadora ou uma longa sequência de uso do computador podem justificar o investimento no modelo principal. Ele também é a opção padrão mais adequada durante a fase inicial de descoberta, quando a equipe ainda não sabe o que um modelo menor deixa de detectar e o custo não é uma restrição imediata.
Use os dois quando a dificuldade da tarefa variar
A maioria dos sistemas maduros não deve impor um único modelo a todas as solicitações. Utilize o Sol para a ampla faixa intermediária e o Astra como camada de escalonamento. Adicione o Luna ou outro modelo menor para classificação e transformação previsíveis. Esse projeto em camadas reflete a diversidade real da carga de trabalho e costuma ser mais econômico do que tentar definir um único vencedor definitivo. Nosso metodologia de teste de modelos oferece uma estrutura útil para distinguir evidências repetíveis de meras impressões.
Como usar o GPT-6.1 Sol e o GPT-6 Astra no GlobalGPT
O GlobalGPT oferece rotas de produto em tempo real para ambos os modelos dentro de um único espaço de trabalho multimodelo. Abra o espaço de trabalho, inicie uma nova conversa e verifique o seletor de modelos atual para o GPT-6.1 Sol ou o GPT-6 Astra. Manter os dois modelos em uma única interface é útil para trabalhos exploratórios comparativos, enquanto a avaliação por API continua sendo a melhor opção para pontuação automatizada, captura exata do uso e controles de implantação.
Comece com o Sol na primeira tentativa; depois, execute novamente a solicitação mais difícil com o Astra e compare o que mudou de forma significativa.
Abrir GlobalGPTPara obter mais informações específicas sobre o modelo, leia nosso Guia explicativo do GPT-6.1 Sol e Análise do GPT-6 Astra. Essas páginas abordam cada modelo individualmente; esta página se concentra na decisão de compra e na escolha entre eles.
Perguntas frequentes
O GPT-6.1 Sol é melhor que o GPT-6 Astra?
Não em termos absolutos. A OpenAI posiciona o GPT-6 Astra como seu modelo mais avançado e o GPT-6.1 Sol como um modelo de custo mais baixo, com desempenho próximo ao do Astra para tarefas complexas. O Sol é a opção com melhor custo-benefício quando atende aos seus padrões de qualidade; o Astra é a escolha mais segura, que prioriza a qualidade, para as tarefas mais difíceis.
Quanto mais barato é o GPT-6.1 Sol em comparação com o GPT-6 Astra?
Nas tarifas padrão, o Sol custa $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, enquanto o Astra custa $10 e $50. O Sol é, portanto, cinco vezes mais barato para entradas e saídas sem cache. Seu preço de $0,10 para entradas com cache é um décimo da taxa de $1 do Astra.
O GPT-6.1 Sol e o GPT-6 Astra têm a mesma janela de contexto?
Sim. O OpenAI especifica uma janela de contexto de 1.050.000 tokens, entrada máxima de 922.000 e saída máxima de 128.000 para ambos os modelos. Solicitações com mais de 272 mil tokens de entrada fazem com que a solicitação completa seja encaminhada para taxas de contexto longo mais elevadas.
Qual modelo é melhor para programação?
O Astra é a escolha ideal, com foco na qualidade, para tarefas de repositório excepcionalmente difíceis, ambíguas ou de alto risco. O Sol é a opção padrão mais prática para tarefas rotineiras de desenvolvimento de funcionalidades, depuração, revisões e loops de agentes, pois seu custo mais baixo permite um maior número de iterações. Execute ambos nos mesmos testes de repositório antes de padronizar.
Os dois modelos suportam ferramentas e entrada de imagens?
Sim. As páginas oficiais dos modelos listam entrada de texto e imagens, saída de texto, saídas estruturadas, chamada de funções, pesquisa na web, pesquisa de arquivos, interpretador de código, shell hospedado, aplicação de patch, uso do computador, MCP, habilidades e pesquisa de ferramentas. A chamada de ferramentas deve utilizar a API de Respostas.
Quando devo pagar pelo GPT-6 Astra?
Utilize o Astra quando um erro acarretar custos elevados, quando a tarefa for genuinamente de ponta ou quando uma avaliação comparativa demonstrar que sua qualidade superior reduz o retrabalho o suficiente para justificar um custo cinco vezes maior do que o preço do token. Exemplos incluem migrações críticas, uso complexo de computadores autônomos e revisão final de entregas de alto risco.
Qual exercício de raciocínio devo escolher?
Comece no nível médio, que é o padrão documentado para ambos os modelos. Reduza o nível para transformações simples e aumente-o apenas quando a dificuldade da tarefa ou o custo do erro assim o exigirem. A configuração eficiente é aquela que, com o mínimo de esforço, passa consistentemente nos seus testes de aceitação.
Posso usar o GPT-6.1 Sol e o GPT-6 Astra no GlobalGPT?
O GlobalGPT oferece rotas ativas tanto para o GPT-6.1 Sol quanto para o GPT-6 Astra em seu espaço de trabalho multimodelo. A disponibilidade pode variar de acordo com a conta e a interface; portanto, abra o espaço de trabalho e verifique o seletor de modelos atual antes de iniciar um fluxo de trabalho de produção.
Devo direcionar todas as solicitações para um único modelo?
Normalmente, não. Um roteador simples pode encaminhar tarefas comuns para o Sol e encaminhar casos de baixa confiança, que falharam nos testes ou de alto risco para o Astra. Isso aproveita a maior parte da vantagem de custo do Sol, reservando o Astra para situações em que a capacidade marginal tenha um valor mensurável.
Veredicto final
O GPT-6.1 Sol deve ser o primeiro modelo a ser avaliado pelas equipes mais preocupadas com os custos; o GPT-6 Astra deve continuar sendo a opção a ser considerada para as tarefas mais complexas. O contexto comum, o limite de produção, as modalidades, os controles de raciocínio e o catálogo de ferramentas tornam a comparação excepcionalmente clara. O Sol oferece a vantagem econômica. O Astra detém a vantagem oficial em termos de capacidade.
O indicador decisivo não é apenas o preço do token ou o prestígio do modelo. Avalie o custo por resultado aceito sob restrições operacionais e orçamentos reais. Se o Sol apresentar uma taxa de aprovação semelhante, é difícil ignorar suas taxas de entrada e saída sem cache, que são cinco vezes menores. Se o Astra evitar falhas, reduzir a necessidade de revisão por especialistas ou resolver tarefas que o Sol não consegue, o preço mais alto pode ser justificado. Comece com tarefas idênticas, mantenha a avaliação cega sempre que possível e promova apenas o modelo e o esforço de raciocínio que merecerem seu lugar.