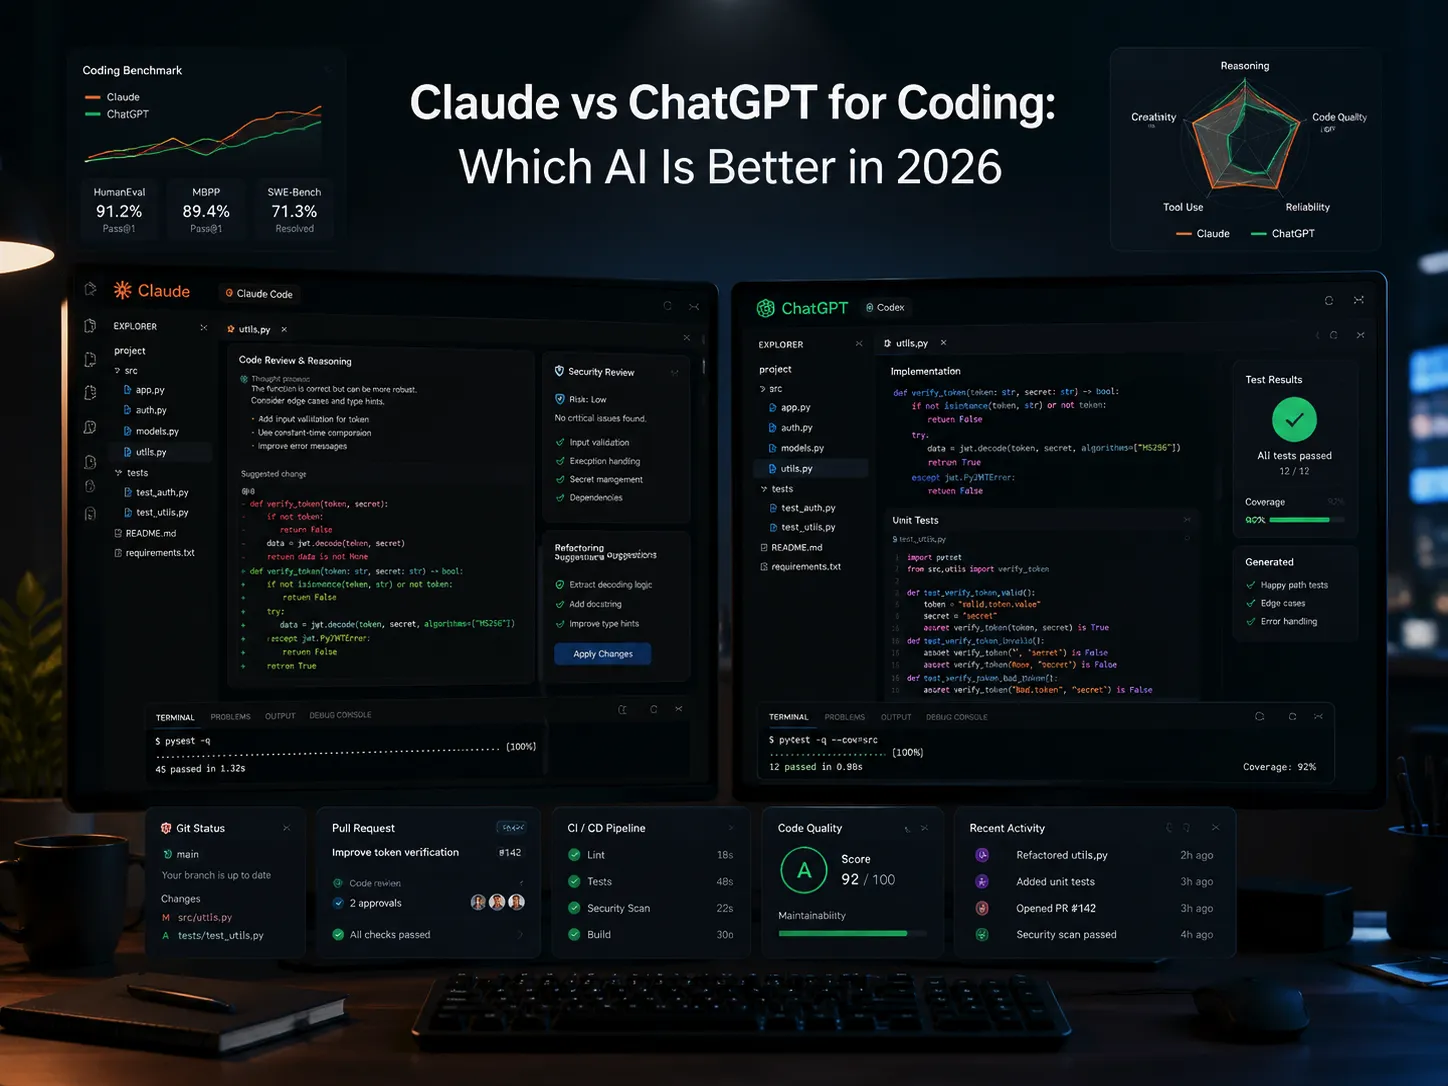
Bij onze tests op 7 juli 2026 bleek Claude Sonnet 5 de betere eerste doorloop te zijn voor codereview, analyse van de onderliggende oorzaak, architectuurplanning en redeneren in een brede context. GPT-5.5 was de betere eerste keuze wanneer je een volledig implementatieontwerp, een uitvoerbare testopzet of kant-en-klare voorbeelden nodig hebt. Voor werkzaamheden op repository-niveau kun je Claude Code vergelijken met Codex, in plaats van beide bedrijven alleen op basis van het chatvenster te beoordelen.
De nuttige indeling is niet simpelweg “Claude wint” of “ChatGPT wint”. Per 27 september 2026 bestaat het assortiment van Anthropic uit Claude Fable 5.1, Opus 5.5, Sonnet 5 en Haiku 4.5; de GPT-6-familie van OpenAI omvat Astra, Sol en Luna. Toegang tot de producten is van belang: Sol en Luna werden gelanceerd in ChatGPT Work, Codex en de API, waarbij in de aankondiging expliciet gewone Chat werd uitgesloten. De onderstaande praktijkgedeelten blijven een verouderde vergelijking tussen Claude Sonnet 5 en GPT-5.5, getest met dezelfde prompts op 7 juli 2026. Zie voor een actuele vergelijking Claude Opus 5.5 versus GPT-6 Sol.
Als je modellen wilt vergelijken zonder met verschillende abonnementen te moeten jongleren, is GlobalGPT een praktische werkruimte voor meerdere modellen met GPT-6 Astra en Claude Opus 5,5 beschikbaar in de modelkiezer. Het is handig voor het vergelijken van code-antwoorden, planning, schrijven en onderzoek, maar het is geen vervanging voor Claude Code, Codex, officiële API’s, een IDE of een ontwikkelingsworkflow die rekening houdt met repositories.

Inhoudsopgave
- Claude versus ChatGPT voor programmeren: kort antwoord
- Wat is er in 2026 veranderd?
- Huidig aanbod aan coderingsmodellen
- Overzicht van benchmarks: SWE-Bench, Terminal-Bench en wat ze betekenen
- Hoe we Claude en ChatGPT hebben getest op het gebied van programmeren
- Test 1: foutopsporing en analyse van de onderliggende oorzaak
- Test 2: refactoring en onderhoudbaarheid
- Test 3: redeneren en plannen met meerdere bestanden
- Test 4: unit-tests en verificatie
- Test 5: beoordeling van de beveiliging en betrouwbaarheid
- Claude Code en Codex: als chatten niet genoeg is
- Prijzen: Claude, ChatGPT, Codex en GlobalGPT
- Welke programmeeromgeving moet je kiezen?
- Waarom veel ontwikkelaars nog steeds beide gebruiken
- FAQ
Claude versus ChatGPT voor programmeren: kort antwoord
In onze chattests van 7 juli met dezelfde prompt bleek Claude Sonnet 5 de betere eerste poging te zijn wanneer het probleem dubbelzinnig was: het gaf prioriteit aan waarschijnlijke oorzaken, filterde ruis weg en legde het risico duidelijk uit. GPT-5.5 presteerde beter wanneer de volgende stap een vollediger implementatieontwerp betrof met imports, test-scaffolding en meer codedetails. Deze observaties hebben betrekking op die specifieke test, niet op elke toekomstige modelrelease.
Voor de dagelijkse ontwikkeling is de beste werkwijze meestal:
- Gebruik eerst Claude voor codebeoordeling, het indelen van bugs, architectuurbeslissingen en vragen als “Wat moet ik als eerste controleren?”.
- Gebruik eerst ChatGPT voor het genereren van een eerste implementatie, het schrijven van testskeletten, het opstellen van voorbeelden en het omzetten van een plan in code.
- Gebruik beide voor migraties, beveiligingsgevoelige wijzigingen, betalingen, authenticatie, het uploaden van bestanden en alles wat de productiegegevens kan beschadigen.
| Behoefte aan programmeerwerk | Betere eerste keuze | Waarom |
|---|---|---|
| Een lastige bug opsporen | Claude eerst | In onze test gaf Claude voorrang aan de waarschijnlijke oorzaak en legde het het storingsverloop duidelijk uit. |
| Een volledig implementatievoorstel opstellen | ChatGPT eerst | In onze test leverde GPT-5.5 uitgebreidere code en meer kant-en-klare scaffolding. |
| Beoordeling van veiligheids- of betrouwbaarheidsrisico’s | Eerst Claude, daarna ChatGPT | Claude heeft de ernstgraad duidelijk ingedeeld; ChatGPT heeft concrete implementatiepatronen toegevoegd. |
| Bestanden in een repository wijzigen | Claude-code of Codex | De context van de repo, het uitvoeren van commando’s, tests en diffs zijn belangrijker dan een antwoord dat alleen uit een chat bestaat. |
Als je je vooral afvraagt welke modelfamilie over het algemeen het meest geschikt is voor het programmeren, dan is de bredere beste AI-model voor codering Deze vergelijking is een nuttige aanvulling om te lezen. Als je keuze voornamelijk binnen het OpenAI-ecosysteem ligt, vind je in de gids ‘Het beste ChatGPT-model voor codering’ meer informatie over de keuze van een GPT-model.
Wat is er in 2026 veranderd?
Bij een zinvolle vergelijking met 2026 moet rekening worden gehouden met drie verschuivingen.
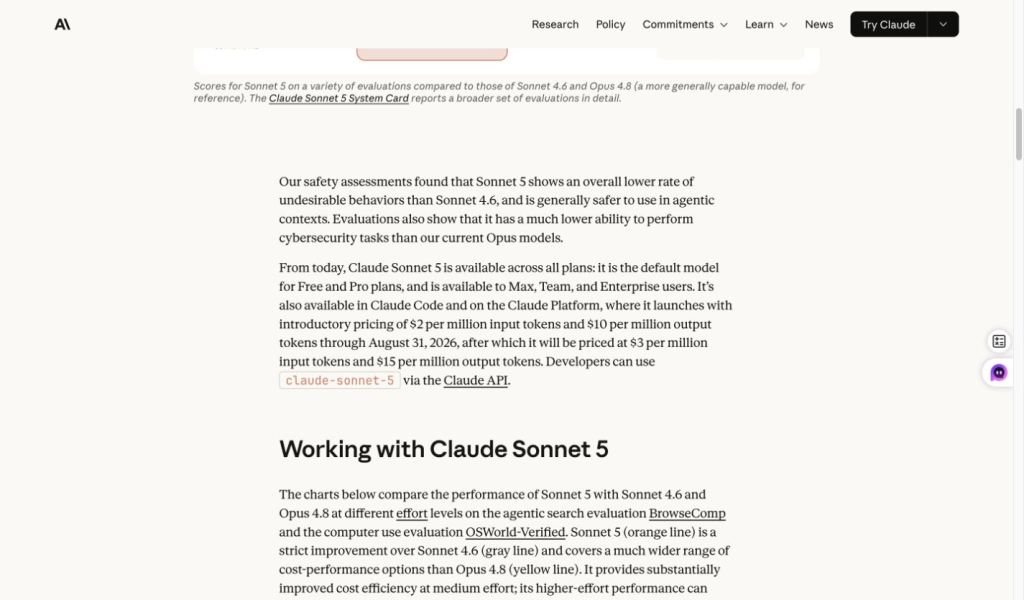
Ten eerste heeft Claude Sonnet 5 de stand van zaken aan de kant van Claude veranderd. Anthropic beschrijft Sonnet 5 als beschikbaar in alle abonnementen en in de Claude-code, met toegang tot het Claude-platform voor ontwikkelaars. Dat is van belang omdat Claude niet langer alleen een chatassistent is voor uitleg over coderen; het maakt deel uit van de workflow van de codeeragent van Anthropic.
Ten tweede is GPT-6 nu de huidige modelfamilie van OpenAI voor programmeerwerk. Astra richt zich op complexe softwareontwikkeling; Sol en Luna bieden goedkopere opties. Aankondiging van de release van OpenAI op 22 september vermeldt Sol en Luna in ChatGPT Work en Codex voor de Plus-, Pro-, Business-, Enterprise- en Edu-versies, waarbij Luna ook beschikbaar is voor Free- en Go-gebruikers in de desktop-app. Er wordt expliciet vermeld dat deze modellen nog niet beschikbaar zijn in Chat. Toegang tot de API wordt apart in rekening gebracht.
Ten derde nemen chatassistenten en programmeeragenten verschillende onderdelen van het werk voor hun rekening. Gewone chat is handig voor korte stukjes code, foutopsporing, uitleg en planning. Claude-code en Codex Dit zijn repo-bewuste workflows die zijn ontworpen om bestanden te controleren, opdrachten uit te voeren, wijzigingen te testen en grotere taken uit te voeren. Bij een eerlijke vergelijking wordt de kwaliteit van de chatuitvoer losgekoppeld van de mogelijkheden van het product ‘coding-agent’.
Huidig aanbod aan coderingsmodellen
Vanaf 27 september 2026 gaat het bij de codevergelijking om een beslissing over de opstelling en niet langer om een rechtstreekse vergelijking tussen Claude en ChatGPT:
| Zijde | Actuele modellen om in overweging te nemen | Het beste gebruik van codering |
|---|---|---|
| Claude | Claude Fable 5,1, Claude Opus 5,5, Claude Sonnet 5 en Claude Haiku 4,5 | Beoordeling met een brede context, planning, foutopsporing, agentische codering en Claude-code-workflows. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol en GPT-6 Luna; de beschikbaarheid verschilt tussen ChatGPT Work, Chat, Codex en API | Implementatie, frontend-werkzaamheden, tests, workflows met behulp van tools en Codex-taken. |
| GlobalGPT | GPT-6 Astra en Claude Opus 5.5, geverifieerd in GlobalGPT; dit is een afzonderlijk platformabonnement | Een directe vergelijking van prompts, alledaagse vragen over code, onderzoek en evaluatie van aanpakken. |
Als u de toegangsgegevens en de details van de reis van Claude bijhoudt, raadpleeg dan het aparte Claude AI-plannen voor 2026 gids en de uitgebreidere Claude AI-prijsgids. Als je OpenAI-abonnementen met elkaar vergelijkt, is het overzicht van de ChatGPT-abonnementen voor 2026 het duidelijkere aanvullende document.
Overzicht van benchmarks: SWE-Bench, Terminal-Bench en wat ze betekenen
Benchmarks zijn nuttig omdat ze laten zien hoe modellen zich gedragen bij gecontroleerde codeertaken. Het is van cruciaal belang om bij elke benchmark goed te kijken naar wat er daadwerkelijk wordt gemeten. Een benchmark op basis van een repository-issue, een benchmark met een terminal-agent en een officiële tabel bij de lancering van een model geven niet dezelfde informatie weer; daarom moeten ze in combinatie met de onderstaande praktische tests worden gebruikt.
GPT-5.5: Codering op basis van de testdatum
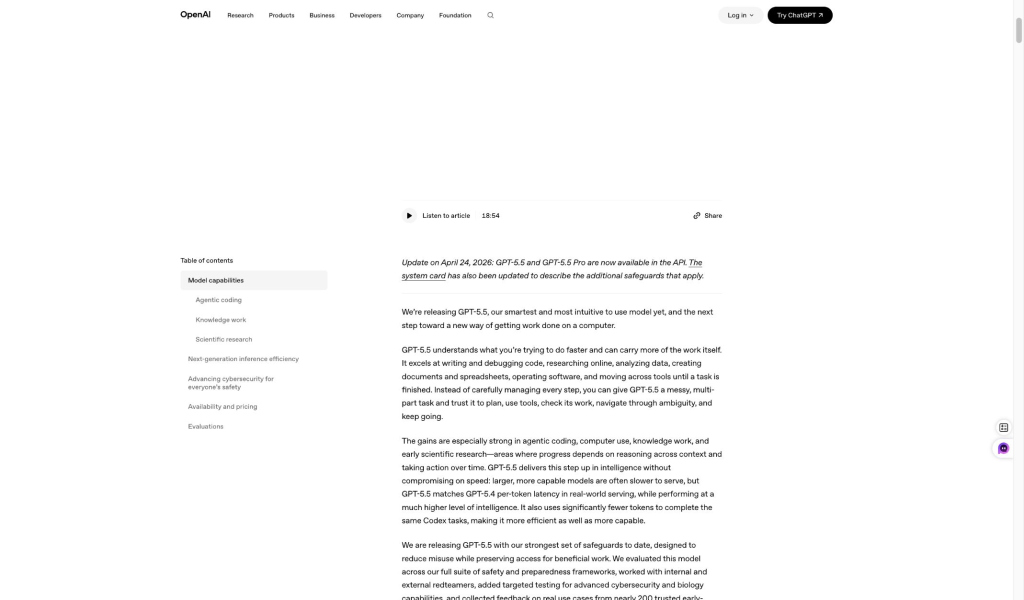
De onderstaande informatie over het GPT-5.5-materiaal is behouden omdat deze overeenkomt met het model dat werd gebruikt in de praktische vergelijking van 7 juli. Het ondersteunt de op de implementatie gerichte observaties van de testafdeling, maar het mag niet worden opgevat als de huidige OpenAI-modelreeks; GPT-6 is nu de actieve familie, waarbij de toegang varieert tussen ChatGPT Work, gewone Chat, Codex en de API.
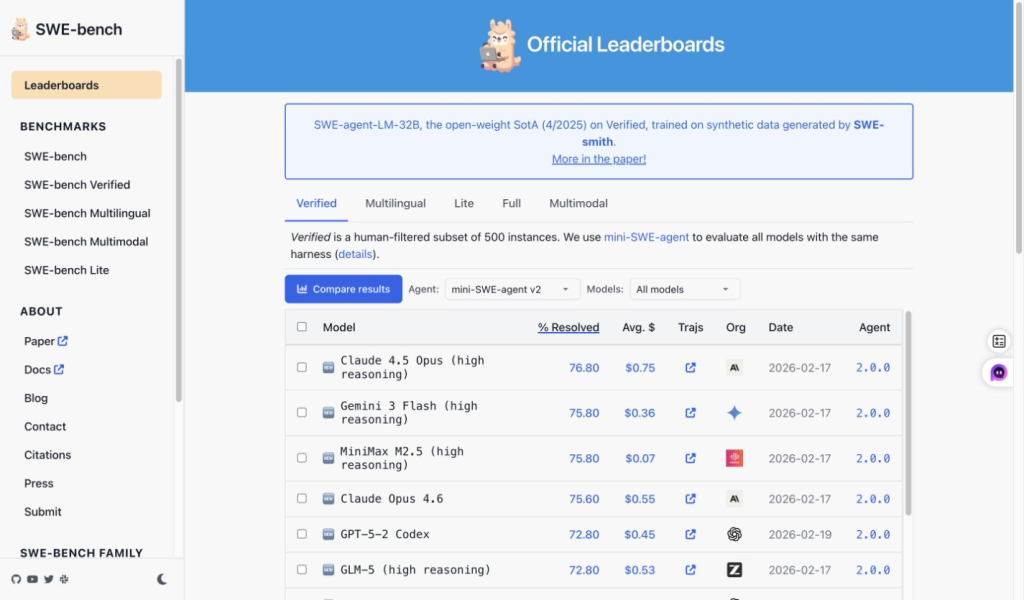
SWE-Bench: oplossing van een probleem in de repository
SWE-Bench is nuttig omdat het dichter bij echt softwareonderhoud staat dan een korte prompt met een codefragment. Het kijkt naar issues in de repository en of een model wijzigingen kan genereren die de taak oplossen. Wat betreft de vergelijking tussen Claude en ChatGPT zegt dit iets over de kracht op het gebied van software-engineering, maar het vertelt nog steeds niet het hele verhaal over de kwaliteit van de uitleg, het beoordelingsvermogen bij het beoordelen, of hoe nuttig een antwoord aanvoelt in een chat-workflow.
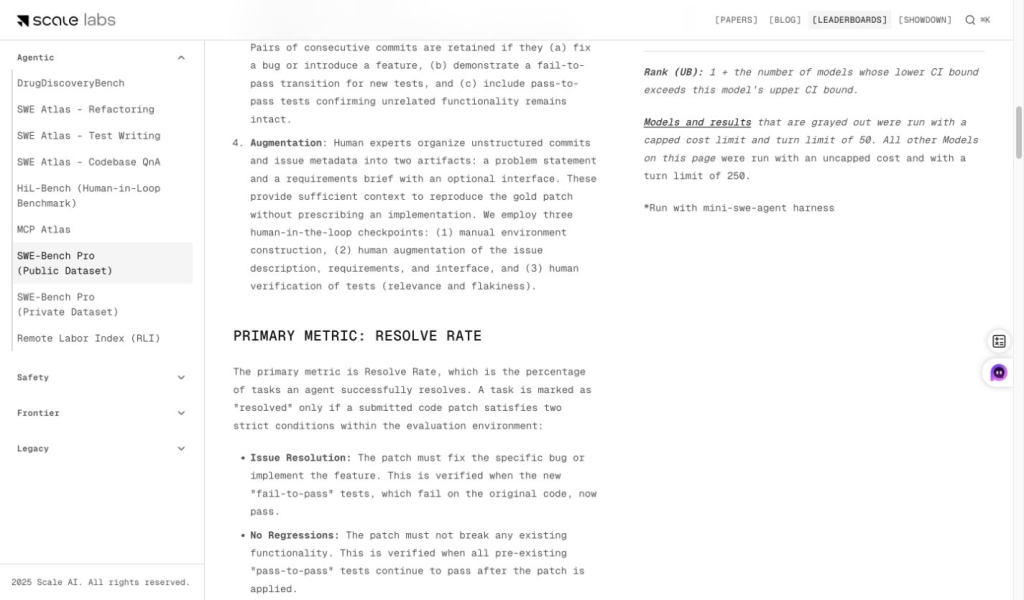
SWE-Bench Pro: moeilijkere programmeertaken en oplossingspercentage
Het openbare klassement van Scale’s SWE-Bench Pro is een strenger criterium omdat het zich richt op veeleisendere repository-taken en de oplossingsgraad als belangrijkste maatstaf hanteert. Dit is vooral nuttig wanneer je belang hecht aan de daadwerkelijke capaciteiten van een codeeragent: niet alleen of het model een bug kan verklaren, maar ook of het onder benchmarkomstandigheden een repository naar een werkende oplossing kan leiden.
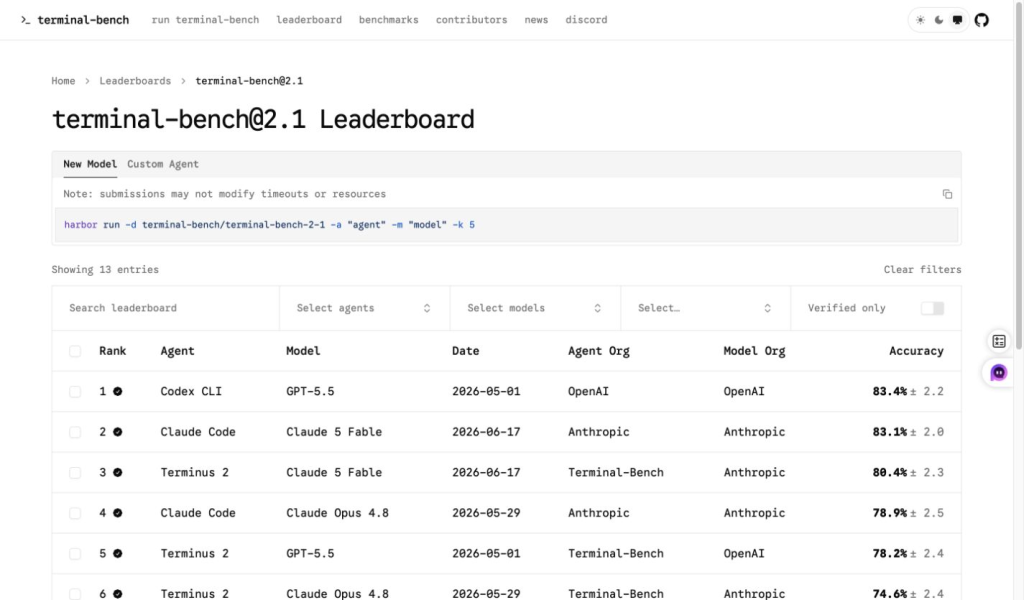
Terminal-Bench: taken via de opdrachtregel en agent-workflows
Terminal-Bench 2.1 verschilt van SWE-Bench omdat het zich richt op het uitvoeren van taken via de terminal en de opdrachtregel door middel van agent-/modelconfiguraties. Daardoor is het relevanter voor workflows in de stijl van Claude Code en ChatGPT Codex dan voor een gewone chatprompt van het type “schrijf deze functie”. Als je een codeerassistent zoekt voor werk op repository-niveau of via de opdrachtregel, dan hoort deze benchmark mee te wegen in je beslissing.
| Bewijs | Aanbevolen lectuur voor | Praktische tip |
|---|---|---|
| OpenAI GPT-5.5-programmeerbronnen | GPT-5.5-programmering en agentgerichte benadering van software-engineering. | Er is veel steun voor ChatGPT als programmeerassistent die zich vooral richt op de praktische uitvoering. |
| SWE-Bench | Het oplossen van problemen in de repository en taken op het gebied van softwareonderhoud. | Een goede indicator voor programmeervaardigheden, vooral wanneer de context van de repository van belang is. |
| SWE-Bench Pro | Moeilijkere repository-taken en een vergelijking van het percentage opgeloste problemen. | Nuttig om het vermogen tot serieuze agentische codering te beoordelen. |
| Terminal-Bench 2.1 | Terminaltaken, het uitvoeren van opdrachten en het instellen van agents en modellen. | Dit is relevanter voor de workflows van Claude Code en Codex dan eenvoudige chatopdrachten. |
Benchmarks maken beide modelfamilies tot geloofwaardige programmeeropties, maar ze geven geen definitief antwoord op de vraag welke keuze het beste past bij de dagelijkse workflow. In de onderstaande paragrafen worden dezelfde opdrachten gebruikt voor foutopsporing, refactoring, planning, unit-tests en beveiligingsbeoordeling, zodat je kunt zien waar de antwoorden in de praktijk van elkaar verschilden.
Hoe we Claude en ChatGPT hebben getest op het gebied van programmeren
Op 7 juli 2026 hebben we GPT-5.5 en Claude Sonnet 5 getest in GlobalGPT, met gebruikmaking van dezelfde interface en dezelfde prompts. Het doel was niet om een volledige IDE-agentbenchmark na te bootsen. Het ging erom alledaagse hulp bij het programmeren te vergelijken: foutopsporing, refactoring, redeneren op basis van meerdere bestanden, het schrijven van tests en beveiligingsbeoordelingen.
De beoordeling was eenvoudig: juistheid, redenering naar de onderliggende oorzaak, onderhoudbaarheid, dekking van randgevallen, verificatie en het opvolgen van instructies. Daardoor sluit de vergelijking goed aan bij de manier waarop ontwikkelaars AI-codeerassistenten in de praktijk gebruiken.
Test 1: Foutopsporing en analyse van de hoofdoorzaak
In de eerste opdracht werd beide modellen gevraagd een JavaScript-functie te beoordelen die tickets op prioriteit groepeert. De fout is subtiel maar komt vaak voor: de functie probeert iets in de acc[ticket.priority] voordat die array bestaat.
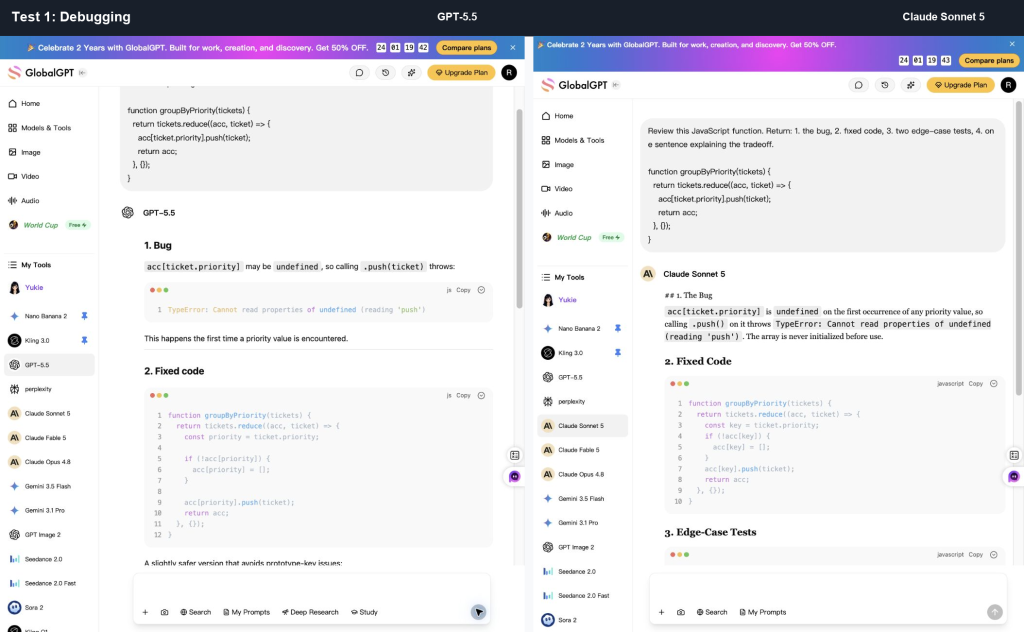
Wat ChatGPT goed deed: GPT-5.5 heeft de fout opgespoord, de gecorrigeerde code aangeleverd, tests voor randgevallen toegevoegd en een meer defensieve aanpak gehanteerd Object.create(null) variant. Dat extra implementatiedetail is handig wanneer object-sleutels mogelijk conflicteren met overgeërfde eigenschappen.
Wat Claude goed deed: Claude Sonnet 5 ontdekte dezelfde bug en gaf een nauwkeuriger antwoord. Hij bracht ook een randgeval met onbepaalde prioriteit ter sprake, en dat is precies het soort praktische grensgeval waar een beoordelaar rekening mee moet houden.
Winnaar: Gelijk, met een lichte voorsprong voor ChatGPT wat betreft de nuances in de implementatie. Claude was strakker; GPT-5.5 was vollediger.
Test 2: Refactoring en onderhoudbaarheid
De tweede opdracht vroeg om een refactor ter verbetering van de leesbaarheid, zonder het gedrag te wijzigen. Dit is een goede test, omdat veel door AI gegenereerde code-antwoorden kleine hulpprogramma’s te veel refactoren en daardoor meer bewegende onderdelen creëren dan de oorspronkelijke code nodig heeft.
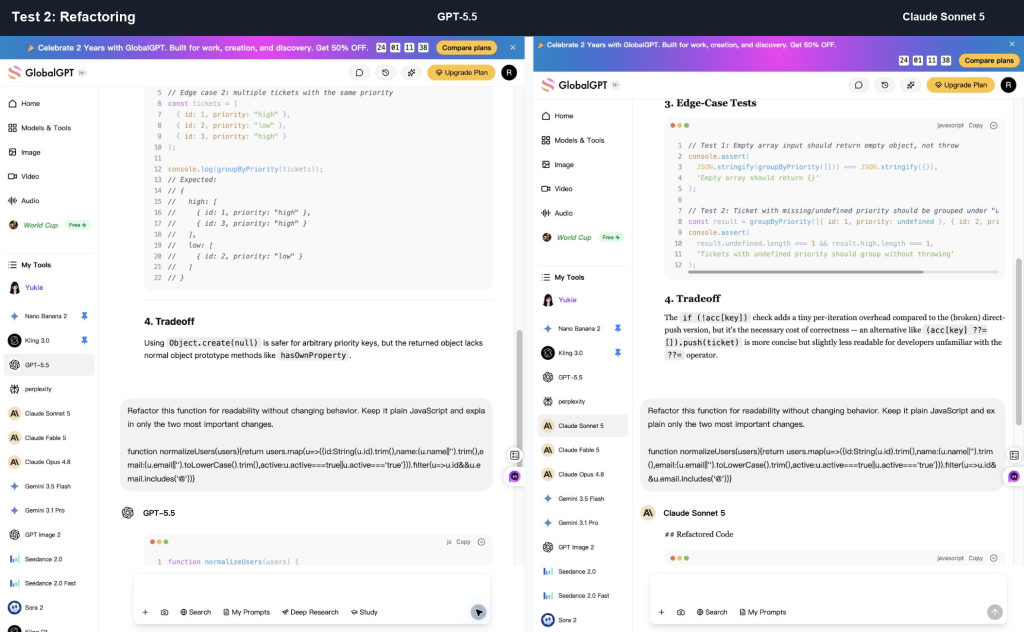
Wat ChatGPT goed deed: GPT-5.5 heeft de structuur grotendeels in de buurt van het origineel gehouden, benoemde tussenwaarden geïntroduceerd en de instructie “slechts twee belangrijke wijzigingen” nauwgezet opgevolgd. Dat is waardevol wanneer de gebruiker een conservatieve refactor wenst.
Wat Claude goed deed: Claude Sonnet 5 heeft hulpfuncties zoals een normalisator en een validator eruit gehaald. Hierdoor werd de intent makkelijker te doorlopen, maar veranderde de structuur meer dan bij GPT-5.5 het geval was.
Winnaar: ChatGPT voor terughoudendheid; Claude voor modulaire leesbaarheid. Als je een veilige, minimale refactor nodig hebt, begin dan met ChatGPT. Als je duidelijkere domeinnaamgeving wilt, vraag dan Claude om een tweede ronde.
Test 3: Redeneren en plannen op basis van meerdere bestanden
De derde opdracht bestond uit een kleine Next.js-bestandsstructuur en een bugrapport: ingelogde gebruikers kunnen kleine bestanden uploaden, maar bij bestanden groter dan 8 MB mislukt de upload zonder foutmelding zodra de voortgangsbalk 100% bereikt.
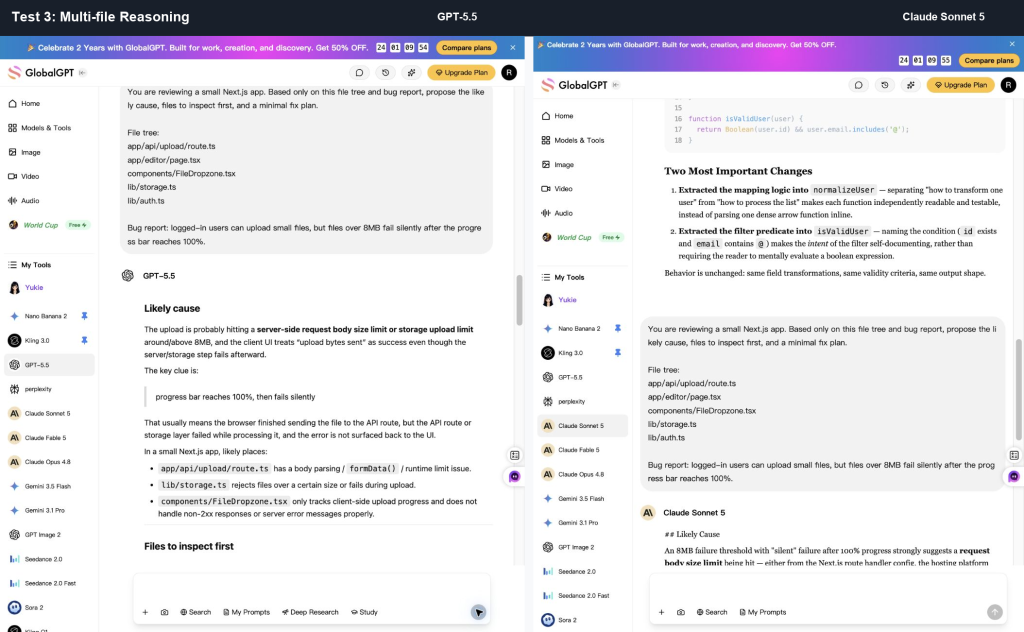
Wat ChatGPT goed deed: GPT-5.5 heeft een gedetailleerd, op de uitvoering gericht plan opgesteld. Daarin werd ingegaan op controles van de servergrootte, de afhandeling van reacties van clients en de verspreiding van opslagfouten.
Wat Claude goed deed: Claude Sonnet 5 richtte zich meteen op de drempel van 8 MB, waarschijnlijk beperkingen van het platform of de bestandsgrootte, de werking van de voortgangsbalk en een verificatieproces voor 7 MB, 8 MB en 9 MB. Het leek meer op een opmerking van een senior beoordelaar.
Winnaar: Claude. Het stelde de waarschijnlijke oorzaak sneller vast en bood een duidelijker traject voor een minimale inspectie.
Test 4: Unit-tests en verificatie
In de vierde opdracht werd aan beide modellen gevraagd om TypeScript-unit-tests te schrijven voor een helper die de limieten voor uploads en Codex-toegang retourneert. Hiermee wordt getest of het model de vertakkingslogica kan beschermen tegen toekomstige regressie.
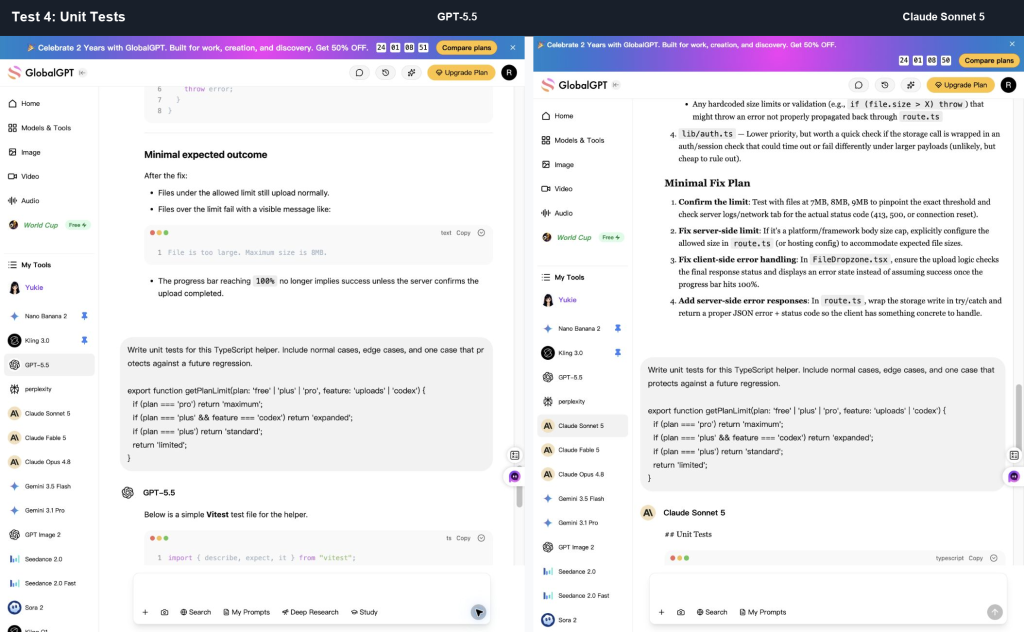
Wat ChatGPT goed deed: GPT-5.5 bevatte imports voor het testframework en genereerde een Vitest-bestand dat eruitzag alsof het uitvoerbaar was. Het omvatte de verwachte combinaties en maakte het eenvoudig om het antwoord in een project te plakken.
Wat Claude goed deed: Claude Sonnet 5 legde het werkelijke regressierisico beter uit: pro + codex moet worden onderbroken vóór de functiespecifieke controles. Het was een antwoord met een sterkere onderbouwing, ook al was het als bestand minder kant-en-klaar.
Winnaar: Claude voor het opstellen van testcases; ChatGPT voor het genereren van startbestanden. Gebruik in de praktijk ChatGPT voor de eerste testversie en Claude om te beoordelen of de tests het juiste gedrag waarborgen.
Test 5: Beoordeling van beveiliging en betrouwbaarheid
In de vijfde opdracht werd aan beide modellen gevraagd om een Express-webhook-eindpunt te beoordelen. Een goed antwoord zou moeten ingaan op handtekeningverificatie, vereisten voor de onbewerkte body, idempotentie, validatie, afhandeling van databasefouten en limieten voor de grootte van verzoeken.
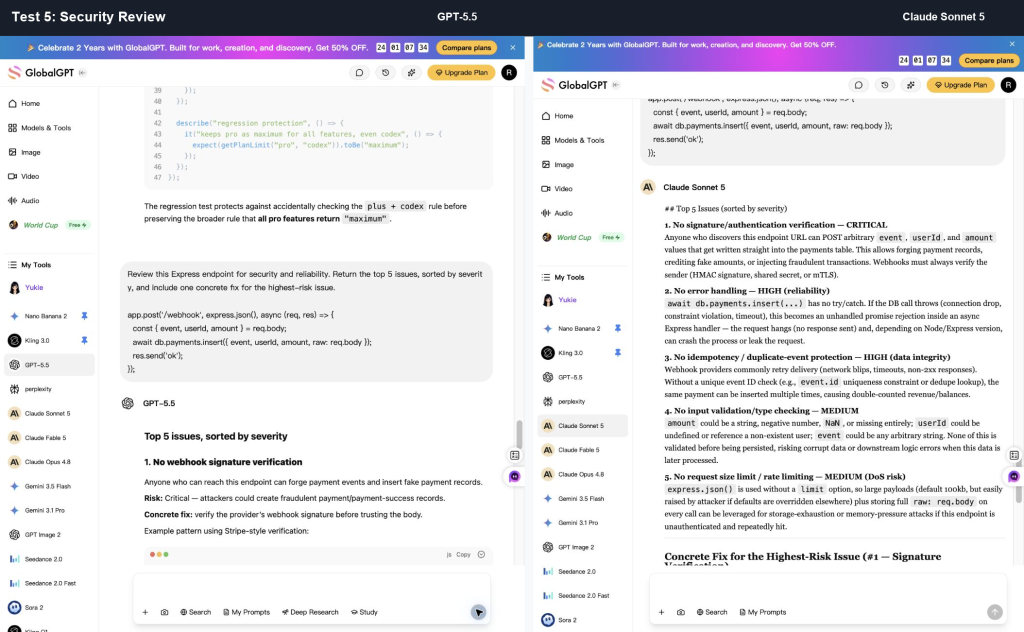
Wat ChatGPT goed deed: GPT-5.5 stelde een oplossing in de stijl van een serviceprovider voor, inclusief een Stripe-achtige express.raw() patroon. Dat is handig wanneer de volgende stap bestaat uit het implementeren van een concrete webhook-handler.
Wat Claude goed deed: Claude Sonnet 5 bood een helderdere, strakkere redenering en bevatte betrouwbaardere details over de vergelijking van handtekeningen, waarbij gebruik werd gemaakt van concepten voor vergelijkingen in constante tijd. Daardoor kwam de risicobeoordeling scherper over.
Winnaar: Gelijk, met een lichte voorkeur voor Claude wat betreft de uitleg over beveiliging. Beide modellen waren krachtig genoeg om bruikbaar te zijn, maar geen van beide antwoorden mag in de plaats komen van een echte beveiligingsbeoordeling van betalings- of authenticatieprocessen.
Claude Code versus ChatGPT Codex
De chat-uitvoer is slechts één onderdeel van de beslissing over het coderen. Claude Code en Codex zijn afzonderlijke workflows voor de ontwikkeling van agents, bedoeld voor taken waarbij bestanden, commando’s, tests, pull-verzoeken of bredere wijzigingen in de codebase betrokken zijn.
| Werkstroom | Beste pasvorm | Belangrijke grens |
|---|---|---|
| Claude-chat | Redeneren, fouten opsporen, beoordelen, uitleggen en plannen. | Het neemt alleen de context waar die je zelf opgeeft, tenzij het is gekoppeld aan tools of een bredere workflow. |
| ChatGPT-chat | Ontwerpen voor implementatie, tests, voorbeelden en vragen over het gebruik van de API. | Zelfs een overtuigend antwoord moet nog steeds in je project worden getoetst. |
| Claude Code | Repo-bewust programmeren, navigeren door de codebase, tests en het plannen van grotere taken. | Controleer de machtigingen, het beveiligingsbeleid en de voorgestelde wijzigingen voordat u de wijzigingen accepteert. |
| Codex | Repo-bewuste implementatie, foutopsporing, tests, beoordeling en in OpenAI geïntegreerde programmeerworkflows. | De toegangsvoorwaarden, het gebruik en de beschikbaarheid van het model wijken af van die van gewone chatdiensten en kunnen in de loop van de tijd veranderen. |
De praktische aanpak: gebruik chatmodellen voor het uitwerken van ideeën, uitleg en kleine taken; gebruik Claude Code of Codex wanneer het werk context uit een repository en uitvoerbare stappen vereist.
Prijzen: Claude, ChatGPT, Codex en GlobalGPT
Begin met je af te vragen waarvoor je betaalt. Met een chatabonnement betaal je voor dagelijkse interactieve hulp bij het programmeren. Met een ‘coding-agent’-workflow betaal je voor repo-gerichte taken, zoals CLI-, IDE-, web- en cloudtaken of integraties. Bij API-tariefmodellen betaal je per miljoen tokens. Met een multi-model-werkruimte betaal je voor het eenvoudig schakelen tussen Claude, GPT, Gemini, Perplexity en andere modellen op één plek.
De prijzen, gecontroleerd op 27 september 2026, zijn in Amerikaanse dollars, exclusief toepasselijke belastingen. In de tabel wordt een onderscheid gemaakt tussen consumentenabonnementen, standaardtarieven voor API-tokens en de eigen jaarabonnementen van GlobalGPT. De prijspagina van Claude Het jaarlijkse equivalent van Rounds Pro komt neer op $17 per maand; $200 die vooraf wordt betaald, komt neer op $16,67 per maand.
| Product of abonnement | Weergegeven prijs | Wat dit betekent voor het programmeren |
|---|---|---|
| Consument · Claude Gratis | $0 | Genoeg om wat eenvoudige programmeervragen te stellen en de stijl van Claude uit te proberen voordat je betaalt. |
| Consumenten · Claude Pro | $20 per maand; $200 per jaar vooraf (gelijk aan $16,67 per maand) | Inclusief Claude-code; gebruik van de betaalde versie voor chat en het delen van de Claude-code. |
| Consumenten · Claude Max | Vanaf $100 per maand | Opties voor intensiever gebruik; Claude-code inbegrepen. De facturering voor de API-console gebeurt apart. |
| Consument · ChatGPT Gratis | $0/maand | Lichte chat; de desktopversie van GPT-6 Luna verschilt van de gewone Chat. |
| Consument · ChatGPT Go | $8/maand volgens de oorspronkelijke Amerikaanse referentie; lokale prijzen kunnen afwijken | Maandelijks abonnement; kijk op de lokale prijspagina voor het bedrag in jouw regio. |
| Consument · ChatGPT Plus | $20/maand, maandelijks gefactureerd | Regelmatige programmeeropdrachten en toegang tot Codex/Work voor gerechtigden; het gebruik van de API wordt apart in rekening gebracht. |
| Consument · ChatGPT Pro | $100 per maand; bestaande abonnementen van $200 per maand blijven geldig | Nieuwe aanmeldingen en upgrades voor $200 worden vanaf 10 september 2026 opgeschort. Abonnementen op $100 blijven beschikbaar. |
| API · Claude Sonnet 5 | $2/M-ingang; $10/M-uitgang | Standaard API-tarief voor coderingstools en workflows met een grote context. |
| API · Claude Opus 5,5 | $4/M-ingang; $20/M-uitgang | Standaardsnelheid. In de snelle modus is de invoer $8/M en de uitvoer $40/M. |
| API · GPT-6 Astra | $10/M-ingang; $50/M-uitgang | Standaard API-tarief; los van een ChatGPT-abonnement. |
| API · GPT-6 Sol / Luna | Sol: $2/M-ingang, $10/M-uitgang; Luna: $0.10/M-ingang, $0.50/M-uitgang | Aparte facturering voor ontwikkelaars; gebruik de exacte model-ID en het exacte tarief. |
| Platform · GlobalGPT Basic | $5,80/maand of het equivalent daarvan; $69,60, jaarlijks gefactureerd | Een betaalbare manier om verschillende modelfamilies met elkaar te vergelijken voor dagelijkse programmeeropdrachten en onderzoek. |
| Platform · GlobalGPT Pro | $10,80 per maand; $129,60 wordt jaarlijks gefactureerd | Een betere oplossing wanneer je tijdens je dagelijkse werkzaamheden tussen verschillende modelfamilies wisselt. |
| Platform · GlobalGPT Onbeperkt | $25/maand equivalent; $300 wordt jaarlijks gefactureerd | Voor het regelmatig vergelijken van meerdere modellen binnen één werkruimte. Deze abonnementen omvatten geen officiële API-tegoed of native Claude Code/Codex-abonnementen. |
Voor de meeste individuele ontwikkelaars gaat het niet om de vraag “welk bedrijf is het goedkoopst?”, maar om “welke prijs past bij de werkwijze?”. Als je vooral vragen stelt en codefragmenten plakt, dan is Claude Pro of ChatGPT Plus is wellicht voldoende. Als je een repo-bewuste implementatie wilt, vergelijk dan de toegang tot Claude Code en Codex. Als je dagelijks meerdere modellen vergelijkt, kan GlobalGPT een overzichtelijkere dagelijkse werkruimte bieden, omdat de kosten gekoppeld zijn aan één multi-modelabonnement in plaats van aan meerdere afzonderlijke abonnementen.
Voor programmeertools die intensief gebruikmaken van API’s zijn abonnementsprijzen geen geschikte maatstaf. De prijs per token is belangrijker, omdat de codecontext omvangrijk is. Claude Sonnet 5 kost $2/M aan invoer en $10/M aan uitvoer, terwijl Opus 5.5 bij standaardsnelheid $4/M en $20/M kost. Een miljoen invoertokens plus een miljoen uitvoertokens kost daarom $12 op Sonnet 5 of $24 op Opus 5.5. Voor OpenAI kost hetzelfde gebruik $60 op Astra, $12 op Sol of $0,60 op Luna tegen standaardtarieven. Dit zijn API-kosten, geen tegoeden die zijn inbegrepen in ChatGPT-, Claude- of GlobalGPT-abonnementen.
Welke programmeeromgeving moet je kiezen?
Kies niet alleen op basis van de modelnaam. Kies op basis van het soort programmeerwerk dat je daadwerkelijk doet. Eén en dezelfde persoon kan tijdens een normale werkdag ChatGPT gebruiken voor een eerste implementatie, Claude voor controle, Codex voor werk aan de repository met uitvoerbare bestanden en GlobalGPT voor snelle modelvergelijkingen.
Beginners die leren programmeren: Begin met ChatGPT. Daarin vind je meestal meer voorbeelden, meer ondersteuning en een vlottere weg van “Ik begrijp deze fout niet” naar “Hier is de werkende oplossing.”
Junior-ontwikkelaar die bugs verhelpt: Begin met Claude als het probleem nog onduidelijk is. Claude is goed in het afbakenen van de waarschijnlijke oorzaak, het aangeven wat je als eerste moet controleren en het helder houden van de uitleg. Gebruik daarna ChatGPT als je op zoek bent naar een concrete oplossing, een testcase of een voorbeeld van een implementatie.
Senior ingenieur die een wijziging beoordeelt: Begin met Claude. Dit model leent zich beter voor afwegingen, het rangschikken van ernst, architecturale overwegingen en beknopte kritiek. Voor taken met een grotere codebase kun je beter vanuit de chat overschakelen naar Claude Code of Codex, zodat het model met bestanden en commando’s kan werken in plaats van met een geplakt fragment.
Frontend- of UI-ontwikkelaar: Begin met ChatGPT voor de eerste doorloop. Dit levert doorgaans uitgebreidere componentcode, statusbeheer en teststructuren op. Gebruik vervolgens Claude om de toegankelijkheid, componentgrenzen en naamgeving te controleren, en om na te gaan of de code niet te ingewikkeld is voor het ontwerp.
Beheerder van een omvangrijke codebase: Kies voor ‘Claude Code’ of ‘Codex’, afhankelijk van je stack, accounttoegang, beveiligingsbeleid en de workflow die je verkiest. Zodra een taak meerdere bestanden omvat, is de workflow van de agent doorgaans belangrijker dan welk chatantwoord beter klinkt.
Alleenoprichter of klein team: Gebruik beide modelfamilies als het budget het toelaat. Een praktische opzet is GlobalGPT voor dagelijkse modelvergelijkingen en het omzetten van ideeën naar code, aangevuld met Claude Code of Codex wanneer een taak toegang tot een repository en uitvoerbare stappen vereist.
| Type ontwikkelaar | De beste eerste keuze | Waarom |
|---|---|---|
| Beginners die leren programmeren | ChatGPT | Meer voorbeelden, uitgebreidere uitleg en beginnersvriendelijke hulpmiddelen. |
| Junior-ontwikkelaar die bugs verhelpt | Claude eerst | Een helderder benadering van de onderliggende oorzaken en betere richtlijnen voor wat je als eerste moet controleren. |
| Senior ingenieur die een wijziging beoordeelt | Claude | Beter geschikt voor afwegingen, risicobeoordeling en beknopte kritiek. |
| Frontend-/UI-ontwikkelaar | Eerst ChatGPT, daarna Claude | ChatGPT stelt het onderdeel op; Claude controleert de toegankelijkheid, structuur en onderhoudbaarheid. |
| Beheerder van een omvangrijke codebase | Claude Code of Codex, afhankelijk van de stack en de toegang | Bestanden, commando’s, tests en machtigingen zijn belangrijker dan één enkel antwoord in een chat. |
| Oprichter van Solo | Beide, vaak via één werkruimte waarin meerdere modellen worden gebruikt | Snelle conceptversies, zorgvuldige controle en snel wisselen van model: het speelt allemaal een rol wanneer één persoon de verantwoordelijkheid voor het product draagt. |
Als je twijfelt tussen de nieuwere Claude- en GPT-modellenreeksen, biedt de vergelijking tussen de Claude Opus 5.5 en de GPT-6 Sol meer modelspecifieke informatie. Als je de verschillende betaalde OpenAI-abonnementen met elkaar vergelijkt, dan is de ChatGPT Plus vs Pro Een vergelijking kan helpen om te bepalen of intensiever gebruik de moeite waard is.
Waarom veel ontwikkelaars nog steeds beide gebruiken
Het gebruik van zowel Claude als ChatGPT duidt niet op besluiteloosheid. Het zorgt juist voor een betere kwaliteitscontrolecyclus.
- Bedenk het plan samen met Claude, voer het uit met ChatGPT: handig wanneer je Claude wilt gebruiken om het risico te beperken en ChatGPT om de eerste implementatie te genereren.
- Opstellen met ChatGPT, nakijken met Claude: handig als je snel code nodig hebt, maar toch een strengere tweede mening wilt.
- Stel beide vragen voordat je aan de productie begint: handig voor betalingen, authenticatie, uploads, migraties, caching en ingrijpende wijzigingen in de database.
- Gebruik een agent wanneer voor de taak bestanden nodig zijn: Claude Code of Codex kan belangrijker zijn dan gewone chat wanneer het model context uit de repository nodig heeft.
GlobalGPT past in het patroon “beide gebruiken” wanneer het gaat om het snel vergelijken van modellen, dagelijkse hulp bij het coderen, planning of onderzoek. Het is met name nuttig voor het dagelijks vergelijken van modellen, het herzien van concepten, het snel inwinnen van een second opinion en het kiezen van de modelstijl die het beste past bij het volgende werkstuk.
Als je alleen de toegang tot Claude beoordeelt, dan is de beste Claude AI alternatieven Deze lijst is een algemene richtlijn voor noodgevallen.
FAQ
Wat is in 2026 beter om mee te programmeren: Claude of ChatGPT?
Kies eerst Claude voor codereview, het oplossen van onduidelijke fouten, architectuurplanning en redeneringen met een brede context. Kies eerst ChatGPT voor implementatieontwerpen, voorbeelden, frontend-werk en het opzetten van tests. Wanneer de taak toegang tot de repository, commando's, tests of bewerkingen in meerdere bestanden vereist, vergelijk dan Claude Code met Codex in plaats van alleen op de chat te vertrouwen.
Is Claude beter dan ChatGPT voor het opsporen van fouten?
Claude is vaak de betere keuze voor de eerste debug-ronde, omdat het de waarschijnlijke oorzaak meestal vooropstelt en het fouttraject duidelijk uitlegt. Bij onze JavaScript- en Next.js-tests blonk Claude Sonnet 5 vooral uit in het stellen van beknopte diagnoses. ChatGPT presteerde nog steeds goed wanneer de oplossing meer implementatiedetails vereiste.
Is ChatGPT Codex beter dan Claude Code?
Geen van beide is automatisch beter voor elk team. ChatGPT Codex past bij op OpenAI gebaseerde workflows en implementatie-intensieve taken van agents. Claude Code komt goed tot zijn recht wanneer het werk baat heeft bij de stijl van Claude op het gebied van planning, evaluatie en redeneren in een brede context. Welke keuze het beste is, hangt af van de toegang tot de repository, de prijs, de stack, de machtigingen en het teambeleid.
Wat is beter voor een grote codebase?
Bij een omvangrijke codebase is de workflow van de agent belangrijker dan alleen het chatmodel. Gebruik Claude Code of Codex wanneer de assistent bestanden moet controleren, commando’s moet uitvoeren, tests moet uitvoeren of gedrag tussen modules moet traceren. Zorg ervoor dat er menselijke controle plaatsvindt met betrekking tot machtigingen, risicovolle commando’s en de uiteindelijke diff.
Wat is beter voor beginners die leren programmeren?
ChatGPT is meestal makkelijker voor beginners, omdat het doorgaans meer voorbeelden, uitgebreidere uitleg en kant-en-klare codefragmenten biedt. Claude kan een betere keuze zijn als de beginner er niet uitkomt waarom iets niet lukt en een duidelijkere conceptuele uitleg nodig heeft.
Wat is beter voor frontend-HTML en UI-code?
ChatGPT is vaak beter geschikt voor het genereren van een eerste concept van HTML, CSS of componenten. Claude is handig om de structuur te controleren, de lay-out te vereenvoudigen en problemen op het gebied van toegankelijkheid of onderhoudbaarheid op te sporen. Voor afgewerkt frontend-werk kun je ChatGPT gebruiken om een concept op te stellen en Claude om dit te controleren.
Welk model is beter geschikt voor het schrijven van tests?
ChatGPT is geschikter als je een compleet testbestand wilt met imports en een structuur die er uitvoerbaar uitziet. Claude is geschikter als je wilt begrijpen welk gedrag bescherming nodig heeft en waarom een regressietest belangrijk is. Een goede werkwijze is om tests te genereren met ChatGPT en vervolgens aan Claude te vragen welke randgevallen ontbreken.
Laten benchmarks zoals SWE-Bench zien welke programmeerhulp beter is?
Nee. SWE-Bench, SWE-Bench Pro en Terminal-Bench zijn waardevolle indicatoren, met name voor agentische codeerworkflows, maar ze geven geen volledig beeld van de dagelijkse ondersteuning bij het coderen. Benchmarks meten een gecontroleerde testomgeving; echte ontwikkelaars hebben daarnaast ook behoefte aan een heldere redenering, bruikbare code, onderhoudbare wijzigingen en goede verificatiestappen.
Moeten ontwikkelaars zowel Claude als ChatGPT gebruiken?
Ja, vooral voor serieus werk. Gebruik Claude voor het plan, de risicoanalyse en de diagnose. Gebruik ChatGPT voor conceptversies van de implementatie, voorbeelden en teststructuren. Voer vervolgens de code uit, bekijk de verschillen en controleer het gedrag in je eigen project.
Kan ik Claude en ChatGPT in GlobalGPT met elkaar vergelijken?
Ja. GlobalGPT is handig om antwoorden van Claude en ChatGPT binnen één werkruimte te vergelijken, mits de benodigde modellen daar beschikbaar zijn. Het werkt goed voor alledaagse codevragen, planning, onderzoek en het inwinnen van een second opinion. Het is geen vervanging voor Claude Code, Codex, een IDE, officiële API's of tools op repository-niveau.