

Welke AI-modellen je het beste op je shortlist kunt zetten, hangt af van het werk dat je moet uitvoeren. Voor tekst, coderen en redeneren kun je de huidige GPT-, Claude-, Gemini-, Grok-, DeepSeek- en Qwen-series met elkaar vergelijken. Voor afbeeldingen kun je GPT Image, Nano Banana en Midjourney overwegen; voor video begin je met de functies voor het genereren en bewerken die je project nodig heeft. Een onderzoeksassistent heeft ook zoekfuncties en betrouwbare bronnen nodig, niet alleen een krachtig taalmodel.
Begin met je moeilijkste terugkerende taak en kies vervolgens de goedkoopste oplossing waarmee je die taak betrouwbaar kunt uitvoeren. Een model dat een overtuigende alinea kan schrijven, kan toch een document verkeerd interpreteren, een bronvermelding verzinnen of code genereren die niet werkt. De onderstaande aanbevelingen zijn gebaseerd op officiële modeldocumentatie en praktische selectiecriteria; het is een shortlist per taak, geen ranglijst op basis van scores.
GlobalGPT brengt meerdere modelfamilies en AI-functies samen in één abonnement, zodat je binnen dezelfde werkruimte kunt overschakelen van onderzoek en schrijven naar afbeeldingen en video. Dat is een praktische, budgetvriendelijke optie wanneer je week uit verschillende soorten werk bestaat en je minder afzonderlijke abonnementen wilt beheren.
Officiële modeloverzichten, gecontroleerd op 15 september 2026. Historische voorbeelden zijn voorzien van de aanduiding van hun oorspronkelijke modellen.
Welk AI-model moet je als eerste kiezen?
Een handige selectie per taak
| Jouw opdracht | Kandidaten om te vergelijken | Wat zou de doorslag moeten geven bij de keuze? |
|---|---|---|
| Alledaagse tekst en programmeren | GPT-5.6 Terra; Claude Sonnet 5; Gemini 3,8 Flash | Het opvolgen van instructies, bruikbare resultaten en de hoeveelheid bewerking die je nodig hebt. |
| Ingewikkelde redeneringen of uitgebreide codering | GPT-6 Astra; Claude Opus 5 of Fable 5.1; Qwen3.8 | Succes bij het oplossen van je eigen lastige zaken, met de benodigde hulpmiddelen en bevoegdheden. |
| Grote documenten en gemengde invoer | Gemini 3.1 Pro Preview; huidige GPT- en Claude-modellen | Bestandsondersteuning, nauwkeurig opzoeken en bronvermeldingen – niet alleen opslagcapaciteit. |
| Nieuw onderzoek | Een assistent met zoekfunctie; Perplexity; Grok met zoekfuncties | De kwaliteit van de bronnen, de publicatiedata en of de bronvermeldingen het antwoord ondersteunen. |
| Grootschalige API-werkzaamheden | GPT-5.6 Luna; DeepSeek V4.1 Flash; een geschikt kleiner Qwen-model | Kosten per geaccepteerd resultaat, plus vereisten op het gebied van latentie en implementatie. |
| Afbeeldingen maken en bewerken | GPT Image 2.5; Nano Banana-serie; Midjourney | Nauwkeurigheid van de tekst, controle van de referentieafbeelding, visuele stijl en herhaalbaarheid. |
| Videoproductie | Veo 3.1 en videotools met de bedieningselementen die je nodig hebt | Beweging, continuïteit, geluid, een aanpasbare workflow en bruikbare exportmogelijkheden. |
Bepaal eerst welke input en hulpmiddelen nodig zijn, en vergelijk de kandidaten vervolgens aan de hand van een resultaat dat je kunt beoordelen.
Koop niet voor elke aanvraag het meest geavanceerde model. Bij routinematige gegevensontsluiting, korte herschrijvingen en opmaak is er vaak een duidelijk ‘geslaagd/mislukt’-doel. Bewaar een krachtiger redeneermodel voor de gevallen waarin een goedkopere optie dat doel niet kan halen. Voor een eenmalige taak kan de eenvoudigste bruikbare app belangrijker zijn dan een klein verschil in API-kosten.
AI-modellen, apps en abonnementen zijn verschillende opties
Een AI-model is het systeem dat op basis van uw invoer een uitvoer genereert. Een app voegt daar de werkomgeving aan toe: bestanden uploaden, zoeken, opgeslagen gesprekken, beeldbewerkingstools of koppelingen met andere software. Een abonnement bepaalt hoe u toegang krijgt tot die omgeving en wat de gebruikslimieten zijn. GPT is een modelfamilie, ChatGPT is een product en een ChatGPT-abonnement is een aankoopbeslissing. Hetzelfde onderscheid geldt voor Claude-modellen en Claude Pro.
GlobalGPT is een platform dat meerdere modellen ondersteunt, en hoort daarom thuis in de discussie over workflows en toegang. Perplexity is in deze vergelijking vooral een op onderzoek gericht product; de API-modellen en ontwikkelaarsdiensten ervan vormen een aparte laag. Door al deze namen in één ranglijst van “beste modellen” te plaatsen, wordt de aankoopbeslissing bemoeilijkt, omdat de modellen verschillende problemen oplossen.

- Kies een app wanneer je een kant-en-klare interface zoekt voor bestanden, gesprekken of creatief werk.
- Kies een API wanneer software automatisch verzoeken moet versturen en de resultaten moet verwerken.
- Kies een inzet zonder gewichtsbeperking wanneer het zelf uitvoeren van het model deel uitmaakt van de vereisten. Houd bij die beslissing rekening met hardware, onderhoud en beveiliging.
Een model dat afbeeldingen als invoer ondersteunt, genereert niet automatisch afbeeldingen als uitvoer. Evenzo betekent een groot contextvenster niet dat de chat-app bestanden van elke omvang accepteert. Zorg dat het model, de productfuncties en het abonnement bij elkaar passen voordat je prijzen vergelijkt.
Tekst-, codeer- en redeneringsmodellen die het overwegen waard zijn om op de shortlist te plaatsen
OpenAI: GPT-6 Astra en de GPT-5.6-serie
De modelcatalogus van OpenAI beveelt GPT-6 Astra aan voor complexe redeneringen en programmeren, GPT-5.6 Terra voor een evenwicht tussen prestaties en kosten, en GPT-5.6 Luna voor kostengevoelige taken met grote volumes. GPT-5.6 Sol wordt ook genoemd voor complexe professionele taken. Dit zijn verschillende keuzes op het gebied van budget en taken binnen één productfamilie, en geen redenen om automatisch voor het duurste model te kiezen.
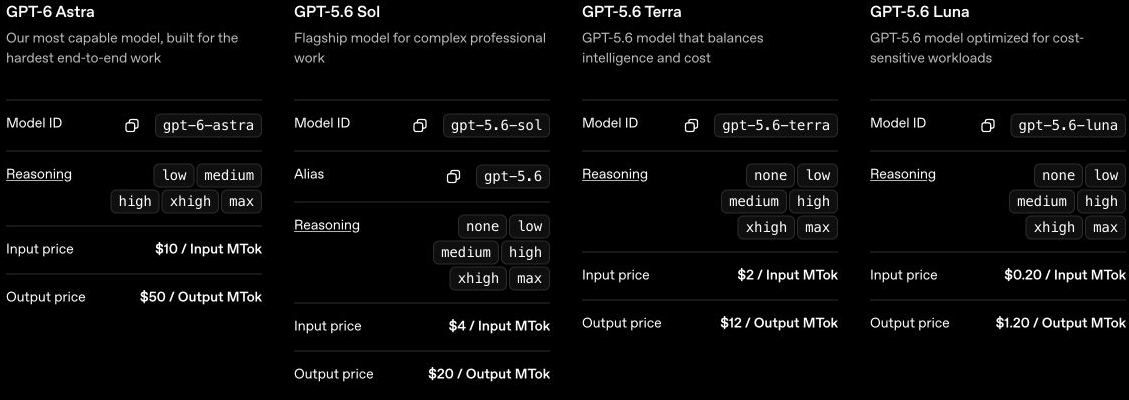
Voor een ontwikkelaar is het nuttig om dezelfde defecte functie, testsuite en acceptatiecriteria bij twee kandidaten met elkaar te vergelijken. Voor een analist is het raadzaam om dezelfde brondocumenten te gebruiken en beide modellen te vragen het bewijs achter elke conclusie aan te wijzen. Een vloeiende uitleg is niet voldoende als de code niet werkt of als het aangehaalde document iets anders zegt.
- Begin hier voor: een combinatie van tekst, gestructureerde opdrachten, redeneeropdrachten en programmeeropdrachten.
- Vergelijk: Terra of Luna voor routinematige taken; Sol of Astra wanneer de extra kosten in de zwaardere gevallen gerechtvaardigd zijn.
- Toegang: De onderstaande API-prijzen zijn kosten voor ontwikkelaarstokens. Deze staan los van ChatGPT-abonnementen en toolspecifieke kosten.
Claude: Sonnet 5, Opus 5 en Fable 5.1
Het huidige assortiment van Anthropic omvat Claude Sonnet 5, Opus 5, Fable 5.1 en Haiku 4.5. Anthropic wijst naar Opus 5 voor de meeste workloads en naar Fable 5.1 voor veeleisende redeneringen of agentische taken met een lange tijdshorizon, wanneer evaluaties op Opus nog tekortschieten. Dat is een nuttige upgraderegel: investeer pas in het krachtigere model nadat een daadwerkelijke mislukking is vastgesteld, in plaats van voordat de taak wordt aangepakt.
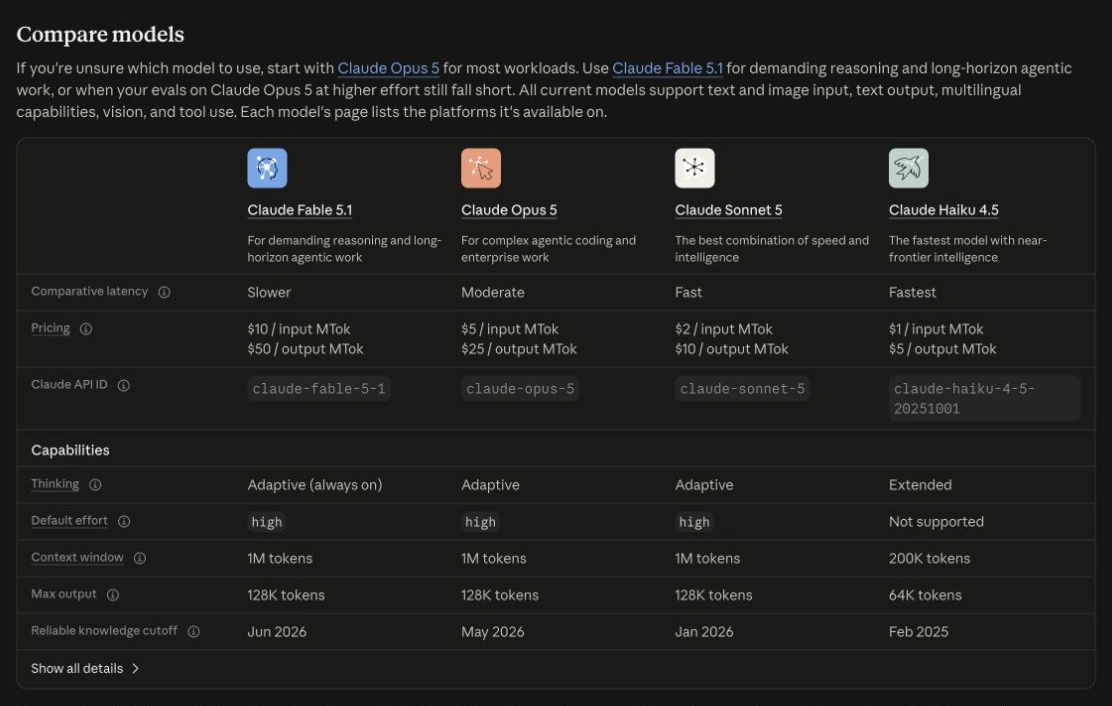
Bij het schrijven moet je beoordelen of het model je feiten, stijl en beperkingen behoudt na meerdere revisierondes. Bij het programmeren moet je beoordelen welke wijzigingen het oplevert en welke tests het doorstaat. Een uitgebreid antwoord kan indrukwekkend zijn, maar kost veel tijd om te beoordelen. Vraag om het kleinste complete resultaat: een herziene paragraaf, een werkende patch of een besluit met traceerbare onderbouwing.
- Begin hier voor: uitgebreide schrijfopdrachten, codebeoordeling en projecten waarbij zorgvuldig gebruik moet worden gemaakt van het verstrekte materiaal.
- Vergelijk: Sonnet 5 als uitgangspunt; Opus 5 of Fable 5.1 voor veeleisende taken. Dit is een selectievolgorde, geen op zichzelf staande kwaliteitsranglijst.
- Toegang: Claude-app-abonnementen en API-facturering zijn twee verschillende zaken. Vergelijk Claude-plannen en de API en uitsplitsing van het gebruik voor de route die u wilt kopen.
Als je tussen de twee ecosystemen moet kiezen, dan is de Vergelijking tussen Claude en ChatGPT gaat in op overwegingen op productniveau. Pas de benchmarkpositie van een ouder model niet toe op een nieuwe versie met een vergelijkbare naam.
Gemini: 3.8 Flash en 3.1 Pro – Vooruitblik
De modelgids van Google vermeldt Gemini 3.8 Flash als stabiel model en Gemini 3.1 Pro als preview. 3.8 Flash wordt beschreven in de context van software-engineering, autonome agents en complexe bedrijfsworkflows; 3.1 Pro blijft een optie voor het oplossen van complexe problemen. “Flash” en “Pro” zijn productfamilies, dus de exacte versie en releasestatus zijn belangrijker dan de naam alleen.
Gemini verdient een plek op de shortlist wanneer een opdracht gemengde input omvat, zoals een rapport plus afbeeldingen of een video plus een transcriptie. Controleer of het antwoord verwijst naar de juiste pagina, het juiste frame of de juiste passage. Hiermee wordt een veelvoorkomende fout bij lange contexten opgespoord: het model accepteert het materiaal, maar haalt er het verkeerde detail uit.

Google's oorspronkelijke benchmarktabel bevat de hierboven weergegeven vergelijking tussen de twee oudere versies. Dit is handig om de benchmarkvoorwaarden te begrijpen. Rijen waarbij tools worden gebruikt en rijen zonder tools geven antwoord op verschillende vragen. In het gedeelte met de uitgebreide context wordt ook een onderscheid gemaakt tussen een gemiddelde van 128K en een puntgewijs resultaat van 1M. Houd rekening met deze verschillen bij het beoordelen van een bewering over “beter redeneren” of “een langer geheugen”.”
Voor vragen over de aankoop en installatie, zie Gemini-abonnementsopties en Gemini-abonnement instellen. De Vergelijking tussen Gemini 3.1 Pro en Claude Opus 4.6 is een vergelijking tussen specifieke versies, en geen bewijs met betrekking tot de nieuwere Claude-serie.
Grok 4.6: het model scheiden van de live-zoekfunctie
De documentatie van het model Grok Vermeldt Grok 4.6 voor code- en algemene teksttaken, met een contextvenster van 500.000 tokens. Er wordt ook een cruciale beperking aangegeven: een model is niet op de hoogte van actuele gebeurtenissen buiten zijn trainingsgegevens, tenzij zoekfuncties zijn ingeschakeld. Voor actuele informatie is de praktische keuze ‘Web Search’ of ‘X Search’, en niet simpelweg de naam Grok.

Beoordeel bij een workflow voor het volgen van nieuws of trends of de assistent het oorspronkelijke bericht vindt, de datum ervan onderscheidt van die van een herpublicatie en de bewering aan de bron koppelt. De zoekfunctie kan materiaal ophalen zonder dat de uiteindelijke interpretatie daarmee correct is. Vergelijk bij het opstellen van tijdloze teksten of coderingstaken de output met uw acceptatiecriteria, in plaats van ervan uit te gaan dat de koppeling met sociale media Grok ongeschikt maakt.
DeepSeek: huidige API-opties en kostenbeheersing
De API-tabel van DeepSeek kaarten deepseek-flash naar DeepSeek V4.1 Flash en deepseek-v4-pro naar DeepSeek V4 Pro 0813. In dezelfde tabel staat dat Flash Vision ondersteunt, terwijl de vermelde Pro-route dat niet doet. Een indrukwekkender klinkende naam is dus geen garantie voor ondersteuning van de ingang die je hebt.
DeepSeek is een geschikte, kostenbewuste API-kandidaat, maar vergelijk wel de volledige factureringsvoorwaarden. In de vermelde tarieven wordt onderscheid gemaakt tussen cache-hits en cache-misses, en tussen piek- en daluren. Een opgegeven minimumprijs kan betrekking hebben op een in de cache opgeslagen verzoek tijdens een bepaalde periode, en niet op de kosten van een gewoon verzoek dat niet in de cache is opgeslagen.
- Begin hier voor: terugkerende API-werkbelastingen waarbij prijs en compatibiliteit bij de implementatie van belang zijn.
- Controleer eerst: nauwkeurige modeltoewijzing, ondersteuning voor beeldinvoer en vereisten voor de uitvoer.
- Stel je begroting goed op: Gebruik de invoer- en uitvoersnelheden zonder caching voor een voorzichtige eerste schatting; pas caching of tijdbesparingen alleen toe als uw workload daarvoor in aanmerking komt.
Qwen: een open modellenreeks met verschillende afmetingen
De officiële repository van Qwen heeft betrekking op de open modelserie Qwen3.5, inclusief de 3.6-versie en de nieuwere Qwen3.8-versies. Hierin worden de modellen Qwen3.8-27B en Qwen3.8-2.4T-A95B vermeld, terwijl eerdere 3.5-maten onder meer 0.8B, 2B, 4B en 9B omvatten. Deze benamingen staan voor zeer uiteenlopende implementatievereisten; een klein lokaal model en een groot vlaggenschip zijn niet onderling uitwisselbaar.

De relevante vraag voor lokaal werk is: “Wat kan mijn hardware goed aan?” Houd rekening met modelgewichten, runtime-overhead en het geheugengebruik bij een steeds langer wordend gesprek. Quantificatie kan het uitvoeren van een model vergemakkelijken, maar het effect ervan op je taak moet in de evaluatie worden meegenomen. In de repository worden lokale frameworkopties gedocumenteerd, waaronder llama.cpp en MLX; lees de exacte modelkaart en licentie door voordat je het model implementeert.
Kies voor je onderzoek bronnen en zoekinstrumenten, evenals een model
Perplexity is een zoek- en onderzoeksproduct dat antwoorden combineert met bronvermeldingen. De toegang tot zoekfuncties, modellen en uploadmogelijkheden wordt bepaald door de consumentenabonnementen; Sonar en API-diensten voor ontwikkelaars zijn een aparte keuze. Een antwoord met veel bronvermeldingen is alleen nuttig als de gelinkte bronnen de belangrijkste beweringen daadwerkelijk onderbouwen.
Als je af en toe onderzoek doet, begin dan met de gratis versie: eenvoudige zoekopdrachten, automatische modelselectie en een beperkt aantal uploads. De vergelijking van officiële plannen, gecontroleerd op 15 september 2026, vermeldt 3 Pro Searches per dag en 1 Research-zoekopdracht per maand gratis, zonder geavanceerde AI-modellen of beeldgeneratie. Met Pro krijg je geavanceerde modellen, uitgebreide Pro Search en hogere limieten voor uploads en analyses. Voor Pro Search gelden wekelijkse limieten en voor Research maandelijkse limieten; de tabel voor consumenten geeft geen exacte aantallen voor Pro.
Perplexiteit Pagina met individuele prijzen, geraadpleegd op 15 september 2026, vermeldt Free voor $0/maand, Pro voor $20/maand en Max voor $200/maand. Dit zijn de weergegeven maandprijzen, geen jaarprijzen of totaalbedragen inclusief belasting bij het afrekenen. Probeer de gratis versie uit met een representatieve onderzoeksvraag en overweeg vervolgens een betaald abonnement als de geavanceerde modellen of hogere gebruikslimieten voorzien in een terugkerende behoefte.
Stel een korte checklist op voordat je een antwoord accepteert. Bekijk de bron van een belangrijk cijfer; controleer of het om primaire berichtgeving gaat; verifieer de publicatiedatum; en maak onderscheid tussen een direct citaat en de interpretatie van de medewerker. Voor veranderlijke feiten, zoals prijzen en productbeschikbaarheid, is de actuele documentatie van een leverancier een betrouwbaardere bron dan een samenvattend artikel.
- Vraag voor een literatuuronderzoek om originele artikelen en breng in kaart welke onderzoeksvraag in elk artikel aan de orde komt.
- Vraag bij het nemen van een aankoopbeslissing naar het exacte abonnement, de factureringsbasis en de ingangsdatum van de aangeboden voorwaarden.
- Vergelijk voor recent nieuws het oorspronkelijke bericht met de berichtgeving die daarna is verschenen.
- Bij een omstreden vraag moet je je afvragen over welke aspecten de bronnen het eens zijn en welke onduidelijk blijven.
Gebruik De modellen en modi van Perplexity om inzicht te krijgen in de beschikbare werkmodi, en Perplexiteit abonnementsplannen voor de aankoopbeslissing. Een geavanceerder redeneermodel kan niet compenseren dat in de bronverzameling het relevante document ontbreekt.
Beeldmodellen: kies voor bewerkingscontrole, tekstnauwkeurigheid of visuele stijl
GPT-afbeelding: praktisch genereren en bewerken
In de huidige catalogus van OpenAI staan ‘GPT Image 2.5 Sunburst’ voor het genereren en bewerken van afbeeldingen en ‘GPT Image 2.5 Flare’ voor snellere dagelijkse afbeeldingsgeneratie. Vergelijk beide producten aan de hand van dezelfde advertentie, hetzelfde diagram of dezelfde opdracht voor een productafbeelding, rekening houdend met de aanpassingen die u verwacht te maken.
Geef voor een zakelijke afbeelding de exacte tekst, lay-out en benodigde elementen op. Bekijk vervolgens het resultaat op de uiteindelijke weergavegrootte. Zelfs een prachtige infographic kan een verkeerd gespeld label of een aannemelijk maar onjuist getal bevatten. Als de afbeelding feiten weergeeft, controleer die feiten dan los van het uiterlijk van de afbeelding.

Nano Banana: het maken en bewerken van afbeeldingen op basis van referentiemateriaal
In de lijst van Google worden de modellen Nano Banana Pro, Nano Banana 2 en Nano Banana 2 Lite onderscheiden. Nano Banana Pro komt overeen met gemini-3-pro-beeld; Nano Banana 2 naar gemini-3.1-flash-image; en Lite naar gemini-3.1-flash-lite-image. Kies de exacte route wanneer je het generatie- en bewerkingsgedrag vergelijkt, in plaats van de bijnaam als één onveranderlijk model te beschouwen.

Bij bewerkingen op basis van referentiemateriaal is een andere beoordeling nodig dan bij het eenmalig genereren van afbeeldingen. Is de gevraagde wijziging doorgevoerd? Zijn de achtergrond, kleding, het gezicht of productdetails onbedoeld veranderd? Een kleine aanpassing waarbij de rest van de afbeelding intact blijft, kan nuttiger zijn dan een ingrijpende herbewerking. Zie Aan de slag met Nano Banana Pro, toegangswegen en Kosten van de Nano Banana Pro voor de volgende stappen.
Midjourney: beoordeel de stijl aan de hand van de opdrachtomschrijving
Midjourney’s officiële handleiding, geraadpleegd op 15 september 2026, noemt V8.2 als de standaardversie, uitgebracht op 24 juli. Deze update richt zich op esthetiek en personalisatie en introduceert een ‘Edit Model’-functie die ‘Omni Reference’, ‘Character Reference’ en ‘Retexture’ vervangt. Overweeg deze functie voor moodboards, conceptkunst of een opvallende campagne-uitvoering. Een conceptschets heeft een overtuigende stijl nodig; een gelabeld productdiagram vereist exacte inhoud. Vergelijk het resultaat en de revisies ervan met die opdrachtomschrijving.
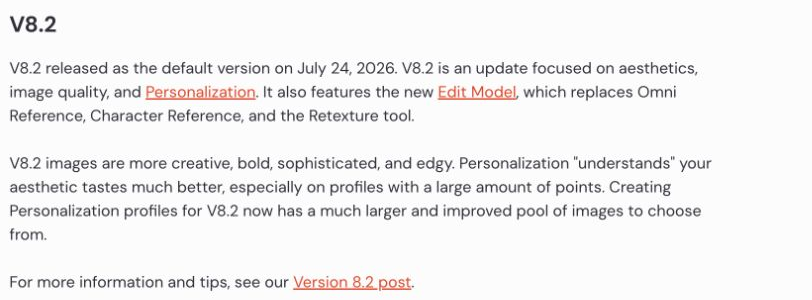

Om de test zinvol te laten zijn, moet je de proefpersoon, de vereiste samenstelling en het exportformaat consistent houden. Ga na of je de gekozen aanpak kunt aanpassen zonder helemaal opnieuw te moeten beginnen. Als het essentieel is dat de tekst of de identiteit nauwkeurig behouden blijft, voer dan expliciete goed/fout-controles uit. De Vergelijking tussen Nano Banana Pro en Midjourney biedt een andere manier om die beslissing te benaderen.
Videomodellen: beoordeel de hele clip, niet één aantrekkelijk beeld
Veo 3.1 en de productieworkflow
De documentatie van Google over Veo beschrijft Veo 3.1 voor het genereren van video met creatieve bedieningselementen en audio. De voorbeelden omvatten referentiebeelden, scène-uitbreiding en workflows voor het eerste en laatste beeld. Die bedieningselementen zijn van belang als je meerdere opnames nodig hebt die deel uitmaken van hetzelfde verhaal, in plaats van één op zichzelf staande clip.
Test de productiebeperking die achteraf het moeilijkst te verhelpen is: een consistent personage, een product dat zijn vorm behoudt, leesbare borden of gesynchroniseerde dialogen. Bekijk de volledige clip op normale snelheid en let goed op moeilijke overgangen. Een model kan een sterk openingsbeeld opleveren, maar het kan misgaan zodra de camera beweegt.
Toegang, gebruik en export zijn afhankelijk van de productroute, dus vergelijk de Veo 3.1 Abonnements- en gebruiksopties naast de creatieve instellingen. Vergelijk een API-limiet per seconde niet rechtstreeks met een maandelijks abonnement zonder rekening te houden met het inbegrepen verbruik en het type uitvoer.
Sora: verklaring voor de aangekondigde sluiting
OpenAI's Kennisgeving inzake het stopzetten van Sora, gepubliceerd op 11 september 2026, meldde dat de web- en app-diensten op 26 april waren beëindigd en dat de API op 24 september 2026 zou worden uitgeschakeld. Beschouw Sora als een migratiekwestie voor een bestaand project, en niet als een startpunt voor een nieuwe videoworkflow. Controleer de mededeling op eventuele gewijzigde data en actuele exportinstructies.

De Workflow voor het storyboard van Sora, Uitleg over de Sora 2 Pro en Versiespecifieke handleiding voor de duur van Sora beschrijf historische kenmerken. Gebruik deze om vast te stellen wat er in een bestaand project behouden moet blijven, en vergelijk vervolgens Sora alternatieven aan de hand van die vereisten. Bewaar de opdrachtomschrijving, het referentiemateriaal en de volledige output bij elkaar, zodat je een vervangende versie aan de hand van dezelfde opdrachtomschrijving kunt beoordelen.
Vergelijk API-kosten voor dezelfde werklast
API-facturering is gebaseerd op het aantal invoer- en uitvoertokens; met een abonnementsovereenkomst krijgt de gebruiker toegang tot een bepaald abonnement. Houd deze budgetten gescheiden. In de onderstaande berekening wordt uitgegaan van 100 verzoeken, elk met 10.000 niet-gecachete invoertokens en 1.000 gefactureerde uitvoertokens: in totaal 1 miljoen invoertokens plus 100.000 uitvoertokens. Dit is een illustratieve workload, geen gemeten factuur of kwaliteitsbenchmark.
USD, standaardtarieven voor genoteerde tokens, gecontroleerd op 15 september 2026. Korte verzoeken zoals gespecificeerd; geen cachekorting, batchkorting, prioriteitsniveau, belastingen of betaalde tools. De toegestane hoeveelheid omvat, indien van toepassing, gefactureerde redeneringstokens. Bronnen: Modelcatalogus OpenAI, Overzicht van het Anthropic-model, Grok-modellen en prijzen.
Het goedkoopste model is alleen nuttig als de resultaten aan je controles voldoen. Als een goedkoper model herhaalde pogingen of aanzienlijke handmatige correcties vereist, vergelijk dan de kosten per geaccepteerd resultaat. Begin met een goedkoper model voor duidelijke, repetitieve taken en stuur moeilijke gevallen door naar een krachtiger model wanneer het eerste resultaat niet voldoet.
De tarieven waarop de berekening is gebaseerd
| Model | Invoer / 1 miljoen tokens | Opbrengst / 1 miljoen tokens |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| Grok 4,6 | $2.00 | $6.00 |
| Claude Sonnet 5 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
Dit zijn API-tarieven, geen maandelijkse abonnementskosten. In de bovenstaande workload blijven de invoergrootte en de gefactureerde uitvoergrootte vast; er wordt niet uitgegaan van een gelijke uitvoerlengte, nauwkeurigheid of snelheid in de praktijk.
DeepSeek hanteert een ander tijdsafhankelijk tarief. De huidige V4.1-Flash-tabel vermeldt voor niet-gecachete input $0,15 buiten de piekuren of $0,30 tijdens de piekuren, en voor output $0,60 buiten de piekuren of $1,20 tijdens de piekuren, per miljoen tokens. V4 Pro vermeldt $0,66/$1,32 voor niet-gecacheerde invoer en $1,98/$3,96 voor uitvoer. De gedocumenteerde piekperiodes zijn 01:00–04:00 en 06:00–10:00 UTC, van maandag tot en met vrijdag. Gebruik het tarief dat geldt op het moment dat de taak wordt uitgevoerd; prijzen voor ingang met cache horen in een aparte berekening thuis.
Voor een gemengde dagelijkse workflow, Het abonnementsmodel voor meerdere modellen van GlobalGPT biedt een eenvoudigere manier om onderzoek, het opstellen van teksten, hulp bij het coderen en het bedenken van creatieve ideeën in één keer te regelen. Vergelijk dat gemak en die veelzijdigheid eens met het beheren van meerdere abonnementen of het zelf opzetten van een API-workflow. In een API-prijstabel worden de prijs en de gebruiksvoorwaarden van het abonnement niet vermeld.
Open-weight of hosted: bepaal zelf hoeveel je wilt beheren
Open weights bieden je een implementatiemogelijkheid: je kunt een model uitvoeren in een omgeving waarover je zelf de controle hebt. Dit betekent echter niet automatisch dat de gehele workflow gratis, privé of onbeperkt is. Controleer de licentie die bij het betreffende model hoort, de hardware die nodig is om het uit te voeren en waar de bijbehorende applicatie bestanden of logbestanden naartoe stuurt.
- Kies een gehoste app wanneer je snel aan de slag wilt en het model niet hoeft te bedienen.
- Kies een gehoste API wanneer je automatisering nodig hebt zonder dat je inferentiehardware hoeft te onderhouden.
- Overweeg implementatie op lokaal niveau wanneer dit de moeite waard is vanwege offline werkzaamheden, infrastructuurbeheer of een specifieke vereiste op het gebied van gegevensverwerking.
- Vergelijk kleinere modellen op je hardware voordat je ervan uitgaat dat een vlaggenschipmodel met meer parameters de praktische keuze is.
Een lokaal model kan de externe gegevensoverdracht verminderen, maar de rest van het systeem blijft belangrijk: het ophalen van gegevens, plug-ins, telemetrie, opgeslagen geschiedenis en back-ups. Voor een team is het beter om dit te zien als een beoordeling van de implementatie dan als een belofte die wordt afgeleid uit het woord “open”. De Gids voor gegevensbescherming bij AI biedt context voor het vergelijken van vereisten op het gebied van gegevensverwerking.
Moet je één AI-model gebruiken of meerdere?
Eén model is voldoende als het je terugkerende taken goed afhandelt. Voeg een ander model toe als dat een specifieke leemte opvult: betere toegang tot bronnen, een vereist invoertype, een beter beheersbare beeldbewerking of een goedkopere batchverwerking. Het verzamelen van abonnementen zonder aan elk daarvan een taak toe te wijzen, leidt tot meer beslissingen en meer overdrachten.

Stel een workflow op rond het eindproduct
| Werk | Handige reeks | Acceptatiecontrole |
|---|---|---|
| Marketing | Onderzoeksbronnen → concepttekst → beeldmateriaal maken → beweringen controleren | De beweringen van de campagne worden onderbouwd, en zowel de tekst als het beeldmateriaal brengen hetzelfde verhaal over. |
| Softwareontwikkeling | Probleem analyseren → code aanpassen → tests uitvoeren → verschillen controleren | De wijziging voldoet aan de eis zonder dat dit elders onverwachte gevolgen heeft. |
| Inhoud maken | Opzet → script → referentieafbeeldingen → videobeelden → montage | De personages, productdetails en verhaallijn blijven consistent. |
| Opstartactiviteiten | Input samenvatten → beslissingen distilleren → vervolgacties opstellen | Besluiten hebben verantwoordelijken en datums, en er worden geen ongefundeerde feiten in het verslag opgenomen. |
| Bedrijfsactiviteiten | Kies een goedgekeurde omgeving → verwerk de toegestane gegevens → controleer de uitvoer | De workflow voldoet aan de eisen van de organisatie op het gebied van toegang, gegevens en controle. |
Begin met één voltooid eindproduct. Bewaar de bronnotities en acceptatiecontroles bij het werk terwijl het tussen verschillende tools wordt verplaatst.
GlobalGPT sluit aan bij het meerstappenmodel door modelfamilies en creatieve functies op één plek samen te brengen. Bewaar de nuttige bronvermeldingen, de opdrachtomschrijving en de acceptatiecriteria bij het werk, ook als je van taak wisselt. De Overzicht van alles-in-één AI-modellen is een nuttig vervolgartikel als de belangrijkste afweging de breedte van de werkruimte is in plaats van één specifiek model.
Hoe maak je een keuze: een beoordelingsproces in vijf stappen dat je kunt herhalen
- Geef één te leveren resultaat aan. Bijvoorbeeld een samenvatting van 500 woorden met paginaverwijzingen, een patch die drie tests doorstaat, of een productafbeelding met twee exacte labels.
- Kies twee geschikte kandidaten. Zorg eerst dat de benodigde input en hulpmiddelen op elkaar zijn afgestemd. Vergelijk een assistent met zoekfunctionaliteit niet met een model dat geen zoekhulpmiddelen heeft gekregen, en noem het verschil dan ‘modelintelligentie’.
- Gebruik dezelfde opdracht en dezelfde input. Noteer het model, het product, de instellingen en de datum. Bewaar het eerste volledige resultaat in plaats van alleen de meest geslaagde poging te selecteren.
- Controleer eerst of het klopt, pas daarna de opmaak. Controleer bronvermeldingen, voer relevante codetests uit en bekijk de details van afbeeldingen of video’s. Leg vast welke correcties door mensen nodig zijn.
- Herhaal de moeilijke gevallen. Als de keuze moeilijk is of de resultaten tegenstrijdig zijn, herhaal dan die gevallen en houd de extra resultaten apart. Maak je keuze op basis van de gewenste uitkomst, de benodigde inspanning en de totale kosten.
Bij het schrijven is het nuttig om te controleren of alle aangehaalde feiten een herschrijving doorstaan. Bij het samenvatten vergelijk je de uitkomst met een korte antwoordsleutel. Bij onderzoek open je de geciteerde pagina’s. Bij video’s sla je de volledige clip op en bekijk je deze. De GlobalGPT-methodologie voor het testen van modellen biedt extra achtergrondinformatie voor het vastleggen van vergelijkingen.
Vermijd vier valkuilen: kopen op basis van populariteit, het vergelijken van ongelijksoortige prijseenheden, één enkele benchmark beschouwen als de volledige taak, en geen rekening houden met de tijd die het genereren van een output in beslag neemt. Geen van deze valkuilen wordt verholpen door simpelweg de nieuwste modelnaam te kiezen. Een herhaalbare evaluatie is nuttiger omdat deze opnieuw kan worden uitgevoerd wanneer een model verandert.
Veelgestelde vragen
Wat is op dit moment het beste AI-model?
Er is geen eenduidige winnaar. Begin met de huidige GPT-, Claude-, Gemini-, Grok-, DeepSeek- of Qwen-opties voor tekst en code, en beperk vervolgens de keuze op basis van je taak, de benodigde tools, de invoergegevens en je budget. Gebruik een speciaal beeld- of videomodel wanneer het eindresultaat dit vereist.
Welk AI-model zou ik eens moeten uitproberen om mee te programmeren?
Kies kandidaten die je ontwikkelingsworkflow ondersteunen, zoals de huidige GPT-, Claude-, Gemini- of Qwen-modellen. Vergelijk ze aan de hand van dezelfde issue, codebase en tests. Een wijziging die wordt goedgekeurd en weinig reviewwerk vereist, is een beter selectiecriterium dan een overtuigende uitleg.
Is een groter contextvenster altijd beter?
Een groter contextvenster biedt ruimte voor meer materiaal in een verzoek, maar garandeert geen nauwkeurige opvraging of redenering op basis van dat materiaal. Test of het model de exacte passage, pagina of het exacte frame kan vinden die nodig zijn voor je antwoord.
Zijn AI-modellen met open gewicht gratis?
De gewichten zijn wellicht beschikbaar onder een licentie, maar voor het gebruik ervan zijn mogelijk hardware, hosting en onderhoud nodig. Controleer de exacte licentievoorwaarden en de implementatiekosten. Bij een lokale implementatie moet ook de bijbehorende applicatie en de gegevensverwerking daarvan worden beoordeeld.
Heeft Grok automatisch toegang tot live nieuws?
Nee. In de API-documentatie van Grok staat dat voor actuele informatie zoektools zoals Web Search of X Search nodig zijn. De trainingskennis van een model en de bronnen die tijdens een verzoek worden opgehaald, zijn twee verschillende zaken.
Kan ik de API-prijzen vergelijken met een maandelijks AI-abonnement?
Pas nadat u de werklast en de inhoud van elke route hebt vastgesteld. API-tarieven worden doorgaans berekend op basis van tokens of media-output, terwijl een abonnement toegang biedt volgens de gebruiksvoorwaarden van het betreffende abonnement. Vergelijk de totale kosten van uw beoogde workflow, net zoals u dat bij de hoofdprijzen zou doen.
Moet het populairste AI-model ook het beste voor mij zijn?
Nee. Populariteit zegt niets over de vraag of een model je bestanden kan verwerken, aan je eisen voldoet of binnen je budget past. Maak op basis van de actuele documentatie een shortlist en vergelijk vervolgens de daadwerkelijke resultaten met een taak die je kunt controleren.
Kies het model waarmee je de volgende taak met zo min mogelijk vermijdbare correcties kunt uitvoeren. Begin klein, houd bij wat goed gaat en voeg pas een ander model toe als dat een duidelijk probleem oplost. Als je werk zich uitstrekt over onderzoek, tekst en creatieve output, Probeer die workflow eens in GlobalGPT en beoordeel het eindresultaat.





