证据指南 · 更新于2026年9月
Perplexity AI 可以帮助您查找资料并撰写初稿,但其引用并不保证答案的正确性。. 准确性取决于问题、搜索模式以及来源的质量。这是开展研究的一个有用起点;但重要论点仍需对照原始页面进行核实。.
带编号的引用可能会指向一个真实且相关的页面,但该页面旁边可能并未提供与之相对应的具体统计数据、日期、引文或结论。因此,Perplexity引用准确性不仅仅关乎链接是否有效:来源必须在相同的语境下支持该论点。.
在发布统计数据、引用论文或依据某项答案做出决策之前,请打开附件中的原始资料,找到相关段落,并将其中表述、日期和范围与该答案进行对比。如果证据缺失或内容有出入,请将该说法视为未经证实。.
Perplexity的准确率到底是什么意思?
Perplexity的准确性至少包含两个层面:答案是否正确,以及其来源是否能支持该答案。一个百分比通常涵盖了多项不同的测试。一个链接即使能成功打开,仍可能未能通过最重要的测试:即该页面是否能支持与其相关的论点。.
| 尺寸 | 问题 | 常见故障 |
|---|---|---|
| 引文解析 | 该网址能否正常打开并跳转到目标页面? | 失效、重定向或伪造的URL |
| 来源的相关性 | 该页面真的与该主题相关吗? | 仅提及该主题的实时页面 |
| 申请支持 | 它是否支持具体的句子、数字或日期? | 引用过度还是虚构数据 |
| 品质与新鲜度 | 内容是否具有原创性、权威性且内容最新? | 过时的页面或转载内容 |
对于出版商和品牌而言,引用存在与内容准确性是两码事。某款工具可以告诉你Perplexity提到了贵公司,但无法判断该回答是否对贵公司进行了准确描述。存在度衡量的是可见度;准确度则衡量的是来源与陈述是否一致。.
我们的 Perplexity AI 使用入门指南 介绍了基本的工作流程。本文重点探讨答案出现后的后续步骤:核查证据。.
那项最著名的Perplexity引文研究实际上测试了什么?
托中心与《哥伦比亚新闻评论》的研究方法
最有参考价值的公开基准是Tow数字新闻中心发布的一项研究,该研究由 《哥伦比亚新闻评论》 2025年3月6日。研究人员选取了20家新闻媒体,从每家媒体中各抽取10篇文章,并将文章摘录提交给8家人工智能搜索引擎。每个系统都需要识别文章的标题、发布方、发布日期和网址。.
这产生了1,600个查询:20家出版商乘以10篇文章,再乘以8种工具。该方法之所以有用,是因为研究人员掌握了一篇已知的源文章,可以将每个答案与之进行对比。其局限性在于,它仅测试了新闻片段的来源识别能力,而非涵盖所有研究、购物、学术、编程或综合类问题。.
该研究对Perplexity得出的结论
| 工具 | 测试任务的结果 | 如何阅读 |
|---|---|---|
| 困惑 | 37% 错误 | 特定新闻来源识别任务 |
| ChatGPT 搜索 | 67% 错误 | 相同的任务和比较框架 |
| Grok 3 | 94% 错误 | 相同的任务和比较框架 |
原始来源: AI搜索存在引用问题, ,托中心/《哥伦比亚新闻评论》,2025年3月6日发表。.
该研究未能证明什么
- 它并未测试所有题目,也未测试Perplexity模式。.
- 它并未为未来的版本创建一个永久的评分。.
- 这并不能证明每一个引用Perplexity的文献都是错误的。.
- 它并未在每个主题上都成为全球赢家。.
- 不应将其改写为“63% 总体引用准确率”。”
Prompt Architects 的分析 也指出了同样有价值的观点:只有当读者能够了解该数据背后的样本、评分规则、任务定义和日期时,这个数字才有意义。.
为什么一个Perplexity的引用形式看起来正确,却仍然是错误的?
引用不一致比断链更难察觉。页面加载后,标题听起来似乎切题,答案也可能显得很有把握。但当你将该说法与来源页面的措辞和上下文进行对比时,问题便显现出来了。.
| 失效模式 | 外观如何 | 检查 |
|---|---|---|
| 索赔与来源不符 | 原始来源并不支持该说法。. | 找出确切的句子或数字。. |
| 引用过度 | 原文提出了一个较为温和的观点;回答则提出了更强有力的观点。. | 比较措辞的力度和方向。. |
| 话题偏离 | 链接可以打开,但文章的内容是关于另一个主题的。. | 请阅读标题和开头部分。. |
| 虚幻统计数据 | 该数字出现在答案中,但页面上没有。. | 查找该数值及其单位。. |
| 内容分发中的困惑 | 转发时标注了引用来源,而非原始发布者。. | 查找第一方版本和日期。. |
| 过时或损坏的源文件 | 页面已更改、消失或出现错误。. | 在新会话中打开。. |
困惑的 来源标签指南 此外,这还设定了一个有用的预期:标签描述的是网站整体,而非每篇具体文章或每项主张的真实性。.
请在数字、日期、姓名、引语或推荐语周围画圈。.
点击该句子后面的来源链接。.
搜索短语、数字或证据。.
检查上下文、范围、日期和来源。.
如何在两分钟内验证一条Perplexity引用
首先从如果出现错误会造成最大损害的陈述入手:价格、百分比、日期、引语、法律条款、医疗说明或与竞争对手的对比。.
- 选择索赔事项。. 请准确抄写该句子或数字。.
- 请打开附件中的引用。. 请使用与该句子相关的来源。.
- 搜索本页。. 使用“查找”功能查找数字、短语或命名的研究。.
- 请阅读这段文字。. 检查科目、日期、范围、单位和方向。.
- 核查来源。. 优先选择原始版本和当前版本。将匹配失败的条目标记为“未验证”。.
可重复使用的验证提示: 请打开你引用的关于“[主张]”的来源。引用支持该主张的确切句子。如果该来源中没有支持所述主张的句子,请直接说明这一点,不要重新表述该主张。.
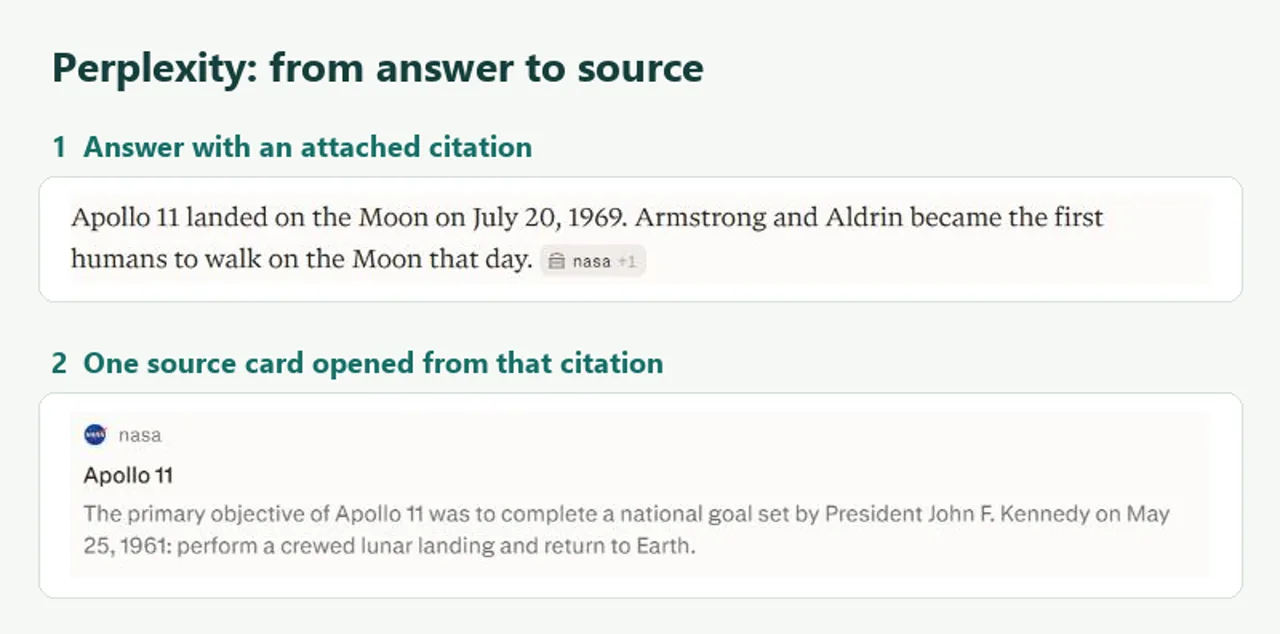
该提示并不会提高原始检索结果的准确性。它只是迫使模型展示其推理过程。当答案将被公布或用于涉及重大利害关系的决策时,您仍然需要阅读原始资料。.
Perplexity深度研究比标准搜索更准确吗?
一份篇幅更长、引用来源更丰富的报告可能更有用,但篇幅长短本身并不构成验证评分。深度研究在检索、整合和错误归类信息方面存在更多可能性。公开案例可以表明存在引用问题;但这些案例并不能为每次研究会话确立一个稳定的准确率百分比。.
根据工作量调整审核力度。对风险较低的概述性内容进行抽查。对于文献综述、尽职调查备忘录或包含硬数据的报告,请逐一核对每个数字并查阅来源。我们的 模型与模式指南 解释了工作流程的差异;但这不能替代验证。.
在引用方面,Perplexity 是否比 ChatGPT 更准确?
在Tow Center的具体新闻来源识别任务中,Perplexity产生的错误答案比ChatGPT Search更少。这是一次公平的同任务比较,而非对所有模型、查询、日期或模式的全面评价。.
要进行公平的比较,必须使用相同的提示、数据集、时间窗口、评分规则以及对弃权处理的方式。有关更广泛的工作流背景,请参阅我们的 Perplexity 与 ChatGPT 测试.
在什么情况下使用Perplexity引用是安全的?
| 用例 | 如何处理引用 |
|---|---|
| 主题与来源发现 | 一个不错的起点;开源资源。. |
| 时事导向 | 核对日期、原件及更新内容。. |
| 简要总结 | 对包含该结论的论点进行抽查。. |
| 学术文献综述 | 请阅读并引用原文。. |
| 医疗、法律、财务或安全方面的决策 | 请仅将输出结果视为线索。. |
| 品牌和AEO监测 | 分别跟踪存在情况和准确性。. |
在为人工智能研究任务上传内部文件或个人数据之前,请先查看相关政策和工作区控制设置。我们的指南介绍 各模型政策中的AI数据隐私 是一个有用的起点。.
如何核实有关某个品牌的说法?
“我们被引用了”只是审计的第一行。请记录查询内容、主张的回答、引用网址、来源类型,以及该页面是否支持该主张。由于网络和检索系统会发生变化,请补充访问方式和测试日期。.
| 审计字段 | 记录什么 |
|---|---|
| 查询 | 确切的提示词以及目标市场或语言 |
| 主张 | 待核对的句子、数字或描述 |
| 引用 | 网址、标题、出版方和访问日期 |
| 支持状态 | 得到支持、部分支持、被反驳或未找到 |
| 来源 | 原创、联合发布、官方、二次创作或社区内容 |
| 背景 | 模式、型号、日期和变更说明 |
如果您正在核查有关贵公司或竞争对手的回答,请将每项价格、功能和限制与原始产品页面进行对比。例如,除非该页面在同一套餐下列出了该功能,否则仅引用定价页面并不能证明该功能已被包含。在将该回答用于报告或建议之前,请记录下任何不一致之处。.
有关相关产品的决策,请参阅我们的 困惑替代品, ,关于……的指南 Perplexity 的工作原理与 Google 以及 ChatGPT 相比如何, ,以及对 Perplexity的研究与引用功能.
常见问题
Perplexity 提供的信息准确吗?
Perplexity 可以提供有用且最新的信息,特别是在查找信息来源方面。信息的准确性取决于查询内容、来源集、模式以及陈述内容。对于重要的数字、日期、引语和建议,在被引用的页面予以证实之前,应将其视为未经核实。.
Perplexity 消息来源可靠吗?
有些信息具有权威性,有些则不然。来源标签可以帮你判断该网站的可靠性,但无法证明某篇文章支持某一句子的说法。请核对其发布日期、来源及上下文。.
Perplexity AI 的准确率是多少?
目前尚无一个能涵盖所有查询和模式的统一百分比。最著名的公开基准测试在某项新闻来源识别任务中测得37%的错误率。报告时应注明其样本和任务,而非将其作为通用分数。.
Perplexity 引用是否意味着该主张已得到验证?
不。引用是指附上了来源。核实则需要检查该来源是否在相同的语境和范围内包含了针对该具体主张的证据。.
Perplexity 适合学术写作吗?
它有助于发现论文并制定阅读清单。打开原始论文,核实引文或研究结果,并引用该论文本身。.
Perplexity 比 ChatGPT 更准确吗?
在托中心(Tow Center)针对特定新闻来源识别的测试中,Perplexity 的表现优于 ChatGPT Search。但这并不意味着它在所有主题或模式下都能胜出。.
如何检查Perplexity的引用是否正确?
打开具体的引用条目,搜索关键词或编号,阅读前后文,并比较主题、范围、日期和方向。若匹配不成功,请标记为“未核实”。.
即使链接有效,Perplexity 是否仍可能引用了错误的来源?
是的。该页面可以是活跃的且相关,但仍然无法支持该具体主张。主张与来源的匹配比仅仅检查URL是否解析更有用。.
想要一个带参考文献的研究工作区吗? 如果您希望直接获取研究经验,并希望在一个地方比较各种人工智能工作流,请探索 Perplexity 至 GlobalGPT。.
在 GlobalGPT 时开仓 Perplexity结论:将引用视为线索,然后对相关主张进行核实
Perplexity的引用信息能加快研究进度,因为它们为你提供了一条返回网络的途径。但这并不意味着可以省略阅读原始文献的环节。 Tow Center/CJR的研究结果是有用的证据,但其得出的37%这一数据仅适用于一项特定的新闻来源任务。它并非一个永久性的、通用的Perplexity引用评分。.
当某个论点至关重要时,请明确该论点,查阅相关引用,寻找证据,并对比上下文。这种习惯能发现那些被精美的界面所掩盖的错误,并在你需要解释答案来源时,为你提供一份经得起推敲的记录。.