快速回答: GPT-6 Luna 是 OpenAI 专为高吞吐量任务设计的模型。 官方 API 显示,标准费率下每 100 万输入令牌消耗 $0.10,每 100 万输出令牌消耗 $0.50,上下文窗口为 105 万令牌,最大输出为 12.8 万令牌。 GlobalGPT 当前列出的为 GPT-5.6 Sol 和 GPT-5.6 Luna,而非精确的 GPT-6 路径,因此必须通过 OpenAI 的 API 模型 ID 单独核对平台命名。.
OpenAI 将 GPT-6 Luna 描述为其用于专注型、高吞吐量任务的最高效模型。这一表述属于供应商的定位宣传,并非经过测量的质量评分。本评测将已发布的规格转化为采购和架构决策,并附有出处地记录了公众的反应。 我们还针对该模型ID、路径、提示词集、原始输出及使用方式进行了范围限定兼容性API测试。下文展示的任务结果仅为一次观测到的运行结果,并非官方基准测试。.
简评
在官方价格表中,Luna 是最务实的“成本优先”选项:它保留了与 Sol 相同的整体背景和输出上限,但收取的代币费率仅为后者的零头。这使其在针对性强且需要反复调用的场景中极具吸引力,但若未经受控测试,低价格并不能证明其延迟更低或质量更优。.
最有用的区分并非仅仅在于“智能”与“快速”之间,而是工作负载的形态。GPT-6 Luna 与其同系列产品拥有相同的标称上下文处理能力与输出上限,但其定位和定价使得选择不同的运行点更为合理。对比更广泛的 AI模型选择指南 和 最适合编码的人工智能模型 当任务涉及多个提供商时,请参考本指南。.
GPT-6 Luna 概览
下表遵循当前的 GPT-6 Luna 官方模型页面. 上下文容量与推荐的提示词长度并不相同,且最大输入量与标题上下文窗口是分开的。.
| 字段 | 官方估值 |
|---|---|
| 官方 API ID | gpt-6-luna |
| 服务提供商定位 | 需要高度专注且工作量大的任务 |
| 上下文窗口 | 1,050,000 个代币 |
| 最大输入 | 922,000 个代币 |
| 最大输出 | 128,000 个代币 |
| 知识分数线 | 2026年5月18日 |
| 输入/输出 | 文本+图像输入 / 文本输出 |
| 推理过程 | 无、低、中、高、超高、最大 |
| 支持的端点 | 聊天自动补全、回复、批量处理 |
这两款姊妹模型均在文档中列出的功能集内支持结构化输出、函数调用、流式处理、提示词缓存、图像输入、文件搜索和网页搜索。工具的具体行为仍取决于端点、账户和请求配置;请勿仅根据功能复选框的存在就推断工具运行成功。.
就家庭层面而言,该 GPT-6 Astra 评测 展示了相关的一篇 GPT-6 文章是如何将服务提供商文档、平台路径和归因反应区分开来的。.
GPT-6 Luna 的定价与“27.2K 规则”
按标准费率计算,该 OpenAI 定价页面 列出了每100万个令牌的$0.10输入、$0.01缓存输入、$0.125缓存写入以及$0.50输出。缓存写入量为未缓存输入量的1.25倍。 Batch 和 Flex 的定价为 50%(标准模式),Fast 模式的费率为适用费率的 2 倍,若区域处理可用,则额外增加 10%。.
| 费率类别 | 最高支持 272K 输入 | 输入值大于 272K |
|---|---|---|
| 未缓存的输入 | $0.10 / 1M | $0.20 / 1M |
| 缓存输入 | $0.01 / 1M | $0.02 / 1M |
| 缓存写入 | $0.125 / 1M | $0.25 / 1M |
| 输出 | $0.50 / 1M | $0.75 / 1M |
“长上下文”列是根据 OpenAI 的规则计算得出的:当输入量超过 272K 时,输入速率和缓存速率翻倍,且整个请求的输出量乘以 1.5。这并非混合速率计费。 作为实际预算基准,100K 输入加上 10K 输出大约需要 $0.015 在工具或区域提升之前;一个30万输入加2万输出的示例大约需要 $0.075 按长上下文费率计算。.
一个大的上下文窗口虽然很有用,但要填满它并不容易。检索、片段选择、缓存复用和输出限制比那个105万的头条数字更为重要。请参阅 GPT-6 Astra 价格明细 有关上下文阈值和缓存机制的相关说明,请参见此处。.
GPT-6 Luna API 的适配、工具和限制
OpenAI 建议在内置工具和函数调用中使用 Responses API。Chat Completions 仅在以下情况下支持函数调用: 推理_努力 已设置为 无. 这是一个在迁移前值得注意的实现细节:一个请求在语法上可能有效,却可能与您当前集成所期望的工具行为不符。.
| 能力 | 受支持或已记录的行为 |
|---|---|
| 答复 | 已支持;内置工具和函数调用 |
| 聊天自动补全 | 已支持;仅在 reasoning_effort=none 时调用该函数 |
| 批次 | 已支持;采用 50% 标准代币费率的独立处理模式 |
| 音频 / 实时 / 视频 | 该型号页面不支持此功能 |
| 图像输入 | 支持;输出仍为文本 |
| 最大输入 | 92.2万个令牌;请勿将其与105万个令牌的上下文窗口混淆 |
当前的速率限制表列出了以下标准层级。RPM 表示每分钟请求数,TPM 表示每分钟令牌数,而队列值即为批次令牌上限。.
| 层 | RPM | TPM | 批处理队列 |
|---|---|---|---|
| 第 1 级 | 500 | 500,000 | 5,000,000 |
| 第 2 级 | 5,000 | 2,000,000 | 20,000,000 |
| 第 3 级 | 5,000 | 4,000,000 | 40,000,000 |
| 第 4 级 | 10,000 | 10,000,000 | 1,000,000,000 |
| 第 5 级 | 30,000 | 180,000,000 | 15,000,000,000 |
在正式上线之前,请在您自己的账户中验证确切的层级、端点、流式传输模式和工具契约。该 《法典》使用限制指南 这有助于解释为何模型的公布上限与账户的实际可用额度并不一致。.
GPT-6 Luna 的规格意味着什么
| 阅读器职位 | 为什么合适 | 需要核实的内容 |
|---|---|---|
| 定向提取 | 该服务提供商将Luna用于处理需要高度专注且处理量大的任务,且代币费率较低。. | 定义一个模式,并测试字段格式错误或缺失的情况。. |
| 重复的摘要 | 较低的投入、缓存和产出价格,使得对重复性工作的预算编制更加容易。. | 在路由中确认缓存命中情况和输出限制。. |
| 大型输入批次 | 922K的最大输入量和1.05M的上下文容量可支持庞大的源数据集。. | 请关注272K长上下文乘法器。. |
| 开放式代理工作 | 该 API 在理论上提供了同样广泛的工具词汇。. | 在认定达到Sol级质量或延迟之前,请先运行一个受控任务。. |
这是一张拟合图,而非基准图。请使用 一体化 AI 模型工作流指南 当你真正需要决定的是如何在一个可重复的流程中切换模型,而不是哪个单一模型听起来最有力时。.
API 实践测试:三项匹配任务
我们在以下位置通过 Broly Anywhere 兼容性 API 运行了这三个相同的小任务: https://anywhere.broly.ai/v1/chat/completions 使用模型 ID gpt-6-luna:代码审查、长篇决策备忘录以及严格的JSON数据提取。这些是有用的工作流观察结果,并非官方的OpenAI基准测试或通用排名。前两次运行遇到了临时性的HTTP 503超载响应;重试后,三项任务均以HTTP 200状态码完成。.
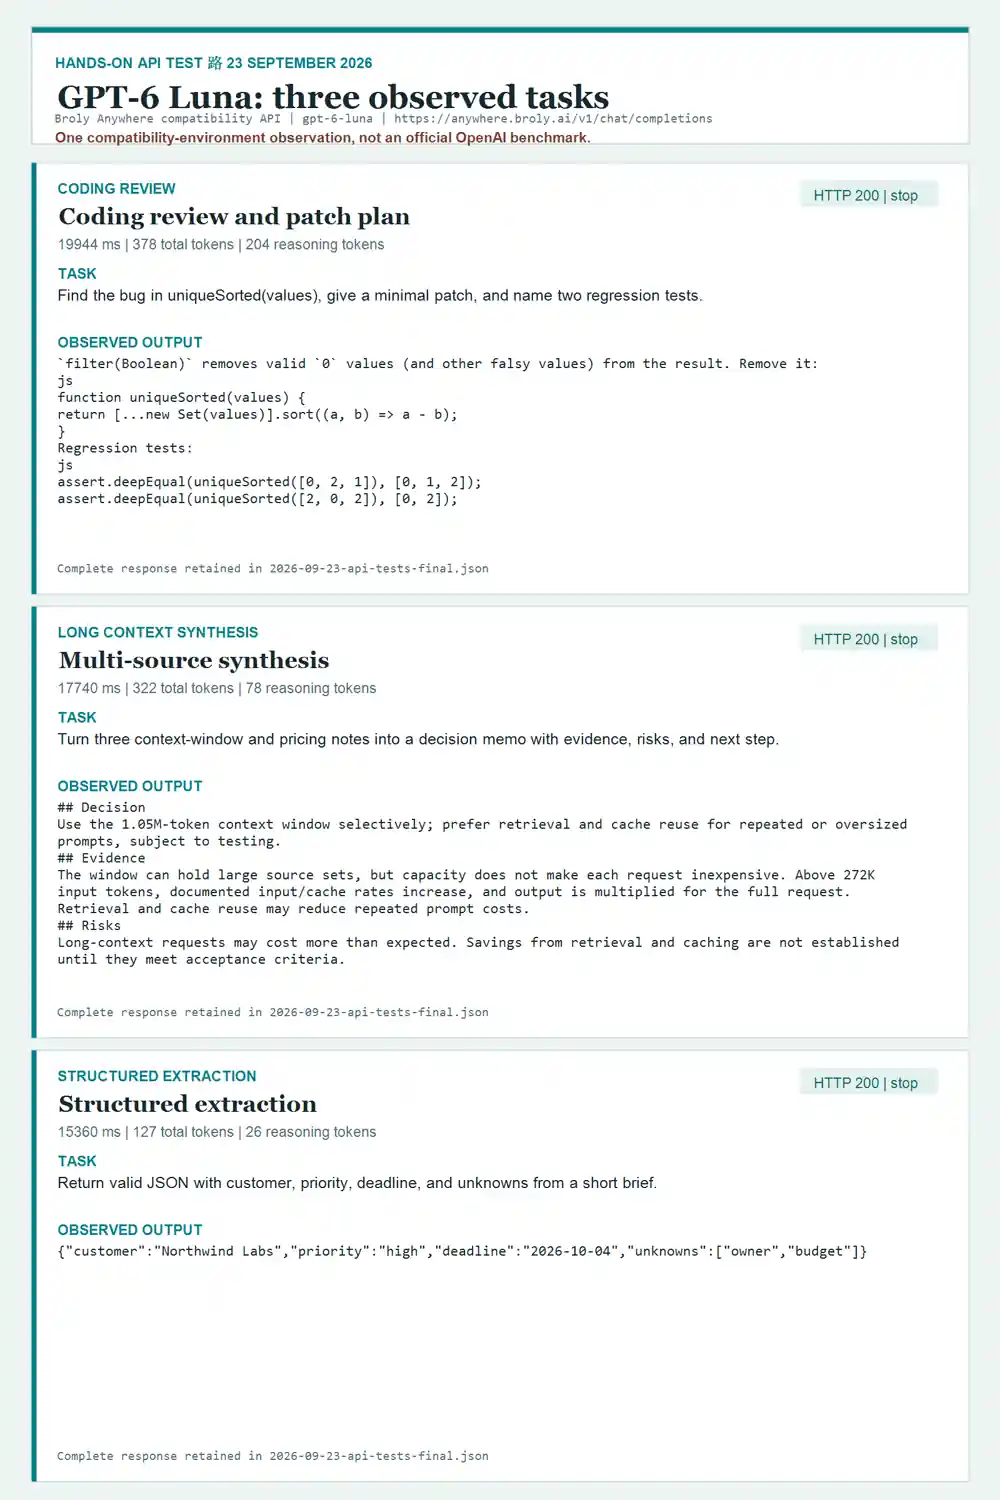
完整的 JSON 报告保留了全部提示、输出、HTTP 状态、完成原因、延迟和使用情况字段。下方的卡片在 WordPress 源代码中保留了这些信息,并支持编辑。.
代码审查和补丁计划
19944 毫秒 · 总计 378 个令牌 · 204 个推理令牌
请像审查生产环境代码库中的代码一样,审查这个简短的 JavaScript 函数。找出其中的错误,解释其失败模式,并提出一个最简补丁以及两个针对性的回归测试。 函数:function uniqueSorted(values) { return [...new Set(values)].sort((a, b) => a - b).filter(Boolean); }`filter(Boolean)` 会从结果中移除有效的 `0` 值(以及其他被视为假值的值)。将其移除:
```js
function uniqueSorted(values) {
return [...new Set(values)].sort((a, b) => a - b);
}
```
回归测试:
```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```多源合成
17740 毫秒 · 总计 322 个令牌 · 78 个推理令牌
将以下三条备注整合成一份简洁的决策备忘录,内容应包括:决策、依据、风险及后续步骤。备注 A:105 万令牌的上下文窗口虽能容纳大量源数据集,但并非每次请求的成本都很低。 备注 B:当输入令牌数超过 272K 时,已记录的输入/缓存速率会增加,且整个请求的输出量会成倍增加。备注 C:检索和缓存复用可降低重复提示的成本,但仍需对验收标准进行测试。.
## 决策
有选择地使用 105 万令牌的上下文窗口;对于重复或超大提示词,优先采用检索和缓存复用策略,但需经测试验证。

## 依据
该窗口可容纳大型源数据集,但容量并不能使每次请求的成本降低。当输入令牌数超过 272K 时,已记录的输入/缓存速率会增加,且整个请求的输出量会成倍增加。检索和缓存复用可能降低重复提示的成本。

## 风险
长上下文请求的成本可能高于预期。只有在满足验收标准后,检索和缓存带来的节省才能得到确认。

## 下一步
针对定义的质量和成本验收标准,测试具有代表性的工作负载,包括超过 272K 令牌的请求和重复提示场景。.
结构化提取
15360 毫秒 · 共计 127 个令牌 · 26 个推理令牌
从该简报中提取以下字段,并仅返回包含 customer、priority、deadline 和 unknowns 这四个键的有效 JSON 数据。简报内容:客户:Northwind Labs。优先级:高。截止日期:2026-10-04。负责人未命名,预算未确定。.
{"客户":"Northwind Labs","优先级":"高","截止日期":"2026-10-04","未知信息":["负责人","预算"]}在编程任务中,GPT-6 Luna 发现了 filter(布尔值) 并提供了一个补丁以及回归覆盖率;此次完整的运行共使用了378个令牌。在长上下文任务中,它在保留决策、证据、风险和下一步结构的同时,将27.2万条定价注意事项延续到了后续处理中;该响应共使用了322个令牌。 在结构化提取任务中,该模型以 JSON 格式返回了要求的客户、优先级、截止日期和未知数字段。这些是该路径下观察到的输出结构,并非证明某个模型普遍更优的证据。.
公众反应能告诉你什么,又不能告诉你什么
以下来源作为注明出处的公众反响被纳入其中,而非作为官方文件或受控基准证据。其标题反映了各创作者选择测试或解释的内容;这些内容并不代表整个市场的结果。.
- Chase AI: GPT 6 Sol & Luna 现已上市(而且比 50% 更便宜!). 将这种叙事框架和任何表现形式视为该创作者的个人体验,而非放之四海皆准的标准。.
- Rob “AI 专家”: ChatGPT 发布了 GPT-6 Sol 和 GPT-6 Luna(ChatGPT 的新模型与智能代理). 将这种叙事框架和任何表现形式视为该创作者的个人体验,而非放之四海皆准的标准。.
- 与苏尔亚共话人工智能: GPT-6 Soul 与 Luna 与 Claude Opus 5.5:该选哪一款?. 将这种叙事框架和任何表现形式视为该创作者的个人体验,而非放之四海皆准的标准。.
这里还有另一个命名问题:一些公开视频在标题中将“GPT-6”和“GPT-5.6”混用。在复现某项说法时,请确保准确显示模型的ID。该 GPT-6 Astra 与 GPT-5.6 Sol 的对比 这是一个很好的例子,说明了为何应将提供商标识、平台标签和路由分别记录下来。.
关于 GlobalGPT 的访问权限及 GPT-5.6 的命名说明
GlobalGPT 的经过验证的模型目录目前公开了 GPT-5.6 Sol 和 GPT-5.6 Luna. 本文中提到的确切 OpenAI API ID 是 gpt-6-luna 并属于 OpenAI 的官方文档。一个确切的 /home/gpt-6-luna GlobalGPT 路线尚未得到验证,因此本文并不主张该平台路线是 GPT-6 的访问途径。.
关于当前平台的命名及独立署名规则,请参阅 GPT-5.6 定价指南 和 GPT-5.6 模型对比. 这些页面属于平台/编辑背景信息;它们不会覆盖 OpenAI 的 API 定价表。.
此链接显示的是 GlobalGPT 当前的平台命名,而非经过验证的 GPT-6 OpenAI 模型 ID。.
打开 GlobalGPT 型号目录哪些人适合选择 GPT-6 Luna?
如果您的备选名单中包含一些价格较低的替代方案,请比较 更全面的型号目录 而不是理所当然地认为最新型号就一定最具性价比。如果您正在评估数据密集型工作,那么 数据分析模型指南 提供了一个独立的工作流视图。.
常见问题
什么是 GPT-6 Luna?
GPT-6 Luna 是 OpenAI 专为高吞吐量任务设计的模型。其官方 API 模型 ID 为 gpt-6-luna。.
GPT-6 Luna 的价格是多少?
OpenAI 显示,GPT-6 Luna 的定价为每 100 万个输入令牌 $0.10,每 100 万个缓存输入令牌 $0.01, 每 100 万次缓存写入为 $0.125,每 100 万个输出令牌为 $0.50(均按标准费率计算)。.
当输入令牌数量超过 272K 时会发生什么?
当请求的输入令牌数超过 272K 时,OpenAI 会对整个请求应用 2 倍的输入速率和缓存速率,以及 1.5 倍的输出速率。.
上下文和输出有什么限制?
GPT-6 Luna 指定的上下文窗口为 1,050,000 个令牌,最大输入为 922,000 个令牌,最大输出为 128,000 个令牌。.
知识截止点是什么?
当前的 OpenAI 模型页面显示,GPT-6 Luna 的知识截止日期为 2026 年 5 月 18 日。.
有哪些推理设置可供选择?
该 API 记录了“无”、“低”、“中”、“高”、“x高”和“最大”这几种推理难度级别,其中“中”为默认值。.
支持哪些 API 端点?
GPT-6 Luna 支持聊天补全、回复和批量处理。该模型页面未将实时处理、助手、音频、视频、图像生成、嵌入、微调、内容审核或旧版补全列为支持的功能。.
GPT-6 Luna 能处理图片吗?
是的。该模型页面列出了文本和图像输入以及文本输出。但这并不意味着它是一个图像生成模型。.
GlobalGPT 支持 GPT-6 Luna 吗?
OpenAI 的官方型号名称为 GPT-6 Luna,但 GlobalGPT 目前显示的是 GPT-5.6 Sol 和 GPT-5.6 Luna 标签。 由于尚未证实通过 GlobalGPT 访问 GPT-6 的具体路径,因此本文并不声称可通过 GlobalGPT 访问 GPT-6。.
这篇文章中包含基准测试吗?
是的,但测试范围较窄:通过 Broly Anywhere 兼容性 API 执行的三项匹配任务。测试结果被记录为一次观察到的运行,并非 OpenAI 的官方基准测试,也不代表其是通用的优胜者。.
最终判决
在官方价格表中,Luna 是最务实的“成本优先”选项:它与 Sol 保持相同的标称背景和输出上限,但收取的代币费率仅为后者的零头。这使其非常适合针对性强、重复频率高的调用,但在未进行受控测试的情况下,低价格并不能证明其延迟更低或质量更优。 发布前,请在发布当天再次核对官方模型和定价页面。.
核查日期:2026年9月23日。官方信息:OpenAI 开发团队。平台路线命名:GlobalGPT。公众反应:仅附有相关创作者和出版物的来源链接,未注明出处。.