在我們 2026 年 7 月 7 日的測試中,Claude Sonnet 5 在程式碼審查、根本原因分析、架構規劃以及長文脈推理方面,是更佳的初稿選擇。 若您需要完整的實作草案、可執行的測試骨架,或是可直接複製的範例,GPT-5.5 則是更適合的初步選擇。針對儲存庫層級的工作,建議將 Claude Code 與 Codex 進行比較,而非僅憑聊天視窗來評判這兩家公司。.
有意義的區分並非單純是「Claude 勝出」或「ChatGPT 勝出」。 截至 2026 年 9 月 27 日,Anthropic 的產品陣容包含 Claude Fable 5.1、Opus 5.5、Sonnet 5 以及 Haiku 4.5; OpenAI 的 GPT-6 系列則包含 Astra、Sol 和 Luna。產品存取權限至關重要:Sol 和 Luna 是在 ChatGPT Work、Codex 以及 API 上推出的,而公告中明確排除了一般版 Chat。 下文的實測部分仍為 Claude Sonnet 5 與 GPT-5.5 之間的過時比較,測試於 2026 年 7 月 7 日使用相同的提示語進行。如需最新的搭配比較,請參閱 Claude Opus 5.5 對比 GPT-6 Sol.
如果您希望在無需在不同訂閱方案之間來回切換的情況下比較各種模型,GlobalGPT 是一個實用的多模型工作區,內含 GPT-6 Astra 以及 Claude Opus 5.5 可在其模型選擇器中使用。它對於比較程式碼答案、規劃、編寫及研究都很有幫助,但無法取代 Claude Code、Codex、官方 API、整合開發環境(IDE)或具備儲存庫意識的開發工作流程。.

目錄
- Claude 對決 ChatGPT:程式設計篇——快速解答
- 2026 年發生了什麼變化
- 現行編碼模型系列
- 效能測試概覽:SWE-Bench、Terminal-Bench 及其意義
- 我們如何測試 Claude 和 ChatGPT 的程式設計能力
- 測試 1:除錯與根本原因分析
- 測試 2:重構與可維護性
- 測試 3:多檔案推理與規劃
- 測試 4:單元測試與驗證
- 測試 5:安全性與可靠性審查
- 克勞德・科德與《科德克斯》:當聊天已不足以應付時
- 定價:Claude、ChatGPT、Codex 和 GlobalGPT
- 您應該選擇哪種編碼設定?
- 為什麼許多開發者仍然同時使用這兩者
- 常見問題
Claude 對決 ChatGPT:程式設計篇——快速解答
在我們 7 月 7 日針對相同提示進行的聊天測試中,當問題含糊不清時,Claude Sonnet 5 展現出更強的初次回應表現:它優先考量可能的成因、篩除雜訊,並清晰闡明風險。 當後續步驟是包含進口指令、測試骨架及更多程式碼細節的完整實作草案時,GPT-5.5 的表現則更為出色。這些觀察結果僅針對該次測試,並不代表未來每個模型版本的表現。.
就日常開發而言,最佳的工作流程通常是:
- 先使用克勞德 適用於程式碼審查、錯誤分類、架構決策,以及「我該先檢查什麼?」這類問題。.
- 請先使用 ChatGPT 用於生成初始實作、撰寫測試骨架、製作範例,以及將計畫轉化為程式碼。.
- 兩者都使用 適用於資料遷移、涉及安全的變更、付款、身分驗證、檔案上傳,以及任何可能損毀生產環境資料的操作。.
| 程式設計需求 | 更佳的首輪選秀權 | 為何 |
|---|---|---|
| 除錯一個棘手的錯誤 | 克勞德首發 | 在我們的測試中,Claude 優先考量了可能的肇因,並清楚闡明了故障路徑。. |
| 撰寫完整的實作草案 | 先看 ChatGPT | 在我們的測試中,GPT-5.5 提供了更完整的程式碼以及更多可直接使用的程式架構。. |
| 審查安全性或可靠性風險 | 先是克勞德,然後是 ChatGPT | Claude 清楚地對嚴重性進行了分級;ChatGPT 則補充了具體的實作模式。. |
| 在儲存庫中修改檔案 | Claude 《Code》或《Codex》 | Repo 的背景、指令執行、測試及差異比純聊天式的回答更重要。. |
如果你最關心的問題是,哪個模型家族在整體編碼方面最為合適,那麼從更廣泛的角度來看, 最適合編碼的 AI 模型 這篇比較文章是值得進一步閱讀的參考資料。若您主要考慮在 OpenAI 生態系統內做出決策,〈最佳 ChatGPT 編碼模型指南〉一文則針對 GPT 模型的選擇提供了更詳盡的說明。.
2026 年有哪些變化
一項有用的 2026 年比較必須將三項轉變納入考量。.
首先,《克勞德·索內特 5》改變了克勞德一方的決定。. Anthropic 說明 Sonnet 5 適用於所有方案,並包含在 Claude Code 中,開發者可透過 Claude Platform 存取該功能。這點至關重要,因為 Claude 已不再僅是提供程式碼解說的聊天助理;它已是 Anthropic 程式碼代理工作流程的一部分。.
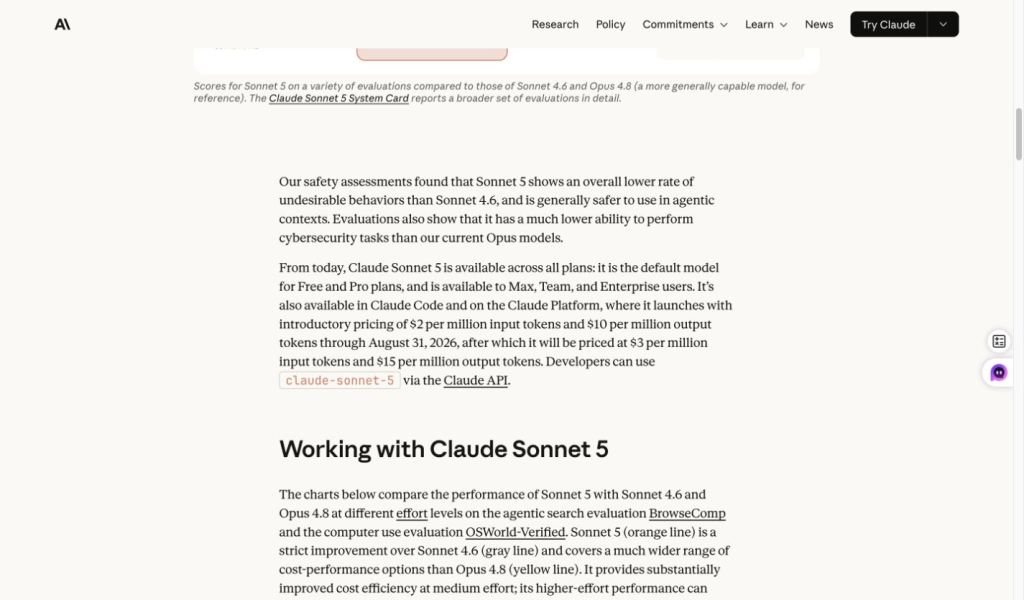
其次,GPT-6 目前是 OpenAI 用於編碼工作的標準模型系列。. Astra 鎖定複雜的軟體工程領域;Sol 和 Luna 則提供更經濟實惠的選擇。. OpenAI 於 9 月 22 日發布的公告 在 ChatGPT Work 和 Codex 中,列出了 Sol 和 Luna 適用於 Plus、Pro、Business、Enterprise 及 Edu 方案;此外,Luna 亦可供 Free 和 Go 方案的用戶在桌面應用程式中使用。該說明明確指出,這些模型目前尚未在 Chat 中提供。API 存取將另行計費。.
第三,聊天助理和程式設計代理分別負責解決工作中的不同環節。. 純文字聊天對於分享程式碼片段、除錯、說明及規劃都相當實用。. Claude 《法典》與《經叢》 這是一系列支援儲存庫的工作流程,旨在檢查檔案、執行指令、測試變更,並能跨大型任務運作。公平的比較應將聊天輸出品質與程式碼代理產品的實際功能區分開來。.
現行編碼模型系列
截至 2026 年 9 月 27 日,編碼對比已成為一項陣容決策,而非單純的 Claude 對決 ChatGPT 的對戰:
| 側面 | 值得考慮的現行機型 | 最佳程式設計應用 |
|---|---|---|
| 克勞德 | Claude Fable 5.1、Claude Opus 5.5、Claude Sonnet 5 以及 Claude Haiku 4.5 | 長上下文審查、規劃、除錯、主動式編碼,以及 Claude Code 工作流程。. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol 及 GPT-6 Luna;ChatGPT Work、Chat、Codex 和 API 的可用性各不相同 | 實作、前端開發、測試、工具使用工作流程,以及 Codex 相關任務。. |
| GlobalGPT | GPT-6 Astra 以及 Claude Opus 5.5,已於 GlobalGPT 中驗證;這是一項獨立的平台訂閱服務 | 並列提示比較、日常程式碼問題、研究及方法評估。. |
若您正在追蹤 Claude 的存取權限與方案詳情,請參閱另一份 克勞德 AI 2026 年計畫 指南,以及更詳盡的 Claude AI 定價指南。若您正在比較 OpenAI 方案,則 ChatGPT 訂閱方案 2026 年細項分析是更簡明扼要的參考資料。.
效能測試概覽:SWE-Bench、Terminal-Bench 及其意義
基準測試之所以有用,是因為它們能顯示模型在受控的編碼任務中表現如何。關鍵在於要仔細理解每個基準測試實際測量的是什麼。儲存庫問題基準測試、終端機代理程式基準測試,以及官方模型發布表格所傳達的訊息並不相同,因此應與下文所述的實際操作測試一併使用。.
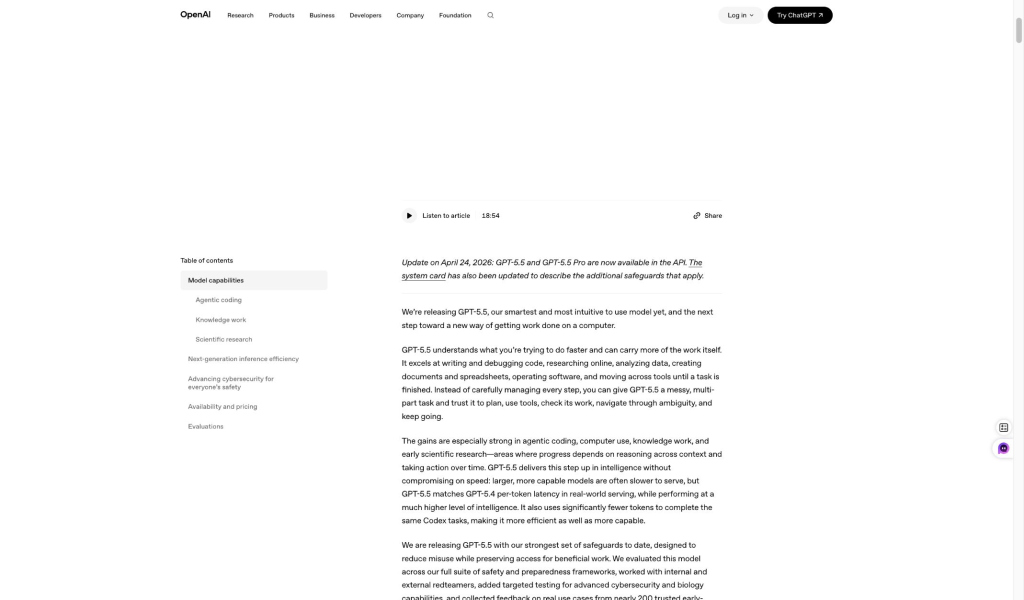
GPT-5.5 根據測驗日期所獲得的編碼證據
以下關於 GPT-5.5 的資料之所以保留,是因為它與 7 月 7 日實機比較中使用的機型相符。 該資料支持測試專區中以實作為主的觀察結果,但不應被解讀為當前的 OpenAI 模型陣容;GPT-6 現已成為主要產品系列,其存取方式因 ChatGPT Work、一般版 Chat、Codex 及 API 而有所不同。.
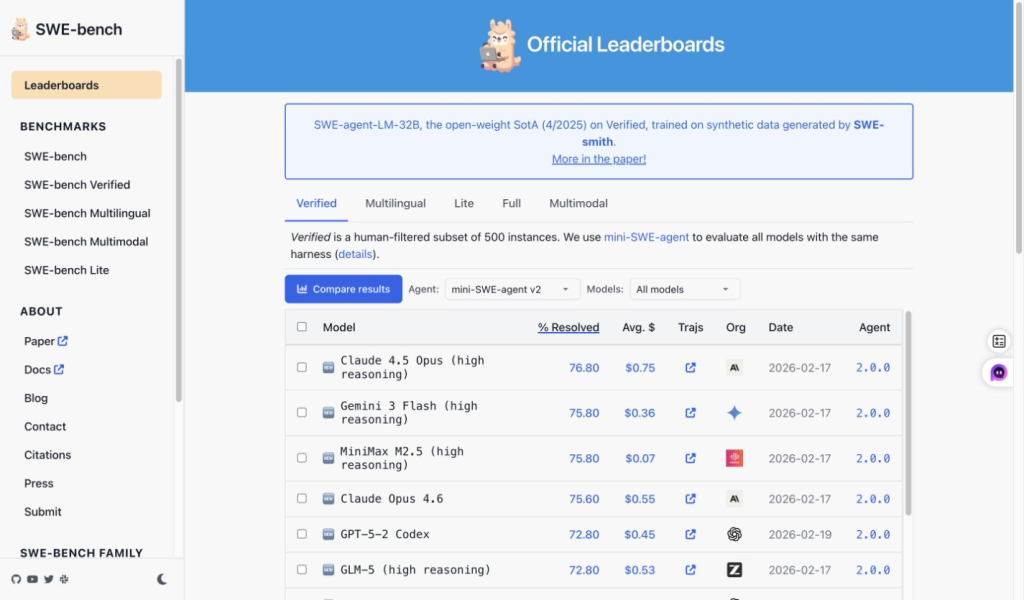
SWE-Bench:儲存庫問題解決
SWE-Bench 這項功能之所以有用,是因為它比僅提供短程式碼片段的提示更貼近實際的軟體維護情境。它會檢視儲存庫中的問題,並評估模型能否產生能解決該任務的修改內容。 就 Claude 與 ChatGPT 的比較而言,這雖能反映出兩者在軟體工程方面的實力,但仍無法完整呈現解釋品質、審查判斷,或是答案在聊天工作流程中實際感受到的實用性等面向。.
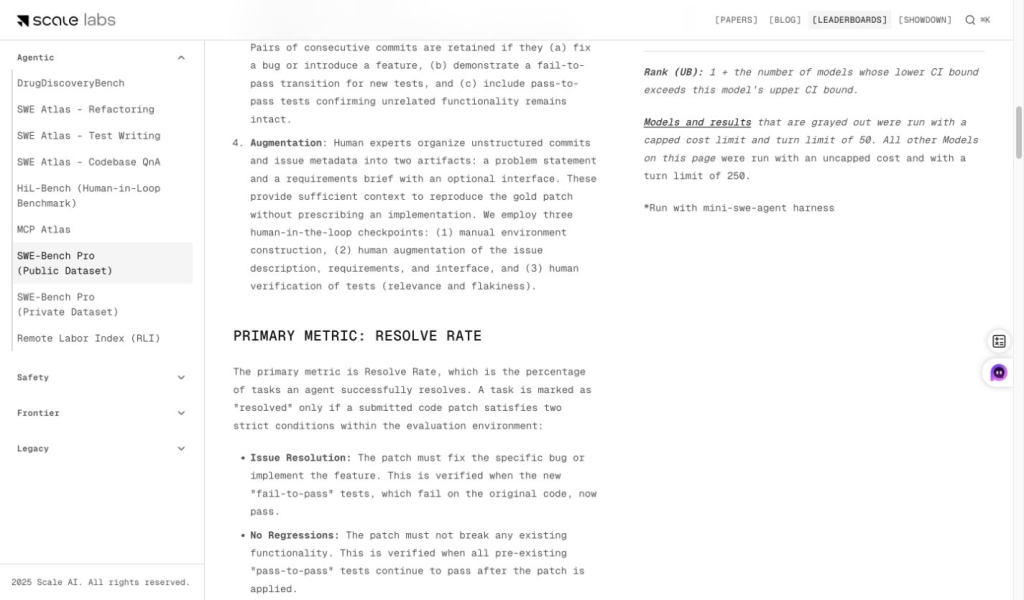
SWE-Bench Pro:更具挑戰性的編碼任務與解題率
Scale 的 SWE-Bench Pro 公開排行榜 這是一項更具挑戰性的指標,因為它著重於更嚴苛的儲存庫任務,並以「解決率」作為主要衡量標準。當您重視「程式碼代理」的實際能力時,這項指標最為有用:不僅是檢視模型能否解釋錯誤,更在於它能否在基準測試條件下,引導儲存庫朝著可運作的修正方案邁進。.
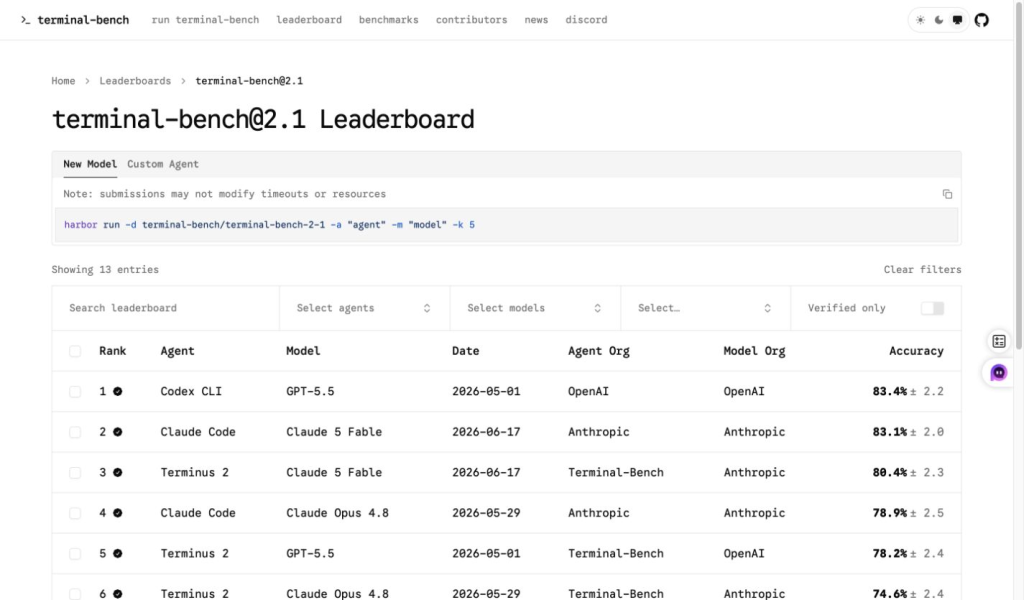
Terminal-Bench:命令列與代理程式工作流程任務
Terminal-Bench 2.1 它與 SWE-Bench 的不同之處在於,它著重於透過代理程式/模型設定來完成終端機和命令列任務。這使得它對於 Claude Code 和 ChatGPT Codex 風格的工作流程而言,比單純的「撰寫此函式」聊天提示更具相關性。 若您正在為儲存庫層級或命令列工作挑選程式碼助理,此基準測試應納入決策考量。.
| 證據 | 最適合閱讀的對象是 | 實用要點 |
|---|---|---|
| OpenAI GPT-5.5 程式設計教材 | GPT-5.5 的程式設計與以代理為導向的軟體工程定位。. | ChatGPT 作為一款著重實作的程式設計助手,獲得了強大的支持。. |
| SWE-Bench | 儲存庫問題的解決與軟體維護任務。. | 這是編碼能力的良好指標,特別是在儲存庫背景至關重要的情況下。. |
| SWE-Bench Pro | 更困難的儲存庫任務與解決率的比較。. | 有助於評估嚴肅的行為主體編碼能力。. |
| Terminal-Bench 2.1 | 終端機任務、指令執行,以及代理程式/模型設定。. | 與其說是簡單的聊天提示,不如說這與 Claude Code 和 Codex 的工作流程更相關。. |
基準測試雖使這兩大程式設計範式都成為值得信賴的選項,但並不能決定日常工作流程的選擇。以下各節針對除錯、重構、規劃、單元測試及安全性審查,均採用相同的提示,以便您了解實際應用中兩者的答案有何差異。.
我們如何測試 Claude 和 ChatGPT 的程式設計能力
我們於 2026 年 7 月 7 日在 GlobalGPT 上測試了 GPT-5.5 和 Claude Sonnet 5,並採用相同的介面與相同的提示語。 此次測試的目標並非重現完整的 IDE 代理程式基準測試,而是比較日常編碼輔助功能:除錯、重構、多檔案推理、撰寫測試程式碼以及安全性審查。.
評分標準很簡單:正確性、根本原因推論、可維護性、邊界情況涵蓋度、驗證,以及遵循指示。這使得評比結果更貼近開發人員實際使用 AI 程式碼助理的情況。.
測試 1:除錯與根本原因分析
第一個提示要求兩個模型檢視一個將票券依優先級分組的 JavaScript 函式。這個錯誤雖然不易察覺,但很常見:該函式試圖將資料推入 acc[ticket.priority] 在該陣列存在之前。.
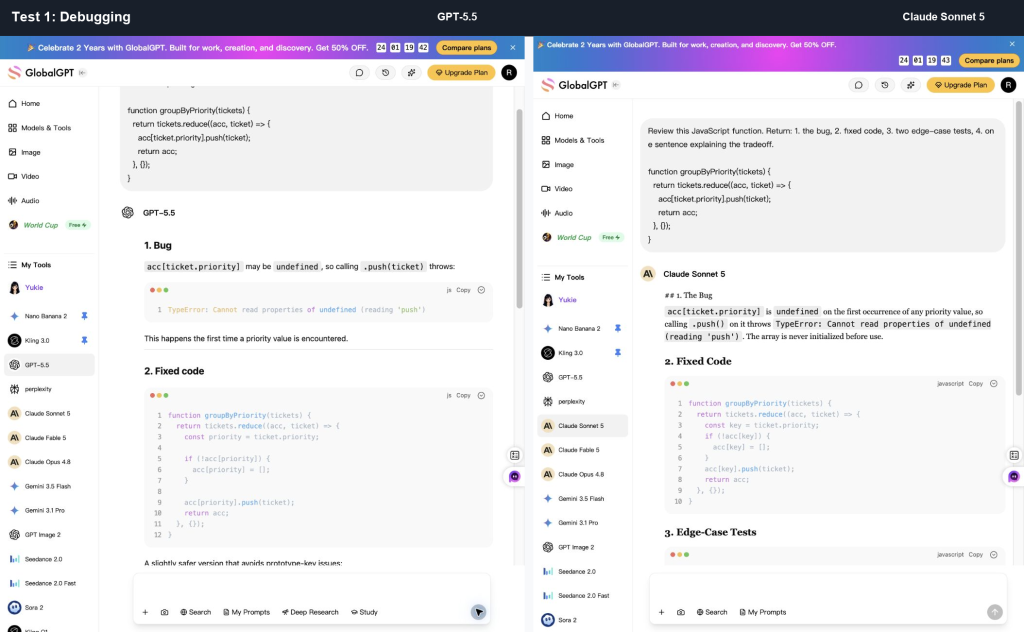
ChatGPT 的優點: GPT-5.5 找到了這個錯誤,提供了修正後的程式碼,新增了邊界情況的測試,並加入了更為謹慎的 Object.create(null) 變體。當物件鍵可能與繼承而來的屬性發生衝突時,這項額外的實作細節便派上用場。.
克勞德做得好的地方: Claude Sonnet 5 發現了相同的錯誤,並給出了更精確的解答。這也提出了一個「優先級未定義」的邊緣案例,這正是審閱者應予以考量的實務邊界。.
優勝者: 平手,但在實作細節方面,ChatGPT 略勝一籌。Claude 的程式碼更簡潔;GPT-5.5 的程式碼則更完整。.
測試 2:重構與可維護性
第二個提示要求在不改變行為的前提下,進行可讀性重構。這是一個很好的測試,因為許多 AI 編碼答案會對小型輔助程式進行過度重構,導致產生的變動部分比原始程式碼所需的還要多。.
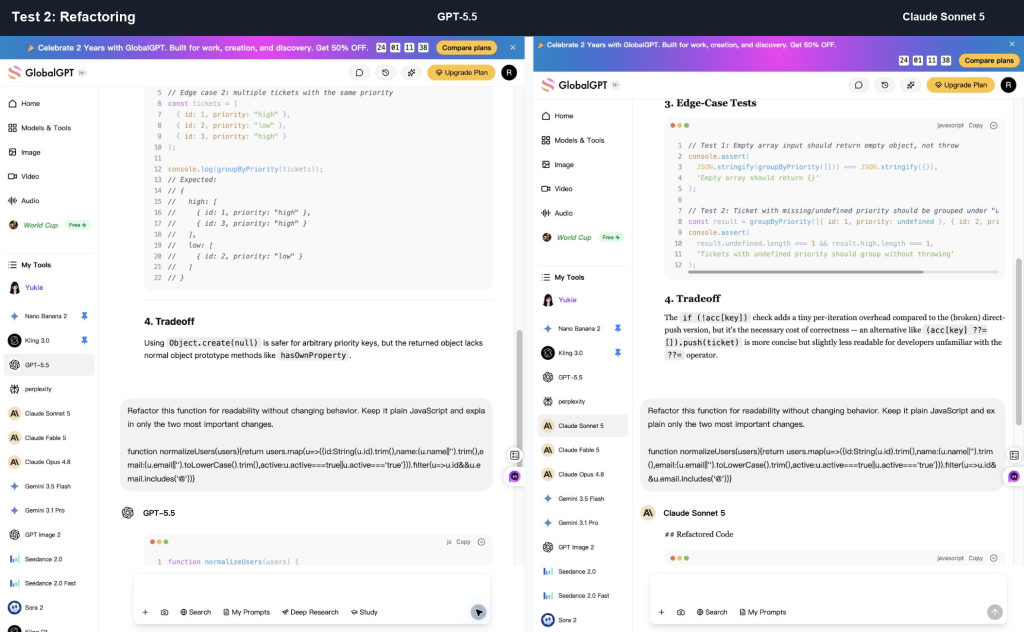
ChatGPT 的優點: GPT-5.5 盡量保留了原始的結構,引入了命名的中間變數,並嚴格遵循了「僅進行兩項重要變更」的指示。當使用者希望進行保守的重構時,這一點非常有價值。.
克勞德做得好的地方: Claude Sonnet 5 將正規化函式和驗證函式等輔助函式抽離出來。此舉雖使意圖更易於檢視,但相較於 GPT-5.5,它對結構的改變幅度更大。.
優勝者: ChatGPT 用於控制;Claude 用於提升模組化可讀性。若您需要進行安全且最小的重構,請先從 ChatGPT 開始。若您希望獲得更清晰的領域命名,請請 Claude 進行二次審閱。.
測試 3:多檔案推理與規劃
第三個練習題提供了一個小型 Next.js 檔案結構,以及一份錯誤報告:已登入的使用者可以上傳小檔案,但當進度條達到 100% 時,超過 8MB 的檔案會無提示地上傳失敗。.
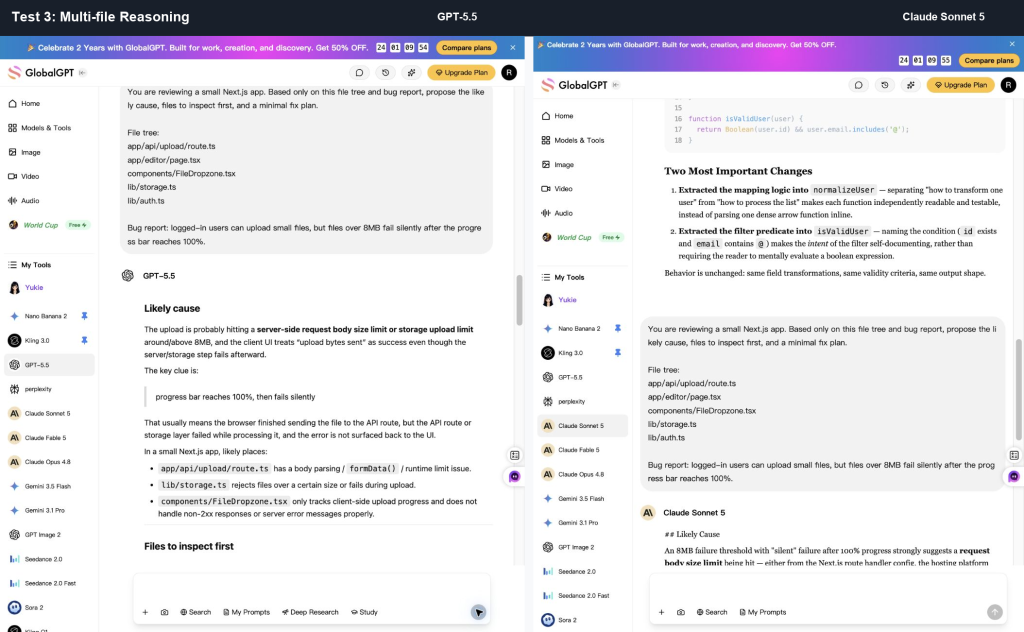
ChatGPT 的優點: GPT-5.5 產出了一份詳盡且著重於實作的計畫。其中提到了伺服器規模檢查、客戶端回應處理,以及儲存錯誤的傳播。.
克勞德做得好的地方: 克勞德的第 5 首十四行詩立即將焦點放在 8MB 的門檻上,這很可能是受平台或機身尺寸的限制、進度條的語義,以及 7MB/8MB/9MB 的驗證路徑所致。這更像是一份高階審查筆記。.
優勝者: 克勞德。它能更快地鎖定可能的肇因,並提供更精準的最低限度檢查路徑。.
測試 4:單元測試與驗證
第四個提示要求兩個模型為一個輔助函式編寫 TypeScript 單元測試,該輔助函式會傳回上傳及 Codex 存取的方案限制。此測試旨在驗證模型能否防止分支邏輯在未來發生回歸問題。.
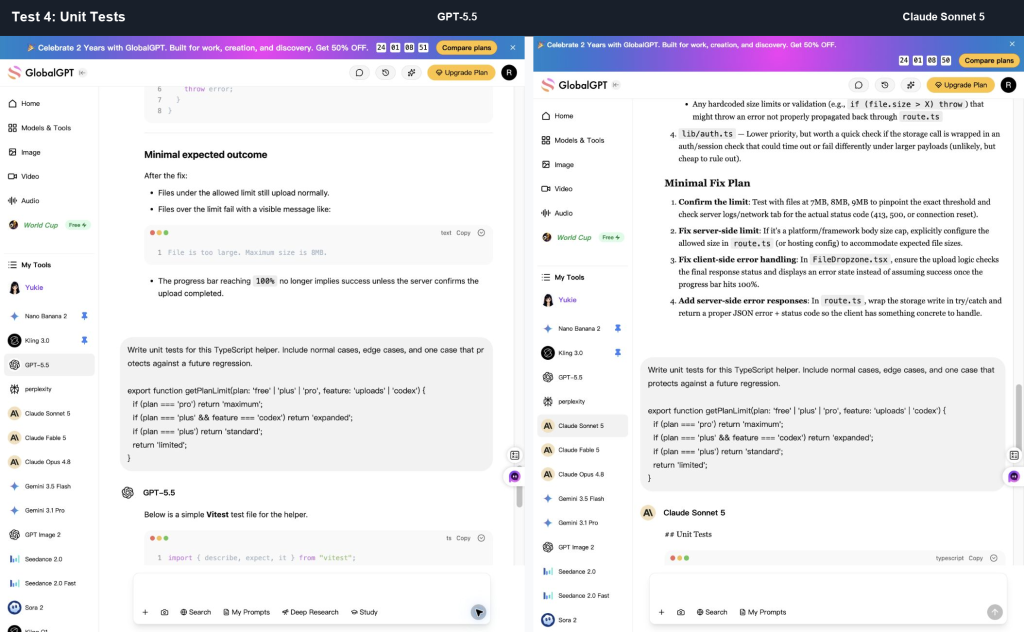
ChatGPT 的優點: GPT-5.5 包含測試框架的匯入指令,並產生了一個看似可執行的 Vitest 檔案。該檔案涵蓋了預期的所有組合,且讓使用者能輕鬆將結果貼入專案中。.
克勞德做得好的地方: 克勞德·索內特第 5 首十四行詩更清楚地闡述了真正的回歸風險: pro + codex 必須在針對特定功能的檢查之前就進行短路。雖然作為檔案而言,它的即用性較低,但這是一個更具說服力的解答。.
優勝者: Claude 用於測試推理;ChatGPT 用於生成起始檔案。實際操作時,先使用 ChatGPT 撰寫測試草稿,再由 Claude 進行評析,以確認這些測試能否確保系統展現正確的行為。.
測驗 5:安全性與可靠性檢討
第五個提示要求兩個模型都檢視一個 Express Webhook 端點。一個好的答案應涵蓋簽名驗證、原始內容要求、幂等性、驗證、資料庫錯誤處理以及請求大小限制。.
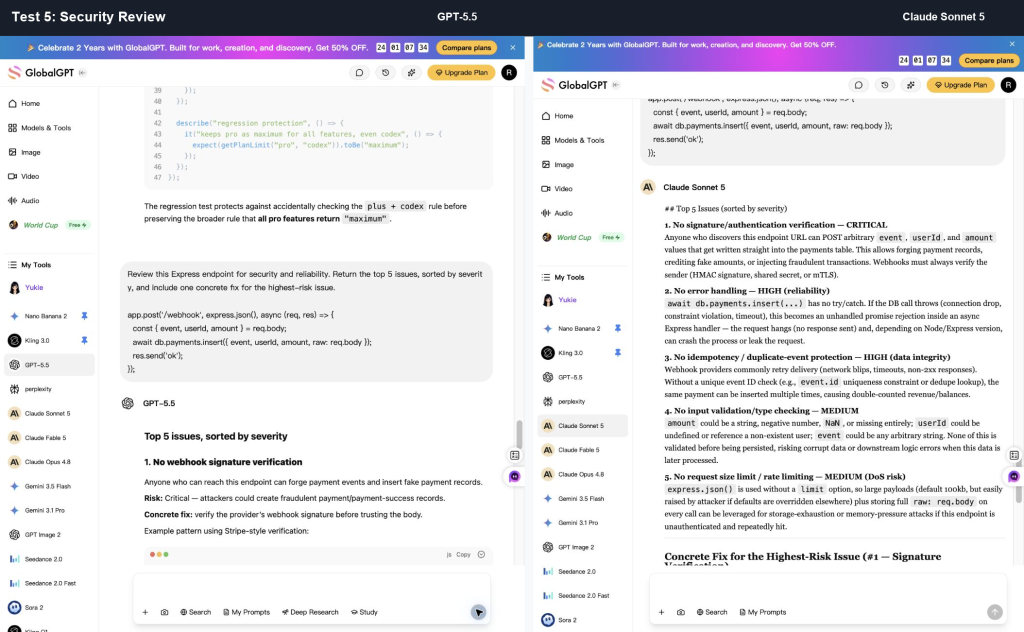
ChatGPT 的優點: GPT-5.5 提供了一種服務供應商風格的解決方案,其中包括類似 Stripe 的 express.raw() 模式。當下一步是要實作具體的 webhook 處理程式時,這就派上用場了。.
克勞德做得好的地方: 克勞德的第 5 首十四行詩提供了更清晰嚴謹的推理,並運用恆定時間比較概念,納入更穩妥的簽名比對細節。這使得風險排名的判斷更顯精準。.
優勝者: 平手,但在安全說明方面,Claude 略勝一籌。這兩種模型都足夠強大,足以發揮實用價值,但無論哪種答案,都不應取代針對支付或驗證流程所進行的實際安全審查。.
Claude Code 對決 ChatGPT Codex
聊天輸出僅是編碼決策的一部分。Claude Code 與 Codex 是兩套獨立的代理開發工作流程,適用於涉及檔案、指令、測試、拉取請求或更廣泛的程式碼庫變更等任務。.
| 工作流程 | 最適合 | 重要的界線 |
|---|---|---|
| 克勞德聊天 | 推理、除錯、檢視、說明與規劃。. | 除非它與工具或更廣泛的工作流程相連,否則它只能看到您提供的上下文。. |
| ChatGPT 聊天 | 實作草案、測試、範例以及 API 使用相關問題。. | 即使是極具說服力的答案,仍需在您的專案中進行驗證。. |
| 克勞德·科德 | 符合 Repo 規範的程式設計、程式碼庫導覽、測試,以及大型任務的規劃。. | 在接受變更之前,請先審閱權限設定、安全性政策以及提出的差異對比。. |
| 《古籍》 | 支援 Repo 的實作、除錯、測試、審查,以及與 OpenAI 整合的程式碼工作流程。. | 方案的存取權限、使用方式及模型可用性與一般聊天功能有所不同,且可能會隨時間而變動。. |
務實的做法:將聊天模型用於思考、解釋及處理小型任務;當工作需要參考儲存庫背景資訊及可執行的步驟時,則使用 Claude Code 或 Codex。.
定價:Claude、ChatGPT、Codex 和 GlobalGPT
首先,請問問自己究竟是在為什麼付費。 聊天方案是用來支付每日互動式程式設計協助的費用。程式設計代理工作流程則用於支付與儲存庫相關的工作,例如 CLI、IDE、網頁、雲端任務或整合服務。API 定價是以每百萬個標記為單位計費。多模型工作區則讓您能在同一個平台中,更輕鬆地在 Claude、GPT、Gemini、Perplexity 及其他模型之間切換。.
2026年9月27日查閱的價格均以美元計價,且未含相關稅費。此表格分別列出消費者訂閱方案、標準 API 代幣費率,以及 GlobalGPT 自身的年度方案。. Claude 的定價頁面 rounds Pro 的年度費用相當於每月 $17;若預先支付 $200,則相當於每月 $16.67。.
| 產品或方案 | 顯示價格 | 這對程式設計意味著什麼 |
|---|---|---|
| 消費者 · Claude 免費 | $0 | 足以應付簡單的程式設計問題,並在付費前試試 Claude 的風格。. |
| 消費級 · Claude Pro | 每月 $20;每年預付 $200(相當於每月 $16.67) | 包含 Claude 代碼;聊天功能及 Claude 代碼共享皆計入付費方案的使用量。. |
| 消費級 · Claude Max | 每月 $100 起 | 更高用量方案;已包含 Claude 代碼。API 控制台的計費為獨立項目。. |
| 消費者 · ChatGPT 免費 | $0/月 | 輕量版聊天功能;GPT-6 Luna 的桌面版存取方式與一般聊天功能有所不同。. |
| 消費者 · ChatGPT Go | 原始美國參考資料中為 $8/月;當地價格可能有所不同 | 每月訂閱;請查閱當地定價頁面,以確認您所在市場的價格。. |
| 消費者 · 聊天GPT Plus | 每月 $20,每月計費 | 定期提供程式設計提示,並可使用符合資格的 Codex/Work 服務;API 使用費用將另行計費。. |
| 消費者 · ChatGPT Pro | 每月 $100;現有的每月 $200 訂閱方案將繼續生效 | 自 2026 年 9 月 10 日起,將暫停受理 $200 的新訂閱與升級申請。$100 訂閱服務仍可繼續申請。. |
| API · 克勞德·索內特 第五首 | $2/M 輸入;$10/M 輸出 | 適用於程式碼編寫工具及大範圍上下文工作流程的標準 API 費率。. |
| API · Claude Opus 5.5 | $4/M 輸入;$20/M 輸出 | 標準速度。快速模式的輸入參數為 $8/M,輸出參數為 $40/M。. |
| API · GPT-6 Astra | $10/M 輸入;$50/M 輸出 | 標準 API 費率;與 ChatGPT 方案分開計算。. |
| API · GPT-6 Sol / Luna | Sol:$2/M 輸入,$10/M 輸出;Luna:$0.10/M 輸入,$0.50/M 輸出 | 開發者計費應分開處理;請使用確切的模型 ID 和費率。. |
| 平台 · GlobalGPT 基礎版 | 相當於每月 $5.80;按年計費為 $69.60 | 這是一種經濟實惠的方式,可針對日常編碼提示與研究,比較多個模型系列。. |
| 平台 · GlobalGPT Pro | 相當於每月 $10.80;每年計費為 $129.60 | 在日常工作中於多個產品系列之間切換時,能提供更佳的適應性。. |
| 平台 · GlobalGPT 無限版 | 相當於 $25/月;$300 按年計費 | 適用於在單一工作區中頻繁進行多模型比較。這些方案不包含官方 API 配額,亦不包含原生 Claude Code/Codex 訂閱。. |
對大多數個人開發者而言,決策重點並非「哪家公司最便宜?」,而是「哪個價格最符合工作流程?」。如果你主要是在提問和貼上程式碼片段,那麼 Claude Pro 或 聊天GPT Plus 這樣可能就足夠了。若您需要支援 repo 的實作方式,請比較 Claude Code 與 Codex 的存取權限。若您每天都需要比較多個模型,GlobalGPT 將能提供更簡潔的日常工作空間,因為其費用僅與單一的多模型方案掛鉤,而非多個獨立的訂閱方案。.
對於以 API 為主的程式設計工具而言,訂閱價格並非合適的比較標準。由於程式碼的上下文範圍龐大,代幣定價反而更為重要。. 克勞德·索內特 第五首 在標準速度下,其輸入成本為 $2/M,輸出成本為 $10/M;而 Opus 5.5 的輸入成本為 $4/M,輸出成本為 $20/M。 因此,100萬個輸入代幣加上100萬個輸出代幣,在 Sonnet 5 上需消耗 $12,而在 Opus 5.5 上則需消耗 $24。 對於 OpenAI,相同的使用量在 Astra 上按標準費率需消耗 $60,在 Sol 上需消耗 $12,或在 Luna 上需消耗 $0.60。 這些屬於 API 費用,並非包含在 ChatGPT、Claude 或 GlobalGPT 訂閱方案中的配額。.
該選擇哪種編碼設定?
請不要僅憑模型名稱來選擇。應根據您實際進行的程式設計工作類型來選擇。同一位使用者在日常工作中,可能會使用 ChatGPT 進行初步實作、Claude 進行審查、Codex 處理可執行儲存庫相關工作,以及 GlobalGPT 進行快速的模型並行比對檢查。.
初學者學習程式設計: 先從 ChatGPT 開始。它通常會提供更多範例、更完善的引導,並能讓您更順暢地從「我不明白這個錯誤」過渡到「這就是可運作的結構」。“
初級開發人員正在修復錯誤: 當問題尚不明朗時,建議先從 Claude 開始。Claude 擅長縮小可能原因的範圍、指出應優先檢查的項目,並讓解釋保持重點清晰。之後若需要具體的修補程式、測試案例或實作範例,再使用 ChatGPT。.
資深工程師審查變更: 先從 Claude 開始。它更適合用於權衡取捨、嚴重性排序、架構考量以及簡明扼要的評論。若要處理較大的程式碼庫任務,請從聊天模式切換至 Claude Code 或 Codex,這樣模型就能處理檔案和指令,而非僅是貼上的程式碼片段。.
前端或使用者介面建構工具: 首先使用 ChatGPT 進行初稿。它通常能產出更完整的元件程式碼、狀態處理機制以及測試骨架。接著使用 Claude 來審查無障礙性、元件邊界、命名規範,以及程式碼是否過於花俏而與設計不符。.
大型程式碼庫維護者: 請根據您的技術堆疊、帳戶存取權限、安全政策以及偏好的工作流程,選擇 Claude Code 或 Codex。一旦任務涉及多個檔案,代理程式的工作流程通常比哪個聊天回覆聽起來更動聽更為重要。.
獨自創業或小型團隊: 若預算允許,建議同時使用這兩大模型系列。一個實用的配置方案是:日常模型比較及「從構想到程式碼」的提示任務使用 GlobalGPT,而當任務需要存取程式碼儲存庫及執行步驟時,則搭配使用 Claude Code 或 Codex。.
| 開發者類型 | 最佳首選 | 為何 |
|---|---|---|
| 初學者學習程式設計 | 聊天GPT | 更多範例、更詳盡的說明,以及適合初學者的學習引導。. |
| 初級開發人員正在修復錯誤 | 克勞德首發 | 更清晰的根本原因分析,以及更完善的「優先檢查此處」指引。. |
| 資深工程師正在審查一項變更 | 克勞德 | 在權衡取捨、風險排序及簡明評析方面表現更為出色。. |
| 前端/使用者介面開發人員 | ChatGPT 排第一,Claude 排第二 | ChatGPT 負責草擬該組件;Claude 則負責審查其無障礙性、結構與可維護性。. |
| 大型程式碼庫維護者 | Claude Code 或 Codex,視堆疊與存取方式而定 | 檔案、指令、測試和權限,比單一的聊天室回覆更為重要。. |
| Solo 創辦人 | 兩者皆可,通常透過單一的多模型工作區來實現 | 當產品由一人負責時,快速草擬、仔細審閱以及迅速切換模型都至關重要。. |
如果您正在抉擇較新的 Claude 與 GPT 模型系列,Claude Opus 5.5 與 GPT-6 Sol 的比較將提供更多針對特定模型的背景資訊。如果您正在評估付費的 OpenAI 方案,則 ChatGPT Plus vs Pro 透過比較,可以幫助判斷是否值得增加使用量。.
為什麼許多開發者仍然同時使用這兩者
同時使用 Claude 和 ChatGPT 並非優柔寡斷,而是能建立更完善的品質控制循環。.
- 與克勞德共同規劃,透過 ChatGPT 執行: 當您希望使用 Claude 來降低風險,並使用 ChatGPT 來生成第一個實作版本時,這會很有幫助。.
- 使用 ChatGPT 撰寫草稿,並由 Claude 進行審閱: 當您需要快速編寫程式碼,卻又希望獲得更嚴格的第二意見時,這會很有幫助。.
- 在接觸生產環境之前,請先確認以下兩點: 適用於付款、驗證、上傳、資料遷移、快取以及會破壞資料庫的變更。.
- 當任務需要檔案時,請使用代理程式: 當模型需要儲存庫背景資訊時,「克勞德代碼」(Claude Code)或「克勞德手稿」(Codex)的重要性可能比一般聊天內容更高。.
當任務涉及提示比較、日常編碼協助、規劃或研究時,GlobalGPT 便符合「兩者兼用」的模式。它特別適用於日常模型比較、草稿迭代、快速徵求第二意見,以及選擇最適合下一項工作的模型風格。.
若您僅在評估 Claude 的存取權限,那麼 最佳 Claude AI 替代品 這份清單是一份更廣泛的備用指南。.
常見問題
在 2026 年,編寫程式時,是 Claude 還是 ChatGPT 更勝一籌?
在進行程式碼審查、模糊的除錯、架構規劃以及長上下文推理時,請優先選擇 Claude。 在撰寫實作草稿、範例、前端開發及測試骨架時,請優先選擇 ChatGPT。當任務需要存取儲存庫、執行指令、執行測試或進行多檔案編輯時,請將 Claude Code 與 Codex 進行比對,而非僅依賴聊天功能。.
在除錯方面,Claude 是否比 ChatGPT 更勝一籌?
Claude 通常更適合作為首次除錯步驟,因為它傾向於優先處理最可能的成因,並清楚闡明失敗路徑。在我們的 JavaScript 和 Next.js 測試中,Claude Sonnet 5 在簡明扼要的診斷方面表現尤為出色。當修復方案需要更完整的實作細節時,ChatGPT 依然表現出色。.
ChatGPT Codex 是否比 Claude Code 更優越?
這兩者都並非對每支團隊而言都自動更優。ChatGPT Codex 適合以 OpenAI 為核心的工作流程,以及需要大量實作的代理任務。當工作能從 Claude 的規劃、審查及長文脈推理風格中受益時,Claude Code 便展現出強大優勢。 究竟哪種選擇更佳,取決於儲存庫存取權限、定價、技術堆疊、權限設定以及團隊政策。.
對於大型程式碼庫來說,哪一種比較好?
對於大型程式碼庫而言,代理工作流程的重要性遠高於單純的聊天模型。當助理需要檢視檔案、執行指令、執行測試,或跨模組追蹤行為時,請使用 Claude Code 或 Codex。針對權限、高風險指令以及最終的差異比對結果,仍需保留人工審查。.
對於剛開始學習程式設計的初學者來說,哪一種比較好?
對於初學者來說,ChatGPT 通常比較容易上手,因為它傾向於提供更多範例、更詳盡的說明,以及可直接執行的程式碼片段。當初學者卡在某個問題上,不明白為何會失敗,並需要更清晰的概念性解釋時,Claude 則可能更為合適。.
對於前端 HTML 和 UI 程式碼來說,哪一種比較好?
ChatGPT 在生成 HTML、CSS 或元件的初稿方面通常更為出色。Claude 則擅長審查結構、簡化版面配置,以及發現無障礙性或可維護性問題。若要完成精緻的前端作品,建議使用 ChatGPT 進行草擬,並由 Claude 進行審閱。.
哪種模型更適合撰寫測試?
若您需要包含導入語句且結構看似可執行的完整測試檔案,ChatGPT 會是更好的選擇;若您想了解哪些行為需要保護,以及回歸測試為何重要,Claude 則更為合適。一個有效的作業流程是:先用 ChatGPT 生成測試案例,然後詢問 Claude 還缺少哪些邊界情況。.
像 SWE-Bench 這樣的基準測試,能否證明哪款程式碼輔助工具更優越?
不。SWE-Bench、SWE-Bench Pro 和 Terminal-Bench 雖是極具價值的指標,特別是對於以代理為導向的編碼工作流程而言,但它們並不能完全預測日常編碼的實務協助。基準測試衡量的是受控的測試環境;而真正的開發人員還需要清晰的推理、實用的程式碼、易於維護的變更,以及完善的驗證步驟。.
開發者應該同時使用 Claude 和 ChatGPT 嗎?
是的,特別是針對嚴肅的工作。請使用 Claude 來進行規劃、風險評估和診斷;使用 ChatGPT 來撰寫實作草稿、範例以及測試框架。接著執行程式碼、檢視差異,並在您自己的專案中驗證行為。.
我可以在 GlobalGPT 中將 Claude 和 ChatGPT 進行比較嗎?
是的。當所需模型已存在於同一個工作區時,GlobalGPT 便能協助您在該工作區內比較 Claude 與 ChatGPT 的解答。它非常適合用於日常的程式碼問題、規劃、研究以及尋求第二意見。 它並不能取代 Claude Code、Codex、整合開發環境(IDE)、官方 API 或儲存庫層級的工具。.