
Claude Fable 5.2 против Opus 5.5: программирование, стоимость и выбор
Пять задач с одинаковыми запросами сравнивают Claude Fable 5.2 и Opus 5.5 в исследованиях, дизайне ИИ-интерфейсов, написании текстов, работе с данными и планировании продукта, с оригинальными скриншотами и зафиксированным временем и использованием токенов.
 Chloe Murphy

Opus 5.5 — разумная отправная точка для рутинной работы; протестируйте Fable 5.2, когда конкретная задача всё ещё требует улучшения. В наших четырёх завершённых парах текстовых задач обе модели правильно выполнили ключевой исследовательский расчёт и метрики данных. План продукта Fable более аккуратно учёл одну неопределённость; оба письменных результата соответствовали основным ограничениям.
Сравнение дизайна использует новый согласованный прогон на 32 768 токенов. Его скриншоты, проверки взаимодействия и ограничения приведены в задании по дизайну ниже.
Fable 5.2 новее и стоит дороже за токен. Но даёт ли он лучший результат — или просто больший счёт? Мы сравнили исследования, дизайн ИИ-интерфейсов, написание текстов, анализ данных и продуктовые решения, используя одинаковое техническое задание для каждой модели.
Если вы предпочитаете сравнивать модели без управления отдельными настройками API, GlobalGPT предлагает мультимодельное рабочее пространство. Приведённые здесь тесты API не подтверждают доступность Fable 5.2 внутри GlobalGPT.
Практическое сравнение
| Решение | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Стандартный ввод / вывод на миллион токенов | $8 / $40 | $4 / $20 |
| Исследовательский тест | Расчёт верен; причинно-следственная формулировка требует правки | Расчёт верен; деталь дизайна исследования не подкреплена |
| Тест контента | Объяснение на 180 слов; более короткая озвучка | Объяснение на 180 слов; более полный пример |
| Тест данных | Все запрошенные показатели верны | Все запрошенные показатели верны |
| Тест продукта | Тщательное различие между подтверждённым и возможным вредом | Полезный план; неподтверждённое утверждение о потерянной работе |
| Первоначальная попытка дизайна | Нет артефакта: ошибка HTTP | Полный HTML после очистки блоков кода |
Как мы тестировали две модели
В каждой задаче использовались одинаковые исходные материалы, новый диалог и одинаковый лимит вывода для обеих моделей. В текстовых задачах использовался лимит в 16 000 токенов; в финальном прогоне дизайна — 32 768. Подсказки, настройки, время и использование указаны вместе с соответствующей задачей ниже.
Все исследования, продукты, данные заказов и отзывы в брифингах были вымышленными тестовыми фикстурами. Мы проверили расчеты по подготовленному ключу ответов. Усилие рассуждения оставалось на уровне платформы по умолчанию, поэтому это не бенчмарк с равными усилиями. Метки моделей, возвращаемые сторонним шлюзом, не устанавливают независимо маршрутизацию вверх по потоку.
Исследователь: синтез без преувеличения доказательств
Тот же промпт · Тест исследователя
You are a researcher. Use only these FICTIONAL study summaries about an AI writing assistant. A: randomized 120 adults, 60 per arm, intervention mean score baseline70 followup78, control baseline69 followup74, four weeks; no standard deviations, uncertainty intervals, or attrition information reported. B: observational 300 adults, usage correlated with writing scores r=.32, no confounder adjustment. C: interviews with12 users reporting perceived improvement. In under650 words synthesize evidence with A/B/C citations, calculate difference in changes, explain what cannot be inferred, and propose a feasible preregistered followup study with primary endpoint and analysis. Do not invent citations or statistical significance.
Задача исследователя требовала синтеза трех вымышленных исследований, включая рандомизированное испытание с неполной отчетностью. Существенный расчет был (78 − 70) − (74 − 69) = 3 балла. Обе модели ответили правильно и отказались выдумывать статистическую значимость.
Fable 5.2
Предложил слепую оценку письма без посторонней помощи, анализ намерения лечить и проверки чувствительности к отсутствующим данным. Также привел явно гипотетический пример размера выборки.
«Только разница в 3 балла объясняется ассистентом»
Эта формулировка была слишком уверенной с учетом неизвестного отсева и пробелов в отчетности, даже несмотря на то, что последующие абзацы уточняли оценку. Также предполагалось, что участники интервью, вероятно, были самоотобранными.
Opus 5.5
Четко разделил рандомизированные, наблюдательные и интервью-доказательства. Предложил исследование с поправкой на исходный уровень и сохранил расчет размера выборки зависимым от вариабельности пилотного исследования.
«по своей природе поперечное, как описано»
Предоставленное наблюдательное резюме не уточняло поперечный дизайн. Эта деталь должна была остаться неизвестной.
Если вы адаптируете этот бриф, сохраняйте доказательства неизменными и просите каждую модель отделять сообщаемые факты от выводов. Наши Промпты Claude для исследований и программирования предлагают больше примеров ограничений, специфичных для задачи.
Designer: рабочее пространство с несколькими моделями ИИ
Тот же промпт · Тест Designer
You are a product designer and frontend builder. Return only one complete self-contained HTML file with inline CSS and JavaScript, no external assets/CDNs. Build a polished AI multi-model workspace called Parallel. Give it a distinctive cohesive visual identity with excellent typography, whitespace, hierarchy and responsive layout; choose your own palette. Include sidebar, model A/B selectors, prompt textarea, compare button, two side-by-side result cards, loading state, clear button, per-result copy button, empty-input validation, keyboard-accessible controls and mobile stacking. Models A/B are FICTIONAL; all outputs must be locally simulated and explicitly labeled demo. No real API calls or fake live performance metrics. Compare must work repeatedly and preserve the submitted prompt in both outputs. Copy must report success only after actual success, otherwise provide an error. Aim for a complete compact artifact, not an explanation.
Бриф дизайнера просил обе модели создать Параллель: автономное рабочее пространство для сравнения ИИ с боковой панелью, селекторами моделей, вводом подсказки, смоделированными карточками результатов, проверкой, элементами управления копированием и мобильной компоновкой. Мы оставили цветовую палитру и визуальную идентичность открытыми.
Финальный совпадающий прогон использовал тот же промпт, потоковую передачу и общий лимит в 32 768 токенов. Оба ответа достигли нормальной остановки. Исходные артефакты остаются неотредактированными; при сохранении HTML удаляется только охватывающее Markdown-ограждение, если оно есть.
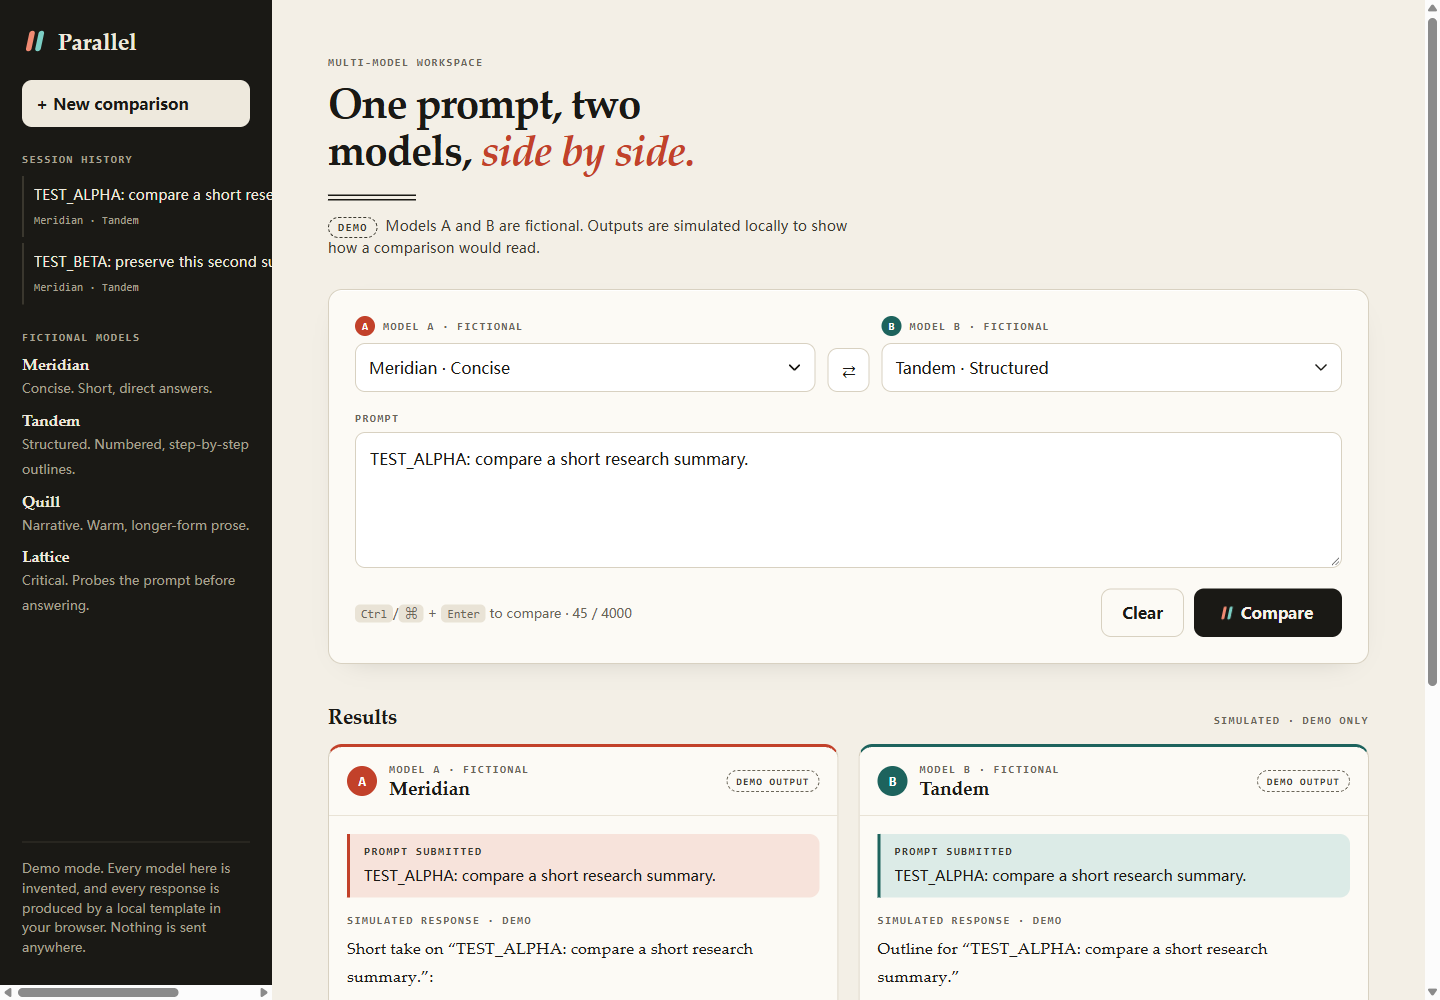
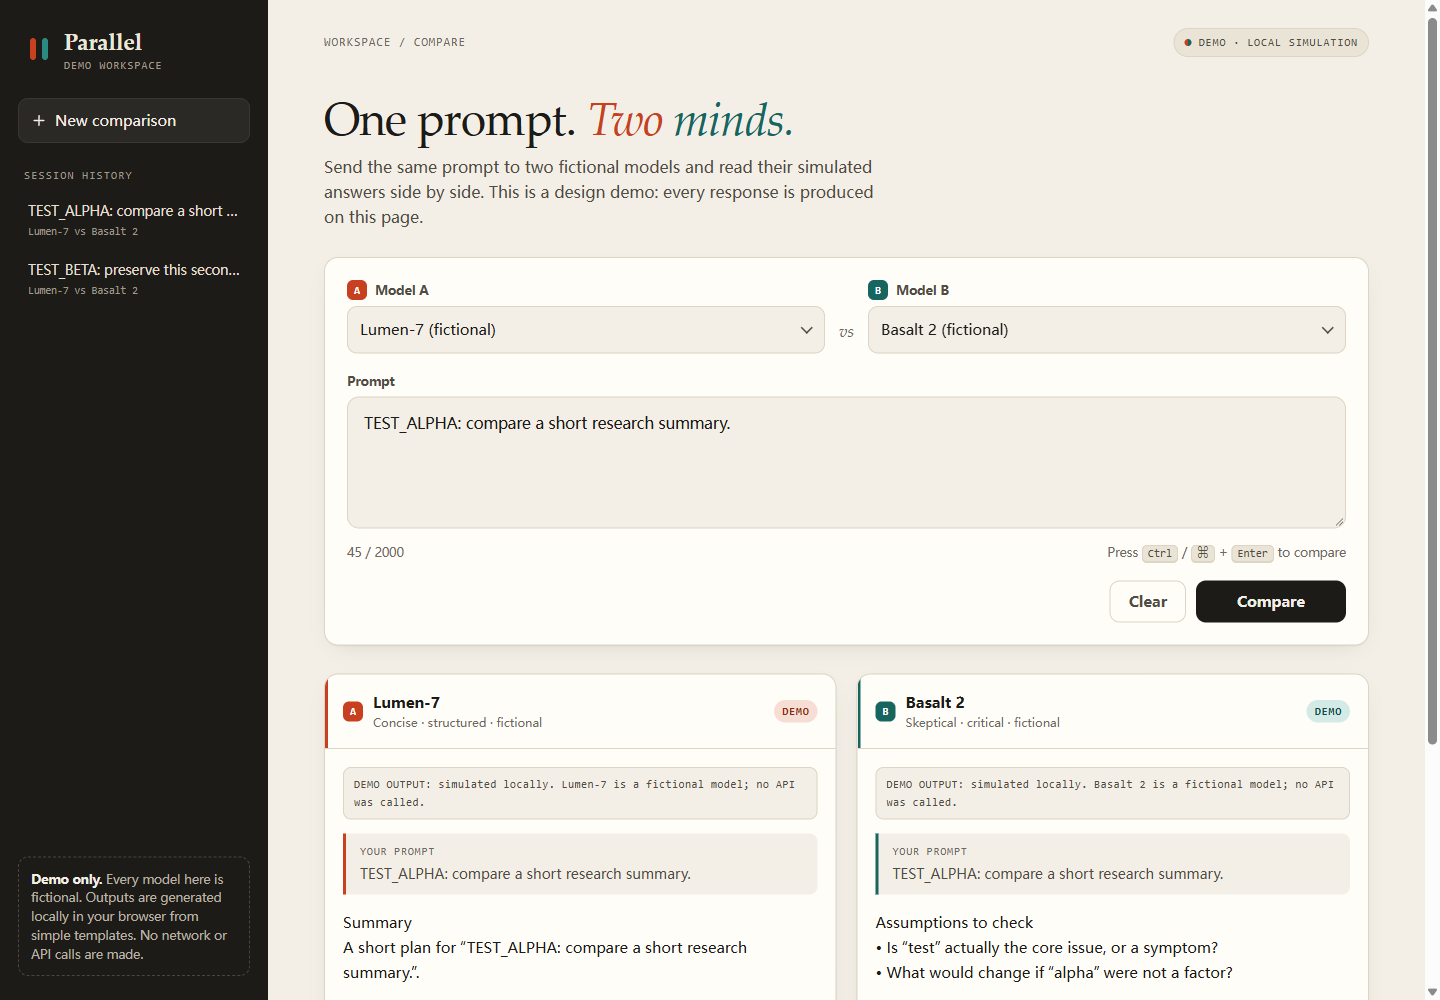
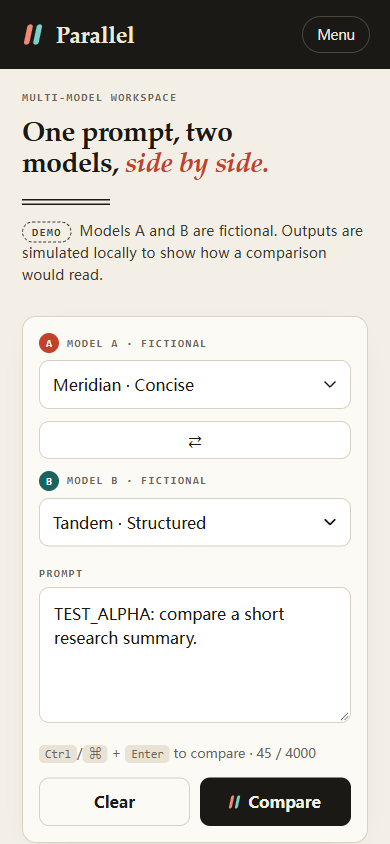
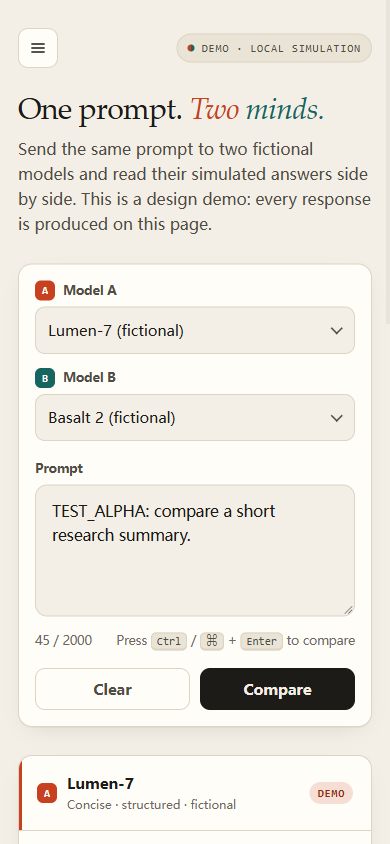
Как на самом деле выглядели отрендеренные страницы
Пример Fable 5.2
Более тяжелый заголовок с засечками, курсивное красное выделение и высококонтрастная боковая панель придают этой странице более сильную редакционную идентичность. Элемент управления сменой модели — полезное дополнение, но на мобильных устройствах он занимает целую строку и отодвигает подсказку и результаты вниз.
Пример Opus 5.5
Более легкий заголовок и более простая область выбора модели выглядят сдержаннее. При том же мобильном окне просмотра кнопка «Сравнить» заканчивается примерно на 710 пикселях от верха, против 826 пикселей в образце Fable, оставляя место для более раннего появления первой карточки результата.
Оба выбрали теплые бумажные тона, темные боковые панели и заголовки с засечками. Разница здесь в иерархии и плотности, а не в совершенно другом языке дизайна.Для этого конкретного рабочего пространства мы предпочитаем компактный макет образца Opus.Если приоритетом является более заметный редакционный заголовок, образец Fable обладает такой привлекательностью. Это субъективное предпочтение между этими возвращенными артефактами, а не общая эстетическая оценка базовых моделей.
Проверки браузера: внешний вид и поведение отдельно
| Проверить | Образец Fable | Образец Opus |
|---|---|---|
| Проверка пустого ввода | Пройдено | Пройдено |
| Повторные сравнения сохраняют отправленный запрос | Пройдено | Пройдено |
| Видимая обратная связь при загрузке | Пройдено | Пройдено |
| Очистить ввод | Пройдено | Пройдено |
| Переполнение страницы при ширине 390 пикселей | Не измерено | Не измерено |
| Сбой копирования честно сообщает об ошибке | Пройдено | Пройдено |
| Успешное копирование в буфер обмена | Не проверено | Не проверено |
Мы открыли неотредактированные выходные данные в Chrome и использовали элементы управления DOM для выполнения проверок. Скриншоты рабочего стола используют 1440 × 1000; мобильные скриншоты используют 390 × 844. Все четыре показывают один и тот же отправленный запрос после сравнения и перед проверкой копирования. Во время этих шагов не было зафиксировано исключений времени выполнения. Записи в буфер обмена не удались в автоматизированном сеансе, и полный обход только с клавиатуры не тестировался.
Использование финальной пары дизайнов дает прокси по стандартной ставке в размере $0.8826 для Fable и $0.2918 для Opus. При этом используются тарифы провайдеров и токены, сообщенные шлюзом, исключаются предыдущие попытки, и это не фактический счет шлюза.
Предыдущие попытки и ограничения доказательств
Создатель контента: точный текст в двух форматах
Тот же промпт · Тест создателя контента
You are a content creator. Based ONLY on these FICTIONAL product facts, write a180-word plain-English explainer and a45-second video script with timestamps, then a five-item fact-check checklist. Facts: Lumen is a fictional AI workspace; it lets users compare two AI text drafts side by side, save prompts locally in their browser, and manually copy a chosen result. It does not publish content automatically, browse the web, or verify facts. No prices, launch dates, speed metrics, supported model names, or privacy guarantees are provided. Audience: freelancers who struggle to choose a usable first draft. Explain a practical example, avoid hype and invented claims, and distinguish local prompt saving from an unproven no-training guarantee.
Бриф для создателя предоставил вымышленное рабочее пространство только с тремя функциями: параллельное сравнение черновиков, локальное сохранение промптов и ручное копирование. Требовался пояснительный текст на 180 слов, сценарий на 45 секунд и контрольный список проверки фактов из пяти пунктов.
Оба пояснительных текста соответствовали требованию в 180 словсогласно нашему правилу подсчета слов, которое сохраняет внутренние апострофы и дефисы внутри слова. Оба сохранили ограничения функций и правильно избежали трактовки локального хранилища как гарантии отсутствия обучения.
Fable 5.2
Начал с трудности фрилансера в выборе черновика, затем объяснил три функции короткими предложениями. Закадровый голос видео содержал 101 слово: около 135 слов в минуту при произнесении за 45 секунд.
Opus 5.5
Использовал более подробный пример копирайтера, противопоставляя более сильное вступление более ясным объяснениям функций. Его закадровый голос содержал 109 слов: около 145 слов в минуту за тот же промежуток времени.
Эти оценки темпа взяты из письменного закадрового текста, а не из хронометрированной записи. Fable оставляет больше места для пауз; Opus использует больше времени для объяснения примера.
Для более длинных статей наше руководство использование Claude для написания длинных текстов рассказывает, как отделить черновую работу от проверки и редактирования.
Аналитик данных: возвраты, отсутствующая атрибуция и ROAS
Тот же промпт · Тест аналитика данных
You are a data analyst. Use only this synthetic data. Orders CSV(order_id,updated,status,channel,amount): o1,1,paid,Search,100; o2,1,paid,Social,80; o2,2,refunded,Social,80; o3,1,paid,Search,120; o4,1,pending,Email,60; o5,1,paid,,50; o6,1,paid,Partner,90; o7,1,paid,Email,70; o8,1,paid,Social,60; o9,1,paid,Partner,110. Channel spend/clicks: Search200/100; Social100/80; Email50/40; Partner0/20. Deduplicate by order_id keeping greatest updated. Paid orders count and revenue use latest paid only; refunded/pending contribute zero. Blank channel must remain Unknown and cannot inherit spend/clicks. Calculate overall paid count, revenue, each channel paid count/revenue/conversion rate per click/ROAS, and measurable ROAS ranking; zero or missing denominator is N/A. Show arithmetic and propose a cautious next-budget decision without inferring causality. Return table and explanation under600 words.
Задача аналитика была разработана для выявления ошибок, которые может скрыть аккуратная таблица: дублирующиеся идентификаторы заказов, последующий возврат, отложенный заказ, неизвестный канал и партнерский канал с нулевыми расходами.
Обе модели совпали с подготовленным ключом ответов: 7 оплаченных заказов и 600 дохода после сохранения последнего статуса заказа. Они исключили возвращенные и отложенные записи, сохранили отсутствующую атрибуцию под «Неизвестно» и пометили неопределенные соотношения как N/A.
| Канал | Оплаченные заказы | Доход | Конверсия / клик | ROAS |
|---|---|---|---|---|
| Поиск | 2 | 220 | 2.00% | 1.10 |
| Социальные сети | 1 | 60 | 1.25% | 0.60 |
| Электронная почта | 1 | 70 | 2.50% | 1.40 |
| Партнер | 2 | 200 | 10.00% | Н/Д: нулевые расходы |
| Неизвестно | 1 | 50 | Н/Д | Н/Д |
Fable показал арифметику доходов в таблице каналов и предложил проверить возвраты, отложенные заказы, отсутствующие теги и незарегистрированные затраты партнеров, прежде чем что-либо существенно менять. Opus добавил таблицу дедупликации по каждой записи и подсчитал, что неприписанный доход составил 8,3% от общего.
Оба рекомендовали тест с ограниченным бюджетом, а не рассматривать наблюдаемый ROAS как причинное доказательство. Замечание Opus о том, что одна дополнительная продажа в соцсетях примерно удвоит ROAS, предполагает схожую сумму заказа; это не было новым фактом во входных данных.
Продакт-менеджер: вред прежде голосов за функции
Тот же промпт · Тест продакт-менеджера
You are a product manager for a FICTIONAL AI subscription workspace. Feedback: 2 users report duplicate charges after retrying checkout; billing logs confirm one duplicate captured charge. 30 users request dark mode. 8 report one model unavailable and no warning before using a prompt; outage reproduced. 1 requests account/data deletion; request pending for20 days, governing deadline unknown. 12 request reusable saved prompts. 4 want team seats; no revenue commitment. Two engineers available for one week; effort estimates unknown. Produce a one-week priority plan with rationale, explicit unknowns, scope boundaries, owner roles, acceptance criteria, instrumentation and rollback/containment steps. Do not fabricate legal deadlines, revenue, effort or certainty. Distinguish immediate containment from permanent fixes; do not rank purely by vote count. Under700 words.
В брифе продукта сочетались подтверждённое двойное списание, просроченный запрос на удаление от пользователя, воспроизведённый сбой модели и более популярные запросы функций. Ловушка заключалась в том, чтобы отдать приоритет 30 голосам за тёмную тему, а не доказанному вреду.
Обе модели поставили биллинг, последующие действия по удалению и сдерживание сбоев выше разработки функций. Ни один не выдумал юридический срок для удаления. Оба назначили роли владельцев, отделили немедленное сдерживание от постоянных исправлений и предложили приёмочные проверки и мониторинг.
Fable 5.2
Указал сверку возвратов, исправление для предотвращения повторных списаний и ручное сдерживание сбоев. Он явно рассматривал возможную потерю квоты как то, что нужно подтвердить, и пометил удаление как необратимое.
Opus 5.5
Добавлено предупреждение перед отправкой, сохранение подсказок и явное правило против незаметной смены моделей. Таблицу приоритетов было легко просмотреть.
Однако в нём говорилось, что пользователи «молча теряют работу и подсказки». Предоставленные отзывы подтверждали сбой и отсутствие предупреждения, но не доказанную потерю подсказок.
Цены Fable 5.2 и Opus 5.5
Для стандартных запросов API Fable 5.2 стоит вдвое дороже за токен, чем Opus 5.5. Это делает Opus более дешёвой отправной точкой, когда обе модели дают приемлемый результат при схожем расходе токенов.
Ввод / вывод
Ввод / вывод
Это стандартные тарифы на ввод/вывод Anthropic, проверенные 11 ноября 2026 года, изспецификация Fable.
спецификация Opus указана соответствующая стандартная ставка. Быстрый режим, кэширование, пакетные скидки, потребительские подписки и выставление счетов третьими лицами имеют разные условия.
Для иллюстративного запроса с 10 000 входных токенов и 5 000 выходных токенов расчет по стандартному тарифу составляет $0,28 для Fable и $0,14 для Opus. Это рабочий пример, а не счет из наших тестов.
Более высокая ставка за токен не означает более высокую стоимость за успешную задачу. Более короткий ответ, меньше раундов правок или меньше рассуждений могут изменить итог. Наши однораундовые тесты не могут установить долгосрочную экономию.
Если вы интегрируете любую из моделей в приложение, руководство по настройке Claude API рассматривает вопросы настройки отдельно от сравнения тарифов на токены здесь.
Умножение использования, сообщенного шлюзом, на стандартные тарифы Anthropic дает прокси на основе тарифов в размере $0,4291 для Fable против $0,1799 для Opus по этим четырем задачам. Формула: входные токены × входной тариф + выходные токены × выходной тариф, деленное на один миллион. Это исключает все запросы на проектирование и неудачные вызовы.прокси на основе тарифов: $0,4291 для Fable против $0,1799 для Opus по этим четырём задачам. Формула: входные токены × входной тариф + выходные токены × выходной тариф, делённое на один миллион. Это исключает все запросы на дизайн и неудачные вызовы.
Этот прокси не фактическая плата шлюза. Мы не проверяли его счёт-фактуру, эквивалентность учёта токенов или наценку. Он также не измеряет стоимость последующего редактирования человеком или дополнительных попыток.
Что устанавливают официальные бенчмарки
Оценка запуска Anthropic даёт Fable преимущество в нескольких сложных задачах. В таблице ниже воспроизведены три заявленных балла; это оценки провайдера, отдельные от наших собственных ролевых тестов.
| Оценка | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0 | 49.1% | 45.5% |
| FrontierSWE v2 | 69.9% | 62.3% |
| Terminal-Bench-Science 0.1 | 74.6% | 58.7% |
отчёт о запуске использует максимально доступное усилие каждой модели, если не указано иное. Эти оценки поддерживают попытку использовать Fable для сложной технической работы; они не устанавливают универсального преимущества в письме, оценке продукта или визуальном вкусе.
Обе модели указывают контекстное окно в один миллион токенов и лимит вывода в 128 000 токенов. Эти ограничения здесь не подвергались стресс-тестированию.
Часто задаваемые вопросы
Fable 5.2 лучше, чем Opus 5.5, для программирования?
Anthropic сообщает о более высоких оценках Fable в нескольких сложных тестах по программированию. Наше упражнение по программированию — это рабочее пространство ИИ с одним файлом, а не бенчмарк репозитория, поэтому оно не может определить общего победителя в программировании.
Fable 5.2 стоит дороже?
Стандартные тарифы API на ввод и вывод вдвое выше, чем у Opus 5.5: 8 $/40 $ против 4 $/20 $ за миллион токенов. Фактическая стоимость задачи также зависит от использования, рассуждений, повторных попыток, кэширования и сервиса, который выставляет счёт.
Проводились ли эти тесты внутри GlobalGPT?
Нет. Они использовали названные модели через сторонний API-шлюз. Они не устанавливают доступность моделей, биллинг или нативные функции внутри GlobalGPT или собственных приложений Claude.
Можно ли доверять любой из моделей в обобщении исследований без проверки?
Оба исследовательских ответа правильно рассчитали основной результат, но каждый ввел по крайней мере один вывод, требующий редактирования. Проверьте каждую деталь дизайна исследования и отделите оценки от утверждений о значимости.
Доказывает ли более красивая сгенерированная страница лучшие способности к кодированию?
Нет. Визуальный дизайн, рабочие взаимодействия, доступность и сопровождаемость — это отдельные измерения. Одна привлекательная страница не может установить надежность кодирования на уровне репозитория.
Было ли моделям предоставлено равное усилие на рассуждение?
Мы использовали одинаковые входные данные и пределы вывода, оставив настройки рассуждений на уровне платформы по умолчанию. Сопоставление шлюза не было независимо проверено, поэтому это не является бенчмарком с равными усилиями.
Стоит ли мне перевести всю свою работу на Fable 5.2?
Сначала используйте приемочный тест для конкретной задачи. Начните с более дешевой модели, которая ему соответствует, а затем переходите на Fable, когда сможете определить worthwhile улучшение.
Окончательный вердикт: какую модель следует использовать?
Начните с Opus 5.5, когда целью является приемлемый первый черновик. Его более низкая стандартная ставка токенов делает его практической основой для рутинного написания, очистки данных и планирования. Для получения дополнительной информации см. наш обзор Claude Opus 5.5.
Попробуйте Fable 5.2, когда конкретная сложная задача по-прежнему не соответствует вашим критериям приемки. Сохраняйте те же входные данные и проверьте, устраняет ли он фактический сбой. руководство по выбору модели также рекомендует начинать с последней версии Opus и переходить на более высокий уровень, когда Opus с большими усилиями оказывается недостаточным.
Если ни одна из премиум-моделей не нужна, Sonnet 5.5 vs Opus 5.5 является более релевантным сравнением затрат.
Для более широкого набора провайдеров см. наши тесты генератора текста с ИИ.
Для работы с репозиторием демонстрация с одним файлом в этом обзоре — лишь отправная точка. Она не проверяет доступ к оболочке, редактирование нескольких файлов, длительное использование инструментов или поведение восстановления агента кодирования. Подробнее о настройке см. в нашем руководстве выбор модели в Claude Code прежде чем рассматривать завершение чата как замену полноценной среды разработки.



