
O GPT-6.1 Sol é o modelo equilibrado da OpenAI para programação complexa, uso de computadores e trabalho profissional. Ele mantém a janela de contexto de 1.050.000 tokens e o limite máximo de saída de 128.000 tokens do GPT-6 Astra, mas o preço da API Padrão cai para $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. Isso representa um quinto das taxas por token atuais do Astra. A troca é simples: o Astra continua sendo o carro-chefe, enquanto o Sol visa oferecer capacidade suficiente para equipes que se preocupam com o custo por tarefa concluída.
Este guia distingue o que Documentos OpenAI para o GPT-6.1 Sol com base no que criadores independentes observaram em testes iniciais. Ele também apresenta a regra de preços para contextos longos, exemplos realistas de custos, um padrão funcional da API de respostas e uma maneira prática de escolher entre Sol, Astra, Luna e o antigo GPT-6 Sol.
O que é o GPT-6.1 Sol?
O GPT-6.1 Sol é o modelo mais recente da família GPT-6 da OpenAI. A descrição oficial o define como um modelo para programação complexa, uso de computadores e trabalho profissional, com desempenho próximo ao do Astra a um custo menor. Na hierarquia da família, o Astra é a opção de maior capacidade, o Luna é a opção de eficiência e o Sol é o meio-termo para tarefas que são complexas o suficiente para exigir raciocínio robusto, mas frequentes o suficiente para que o custo unitário seja importante.
O ID do modelo é gpt-6.1-sol. Essa sequência exata é importante em chamadas de API, registros de teste, registros de cobrança e configuração de implantação. A versão mais antiga gpt-6-sol continua sendo um modelo diferente, embora os preços de entrada e saída não armazenados em cache sejam os mesmos. A página do OpenAI referente ao modelo antigo agora direciona os leitores para a versão mais recente, enquanto a nossa Análise do GPT-6 Sol e limites da API fornece a linha de base histórica.
A razão mais evidente para se interessar por essa atualização não é um único número na tabela de classificação. É a combinação de uma janela de contexto de tamanho pioneiro, amplo suporte a ferramentas, cinco níveis de esforço de raciocínio e um preço que incentiva um uso mais amplo do que o do Astra. Um modelo que seja um pouco mais fraco, mas acessível o suficiente para ser executado em qualquer rascunho, revisão de código ou fluxo de trabalho de várias etapas, pode oferecer mais valor do que um modelo top de linha reservado para ocasiões raras.
Esse posicionamento ainda precisa ser testado em relação às suas próprias tarefas. O OpenAI’s orientações para a seleção de modelos recomenda explicitamente comparar o Sol com o Astra no mesmo trabalho. Um fluxo de trabalho de documentos jurídicos, uma refatoração de repositório, um agente de navegador e uma apresentação em quadro podem colocar à prova diferentes capacidades. Trate o rótulo do modelo como uma hipótese inicial e, em seguida, avalie a precisão, o número de revisões, a latência e o custo total por resultado aceito.
Especificações do GPT-6.1 Sol
O catálogo oficial de modelos enumera entradas de texto e imagem com saída de texto. Áudio e vídeo não são modalidades de entrada ou saída compatíveis com o próprio modelo. Essa distinção é útil na hora de projetar um produto: é possível enviar capturas de tela, diagramas, páginas digitalizadas ou outras imagens, mas a transcrição de áudio e a compreensão de vídeo exigem um componente ou ferramenta separada.
Sua entrada máxima é menor do que a janela de contexto principal, pois a saída e o processamento interno precisam de espaço dentro do orçamento total. O limite máximo de saída de 128.000 tokens é generoso, mas solicitar uma resposta muito extensa raramente é o melhor projeto. Saídas longas custam mais, levam mais tempo para serem revisadas e podem apresentar desvios. Para a maioria dos trabalhos de software, saídas estruturadas menores com pontos de verificação são mais fáceis de validar.
Apoio ao raciocínio baixo, médio, alto, xalto, e máx.; “médio” é o padrão. O nenhum e mínimo As configurações não estão disponíveis. Use um esforço menor para transformações de rotina e aumente-o apenas quando o custo de erro ou a complexidade de uma tarefa justificar o uso de tokens e tempo adicionais. O objetivo prático é a configuração mais leve que ainda permita que seus testes de aceitação sejam aprovados.
Os desenvolvedores que estiverem comparando preços anteriores e o comportamento dos tokens podem usar nosso Exemplos de preços e custos do GPT-6 Sol como ponto de referência. A principal mudança na especificação não é o tamanho do contexto, que permanece consistente entre os modelos GPT-6 abordados aqui. Trata-se do posicionamento atualizado do Sol mais recente e da entrada em cache mais econômica.
Desempenho: o que mostram os dados oficiais
O comunicado de lançamento do OpenAI afirma que o GPT-6.1 Sol apresenta melhorias substanciais em relação ao GPT-6 Sol em tarefas profissionais complexas, como escrever e depurar código, compreender documentos e executar fluxos de trabalho empresariais com várias etapas. A empresa afirma que o modelo se aproxima do GPT-6 Astra em várias avaliações, a um custo menor. Essas são afirmações oficiais de avaliação, não uma garantia de que todas as solicitações terão resultados próximos aos do Astra.
O Anexo ao cartão do sistema solar GPT-6.1 isso estabelece um limite importante: as avaliações foram realizadas no ambiente de pesquisa do OpenAI ou por meio da API, e o ChatGPT em produção pode apresentar diferenças, pois os prompts do sistema, as ferramentas disponíveis e as configurações de esforço não são idênticas. É por isso que um artigo bem elaborado deve manter as evidências oficiais de benchmark separadas dos testes de um criador e da avaliação interna de uma empresa.
Um exemplo concreto é o HealthBench. Na tabela publicada, o GPT-6.1 Sol registra pontuações ajustadas ao comprimento de 64,2 no HealthBench Professional, 58,5 no HealthBench, 36,2 no HealthBench Hard e 96,0 no HealthBench Consensus. As pontuações correspondentes do Astra são 64,7, 58,3, 36,6 e 95,5. O OpenAI descreve os modelos como estando dentro de uma variação de 0,5 ponto percentual nessas quatro avaliações.
Esse resultado corrobora a expressão “próximo ao Astra” dentro dessa família de avaliações. Ele não comprova igualdade em termos de qualidade de engenharia de software, confiabilidade do navegador ou estilo de apresentação. Um benchmark de desempenho mede uma capacidade diferente daquela necessária para corrigir uma condição de corrida ou coordenar ferramentas. Para uma análise mais aprofundada do perfil de testes mais abrangente do modelo principal, consulte o Análise e testes práticos do GPT-6 Astra.
A interpretação prática mais plausível é condicional: o GPT-6.1 Sol deve ser incluído no conjunto de candidatos para tarefas exigentes, especialmente quando o preço do Astra restringiria seu uso. Ele merece uma avaliação comparativa, e não uma promoção automática. Avalie a taxa de aprovação, o número de correções feitas por humanos, os erros da ferramenta, os tokens gerados e o tempo necessário para se chegar a um artefato aceito. Essas métricas transformam uma comparação de modelos em uma decisão de negócios.
Programação: O que o GPT-6.1 Sol é capaz de fazer
O GPT-6.1 Sol possui os componentes básicos esperados de um modelo de programação moderno: processamento em fluxo contínuo, saídas estruturadas, chamada de funções, pesquisa de arquivos, entrada de imagens, pesquisa na web e armazenamento em cache de prompts. Por meio da API de respostas, o OpenAI também oferece um interpretador de código, shell hospedado, aplicação de patches, habilidades, uso de computador, MCP e pesquisa de ferramentas. Isso torna o modelo adequado para fluxos de trabalho que inspecionam arquivos, propõem alterações, executam comandos e retornam resultados verificados por máquina.
O suporte a recursos não significa que todos os ambientes disponibilizem todas as ferramentas automaticamente. Seu aplicativo ainda decide quais ferramentas existem, quais permissões elas recebem, como os resultados são retornados ao modelo e quais ações precisam de confirmação. O recurso “Chat Completions” funciona para o GPT-6.1 Sol sem a necessidade de chamar ferramentas, enquanto o OpenAI direciona os aplicativos que utilizam ferramentas para o “Responses”. Novos sistemas agenticos devem tratar esse limite da API como uma escolha arquitetônica, e não como uma diferença sintática menor.
No momento da publicação, o modelo exato não havia sido divulgado no catálogo de bate-papo do local do teste; portanto, este guia não alega estabelecer um novo padrão de referência interno para as quatro tarefas de programação planejadas. A avaliação de programação baseia-se em dados oficiais de desempenho e em execuções públicas identificadas. Isso é mais útil do que substituir discretamente o Astra ou o antigo Sol e atribuir o nome errado do modelo ao resultado.
Uma avaliação sólida deve incluir depuração com testes de regressão, um recurso de múltiplos arquivos com limites definidos, uma revisão de segurança e uma decisão de engenharia restrita ao esquema. Essas tarefas vão além do simples teste da geração de código. Elas revelam se o modelo preserva uma API, detecta casos extremos, respeita as restrições de saída e indica o que não foi possível verificar. Nossa guia dos melhores modelos de IA para programação em 2026 explica por que a melhor opção varia de acordo com o fluxo de trabalho.
Identifique o menor defeito, mantenha a API e adicione testes executáveis.
Respeite a concorrência, a ordenação, a validação e o comportamento em caso de falha.
Priorize as formas de exploração, forneça uma correção mínima e evite alegações infundadas sobre a estrutura do sistema.
Ao executar um comando como este, avalie o resultado de forma sistemática. O valor zero permanece? As duplicatas foram removidas? A ordenação numérica está correta? Os testes são executados com node --test? Uma explicação bem elaborada não pode compensar uma afirmação incorreta. A mesma regra se aplica ao trabalho com repositórios: defina as condições de aceitação antes de escolher o modelo e, em seguida, analise o patch, em vez de se basear na convicção transmitida pelo texto.
Preços do GPT-6.1 por Sol
O página oficial de preços da API Mede as taxas do GPT-6.1 Sol por um milhão de tokens. A entrada custa $2, a entrada em cache custa $0,10, as gravações no cache custam $2,50 e a saída custa $10. A entrada em cache, portanto, representa 5% da taxa de entrada sem cache, enquanto a gravação de novo conteúdo no cache custa 1,25 vezes a entrada comum. Taxas específicas da ferramenta podem ser adicionadas separadamente, de modo que o cálculo de tokens é apenas uma parte da carga de trabalho que utiliza a ferramenta.
O detalhe mais importante em relação à tarifação é o limite de 272 mil. Quando a entrada ultrapassa 272.000 tokens, toda a solicitação passa a ter taxas de entrada e de cache duas vezes maiores e uma taxa de saída 1,5 vez maior. Não se trata de uma sobretaxa marginal aplicada apenas aos tokens acima desse limite. Aplicativos que costumam ficar próximos desse limite devem contar os tokens antes do envio e considerar o particionamento, a recuperação ou a compactação.
O modo Rápido dobra os preços do modo Padrão. Os modos em Lote e Flex reduzem as tarifas do modo Padrão em 50%, e o processamento regional acrescenta um acréscimo de 10%, quando disponível. Esses modos resolvem problemas diferentes: o modo rápido compensa a latência, o modo em lote troca a rapidez pelo custo, o modo flexível troca a previsibilidade do agendamento pelo custo e o processamento regional atende às necessidades de localização dos dados. Não compare seus preços sem comparar suas restrições operacionais.
Os preços padrão da Astra são de $10 na entrada e $50 na saída por milhão de tokens, exatamente cinco vezes as taxas principais da Sol. O Preços e limites de tokens da API do GPT-6 Astra O guia analisa esse prêmio com mais detalhes. O Sol e a versão anterior do GPT-6 Sol compartilham os mesmos preços de entrada e saída não armazenados em cache, mas o GPT-6.1 Sol reduz a entrada armazenada em cache de $0,20 para $0,10 por milhão de tokens.
Exemplos de custo real
Os preços dos tokens ficam mais fáceis de avaliar quando convertidos em solicitações completas. Os exemplos abaixo utilizam o processamento Padrão, sem taxas de chamada de ferramentas, sem prêmio regional e sem entrada em cache, salvo indicação em contrário. O comprimento real da saída costuma influenciar a cobrança mais do que os desenvolvedores esperam, pois a saída custa cinco vezes mais do que a entrada comum no GPT-6.1 Sol.
Para a revisão de código com 100 mil entradas e 5 mil saídas, as entradas custam $0,20 e as saídas custam $0,05, resultando em uma estimativa de $0,25. Se toda a entrada de 100 mil for considerada em cache, sua parcela de entrada cai para $0,01 e o total passa a ser $0,06. Se o aplicativo precisar gravar esse prefixo de 100 mil no cache primeiro, a parcela de gravação no cache será de $0,25 antes da saída.
O exemplo de 300 mil entradas ultrapassa o limite. As entradas são cobradas a uma taxa efetiva de $4 por milhão; portanto, 300 mil custam $1,20. A saída é cobrada a uma taxa efetiva de $15 por milhão; portanto, 10 mil custam $0,15. O total é $1,35. Uma solicitação apenas um pouco acima do limite pode, portanto, custar muito mais do que uma que esteja logo abaixo dele, mesmo antes da aplicação de ferramentas.
As opções “Batch” ou “Flex” reduziriam pela metade o total elegível do “Standard”, enquanto a opção “Fast” o dobraria. No primeiro exemplo, isso significa aproximadamente $0,125 nas opções “Batch” ou “Flex” e $0,50 na opção “Fast”. As equipes que ainda utilizam modelos GPT-5.6 mais antigos podem comparar essas premissas com as nossas Preços do GPT-5.6 e créditos Codex detalhamento.
Como usar o GPT-6.1 Sol
A maneira mais simples de desenvolvimento é por meio da API de respostas. Instale o SDK OpenAI atual, forneça a chave da API por meio do seu ambiente e configure modelo para gpt-6.1-sol. O guia oficial de geração de texto recomenda respostas para solicitações diretas ao modelo, e a página do modelo exige isso para a invocação da ferramenta.
1. Comece com uma solicitação simples à API de respostas
Mantenha a primeira solicitação simples. Confirme se o ID exato do modelo está disponível para o seu projeto, registre os campos do modelo e de uso retornados e armazene metadados suficientes para reproduzir a execução. Não comece com uma cadeia de ferramentas gigantesca. Uma solicitação simples separa os problemas de acesso ao modelo dos problemas relacionados à definição de ferramentas, permissões e orquestração.
2. Adicione ferramentas apenas por meio da API de Respostas
Quando o fluxo de trabalho exigir pesquisa de arquivos, pesquisa na web, execução de código, acesso ao shell, uso do computador, MCP ou funções personalizadas, defina o menor conjunto de ferramentas necessário. Limite o escopo dos arquivos e da rede, valide os argumentos das ferramentas e decida quais ações exigem confirmação humana. O modelo pode propor e chamar ferramentas, mas seu aplicativo continua sendo responsável por executá-las e fazer valer as permissões.
3. Ajustar o esforço de raciocínio por meio de uma avaliação
Comece com a configuração “média”, que é a padrão. Execute um conjunto de avaliação representativo e, em seguida, compare as configurações “baixa”, “alta” ou “xalta” com a taxa de aceitação, os tokens de saída, a latência e a contagem de revisões. A configuração “esforço máximo” pode ajudar nas tarefas mais difíceis, mas usá-la em todas as situações pode anular a vantagem de custo que tornou o Sol atraente. Mantenha a configuração mais leve que forneça resultados confiáveis.
4. Use o comando GlobalGPT para uma comparação interativa
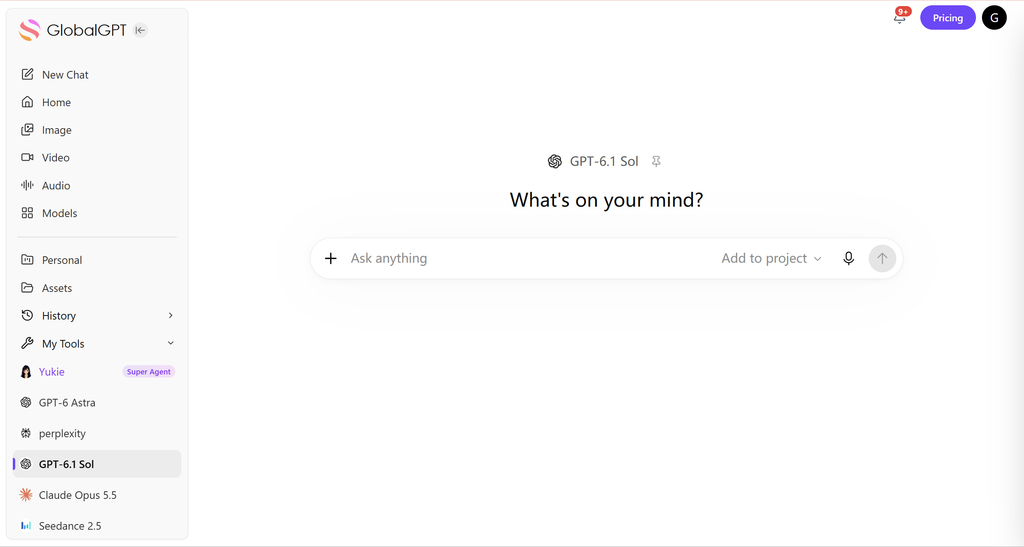
Para trabalhos interativos, abra O espaço de trabalho multimodelo do GlobalGPT e selecione o GPT-6.1 Sol quando ele estiver disponível no seletor da sua conta. Essa opção é útil para comparar respostas sem precisar manter abas e assinaturas separadas. Ela não substitui os controles de implantação da API, a automação de repositórios, o Codex ou um IDE. Nosso guia para Opções do modelo ChatGPT para codificação aborda essas diferenças no fluxo de trabalho.
GPT-6.1 Sol x GPT-6 Sol, Astra e Luna
Todos os quatro modelos desta comparação aceitam texto e imagens, retornam texto e apresentam uma janela de contexto de 1.050.000 tokens com saída máxima de 128.000. As diferenças significativas estão na posição, no preço, na data de corte, nas configurações de raciocínio e no nível de qualidade observado em uma tarefa real. A tabela utiliza os preços oficiais atuais dos tokens Standard, verificados em 1º de outubro de 2026.
| Modelo | Melhor ajuste | Entrada / 1M | Em cache / 1M | Saída / 1M | Limite |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Trabalho complexo com controle de custos | $2 | $0.10 | $10 | 30 de abril de 2026 |
| GPT-6 Astra | Trabalho que exige o máximo e prioriza a qualidade | $10 | $1 | $50 | 30 de abril de 2026 |
| GPT-6 Sol | Integrações mais antigas do Sol já existentes | $2 | $0.20 | $10 | 20 de abril de 2026 |
| GPT-6 Luna | Tarefas específicas e de grande volume | $0.10 | $0.01 | $0.50 | 18 de maio de 2026 |
Escolha o Astra quando a tarefa for difícil o suficiente para que um pequeno ganho de qualidade possa evitar um retrabalho humano dispendioso. Escolha o GPT-6.1 Sol quando o trabalho ainda for complexo, mas frequente, especialmente se o desconto por entrada em cache for útil. Escolha o Luna quando o volume e a latência forem os fatores determinantes e a tarefa estiver bem definida. Mantenha a versão mais antiga do Sol apenas nos casos em que o risco de migração, as avaliações existentes ou o trabalho de compatibilidade tornem uma mudança imediata pouco atraente.
A diferença de preço de cinco vezes entre o Sol e o Astra é grande, mas o preço por token não é o mesmo que o preço por resultado aceito. Um modelo mais eficiente pode usar menos tokens de saída, chamar menos ferramentas ou precisar de menos revisões. Por outro lado, o Sol pode vencer mesmo com uma revisão a mais, se o preço unitário do Astra compensar essa diferença. Compare os rastros completos das tarefas, em vez de multiplicar apenas o comprimento de um único prompt.
Os leitores que estiverem decidindo se vale a pena dar o salto para o modelo top de linha podem usar o Comparação entre o GPT-6 Astra e o GPT-5.6 Sol para o contexto da linha anterior. Para o ramo de menor custo da família atual, o Análise do GPT-6 Luna e melhores usos apresenta os limites relevantes da API e a adequação à carga de trabalho.
O que dizem os críticos
A OpenAI apresentou o GPT-6.1 Sol durante a palestra principal do DevDay de 29 de setembro de 2026, juntamente com outros lançamentos de produtos. Esse vídeo oficial estabelece o momento do lançamento e o posicionamento do produto; não se trata de uma prova independente. A reação externa relevante vem de criadores que divulgam uma tarefa, um conjunto de comparação, um método de cálculo de custo e uma falha, em vez de simplesmente repetir o discurso oficial do lançamento.
Será que ele sabe programar? relatou um desempenho do Sol muito mais barato e rápido em uma comparação de três rodadas entre o Blender e o Godot, mas afirmou que a qualidade do jogo se deteriorou ao longo das rodadas.
Matt Johnston relatou uma pontuação ponderada de 96 e um custo de $2,63 em sua configuração de nove testes, ao mesmo tempo em que mencionou claramente uma falha na tarefa do pinguim.
Duncan Rogoff comparou o Sol com o Sonnet 5.5 em seis versões e monitorou o tempo, os tokens e o custo final.
Em Vídeo de três rodadas do ’Can It Code?”, as tarefas passaram de um kit de masmorra em low-poly no Blender para personagens modelados e animados e, em seguida, para um jogo jogável no Godot. O criador estimou $29,17 e 7 horas e 5 minutos para o Sol em todas as rodadas, muito abaixo dos resultados comparativos, mas considerou o jogo final menos agradável e afirmou que o Sol piorou a cada rodada. A conclusão é que se trata de custo e velocidade, com uma ressalva quanto à qualidade, e não de uma classificação geral.
A análise de Matt Johnston sobre as nove partidas de teste apresenta uma pontuação ponderada de 96, empatada com Sonnet 5.5 na tabela da Stonelabs, e um custo do pacote de $2.63, em comparação com cerca de $14 para a Astra e $12 para a Opus 5.5. Ele também destaca uma falha na tarefa do pinguim. Esses números pertencem ao seu projeto de benchmark e à contabilidade de custos; eles devem ser reproduzidos antes de serem utilizados para aquisição.
A comparação entre seis modelos de construção, feita por Duncan Rogoff abrange páginas de destino, jogos 3D para navegador, cenas do Blender, vídeos explicativos interativos e apresentações para investidores. A descrição pública indica que os testes monitoram o tempo de compilação, o uso de tokens e o custo final. Até que o resultado completo e visível seja analisado, este guia utiliza o vídeo como evidência de um método prático de comparação, e não como prova de que algum dos modelos tenha vencido.
Essas primeiras análises concordam em uma questão relevante: o preço baixo do Sol se mantém quando comparado a um projeto completo? Suas respostas dependem da tarefa em questão. Um criador observou uma eficiência de custo impressionante, mas com qualidade final do jogo mais fraca; outro relatou uma pontuação alta e um custo baixo do pacote; um terceiro projetou um amplo confronto direto. Essa diversidade é mais informativa do que uma frase de consenso sintética.
Quem deve usar o GPT-6.1 Sol?
O GPT-6.1 Sol é ideal para equipes que já possuem um trabalho significativo e um ciclo de avaliação. Ele se torna especialmente atraente quando o mesmo contexto extenso é reutilizado por meio do armazenamento em cache de prompts, quando uma implantação do Astra seria muito cara para ser escalonada ou quando o Luna não oferece profundidade suficiente para a tarefa. O modelo é menos atraente quando uma tarefa leve de extração ou classificação já funciona de maneira confiável em um nível de preço mais acessível.
- Codificação em escala de repositório
- Resultados profissionais complexos
- Revisão de contexto longo com armazenamento em cache
- Fluxos de trabalho com uso de ferramentas e funções de avaliação
- Decisões críticas para a segurança
- Tarefas em que os erros custam caro
- Trabalho próximo ao limite de 272 mil
- Fluxos sensíveis à latência
- Marcação simples
- Transformações determinísticas curtas
- Extração de alto volume e baixo risco
- Tarefas já resolvidas pela Luna
As equipes de software devem considerar o Sol quando precisarem de um modelo para realizar raciocínios em vários arquivos, gerar testes, analisar questões de segurança ou operar ferramentas sob supervisão. Analistas podem utilizá-lo para síntese de múltiplos documentos e entregas estruturadas. Equipes de operações podem utilizá-lo para fluxos de trabalho que combinam dados, regras e contexto de negócios. Em todos os casos, o fluxo de trabalho requer critérios de aceitação explícitos e uma etapa de verificação humana ou automatizada.
Usuários individuais e pequenas equipes podem preferir um espaço de trabalho interativo multimodelo antes de desenvolver uma integração por API. Isso torna a comparação entre o Sol e o Astra mais concreta, sem a necessidade de definir uma arquitetura de aplicativo. Se você ainda está decidindo entre diferentes provedores e modalidades, nosso guia para escolha de um modelo de IA com base na tarefa, nas ferramentas e no custo oferece uma lista de finalistas mais abrangente.
Limites e modos de falha
Uma janela de contexto de um milhão de tokens representa capacidade, não memória perfeita. Instruções importantes ainda podem ser diluídas por documentos ruidosos, regras duplicadas ou evidências conflitantes. Estruture entradas longas, identifique fontes confiáveis e peça ao modelo para citar o arquivo ou a passagem por trás das conclusões relevantes. A recuperação e a compactação podem ser melhores do que enviar tudo a cada rodada.
O passo de preço com contexto extenso representa um segundo risco. Uma solicitação com 273 mil tokens de entrada é cobrada pela tarifa mais alta referente à solicitação completa, e não apenas pelos mil tokens finais. Isso pode gerar cobranças inesperadas em aplicativos que montam o contexto dinamicamente. Adicione a contagem de tokens e verificações de orçamento antes da solicitação e registre quais documentos fizeram com que uma chamada ultrapassasse o limite.
O uso de ferramentas amplia as capacidades e a superfície de ataque. Trate páginas da Web, arquivos recuperados e resultados gerados por ferramentas como dados não confiáveis. Valide os argumentos das funções, isole a execução de código, restrinja caminhos de arquivos e acesso à rede e exija confirmação para ações de alto impacto. O suporte do modelo ao uso de shell hospedado ou de computadores não é motivo para conceder permissões amplas.
Por fim, os testes iniciais com criadores podem ser informativos, sem serem definitivos. Diferentes instruções do sistema, ferramentas, estruturas de apoio, limites de tempo e critérios de avaliação podem reverter o resultado de um vencedor aparente. Use os testes públicos para elaborar sua própria avaliação, e não para ignorá-la. Um modelo que se destaque na criação de um jogo visual pode ainda assim falhar no seu plano de migração, e o contrário também é possível.
Perguntas frequentes
Essas respostas resumem as informações oficiais sobre a API e os pontos práticos para tomada de decisão abordados acima.
O que é o GPT-6.1 Sol?
O GPT-6.1 Sol é um modelo de raciocínio OpenAI destinado à programação complexa, ao uso de computadores e ao trabalho profissional. A classificação OpenAI o posiciona entre o nível Luna, de baixo custo, e o nível Astra, que é o carro-chefe, oferecendo capacidade próxima à do Astra a um preço de API mais baixo.
Quanto custa o GPT-6.1 Sol?
Os preços padrão da API são $2 por milhão de tokens de entrada, $0,10 por milhão de tokens de entrada armazenados em cache, $2,50 por milhão de tokens gravados no cache e $10 por milhão de tokens de saída. Prompts longos, o modo rápido, o processamento regional, o processamento em lote e o Flex podem alterar a taxa efetiva.
O que é a janela de contexto do GPT-6.1 Sol?
O OpenAI apresenta uma janela de contexto de 1.050.000 tokens, uma entrada máxima de 922.000 tokens e até 128.000 tokens de saída. Uma janela grande permite que o modelo analise uma quantidade substancial de material, mas não garante uma recuperação perfeita nem torna todas as solicitações grandes econômicas.
O GPT-6.1 Sol é bom para programação?
Ele foi projetado para programação complexa e oferece suporte a saídas estruturadas, chamadas de função, interpretador de código, shell hospedado, aplicação de patches, habilidades, MCP e outras ferramentas por meio da API Responses. As equipes de produção devem continuar realizando testes específicos do repositório antes de alterar um fluxo de trabalho crítico.
Devo usar o GPT-6.1 Sol ou o GPT-6 Astra?
Escolha o Sol quando o custo for um fator importante e sua própria avaliação indicar que ele atende aos padrões de qualidade. Escolha o Astra para os trabalhos mais exigentes, quando a diferença de qualidade justificar uma taxa de tokens padrão cinco vezes maior. Teste ambos em tarefas representativas antes de decidir.
O que acontece quando uma solicitação ultrapassa 272 mil tokens de entrada?
O OpenAI indica que a solicitação completa é cobrada a uma taxa duas vezes maior do que as taxas normais de entrada e de cache e a 1,5 vez a taxa normal de saída, assim que a entrada ultrapassar 272 mil tokens. Essa mudança brusca pode ser mais relevante do que o tamanho da janela de contexto mencionado inicialmente em aplicações com documentos longos.
O GPT-6.1 Sol é compatível com a API Chat Completions?
Sim, o recurso “Chat Completions” é compatível com solicitações que não envolvem a chamada de ferramentas. O OpenAI orienta os desenvolvedores a utilizarem a API de Respostas para a chamada de ferramentas; portanto, novos aplicativos que utilizem agentes ou ferramentas devem, normalmente, começar pela API de Respostas, em vez de depender da interface mais antiga.
O GPT-6.1 Sol aceita imagens?
Sim. A página oficial do modelo indica a entrada de texto e imagens, com saída de texto. Áudio e vídeo não são modalidades suportadas pelo modelo, embora um aplicativo possa utilizar outros serviços ou ferramentas associadas ao modelo quando esses tipos de mídia forem necessários.
Como posso usar o GPT-6.1 Sol no GlobalGPT?
Abra o GlobalGPT, inicie um novo bate-papo e selecione o GPT-6.1 Sol quando ele aparecer no seletor de modelos da sua conta. O GlobalGPT é um espaço de trabalho multimodelo prático; as chaves de API, os controles de implantação e a automação do repositório continuam sendo fluxos de trabalho separados para desenvolvedores.
Veredicto final
O GPT-6.1 Sol é a opção mais interessante do GPT-6 para compradores que precisam de recursos avançados de raciocínio e programação, mas não podem justificar o uso do Astra em todas as execuções. Ele se equipara ao Astra em termos de limites de contexto e saída, utiliza a mesma data de corte de conhecimento (30 de abril de 2026) e custa um quinto do preço por token de entrada e saída não armazenado em cache, de acordo com as tarifas padrão. O desconto para entradas armazenadas em cache também é maior do que no GPT-6 Sol anterior.
O modelo não é automaticamente a melhor opção. O Luna continua sendo significativamente mais barato para trabalhos específicos, e o Astra ainda pode reduzir o número de revisões nas tarefas mais complexas. A comparação correta é o custo total por resultado aceito, medido com o mesmo prompt, as mesmas ferramentas, os mesmos dados e as mesmas regras de pontuação. Acima de 272 mil tokens de entrada, leve em conta o multiplicador de preço antes de tomar uma decisão.
Abra o GlobalGPT, selecione o GPT-6.1 Sol quando estiver disponível e compare-o com o Astra ou o Luna utilizando uma tarefa real e uma lista de verificação de aceitação.
Abrir GlobalGPTPara a implantação da API, comece pela página oficial do modelo e por uma pequena solicitação à API de respostas. Para uma comparação interativa, use a rota multimodelo acima. De qualquer forma, guarde os resultados, o histórico de uso, as configurações e as falhas. A promessa do GPT-6.1 Sol não se resume apenas a tokens mais baratos; trata-se de uma oportunidade melhor de executar raciocínios eficazes com frequência suficiente para que se tornem parte do fluxo de trabalho.









