O DeepSeek V4 Pro já está disponível como modelo de produção, mas a escolha entre Pro, Flash e Vision-Exp ficou menos simples após as atualizações de agosto de 2026. Os três modelos compartilham o mesmo nome de família, mas atendem a prioridades diferentes: confiabilidade sob restrições complexas, custo e volume, ou entrada de imagem.
A decisão prática começa pela carga de trabalho. O Flash é o ponto de partida mais sensato para textos de grande volume e automação com restrições orçamentárias. O Pro é a opção mais adequada quando uma resposta inconsistente gera retrabalho dispendioso. Quando a entrada incluir imagens, use deepseek-v4-flash-vision-exp em vez de qualquer um dos modelos apenas de texto.
Se você preferir manter a pesquisa, a redação, o raciocínio e a assistência à programação em um único fluxo de trabalho, você pode acessar GlobalGPT. Há também uma rota exclusiva para DeepSeek V4 Pro. Trata-se de uma alternativa de interface; o faturamento, os limites e as integrações da API oficial continuam fazendo parte do próprio ambiente da DeepSeek.

O DeepSeek V4 já foi lançado oficialmente?
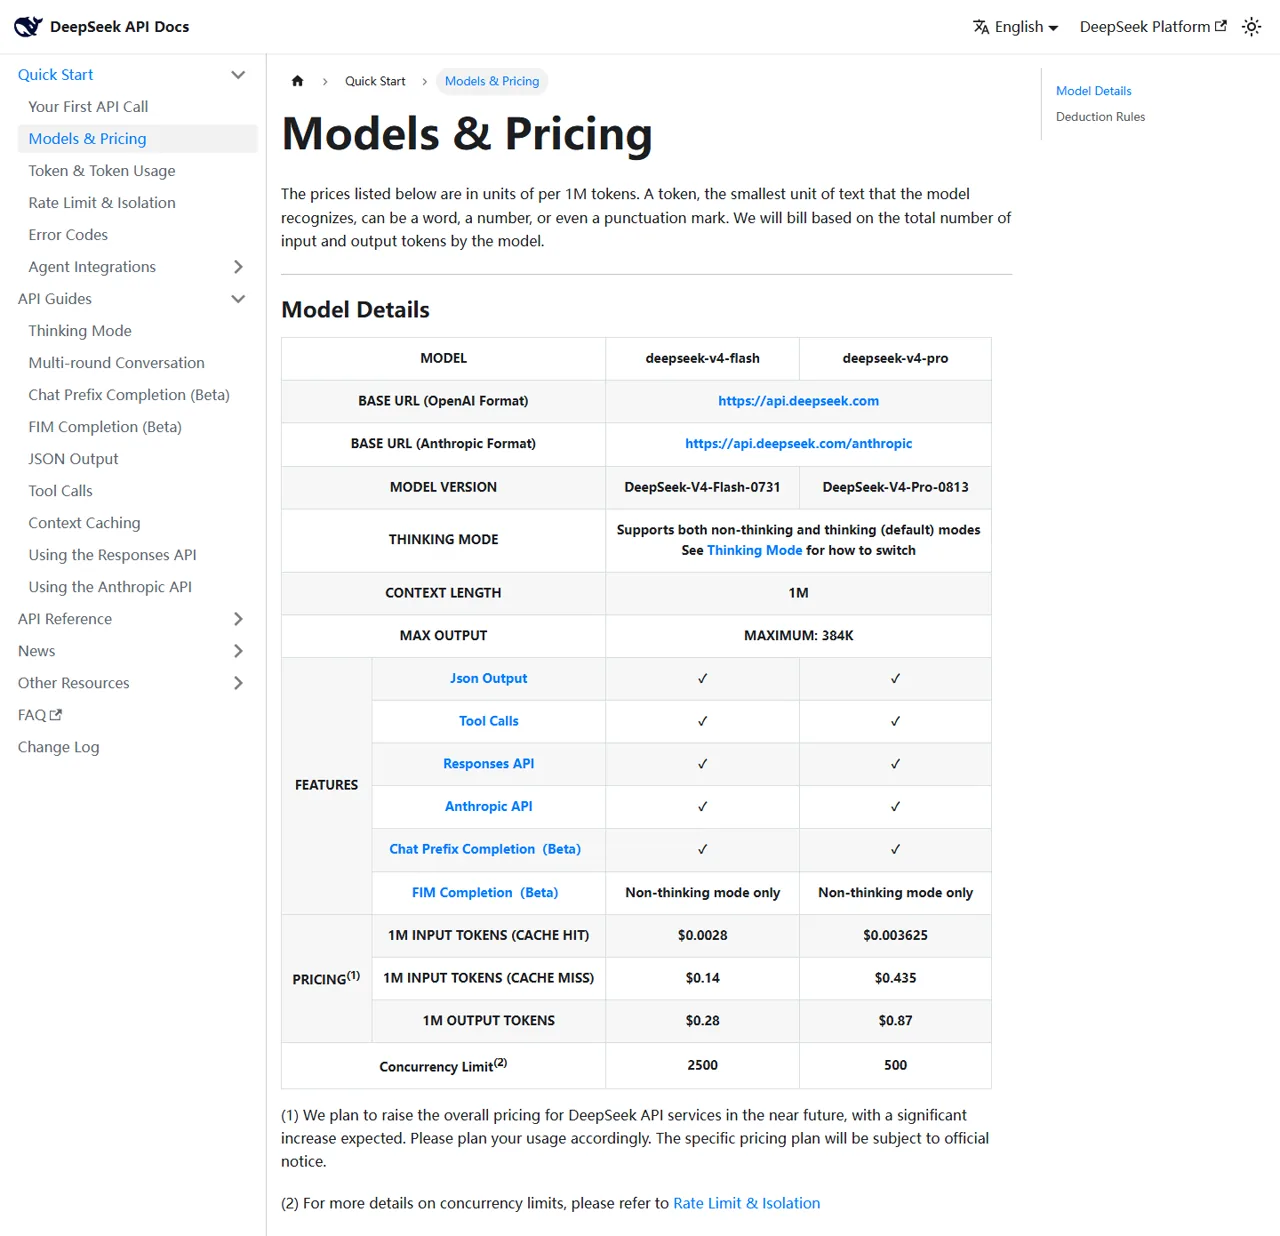
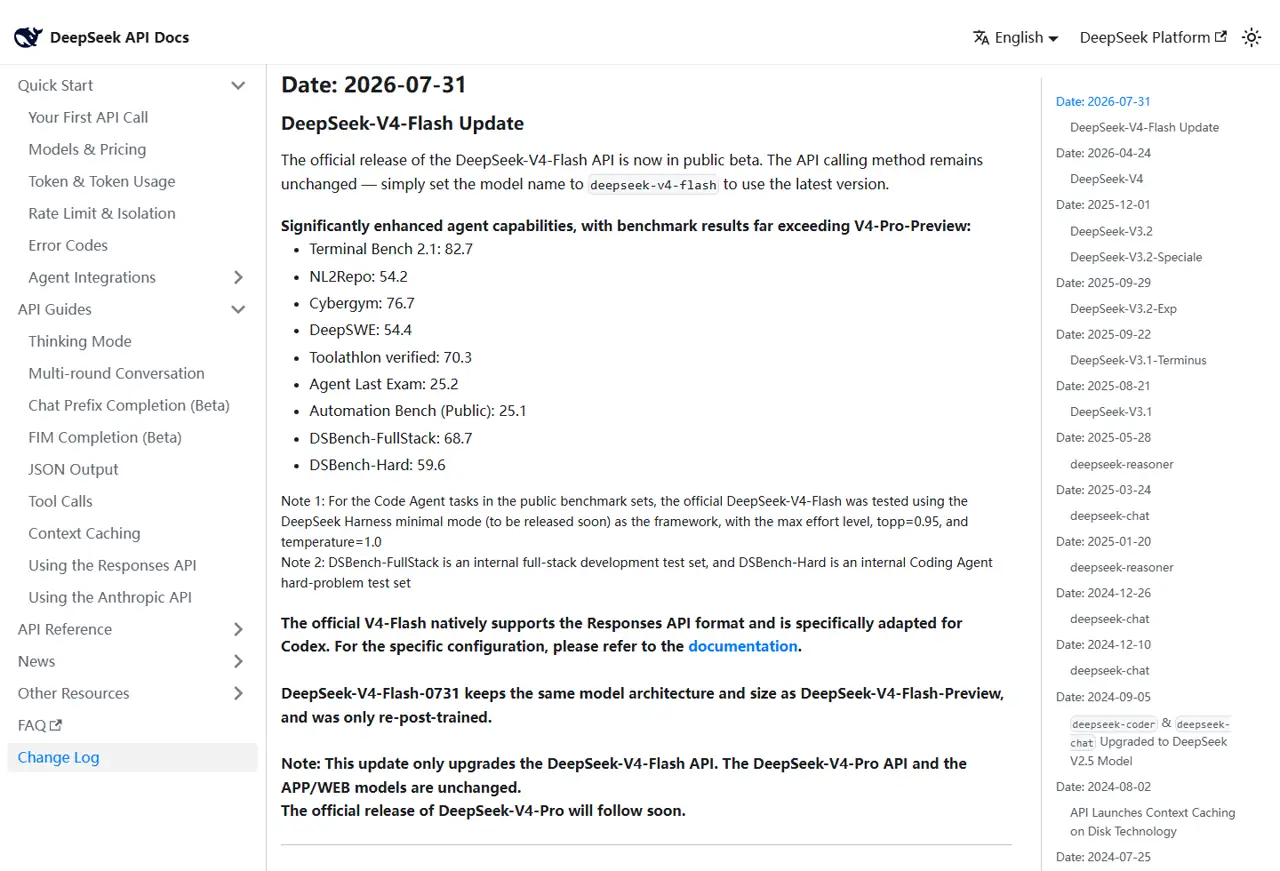
Sim. A DeepSeek anunciou a disponibilidade geral do V4 Pro em 13 de agosto de 2026. A documentação oficial identifica o modelo de produção como DeepSeek-V4-Pro-0813. O V4 Flash aparece como DeepSeek-V4-Flash-0731, enquanto o modelo experimental de visão foi lançado em 21 de agosto como deepseek-v4-flash-vision-exp.
- V4 Pro: um modelo de texto voltado para tarefas mais complexas.
- V4 Flash: um modelo de texto otimizado em termos de custo e volume.
- V4 Flash Vision-Exp: uma variante experimental que aceita imagens.
A disponibilidade geral não significa que todos os produtos ou provedores ofereçam a mesma interface, cota ou integração. Para decisões relacionadas à API, consulte o site oficial Modelos e preços página e o Notas de lançamento do GA.
DeepSeek V4 Pro
Versão: Pro-0813
Melhor ajuste: programação mais complexa, agentes, raciocínio e entregas com muitas restrições.
DeepSeek V4 Flash
Versão: Flash-0731
Melhor ajuste: produção em alta produtividade, codificação de rotina, recuperação e cargas de trabalho com restrições de custo.
Os nomes podem causar confusão, pois o relatório técnico da V4 descreve variantes de pré-visualização, enquanto a API em produção utiliza versões de produção com data específica. Ao longo desta análise, “Pro” refere-se a Pro-0813 e “Flash” refere-se a Flash-0731, a menos que uma frase mencione explicitamente “V4 Preview”.”
O que mudou no DeepSeek V4 Pro?
As mudanças mais evidentes são a escala, a capacidade de contexto, as interfaces orientadas a agentes e uma estratégia de produto em duas camadas. A DeepSeek’s cartão oficial do modelo Pro identifica um modelo de mistura de especialistas com 1,6 trilhão de parâmetros no total e 49 bilhões de parâmetros ativos, disponibilizado sob a licença do MIT. Os materiais da V4 que acompanham o trabalho descrevem novos estudos sobre atenção e roteamento, com o objetivo de tornar viável o processamento de milhões de tokens.
- Dois níveis atuais: O Pro para trabalhos que exigem qualidade e o Flash para rendimento e custo.
- Memória de trabalho muito mais longa: uma janela de contexto com 1 milhão de tokens para ambos os modelos.
- Limite máximo de geração: até 384 mil tokens de saída, conforme a especificação oficial.
- Interfaces de agente: chamadas de ferramentas, saída em JSON, API de respostas e acesso compatível com Anthropic.
- Categorias de peso aberto: Estão disponíveis fichas técnicas e arquivos oficiais do modelo V4, embora a implantação local em grande escala continue sendo um grande projeto de infraestrutura.
Essa combinação torna o V4 relevante para codificação em escala de repositório, pacotes de pesquisa extensos e rastros de agentes com várias etapas. Ela também altera o panorama competitivo: uma avaliação útil agora precisa ir além da qualidade do bate-papo e questionar como o modelo se comporta ao lidar com ferramentas, formatos rígidos e entradas extensas. Nossa Comparação entre DeepSeek e ChatGPT apresenta mais informações sobre as diferenças entre esses ecossistemas.
DeepSeek V4 Pro x Flash: a diferença na prática
Ambas as versões apresentam o mesmo contexto de título e os mesmos limites de saída; portanto, não se trata de uma escolha entre um “modelo completo” e um “modelo de contexto reduzido”. Trata-se, principalmente, de uma decisão relacionada à qualidade, ao preço e ao planejamento de capacidade. O limite oficial de simultaneidade do Flash é cinco vezes maior que o do Pro, enquanto os tokens de entrada e saída com falha de cache do Pro custam pouco mais de três vezes mais.
Pro x Flash: uma visão geral
Especificações oficiais e preços verificados em 13 de agosto de 2026; as observações práticas são baseadas em uma única execução por tarefa e não constituem testes de desempenho oficiais.
Escolha o Flash quando…
Você precisa de escalabilidade a baixo custo, correções de código de rotina, extração, classificação ou muitas solicitações paralelas — e pode validar cálculos de alto risco e restrições de formato.
Escolha a versão Pro quando…
O resultado combina código, políticas, finanças ou diversas restrições exatas, e o custo adicional é menor do que o custo de uma falha sutil.
Testes práticos: codificação, recuperação e cumprimento de restrições
Testamos os dois IDs de modelo de API por meio do mesmo endpoint do Broly Anywhere compatível com OpenAI em 13 de agosto de 2026. A temperatura era de 0. Cada resultado pontuado corresponde a uma execução por modelo e tarefa. O tempo real inclui o atraso do gateway e do upstream, portanto, serve como uma observação — e não como uma classificação estável de latência.
Quadro de resultados prático
Tanto o Pro quanto o Flash foram aprovados em todos os testes corrigidos.
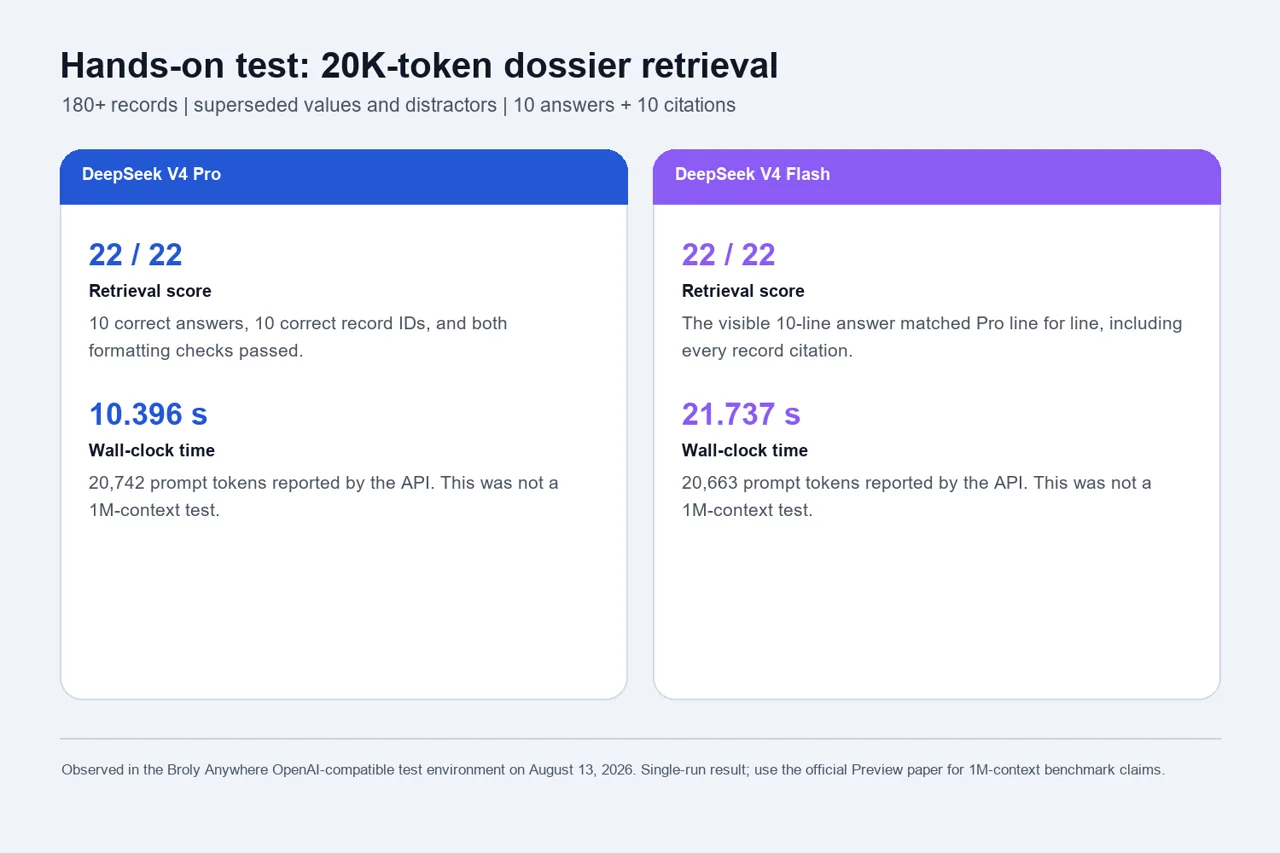
Tanto as respostas quanto todas as referências aos registros exigidas estavam corretas.
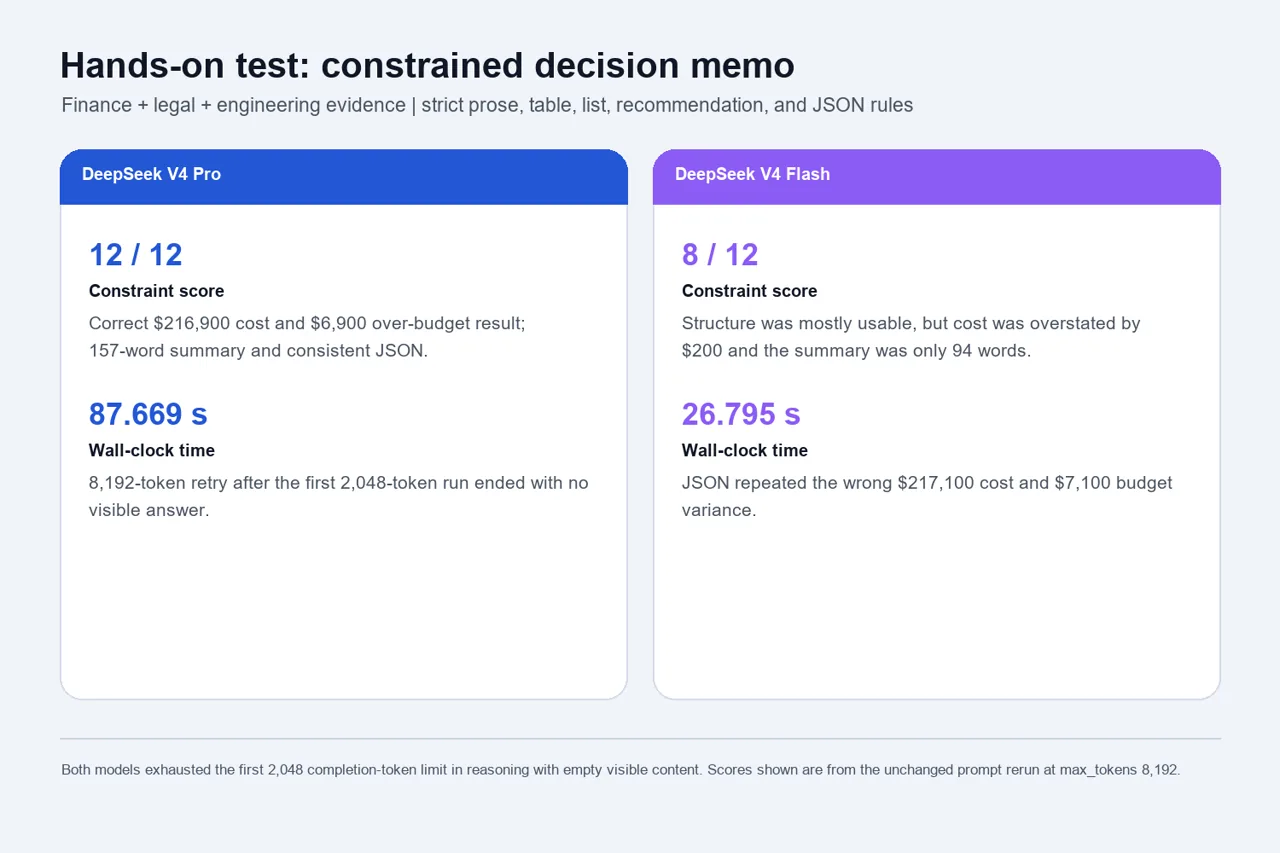
O Pro cumpriu todas as regras; o Flash não atendeu às restrições aritméticas e de comprimento.
Teste 1: depuração em Python com o agentic
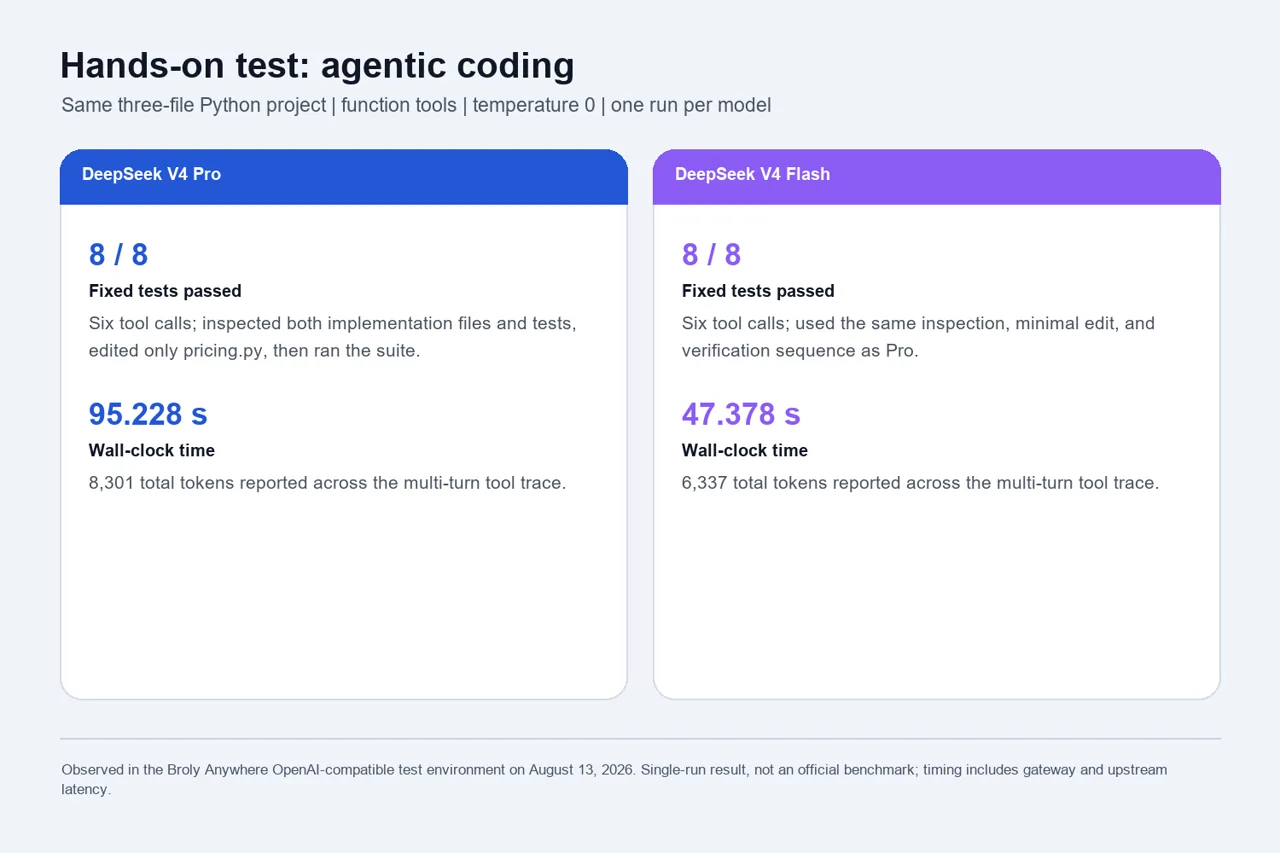
O harness forneceu a cada modelo quatro ferramentas — listar arquivos, ler um arquivo, gravar um arquivo e executar testes — dentro de um pequeno projeto de Python de três arquivos sobre preços. Isso se assemelha mais a um fluxo de trabalho de agente do que a solicitar um trecho de código no chat.
Depurar, corrigir e verificar um projeto de cálculo de preços em Python
Ambos os modelos seguiram o mesmo caminho de seis chamadas, com alterações apenas na implementação, e produziram 8 aprovados. O Flash concluiu essa execução em 47,378 segundos, contra os 95,228 segundos do Pro, e utilizou menos tokens devolvidos. Não houve um vencedor em termos de qualidade neste caso. Para outra perspectiva focada no código, consulte nosso Teste de programação em Python: DeepSeek vs ChatGPT.
Teste 2: recuperação de um dossiê com aproximadamente 20,7 mil tokens
Anexamos um dossiê contendo mais de 180 registros, opções de resposta repetidas, rascunhos desatualizados e dez fatos dispersos. O modelo precisava responder em um formato exato de dez linhas e citar um registro para cada resposta.
Responda a um dossiê confuso com referências precisas
Ambos os modelos obtiveram 22/22: dez respostas corretas, dez citações corretas e dois pontos de formatação. O Pro concluiu essa execução em 10,396 segundos e o Flash em 21,737 segundos. O uso real da solicitação foi de cerca de 20,7 mil tokens. Isso o torna um teste de recuperação de tamanho médio útil, mas não validar a janela completa de 1 milhão de tokens.
Teste 3: um memorando rigoroso sobre a decisão de lançamento
Essa tarefa combinava um resumo de 120 a 180 palavras, uma tabela com exatamente quatro linhas, riscos fixos e contagens desconhecidas, uma decisão breve, um JSON válido e um cálculo de custos para o primeiro ano com base em notas das áreas financeira, jurídica, de engenharia, de vendas, de suporte e de segurança.
Elabore um memorando de lançamento com regras aritméticas e de saída rigorosas
Com um limite de 2.048 tokens de conclusão, ambos os modelos utilizaram o orçamento de conclusão disponível no raciocínio retornado e não produziram nenhuma resposta visível. Preservamos esses registros e, em seguida, executamos novamente o prompt inalterado com um limite de 8.192 tokens. O Pro obteve 12/12. O Flash obteve 8/12 porque relatou $217.100 em vez de $216.900, transportou o erro $200 para a variância, e escreveu um resumo de 94 palavras em vez das 120–180 palavras exigidas.
A lição é específica, não universal: o Flash já se destacava nas tarefas de codificação e recuperação, enquanto o Pro apresentava melhor desempenho na combinação mais complexa de restrições aritméticas, estruturais e de política. Se o seu fluxo de trabalho depende de um shell de agente, nosso Comparação entre OpenClaw, Claude e OpenCode ajuda a ajustar o modelo à ferramenta ao redor.
Tests de desempenho do DeepSeek V4: o que os dados oficiais comprovam
A fonte de referência mais segura é a Relatório técnico DeepSeek V4, mas suas tabelas e gráficos descrevem os modelos da V4 Preview. Eles são úteis para compreender a capacidade pretendida da arquitetura e a configuração de teste; não se trata de pontuações independentes referentes à versão da API Pro-0813, de data específica.
As notas da pré-avaliação não são as notas do Pro-0813
Arquitetura e resultados de testes de desempenho do DeepSeek.
Versões de produção desatualizadas listadas na documentação da API.
As notas da pré-visualização não podem ser reclassificadas como notas Pro-0813.
A atualização do Flash de 31 de julho também divulga os resultados dos agentes e indica o harness, as configurações e o suporte do Codex. Esses detalhes são importantes porque as tabelas de classificação entre fornecedores podem variar de acordo com a estrutura de teste, o orçamento de raciocínio, as definições das ferramentas e as regras de repetição de tentativas. Um resultado sem indicar o respectivo harness não é suficiente para declarar um vencedor incondicional.
Pela mesma razão, nossas três tarefas complementam as evidências oficiais, em vez de substituí-las. Elas mostram o que aconteceu em um cenário divulgado. Se você estiver comparando produtos de agentes, em vez de apenas APIs de modelos, nosso Guia comparativo entre o Codex e o código Claude explica por que o fluxo de trabalho em torno disso pode alterar a experiência do usuário.
Preços da API DeepSeek V4
A política de preços da API do DeepSeek é excepcionalmente agressiva no momento do lançamento. A tabela abaixo reproduz os valores oficiais por milhão de tokens verificados em 13 de agosto de 2026. A página oficial também alerta que os preços subirão significativamente no futuro; portanto, considere esses números como dados desatualizados, referentes à época do lançamento.
Preço por 1 milhão de tokens
Uma carga de trabalho simples, sem cache, com 10 milhões de tokens de entrada e 2 milhões de tokens de saída seria de $1,96 no Flash e $6,09 no Pro, com essas taxas. Essa ilustração não leva em conta acertos de cache, margens de lucro do provedor, novas tentativas e quaisquer alterações de preço posteriores. As equipes que estiverem comparando fornecedores devem utilizar uma única combinação de tokens e uma única base de cobrança; nossa Guia de preços da API Claude Opus 4.6 mostra por que a entrada, a saída e o armazenamento em cache precisam de linhas separadas.
O que significa a janela de contexto de 1M — e quais são os limites
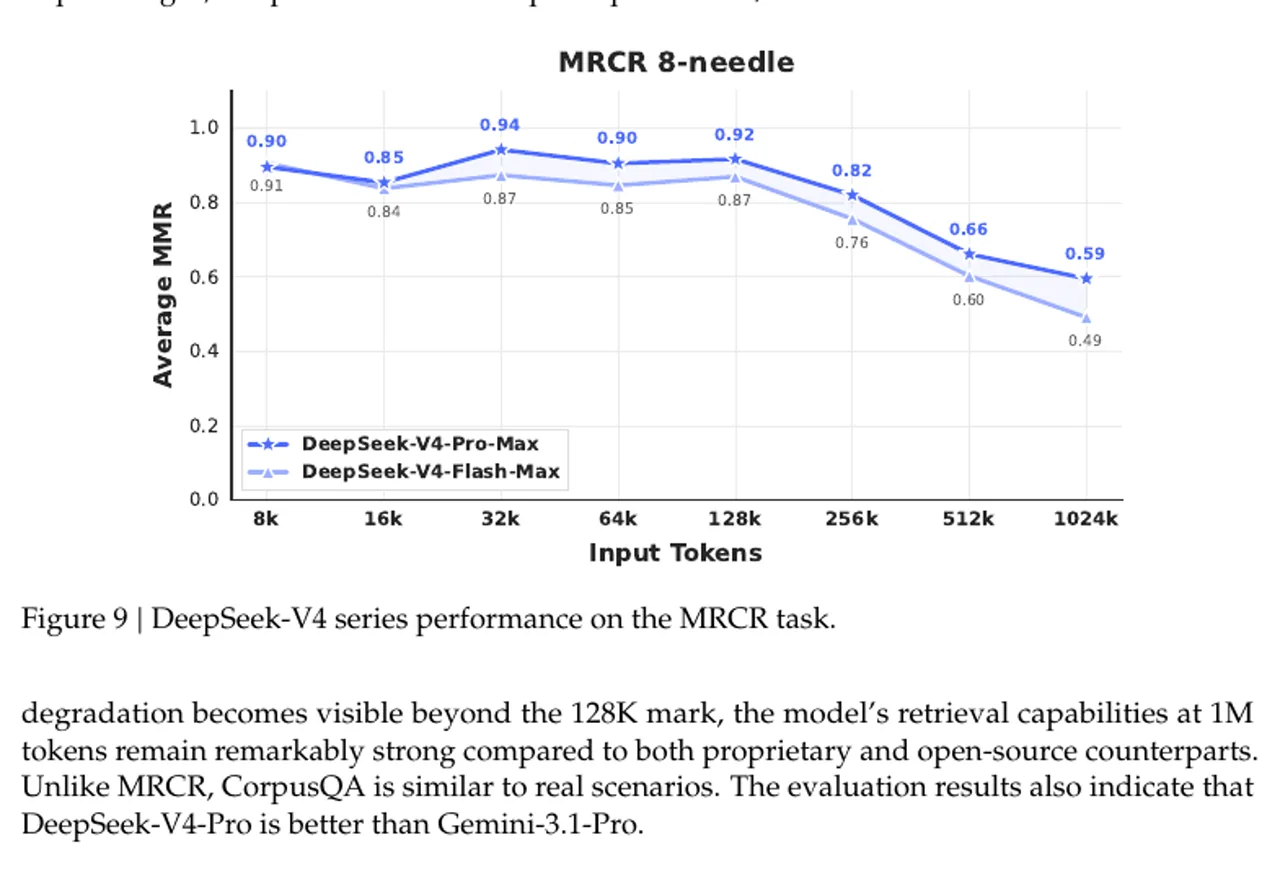
Uma janela de contexto de 1 milhão de tokens é uma capacidade, não uma garantia de recuperação perfeita em todas as posições. Ela oferece à API espaço para repositórios muito grandes, coleções de documentos, pacotes de pesquisa ou históricos de agentes. A questão da qualidade é se o modelo consegue recuperar o detalhe correto depois que evidências relevantes ficam ocultas entre centenas de milhares de tokens que distraem a atenção.
O relatório de pré-visualização do DeepSeek inclui um gráfico de resolução de coreferência em múltiplas rodadas (MRCR) para um conjunto de dados que varia de 8 mil a 1 milhão de tokens de entrada. A curva se mantém forte em comprimentos menores, mas apresenta declínio após 128 mil. Isso é uma evidência normal de um problema grave relacionado ao contexto longo, e é por isso que “suporta 1 milhão” nunca deve ser interpretado como “sem perdas em 1 milhão”.”
A interface da API tem limitações específicas. As do DeepSeek Guia da API de respostas descreve uma implementação sem estado: recursos como id_da_resposta_anterior, conversas, loja e histórico não são suportados. Entradas de imagem e arquivo também não são suportadas; portanto, é necessário extrair o texto ou construir a camada de estado fora do modelo.
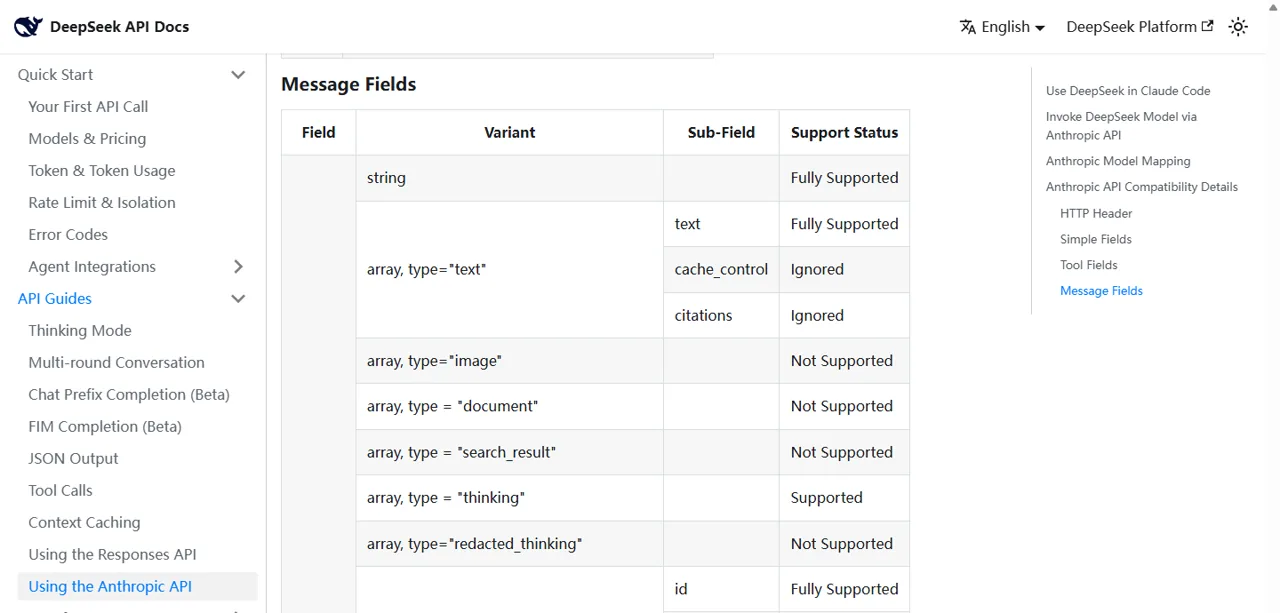
O Tabela de API compatível com Anthropic da mesma forma, indica que as variantes de imagem e mensagem de documento não são compatíveis. Compatibilidade, portanto, significa formatos de solicitação e ferramentas familiares — e não a correspondência exata, recurso por recurso, com todos os modelos ou clientes Anthropic.
Como testar o DeepSeek V4 Pro e o Flash
Você tem três opções práticas. Escolha de acordo com o que você deseja: uma conversa rápida, controle da API de produção ou um espaço de trabalho multimodelo.
Escolha sua forma de acesso
DeepSeek Web/Aplicativo
Ideal para testar o modelo por meio da interface de usuário da própria DeepSeek.
API oficial
Ideal para faturamento por token, ferramentas, JSON, estruturas de agentes e controle de produção.
GlobalGPT
Ideal para abrir arquivos do Pro ou do Flash em um ambiente de trabalho multimodelo mais abrangente, sem precisar criar um cliente primeiro.
Rota 1: chat oficial do DeepSeek
Comece em Site oficial do DeepSeek se você quiser apenas conhecer a experiência atual do consumidor. O acesso do consumidor e o faturamento da API são coisas distintas; o fato de haver uma interface de chat disponível não significa que a API seja gratuita.
Caminho 2: API oficial e agentes de programação
Uso deepseek-v4-pro ou deepseek-v4-flash com as interfaces documentadas compatíveis com OpenAI. Ambas oferecem suporte aos modos “thinking” e “non-thinking”, saída em JSON, chamadas de ferramentas, API de respostas e acesso compatível com Anthropic. O FIM se aplica apenas no modo “non-thinking”.
A DeepSeek também publica um guia oficial de integração do Codex. Se você estiver decidindo primeiro entre os shells de agente, compare Claude: Preços e limites de uso do código antes de presumir que o custo do token do modelo corresponde ao valor total da conta.
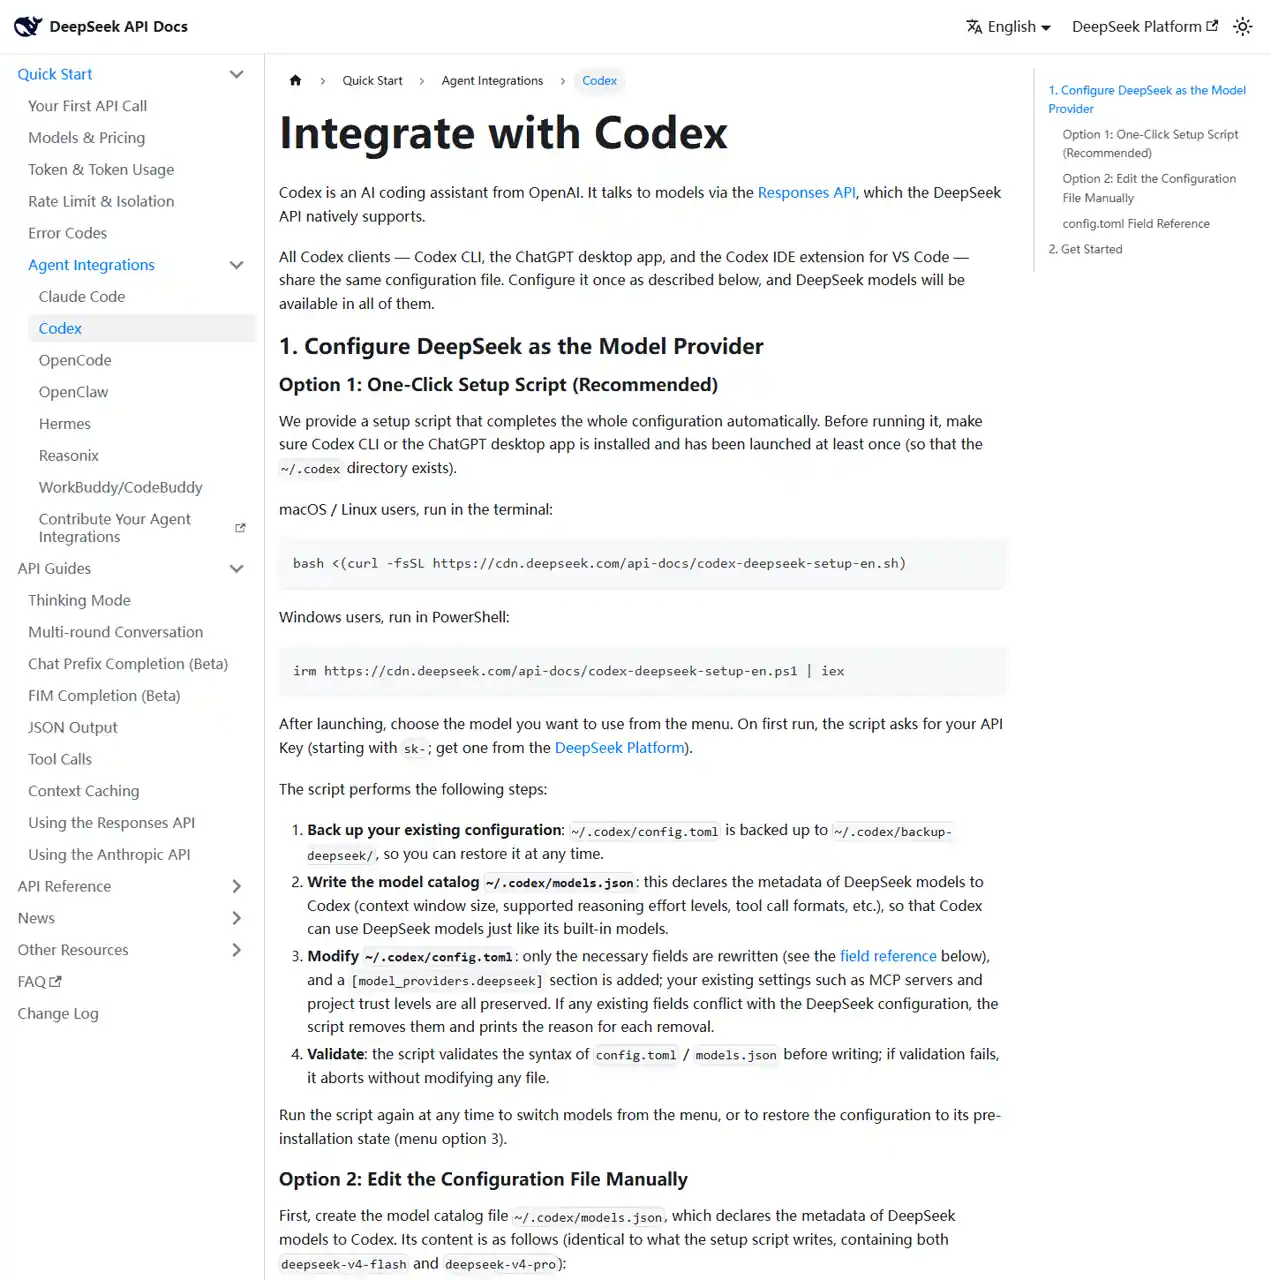
Os usuários do código Claude podem seguir a mesma lógica de endpoint e modelo descrita em nosso guia para Configurando um modelo no código Claude, ao verificar a tabela de compatibilidade em tempo real do DeepSeek para campos não suportados.
Rota 3: GlobalGPT
O GlobalGPT possui entradas específicas para ambos os modelos. A rota de conversão verificada é DeepSeek V4 Pro no GlobalGPT. Também existe uma página de produto em Flash, mas não encontramos um parâmetro de campanha específico para Flash que tenha sido confirmado; portanto, não vamos inventar um.
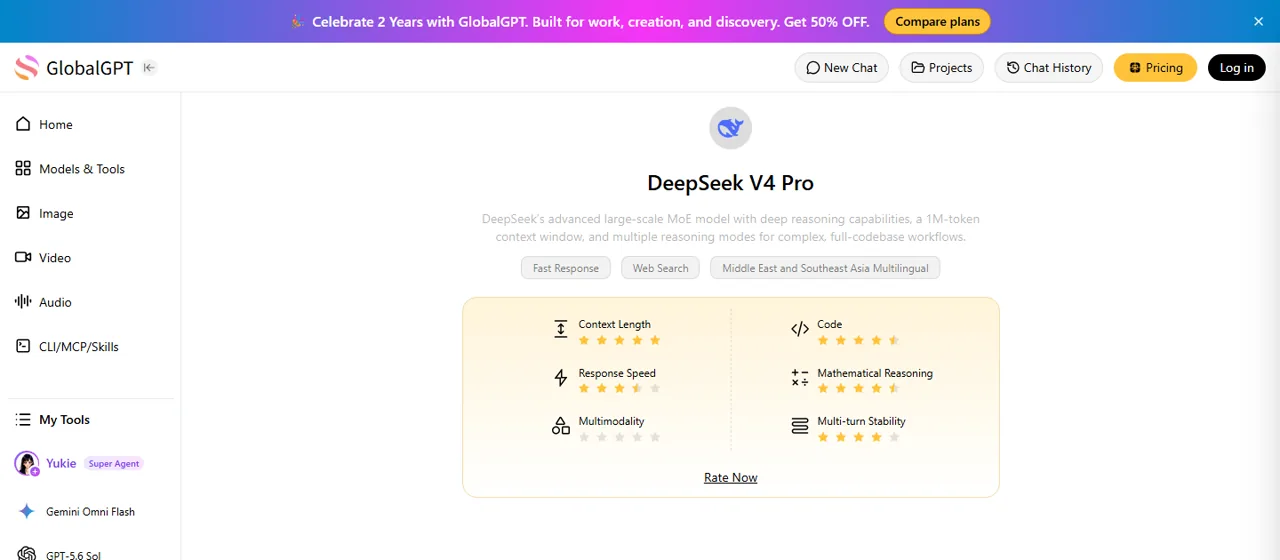
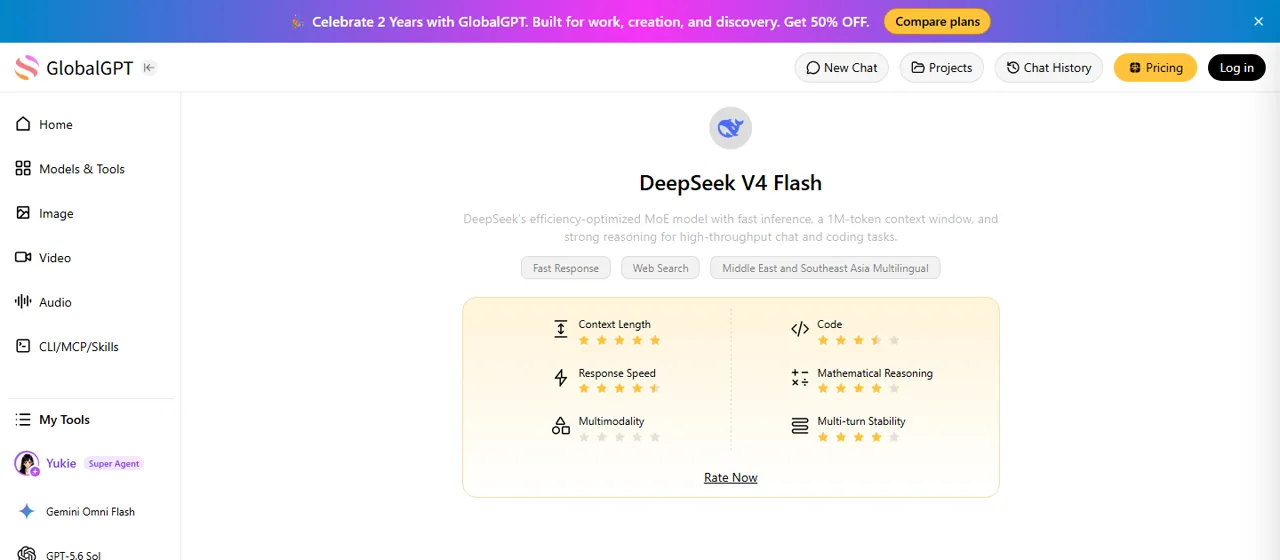
Para fluxos de trabalho de terminal, o Configuração do código GlobalGPT CLI no Claude explica como uma plataforma multimodelo pode se integrar a uma rotina de codificação já existente. Ela não substitui as ferramentas nativas do repositório; ela muda a forma como você acessa e compara modelos.
Qual modelo DeepSeek V4 você deve escolher?
Ajustar o modelo ao custo da falha
Flash
Escolha-o para bate-papos de alto volume, extração de dados, código de rotina, recuperação de informações e agentes com validação rigorosa. Ele foi aprovado com perfeição em duas das nossas três tarefas, pelo menor preço oficial.
Prós
Opte por ele quando aritmética rigorosa, formatação, políticas e raciocínio em múltiplos domínios se unirem em um único resultado final. Foi o único modelo a obter nota 12/12 em nosso memorando.
GlobalGPT
Escolha a rota da plataforma quando quiser testar o modelo ou comparar alternativas sem precisar, primeiro, escrever um cliente de API.
Para muitas equipes, o Flash é a melhor opção para a primeira implantação: é muito mais barato, suporta os mesmos limites de contexto e saída especificados e lidou com nossos testes de codificação e de recuperação de 20,7 mil sem qualquer perda de qualidade. Adicione verificações determinísticas para números, esquema e seções obrigatórias.
Mude para a versão Pro quando o tempo gasto com revisões ou o custo de erros superar a economia gerada pelo uso de tokens. A diferença de preço é real, mas também o é o valor de acertar, logo na primeira tentativa, um memorando detalhado sobre conformidade ou lançamento. Se sua lista de finalistas incluir outros assistentes, o mais abrangente Guia de escolha entre DeepSeek e ChatGPT pode ajudar a distinguir a qualidade do modelo do ecossistema do produto.
Conclusão: vale a pena comprar o DeepSeek V4 Pro?
Vale a pena considerar o DeepSeek V4 Pro quando o trabalho exige mais controle do que volume. Não é a opção padrão mais econômica: na API, a versão Pro custa três vezes mais do que a Flash nas principais linhas de entrada e saída com falha de cache, tanto em horários de pico quanto fora deles. Esse custo adicional faz sentido quando uma resposta incorreta gera retrabalho, sobrecarga de revisão ou risco operacional.
Para tarefas rotineiras, o Flash oferece o equilíbrio mais simples entre custo e escala. Para imagens, use o Vision-Exp. Se o objetivo não for a administração de APIs, mas sim alternar entre pesquisa, redação e assistência técnica, um espaço de trabalho multimodelo pode ser mais prático do que configurar cada serviço separadamente.
Próximo passo
Abra o DeepSeek V4 Pro em um espaço de trabalho que também reúna outros modelos para pesquisa, redação e assistência à programação.
Experimente o DeepSeek V4 ProPerguntas frequentes sobre o DeepSeek V4
O DeepSeek V4 Pro já foi lançado?
Sim. O DeepSeek V4 Pro entrou em disponibilidade geral em 13 de agosto de 2026 com o identificador de produção DeepSeek-V4-Pro-0813.
Qual é a diferença entre o DeepSeek V4 Pro e o Flash?
O Flash prioriza custo e concorrência, enquanto o Pro foi projetado para tarefas de texto com mais restrições e um custo de falha mais elevado. Ambos apresentam uma janela de contexto de 1 milhão de tokens e uma saída máxima de 384 mil tokens.
Quanto custa o DeepSeek V4 Pro?
Por 1 milhão de tokens, o preço do plano Pro fora do horário de pico é de $0,022 para entrada com acerto no cache, $0,66 para entrada com falha no cache e $1,98 para saída. Os preços nos horários de pico são $0,044, $1,32 e $3,96.
Quais são os horários de pico da API?
O horário de pico é das 01h00 às 04h00 e das 06h00 às 10h00 UTC, de segunda a sexta-feira. Nos demais horários, aplicam-se as tarifas fora do horário de pico.
O DeepSeek V4 aceita imagens?
deepseek-v4-flash-vision-exp aceita imagens. O guia oficial lista os formatos JPEG, PNG, GIF e WebP. Os modelos de texto “Pro” e “Flash” devem ser tratados separadamente.
A janela de contexto de 1 milhão de tokens garante uma recuperação perfeita?
Não. O limite de 1 milhão de tokens refere-se à capacidade. A recuperação ainda depende da estrutura do documento, da localização dos fatos, do prompt e do método de verificação.
Posso usar o DeepSeek V4 com o Codex?
Sim. A documentação oficial descreve uma integração por meio da API Responses e lista o Flash, o Pro e o Vision-Exp como opções de modelo.
Como posso testar o DeepSeek V4 Pro sem configurar uma API?
Você pode usar uma interface que ofereça o modelo, como a GlobalGPT. Essa opção é adequada para bate-papo, pesquisa, redação e assistência técnica; seu sistema de cobrança e seus recursos não são equivalentes aos do console oficial da API.