
É fácil interpretar erroneamente os preços do GPT-6 Sol, pois duas questões acabam se confundindo. Uma cotação de API é um cálculo por uso baseado em tokens e na tabela de preços do provedor. Uma rota de assinatura/fluxo de trabalho é uma decisão mais ampla sobre a frequência com que você precisa de um modelo, de vários modelos e de ferramentas conectadas.
Este guia utiliza o GPT-6 Sol em GlobalGPT para os testes práticos. A página oficial de lançamento do OpenAI indica que o GPT-6 Sol custa $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, com um desconto de 90% nas leituras de entrada em cache (cerca de $0,20 por milhão de tokens de entrada em cache). A calculadora abaixo utiliza essas taxas publicadas quando você as insere e mantém a opção de assinatura separada.
Para trabalhos interativos mais abrangentes, GlobalGPT reúne o GPT-6 Sol junto com outros modelos e funções de IA em um único painel. Isso é importante quando o trabalho propriamente dito passa da pesquisa para a elaboração de rascunhos, código, imagens, vídeo ou um fluxo de trabalho conectado à interface de linha de comando (CLI).
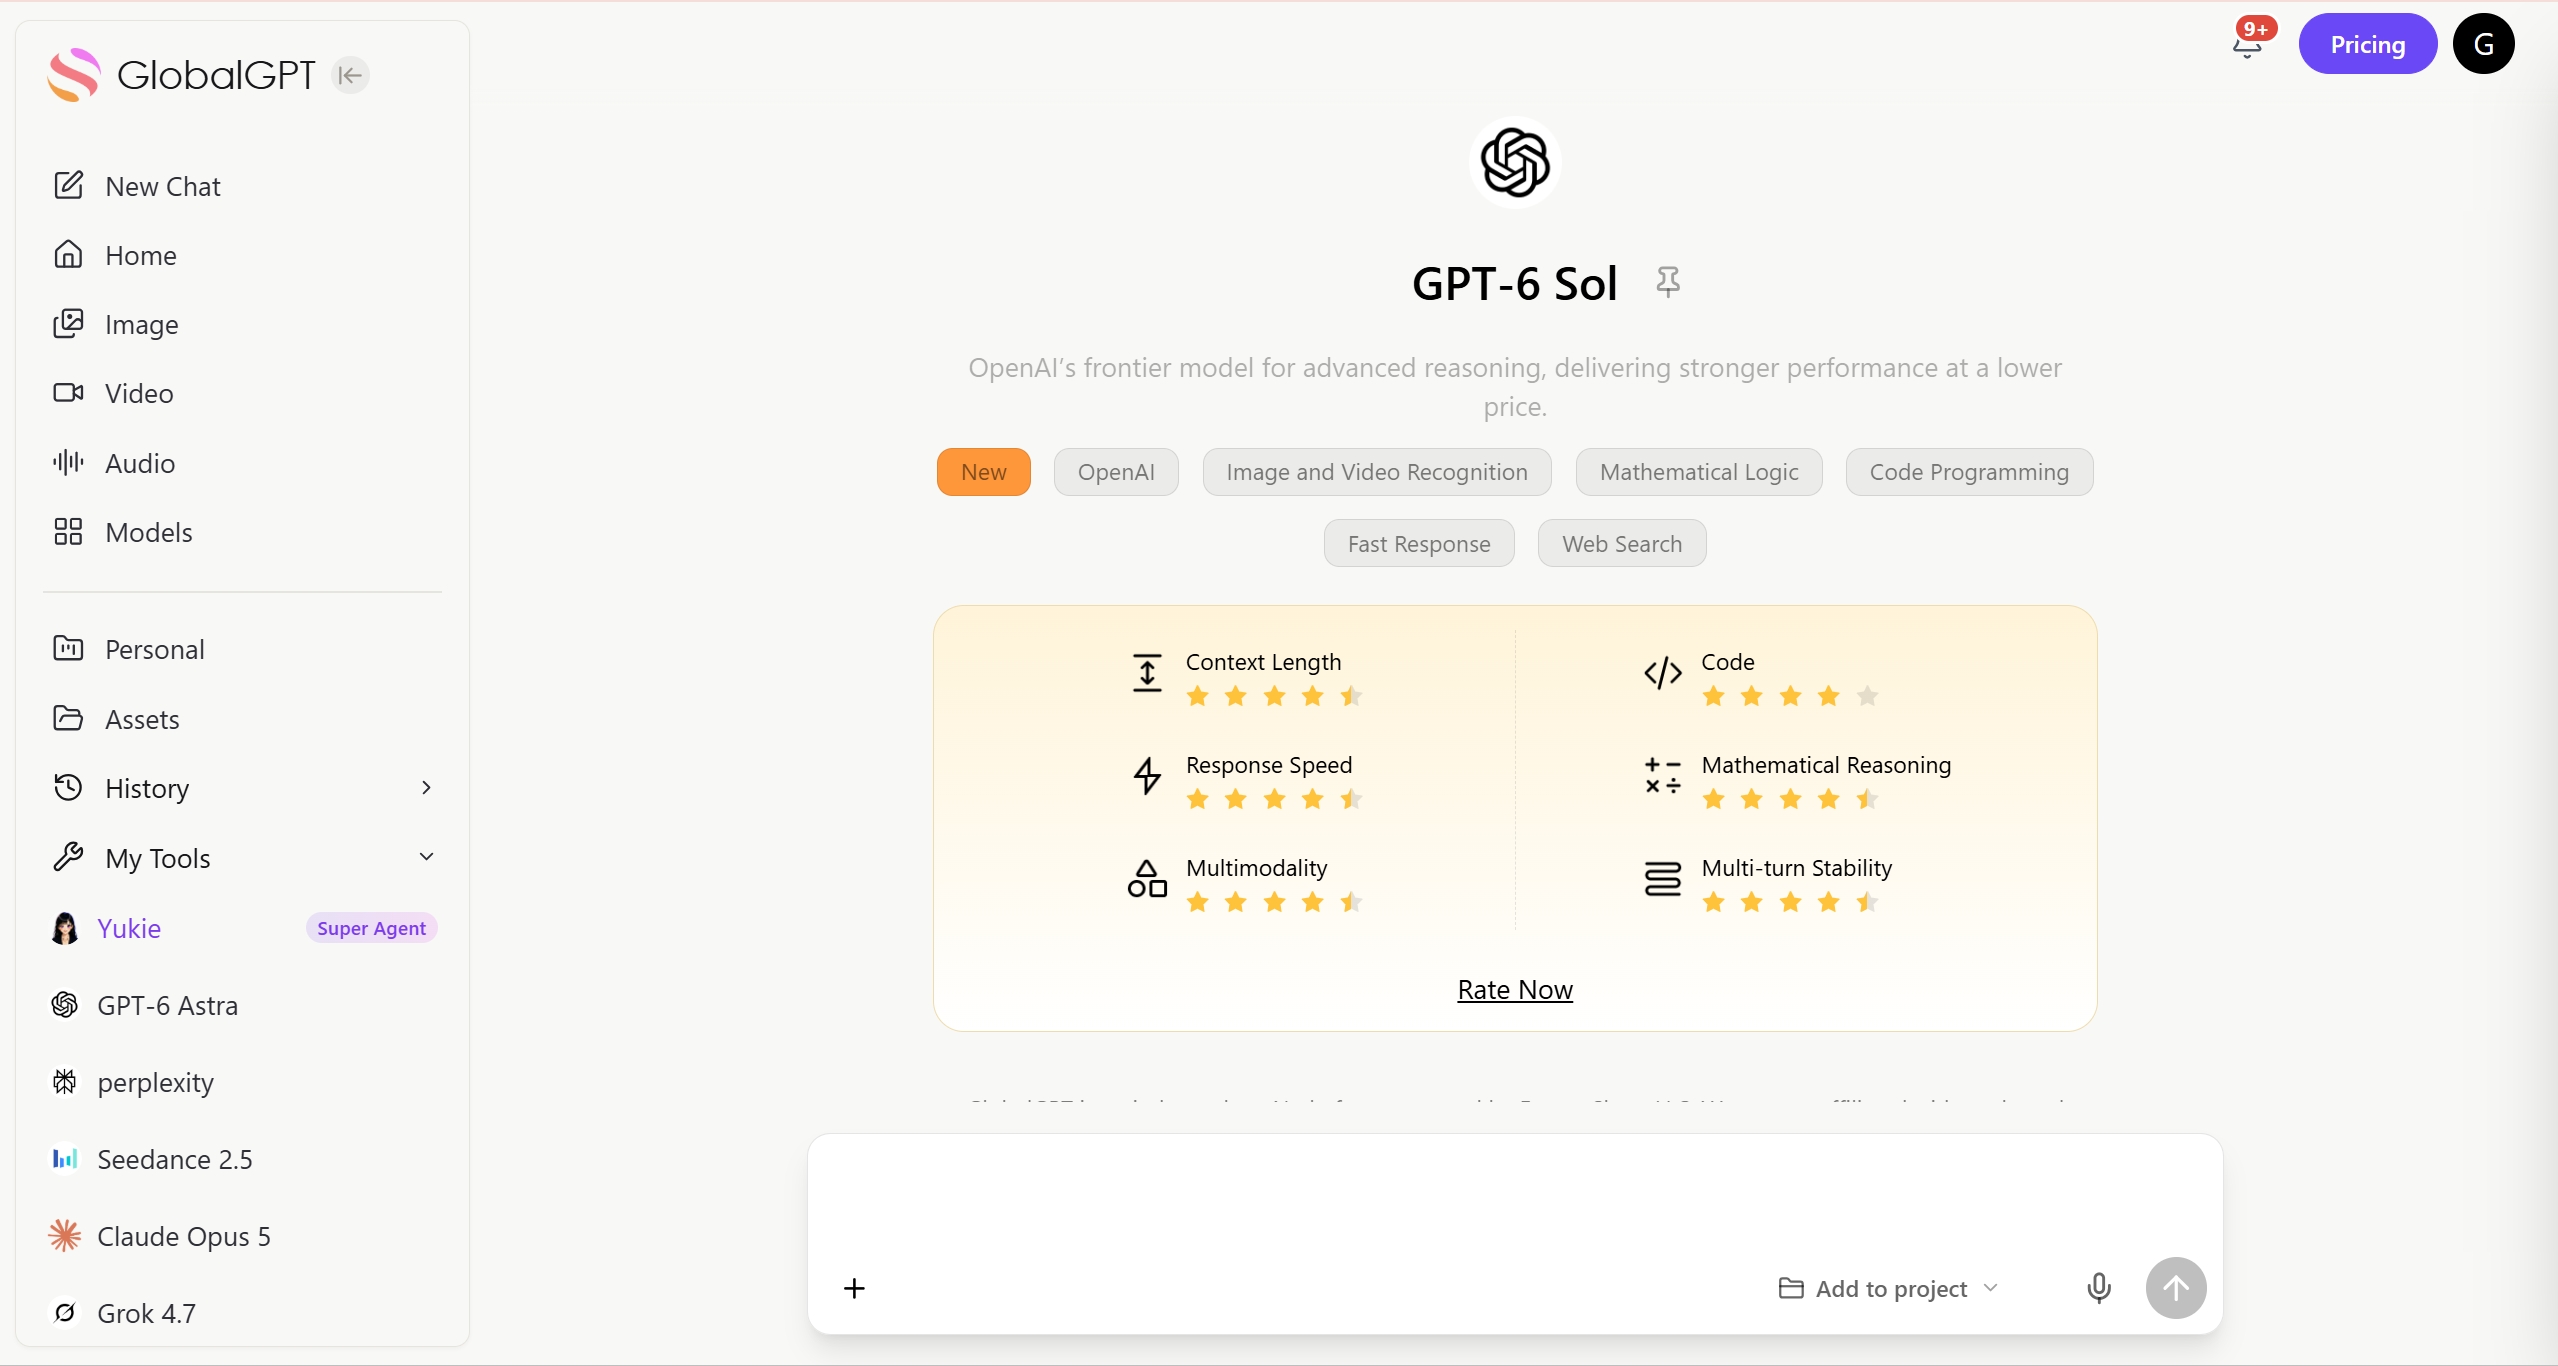
A Espaço de trabalho do GlobalGPT oferece um plano de assinatura que abrange diversos modelos e funções de IA. Trata-se de uma forma de compra diferente das chamadas de API cobradas por uso oferecidas por um provedor. O Análise do GPT-6 Sol explica como o modelo se encaixa em um fluxo de trabalho mais amplo.
O que pode significar “preço do GPT-6 Sol”
Há três questões distintas relacionadas a custos: o medidor de tokens de entrada/saída da API, regras opcionais, como processamento em cache ou em lote, e o valor de uma assinatura que inclui acesso e ferramentas de fluxo de trabalho. Apenas as duas primeiras podem ser reduzidas a uma fórmula de tokens.
- API: É ideal quando o software envia solicitações previsíveis e você precisa de uma estimativa rastreável para cada chamada.
- Assinatura/fluxo de trabalho: é mais eficaz quando as pessoas alternam entre modelos e funções durante uma tarefa mais ampla.
- Percurso misto: útil quando as tarefas de produção são programáveis, mas a exploração, a redação ou o trabalho multimodal são interativos.
Status oficial dos preços da API
O OpenAI indica que o GPT-6 Sol tem um custo de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. A mesma página do comunicado informa que as leituras de entradas em cache recebem um desconto de 90%, o que equivale a $0,20 por milhão de tokens de entrada em cache. O OpenAI apresenta essas taxas como 50% mais baixas do que o preço promocional do GPT-5.6 Sol.
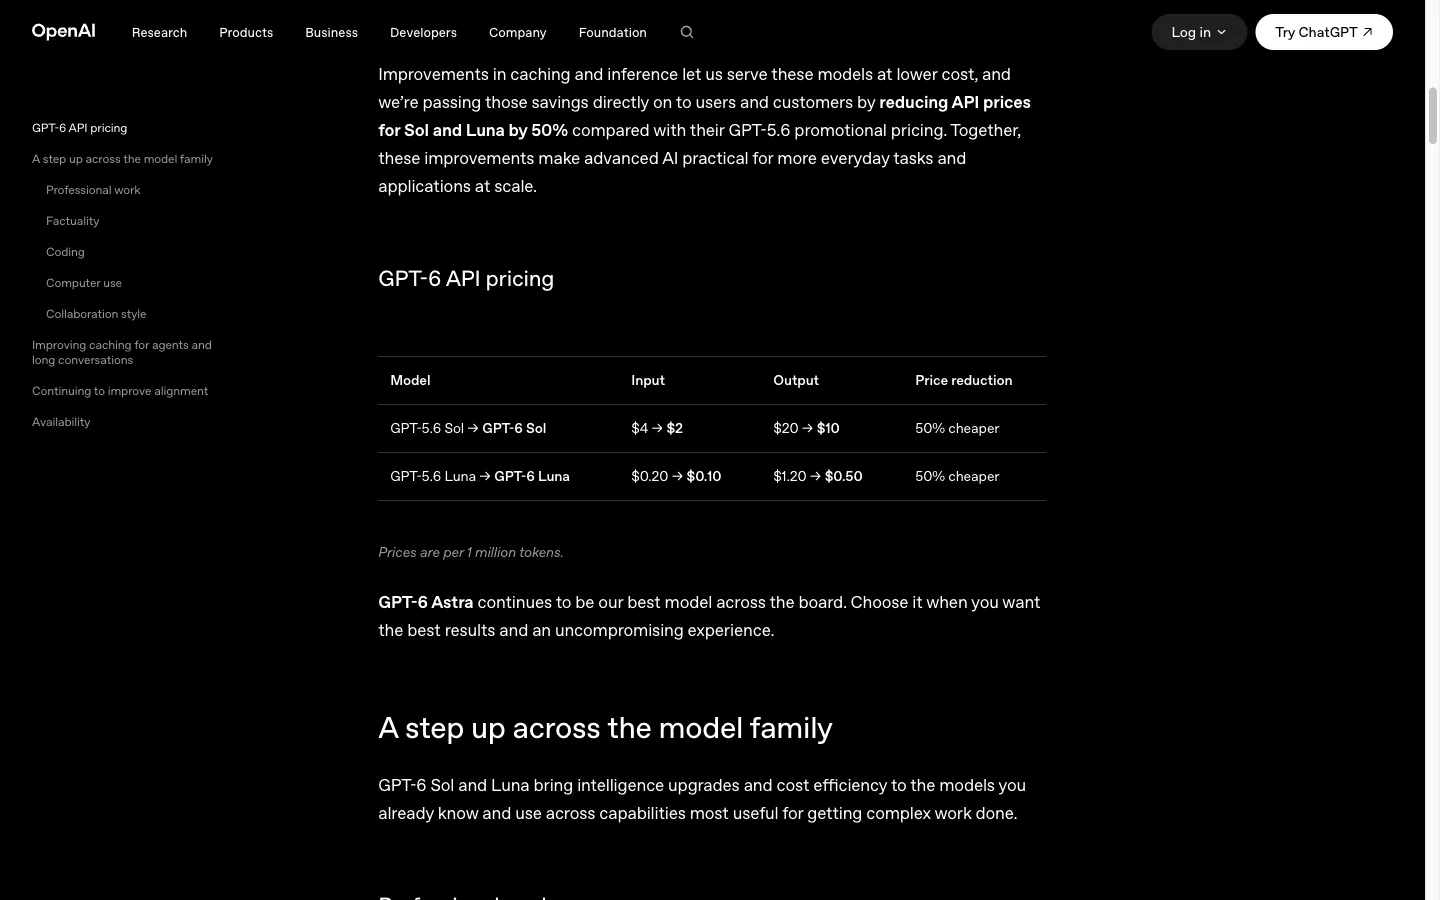
Com o mesmo número de tokens, a saída custa cinco vezes mais do que a entrada sem cache. Manter uma resposta concisa pode ser tão importante quanto encurtar o prompt.
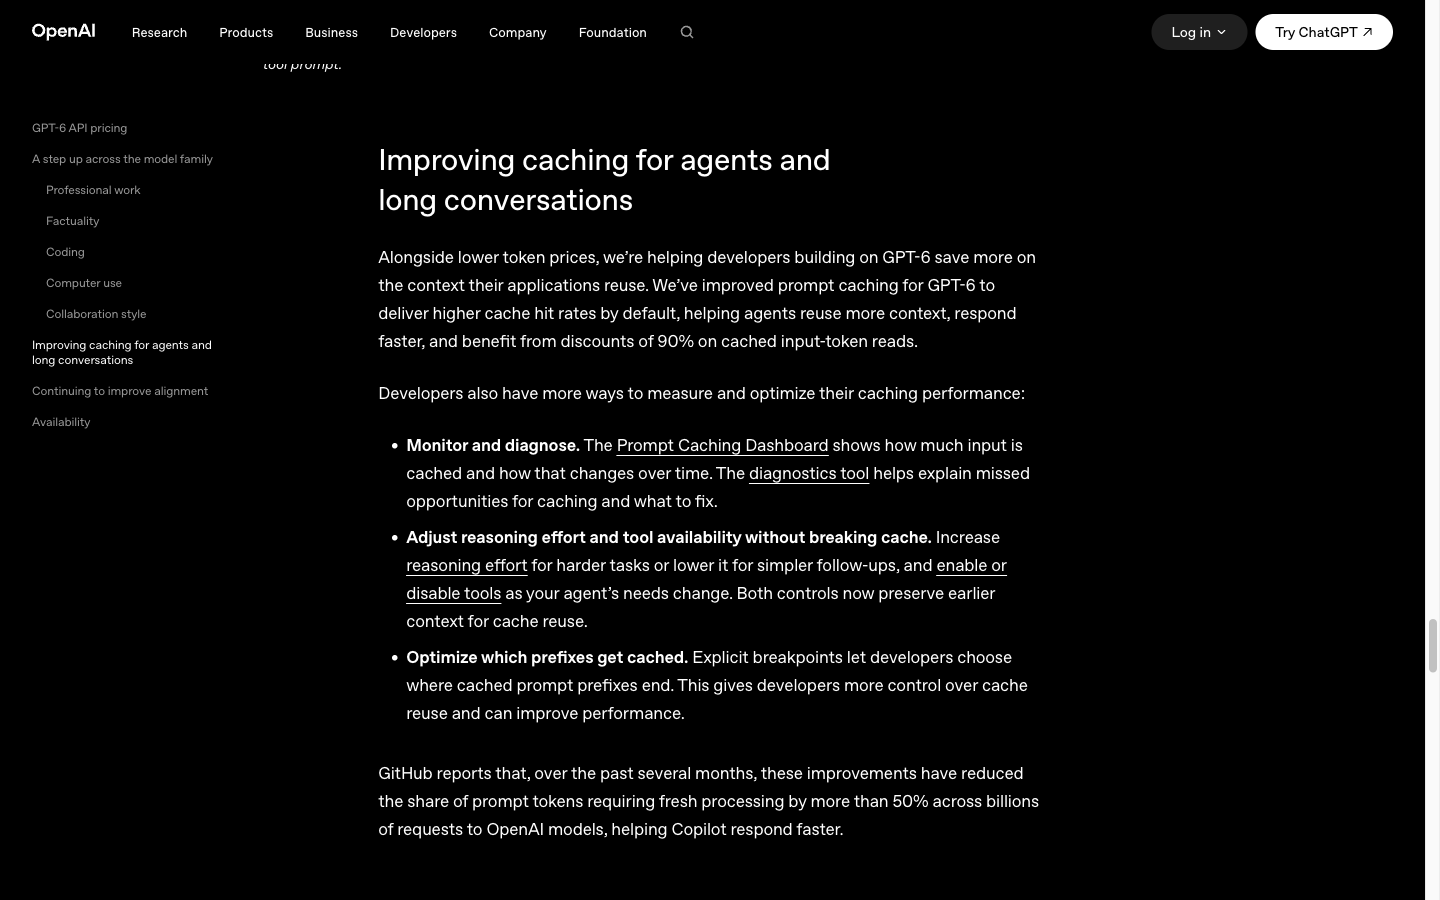
O desconto transforma $2 por milhão de tokens de entrada em $0,20 por milhão de leituras em cache qualificadas. Uma solicitação repetida não é prova de um acerto no cache; utilize os dados registrados de uso de tokens em cache ao reconciliar os custos reais.
Orçamentos elaborados com base nas tarifas publicadas
Os exemplos a seguir utilizam as tarifas do GPT-6 Sol publicadas. Eles mostram como a contagem de tokens se transforma em uma estimativa da API; não se trata do preço da assinatura.
| Cenário | Entrada | Saída | Fórmula | Resultado |
|---|---|---|---|---|
| Perguntas e respostas breves | 12.500 @ $2/M | 2.000 @ $10/M | 0,0125 × 2 + 0,002 × 10 | $0.045 |
| Livro-razão estruturado | 1.200.000 @ $2/M | 300.000 @ $10/M | 1,2 × 2 + 0,3 × 10 | $5.40 |
| Contexto armazenado em cache | 1.000.000 a $0,20/M | 100.000 @ $10/M | 1 × 0,20 + 0,1 × 10 | $1.20 |
Divida os tokens por um milhão antes de multiplicá-los pela taxa por milhão. Aplique a taxa armazenada em cache apenas aos tokens de entrada que realmente se qualificam para um acerto no cache; cobrem a entrada restante pela taxa padrão.
Um desconto na entrada de 90% não significa uma fatura 90% menor
Exemplo de cálculo: 1 milhão de tokens de entrada no total + 100.000 tokens de saída. A cor azul-petróleo representa o custo de entrada; a cor ferrugem, o custo de saída. Apenas o acerto no cache de entrada muda.
O valor economizado é $1,80, ou seja, 60% do total deste exemplo. A geração de resultados ainda custa $10 por milhão de tokens. Uma resposta longa pode, portanto, pesar bastante na conta, mesmo quando o prompt está armazenado em cache.
Custo = (entrada total − entrada armazenada em cache) / 1M × $2
 + entrada armazenada em cache / 1M × $0,20
 + saída / 1M × $10
Derivado de Taxas padrão publicadas da OpenAI e desconto por leitura em cache da 90%. Considera os acessos ao cache elegíveis; exclui taxas de ferramentas, impostos e outros ajustes de faturamento.
API interativa e calculadora de fluxo de trabalho
Utilize as taxas GPT-6 Sol publicadas como valores iniciais: entrada $2/M, saída $10/M e entrada em cache $0,20/M. O seletor de rota explica o limite de decisão GlobalGPT sem incluir o preço da assinatura nos cálculos da API.
Calculadora de custos da API do GPT-6 Sol
Use as taxas OpenAI publicadas como ponto de partida: entrada $2/M, saída $10/M e entrada em cache $0,20/M. Você pode substituí-las quando uma tabela de taxas oficial mais recente for atualizada.
Resultado da API = (entrada total − entrada em cache) ÷ 1.000.000 × taxa de entrada + saída ÷ 1.000.000 × taxa de saída + entrada em cache ÷ 1.000.000 × taxa de cache. O valor do fluxo de trabalho é apresentado como uma decisão de roteamento, não como um preço de assinatura.
Testes práticos do GPT-6 Sol
O que essas três verificações práticas realmente comprovam
| Verificar | Resultado observado | O que é compatível |
|---|---|---|
| P01: aritmética básica | $0.041, com base nas taxas fictícias fornecidas para $2/$8 | Com base nas taxas indicadas e considerando que se trata de uma estimativa fictícia; não é a conta oficial de hoje. |
| P02: orçamento estruturado | $7.20 do livro-razão fictício $3/$12; 105 tokens de entrada efetivos | Cálculos em JSON e preservação de incógnitas. O número de 1,2 milhão de tokens era um valor do livro-razão, não um teste de contexto extenso. |
| P03: função da calculadora | A primeira tentativa atingiu seu limite de saída; a segunda retornou a função completa | Geração de código com uma tentativa de repetição declarada. Não foram testados a API de processamento em lote, uma fatura de prestador de serviços nem descontos por lote. |
Essas verificações esclarecem como o modelo lida com uma tarefa de precificação. A tabela de preços oficial acima indica o que o prestador cobra. Manter essas questões separadas evita que um valor gerado pelo modelo seja interpretado como uma afirmação sobre preços.
Esses testes utilizam o GPT-6 Sol no GlobalGPT. Eles mostram como o modelo lida com cálculos de preços, dados estruturados e código de calculadora; a tabela de cobrança do provedor acima foi retirada da página de lançamento publicada do OpenAI. P01 e P02 mantêm suas primeiras saídas. P03 foi repetido uma vez porque sua primeira resposta atingiu o limite de saída antes de concluir a função.
P01 · Perguntas e respostas sobre operações a descoberto
P01-curto · primeira saída retornadaHTTP 2005,23 sNesta verificação: O GPT-6 Sol processou o prompt em GlobalGPT. O resultado mostra como ele lida com cálculos de preços e instruções estruturadas; trata-se de algo independente de qualquer tabela de preços do provedor.
Uso: 109 entradas · 132 saídas · 241 no total · motivo_de_conclusão=parada.
Ver o prompt exato e a saída completa
Solicitação
Você está testando um explicador de preços. Use apenas esta tabela de preços fictícia fornecida: entrada $2,00 por milhão de tokens, saída $8,00 por milhão de tokens. Pergunta: quanto custariam 12.500 tokens de entrada e 2.000 tokens de saída? Mostre a fórmula, identifique o resultado como fictício e indique quais informações ainda seriam necessárias para um orçamento real de um provedor.
Saída completa
**Custo hipotético:**
(12.500 ÷ 1.000.000 × $2,00) + (2.000 ÷ 1.000.000 × $8,00) = **$0,041** (4,1¢).

Para obter uma cotação real de um fornecedor, você precisaria saber o nome do fornecedor e o modelo, suas tarifas atuais e quaisquer descontos, cobranças extras ou impostos aplicáveis.
P02 · Orçamento estruturado
Estrutura P02 · primeiro resultado retornadoHTTP 2005,639 sNesta verificação: O GPT-6 Sol processou o prompt em GlobalGPT. O resultado mostra como ele lida com cálculos de preços e instruções estruturadas; trata-se de algo independente de qualquer tabela de preços do provedor.
Uso: 105 entradas · 196 saídas · 301 no total · motivo_de_conclusão=parada.
Ver o prompt exato e a saída completa
Solicitação
Retorne um objeto JSON compacto com as chaves input_cost, output_cost, total_cost, assumptions e unknowns. Use este livro-razão fictício: 1.200.000 tokens de entrada, 300.000 tokens de saída; as taxas são $3/M para entrada e $12/M para saída; a taxa de entrada em cache não é fornecida. Não adicione um desconto em cache nem qualquer informação do provedor.
Saída completa
{"custo_de_entrada":3,60,"custo_de_saída":3,60,"custo_total":7,20,"suposições":["USD; todos os tokens de entrada cobrados a $3/M, sem desconto de cache"],"incógnitas":["taxa de entrada em cache","contagem de tokens de entrada em cache"]}P03 · Função de cálculo de custos
Lote de códigos P03 · segunda tentativa após truncamento do limite de saídaHTTP 20013,602 sNesta verificação: O GPT-6 Sol processou o prompt em GlobalGPT. O resultado mostra como ele lida com cálculos de preços e instruções estruturadas; trata-se de algo independente de qualquer tabela de preços do provedor.
Uso: 129 entradas · 757 saídas · 886 no total · motivo_conclusão=interrupção.
Tentar novamente: A tentativa 1 foi interrompida no `max_tokens` e ficou incompleta; nova tentativa permitida devido a saída inválida
Ver o prompt exato e a saída completa
Solicitação
Escreva uma função JavaScript completa e executável, chamada `estimateTokenCost(inputTokens, outputTokens, inputRatePerMillion, outputRatePerMillion)`, para uma calculadora de preços. Requisitos: retorne um erro de validação claro para valores vazios, não numéricos, negativos ou não finitos; aceite zero somente quando ambas as contagens de tokens forem zero; use aritmética comum; inclua um exemplo normal e um exemplo finito muito grande sem causar o valor infinito; não afirme que essas taxas são reais. Retorne apenas o código JavaScript completo e uma breve nota.
Saída completa
```javascript
function estimateTokenCost(
  inputTokens,
  outputTokens,
  inputRatePerMillion,
  outputRatePerMillion
) {
  const values = {
    inputTokens,
    outputTokens,
    inputRatePerMillion,
    outputRatePerMillion
  };

  for (const [name, value] of Object.entries(values)) {
    if (typeof value !== "number" || !Number.isFinite(value)) {
      return { error: `${name} must be a finite number.` };
    }
    if (value < 0) {
      return { error: `${name} cannot be negative.` };
    }
  }

  const bothCountsZero = inputTokens === 0 && outputTokens === 0;
  if (!bothCountsZero && (inputTokens === 0 || outputTokens === 0 ||
      inputRatePerMillion === 0 || outputRatePerMillion === 0)) {
    return { error: "Zero values are allowed only when both token counts are zero." };
  }

  const cost =
    (inputTokens / 1_000_000) * inputRatePerMillion +
    (outputTokens / 1_000_000) * outputRatePerMillion;

  if (!Number.isFinite(cost)) {
    return { error: "The calculated cost is not finite." };
  }

  return { cost };
}

// Illustrative rates only; these are not real prices.
console.log(estimateTokenCost(1_000, 500, 2, 4));
console.log(estimateTokenCost(1e150, 2e150, 3e150, 4e150));
```

Note: The examples use hypothetical rates.
API x rota de fluxo de trabalho GlobalGPT
O preço é apenas um dos fatores a serem considerados na decisão. Uma API pode ser a ferramenta certa para uma chamada de back-end, mesmo quando uma assinatura ou um fluxo de trabalho seja a melhor opção para o trabalho humano envolvido.
| Pergunta | Rota da API | Rota do fluxo de trabalho GlobalGPT |
|---|---|---|
| Como o custo é calculado? | Fichas com medição de consumo, de acordo com a tabela de preços de um provedor verificado. | Termos atuais do plano, regras de acesso e valor do fluxo de trabalho; verifique a página ativa. |
| Que tipo de trabalho é adequado? | Chamadas programáveis, tarefas em lote, serviços de produção. | Pesquisa interativa, redação, programação e diversas funções de IA em um único painel. |
| O que você deve verificar? | Unidades de entrada/saída, regras de cache/lote, limites e ID do modelo. | Preço atual do plano, mapeamento de modelos, cotas e controles de uso. |
| Qual é o papel do CLI? | Integração direta de aplicativos. | A interface de linha de comando (CLI) do GlobalGPT pode integrar o acesso aos modelos com terminais e fluxos de trabalho existentes, quando disponíveis na sua conta. |
Colete os números reais de tokens do seu aplicativo, calcule a exposição da API com a tabela de preços verificada e, separadamente, estime o valor do painel multimodelo ao longo do restante da tarefa. Mantenha esses registros separados.
PERGUNTAS FREQUENTES
Qual é o preço oficial da API do GPT-6 Sol?
O OpenAI indica que o GPT-6 Sol custa $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. As leituras de entrada em cache recebem um desconto de 90%, equivalente a $0,20 por milhão de tokens de entrada em cache, conforme indicado na página de lançamento publicada.
O GPT-6 Sol está incluído no plano GlobalGPT?
Não deduza a inclusão de um plano com base no diretório de modelos. Verifique a página do plano GlobalGPT atual e o mapeamento de modelos exibido para a sua conta.
Como faço para estimar uma solicitação de API?
Primeiro, subtraia a entrada armazenada em cache do total de entradas. Cobrar a entrada não armazenada em cache a $2/M, a entrada armazenada em cache elegível a $0,20/M e a saída a $10/M. Acrescentar, quando aplicável, os custos de ferramentas ou outros encargos documentados separadamente.
Devo usar uma API ou uma assinatura?
Utilize a API para chamadas programáveis com tarifação por minuto e uma tabela de tarifas verificada. Considere a opção GlobalGPT quando seu trabalho abranger vários modelos e funções de IA em um único painel. Uma rota mista pode ser uma boa opção quando as chamadas de produção e o trabalho interativo apresentam necessidades diferentes.
Deixe que a tabela de preços faça os cálculos e que o fluxo de trabalho tome as decisões. Verifique novamente os preços em tempo real e os termos do plano antes de comprometer o orçamento.









