Comece com o som que você quer produzir. Escolha o Pick Eleven Music v2 para músicas e instrumentais estruturados, o Qwen Audio 3.0 TTS Flash para narração e voz expressiva, e o Seed Audio 1.0 quando quiser que falas, sons de ambiente e efeitos sejam combinados em uma cena completa.
Você não precisa encontrar um único modelo de áudio ‘ideal’. Um criador que produz música de fundo precisa de algo diferente de um profissional de marketing que grava uma narração ou de um cineasta que está montando uma cena em uma estação ferroviária. Testamos esses trabalhos reais — não apenas listas de recursos — e você pode ouvir todas as dez primeiras produções abaixo.
Se você quiser experimentar a mesma ideia com seu próprio prompt, GlobalGPT oferece um único local para alternar entre os três. Trata-se também de um espaço de trabalho multimodelo mais abrangente: você pode usar modelos como o GPT-5.6 Sol, o Claude Opus 4.8 e o Gemini 3.1 Pro para redação e pesquisa e, em seguida, passar para o GPT Image 2 ou o Seedance 2.0 quando o projeto precisar de imagens ou vídeos. Isso significa que você pode esboçar o roteiro, gerar o áudio e continuar desenvolvendo o restante do projeto sem precisar juntar uma série de ferramentas separadas. O acesso aos modelos varia de acordo com o plano.
Comece pelo que você quer fazer
Esses são pontos de partida, não um ranking universal.
Resposta rápida: qual modelo é mais adequado para cada tarefa de áudio?
Aqui está uma maneira simples de decidir: escolha com base no resultado final, não na marca. O Eleven é o ponto de partida natural quando o produto final é música; o Qwen TTS Flash é ideal para narração e vozes expressivas; o Seed é adequado para cenas que exigem diálogo, ambiente sonoro e efeitos juntos. Nossas seis tarefas práticas mostram em quais situações cada opção se destacou, e os dez exemplos abaixo permitem que você mesmo avalie as vantagens e desvantagens de cada uma.
| Modelo | Comece por aqui quando… | O que tentamos | Lembre-se de que |
|---|---|---|---|
| Eleven Music v2 | Você precisa de uma música ou de uma faixa instrumental estruturada | Dois confrontos musicais e uma apresentação de canções com vocais | Não o utilizamos para a narração |
| Qwen Áudio 3.0 TTS Flash | Você precisa de narração ou de uma voz expressiva | Dois confrontos de discursos | Esses resultados se aplicam à versão do Flash testada |
| Seed Audio 1.0 | Você precisa de uma cena completa com vários tipos de som | Música, discurso e uma cena em uma estação ferroviária | Uma saída flexível não reproduz todas as características do upstream |
Em primeiro lugar, esses são três tipos diferentes de modelo de áudio
Eleven Music v2: um fluxo de trabalho dedicado à música
ElevenLabs descreve Eleven Music como texto transformado em música, com controle sobre gênero, estilo e estrutura. A documentação também mostra resultados vocais ou instrumentais, geração multilíngue e edição por seção ou em toda a música. Esses recursos fazem com que seja o fluxo de trabalho dedicado à música mais claro aqui; isso não significa que seja o mesmo tipo de abordagem de TTS que o Qwen.

Qwen Audio 3.0 TTS Flash: a rota de fala testada aqui
Qwen Audio 3.0 TTS Flash — a rota exata do Anywhere é qwen-audio-3.0-tts-flash—é a via da fala utilizada nos níveis B1 e B2. Documentação sobre síntese de voz do Alibaba Cloud inclui esse nome exato do Flash em seu contexto de voz personalizada. Este artigo não transfere informações sobre duração, formato ou vozes integradas de outras linhas ou variantes do Qwen.

Seed Audio 1.0: um fluxo de trabalho mais abrangente para o cenário de áudio
Cargos na ByteDance Seed Audio 1.0 para a geração de cenas completas, abrangendo voz, efeitos sonoros, ambiente e orquestração unificada. Isso a torna a escolha natural quando uma saída precisa coordenar vários tipos de som. A imagem capturada não sugere visivelmente que se trate de música; portanto, as observações musicais neste artigo se baseiam em nossos testes práticos, e não nessa imagem.

O separado Página da API do BytePlus identifica seed-audio-1.0 como uma rota sem streaming, com entradas de áudio ou imagem de referência, controle de tempo e saída de até 120 segundos. Esses são os dados da rota, mantidos separados da declaração mais ampla sobre o posicionamento do modelo.

Como testamos os três fluxos de trabalho de áudio
Congelamos as instruções antes da geração, enviamos dez tarefas em sequência e mantivemos a primeira saída válida de cada tarefa. Todas as dez solicitações foram bem-sucedidas, sem nenhuma tentativa de repetição. Os trechos de preparação foram excluídos; o áudio de teste abaixo é a primeira mídia válida, sem edição.
- Provas oficiais: documentação do produto ou da API do próprio fabricante.
- Evidências observadas da rota: formato, duração, custo, decodificação e verificações de sinal desta sessão.
- Provas auditivas: as preferências em pares, em teste cego, de um usuário por A1, A2, B1 e B2, além da análise semântica de C1 e C3.
- Limites: A verificação de estabilidade não foi executada; B1 e B2 não foram transcritos nem verificados automaticamente, palavra por palavra.
O valor total cobrado foi de $0,4819752667 para dez saídas. Esse valor refere-se a esta sessão e não constitui uma promessa oficial de preço.
Testes de música: Eleven Music v2 x Seed Audio 1.0
A1: Trilha sonora de fundo para documentário
A1: Trilha sonora de fundo para documentário
Uma trilha instrumental de 30 segundos para um documentário de viagem, com um desenvolvimento suave e um final conclusivo.
Mostrar o prompt exato que travou
Crie uma trilha instrumental de 30 segundos para um curta-metragem documental sobre viagens. Comece com um suave dedilhado de violão e um piano aconchegante, acrescente uma percussão manual leve após o primeiro terço, vá intensificando suavemente e termine com uma cadência limpa e resolvida. O tom deve ser otimista e reflexivo. Sem vocais, sem diálogos e sem efeitos sonoros.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primeira data válida | 30,041 s | MP3, 44,1 kHz, estéreo | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Primeira data válida | 30.000s | PCM WAV, 40 kHz estéreo | $0.0700000 |
- Verificações objetivas
- Ambos os arquivos foram decodificados corretamente, não apresentaram sinais próximos ao clipping e terminaram com um fade nítido. Não foi registrada a conformidade exaustiva dos instrumentos.
- Avaliação do ouvinte
- O ouvinte preferiu o Eleven Music v2 porque a transição do som leve para o pesado parecia mais natural e a coordenação instrumental soava mais harmoniosa.
- Resultado da tarefa
- O número onze foi escolhido para esta tarefa inicial.
- Limitações
- Uma primeira saída válida por modelo; a análise de estabilidade não foi executada.
Prova de compreensão auditiva do A1
Ouça as primeiras gravações do A1
Jogue qualquer uma das cartas para comparar os dois modelos diretamente.
Eleven Music v2
eleven-music-v2Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
Seed Audio 1.0
seed-audio-1.0Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
No caso da faixa A1, o ouvinte escolheu a primeira versão da Eleven por considerar que ela apresentava uma transição mais natural do som leve para o pesado e uma coordenação instrumental mais harmoniosa.
A2: Sinal estruturado para o lançamento de um produto
A2: Sinal estruturado para o lançamento de um produto
Uma sequência instrumental cronometrada de 30 segundos, dividida em três partes: batida minimalista, adição de bateria e aumento da energia, seguida de um final brilhante e ascendente.
Mostrar o prompt exato que travou
Crie uma trilha instrumental de 30 segundos para o lançamento de um produto, dividida em três seções bem definidas: 0–8 segundos, um pulso minimalista de sintetizador; 8–22 segundos, acrescente uma bateria eletrônica nítida e energia harmônica crescente; 22–30 segundos, apresente um clímax final brilhante e um final limpo. Moderna e confiante, mas sem ser agressiva. Sem vocais, falas ou sons ambientais.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primeira data válida | 30,041 s | MP3, 44,1 kHz, estéreo | $0.0750000 |
| Seed Audio 1.0 | seed-audio-1.0 | Primeira data válida | 27,704 s | PCM WAV, 40 kHz estéreo | $0.0646436 |
- Verificações objetivas
- Ambos os arquivos foram decodificados corretamente, sem quase nenhum clipping. O Seed retornou 27,704 segundos para uma solicitação de 30 segundos; trata-se de um comportamento normal da rota, e não de uma perda de qualidade.
- Avaliação do ouvinte
- O ouvinte preferiu o Seed Audio 1.0 por ter uma introdução mais nítida e camadas musicais mais ricas; a abertura do Eleven era difícil de ouvir.
- Resultado da tarefa
- Semente preferida para esta tarefa de primeira saída; os dois testes musicais foram separados.
- Limitações
- O tempo exato de cada seção não foi verificado de forma exaustiva; o teste de estabilidade não foi realizado.
Prova de compreensão auditiva do nível A2
Ouça as primeiras gravações do A2
Jogue qualquer uma das cartas para comparar os dois modelos diretamente.
Eleven Music v2
eleven-music-v2Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
Seed Audio 1.0
seed-audio-1.0Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
No caso do A2, a primeira resposta do Seed conquistou a preferência dos ouvintes porque a introdução era mais nítida e as camadas soavam mais ricas. O Seed apresentou um tempo de 27,704 segundos para uma solicitação de 30 segundos; registramos essa variação separadamente, não como uma penalidade de qualidade. Com uma tarefa musical favorecendo cada modelo, não há um vencedor na categoria de música.
Testes de síntese de voz: Qwen TTS Flash x Seed Audio 1.0
B1: Narração documental neutra
B1: Narração documental neutra
A mesma narração em inglês sobre o porto, com tom calmo e neutro, ritmo moderado e pausas naturais.
Mostrar o prompt exato que travou
Todas as manhãs, o porto acorda antes da cidade. As balsas cruzam as águas, as luzes das lojas se acendem e os primeiros passageiros chegam ao cais. Às sete horas, a tranquila orla já se tornou o centro do dia. Narração documental tranquila, em inglês claro e neutro. Use um ritmo moderado e pausas naturais. Sem música, sons de ambiente ou efeitos sonoros.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Qwen Áudio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Primeira data válida | 27,507 s | MP3, 22,05 kHz mono | $0.0051300 |
| Seed Audio 1.0 | seed-audio-1.0 | Primeira data válida | 18,780 s | PCM WAV, 40 kHz estéreo (canais idênticos) | $0.0438200 |
- Verificações objetivas
- Ambos os arquivos foram decodificados corretamente e continham atividade semelhante à fala e pausas. O usuário não relatou nenhum problema óbvio com o texto.
- Avaliação do ouvinte
- O ouvinte preferiu o Qwen por considerá-lo mais natural e com um tom de documentário; o Seed soou rígido, como um lembrete antes de uma prova.
- Resultado da tarefa
- O Qwen é o modelo preferido para esta tarefa de primeira saída.
- Limitações
- A precisão literal não foi verificada; o teste de estabilidade não foi realizado.
Prova de compreensão oral do nível B1
Ouça as primeiras gravações do B1
Jogue qualquer uma das cartas para comparar os dois modelos diretamente.
Qwen Áudio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
Seed Audio 1.0
seed-audio-1.0Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
A primeira saída do Qwen soou mais natural e com um tom de documentário; o Seed soou um pouco rígido para o ouvinte. Se a verificação de transcrições for fundamental para o seu fluxo de trabalho, este guia separado explica como o ChatGPT pode transcrever áudio. Não utilizamos a transcrição para verificar o B1 palavra por palavra.
B2: Progressão emocional
B2: Progressão emocional
Uma voz feminina que passa de um sussurro tenso, passando por uma narração neutra, até chegar a um tom de entusiasmo aliviado.
Mostrar o prompt exato que travou
“Conseguimos”, sussurrou Maya. Então, as luzes se acenderam novamente. “Ok... agora podemos comemorar!” Use uma única voz feminina adulta e consistente. Diga a primeira frase em voz baixa e com tensão, a frase do meio em um tom narrativo neutro e a frase final com entusiasmo e alívio. Mantenha as mudanças emocionais claras, mas sem exageros teatrais. Sem música nem efeitos sonoros.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Qwen Áudio 3.0 TTS Flash | qwen-audio-3.0-tts-flash | Primeira data válida | 25,913 s | MP3, 22,05 kHz mono | $0.0052950 |
| Seed Audio 1.0 | seed-audio-1.0 | Primeira data válida | 9,180 s | PCM WAV, 40 kHz estéreo (canais idênticos) | $0.0214200 |
- Verificações objetivas
- Ambos os arquivos foram decodificados corretamente; havia várias regiões de fala. As diferenças de duração não foram consideradas como um indicador de qualidade.
- Avaliação do ouvinte
- O ouvinte preferiu o Qwen por oferecer um efeito de sussurro mais intenso e uma sensação mais convincente de narrativa.
- Resultado da tarefa
- O Qwen é o modelo preferido para esta tarefa de primeira saída.
- Limitações
- A precisão literal não foi verificada; o teste de estabilidade não foi realizado.
Prova de compreensão auditiva do nível B2
Ouça as primeiras gravações do B2
Jogue qualquer uma das cartas para comparar os dois modelos diretamente.
Qwen Áudio 3.0 TTS Flash
qwen-audio-3.0-tts-flashGerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
Seed Audio 1.0
seed-audio-1.0Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
A primeira resposta do Qwen apresentou um tom mais sussurrante e uma sensação mais narrativa. O usuário não percebeu nenhum problema óbvio no texto em B1 ou B2, mas a precisão exata das palavras ainda não foi verificada.
Exemplos de fluxos de trabalho com um único modelo
C1: Música com voz estruturada “Eleven Music v2”
C1: Canção vocal estruturada
Uma música indie-pop de 30 segundos com instrumentação e estrutura fixas, além de duas linhas de letra obrigatórias.
Mostrar o prompt exato que travou
Crie uma música indie-pop animada de 30 segundos com uma vocalista principal, guitarra alegre, baixo e palmas. Estrutura: uma introdução instrumental de quatro segundos, um verso curto, um refrão e um final limpo. Use cada uma destas frases da letra uma vez: Verso: ‘Manhã na janela, os planos estão decolando.’ Refrão: ‘Comece de onde você está e torne o momento brilhante.’ Sem narração falada nem efeitos sonoros.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Eleven Music v2 | eleven-music-v2 | Primeira data válida | 30,041 s | MP3, 44,1 kHz, estéreo | $0.0750000 |
- Verificações objetivas
- O MP3 foi decodificado corretamente. Foi detectada uma amostra isolada insignificante em escala máxima, sem distorção generalizada.
- Avaliação do ouvinte
- O ouvinte considerou que o critério foi parcialmente atendido: a voz soava um pouco artificial e apresentava um ruído elétrico.
- Resultado da tarefa
- Alcançado parcialmente para este primeiro resultado.
- Limitações
- Essa observação se aplica apenas a esta primeira saída; a estabilidade não foi verificada.
Prova de compreensão auditiva do C1
Ouça a primeira saída do C1
Reproduza a primeira saída válida desta demonstração de modelo único.
Eleven Music v2
eleven-music-v2Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
A C1 cumpriu parcialmente o contrato. O ouvinte considerou a voz um pouco artificial e percebeu um ruído elétrico. Trata-se de uma observação específica à amostra, e não de uma reclamação de defeito em geral.
C3: Seed Audio 1.0 – cena completa da estação ferroviária
C3: Cena completa da estação ferroviária
Uma cena de 20 segundos em uma estação costeira que combina sons ambientais, um trem em movimento, um sinal sonoro e um anúncio preciso.
Mostrar o prompt exato que travou
Crie uma cena completa de 20 segundos em uma estação ferroviária litorânea ao amanhecer. Comece com uma brisa suave do mar e gaivotas ao longe. Um trem se aproxima pela esquerda e freia na plataforma. Uma locutora da estação, com voz calma, diz exatamente: ‘O trem costeiro das 7h15 está chegando agora na plataforma dois.’ Adicione um breve e suave toque musical antes do anúncio e, em seguida, deixe o trem e o ambiente desaparecerem naturalmente. Mantenha a fala inteligível e a cena espacialmente coerente.
| Modelo | Rota exata | Status | Duração real | Formato | Custo observado |
|---|---|---|---|---|---|
| Seed Audio 1.0 | seed-audio-1.0 | Primeira data válida | 20.000s | PCM WAV, 40 kHz estéreo | $0.0466667 |
- Verificações objetivas
- O arquivo WAV foi decodificado corretamente, não apresentou quase nenhum clipping e, do ponto de vista técnico, continha a estrutura de cena em várias partes solicitada.
- Avaliação do ouvinte
- O ouvinte considerou que o critério foi parcialmente atendido, pois os sons de frenagem e parada do trem pareciam um pouco artificiais.
- Resultado da tarefa
- Alcançado parcialmente para este primeiro resultado.
- Limitações
- O anúncio exato não foi transcrito de forma independente; o teste de estabilidade não foi realizado.
Teste de compreensão auditiva C3
Ouça a primeira produção do C3
Reproduza a primeira saída válida desta demonstração de modelo único.
Seed Audio 1.0
seed-audio-1.0Gerado por meio da rota Anywhere testada em 6 de agosto de 2026. Um primeiro resultado válido; teste de estabilidade não realizado.
O C3 também cumpriu parcialmente o que estava previsto no contrato: o ouvinte achou os sons de frenagem e parada do trem um pouco artificiais. Os criadores de vídeo que combinam voz gerada com imagens também podem perceber isso Guia de diálogo, áudio e sincronização labial útil, embora a sincronização labial não tenha sido testada aqui.
Custo, comprimento da saída e comportamento da rota
Carga observada e duração real da saída
Uma primeira avaliação válida por tarefa, realizada pelo Anywhere em 6 de agosto de 2026. Os valores referem-se a observações de sessão e não constituem uma tabela oficial de preços. As duas minibarras utilizam escalas visuais distintas; não é utilizado eixo duplo nem pontuação combinada.
Os custos observados variam de $0,00513 para o Qwen B1 a $0,075 para cada saída do Eleven. A duração real varia de 9,180 segundos para o Seed B2 a 30,041 segundos para as saídas musicais do Eleven. Esses são resultados medidos em sessões, e não preços de tabela ou pontuações de qualidade.
Por que experimentar esses modelos de áudio no GlobalGPT?
A geração de música, a síntese de voz expressiva e paisagens sonoras completas são tarefas diferentes; é por isso que não existe um modelo único que se destaque como vencedor nessa área. O GlobalGPT torna essa distinção prática: você pode começar com o Eleven Music para uma faixa, mudar para o Qwen Audio para narração ou usar o Seed Audio para uma cena composta, sem precisar manter uma plataforma separada para cada fluxo de trabalho de áudio.
Como o GlobalGPT é um espaço de trabalho multimodelo, e não apenas uma ferramenta de áudio, o trabalho não precisa se limitar a um arquivo de áudio. Você pode usar outros modelos de IA na plataforma para esboçar ou refinar um roteiro, pesquisar um tema, criar imagens de apoio e desenvolver material de vídeo em torno do áudio finalizado.
Em 10 de agosto de 2026, o Página de preços do GlobalGPT apresentou equivalentes mensais de $5,8 para o plano BASIC, $10,8 para o plano PRO e $25,0 para o plano UNLIMITED, com as opções “Seleção anual” e “Faturamento anual” exibidas. Esses são os valores de faturamento anual da página; o acesso aos modelos varia de acordo com o plano.

Qual modelo você deve escolher?
Matriz de resultados da primeira saída com seis tarefas
| Fluxo de trabalho | Modelos testados | Resultado | Motivo observado | Tipo de evidência | Limitação |
|---|---|---|---|---|---|
| A1 · Música | Eleven x Seed | Onze preferidos | Uma progressão mais natural e uma instrumentação mais harmoniosa | Preferência do ouvinte em teste cego | Uma primeira saída para cada um |
| A2 · Música | Eleven x Seed | Preferência por sementes | Uma introdução mais clara e camadas mais ricas | Preferência do ouvinte em teste cego | O Seed retornou 27,704 s |
| B1 · Expressão oral | Qwen x Seed | Qwen (preferencial) | Uma abordagem mais natural no estilo documentário | Preferência do ouvinte em teste cego | Texto não revisado palavra por palavra |
| B2 · Expressão oral | Qwen x Seed | Qwen (preferencial) | Um tom mais intenso de sussurro e uma sensação mais marcante de narrativa | Preferência do ouvinte em teste cego | Texto não revisado palavra por palavra |
| C1 · Canção vocal | Apenas onze | Cumprido parcialmente | A voz soava artificial, com um ruído semelhante ao de uma interferência elétrica | Revisão semântica do usuário | Observação específica da amostra |
| C3 · Paisagem sonora | Apenas sementes | Cumprido parcialmente | A frenagem e a parada do trem soaram artificiais | Revisão semântica do usuário | Anúncio não transcrito |
Nenhuma rodada é convertida em uma pontuação geral ou em um vencedor universal.
- Escolha o Eleven Music v2 quando o trabalho envolve fundamentalmente música: faixas instrumentais estruturadas, canções ou edição musical em nível de seção.
- Escolha o Qwen Audio 3.0 TTS Flash quando a tarefa envolve narração ou discurso expressivo controlado.
- Escolha o Seed Audio 1.0 quando a saída deve se comportar como uma cena completa, combinando ambiente, efeitos e fala.
Essas recomendações resumem a adequação ao fluxo de trabalho, além de seis avaliações da primeira saída. Elas não apontam um vencedor absoluto.
Limitações desta comparação
- Uma primeira saída válida por modelo e tarefa; sem repetições de estabilidade.
- Os textos B1 e B2 não foram transcritos nem revisados palavra por palavra.
- As avaliações auditivas são subjetivas e específicas para cada amostra.
- Uma rota “Anywhere” não corresponde ao produto upstream na íntegra.
- Nenhuma tabela de classificação independente e imparcial abrange exatamente essas três rotas sob um único método.
- O formato do arquivo, a taxa de amostragem, os canais, o tamanho do arquivo e o volume de reprodução não foram considerados como parâmetros de qualidade.
Perguntas frequentes
01O Eleven Music v2, o Qwen Audio 3.0 e o Seed Audio 1.0 são modelos do mesmo tipo?
O No. Eleven Music v2 é um fluxo de trabalho dedicado à música; o Qwen Audio 3.0 TTS Flash é o sistema de síntese de voz testado aqui; e o Seed Audio 1.0 está voltado para a geração de áudio de cenas completas. Portanto, esta comparação apresenta recomendações por tarefa, em vez de impor uma classificação universal.
02Qual modelo foi desenvolvido para a geração de música por IA?
O Eleven Music v2 é, sem dúvida, a melhor opção dedicada à música nesta comparação. Sua documentação oficial descreve o controle sobre gênero, estilo, estrutura, saída vocal ou instrumental, vários idiomas e edição por seção ou da música inteira.
03Qual das opções testadas se adequa melhor à narração e à fala expressiva?
O Qwen Audio 3.0 TTS Flash, identificado aqui pela rota exata do Anywhere qwen-audio-3.0-tts-flash, foi o que melhor se saiu nos testes de narração e fala expressiva. O ouvinte preferiu sua primeira saída tanto no B1 quanto no B2, mas a estabilidade e a precisão exata das palavras não foram testadas.
04Qual modelo é capaz de criar uma paisagem sonora completa com fala e efeitos?
O Seed Audio 1.0 é a solução ideal para a criação de uma paisagem sonora composta. Seu posicionamento oficial abrange voz, efeitos sonoros, ambiente e orquestração unificada, enquanto o teste C3 combinou um anúncio da estação, o movimento do trem, um sinal sonoro e o ambiente litorâneo em uma única saída.
05Posso usar os três no GlobalGPT?
Sim. Você pode experimentar o Eleven Music para música, o Seed Audio 1.0 para cenas de áudio completas e o Qwen Audio 3.0 para fala no espaço de trabalho de áudio do GlobalGPT. O GlobalGPT também reúne fluxos de trabalho de redação, pesquisa, imagem e vídeo na mesma plataforma multimodelo. A disponibilidade dos modelos varia de acordo com o plano.
06Essa comparação aponta um vencedor geral?
Não. Os modelos atendem a fluxos de trabalho diferentes, e os testes práticos abrangem um primeiro resultado válido por modelo e tarefa, sem repetições para verificar a estabilidade. A conclusão útil é condicional: o Eleven para música dedicada, o Qwen TTS Flash para fala e o Seed para cenas de áudio completas.
Experimente seu próprio fluxo de trabalho de áudio
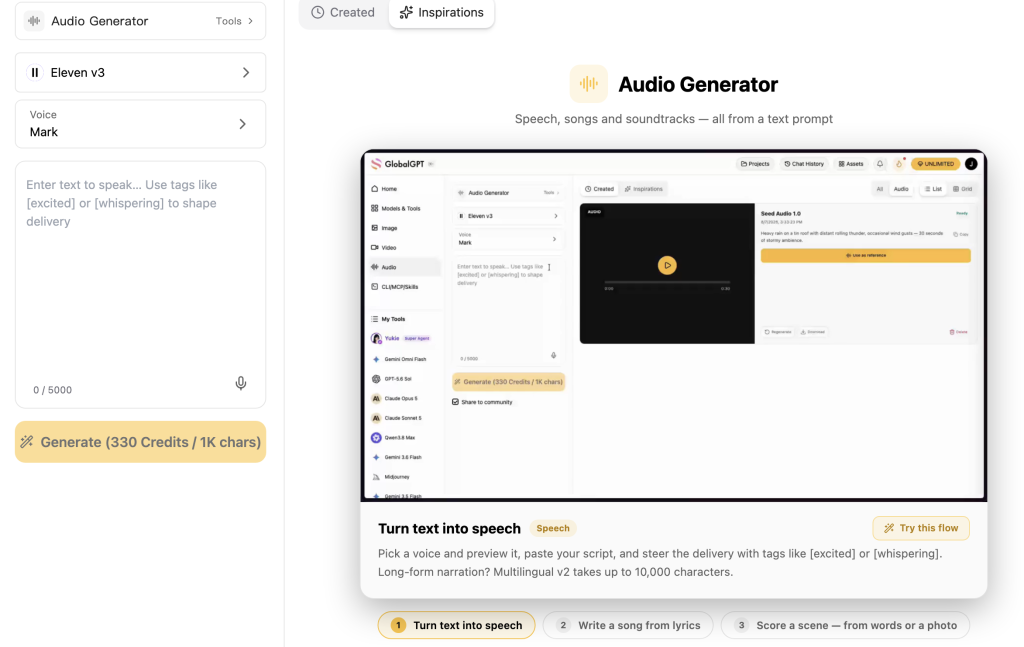
Traga seu próprio roteiro musical, roteiro de narração ou sugestão de paisagem sonora para o Gerador de áudio GlobalGPT e compare o resultado com o trabalho que você realmente precisa concluir. Preste atenção à estrutura musical, à interpretação vocal, à coerência da cena e ao cumprimento das instruções, em vez de escolher um modelo apenas pelo nome.
Assim que a direção de áudio estiver funcionando, você poderá dar continuidade ao projeto com os outros modelos de IA do GlobalGPT para desenvolvimento de roteiro, pesquisa, imagens de apoio e conceitos de vídeo. Isso transforma o teste em um fluxo de trabalho prático de conteúdo, em vez de uma demonstração de áudio isolada; repita as saídas apenas quando precisar de evidências de estabilidade.