Em nossos testes realizados em 7 de julho de 2026, o Claude Sonnet 5 foi a melhor opção inicial para revisão de código, análise de causa raiz, planejamento de arquitetura e raciocínio em contexto amplo. O GPT-5.5 foi a melhor opção inicial quando se precisa de um rascunho completo de implementação, uma estrutura de testes executável ou exemplos prontos para serem copiados. Para trabalhos no nível do repositório, compare o Claude Code com o Codex, em vez de avaliar qualquer uma das empresas apenas pela janela de bate-papo.
A divisão relevante não se resume simplesmente a “Claude vence” ou “ChatGPT vence”. Em 27 de setembro de 2026, a linha de produtos do Anthropic inclui o Claude Fable 5.1, o Opus 5.5, o Sonnet 5 e o Haiku 4.5; a família GPT-6 do OpenAI inclui o Astra, o Sol e o Luna. O acesso aos produtos é importante: o Sol e o Luna foram lançados no ChatGPT Work, no Codex e na API, com o anúncio excluindo explicitamente o Chat comum. As seções práticas abaixo continuam sendo uma comparação desatualizada entre o Claude Sonnet 5 e o GPT-5.5, testadas com os mesmos prompts em 7 de julho de 2026. Para uma comparação atual, consulte Claude Opus 5.5 x GPT-6 Sol.
Se você quiser comparar modelos sem precisar lidar com assinaturas separadas, o GlobalGPT é um espaço de trabalho multimodelo prático com o GPT-6 Astra e Claude Opus 5,5 disponível no seletor de modelos. É útil para comparar respostas de codificação, planejar, escrever e pesquisar, mas não substitui o Claude Code, o Codex, as APIs oficiais, um IDE nem um fluxo de trabalho de desenvolvimento integrado a repositórios.

Índice
- Claude x ChatGPT para programação: resposta rápida
- O que mudou em 2026
- Gama atual de modelos de codificação
- Visão geral dos benchmarks: SWE-Bench, Terminal-Bench e o que eles significam
- Como testamos o Claude e o ChatGPT para programação
- Teste 1: depuração e análise da causa raiz
- Teste 2: refatoração e facilidade de manutenção
- Teste 3: raciocínio e planejamento envolvendo vários arquivos
- Teste 4: testes unitários e verificação
- Teste 5: análise de segurança e confiabilidade
- Claude Code e Codex: quando o chat não é suficiente
- Preços: Claude, ChatGPT, Codex e GlobalGPT
- Qual configuração de codificação você deve escolher?
- Por que muitos desenvolvedores ainda usam os dois
- PERGUNTAS FREQUENTES
Claude x ChatGPT para programação: resposta rápida
Em nossos testes de bate-papo com o mesmo prompt, realizados em 7 de julho, o Claude Sonnet 5 foi o melhor resultado na primeira tentativa quando o problema era ambíguo: ele priorizou as causas prováveis, filtrou o ruído e explicou o risco com clareza. O GPT-5.5 se mostrou mais eficaz quando a etapa seguinte consistia em um rascunho de implementação mais completo, com importações, estrutura de teste e mais detalhes de código. Essas observações se referem a esse teste específico, e não a todas as versões futuras do modelo.
Para o desenvolvimento no dia a dia, o melhor fluxo de trabalho geralmente é:
- Use o Claude primeiro para revisão de código, triagem de bugs, decisões de arquitetura e perguntas do tipo “o que devo inspecionar primeiro?”.
- Use o ChatGPT primeiro para gerar uma implementação inicial, escrever estruturas de teste, criar exemplos e transformar um plano em código.
- Use os dois para migrações, alterações que envolvam segurança, pagamentos, autenticação, envio de arquivos e qualquer coisa que possa comprometer os dados de produção.
| Necessidade de programação | Melhor escolha inicial | Por que |
|---|---|---|
| Depurando um bug complicado | Claude primeiro | Em nosso teste, o Claude identificou a causa provável como prioridade e explicou claramente o caminho da falha. |
| Elaboração de um rascunho completo de implementação | ChatGPT primeiro | Em nosso teste, o GPT-5.5 forneceu um código mais completo e uma estrutura mais pronta para uso. |
| Análise de riscos à segurança ou à confiabilidade | Primeiro o Claude, depois o ChatGPT | Claude classificou a gravidade de forma clara; ChatGPT acrescentou padrões concretos de implementação. |
| Alteração de arquivos em um repositório | Claude Código ou Codex | O contexto do repositório, a execução de comandos, os testes e as comparações são mais importantes do que uma resposta baseada apenas no chat. |
Se a sua dúvida principal é qual família de modelos é a melhor para programação em geral, a resposta mais ampla melhor modelo de IA para codificação Essa comparação é uma boa leitura complementar. Se sua decisão principal estiver dentro do ecossistema OpenAI, o guia “O melhor modelo ChatGPT para codificação” traz mais detalhes sobre a seleção de modelos GPT.
O que mudou em 2026
Uma comparação útil para 2026 precisa levar em conta três mudanças.
Primeiro, o “Claude Sonnet 5” alterou a perspectiva de Claude nessa decisão. O Anthropic descreve o Sonnet 5 como disponível em todos os planos e no Código Claude, com acesso à Plataforma Claude para desenvolvedores. Isso é importante porque o Claude não é mais apenas um assistente de chat para explicações sobre programação; ele faz parte do fluxo de trabalho do agente de programação do Anthropic.
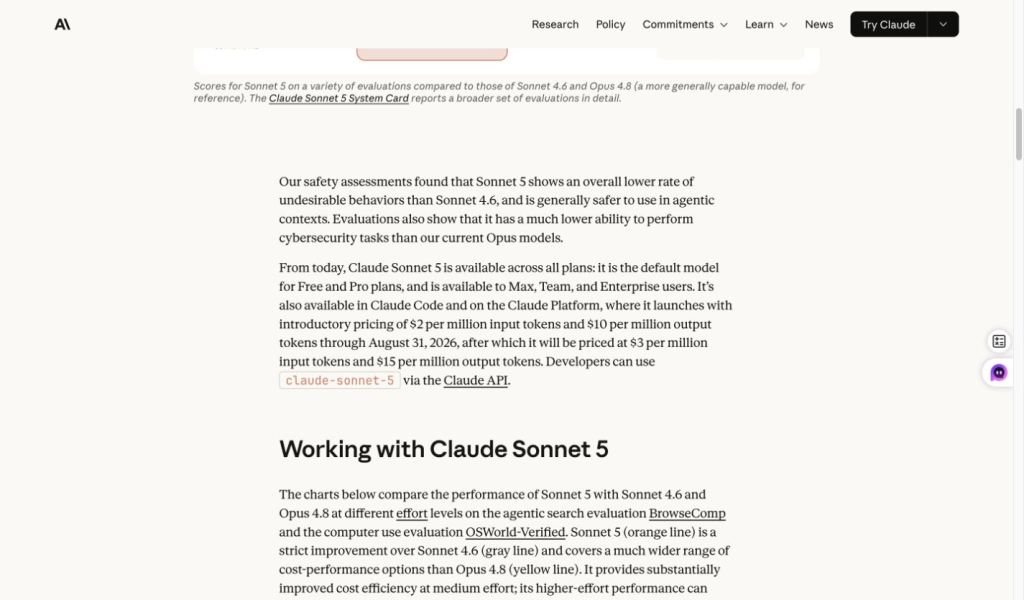
Em segundo lugar, o GPT-6 é agora a família de modelos utilizada pela OpenAI para trabalhos de programação. A Astra tem como foco a engenharia de software complexa; a Sol e a Luna oferecem opções mais econômicas. Anúncio do lançamento do OpenAI em 22 de setembro indica que o Sol e o Luna estão disponíveis no ChatGPT Work e no Codex para as versões Plus, Pro, Business, Enterprise e Edu, sendo que o Luna também está disponível para usuários das versões Free e Go no aplicativo para desktop. O documento afirma explicitamente que esses modelos ainda não estão disponíveis no Chat. O acesso à API é cobrado separadamente.
Em terceiro lugar, os assistentes de chat e os agentes de programação cuidam de diferentes partes do trabalho. O bate-papo simples é útil para trechos de código, depuração, explicações e planejamento. Código Claude e Codex são fluxos de trabalho compatíveis com repositórios, projetados para inspecionar arquivos, executar comandos, testar alterações e atuar em tarefas mais complexas. Uma comparação justa distingue a qualidade da saída do chat das funcionalidades do produto de agente de programação.
Gama atual de modelos de codificação
A partir de 27 de setembro de 2026, a comparação de codificação é uma decisão de alinhamento, e não um confronto isolado entre Claude e ChatGPT:
| Lateral | Modelos atuais a serem considerados | Melhor uso da programação |
|---|---|---|
| Claude | Claude Fable 5,1, Claude Opus 5,5, Claude Sonnet 5 e Claude Haiku 4,5 | Revisão de contexto amplo, planejamento, depuração, programação autônoma e fluxos de trabalho do Claude Code. |
| ChatGPT / OpenAI | GPT-6 Astra, GPT-6 Sol e GPT-6 Luna; a disponibilidade varia entre as versões ChatGPT Work, Chat, Codex e API | Implementação, trabalho no front-end, testes, fluxos de trabalho com o uso de ferramentas e tarefas do Codex. |
| GlobalGPT | GPT-6 Astra e Claude Opus 5.5, verificado em GlobalGPT; trata-se de uma assinatura de plataforma separada | Comparação lado a lado de prompts, dúvidas cotidianas sobre código, pesquisas e avaliação de abordagens. |
Se você estiver acompanhando o acesso ao Claude e os detalhes do plano, consulte o documento separado Planos da Claude AI para 2026 guia e o guia mais detalhado sobre preços do Claude AI. Se você estiver comparando planos do OpenAI, a análise detalhada dos planos de assinatura do ChatGPT para 2026 é o documento complementar mais claro.
Visão geral dos benchmarks: SWE-Bench, Terminal-Bench e o que eles significam
Os benchmarks são úteis porque mostram como os modelos se comportam em tarefas de codificação controladas. O importante é interpretar cada benchmark de acordo com o que ele realmente mede. Um benchmark de issue de repositório, um benchmark de agente de terminal e uma tabela oficial de lançamento de modelos não representam o mesmo indicador; portanto, devem ser utilizados em conjunto com os testes práticos apresentados a seguir.
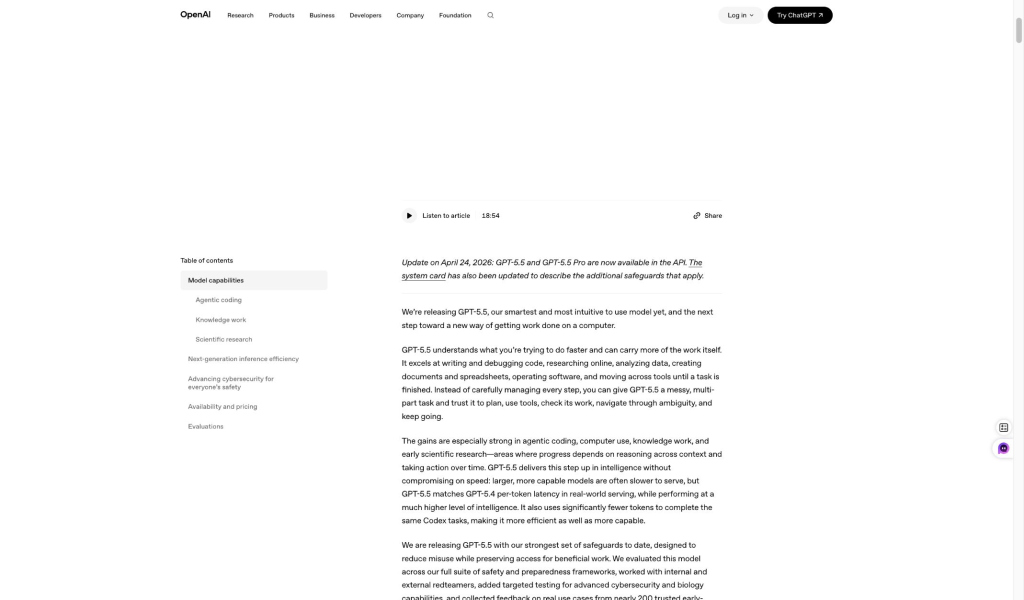
GPT-5.5: Evidência de codificação a partir da data do teste
O material sobre o GPT-5.5 abaixo foi mantido porque corresponde ao modelo utilizado na comparação prática de 7 de julho. Ele corrobora as observações da seção de testes, que se concentram na implementação, mas não deve ser interpretado como a linha atual de modelos OpenAI; o GPT-6 é agora a família ativa, com acesso variando entre o ChatGPT Work, o Chat comum, o Codex e a API.
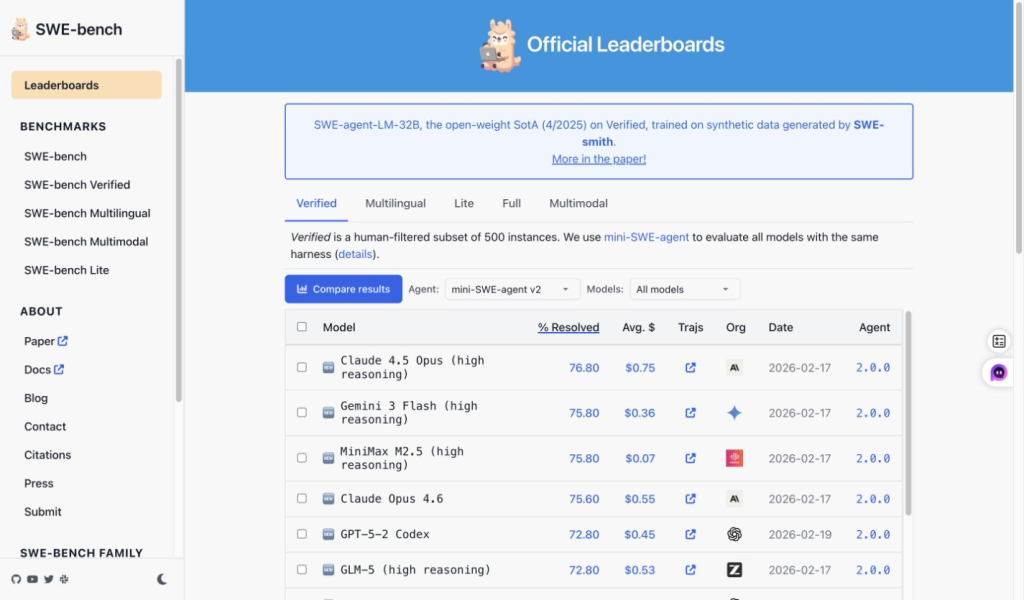
SWE-Bench: resolução de problemas no repositório
SWE-Bench É útil porque se aproxima mais da manutenção real de software do que uma simples solicitação de um pequeno trecho de código. Ele analisa as issues do repositório e verifica se um modelo é capaz de gerar alterações que resolvam a tarefa. No caso do Claude versus o ChatGPT, isso diz algo sobre a capacidade de engenharia de software, mas ainda não revela tudo sobre a qualidade da explicação, o julgamento da revisão ou o quanto uma resposta parece útil em um fluxo de trabalho de chat.
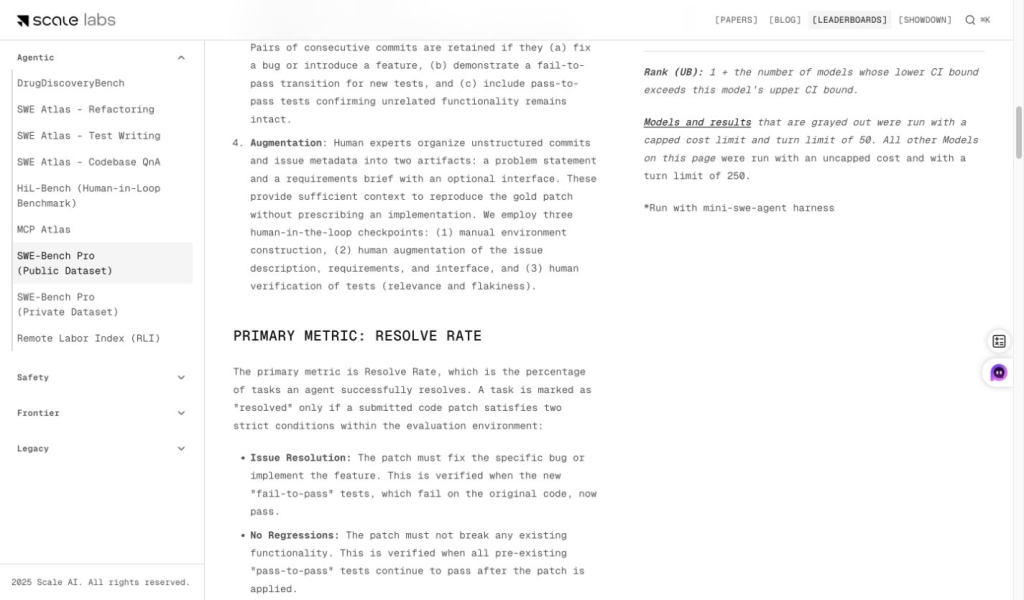
SWE-Bench Pro: tarefas de programação mais complexas e taxa de resolução
Ranking público do SWE-Bench Pro da Scale é um indicador mais rigoroso, pois se concentra em tarefas mais exigentes relacionadas ao repositório e utiliza a taxa de resolução como principal parâmetro de avaliação. Isso é particularmente útil quando se busca avaliar a capacidade real de um agente de codificação: não apenas se o modelo é capaz de explicar um bug, mas se ele consegue conduzir o repositório a uma correção funcional em condições de teste de desempenho.
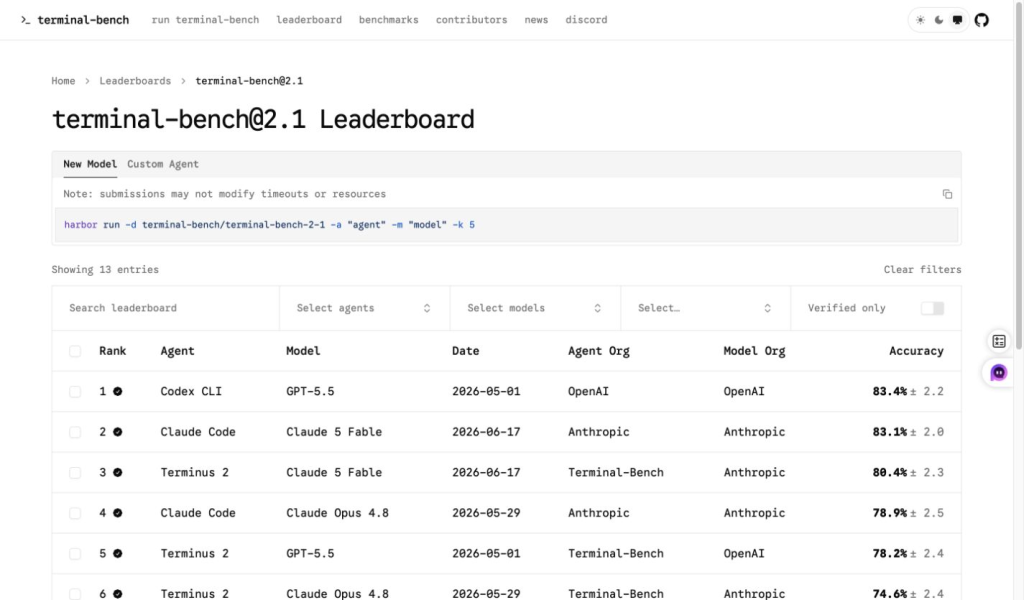
Terminal-Bench: tarefas de linha de comando e de fluxo de trabalho do agente
Banco de terminais 2.1 difere do SWE-Bench porque se concentra na execução de tarefas no terminal e na linha de comando por meio de configurações de agentes/modelos. Isso o torna mais relevante para fluxos de trabalho no estilo Claude Code e ChatGPT Codex do que para um simples prompt de chat do tipo “escreva esta função”. Se você estiver escolhendo um assistente de programação para trabalhos no nível do repositório ou na linha de comando, este benchmark deve ser levado em consideração na decisão.
| Evidências | Leitura recomendada para | Conclusão prática |
|---|---|---|
| Materiais de programação do OpenAI GPT-5.5 | Programação do GPT-5.5 e posicionamento na engenharia de software orientada para agentes. | Forte apoio ao ChatGPT como um assistente de programação voltado para a implementação. |
| SWE-Bench | Resolução de problemas no repositório e tarefas de manutenção de software. | É um bom indicador da capacidade de programação, especialmente quando o contexto do repositório é relevante. |
| SWE-Bench Pro | Tarefas mais complexas no repositório e comparação das taxas de resolução. | Útil para avaliar a capacidade de codificação agênica significativa. |
| Banco de terminais 2.1 | Tarefas no terminal, execução de comandos e configurações de agentes/modelos. | Mais relevante para os fluxos de trabalho do Claude Code e do Codex do que simples prompts de chat. |
Os benchmarks tornam ambas as famílias de modelos opções de codificação confiáveis, mas não determinam a escolha para o fluxo de trabalho diário. As seções a seguir utilizam os mesmos prompts para depuração, refatoração, planejamento, testes de unidade e revisão de segurança, para que você possa ver onde as respostas diferiram na prática.
Como testamos o Claude e o ChatGPT para programação
Testamos o GPT-5.5 e o Claude Sonnet 5 em 7 de julho de 2026 no GlobalGPT, utilizando a mesma interface e os mesmos prompts. O objetivo não era recriar um benchmark completo de agentes de IDE. Era comparar a ajuda no dia a dia da programação: depuração, refatoração, raciocínio envolvendo vários arquivos, criação de testes e revisão de segurança.
A pontuação foi simples: precisão, raciocínio sobre a causa raiz, facilidade de manutenção, cobertura de casos extremos, verificação e cumprimento das instruções. Isso faz com que a comparação se aproxime da forma como os desenvolvedores realmente utilizam os assistentes de programação baseados em IA.
Teste 1: Depuração e análise da causa raiz
A primeira instrução pediu que ambos os modelos analisassem uma função em JavaScript que agrupa tickets por prioridade. O erro é sutil, mas comum: a função tenta inserir em acc[ticket.priority] antes que esse array exista.
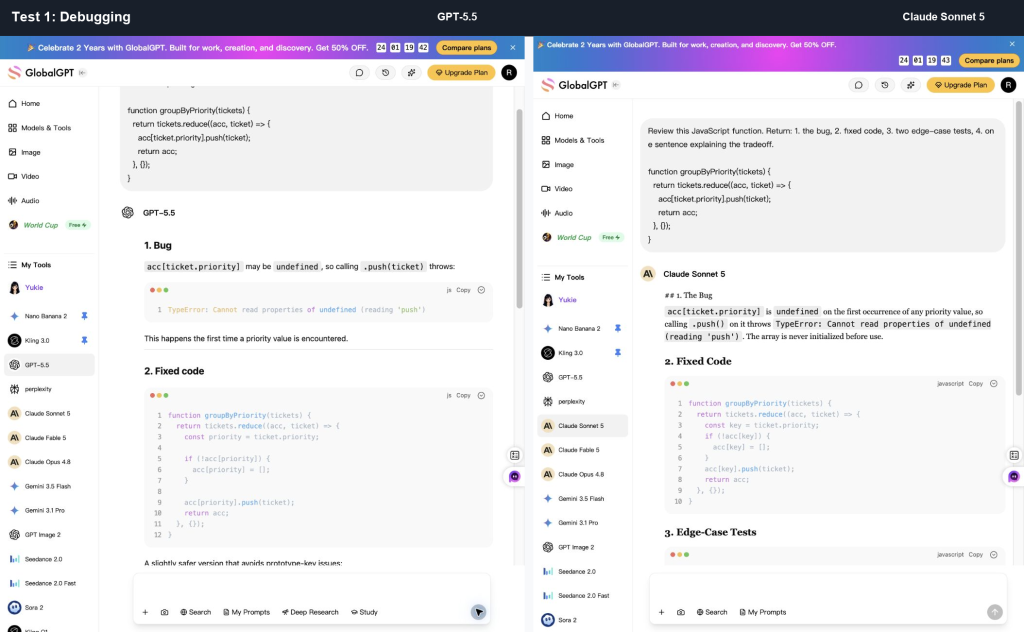
O que o ChatGPT fez bem: O GPT-5.5 identificou o bug, forneceu o código corrigido, adicionou testes para casos extremos e incluiu uma abordagem mais defensiva Object.create(null) variante. Esse detalhe adicional de implementação é útil quando as chaves dos objetos podem entrar em conflito com propriedades herdadas.
O que Claude fez bem: Claude Sonnet 5 encontrou o mesmo bug e deu uma resposta mais precisa. Ele também levantou um caso-limite de prioridade indefinida, que é o tipo de limite prático que um revisor deve levar em consideração.
Vencedor: Empate, com uma ligeira vantagem do ChatGPT em termos de nuances de implementação. O Claude foi mais conciso; o GPT-5.5 foi mais completo.
Teste 2: Refatoração e facilidade de manutenção
A segunda tarefa solicitava uma refatoração para melhorar a legibilidade, sem alterar o comportamento. Esse é um bom teste, pois muitas respostas de programação geradas por IA refatoram excessivamente pequenos utilitários e criam mais componentes móveis do que o código original realmente precisa.
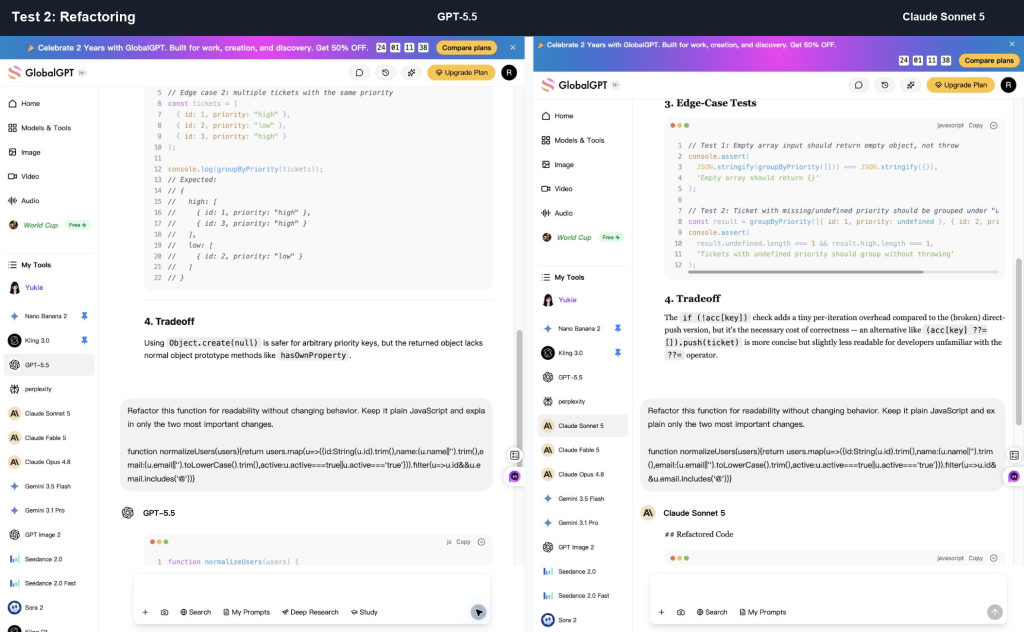
O que o ChatGPT fez bem: O GPT-5.5 manteve a estrutura próxima da original, introduziu valores intermediários nomeados e seguiu à risca a instrução de “apenas duas alterações importantes”. Isso é valioso quando o usuário deseja uma refatoração conservadora.
O que Claude fez bem: O Claude Sonnet 5 extraiu funções auxiliares, como um normalizador e um validador. O resultado tornou o texto mais fácil de analisar, mas alterou a estrutura mais do que o GPT-5.5.
Vencedor: ChatGPT para moderação; Claude para legibilidade modular. Se você precisar de uma refatoração mínima e segura, comece com o ChatGPT. Se quiser uma nomenclatura de domínio mais clara, peça ao Claude para dar uma segunda olhada.
Teste 3: Raciocínio e planejamento com vários arquivos
A terceira tarefa apresentava uma pequena árvore de arquivos do Next.js e um relato de bug: usuários conectados podem fazer upload de arquivos pequenos, mas arquivos com mais de 8 MB falham silenciosamente depois que a barra de progresso chega a 100%.
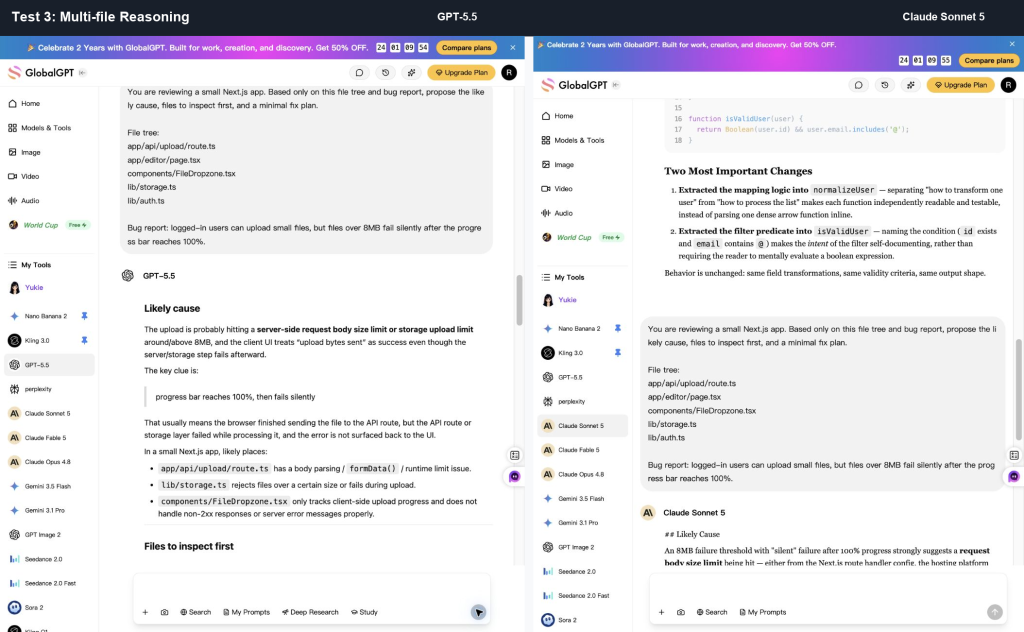
O que o ChatGPT fez bem: O GPT-5.5 elaborou um plano detalhado voltado para a implementação. Ele mencionou verificações do tamanho do servidor, tratamento das respostas dos clientes e propagação de erros de armazenamento.
O que Claude fez bem: Claude Sonnet 5 focou imediatamente no limite de 8 MB, provavelmente devido a restrições da plataforma ou do tamanho do corpo do código, na semântica da barra de progresso e em um caminho de verificação de 7 MB/8 MB/9 MB. Parecia mais uma nota de revisão de um especialista sênior.
Vencedor: Claude. Ele identificou a causa provável mais rapidamente e definiu um caminho de inspeção mínima mais preciso.
Teste 4: Testes unitários e verificação
A quarta tarefa solicitou que ambos os modelos escrevessem testes de unidade em TypeScript para uma função auxiliar que retorna os limites do plano para uploads e acesso ao Codex. Isso verifica se o modelo é capaz de proteger a lógica de ramificação contra regressões futuras.
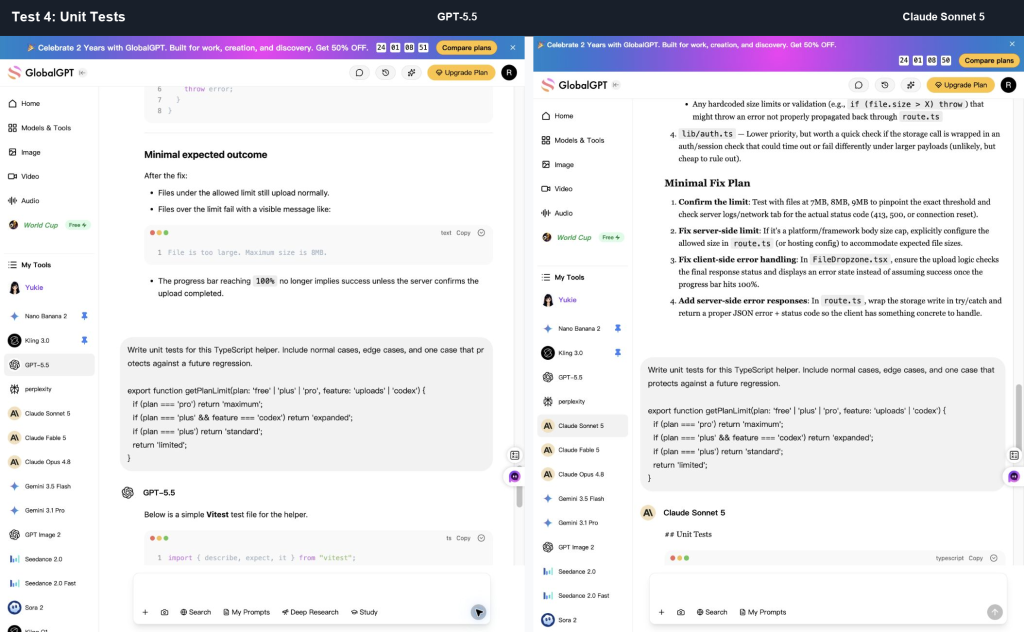
O que o ChatGPT fez bem: O GPT-5.5 incluiu as importações da estrutura de teste e gerou um arquivo Vitest que parecia estar pronto para execução. Ele abrangeu todas as combinações esperadas e facilitou a inserção da resposta em um projeto.
O que Claude fez bem: Claude Sonnet 5 explicou melhor o risco real de regressão: pro + codex deve ser executada antes das verificações específicas de cada recurso. Foi uma resposta com um raciocínio mais sólido, embora fosse menos prática como arquivo.
Vencedor: Claude para a elaboração de testes; ChatGPT para a geração do arquivo inicial. Na prática, use o ChatGPT para o primeiro rascunho dos testes e o Claude para avaliar se os testes garantem o comportamento correto.
Teste 5: Análise de segurança e confiabilidade
A quinta tarefa solicitou que ambos os modelos analisassem um endpoint de webhook do Express. Uma boa resposta deve abordar a verificação de assinatura, os requisitos de corpo bruto, a idempotência, a validação, o tratamento de erros no banco de dados e os limites de tamanho da solicitação.
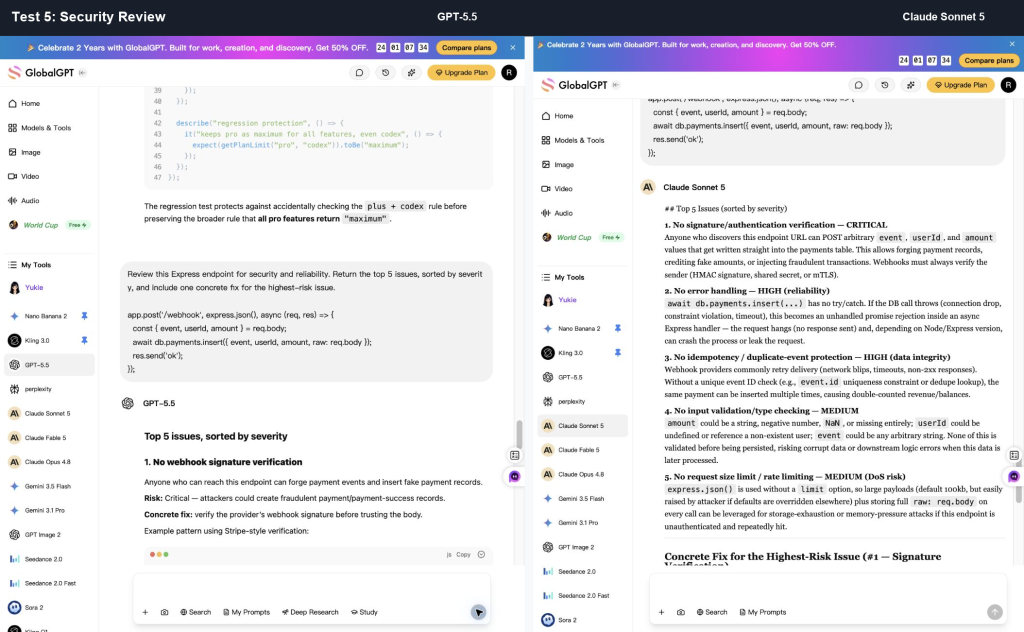
O que o ChatGPT fez bem: O GPT-5.5 apresentou uma solução no estilo de um provedor, incluindo uma solução semelhante à do Stripe express.raw() padrão. Isso é útil quando o próximo passo é implementar um manipulador de webhook concreto.
O que Claude fez bem: O Claude Sonnet 5 apresentou um raciocínio mais claro e rigoroso e incluiu detalhes mais confiáveis sobre a comparação de assinaturas, utilizando conceitos de comparação em tempo constante. Isso fez com que a classificação de riscos parecesse mais precisa.
Vencedor: Empate, com uma ligeira vantagem para o Claude no que diz respeito à explicação sobre segurança. Ambos os modelos foram suficientemente robustos para serem úteis, mas nenhuma das respostas deve substituir uma análise de segurança real dos fluxos de pagamento ou autenticação.
Claude Code x ChatGPT Codex
A saída do chat é apenas uma parte da decisão de programação. O Claude Code e o Codex são fluxos de trabalho distintos de desenvolvimento de agentes para tarefas que envolvem arquivos, comandos, testes, pull requests ou alterações mais amplas na base de código.
| Fluxo de trabalho | Melhor ajuste | Limite importante |
|---|---|---|
| Bate-papo com Claude | Raciocínio, depuração, revisão, explicação e planejamento. | Ele só considera o contexto que você fornecer, a menos que esteja conectado a ferramentas ou a um fluxo de trabalho mais amplo. |
| Bate-papo com o ChatGPT | Rascunhos de implementação, testes, exemplos e dúvidas sobre o uso da API. | Mesmo uma resposta bem fundamentada ainda precisa ser verificada no seu projeto. |
| Código Claude | Programação com foco no Repo, navegação na base de código, testes e planejamento de tarefas de maior porte. | Analise as permissões, a política de segurança e o diff proposto antes de aceitar as alterações. |
| Códice | Implementação compatível com repositórios, depuração, testes, revisão e fluxos de trabalho de programação integrados ao OpenAI. | O acesso ao plano, o uso e a disponibilidade do modelo diferem dos de um chat comum e podem mudar com o tempo. |
A abordagem prática: use modelos de chat para reflexão, explicações e pequenas tarefas; use o Claude Code ou o Codex quando o trabalho exigir contexto do repositório e etapas executáveis.
Preços: Claude, ChatGPT, Codex e GlobalGPT
Comece perguntando pelo que você está pagando. Um plano de chat oferece suporte interativo diário para programação. Um fluxo de trabalho com agente de programação oferece suporte a tarefas relacionadas a repositórios, como CLI, IDE, web, tarefas em nuvem ou integrações. O preço da API é cobrado por milhão de tokens. Um espaço de trabalho multimodelo facilita a alternância entre Claude, GPT, Gemini, Perplexity e outros modelos em um único lugar.
Os preços verificados em 27 de setembro de 2026 estão em dólares americanos, antes dos impostos aplicáveis. A tabela distingue entre assinaturas para consumidores, tarifas padrão de tokens de API e os planos anuais da própria GlobalGPT. Página de preços do Claude O valor anual do Rounds Pro equivale a $17 por mês; o pagamento antecipado de $200 equivale a $16,67 por mês.
| Produto ou plano | Preço exibido | O que isso significa para a programação |
|---|---|---|
| Consumidor · Claude Grátis | $0 | É o suficiente para responder a perguntas simples sobre programação e experimentar o estilo do Claude antes de pagar. |
| Consumidor · Claude Pro | $20 por mês; $200 por ano, pago antecipadamente (equivalente a $16,67 por mês) | Código Claude incluído; uso do chat e do código Claude no plano pago. |
| Consumidor · Claude Máx. | A partir de $100 por mês | Opções de uso mais amplas; código Claude incluído. O faturamento do Console da API é separado. |
| Consumidor · ChatGPT Grátis | $0/mês | Bate-papo simplificado; o acesso ao GPT-6 Luna no desktop é diferente do bate-papo comum. |
| Consumidor · ChatGPT Go | $8/mês na referência original dos EUA; os preços locais podem variar | Assinatura mensal; consulte a página de preços local para saber o valor na sua região. |
| Consumidor · ChatGPT Plus | $20/mês, cobrado mensalmente | Acessos regulares ao Codex/Work e acesso ao Codex/Work para usuários qualificados; o uso da API é cobrado separadamente. |
| Consumidor · ChatGPT Pro | $100/mês; as assinaturas existentes de $200/mês continuam válidas | As novas inscrições e atualizações do plano $200 serão suspensas a partir de 10 de setembro de 2026. As assinaturas do plano $100 continuam disponíveis. |
| API · Claude Soneto 5 | Entrada $2/M; saída $10/M | Taxa padrão da API para ferramentas de codificação e fluxos de trabalho com contexto amplo. |
| API · Claude Opus 5,5 | Entrada $4/M; saída $20/M | Velocidade padrão. O modo rápido tem entrada $8/M e saída $40/M. |
| API · GPT-6 Astra | Entrada $10/M; saída $50/M | Tarifa padrão da API; distinta do plano ChatGPT. |
| API · GPT-6 Sol / Luna | Sol: entrada $2/M, saída $10/M; Luna: entrada $0.10/M, saída $0.50/M | Faturamento separado para desenvolvedores; utilize o ID exato do modelo e a tarifa correspondente. |
| Plataforma · GlobalGPT Básica | Equivalente a $5,80 por mês; $69,60 cobrado anualmente | Uma maneira econômica de comparar várias famílias de modelos para tarefas diárias de programação e pesquisa. |
| Plataforma · GlobalGPT Pro | Equivalente a $10,80 por mês; $129,60 cobrado anualmente | Uma adaptação melhor quando você alterna entre várias famílias de modelos durante o trabalho diário. |
| Plataforma · GlobalGPT Ilimitado | Equivalente a $25/mês; $300 cobrado anualmente | Para comparações frequentes entre vários modelos em um único espaço de trabalho. Esses planos não incluem créditos oficiais da API nem assinaturas nativas do Claude Code/Codex. |
Para a maioria dos desenvolvedores independentes, a decisão não é “qual empresa é mais barata?”, e sim “qual preço se adapta melhor ao fluxo de trabalho?”. Se você passa a maior parte do tempo fazendo perguntas e colando trechos de código, o Claude Pro ou ChatGPT Plus pode ser suficiente. Se você deseja uma implementação compatível com repositórios, compare o acesso ao Claude Code e ao Codex. Se você compara vários modelos todos os dias, o GlobalGPT pode ser a opção mais simples para o seu ambiente de trabalho diário, pois o custo está vinculado a um único plano multimodelo, em vez de várias assinaturas separadas.
No caso de ferramentas de programação que fazem uso intensivo de APIs, os preços das assinaturas não são o parâmetro adequado para comparação. O preço por token é mais relevante, pois o contexto do código é amplo. Claude Soneto 5 custa $2/M de entrada e $10/M de saída, enquanto o Opus 5.5 custa $4/M e $20/M na velocidade padrão. Portanto, um milhão de tokens de entrada mais um milhão de tokens de saída custam $12 no Sonnet 5 ou $24 no Opus 5.5. Para o OpenAI, o mesmo uso custa $60 no Astra, $12 no Sol ou $0,60 no Luna, com tarifas padrão. Essas são taxas de API, e não cotas incluídas nas assinaturas ChatGPT, Claude ou GlobalGPT.
Qual configuração de codificação você deve escolher?
Não escolha apenas com base no nome do modelo. Escolha de acordo com o tipo de trabalho de programação que você realmente realiza. A mesma pessoa pode usar o ChatGPT para uma primeira implementação, o Claude para revisão, o Codex para trabalhar com repositórios executáveis e o GlobalGPT para verificações rápidas e comparativas entre modelos durante um dia normal.
Iniciante aprendendo a programar: Comece com o ChatGPT. Ele geralmente oferece mais exemplos, mais orientação e um caminho mais acessível, partindo de “Não entendo esse erro” até “Aqui está a forma correta”.”
Desenvolvedor júnior corrigindo bugs: Comece com o Claude quando o problema não estiver claro. O Claude é bom para restringir as causas prováveis, indicar o que deve ser verificado primeiro e manter a explicação direta ao ponto. Use o ChatGPT depois disso, quando quiser uma correção específica, um caso de teste ou um exemplo de implementação.
Engenheiro sênior revisando uma alteração: Comece com o Claude. Ele é mais adequado para análises de trade-offs, classificação de gravidade, questões arquitetônicas e críticas concisas. Para tarefas envolvendo bases de código maiores, mude do chat para o Claude Code ou o Codex, para que o modelo possa trabalhar com arquivos e comandos, em vez de um fragmento colado.
Desenvolvedor de front-end ou criador de interface do usuário: Comece com o ChatGPT para a primeira revisão. Ele costuma gerar um código de componentes mais completo, com gerenciamento de estado e estruturas de teste. Em seguida, use o Claude para revisar a acessibilidade, os limites dos componentes, a nomenclatura e se o código é excessivamente complexo para o design.
Responsável pela manutenção de uma base de código extensa: Escolha entre o Claude Code e o Codex com base na sua pilha de tarefas, acesso à conta, política de segurança e fluxo de trabalho preferido. Quando uma tarefa envolve vários arquivos, o fluxo de trabalho do agente costuma ser mais importante do que qual resposta no chat soa melhor.
Fundador sozinho ou equipe pequena: Utilize ambas as famílias de modelos, se o orçamento permitir. Uma configuração prática é usar o GlobalGPT para comparação diária de modelos e geração de código a partir de ideias, além do Claude Code ou do Codex quando uma tarefa exigir acesso ao repositório e etapas executáveis.
| Tipo de desenvolvedor | A melhor opção inicial | Por que |
|---|---|---|
| Iniciante aprendendo a programar | ChatGPT | Mais exemplos, explicações mais completas e orientações adequadas para iniciantes. |
| Desenvolvedor júnior corrigindo bugs | Claude primeiro | Uma abordagem mais clara para identificar a causa raiz e orientações mais precisas sobre o que deve ser verificado primeiro. |
| Engenheiro sênior analisando uma alteração | Claude | Mais adequado para análises de trade-offs, classificação de riscos e críticas concisas. |
| Desenvolvedor de front-end/interface do usuário | Primeiro o ChatGPT, depois o Claude | O ChatGPT elabora o rascunho do componente; o Claude analisa a acessibilidade, a estrutura e a facilidade de manutenção. |
| Responsável pela manutenção de uma base de código extensa | Claude Code ou Codex, dependendo da pilha e do acesso | Arquivos, comandos, testes e permissões são mais importantes do que uma única resposta no chat. |
| Fundador da Solo | Ambos, muitas vezes por meio de um único espaço de trabalho multimodelo | Rascunhos rápidos, revisão cuidadosa e troca ágil de modelos são fatores importantes quando uma única pessoa é responsável pelo produto. |
Se você estiver decidindo entre as famílias de modelos mais recentes Claude e GPT, a comparação entre o Claude Opus 5.5 e o GPT-6 Sol oferece mais contexto específico sobre os modelos. Se você estiver avaliando os planos pagos do OpenAI, o ChatGPT Plus vs Pro Essa comparação pode ajudar a avaliar se vale a pena um uso mais intenso.
Por que muitos desenvolvedores ainda usam os dois
Usar tanto o Claude quanto o ChatGPT não é indecisão. É um ciclo de controle de qualidade mais eficaz.
- Planeje com o Claude, coloque em prática com o ChatGPT: útil quando se deseja usar o Claude para reduzir o risco e o ChatGPT para gerar a primeira implementação.
- Escreva com o ChatGPT, revise com o Claude: útil quando você precisa de um código rápido, mas quer uma segunda opinião mais rigorosa.
- Pergunte a ambos antes de mexer na produção: útil para pagamentos, autenticação, uploads, migrações, armazenamento em cache e alterações destrutivas no banco de dados.
- Use um agente quando a tarefa precisar de arquivos: O Claude Code ou Codex pode ser mais importante do que um bate-papo comum quando o modelo precisa do contexto do repositório.
O GlobalGPT se encaixa no padrão “use os dois” quando a tarefa envolve comparação imediata, ajuda no dia a dia com programação, planejamento ou pesquisa. É especialmente útil para comparação diária de modelos, iteração de rascunhos, segundas opiniões rápidas e escolha do estilo de modelo que melhor se adapta ao próximo trabalho.
Se o acesso ao Claude for o único aspecto que você está avaliando, o melhores alternativas ao Claude AI A lista serve como um guia geral de alternativas.
PERGUNTAS FREQUENTES
O que é melhor para programação em 2026: o Claude ou o ChatGPT?
Escolha primeiro o Claude para revisão de código, depuração de casos ambíguos, planejamento de arquitetura e raciocínio em contextos extensos. Escolha o ChatGPT em primeiro lugar para rascunhos de implementação, exemplos, trabalho de front-end e estrutura de testes. Quando a tarefa exigir acesso ao repositório, comandos, testes ou edições em vários arquivos, compare o Claude Code com o Codex, em vez de depender apenas do chat.
O Claude é melhor que o ChatGPT para depuração?
O Claude costuma ser a melhor opção para a primeira etapa de depuração, pois tende a priorizar a causa mais provável e explicar claramente o caminho da falha. Em nossos testes de JavaScript e Next.js, o Claude Sonnet 5 se destacou especialmente no diagnóstico conciso. O ChatGPT continuou se mostrando eficaz quando a correção exigia detalhes mais completos sobre a implementação.
O ChatGPT Codex é melhor do que o Claude Code?
Nenhuma das duas opções é automaticamente melhor para todas as equipes. O Codex ChatGPT se adapta a fluxos de trabalho centrados no OpenAI e a tarefas de agentes que exigem muita implementação. O Code Claude se destaca quando o trabalho se beneficia do estilo de planejamento, revisão e raciocínio em contexto de longo prazo do Claude. A melhor escolha depende do acesso ao repositório, do preço, da pilha de tecnologias, das permissões e da política da equipe.
O que é melhor para uma base de código grande?
Em uma base de código extensa, o fluxo de trabalho do agente é mais importante do que apenas o modelo de chat. Utilize o Claude Code ou o Codex quando o assistente precisar inspecionar arquivos, executar comandos, realizar testes ou rastrear o comportamento entre módulos. Mantenha a revisão humana em relação às permissões, aos comandos de risco e à comparação final.
O que é melhor para iniciantes que estão aprendendo a programar?
O ChatGPT costuma ser mais fácil para iniciantes, pois tende a fornecer mais exemplos, explicações mais completas e trechos de código prontos para uso. O Claude pode ser mais adequado quando o iniciante está com dificuldade para entender por que algo não funciona e precisa de uma explicação conceitual mais clara.
O que é melhor para o código HTML e de interface do usuário (UI) do front-end?
O ChatGPT costuma ser mais eficaz na geração do primeiro rascunho de HTML, CSS ou componentes. O Claude é útil para revisar a estrutura, simplificar o layout e identificar problemas de acessibilidade ou manutenção. Para um trabalho de front-end bem acabado, use o ChatGPT para elaborar o rascunho e o Claude para revisá-lo.
Qual modelo é melhor para escrever testes?
O ChatGPT é melhor quando você quer um arquivo de teste completo, com importações e uma estrutura que pareça executável. O Claude é melhor quando você quer entender qual comportamento precisa de proteção e por que um teste de regressão é importante. Um fluxo de trabalho eficaz consiste em gerar testes com o ChatGPT e, em seguida, perguntar ao Claude quais casos extremos estão faltando.
Os testes de desempenho, como o SWE-Bench, comprovam qual assistente de programação é melhor?
Não. O SWE-Bench, o SWE-Bench Pro e o Terminal-Bench são indicadores valiosos, especialmente para fluxos de trabalho de codificação baseados na agência, mas não prevêem totalmente a ajuda diária na codificação. Os benchmarks medem um ambiente controlado; os desenvolvedores reais também precisam de raciocínio claro, código utilizável, alterações sustentáveis e boas etapas de verificação.
Os desenvolvedores deveriam usar tanto o Claude quanto o ChatGPT?
Sim, especialmente para trabalhos sérios. Use o Claude para o planejamento, a análise de riscos e o diagnóstico. Use o ChatGPT para rascunhos de implementação, exemplos e estruturas de teste. Em seguida, execute o código, analise as diferenças e verifique o comportamento no seu próprio projeto.
Posso comparar o Claude e o ChatGPT no GlobalGPT?
Sim. O GlobalGPT é útil para comparar respostas do Claude e do ChatGPT em um único espaço de trabalho, quando os modelos necessários estiverem disponíveis nesse local. Ele funciona bem para dúvidas cotidianas sobre código, planejamento, pesquisa e segundas opiniões. Ele não substitui o Claude Code, o Codex, um IDE, APIs oficiais ou ferramentas no nível do repositório.