A escolha dos melhores modelos de IA para a sua lista de finalistas depende do trabalho que você precisa realizar. Para texto, programação e raciocínio, compare as famílias atuais de modelos GPT, Claude, Gemini, Grok, DeepSeek e Qwen. Para imagens, considere o GPT Image, o Nano Banana e o Midjourney; para vídeo, comece pelos recursos de geração e edição de que seu projeto precisa. Um assistente de pesquisa também precisa de ferramentas de busca e fontes confiáveis, não apenas de um modelo de linguagem poderoso.
Comece pela sua tarefa recorrente mais difícil e, em seguida, escolha a configuração mais econômica que a execute de forma confiável. Um modelo capaz de escrever um parágrafo convincente ainda pode interpretar mal um documento, inventar uma citação ou produzir um código com falhas. As recomendações a seguir se baseiam na documentação oficial dos modelos e em critérios práticos de seleção; trata-se de uma lista de finalistas organizada por tarefa, e não de um ranking de pontuações.
GlobalGPT reúne várias famílias de modelos e funções de IA em uma única assinatura, para que você possa passar da pesquisa e da redação para imagens e vídeos no mesmo espaço de trabalho. Essa é uma opção prática e econômica quando sua semana envolve vários tipos de trabalho e você deseja ter menos assinaturas separadas para gerenciar.
Catálogos oficiais de modelos consultados em 15 de setembro de 2026. Os exemplos históricos estão identificados com seus modelos originais.
Qual modelo de IA você deve escolher primeiro?
Uma lista prática organizada por tarefa
| Sua tarefa | Candidatos a serem comparados | O que deve determinar a escolha |
|---|---|---|
| Texto e programação no dia a dia | GPT-5.6 Terra; Claude Sonnet 5; Gemini 3,8 Flash | O cumprimento das instruções, o resultado útil e o nível de edição necessário. |
| Raciocínio complexo ou codificação extensa | GPT-6 Astra; Claude Opus 5 ou Fable 5.1; Qwen3.8 | Tenha sucesso nos seus casos mais complexos, com as ferramentas e permissões necessárias. |
| Documentos extensos e entradas mistas | Prévia do Gemini 3.1 Pro; modelos GPT e Claude atuais | Suporte a arquivos, recuperação precisa e referências às fontes — não apenas a capacidade. |
| Pesquisa recente | Um assistente com funcionalidade de pesquisa; Perplexity; Grok com ferramentas de pesquisa | A qualidade das fontes, as datas de publicação e se as referências bibliográficas corroboram a resposta. |
| Trabalho com API de alto volume | GPT-5.6 Luna; DeepSeek V4.1 Flash; um modelo Qwen menor adequado | Custo por resultado aceito, além dos requisitos de latência e implantação. |
| Criação e edição de imagens | GPT Image 2.5; família Nano Banana; Midjourney | Precisão do texto, controle da imagem de referência, estilo visual e repetibilidade. |
| Produção de vídeo | Veo 3.1 e ferramentas de vídeo com os controles de que você precisa | Movimento, continuidade, áudio, fluxo de trabalho editável e exportação prática. |
Primeiro, verifique se os candidatos atendem aos requisitos de recursos e ferramentas necessários; depois, compare-os com base em um trabalho concreto que você possa avaliar.
Não compre o modelo mais sofisticado para todas as solicitações. Extração de dados rotineira, pequenas reescritas e formatação geralmente têm um critério claro de aprovação ou reprovação. Reserve um modelo de raciocínio mais avançado para os casos em que uma opção mais econômica não consiga atingir esse critério. Para uma tarefa pontual, o aplicativo mais simples e funcional pode ser mais importante do que uma pequena diferença no custo da API.
Modelos de IA, aplicativos e assinaturas são opções diferentes
Um modelo de IA é o sistema que gera uma saída a partir da sua entrada. Um aplicativo oferece o ambiente de trabalho: envio de arquivos, pesquisa, conversas salvas, ferramentas de imagem ou integrações com outros softwares. Uma assinatura determina como você acessa esse ambiente e seus limites de uso. GPT é uma família de modelos, ChatGPT é um produto e um plano ChatGPT é uma decisão de compra. A mesma distinção se aplica aos modelos Claude e ao Claude Pro.
O GlobalGPT é uma plataforma multimodelo, portanto, deve ser incluído na discussão sobre fluxo de trabalho e acesso. O Perplexity é, nessa comparação, principalmente um produto voltado para pesquisa; seus modelos de API e serviços para desenvolvedores constituem uma camada separada. Colocar todos esses nomes em um único ranking de “melhores modelos” dificulta a decisão de compra, pois cada um deles resolve problemas diferentes.

- Escolha um aplicativo quando você deseja uma interface pronta para uso para arquivos, conversas ou trabalhos criativos.
- Escolha um API quando o software precisa enviar solicitações automaticamente e processar os resultados.
- Escolha um implantação com peso aberto quando a execução do modelo por conta própria faz parte dos requisitos. Leve em consideração o hardware, a manutenção e as medidas de segurança nessa decisão.
Um modelo que aceita imagens como entrada não gera automaticamente imagens como saída. Da mesma forma, uma janela de contexto ampla não significa que o aplicativo de bate-papo aceite arquivos de qualquer tamanho. Verifique se o modelo, os recursos do produto e o plano atendem às suas necessidades antes de comparar preços.
Modelos de texto, codificação e raciocínio que merecem ser selecionados
OpenAI: GPT-6 Astra e a família GPT-5.6
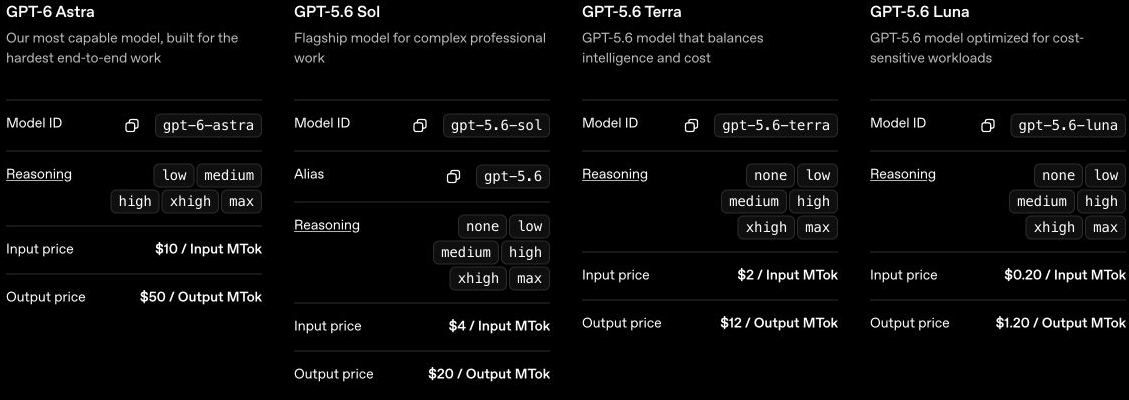
Catálogo de modelos da OpenAI recomenda o GPT-6 Astra para raciocínio complexo e programação, o GPT-5.6 Terra para equilibrar inteligência e custo, e o GPT-5.6 Luna para trabalhos de alto volume em que o custo é um fator importante. O GPT-5.6 Sol também é indicado para trabalhos profissionais complexos. Essas são opções diferentes de orçamento e tarefas dentro de uma mesma família, e não motivos para selecionar automaticamente o modelo mais caro.
Para um desenvolvedor, uma comparação útil é analisar a mesma função com falha, o mesmo conjunto de testes e os mesmos critérios de aceitação em dois candidatos. Para um analista, utilize os mesmos documentos de referência e peça a ambos os modelos que identifiquem as evidências por trás de cada conclusão. Uma explicação fluente não é suficiente se o código não funcionar ou se o documento citado indicar algo diferente.
- Comece por aqui para: uma combinação de texto, exercícios estruturados, raciocínio e tarefas de programação.
- Compare: Terra ou Luna para cargas de trabalho rotineiras; Sol ou Astra quando os casos mais complexos justificam o custo adicional.
- Acesso: Os preços da API abaixo referem-se às taxas do token de desenvolvedor. Eles são distintos das assinaturas do ChatGPT e das taxas específicas de cada ferramenta.
Claude: Sonnet 5, Opus 5 e Fable 5.1
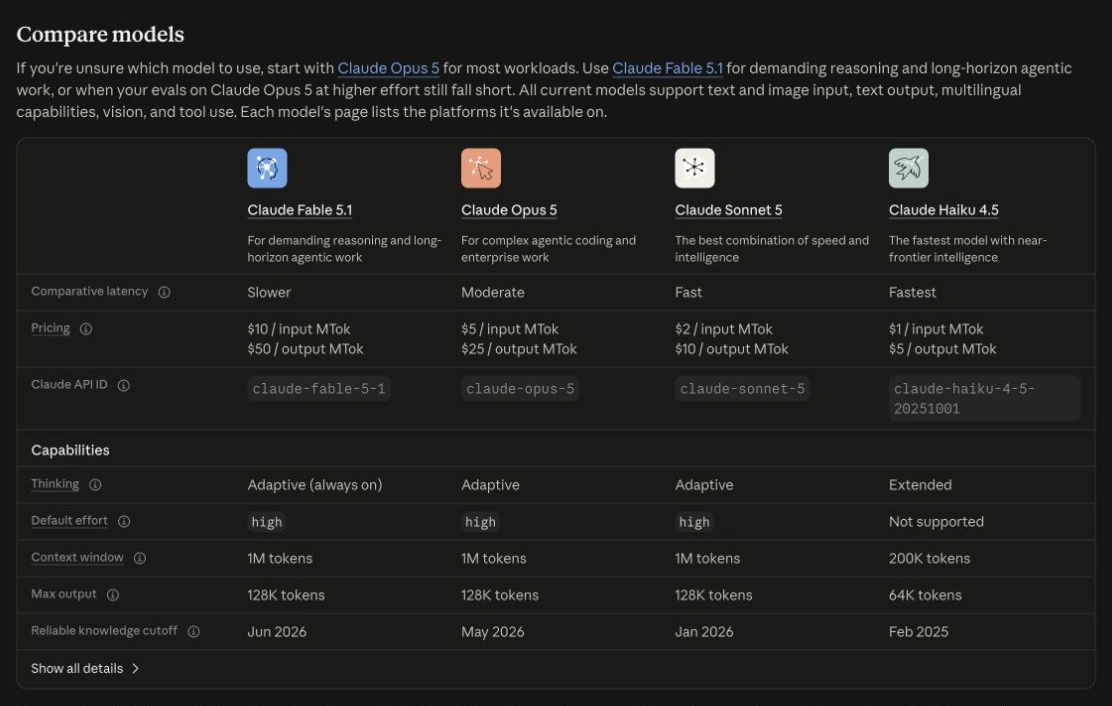
O elenco atual do Anthropic inclui o Claude Sonnet 5, o Opus 5, o Fable 5.1 e o Haiku 4.5. O Anthropic recomenda o Opus 5 para a maioria das cargas de trabalho e o Fable 5.1 para tarefas de raciocínio complexas ou trabalhos de agentes com horizonte de longo prazo, quando as avaliações no Opus ainda se mostram insuficientes. Essa é uma regra de atualização útil: invista no modelo mais complexo somente após identificar uma falha real, em vez de fazê-lo antes mesmo de tentar a tarefa.
Na redação, avalie se o modelo mantém os fatos, o tom e as restrições ao longo de várias rodadas de edição. Na programação, avalie as alterações que ele produz e os testes que ele passa. Uma resposta longa pode ser impressionante, mas cara de revisar. Peça o menor produto final completo possível: uma seção revisada, um patch funcional ou uma decisão com justificativa rastreável.
- Comece por aqui para: redações extensas, revisão de código e projetos que exigem o uso criterioso do material fornecido.
- Compare: Sonnet 5 para a linha de base de trabalho; Opus 5 ou Fable 5.1 para tarefas exigentes. Trata-se de uma sequência de seleção, não de uma classificação de qualidade independente.
- Acesso: As assinaturas do aplicativo Claude e o faturamento da API são diferentes. Compare Planos Claude e o API e detalhamento do uso para a rota que você pretende comprar.
Se você estiver escolhendo entre os dois ecossistemas, o Comparação entre Claude e ChatGPT aborda considerações relacionadas ao produto. Não transfira a posição de referência de um modelo mais antigo para uma nova versão com nome semelhante.
Gemini: 3.8 Flash e 3.1 Pro – Versão de pré-visualização
Diretório de modelos do Google A lista apresenta o Gemini 3.8 Flash como um modelo estável e o Gemini 3.1 Pro como uma versão prévia. Ela descreve o 3.8 Flash no contexto de engenharia de software, agentes autônomos e fluxos de trabalho corporativos complexos; o 3.1 Pro continua sendo uma opção para a resolução de problemas complexos. “Flash” e “Pro” são nomes de família; portanto, a versão exata e o status de lançamento são mais importantes do que apenas o nome em si.
O Gemini merece um lugar na lista de finalistas quando uma tarefa envolve entradas mistas, como um relatório acompanhado de imagens ou um vídeo acompanhado de uma transcrição. Verifique se a resposta se refere à página, ao quadro ou à passagem correta. Isso detecta uma falha comum em contextos longos: o modelo aceita o material, mas extrai o detalhe errado dele.

Google tabela de referência original apresenta a comparação entre as duas versões anteriores, mostrada acima. É útil para analisar as condições dos testes de desempenho. As linhas que utilizam ferramentas e as que não as utilizam respondem a questões diferentes. A seção de contexto mais detalhado também distingue uma média de 128K de um resultado ponto a ponto de 1M. Mantenha essas distinções ao avaliar uma afirmação sobre “melhor raciocínio” ou “memória mais longa”.”
Para dúvidas relacionadas à compra e à configuração, consulte Opções de assinatura do Gemini e Configuração da assinatura do Gemini. O Comparação entre o Gemini 3.1 Pro e o Claude Opus 4.6 trata-se de uma comparação específica entre versões, e não de uma indicação sobre a nova linha Claude.
Grok 4.6: separar o modelo da pesquisa ativa
Documentação do modelo Grok indica Grok 4.6 para tarefas de código e texto em geral, com uma janela de contexto de 500 mil tokens. Também estabelece um limite crucial: um modelo não tem conhecimento de eventos atuais além dos dados de treinamento, a menos que as ferramentas de pesquisa estejam ativadas. Para informações atualizadas, a escolha prática inclui a Pesquisa na Web ou a X Search, e não simplesmente o nome Grok.

Para um fluxo de trabalho de monitoramento de notícias ou tendências, avalie se o assistente encontra a reportagem original, distingue sua data de uma republicação e vincula a afirmação à fonte. A pesquisa pode recuperar o material sem que a interpretação final seja correta. Para tarefas de redação de conteúdo atemporal ou de código, compare o resultado com seus critérios de aceitação, em vez de presumir que a associação com a pesquisa em redes sociais torne o Grok uma opção inadequada.
DeepSeek: opções atuais da API e controles de custos
Tabela de API do DeepSeek mapas deepseek-flash para o firmware DeepSeek V4.1 e deepseek-v4-pro para o DeepSeek V4 Pro 0813. A mesma tabela indica que o Flash oferece suporte ao Vision, enquanto a versão Pro listada não oferece. Portanto, um nome que pareça mais sofisticado não garante o suporte para a entrada que você possui.
A DeepSeek é uma candidata a API útil e econômica, mas compare todas as condições de cobrança. Suas tarifas listadas diferenciam acertos de cache de erros de cache e horários de pico de horários fora de pico. Um preço mínimo cotado pode se referir a uma entrada armazenada em cache durante um determinado período, e não ao custo de uma solicitação comum não armazenada em cache.
- Comece por aqui para: cargas de trabalho recorrentes de API nas quais o preço e a compatibilidade de implantação são importantes.
- Verifique primeiro: mapeamento exato do modelo, suporte à entrada de imagens e requisitos de saída.
- Faça um orçamento correto: Utilize taxas de entrada e saída sem cache para uma primeira estimativa conservadora; aplique o uso de cache ou a redução de tempo de resposta somente quando sua carga de trabalho se enquadrar nos critérios.
Qwen: uma família de modelos aberta com vários tamanhos
Repositório oficial do Qwen abrange a série de modelos abertos Qwen3.5, incluindo a versão 3.6 e as versões mais recentes Qwen3.8. Ele lista os modelos Qwen3.8-27B e Qwen3.8-2.4T-A95B, enquanto os tamanhos anteriores da versão 3.5 incluem 0.8B, 2B, 4B e 9B. Esses nomes representam requisitos de implantação muito diferentes; um modelo local pequeno e um modelo principal de grande porte não são intercambiáveis.

A pergunta relevante para o trabalho local é: “O que meu hardware consegue executar bem?” Leve em consideração os pesos do modelo, a sobrecarga de execução e a memória utilizada por uma conversa que vai se prolongando. A quantização pode facilitar a execução de um modelo, mas seu efeito na sua tarefa deve ser avaliado. O repositório documenta opções de frameworks locais, incluindo llama.cpp e MLX; leia a ficha técnica e a licença do modelo antes da implantação.
Para a pesquisa, escolha fontes e ferramentas de busca, além de um modelo
O Perplexity é um produto de busca e pesquisa que combina respostas com referências. Seus planos para consumidores determinam o acesso a ferramentas de busca, modelos e uploads; os serviços Sonar e a API para desenvolvedores são opções à parte. Uma resposta rica em referências só é útil quando as fontes citadas realmente corroboram suas principais afirmações.
Para pesquisas ocasionais, comece com a versão gratuita: pesquisas básicas, seleção automática de modelos e envios limitados. O comparação de planos oficiais, consultada em 15 de setembro de 2026, indica 3 Pesquisas Pro por dia e 1 consulta de Pesquisa por mês gratuitamente, sem modelos avançados de IA nem geração de imagens. A versão Pro oferece modelos avançados, Pesquisa Pro ampliada e limites maiores de upload e análise. A cota de Pesquisa Pro tem limites semanais e a de Pesquisa, limites mensais; a tabela para consumidores não fornece os números exatos da versão Pro.
Perplexidade Página de preços individuais, consultado em 15 de setembro de 2026, apresenta o plano Gratuito a $0/mês, o Pro a $20/mês e o Max a $200/mês. Esses são os preços mensais exibidos, e não os valores totais de checkout anuais ou com impostos incluídos. Experimente a versão gratuita com uma consulta de pesquisa representativa e, em seguida, considere um plano pago se seus modelos avançados ou limites de uso mais altos atenderem a uma necessidade recorrente.
Elabore uma pequena lista de verificação das fontes antes de aceitar uma resposta. Abra a fonte de um dado importante; verifique se se trata de uma reportagem primária; confirme a data de publicação; e diferencie uma citação direta da interpretação do assistente. Para fatos sujeitos a alterações, como preços e disponibilidade de produtos, a documentação atual do fornecedor é uma referência mais confiável do que um artigo de resumo.
- Para uma revisão da literatura, procure artigos originais e identifique a questão de pesquisa abordada por cada artigo.
- Para tomar uma decisão de compra, solicite o plano exato, a base de cobrança e a data de validade das condições citadas.
- Para notícias recentes, compare o comunicado original com as matérias publicadas posteriormente.
- No caso de uma questão controversa, pergunte em quais pontos as fontes concordam e quais permanecem incertos.
Uso Modelos e modos do Perplexity para entender os modos de funcionamento disponíveis e Planos de assinatura de perplexidade para a decisão de compra. Um modelo de raciocínio mais complexo não consegue compensar um conjunto de fontes que omita o documento relevante.
Modelos de imagem: escolha entre controle de edição, precisão do texto ou estilo visual
Imagem GPT: geração e edição práticas
O catálogo atual da OpenAI inclui o GPT Image 2.5 Sunburst para geração e edição de imagens e o GPT Image 2.5 Flare para uma geração mais rápida no dia a dia. Compare os dois usando o mesmo anúncio, diagrama ou briefing de imagem de produto, incluindo as revisões que você espera fazer.
Para uma imagem corporativa, especifique o texto exato, o layout e os objetos necessários. Em seguida, verifique o resultado no tamanho final de exibição. Um belo infográfico pode conter um rótulo com erro ortográfico ou um número plausível, mas incorreto. Se o recurso visual comunicar fatos, verifique esses fatos separadamente da aparência da imagem.

Nano Banana: criação e edição de imagens com base em referências
O diretório do Google distingue o Nano Banana Pro, o Nano Banana 2 e o Nano Banana 2 Lite. O Nano Banana Pro corresponde a gemini-3-pro-image; Nano Banana 2 até gemini-3.1-flash-image; e Lite para gemini-3.1-flash-lite-image. Escolha a abordagem exata ao comparar a geração e o comportamento de edição, em vez de tratar o apelido como um modelo imutável.

As edições de referência exigem uma revisão diferente daquela feita na geração de imagens pontuais. A alteração solicitada foi realizada? O fundo, as roupas, o rosto ou os detalhes do produto sofreram alterações indesejadas? Uma pequena edição que preserve o restante da imagem pode ser mais útil do que uma reformulação drástica. Veja Introdução ao Nano Banana Pro, rotas de acesso e Preços do Nano Banana Pro para as próximas etapas.
Midjourney: avaliar o estilo em relação ao briefing
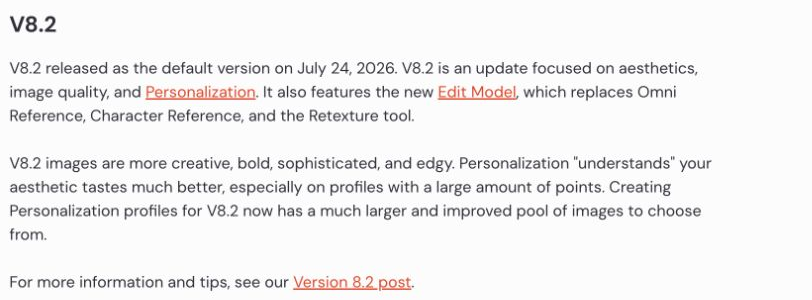
Midjourney’s guia oficial da versão, consultado em 15 de setembro de 2026, indica a V8.2 como a versão padrão, lançada em 24 de julho. Sua atualização se concentra na estética e na personalização e apresenta um “Edit Model” que substitui o “Omni Reference”, o “Character Reference” e o “Retexture”. Considere utilizá-lo para moodboards, arte conceitual ou um tratamento diferenciado para campanhas. Um esboço conceitual precisa de um estilo convincente; um diagrama de produto legendado precisa de conteúdo preciso. Compare o resultado e suas revisões com o briefing.

Para um teste útil, mantenha a consistência quanto ao tema, à composição exigida e ao formato de exportação. Verifique se é possível revisar a direção escolhida sem precisar recomeçar do zero. Se for essencial preservar com precisão o texto ou a identidade, defina essas verificações explícitas de aprovação/reprovação. O Comparação entre o Nano Banana Pro e o Midjourney oferece outra maneira de encarar essa decisão.
Modelos de vídeo: avalie o clipe inteiro, não apenas um quadro atraente
Veo 3.1 e o fluxo de trabalho de produção
Documentação do Google sobre o Veo descreve o Veo 3.1 para a geração de vídeo com controles criativos e áudio. Seus exemplos incluem imagens de referência, extensão de cena e fluxos de trabalho para o primeiro e o último quadro. Esses controles são importantes se você precisar que várias tomadas façam parte da mesma história, em vez de um clipe isolado.
Teste a restrição de produção que for mais difícil de corrigir posteriormente: um personagem consistente, um produto que mantenha sua forma, sinalização legível ou diálogos sincronizados. Assista ao clipe completo em velocidade normal e analise qualquer transição complicada. Um modelo pode apresentar um quadro inicial impactante, mas falhar à medida que a câmera se move.
O acesso, o uso e as exportações dependem da rota do produto; portanto, compare as Veo 3.1 Opções de assinatura e uso juntamente com os controles criativos. Não compare diretamente uma taxa de API por segundo com um plano mensal sem levar em conta o uso incluído e o tipo de saída.
Sora: explicar o encerramento anunciado
OpenAI Aviso de descontinuação do Sora, divulgado em 11 de setembro de 2026, informou que as experiências na web e no aplicativo haviam sido encerradas em 26 de abril e programou o desligamento da API para 24 de setembro de 2026. Considere o Sora como uma questão de migração para um projeto existente, em vez de um ponto de partida para um novo fluxo de trabalho de vídeo. Verifique o aviso para saber se há datas atualizadas e as instruções de exportação vigentes.

O Fluxo de trabalho do storyboard do Sora, Guia explicativo do Sora 2 Pro e Guia de duração do Sora específico para cada versão descreva as características históricas. Use-as para identificar o que um projeto existente precisa preservar e, em seguida, compare Alternativas ao Sora em relação a esses requisitos. Guarde o prompt, o material de referência e a saída completa juntos para que você possa avaliar uma proposta alternativa com base nas mesmas instruções.
Compare os custos da API para a mesma carga de trabalho
A API cobra pelas entradas e saídas de tokens; uma assinatura do consumidor dá acesso a um plano. Mantenha esses orçamentos separados. O cálculo abaixo utiliza 100 solicitações, cada uma com 10.000 tokens de entrada não armazenados em cache e 1.000 tokens de saída faturados: 1 milhão de tokens de entrada mais 100.000 tokens de saída no total. Trata-se de uma carga de trabalho ilustrativa, não de uma fatura real nem de um parâmetro de referência de qualidade.
USD, taxas padrão de tokens listadas, verificadas em 15 de setembro de 2026. Solicitações curtas, conforme especificado; sem desconto de cache, desconto por lote, nível de prioridade, impostos ou ferramentas pagas. A cota de saída inclui tokens de raciocínio faturados, quando aplicável. Fontes: Catálogo do modelo OpenAI, Visão geral do modelo Anthropic, Modelos e preços do Grok.
O custo unitário mais baixo só é útil se os resultados passarem nas suas verificações. Se um modelo mais barato exigir tentativas repetidas ou correções manuais significativas, compare o custo por resultado aceito. Comece com um candidato de custo mais baixo para tarefas claras e repetitivas e, em seguida, encaminhe os casos difíceis para um modelo mais capaz quando o primeiro resultado falhar.
As taxas utilizadas no cálculo
| Modelo | Entrada / 1 milhão de tokens | Saída / 1 milhão de tokens |
|---|---|---|
| GPT-5.6 Luna | $0.20 | $1.20 |
| Claude Haiku 4.5 | $1.00 | $5.00 |
| Grok 4,6 | $2.00 | $6.00 |
| Claude Soneto 5 | $2.00 | $10.00 |
| GPT-5.6 Terra | $2.00 | $12.00 |
| GPT-5.6 Sol | $4.00 | $20.00 |
| Claude Opus 5 | $5.00 | $25.00 |
| GPT-6 Astra | $10.00 | $50.00 |
| Claude Fable 5.1 | $10.00 | $50.00 |
Essas são taxas de API, não taxas de assinatura mensais. A carga de trabalho acima mantém fixos o tamanho da entrada e o tamanho da saída faturada; ela não pressupõe que, na prática, o comprimento, a precisão ou a velocidade da saída sejam iguais.
O DeepSeek utiliza uma tarifa diferenciada em função do horário. Sua tabela Flash atual, versão 4.1, lista a entrada não armazenada em cache como $0,15 fora do horário de pico ou $0,30 no horário de pico, e a saída como $0,60 fora do horário de pico ou $1,20 no horário de pico, por milhão de tokens. O V4 Pro lista $0.66/$1.32 para entradas não armazenadas em cache e $1.98/$3.96 para saídas. Os horários de pico documentados são das 01h00 às 04h00 e das 06h00 às 10h00 UTC, de segunda a sexta-feira. Use a tarifa aplicável no momento em que o trabalho for executado; os preços de entrada em cache devem ser calculados separadamente.
Para um fluxo de trabalho misto no dia a dia, Assinatura multimodelo da GlobalGPT oferece uma maneira mais simples de lidar com pesquisa, redação, ajuda com programação e geração de conteúdo criativo, tudo ao mesmo tempo. Compare essa conveniência e abrangência com a gestão de várias assinaturas ou com a criação de um fluxo de trabalho de API por conta própria. Uma tabela de preços de API não descreve o preço da assinatura nem os termos de uso.
Open-weight ou hospedado: decida o nível de gerenciamento que você deseja
Os pesos abertos oferecem uma opção de implantação: executar um modelo em um ambiente sob seu controle. Eles não tornam automaticamente todo o fluxo de trabalho gratuito, privado ou irrestrito. Verifique a licença associada ao modelo específico, o hardware necessário para executá-lo e para onde o aplicativo associado envia arquivos ou registros.
- Escolha um aplicativo hospedado quando você quer começar rapidamente e não precisa operar o modelo.
- Escolha uma API hospedada quando você precisa de automação sem precisar manter hardware de inferência.
- Considere a implantação local quando o trabalho offline, o controle da infraestrutura ou uma necessidade específica de tratamento de dados justificam essa opção.
- Compare modelos menores no seu hardware antes de concluir que um modelo top de linha com mais parâmetros é a escolha mais prática.
Um modelo local pode reduzir a transferência de dados externos, mas o restante do sistema ainda é importante: recuperação, plug-ins, telemetria, históricos salvos e backups. Para uma equipe, é melhor encarar isso como uma revisão da implantação, em vez de uma promessa inferida da palavra “aberto”. O Guia de privacidade de dados em IA fornece um contexto para comparar os requisitos de tratamento de dados.
É melhor usar um modelo de IA ou vários?
Um modelo já é suficiente quando ele lida bem com suas tarefas recorrentes. Adicione outro quando ele resolver uma lacuna específica: melhor acesso a fontes, um tipo de entrada necessário, uma edição de imagem mais controlável ou uma carga de trabalho em lote de menor custo. Coletar assinaturas sem atribuir uma tarefa a cada uma delas gera mais decisões e mais transferências de responsabilidade.

Crie um fluxo de trabalho em torno do produto final
| Trabalho | Sequência útil | Verificação de aceitação |
|---|---|---|
| Marketing | Pesquisar fontes → elaborar rascunho → criar elementos visuais → revisar as afirmações | As afirmações da campanha são comprovadas, e o texto e os recursos visuais transmitem a mesma mensagem. |
| Desenvolvimento de software | Entender o problema → alterar o código → executar os testes → revisar as diferenças | A alteração atende ao requisito sem causar efeitos indesejados em outras áreas. |
| Criação de conteúdo | Esboço → roteiro → imagens de referência → tomadas de vídeo → edição | Os personagens, os detalhes do produto e a narrativa permanecem consistentes. |
| Operações iniciais | Resumir as contribuições → extrair decisões → elaborar um plano de acompanhamento | As decisões têm responsáveis e datas, e nenhum fato sem fundamento é registrado. |
| Trabalho corporativo | Selecionar ambiente aprovado → processar os dados permitidos → revisar o resultado | O fluxo de trabalho atende aos requisitos da organização em matéria de acesso, dados e revisão. |
Comece com um produto finalizado. Mantenha as notas de origem e as verificações de aceitação junto com o trabalho à medida que ele passa de uma ferramenta para outra.
O GlobalGPT se adapta ao padrão de múltiplas etapas ao reunir famílias de modelos e funções criativas em um único local. Mantenha as notas de referência úteis, o briefing e os critérios de aceitação junto com o trabalho ao alternar entre tarefas. O Visão geral dos modelos de IA “tudo em um” é uma boa leitura a seguir, caso a decisão principal seja a amplitude do espaço de trabalho, em vez de um único modelo especializado.
Como escolher: uma avaliação em cinco etapas que você pode repetir
- Defina um resultado esperado. Por exemplo, um resumo de 500 palavras com referências às páginas, um patch que seja aprovado em três testes ou uma imagem de produto com duas legendas exatas.
- Escolha dois candidatos plausíveis. Primeiro, compare os recursos e as ferramentas necessárias. Não compare um assistente com recurso de busca a um modelo que não recebeu ferramentas de recuperação e chame essa diferença de “inteligência do modelo”.
- Utilize o mesmo briefing e os mesmos dados. Anote o modelo, o produto, as configurações e a data. Salve o primeiro resultado completo, em vez de selecionar apenas a tentativa que ficou melhor.
- Verifique a precisão antes do estilo. Verifique as citações, execute os testes de código pertinentes e analise os detalhes das imagens ou dos vídeos. Registre as correções manuais necessárias.
- Repita os casos mais difíceis. Se a escolha for acirrada ou o resultado for inconsistente, repita esses casos e mantenha os resultados adicionais separados. Faça a escolha com base no resultado esperado, no esforço e no custo total.
Na redação, uma verificação útil é verificar se todos os fatos apresentados se mantêm após uma reformulação. Na extração de informações, compare o resultado com um pequeno gabarito. Na pesquisa, acesse as páginas citadas. No caso de vídeos, salve e assista ao clipe na íntegra. O Metodologia de teste do modelo GlobalGPT fornece contexto adicional para o registro de comparações.
Evite quatro atalhos: comprar com base em alegações de popularidade, comparar unidades de preço diferentes, tratar um único parâmetro de referência como se fosse a tarefa completa e ignorar o tempo de análise que um resultado exige. Nenhuma dessas questões é resolvida simplesmente escolhendo o nome do modelo mais recente. Uma avaliação repetível é mais útil, pois pode ser executada novamente quando um modelo for alterado.
Perguntas frequentes
Qual é o melhor modelo de IA no momento?
Não existe uma opção ideal para todos os casos. Comece com as opções atuais de GPT, Claude, Gemini, Grok, DeepSeek ou Qwen para texto e código e, em seguida, refine a escolha de acordo com sua tarefa, as ferramentas necessárias, os dados de entrada e o orçamento. Use um modelo dedicado para imagens ou vídeos quando o resultado final exigir isso.
Qual modelo de IA eu deveria experimentar para programação?
Escolha candidatos que ofereçam suporte ao seu fluxo de trabalho de desenvolvimento, como os modelos atuais GPT, Claude, Gemini ou Qwen. Compare-os com base na mesma questão, na mesma base de código e nos mesmos testes. Uma alteração aprovada que exija pouco trabalho de revisão é um critério de seleção melhor do que uma explicação convincente.
Uma janela de contexto maior é sempre melhor?
Uma janela de contexto mais ampla permite incluir mais material em uma solicitação, mas não garante uma recuperação precisa nem um raciocínio adequado sobre esse material. Verifique se o modelo consegue localizar a passagem, a página ou o quadro exato necessário para sua resposta.
Os modelos de IA de peso aberto são gratuitos?
Os modelos podem estar disponíveis sob uma licença, mas sua execução pode exigir hardware, hospedagem e manutenção. Verifique o modelo exato da licença e o custo de implantação. Uma implantação local também requer uma análise do aplicativo em questão e do tratamento de dados.
O Grok reconhece automaticamente as notícias em tempo real?
Não. A documentação da API Grok indica que as informações atuais exigem o uso de ferramentas de pesquisa, como o Web Search ou o X Search. O conhecimento de treinamento de um modelo e as fontes recuperadas durante uma solicitação são coisas diferentes.
Posso comparar os preços da API com uma assinatura mensal de IA?
Somente após definir a carga de trabalho e o que cada opção inclui. As tarifas de API são normalmente cobradas por tokens ou por saída de mídia, enquanto uma assinatura oferece acesso de acordo com termos de uso específicos do plano. Compare o custo total do fluxo de trabalho que você pretende implementar, da mesma forma que se faz com os preços anunciados.
O modelo de IA mais popular precisa ser necessariamente o melhor para mim?
Não. A popularidade não indica se um modelo é capaz de processar seus arquivos, atender às suas restrições ou se encaixar no seu orçamento. Use a documentação atual para fazer uma lista de finalistas e, em seguida, compare os resultados reais com uma tarefa que você possa verificar.
Escolha o modelo que permita concluir o próximo trabalho com o menor número possível de correções evitáveis. Comece aos poucos, registre o que dá certo e adicione outro modelo somente quando ele resolver um problema específico. Se o seu trabalho abrange pesquisa, redação e produção criativa, experimente esse fluxo de trabalho no GlobalGPT e avalie o resultado final.