De Qwen 3.8 Max is het nieuwe vlaggenschipmodel van Alibaba Qwen voor codering, professioneel werk, langlopende agents en multimodale taken. De officiële naam is Qwen3.8-Max, zo werd op 3 augustus 2026 bekendgemaakt, met in totaal 2,4 biljoen parameters, 95 miljard actieve parameters en een contextvenster van 1 miljoen tokens.
Deze lancering is meer dan alleen een routineuze update van de benchmarks. Qwen positioneert het model als een agent die kan plannen, tools kan gebruiken, visuele feedback kan beoordelen en door kan gaan met werken tijdens lange takenreeksen – en niet alleen als een chatbot die één vraag per keer beantwoordt. Daarmee komt het in hetzelfde aankoopgesprek terecht als de de beste AI-modellen voor de praktijk, maar de prijs van de API, het abonnement op basis van open gewicht en de implementatievereisten verdienen wat meer aandacht voordat je overstapt.
Wat is Qwen3.8-Max?
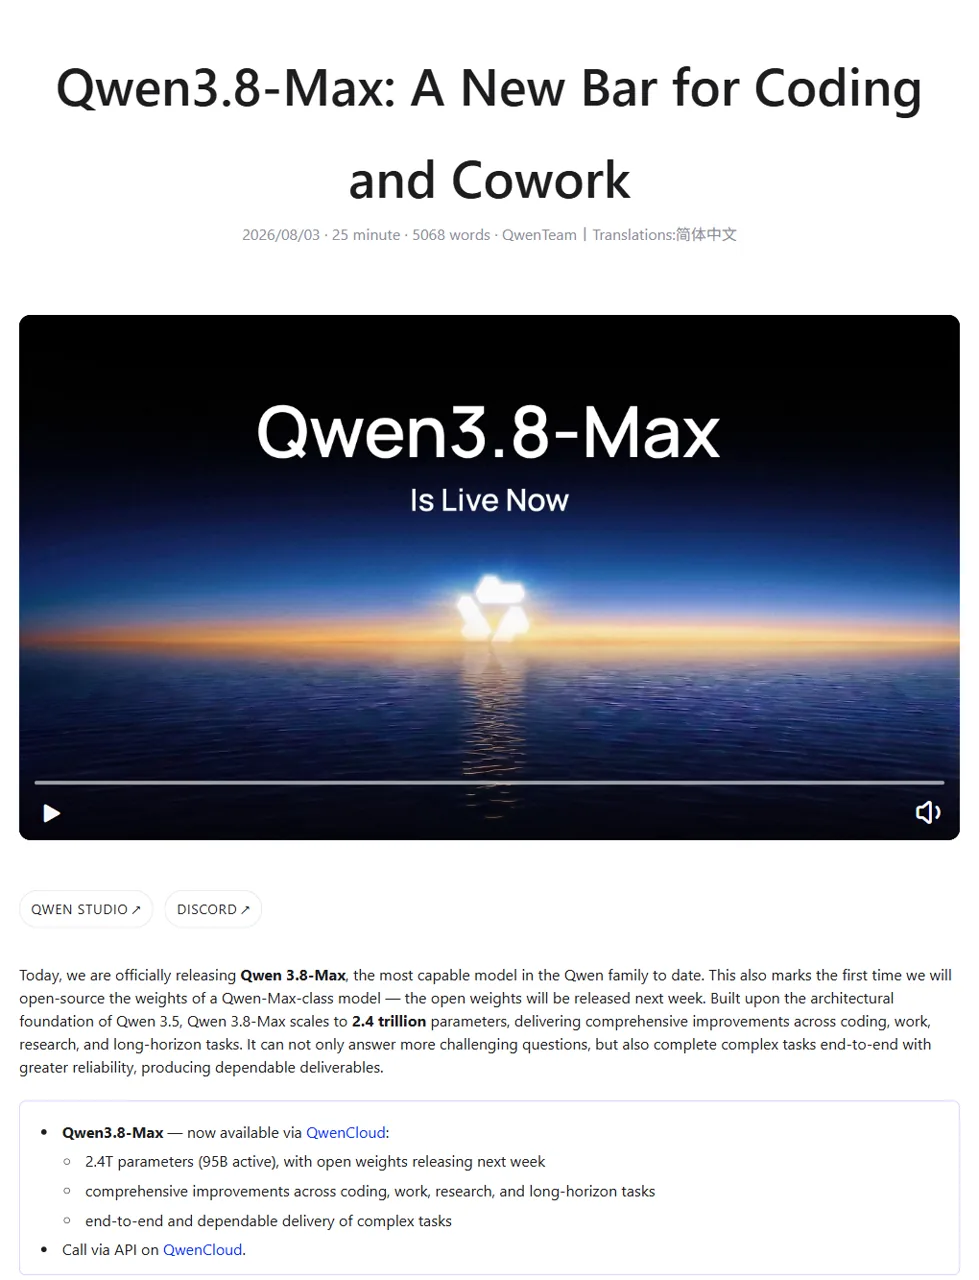
Qwen3.8-Max is een groot ‘mixture-of-experts’-model dat is ontwikkeld door het Qwen-team van Alibaba. Het telt in totaal 2,4 biljoen parameters, maar activeert 95 miljard parameters per token. Het model combineert tekst, code, visueel begrip, het gebruik van tools en planning op lange termijn in één systeem dat is ontworpen om complexe taken van begin tot eind uit te voeren.
De officiële release van Qwen beschrijft vier centrale doelstellingen: meer autonome codering, professionele resultaten van productiekwaliteit, langere taken in een gesloten cyclus en native multimodale agenten. Praktisch gezien wil Qwen dat het model de overstap maakt van “beantwoord deze vraag” naar “neem deze doelstelling, stel een plan op, gebruik de beschikbare hulpmiddelen, controleer het resultaat en ga door totdat het werk is voltooid.”
Qwen 3.8 Maximale specificaties
Het aantal parameters moet in de juiste context worden gezien. Een model met 2,4 biljoen parameters is enorm, maar Qwen3.8-Max gebruikt niet elke parameter voor elk token. Dankzij het ‘mixture-of-experts’-ontwerp wordt elk token door een kleiner, actief deel van het netwerk geleid. Het aantal van 95 miljard actieve parameters is daarom nuttiger om het inferentiegedrag te begrijpen dan het totale aantal alleen, hoewel geen van beide getallen op zichzelf iets zegt over de werkelijke latentie of hardwarevereisten.
Het contextvenster van 1 miljoen tokens is direct bruikbaarder. Het kan in één verzoek grote repositories, lange documentensets, uitgebreide agentgeschiedenissen of maandenlange operationele gegevens bevatten. Dat garandeert weliswaar geen perfecte terugvindbaarheid voor elk token, maar het biedt ontwikkelaars veel meer ruimte om instructies, uitvoer van tools, code en tussentijdse beslissingen te bewaren zonder dat er drastisch hoeft te worden ingekort.
Wat kan de Qwen3.8-Max?
Autonoom coderen
In het lanceringsmateriaal van Qwen ligt de nadruk op projecten die veel verder gaan dan een enkele aanvraag voor codegeneratie. Het bedrijf beschrijft een autonoom ontwikkelingsproces van meer dan 10 dagen, waarbij vanuit een lege map wordt opgebouwd naar een productieproject, terwijl het systeem zich aanpast aan fouten en nieuwe vereisten. Dat is de juiste richting voor agents op repository-schaal, hoewel kopers het model nog steeds moeten valideren voor hun eigen talen, testsuites, beveiligingsregels en implementatieomgeving.
Voor het dagelijkse ontwikkelingswerk zijn de praktische vragen eenvoudiger: Kan het model meerdere bestanden tegelijk verwerken? Blijven de interfaces behouden tijdens het refactoren? Schrijft het tests, analyseert het fouten en corrigeert het zijn eigen patch? Die criteria zijn belangrijker dan één score op een ranglijst bij het kiezen van de beste AI-model voor codering.
Professionele “cowork”-taken
Het woord “cowork” verwijst naar werkresultaten en niet naar informele gesprekken. Qwen belicht rapporten, onderzoeken, presentaties, analyses, documenten en andere deliverables uit honderden beroepen. Een goed cowork-model moet een opdrachtomschrijving volgen, bewijsmateriaal ordenen, de juiste opmaak gebruiken en iets opleveren dat iemand kan bewerken of presenteren – niet alleen maar een aannemelijke alinea.
Actoren met een lange tijdshorizon
Qwen meldt ook taken op systeemniveau die honderden beurten in beslag nemen. Voorbeelden hiervan zijn onder meer meer dan 500 beurten aan optimalisatie van chipontwerpen en een simulatie van een e-commerce-strategie die een jaar duurt. Dit zijn demonstraties van leveranciers, geen belofte dat elke agent dagenlang zonder toezicht zal draaien. Ze laten wel zien waar het product op gericht is: doorlopende planning, evaluatie in een gesloten kringloop en herhaalde verbetering in plaats van geïsoleerde antwoorden.
Multimodale planning en visuele feedback
Qwen3.8-Max beschouwt afbeeldingen en schermen als onderdeel van de agentlus. Een visuele agent kan een pagina bekijken, een actie kiezen, observeren wat er is veranderd en zijn plan bijstellen. Dit ondersteunt taken op het gebied van computergebruik, het begrijpen van documenten, het testen van interfaces, visueel coderen, grafieken en ruimtelijk redeneren. Het moeilijke deel is niet alleen het herkennen van een afbeelding; het is het gedurende vele stappen in verband houden van visuele waarnemingen met het doel van de agent.
Praktijktests: nuttige resultaten, trage reacties en één mislukte test
Ik heb drie afzonderlijke verzoeken uitgevoerd op de qwen3.8-max model-ID via de Anywhere OpenAI-compatibele API op 4 augustus 2026. Dit zijn kleine, praktische controles, geen onafhankelijke benchmark en ook geen uitspraak over elke Qwen-implementatie. Ze zijn nuttig omdat ze zowel de kwaliteit van het zichtbare antwoord als het gedrag van het geteste gateway-pad laten zien.
Foutopsporing met Retry-helper
De eerste taak maakte gebruik van een defecte herproeffunctie uit een scenario met een betalings-webhook. De prompt legde het model de volgende beperkingen op: drie pogingen, twee exacte backoff-vertragingen, onmiddellijke terugkeer bij succes en het opnieuw genereren van de derde uitzondering na een totale mislukking.
In het antwoord werden drie afzonderlijke fouten vastgesteld: onvoorwaardelijke slaap na elke poging, een niet-toegewezen resultaat na uitzonderingen, en een ‘truthiness’-controle die het succes vertraagde of verkeerd afhandelde. De verwachte regel was "paid" met sleep_fn-argumenten [0,1; 0,2].
Ik heb de code vervolgens lokaal uitgevoerd in plaats van de uitleg zomaar te geloven. De code doorliep drie gevallen: twee mislukkingen gevolgd door een succes, een ‘falsey’-succeswaarde bij de eerste aanroep van 0, en drie mislukkingen waarbij de uiteindelijke RuntimeError("failure-3") moest opnieuw worden verzonden. Dit was een goed technisch antwoord. Het nadeel was de latentie: de zichtbare reactie duurde 51,577 seconden via de geteste gateway.
Synthese van tegenstrijdige bewijzen
De tweede opdracht had tot doel te testen of het model actuele officiële feiten kon onderscheiden van oude aantekeningen, beweringen van leveranciers, een opmerking van een gebruiker en een niet-geverifieerde platformroute.
Het model heeft het opzettelijk gecreëerde conflict correct afgehandeld. Het herhaalde de 256K-context of de invoerprijs $1.20 niet als actueel, zette een opmerking over vier GPU's niet om in een hardwarevereiste en beweerde niet dat GlobalGPT al een speciale Qwen3.8-Max-route had. Het bestempelde de officiële benchmarktabel ook als door de leverancier gerapporteerd. Het antwoord duurde 94,973 seconden, dus dit was weer een resultaat waarbij kwaliteit voorop stond in plaats van een snelle extractie.
Wat ging er mis bij de planningsproef?
In een derde verzoek werd gevraagd om een CMS-migratieplan van twee uur, uitgevoerd door twee technici, met expliciete go/no-go- en rollback-mijlpalen. Het eerste verzoek werd na 133,682 seconden beëindigd toen de upstream-verbinding werd verbroken. Een kortere reeks herhalingspogingen max_completion_tokens tot 1.200, maar de API meldde finish_reason: "lengte", heeft het volledige redeneerbudget opgebruikt en leverde na 32,899 seconden geen zichtbaar antwoord op.
Dat is een nuttige operationele waarschuwing, maar het is geen bewijs dat Qwen3.8-Max geen migraties kan plannen. Er was geen plan beschikbaar om te beoordelen. Via deze gateway vereist complexe planning een grotere marge voor voltooiing, streaming of een gefaseerde prompt, zodat de interne redenering niet het volledige responsbudget opgebruikt voordat er zichtbare tekst wordt weergegeven.
Qwen 3.8 Max-benchmarks
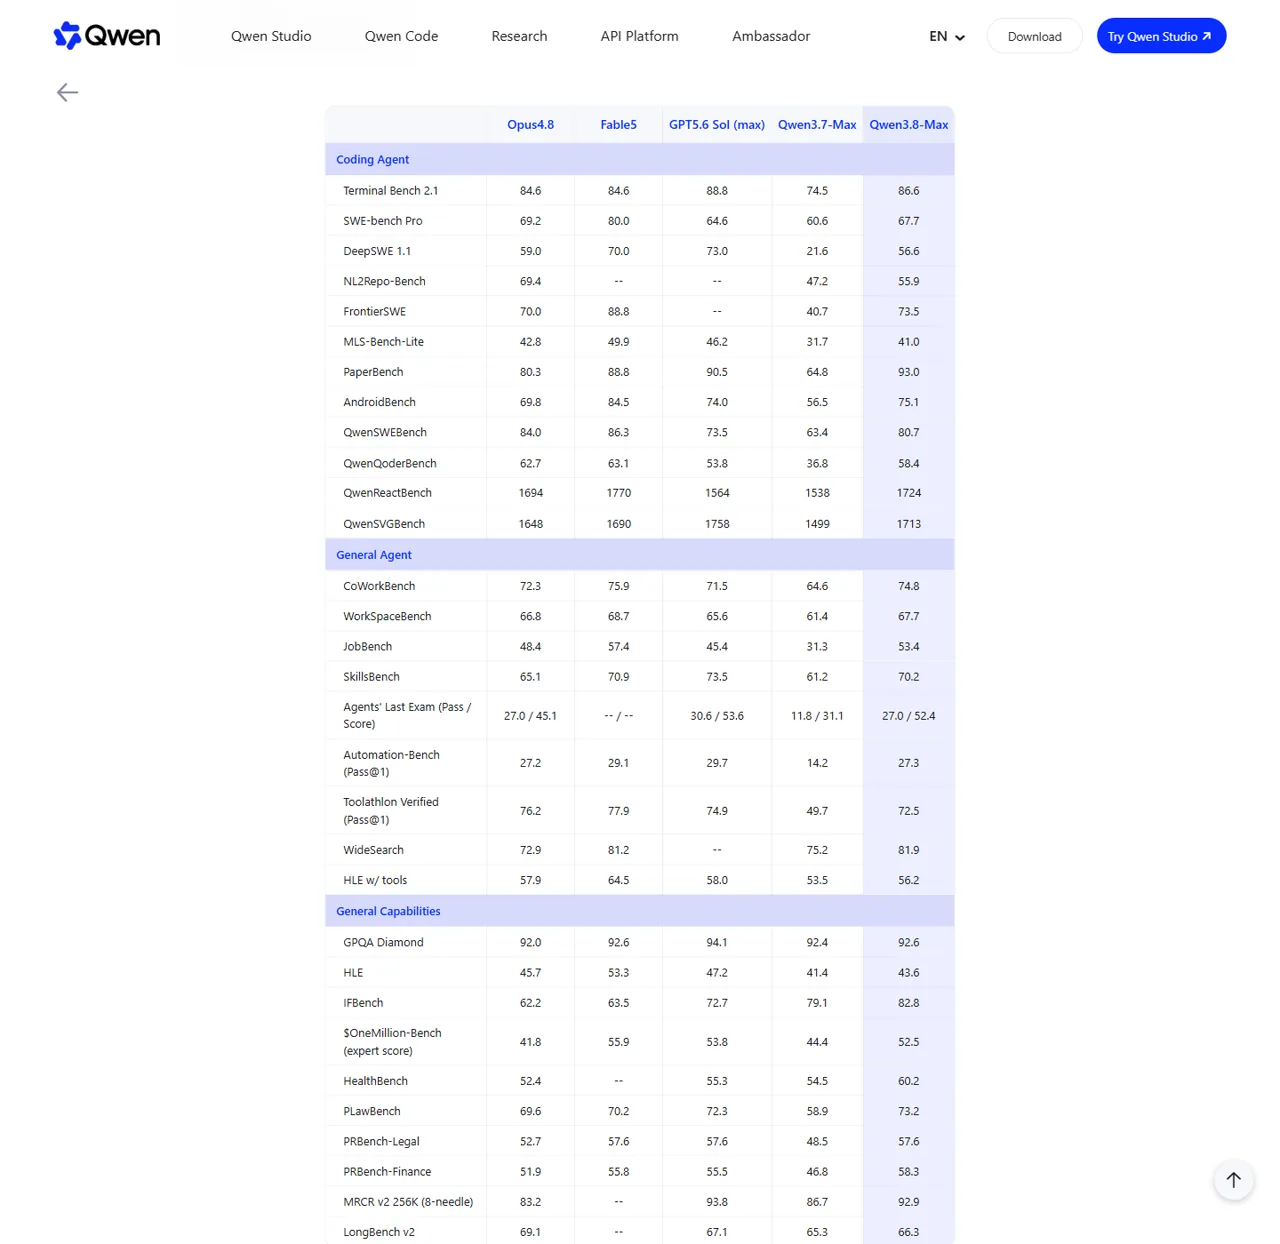
Het officiële benchmarkpakket van Qwen presenteert Qwen3.8-Max als een krachtige codeer- en multimodale agent, maar de resultaten zijn gemengd in plaats van een overweldigende overwinning. Bij sommige tests loopt het voorop ten opzichte van de andere modellen, bij andere zit het dicht in de buurt van de koploper, en in verschillende categorieën blijft het achter bij GPT-5.6 Sol of Fable 5. Dat is een gezonder beeld dan het terugbrengen van tientallen tests tot één “beste model”-label.
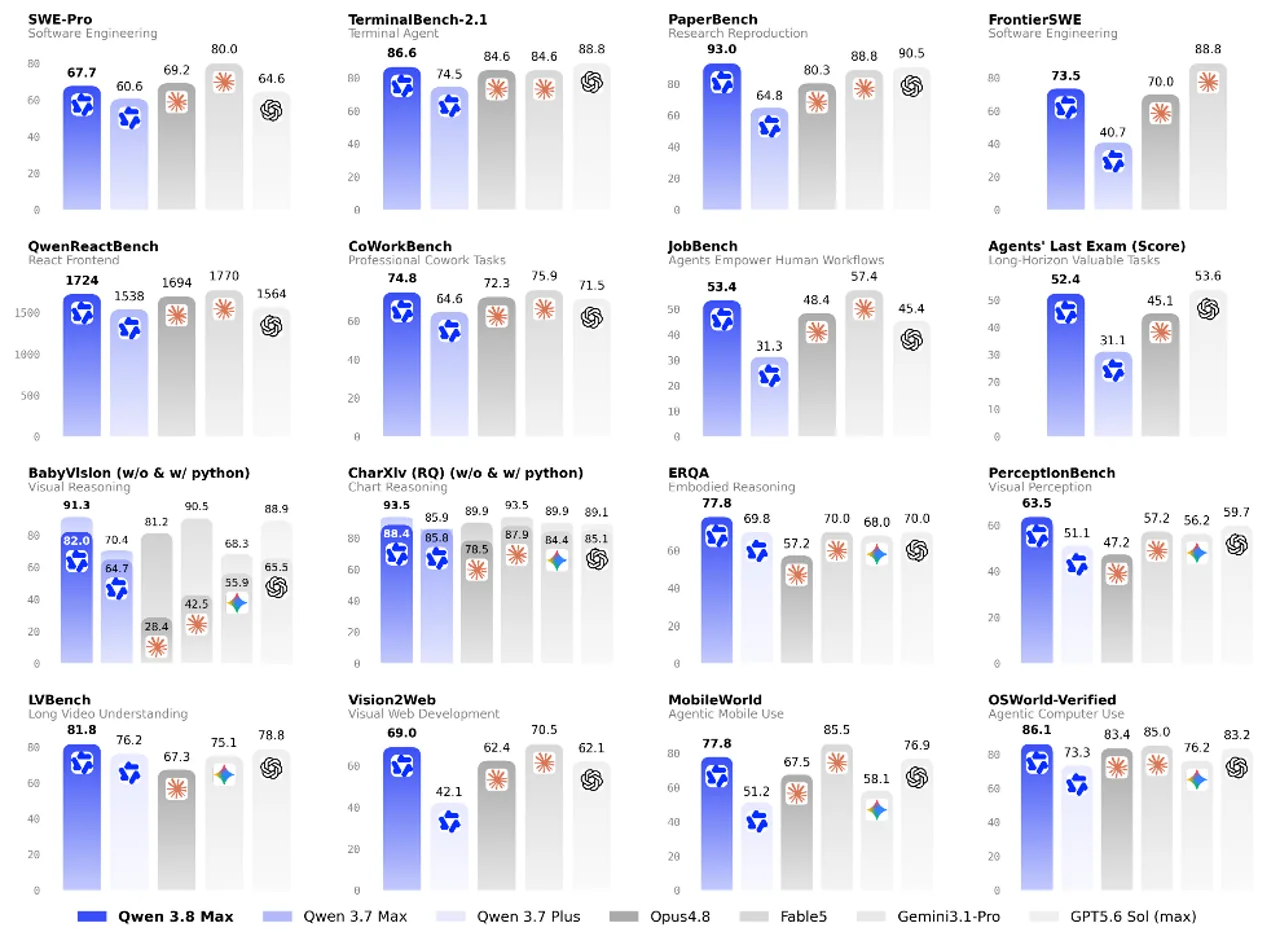
Een selectie uit de officiële ranglijst van Qwen
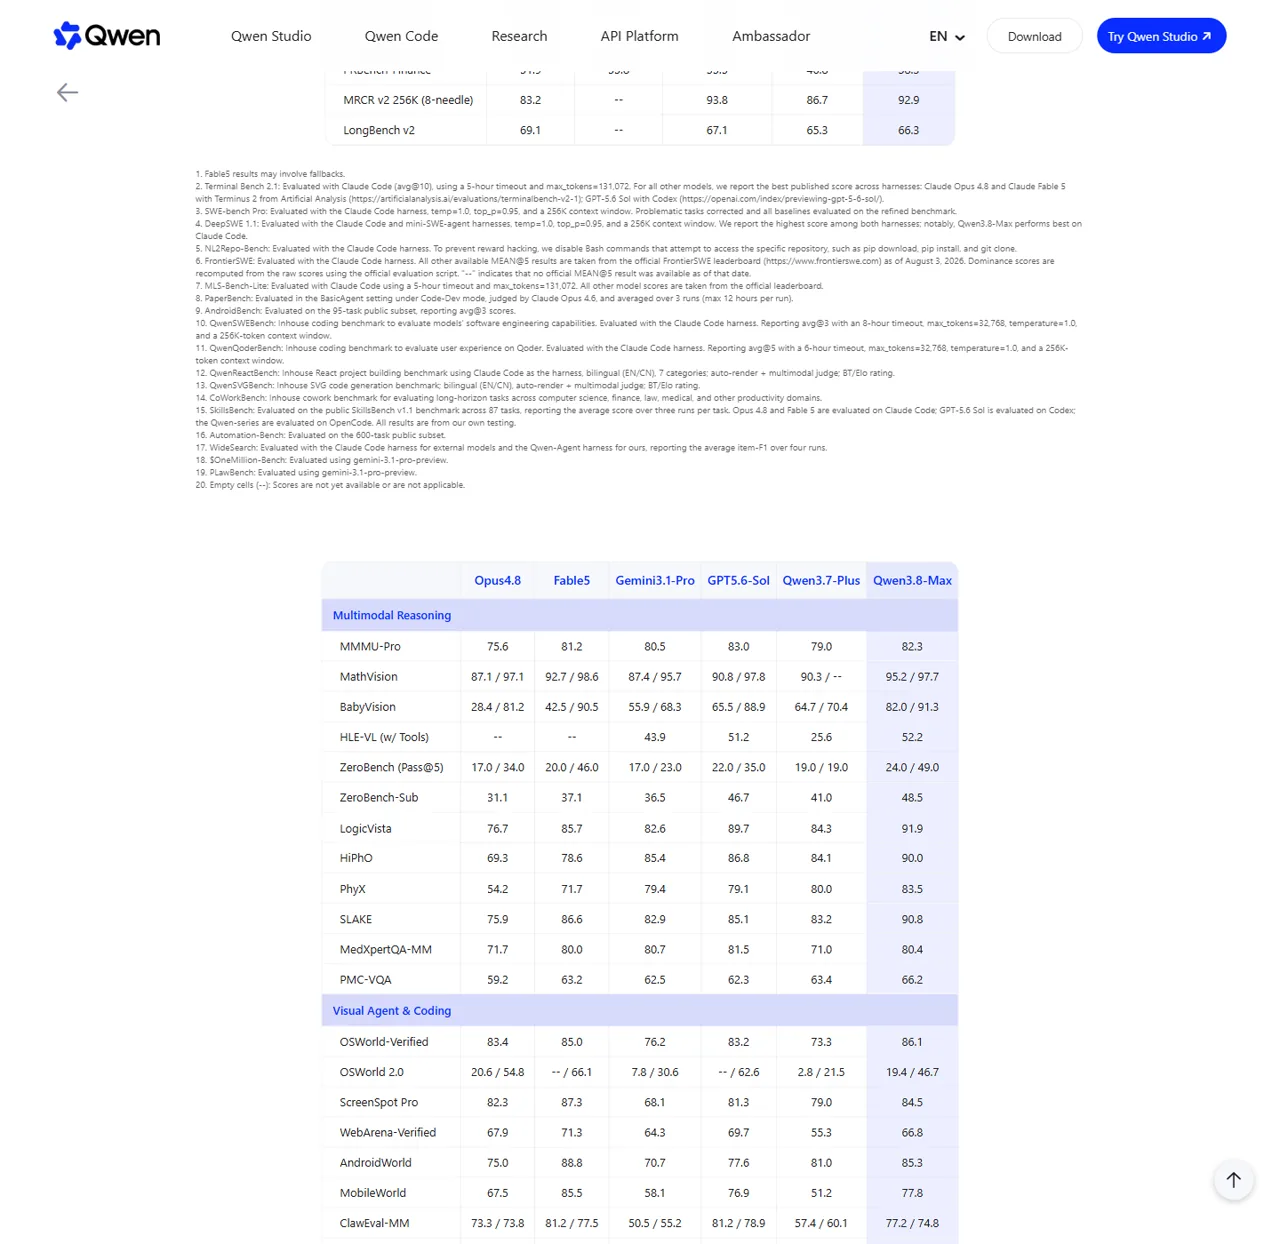
Deze cijfers zijn afkomstig uit het eigen persmateriaal van Qwen. Uit de voetnoten blijkt dat de tabel een combinatie is van officiële modelrapporten, systeemkaarten, openbare ranglijsten en interne evaluaties van Qwen. Ook de bedrading en instellingen verschillen per model. Gebruik de tabel om veelbelovende sterke punten te identificeren en controleer vervolgens de shortlist aan de hand van uw eigen werk voordat u een kostbare beslissing neemt.
Wat de resultaten van de codering betekenen
Het duidelijkste voordeel is de evenwichtigheid. De Qwen3.8-Max scoort goed op het gebied van terminalwerk, softwareontwikkeling, het opstellen van documenten, samenwerkingstaken, zoeken op het web en het opvolgen van instructies. Het hoeft niet in elke categorie te winnen om nuttig te zijn; een agent die consistent sterk presteert op het gebied van planning, coderen, het gebruik van tools en visuele controles, is wellicht betrouwbaarder dan een model dat is geoptimaliseerd voor één specifieke test.
Uit de officiële tabel blijkt ook waarom vergelijkende tests belangrijk zijn. GPT-5.6 Sol staat bovenaan in verschillende rijen die betrekking hebben op redeneren of terminalgebruik, terwijl Fable 5 vooral concurrerend blijft bij taken op het gebied van samenwerking, interface en visuele verwerking. Een afzonderlijke Vergelijking tussen GPT-5.6 en Fable 5 kan u helpen om die modelfamilies te vertalen naar dagelijkse gebruikssituaties, voordat u Qwen3.8-Max aan de shortlist toevoegt.
Wat de multimodale resultaten betekenen
Qwen3.8-Max behaalt sterke officiële resultaten op het gebied van multimodaal redeneren, visuele verankering, computergebruik, documentverwerking en ruimtelijk inzicht. De score van 86,1 op OSWorld-Verified is met name relevant voor agenten die via een scherm werken, omdat deze score het uitvoeren van taken binnen desktopomgevingen meet, en niet louter het beschrijven van een afbeelding.
Hoe Qwen3.8-Max zich verhoudt tot andere modellen
Er is geen eenduidig antwoord op de vraag: “Is Qwen3.8-Max beter dan GPT, Claude of Gemini?” Uit de eigen gegevens van Qwen blijkt dat de koplopers per rij verschillen. De geschiktheid van een product hangt ook af van de betrouwbaarheid van de tool, de kwaliteit van de output, de latentie, de regionale beschikbaarheid, de privacyinstellingen en de interface rondom het model.
Qwen3.8-Max is het meest aantrekkelijk als je één model zoekt dat geschikt is voor coderen, documenten, onderzoek, langdurige taken en visuele agents. GPT-5.6 Sol is wellicht nog steeds de betere keuze voor werkbelastingen waarbij zijn sterke redeneervermogen en eindresultaten goed van pas komen in jouw omgeving. Fable 5 verdient nadere aandacht voor samenwerking en taken waarbij de gebruikersinterface een grote rol speelt; de Vergelijking tussen Fable 5 en Opus 4.8 geeft meer achtergrondinformatie over dat deel van de beslissing.
De geplande open gewichten van het model zouden wel eens het grootste structurele voordeel ervan kunnen worden. Tegenwoordig telt alleen de API-prestatie, maar downloadbare gewichten bieden mogelijkheden voor fijnafstemming, eigen infrastructuur, onderzoek en regionale implementatie. De uiteindelijke waarde hangt af van de vrijgegeven licentie, de gewichtsformaten, de ondersteuning voor kwantisering en de hardware die nodig is om het model op een bruikbare snelheid te laten draaien.
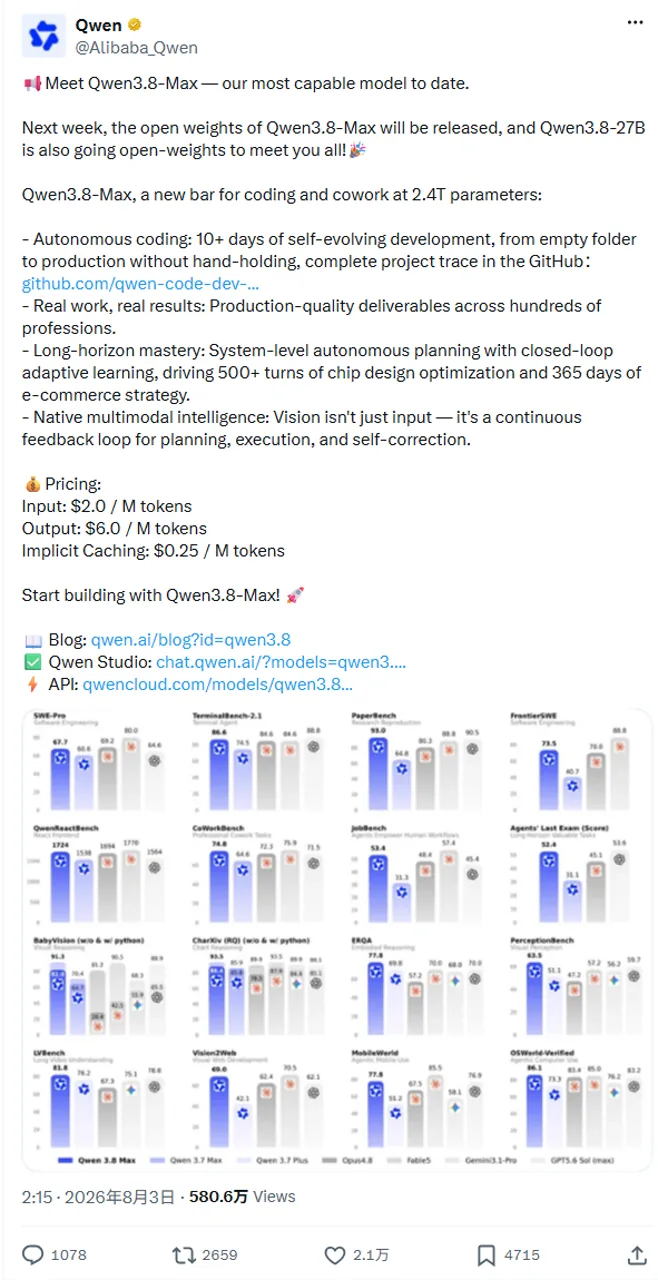
Qwen3.8-Max API-prijzen
Qwen heeft in zijn rapport de volgende introductieprijzen vermeld: officiële mededeling:
Een eenvoudige schatting is:
geschatte kosten = niet-gecachete invoer × $2/M + gecachete invoer × $0,25/M + uitvoer × $6/M
Een run met bijvoorbeeld 10 miljoen niet-gecachete invoertokens en 2 miljoen uitvoertokens zou volgens de tarieven bij de lancering, exclusief eventuele kosten van andere platforms, ongeveer $32 kosten: $20 voor de invoer plus $12 voor de uitvoer. Een agent die bij elke beurt een grote repository opnieuw inleest, kan veel meer uitgeven, waardoor caching en contextbeheer net zo belangrijk zijn als de officiële invoerprijs.
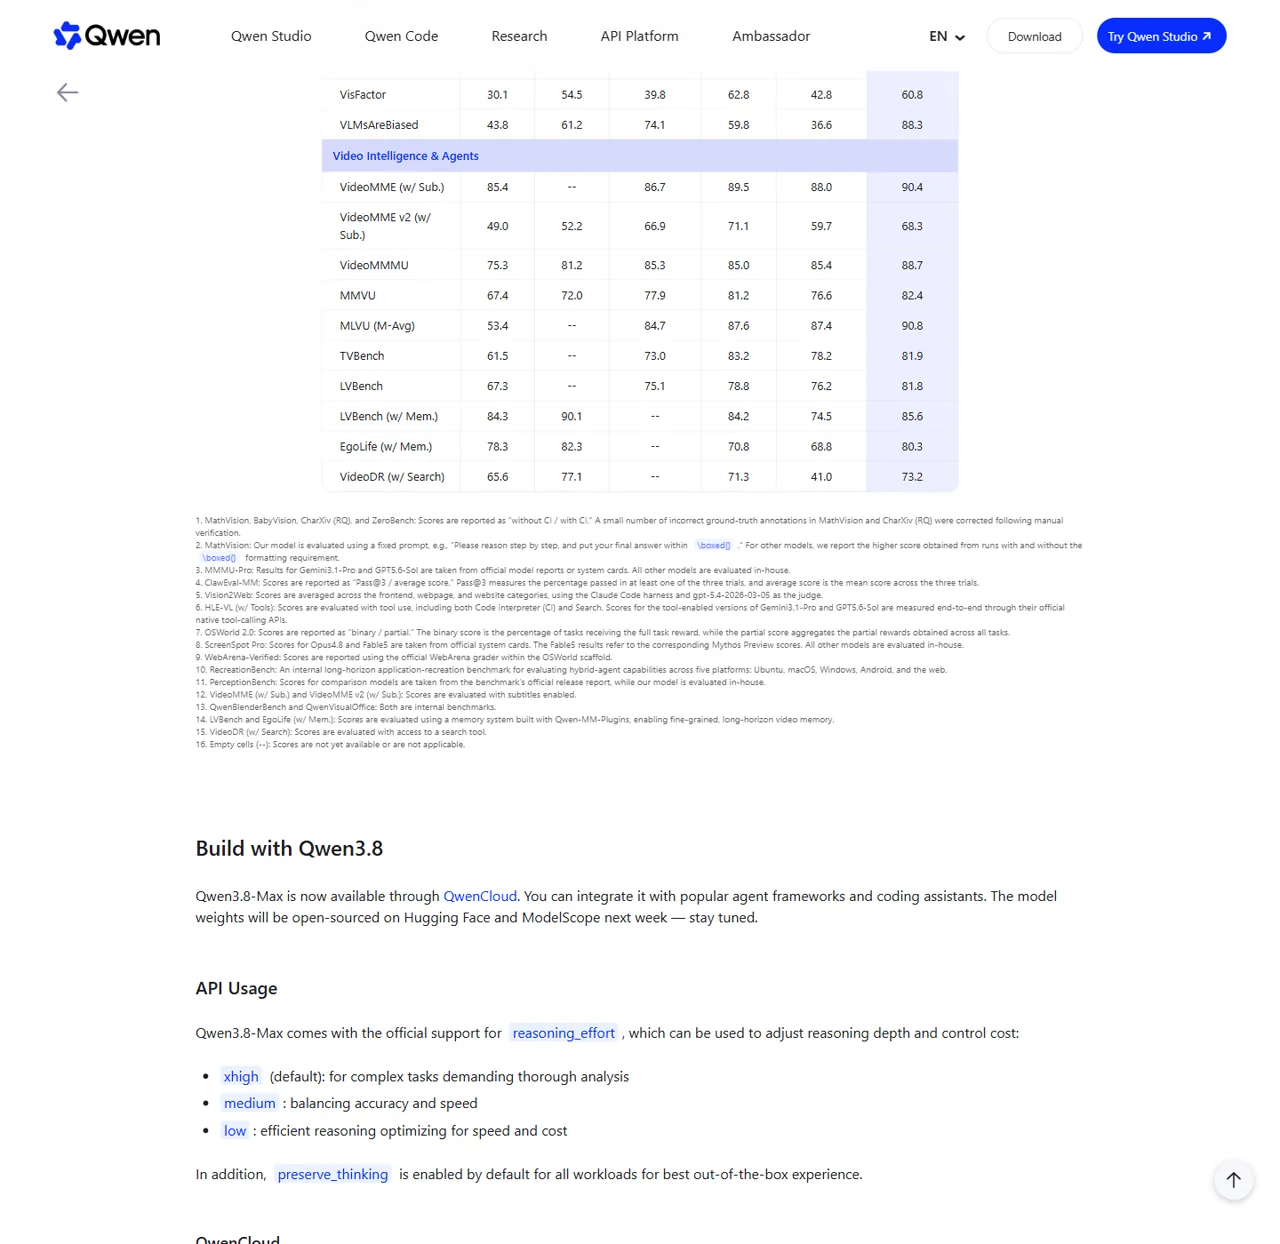
Qwen3.8-Max ondersteunt ook redeneringsinspanning besturingselementen. In het officiële API-gedeelte staan xhoog als standaardinstelling voor complexe analyse, gemiddeld om een evenwicht te vinden tussen nauwkeurigheid en snelheid, en laag voor sneller en efficiënter werken. preserve_thinking is standaard ingeschakeld. Deze instellingen kunnen de kosten verlagen, maar ze moeten worden getoetst aan de kwaliteit van de taken en mogen niet worden beschouwd als onderling uitwisselbare modi.
Bij prijsvergelijkingen tussen verschillende aanbieders is dezelfde voorzichtigheid geboden. Een model met een lager tokentarief kan nog steeds duurder uitvallen als er langere prompts, meer herhalingspogingen of extra tool-aanroepen nodig zijn. De Prijsgids voor de Gemini 3.1 Pro API is een goed voorbeeld van waarom zowel de contextlengte als de gebruiksniveaus van belang zijn, naast het basispercentage.
Toegang tot Qwen3.8-Max
1. Gebruik Qwen Studio voor directe evaluatie
De snelste manier om een eerste blik te werpen is Qwen Studio. Begin met een echte opdracht in plaats van een triviaal vraagstuk: geef een rommelige opdrachtomschrijving, een programmeerprobleem met meerdere bestanden, een reeks documenten of een op afbeeldingen gebaseerde workflow. Controleer of het resultaat nauwkeurig, bewerkbaar en volledig genoeg is om tijd te besparen.
2. Gebruik de QwenCloud API voor applicaties
Qwen3.8-Max is verkrijgbaar via QwenCloud. Op de releasepagina staat vermeld dat de API de in de branche gangbare protocollen voor het aanvullen van chatberichten en reacties ondersteunt, die compatibel zijn met de specificatie van OpenAI, plus een interface die compatibel is met Anthropic. Dat maakt de migratie eenvoudiger, maar je moet toch de modelnamen, parameters, het streaminggedrag, de toolschema’s en de foutafhandeling in de officiële documentatie nog eens doornemen.
3. Koppel het aan programmeer- en agenttools
Op de productpagina van Qwen staan integraties vermeld voor Qwen Code, Claude Code, Codex en OpenClaw. Het model kan daarom in een bestaande terminal- of agent-workflow worden geïntegreerd zonder dat er een nieuwe interface nodig is. Ondersteuning voor integratie neemt de kosten van de bijbehorende tool niet weg, dus vergelijk de factuur voor het model met de afzonderlijke Prijsstructuur van Codex voordat de workflow van een team wordt gestandaardiseerd.
Gebruikers van de Claude-code moeten ook de kosten van het coderingsproduct scheiden van die van de externe model-API. De beschikbare abonnementen en factureringsmethoden worden samengevat in de Prijsgids voor de Claude-code.
Gebruikers van OpenClaw hebben nog een vraag: welk model biedt voor een specifieke agent de beste combinatie van functies, snelheid en prijs? De Vergelijking van het OpenClaw-model biedt een praktisch kader om die keuze te maken, in plaats van automatisch voor het grootste model te kiezen.
4. Zorg ervoor dat de multimodale workflow betrouwbaar blijft
Bij de lancering is QwenCloud de geverifieerde productieroute voor Qwen3.8-Max. Als je ook GPT, Claude, Gemini of Fable-alternatieven vergelijkt, dan is de GlobalGPT-werkruimte voor meerdere modellen kan het wisselen tussen tabbladen voor de ondersteunde modellen verminderen. Gebruik de officiële Qwen-route voor Qwen3.8-Max totdat een specifieke modelpagina voor GlobalGPT is geverifieerd; ga er niet vanuit dat er een nieuwe model-URL bestaat alleen omdat het model is aangekondigd.
Qwen3.8 – Maximale open gewichten
Qwen heeft aangekondigd dat de Qwen3.8-Max-gewichten in de week na de lancering op 3 augustus beschikbaar zouden komen. Hetzelfde officiële X-post Er werd ook gezegd dat Qwen3.8-27B een open-weight-systeem zou worden. Dat is goed nieuws voor lokale implementatie en onderzoek, maar de aankondiging alleen is niet voldoende om een productiecluster te plannen.
Controleer, voordat je hardware downloadt of in de begroting opneemt, de volgende vijf punten op de definitieve modelkaart:
- De exacte licentievoorwaarden en voorwaarden voor commercieel gebruik.
- Officiële URL’s van de Hugging Face- of ModelScope-repositories.
- Beschikbare precisie- en kwantisatieformaten.
- Minimale en aanbevolen vereisten voor CPU, GPU, RAM en opslagruimte.
- Of het vrijgegeven model overeenkomt met het gedrag van de gehoste API en de lengte van de context.
“Open weight” en “open source” zijn niet altijd hetzelfde. ‘Open weight’ geeft aan dat de modelparameters kunnen worden gedownload; de licentie bepaalt wat u mag wijzigen, herdistribueren of commercieel gebruiken. Zolang de repositories en de licentie nog niet live zijn, lopen pagina’s die een Qwen3.8-Max-download, een GGUF-build of precieze lokale hardwarevereisten beloven, te hard van stapel.
De aankondiging van de 27B moet op dezelfde manier worden behandeld. Het zou wel eens de meest realistische keuze voor lokale gebruikers kunnen worden, maar de architectuur, de contextlengte, de geheugenbehoeften en de benchmarkscores moeten afkomstig zijn van de eigen officiële modelkaart – en mogen niet worden overgenomen van het Max-model.
Qwen3.8 – Maximale beperkingen en optimale aanpassing
Beperkingen waarmee rekening moet worden gehouden
- Het meeste bewijs voor de lancering is afkomstig van Qwen. Bij onafhankelijke evaluaties kunnen verschillende vragen, hulpmiddelen of beoordelingsregels worden gebruikt.
- Een uitgebreide context is geen perfect geheugen. Een model kan weliswaar 1 miljoen tokens verwerken, maar toch een detail over het hoofd zien of een vage instructie opvolgen.
- Agenten die veel output genereren, kunnen duur uitvallen. Het aantal $6-fouten per miljoen is van belang wanneer een workflow lange code, rapporten of herhaalde redeneringstrajecten genereert.
- De details over de lokale implementatie zijn pas volledig als de gewichten en de modelkaart zijn aangekomen. Een 2.4T-systeem met alle parameters zal zich niet gedragen als een klein desktopmodel.
- Het gebruik van gereedschap voegt nog een extra kans op fouten toe. De status van de browser, machtigingen, netwerkfouten en slecht gedefinieerde toolschema’s kunnen een model dat verder prima zou werken, onbruikbaar maken.
- Informatie over lanceringen verandert snel. Prijzen, opslagplaatsen, integraties en beschikbaarheid moeten vóór publicatie of aankoop nogmaals worden gecontroleerd.
Voor wie is dit nu een aanrader?
Het komt er simpelweg op neer dat Qwen3.8-Max een grondige test verdient, maar geen overhaaste overstap. Gebruik één veeleisende taak met een duidelijke succesvoorwaarde, houd het totale aantal tokens en herpogingen bij, en vergelijk het uiteindelijke resultaat – niet alleen het eerste antwoord.
Veelgestelde vragen
Wanneer is Qwen 3.8 Max uitgebracht?
Qwen3.8-Max werd op 3 augustus 2026 officieel aangekondigd. Het gehoste model was bij de lancering beschikbaar via Qwen Studio en QwenCloud. Qwen gaf aan dat de open gewichten de week erna zouden worden vrijgegeven, dus de beschikbaarheid van de API en de beschikbaarheid van de downloadbare gewichten moeten als afzonderlijke mijlpalen worden beschouwd.
Is Qwen3.8-Max open source?
Qwen heeft open-source-bestanden aangekondigd voor Qwen3.8-Max, maar de definitieve repository en licentie bepalen wat gebruikers mogen uitvoeren, wijzigen, herdistribueren of commercieel gebruiken. Zolang die bestanden nog niet live en geverifieerd zijn, is de formulering “aankondiging van een open-source-release” nauwkeuriger dan de veronderstelling dat alle open-source-toestemmingen of lokale formaten al beschikbaar zijn.
Hoeveel parameters heeft de Qwen3.8-Max?
Qwen3.8-Max heeft in totaal 2,4 biljoen parameters en activeert 95 miljard parameters per token. Het maakt gebruik van een ‘mixture-of-experts’-architectuur, waardoor het totale aantal parameters en het aantal actieve parameters verschillende onderdelen van het systeem beschrijven. Geen van beide cijfers op zich is een voorspelling van de werkelijke snelheid of de benodigde hardware.
Wat is het contextvenster Qwen3.8-Max?
In de officiële release wordt een contextvenster van 1 miljoen tokens vermeld. Dat is ruim voldoende voor omvangrijke code, documenten, uitvoer van tools en de geschiedenis van agents, maar een maximale context garandeert geen perfecte zoekresultaten. Test het model op de positie, de indeling en de dichtheid van de informatie die in uw daadwerkelijke workflow wordt gebruikt.
Hoeveel kost de Qwen3.8-Max API?
Bij de lancering hanteerde Qwen de volgende tarieven: $2 per miljoen invoertokens, $6 per miljoen uitvoertokens en $0,25 per miljoen impliciet in de cache opgeslagen tokens. Beschouw deze als lanceringsprijzen en controleer ze voordat u uw begroting opstelt. De kosten per agent zijn ook afhankelijk van contexthergebruik, de inspanning voor redenering, het aantal herhalingspogingen en de lengte van de gegenereerde output.
Is de Qwen3.8-Max beter dan de GPT-5.6 Sol of de Fable 5?
Niet bij elke test. Uit de officiële tabel van Qwen blijkt dat Qwen3.8-Max bij sommige benchmarks op het gebied van coderen, zoeken, instructies opvolgen en computergebruik aan kop gaat, terwijl GPT-5.6 Sol of Fable 5 bij andere benchmarks de beste prestaties leveren. Welk model het beste is, hangt af van de taak, de toolomgeving, de latentie, de prijs en de kwaliteit van het eindresultaat.
Kan ik Qwen3.8-Max lokaal uitvoeren?
Qwen heeft aangekondigd dat er in de week na de lancering gewichtsgegevens beschikbaar zullen zijn om te downloaden, maar of dit lokaal haalbaar is, hangt af van de definitieve bestanden, de nauwkeurigheid, ondersteuning voor kwantisering, de licentie en de hardware-richtlijnen. Wacht op de officiële modelkaart voordat je uitgaat van exacte schattingen voor RAM, VRAM of opslagruimte. Kleinere Qwen3.8-varianten zijn wellicht praktischer zodra deze officieel zijn gedocumenteerd.
Wat is Qwen3.8-27B?
In het aankondigingsbericht van Qwen staat dat Qwen3.8-27B ook met open gewichten zal worden uitgebracht. Het artikel over de Max-release bevat onvoldoende details om de specificaties van het Max-model te kunnen hergebruiken voor de 27B-versie. Raadpleeg de specifieke modelkaart voor informatie over de architectuur, het contextvenster, benchmarks, licentie en downloadinstructies.
Kan ik Qwen3.8-Max gebruiken op GlobalGPT?
Op het moment van publicatie was er nog geen specifieke GlobalGPT-route voor Qwen3.8-Max geverifieerd. Gebruik Qwen Studio of QwenCloud voor directe toegang. GlobalGPT blijft nuttig voor het vergelijken van andere beschikbare GPT-, Claude-, Gemini- en Fable-modellen zonder van platform te wisselen.
Eindoordeel
Gebruik Qwen Studio of QwenCloud voor een directe evaluatie van Qwen3.8-Max. Gebruik GlobalGPT om andere geverifieerde modellen te vergelijken, zonder dat dit impliceert dat er al een specifieke Qwen3.8-Max-route bestaat.
Vergelijk de beschikbare modellenQwen 3.8 Max is een van de meest ambitieuze modelintroducties van 2026: in totaal 2,4 biljoen parameters, 95 miljard actieve parameters, een contextvenster van 1 miljoen tokens, sterke officiële resultaten op het gebied van codering en multimodale agents, en een aangekondigd open-weight-traject. De prijzen van de API bij de lancering zijn concurrerend genoeg om het model te testen, vooral omdat caching de kosten van herhaalde contextverwerking vermindert.
De belangrijkste reden om hier aandacht aan te besteden is niet het behalen van één enkele benchmarkoverwinning. Het is juist de poging om programmeren, professionele deliverables, planning op lange termijn, visuele feedback en het gebruik van tools in één model te combineren. Begin met Qwen Studio of een gecontroleerde evaluatie van QwenCloud, meet de kwaliteit van voltooide taken en de totale kosten, en wacht op de officiële wegingsfactoren en licentie voordat u toezeggingen doet over lokale implementatie.
Primaire bronnen gecontroleerd op 4 augustus 2026: Qwen3.8-Max officiële release en officiële lanceringspost van @Alibaba_Qwen.