
Grok 4 API-tarieven: kosten, limieten en hoe u aan de slag kunt gaan

Een app bouwen of een agent budgetteren? Begin met het model dat je daadwerkelijk gaat gebruiken. Het Kennisgeving inzake migratie van 15 mei 2026 stelt dat de oorspronkelijke ID Grok 4 nu zonder al te veel redenering wordt omgezet naar Grok 4.3. Een succesvolle oproep naar een oude ID bewijst niet langer dat het oorspronkelijke model deze ID bediende.

Het API-gebruik wordt apart in rekening gebracht, los van de consumentenabonnementen van Grok. Prijzen voor het Grok-abonnement en de toegang heeft betrekking op de chatabonnementen; die maandelijkse kosten zijn geen token-tegoed voor een directe xAI-integratie.

Wil je een prompt eerst even uitproberen voordat je deze in een app integreert? Probeer Grok 4.6 op GlobalGPT voor een op chat gebaseerde workflow. Gebruik een xAI-API-sleutel voor je eigen integratie en directe facturering via xAI. Dit artikel is gepubliceerd door GlobalGPT; productlinks maken gebruik van verwijzingstracking.
Grok 4 API-prijzen: huidige tarieven en de oude, inmiddels afgeschafte tarieven

In de onderstaande tabel wordt gebruikgemaakt van xAI-catalogusprijzen gecontroleerd op 8 september 2026. Elk bedrag is uitgedrukt in USD per miljoen tokens. Input, ingeslagen input en output zijn afzonderlijke factureringscategorieën, waardoor één samengestelde “prijs per miljoen” de werkelijke kosten van de workload verhult.

USD per 1 miljoen tokens · standaardafhandeling

grok-4.3

Oorspronkelijk Grok 4 doorverwijzingsdoel

Context: 1.000.000 tokens

Prompt < 200K

Invoer
$1.25
In cache opgeslagen invoer
$0.20
Uitvoer / redenering
$2.50

Prompt >= 200K

Invoer
$2.50
In cache opgeslagen invoer
$0.40
Uitvoer / redenering
$5.00

grok-4.6

Huidig vlaggenschip

Context: 500.000 tokens

Prompt < 200K

Invoer
$2.00
In cache opgeslagen invoer
$0.50
Uitvoer / redenering
$6.00

Prompt >= 200K

Invoer
$4.00
In cache opgeslagen invoer
$1.00
Uitvoer / redenering
$12.00

grok-4.5

Eerdere optie van de huidige generatie

Context: 500.000 tokens

Prompt < 200K

Invoer
$2.00
In cache opgeslagen invoer
$0.30
Uitvoer / redenering
$6.00

Prompt >= 200K

Invoer
$4.00
In cache opgeslagen invoer
$0.60
Uitvoer / redenering
$12.00

Zodra de prompt 200.000 tokens bereikt, gelden de tarieven voor lange contexten voor alle tokens in dat verzoek, inclusief de uitvoer.

De overige vermelde Grok 4-familie-ID’s zijn grok-4.20-0309-redenering, grok-4.20-0309-zonder redenering en grok-4.20-multi-agent-0309. Elk heeft een contextvenster van 1 miljoen tokens en dezelfde vermelde tarieven voor korte en lange tokens als Grok 4.3. De overeenkomende eenheidsprijs betekent niet dat het totale tokenverbruik ook overeenkomt, vooral niet bij werkzaamheden met meerdere agenten.

Voor een alternatief dat specifiek op programmeren is gericht, grok-build-0.1 heeft een contextvenster van 256K en invoer-/cache-/uitvoersnelheden bij korte context van $1,00/$0,20/$2,00, die stijgen tot $2,00/$0,40/$4,00 bij de promptdrempel van 200K. Zie voor meer informatie over het gedrag en gebruiksscenario’s onze Grok 4.6 recensie.
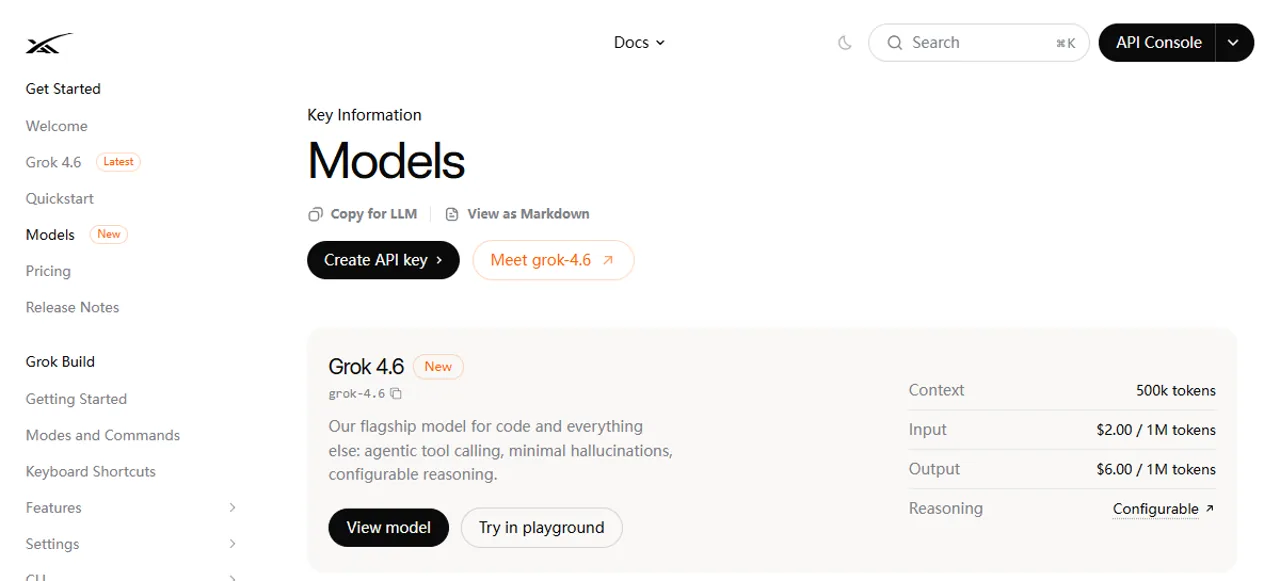
Officiële xAI-documentatie waarin Grok 4.6 wordt vermeld, met de model-ID, een context van 500K en configureerbare redenering.
Officiële xAI-modelcatalogus, vastgelegd op 7 september en opnieuw gecontroleerd op 8 september 2026. De $2/$6-titel is Grok 4,6 voor input/output-prijzen bij korte context; de tarieven voor cache en lange context staan hierboven vermeld.

Wat is er gebeurd met de oorspronkelijke prijs van de $3 / $15?

Oudere bronnen, waaronder onze Grok 4 Handleiding voor API-integratie, prijsopgave $3 per miljoen invoertokens en $15 per miljoen uitvoertokens voor het oorspronkelijke Grok 4. Beschouw dit als een historische prijsopgave, niet als de huidige factuur voor een buiten gebruik gestelde ID. De oude officiële model-URL leidt nu naar de algemene modelcatalogus, dus dit is geen nieuw geverifieerde archiefprijslijst.

De originele Grok 4 aankondiging beschrijft een contextvenster van 256.000 tokens. Die historische capaciteit, en oudere prijzen of drempels van het Fast-model, mogen niet worden overgenomen in een begroting voor de vervanging. De precieze regel voor grok-4-0709 is nu Grok 4.3 met een lage denkinspanning, en wordt gefactureerd tegen de tarieven van Grok 4.3.
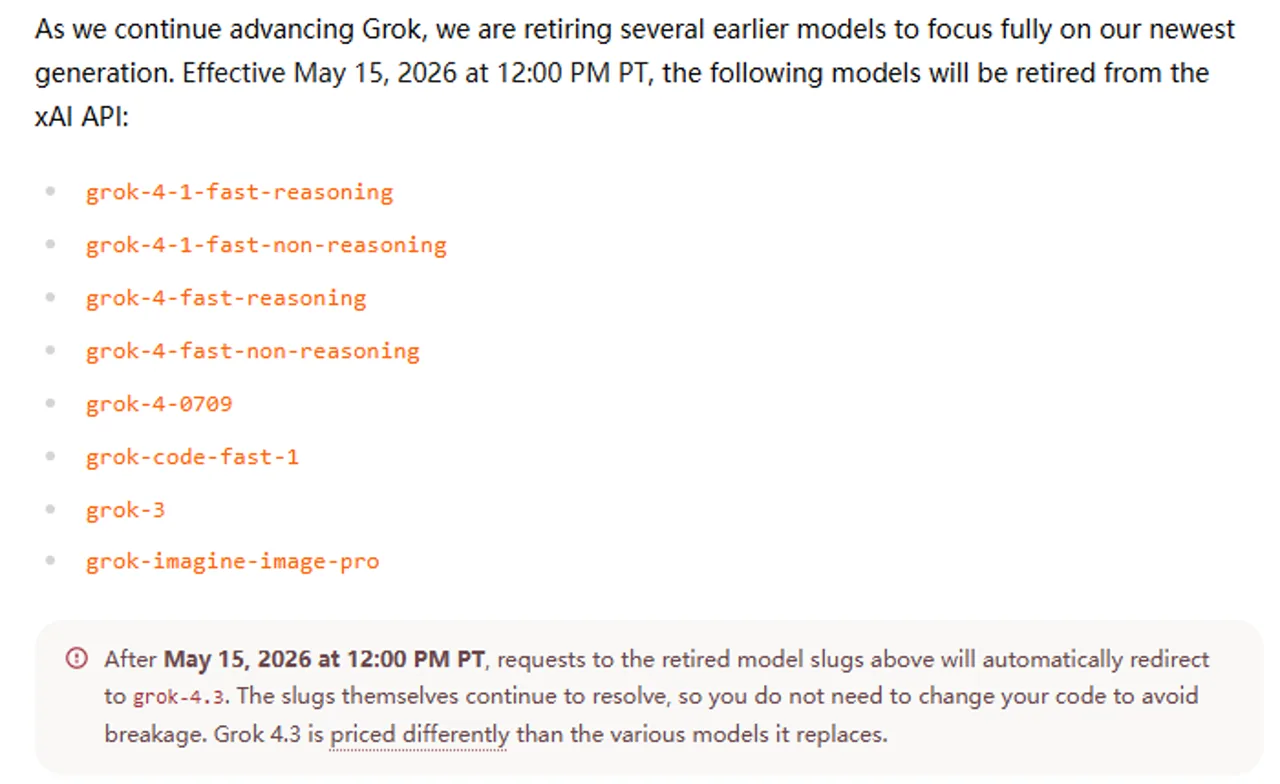
Officiële aankondiging van de stopzetting van grok-4-0709 en de omleiding naar grok-4.3
Kennisgeving inzake de stopzetting van xAI, vastgelegd op 7 september 2026; tekst opnieuw gecontroleerd op 8 september. De vermelde originele Grok 4 ID verwijst door naar Grok 4.3. In de volledige mededeling worden afzonderlijk uitzonderingen voor coderings- en beeldmodellen vermeld.

Grok 4 is een modelgeneratie, terwijl Grok ook de naam is van een consumentenproduct. Onze uitleg over wat Grok 4 is geeft die achtergrondinformatie over het product. Kies bij nieuwe code expliciet een ondersteund model, in plaats van te vertrouwen op een omleiding bij het uit de handel nemen van een model of ervan uit te gaan dat de alias van een provider altijd hetzelfde blijft.

Hoe invoer, in de cache opgeslagen invoer en redeneringen van invloed zijn op de rekening

Eén aanvraag, drie symbolische kosten

Niet-gecacheerde invoer

(I – C) × toevoersnelheid

I = alle prompt-tokens; C = prompt-tokens in de cache.

In cache opgeslagen invoer

C × cachefrequentie

In de cache opgeslagen tokens maken deel uit van de invoer; het is geen extra invoer.

Factureerbare output

O × afgiftehoeveelheid

O houdt rekening met de redenering wanneer het eindpunt deze in de uitvoer vermeldt.

Geschatte waarde van het token in USD = [(I – C) × invoertarief + C × tarief voor in de cache opgeslagen invoer + O × uitvoertarief] / 1.000.000. Tel daar vervolgens de eventuele kosten voor gereedschap, opslag of andere posten bij op. Kies de tarieven voor de lange context aan de hand van het totaalbedrag, inclusief de in de cache opgeslagen tokens, voordat je de berekening uitvoert.

De invoer omvat de berichten, instructies en de gespreksgeschiedenis die naar het model zijn verzonden. Bij caching wordt voor alle verzoeken hetzelfde beginprefix hergebruikt; dit gebeurt automatisch, en xAI raadt aan een gespreks-ID te gebruiken om het hergebruik te verbeteren. Een prompt die er op het eerste gezicht hetzelfde uitziet, garandeert nog niet dat er een cachehit plaatsvindt. De documentatie over het cachen van prompts legt het matchinggedrag uit.

Lees in ‘Chataanvullingen’ prompt_tokens_details.cached_tokens; in ‘Reacties’ staat input_tokens_details.cached_tokens. De Overzicht van cachegebruik en tarieven facturen voor redeneringstokens tegen het volledige voltooiingstarief. Als het totale outputbedrag al redeneringstokens bevat, wordt het toevoegen van redeneringstokens dan zou het opnieuw dubbel worden geteld.

Grok 4.6 ondersteunt een lage, gemiddelde, hoge en zeer hoge redeneerinspanning; de gedocumenteerde standaardinstelling is ‘hoog’ en het redeneren kan niet worden uitgeschakeld. Grok 4.3 ondersteunt ‘geen’, ‘laag’, ‘gemiddeld’ en ‘hoog’. Dat maakt Grok 4.3 met de instelling ‘none’ het overwegen waard voor strikte extractietaken, terwijl Grok 4.6 mogelijk meer tokens verbruikt, zelfs wanneer het zichtbare antwoord kort is. Zie de instellingen voor redenering en de bovenstaande modelvermelding van Grok 4.3.

Oproepen via de tool, batchverwerking en prioriteitsverzoeken

Volgens de officiële prijstabel voor gereedschap, Web Search, X Search en Code Execution kosten elk $5 per 1.000 aanroepen, ofwel $0,005 per aanroep, plus het verbruik van tokens. Een verzoek kan meerdere keren gebruikmaken van tools. Tien zoekaanroepen voegen $0,05 toe vóór de modeltokens; het inschakelen van een tool geeft geen indicatie van het aantal keren dat deze zal worden gebruikt.

Het doorzoeken van bijlagen kost $10 per 1.000 zoekopdrachten; het doorzoeken van collecties kost $2,50 per 1.000. Voor opgeslagen bestanden en collecties gelden bovendien dagelijkse opslag- en downloadkosten. Voor afbeeldingen en video's gelden aparte prijseenheden, dus houd deze buiten een schatting op basis van tekst-token. Onze Handleiding voor de beeld- en videoworkflow van de Grok omvat die afzonderlijke opwekkingsroute.

De Batch-API biedt een korting van 20% tokens voor Grok 4.3 en de drie genoemde Grok 4.20-varianten. De korting geldt voor input-, cached input-, output- en reasoning-tokens. Op de modelpagina van Grok 4.6 staat aangegeven dat de Batch API niet wordt ondersteund. Pas geen algemene korting van 50% toe en ga er niet vanuit dat elk vermeld model batchverwerking ondersteunt.

Prioriteit verwerking kost 2x de standaardtarieven voor tokens, inclusief cache- en redeneringstokens, wanneer de geretourneerde serviceniveau bevestigt prioriteit. Bij terugval naar het standaardtarief gelden de standaardtarieven. De prioriteit geldt voor ‘Chat Completions’ en ‘Responses’, niet voor de Batch API.

Drie voorbeelden van transparante API-kosten

Dit zijn schattingen van de catalogusprijzen, geen daadwerkelijke factuurbedragen. Voor alle onderstaande verzoeken geldt de standaardverwerking: alleen tekst, geen tools, geen opslag, geen herhalingspogingen en geen belastingen. Onder “output” valt elke factureerbare redenering. Bij de eerste twee workloads wordt uitgegaan van prompts van minder dan 200.000 tokens.

Kosten per verzoek en per 10.000 verzoeken

Grok 4.3 · geen cache

$0.005 / aanvraag

2.000 invoer × $1.25 + 1.000 uitvoer × $2.50, gedeeld door 1M. 10.000 verzoeken = $50.

Grok 4,6 · geen cache

$0.010 / aanvraag

2.000 ingangen × $2 + 1.000 uitgangen × $6, gedeeld door 1 miljoen. 10.000 verzoeken = $100.

Grok 4,6 · 90% invoer in cache opgeslagen

$0.0073 / aanvraag

200 niet-gecachet × $2 + 1.800 gecachet × $0,50 + 1.000 output × $6, gedeeld door 1M. 10.000 verzoeken = $73.

Een hoog cache-hitpercentage levert het meeste voordeel op wanneer de input het grootste deel van de werklast uitmaakt. In dat voorbeeld van Grok 4,6 bespaart caching $0,0027 per aanroep, ofwel 27% van het totaal, ook al wordt 90% aan invoertokens in de cache opgeslagen. De uitvoerkosten blijven op $0,006 staan. Beoordeel de besparingen ten opzichte van het volledige verzoek, niet alleen het in de cache opgeslagen gedeelte.

De drempelwaarde van 200K kan het hele verzoek beïnvloeden

Er is weer een inputtoken dat de prijsdrempel overschrijdt

199.999 prompt-tokens

$0.459998

Grok 4.6: (199.999 × $2 + 10.000 output × $6) / 1M. Geen cache.

200.000 prompt-tokens

$0.920000

Grok 4.6: (200.000 × $4 + 10.000 output × $12) / 1M. Geen cache.

Het belangrijkste In de prijstabel wordt expliciet gesproken over “Lange context >= 200.000 tokens” en vermeldt dat voor alle tokens het hogere tarief geldt zodra de prompt de drempel bereikt. In een toelichting bij het model staat “overschrijdt” 200K. Als je precies 200.000 wilt begroten, gebruik dan de expliciete grens uit de prijstabel; ga er niet vanuit dat het goedkopere tarief nog steeds geldt.

Voor een maandelijkse prognose moet u het verwachte aantal verzoeken afzonderlijk inschatten voor elke workload, contextband, cache-hitpatroon en redeneringsinstelling. Tel daar het verwachte aantal herpogingen en het aantal keer dat de tool wordt aangeroepen bij op. Vergelijk die schatting vervolgens met uw eigen kostengegevens na een kleinschalige pilot. Een cijfer in cent per oproep is alleen bruikbaar als de aannames ervan overeenkomen met de productiesituatie.

Context, output, snelheidslimieten en bestedingslimieten zijn verschillende zaken

Vier beperkingen die je moet controleren voordat je gaat opschalen

Contextvenster

Op verzoek

Grok 4.3: 1 miljoen tokens. Grok 4.6: 500.000. Dit is geen maandelijkse toelage.

Uitgavenbegroting

Per reactie

Stel een ondersteunde uitgangscapaciteit in. De contextcapaciteit garandeert niet dat er daadwerkelijk zoveel zichtbare output wordt geproduceerd.

RPS / TPM

Doorvoer

Verzoeken per seconde en tokens per minuut. Beide moeten binnen de team-tier blijven.

Uitgavenbeheersing

Geld

Het prepaidtegoed, automatisch bijladen en factureringslimieten bepalen elk afzonderlijk het opwaardeergedrag.

Het publiek tabel met verwerkingslimieten Voor Grok 4.3 wordt Tier 0 vermeld met 37 verzoeken per seconde en 10 miljoen tokens per minuut; voor Grok 4.6 wordt vermeld: 150 verzoeken per seconde en 50 miljoen tokens per minuut. Dit zijn gepubliceerde tier-gegevens van enige tijd geleden; het is geen garantie dat elke sleutel dezelfde bruikbare capaciteit heeft. De Console van uw team is de bron voor de huidige toegang en limieten van uw model.

De niveaus zijn gebaseerd op de cumulatieve API-uitgaven sinds 1 januari 2026: $0, $50, $250, $1.000 en $5.000 voor niveaus 0 tot en met 4. Verzoeken worden per seconde begrensd aan de hand van het verzoekbudget per minuut gedeeld door 60, zodat u de toewijzing voor een volledige minuut niet in één keer kunt opgebruiken. Input-, output-, reasoning- en cache-tokens tellen allemaal mee voor de TPM, zelfs als sommige minder kosten.

Op de gecontroleerde modelpagina's van de Grok 4.3 en 4.6 worden de afmetingen van de behuizing vermeld, zonder dat er een afzonderlijk maximumvermogen wordt aangegeven. De huidige Referentie voor het ‘Responses’-eindpunt definieert max_uitvoer_tokens als het gecombineerde budget voor uitvoer en redenering: de standaardwaarde is 128.000 wanneer deze niet is ingesteld, en er kan een hogere waarde worden opgegeven voor langere generaties. Deze standaardwaarde garandeert geen 128.000 zichtbare antwoordtokens of een onbeperkte contextlimiet. Stel een expliciet budget in en controleer onvolledige antwoorden.

Documentatie over de facturering van xAI maakt een onderscheid tussen prepaidtegoed en maandelijkse facturering, die standaard is uitgeschakeld. Met automatische herlaadfunctie kan prepaidtegoed worden aangevuld; deze functie heeft zijn eigen drempels en maandelijkse limiet. Een factureringslimiet regelt het postpaidgebruik; dit is niet hetzelfde als één allesomvattende limiet voor prepaidaankopen, herlaadbeurten en verzoeken.

Begin bij je eerste integratie met een beperkt prepaidtegoed en bekijk eventuele instellingen voor automatisch bijladen zorgvuldig. Voor dagelijkse toegang tot de chat zonder een integratie te hoeven schrijven, kun je gebruikmaken van de aparte Handleiding voor het gebruik van de Grok heeft betrekking op de productworkflow. Een chatabonnement en een API-team hebben verschillende instellingen.

Twee echte Grok 4.6-taken: wat de gebruiksgegevens onthullen

We hebben twee voltooide tests van 7 september 2026 hergebruikt via de Broly-aggregatie-API op https://anywhere.broly.ai/v1, met behulp van ‘Chat Completions’. Zowel de aangevraagde als de geretourneerde grok-4.6; de identiteit van het upstream-model is niet onafhankelijk geverifieerd. Dit zijn resultaten van de Grok 4.6-gateway, geen originele Grok 4-tests of een vergelijking tussen verschillende modellen.

Elke taak werd één keer uitgevoerd met temperatuur=0, max_tokens=2048 en stream=false. Er werden geen hulpmiddelen of expliciete redeneeropdrachten meegestuurd. Voor beide verzoeken werd dezelfde systeeminstructie gebruikt:


Instructie voor het gedeelde systeem

Uitgavenoverzicht

De taak heeft vijf synthetische onkostennota's omgezet in gestructureerde JSON-gegevens met centbedragen als gehele getallen, inclusief een negatieve terugbetaling. Het antwoord bevatte alle gevraagde velden en leverde het juiste nettototaal van $209,00 op.

Exacte opdracht: Uitgaven extraheren

Volledige teruggestuurde uitvoer: extractie van uitgaven

{
  "valuta": "USD",
  "items": [
    {
 "label": "trein",
 "bedrag_cents": 4680
    },
    {
 "label": "hotel",
 "amount_cents": 12800
    },
    {
      "label": "diner",
 "amount_cents": 2745
    },
    {
 "label": "terugbetaling",
 "amount_cents": -1250
    },
    {
 "label": "taxi",
 "amount_cents": 1925
    }
  ],
  "net_total_cents": 20900
}

Gerapporteerd gebruik · Uitgavenoverzicht

Invoer / in de cache opgeslagen

364 / 192

In de cache opgeslagen tokens worden meegeteld in het aantal invoergegevens.

Voltooiing / redenering

991 / 857

De motivering wordt vermeld in de details van de afhandeling.

kloktijd

22,753 seconden

Inclusief netwerk- en gateway-overhead; één keer uitgevoerd.

Planning onder beperkingen

De opdracht betrof het selecteren van ondeelbare taken binnen een tijdsbudget van acht uur, waarbij aan bepaalde voorwaarden moest worden voldaan. Het antwoord koos voor A, B, C en E, wat neerkomt op in totaal acht uur en een waarde van 24. We hebben alle 64 deelverzamelingen afzonderlijk opgesomd: 17 daarvan waren haalbaar, en dit was de enige optimale verzameling.

Exacte opdracht: Planning met beperkingen

Volledige uitvoer: Planning met beperkingen

{
  "selected": ["A", "B", "C", "E"],
  "order": ["A", "B", "C", "E"],
  "total_hours": 8,
  "total_value": 24
}

Gerapporteerd gebruik · Beperkte planning

Invoer / in de cache opgeslagen

428 / 192

In de cache opgeslagen tokens worden meegeteld in het aantal invoergegevens.

Voltooiing / redenering

4267 / 4217

De motivering wordt vermeld in de details van de afhandeling.

kloktijd

61,980 seconden

Inclusief netwerk- en gateway-overhead; één keer uitgevoerd.

Het antwoord met betrekking tot de planning is korter dan de JSON-gegevens over de kosten, maar het gerapporteerde totale aantal tokens bedraagt 4.267, waaronder 4.217 redeneringstokens. Dat is de les op het gebied van budgettering: de zichtbare lengte van het antwoord is een slechte maatstaf voor het verbruik van het redeneringsmodel. Deze twee taken zijn nuttige voorbeelden van gebruikspatronen, geen benchmark voor latentie of een algemene kwaliteitsranglijst.

Fragment uit het gebruik van Gateway: planning onder beperkingen

{
  "prompt_tokens": 428,
  "completion_tokens": 4267,
  "total_tokens": 4695,
  "prompt_tokens_details": {
    "cached_tokens": 192
  },
  "completion_tokens_details": {
    "reasoning_tokens": 4217
  }
}

De gateway retourneerde ook een waarde van nul input_tokens en output_tokens velden, ondanks dat de tellers voor ‘Chat Completions’ niet nul waren. Voor deze records hebben we gebruikgemaakt van prompt_tokens en voltooiingstokens. We hebben de aliases met waarde nul niet als een gratis verzoek behandeld en hebben ook geen aantallen zichtbare tokens afgeleid uit andere velden met waarde nul.

Officiële tarieven toepassen zonder het een factuur te noemen

Als deze gateway-aantallen zouden worden gefactureerd op basis van de huidige xAI-lijstprijzen voor korte contexten van Grok 4.6, zou de extractietaak [(364 – 192) × $2 + 192 × $0,50 + 991 × $6] / 1M = $0,006386. De planning zou als volgt zijn: [(428 – 192) × $2 + 192 × $0,50 + 4.267 × $6] / 1M = $0,026170. Dit zijn hypothetische schattingen van de xAI-tarieven, geen tarieven die bij Broly zijn waargenomen.

In het antwoord op de planning werden 4.267 voltooiingstokens gemeld, hoewel het verzonden verzoek max_tokens=2048. De limietregels van de gateway zijn niet geverifieerd. Uit deze discrepantie blijkt niet hoe de eigen outputlimiet van xAI werkt, en de gevraagde limiet kan niet worden beschouwd als een bewezen uitgavenplafond voor deze gateway.

Directe xAI-reacties bevatten een bruikbaarder factureringssignaal: kosten_in_usd_ticks. In de officiële documentatie wordt één USD gedefinieerd als 10.000.000.000 ticks en staat vermeld dat het veld de tokijkosten, kortingen en server-side toolaanroepen van dat verzoek omvat. De hergebruikte gateway-antwoorden bevatten dat veld niet. Voor een conversatie moet je de tick-waarden per verzoek bij elkaar optellen, in plaats van ervan uit te gaan dat elk antwoord een sessietotaal bevat.

Wat onafhankelijke API-gebruikers opviel

Op 21 augustus 2026 heeft een gebruiker van Hacker News mediaman wezen erop dat de Grok 4.6-waarde van $0,50 per miljoen voor de cache-inputfrequentie 25% bedraagt ten opzichte van de $2-waarde voor de niet-gecachete inputfrequentie. Hun zorg betrof herhaalde cache-lezingen bij agentisch werk. De twee Grok-percentages komen overeen met de huidige officiële tabel; de bredere vergelijkingen en speculaties van de commentator zijn persoonlijke beoordelingen.

mediaman op Hacker News over de prijsstelling van de Grok API-cache
mediaman over de prijzen van de Grok 4.6-cache, 21 augustus 2026. Persoonlijke kostenraming; vergelijkingen en speculaties zijn van de commentator. Opgeslagen op 8 september 2026.

Eerder, op 9 november 2025, XCSme beschreven met behulp van Grok 4 Fast via de API voor het parseren en extraheren van gegevens, waarbij het als goedkoop en snel wordt omschreven. Dat is een historisch verslag over een inmiddels uit productie genomen Fast-model. Het geeft geen informatie over de huidige prijs, snelheid of kwaliteit van de Grok 4.3 of Grok 4.6.

XCSme op Hacker News over het extraheren van gegevens uit de Grok-API
XCSme over het gebruik van de Grok 4 Fast voor extractie, 9 november 2025. Eerdere persoonlijke ervaringen met een inmiddels uit productie genomen model. Vastgelegd op 8 september 2026.

Deze twee individuele ervaringen geven aanleiding tot nuttige verkennende vragen: in hoeverre is je code te danken aan opgeslagen context, en in hoeverre aan redeneringen en herhalingspogingen? Ze leiden niet tot een consensus onder ontwikkelaars. Als je ook het resulterende werk vergelijkt, dan is onze Vergelijking van Grok en ChatGPT: werk, zoeken en codering gaat in op dat afzonderlijke besluit.

Aan de slag met de officiële xAI-API

De officiële xAI-snelstartgids maakt gebruik van de Responses API op https://api.x.ai/v1/responses. Dit is een ander eindpunt en een andere account dan het aggregatieplatform dat we bij onze tests op 7 september hebben gebruikt.

  1. Maak een xAI Console-account aan of log in op uw account en selecteer het juiste team.
  2. Voeg API-tegoed toe en bekijk de uitgaveninstellingen. Controleer of het geselecteerde model beschikbaar is voor uw team.
  3. Maak een API-sleutel aan en geef deze door aan je serverproces als XAI_API_KEY. Zorg ervoor dat deze niet in de browsercode, in de versiebeheer-systeem, in schermafbeeldingen of in logbestanden terechtkomt.
  4. Dien een klein verzoek in met een expliciete actuele model-ID en noteer vervolgens het geretourneerde model, het gebruik, het serviceniveau en de verzoek-ID.

In het onderstaande voorbeeld wordt gebruikgemaakt van Node.js 18 of hoger en de ingebouwde fetch-functie, dus er hoeft geen SDK te worden geïnstalleerd. Stel XAI_API_KEY in je procesomgeving in voordat je het programma uitvoert. Het maakt gebruik van de huidige officiële ‘Responses’-verzoekvorm en een lage redeneerinspanning; de code is lokaal getest zonder dat er nog een betaald API-verzoek is verzonden.

Eerste officiële verzoek · Node.js

Controleer of de status ‘voltooid’ is en bekijk het gebruiksobject voordat je opschaalt. In dit voorbeeld worden 2.048 output- en reasoning-tokens toegewezen via het officiële veld ‘Responses’. Een time-out is een deadline aan de clientzijde; dit is geen bewijs dat het werk aan de serverzijde is geannuleerd of niet in rekening is gebracht. Het voorbeeld voert niet automatisch een nieuwe poging uit; de tokenlimiet is geen allesomvattende limiet in dollars voor een toepassing die ook invoer verstuurt of tools aanroept.

Voor een SDK die compatibel is met OpenAI is de basis-URL https://api.x.ai/v1 en de inloggegevens zijn nog steeds jouw xAI API-sleutel. De Responses API maakt gebruik van invoer en redenering: { inspanning: "laag" }; ‘Chat Completions’ maakt gebruik van berichten en zijn eigen parameternamen. Het ongewijzigd kopiëren van een gateway-verzoek naar een ander eindpunt kan mislukken, zelfs als beide JSON accepteren.

Veelvoorkomende integratiefouten en kostenbeheersing

  • 401 Niet toegestaan: controleer de Bearer-header, de sleutel en de uitvoeringsomgeving. Een 403-fout kan wijzen op teamrechten of toegangsbeperkingen. Het herhalen van hetzelfde ongeldige verzoek lost het probleem niet op.
  • 404 Niet gevonden: controleer het exacte eindpunt en de model-ID. Maak onderscheid tussen een ongeldige ID en een gedocumenteerde, buiten gebruik gestelde ID die nog steeds via een omleiding bereikbaar is.
  • 400 of 422: controleer het verzoekschema en de ondersteunde instellingen. In de huidige documentatie over redenering worden bijvoorbeeld straffen voor aanwezigheid/frequentie en stopinstellingen voor redeneringsmodellen afgewezen.
  • 429 Te veel verzoeken: zet het werk in de wachtrij, vlak pieken af en gebruik een begrensde exponentiële back-off met jitter. Houd zowel de RPS als de TPM bij en neem herhalingspogingen mee in het werkbelastingbudget.
  • Onverwachte uitvoer of onvolledige status: controleer het antwoord, de instelling voor de redenering en de geldende uitvoerlimiet. Controleer of de machinaal leesbare uitvoer geldig is voordat u deze gebruikt; een succesvol HTTP-antwoord is geen garantie voor de kwaliteit van de taak.

Kies, om de kosten te beheersen, het goedkoopste model en de goedkoopste redeneringsinstelling die aan jouw eigen taaktests voldoen, hanteer in het begin stabiele instructies om de cache te hergebruiken, verwijder irrelevante geschiedenis, houd de limiet van 200K prompts in de gaten en beperk de lussen van de agent-tools. Gebruik batchverwerking alleen als het model dit ondersteunt en het werk kan wachten. Beschouw prioriteit als een afzonderlijke aankoopkeuze.

Bewaar schattingen van tokens voor de planning en teruggestuurde kostenticks voor afstemming. Sla gehele getallen op bij het samenvoegen van veel verzoeken, en vergelijk de totalen van de verzoeken met het gebruik in de Console en de facturen. Een ontbrekend kostenveld betekent “onbekend”, niet nul; een klein zichtbaar antwoord betekent niet automatisch dat de rekening ook laag is.

Voor de huidige tarieven van Grok 4 API: stel je budget op basis van het model dat daadwerkelijk aan de aanvraag voldoet, de prijsklasse van de prompt en de totale factureerbare output. Begin met een kleine officiële aanvraag, bekijk het verbruik en de kosten, en schaal vervolgens de workload op die aan je eigen criteria voldoet. Voor het verkennen van prompts in een chatwerkruimte, open Grok 4,6 op GlobalGPT.

Grok 4 Veelgestelde vragen over API-prijzen

Hoeveel kost de Grok 4 API momenteel?

Vanaf 8 september 2026 wordt de buiten gebruik gestelde ID grok-4-0709 doorgestuurd naar Grok 4.3. Bij minder dan 200.000 prompt-tokens zijn de tarieven in USD per miljoen: $1,25 voor invoer, $0,20 voor ingegeven invoer en $2,50 voor uitvoer. Bij een lange context worden de tarieven verdubbeld.

Is de originele Grok 4 API nog verkrijgbaar?

Het oorspronkelijke model grok-4-0709 is op 15 mei 2026 uit de xAI-API verwijderd. De ID ervan blijft geldig, maar verzoeken worden afgehandeld door Grok 4.3 met een lage redeneerinspanning en worden gefactureerd tegen de vervangende tarieven.

Hoeveel kost de Grok 4.6 API?

Grok 4.6 kost $2 aan invoer, $0,50 aan ingegeven tekst in de cache en $6 aan uitvoer per miljoen tokens onder de 200K prompttokens. Bij 200K of meer bedragen de tarieven $4, $1 en $12. Tool-aanroepen en andere van toepassing zijnde kosten worden apart in rekening gebracht.

Moet je betalen voor redeneringstokens?

Ja. xAI brengt redeneertokens in rekening op basis van het voltooiingspercentage. Als het redeneren al is meegerekend in de gerapporteerde output of het totaal aantal voltooiingen, voeg dit dan niet nogmaals toe aan uw schatting.

Telt in de cache opgeslagen invoer mee voor de drempel van 200.000?

Ja. Tel de volledige prompt mee, inclusief de in de cache opgeslagen tokens. Volgens de officiële prijstabel valt een prompt van 200.000 tokens of meer onder de categorie ‘lange context’, en gelden de hogere tarieven voor alle tokens in dat verzoek.

Is er een gratis Grok API-quotum inbegrepen bij een chatabonnement?

Ga er niet vanuit dat een chatabonnement xAI API-tegoed omvat. De officiële API-snelstart maakt gebruik van een apart Console-account en -tegoed. Elke promotie moet worden geverifieerd door dat API-team; gratis toegang voor consumenten is een andere aanbieding.

Wat zijn de API-limieten voor Grok?

De limieten zijn afhankelijk van het model en het teamniveau. In de tabel voor niveau 0 staan Grok 4.3 met 37 RPS en 10M TPM, en Grok 4.6 met 150 RPS en 50M TPM vermeld. Gebruik de console van je team om de limieten te controleren die voor jouw sleutel gelden.

Kan ik Grok 4.6 gebruiken op GlobalGPT?

Ja. GlobalGPT heeft een geverifieerde Grok 4.6-chat-invoer. Dat is een afzonderlijke platformworkflow; deze vervangt geen xAI-API-sleutel, directe API-facturering of de instellingen in je xAI-console.

Hoe kan ik de werkelijke kosten van een xAI-verzoek controleren?

Lees de waarde van `usage.cost_in_usd_ticks` uit het officiële antwoord en deel deze door 10.000.000.000 om de waarde in USD te berekenen. Dit veld omvat dat verzoek, inclusief tokenkortingen en server-side tools. Tel de verzoeken bij elkaar op om een conversatie bij te houden.

Deel de post:

Verwante berichten