De GPT-6 Astra en de Claude Fable 5.1 hebben dezelfde basisprijzen voor de API, maar presteerden niet hetzelfde in onze vergelijkende compatibiliteitstests voor de API. Astra leverde meer bruikbare, zichtbare resultaten op op het gebied van redeneren, schrijven, programmeren, het ophalen van informatie uit een lange context en strategie. Fable behaalde een gelijke score in de nauwkeurigheidstest voor lange contexten en schreef geloofwaardige lanceringsteksten, maar verschillende doorlopen werden in dit specifieke traject afgebroken of leverden geen resultaten op.

Kort oordeel
GPT-6 Astra · 43/50
Zoeken in een lange context · elk 10/10
Compatibiliteitsroutering zou een verklaring kunnen zijn voor de lege uitvoer van Fable.
Kies voor GPT-6 Astra als je een betrouwbaar eerste antwoord nodig hebt bij gemengde analytische en technische taken. Kies Claude Fable 5.1 wanneer uw eigen eindpunt is gevalideerd voor de verwerking van zichtbare output en u waarde hecht aan de interpretatie van lange contexten of de weloverwogen proza-stijl. Dit is geen universele modelranglijst: het betreft één gecontroleerde run via Broly Anywhere op 8 september 2026.
GPT-6 Astra vs Claude Fable 5.1 in één oogopslag
| Veld | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| API-ID | gpt-6-astra | claude-fabel-5-1 |
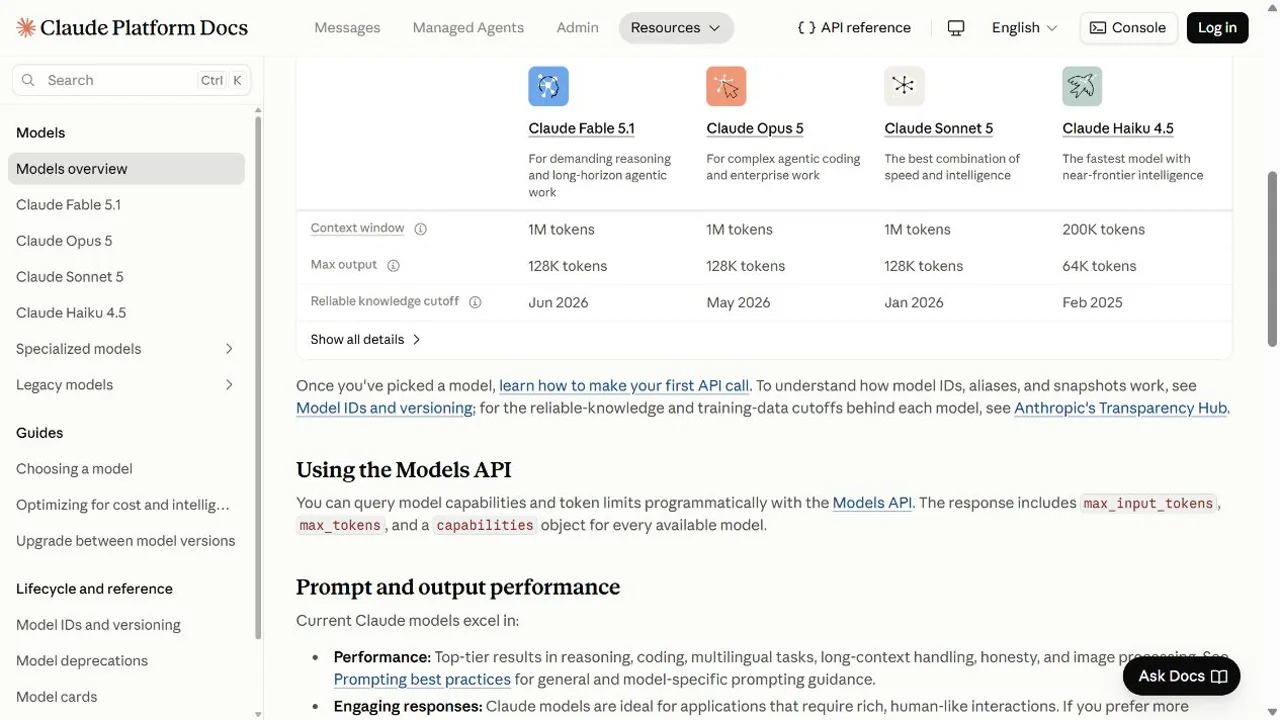
| Context | 1.05M tokens | 1 miljoen tokens |
| Maximaal vermogen | 128K lopers | 128K lopers |
| Basisgegevens | $10 / 1M | $10 / 1M |
| In de cache opgeslagen invoer / treffer | $1 / 1M | $0,25 / 1M |
| Uitgang | $50 / 1M | $50 / 1M |
| Batch | 50% volgens de norm | $5-ingang / $25-uitgang per 1M |
| Redenering | Configureerbare redeneerinspanning | Adaptief denken, altijd actief; hoge standaardinstelling |
| Gemeten testscore | 43/50 | 19/50 |
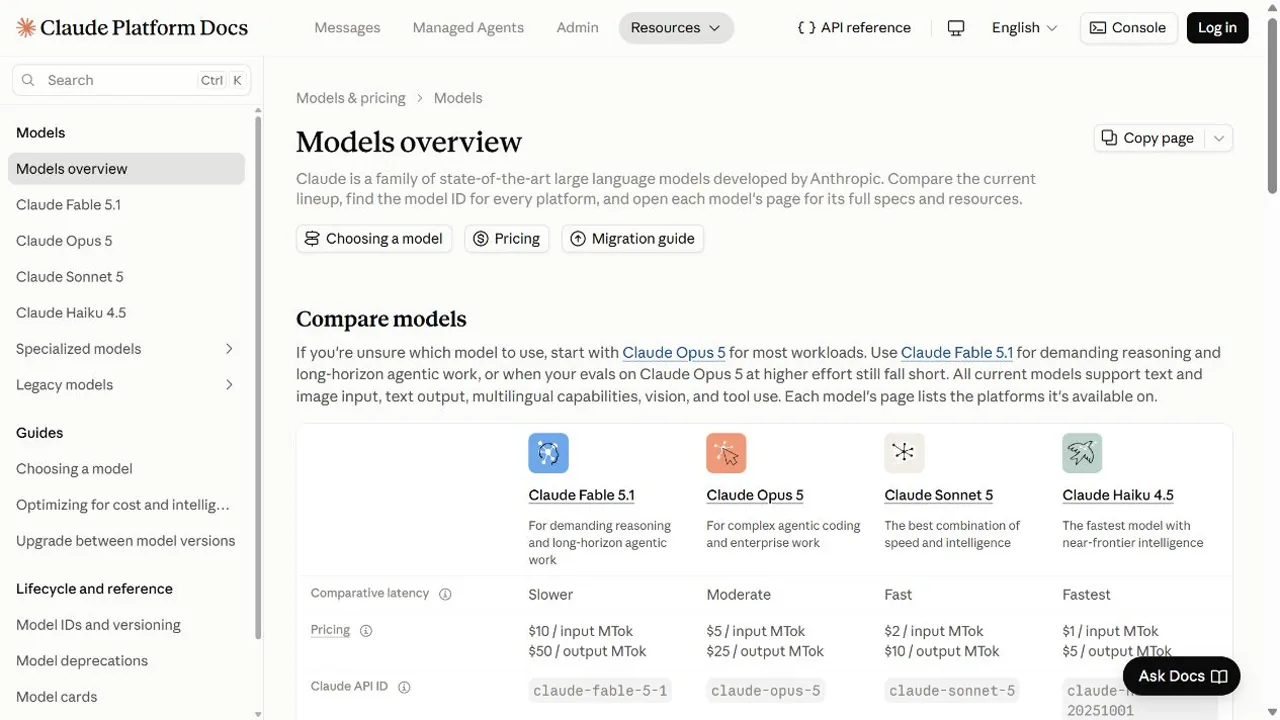
Voor meer achtergrondinformatie over het model, zie onze Recensie van de GPT-6 Astra, Claude Fable 5.1-handleiding, en Vergelijking van het Claude-model.
Prijzen, caching, context en beperkingen
Beide modellen vermelden $10 per miljoen invoertokens en $50 per miljoen uitvoertokens. Het verschil in werking zit hem in de caching. GPT-6 Astra vermeldt $1 per miljoen in de cache opgeslagen invoertokens en een cache-schrijfsnelheid van $12,50. Fable 5.1 vermeldt $0,25 cache-hits, $12,50 schrijfbewerkingen per vijf minuten en $20 schrijfbewerkingen per uur per miljoen tokens. Volgens Anthropic blijft de volledige context van 1 miljoen tegen standaardtarieven; Astra hanteert hogere prijzen zodra de invoer de 272.000 tokens overschrijdt.
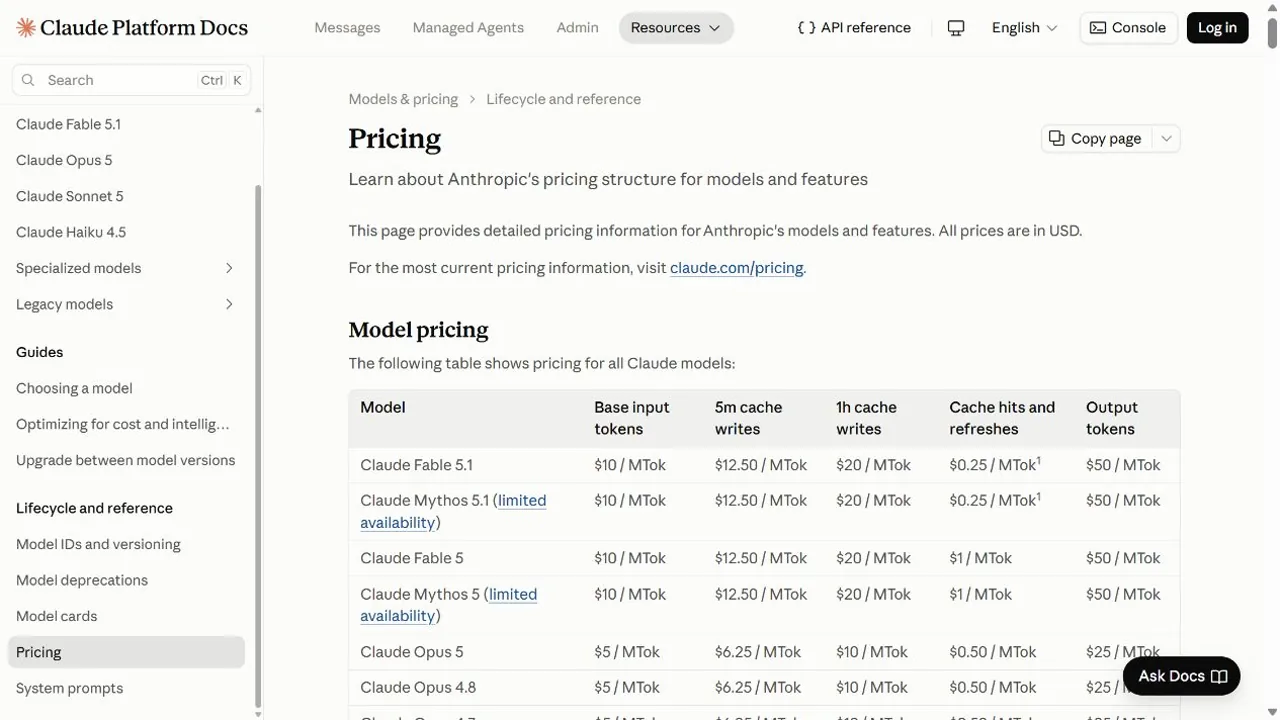
Lees het volledige artikel Prijsopbouw GPT-6 Astra of vergelijk het met onze Claude Fable-prijsgids. De catalogusprijzen van providers komen niet automatisch overeen met GlobalGPT-credits of facturering via de compatibiliteitslaag.
Vijf overeenkomende API-tests
We hebben dezelfde taak naar elk model-ID gestuurd via hetzelfde OpenAI-compatibele eindpunt. Bij de tests 1 tot en met 4 waren maximaal 2.000 uitvoertokens toegestaan. Bij test 5 werd voor beide 1.200 gebruikt, nadat de gateway langere niet-streamingverzoeken van ongeveer 30 seconden had afgewezen. Elke score is gebaseerd op vijf regels die voorafgaand aan de tests zijn gedefinieerd. Een leeg resultaat levert geen punten op voor onzichtbaar werk.
Motivering: Beslissing over SaaS-kosten
Astra heeft het financiële model afgerond; Fable is bij de aannames gestopt.
Bekijk de exacte taak
HTTP 200 · 28,98 s · 242 invoer · 1.427 voltooid · score 10/10
HTTP 200 · 26,01 s · 357 invoer · 2.000 voltooid · score 1/10
Tekst: redactie productlancering
Beide leverden bruikbaar materiaal op, maar Fable voegde details toe die in de aantekeningen ontbraken.
Bekijk de exacte taak
HTTP 200 · 15,47 s · 165 invoer · 500 voltooid · score 10/10
HTTP 200 · 26,01 s · 263 invoer · 1.881 voltooid · score 8/10
Programmeren: gelijktijdigheid in TypeScript
Astra leverde een duidelijke diagnose en gedeeltelijke testresultaten op; Fable leverde op deze route geen zichtbaar antwoord op.
Bekijk de exacte taak
HTTP 200 · 41,54 s · 181 invoer · 2.000 voltooid · score 9/10
HTTP 200 · 29,44 s · 277 invoer · 2.000 voltooid · score 0/10
Uitgebreide context: beplanting als bodemverbetering
Beiden verwezen naar en citeerden de doorslaggevende wijziging van artikel 417.
Bekijk de exacte taak
HTTP 200 · 14,96 s · 99.495 invoer · 244 voltooid · score 10/10
HTTP 200 · 22,24 s · 295.912 invoer · 1.053 voltooid · score 10/10
Strategie: GTM-plan voor 90 dagen
Astra begon aan een weloverwogen plan, maar dat werd voortijdig afgebroken; Fable gaf geen duidelijk antwoord.
Bekijk de exacte taak
HTTP 200 · 34,27 s · 210 invoer · 1.200 voltooid · score 4/10
HTTP 200 · 21,09 s · 338 invoer · 1.200 voltooid · score 0/10
Welk model moet je kiezen?
- Redeneringen en operationele beslissingen: Astra was in deze race veel completer.
- Schrijven: Beide waren bruikbaar; Astra bleef dichter bij de bronpartituren, terwijl Fable gepolijst klonk maar bepaalde details van de interface verzon.
- Codering: Astra leverde de duidelijkere diagnose op. Vergelijk de bredere patronen in onze Coderinggids: Claude versus ChatGPT.
- Lange documenten: Beiden hebben de tegenstrijdigheid precies opgemerkt. De boekhouding van de tokens liep sterk uiteen, dus controleer de kosten aan de hand van je eigen documenten.
- Agentische strategie: Geen van beide voltooide de taak met beperkingen binnen de gestelde termijn; Astra leverde niettemin bruikbaar gedeeltelijk werk op.
Zie voor een ander benchmarkframe GPT-6 Astra versus GPT-5.6 Sol of Claude Fable 5 versus GPT-5.5.
Hoe je beide kunt vergelijken in GlobalGPT
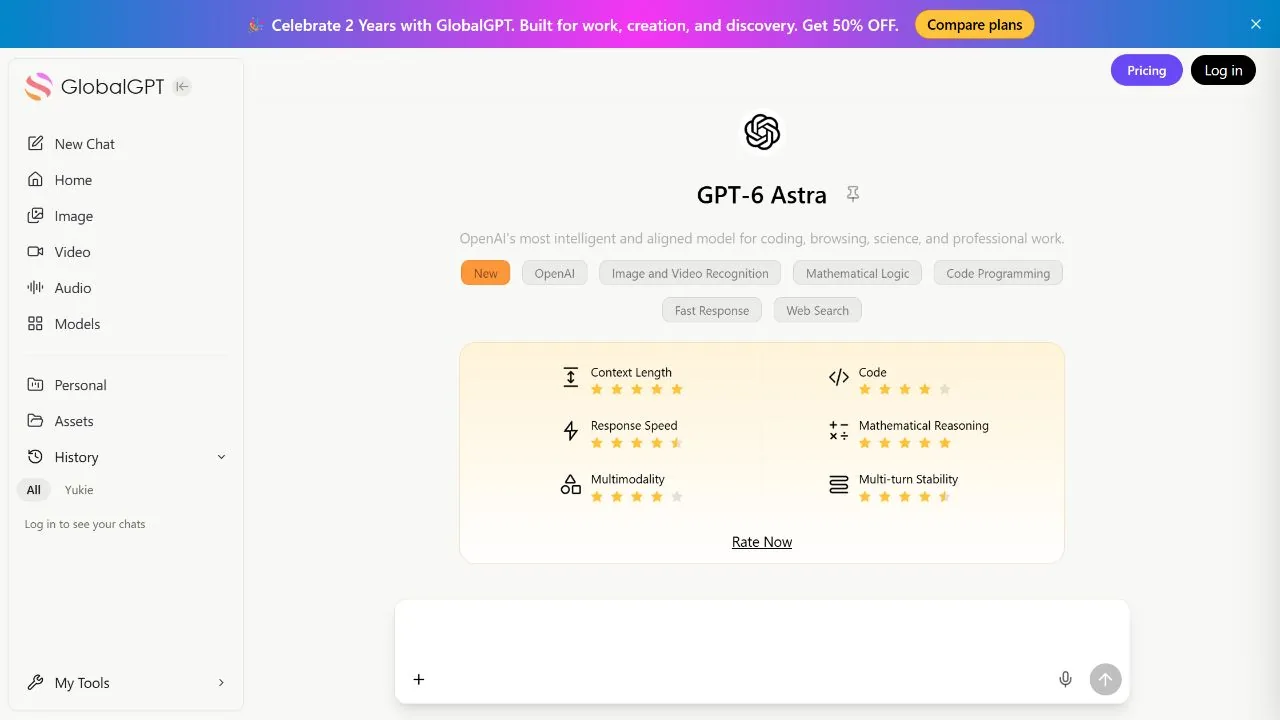
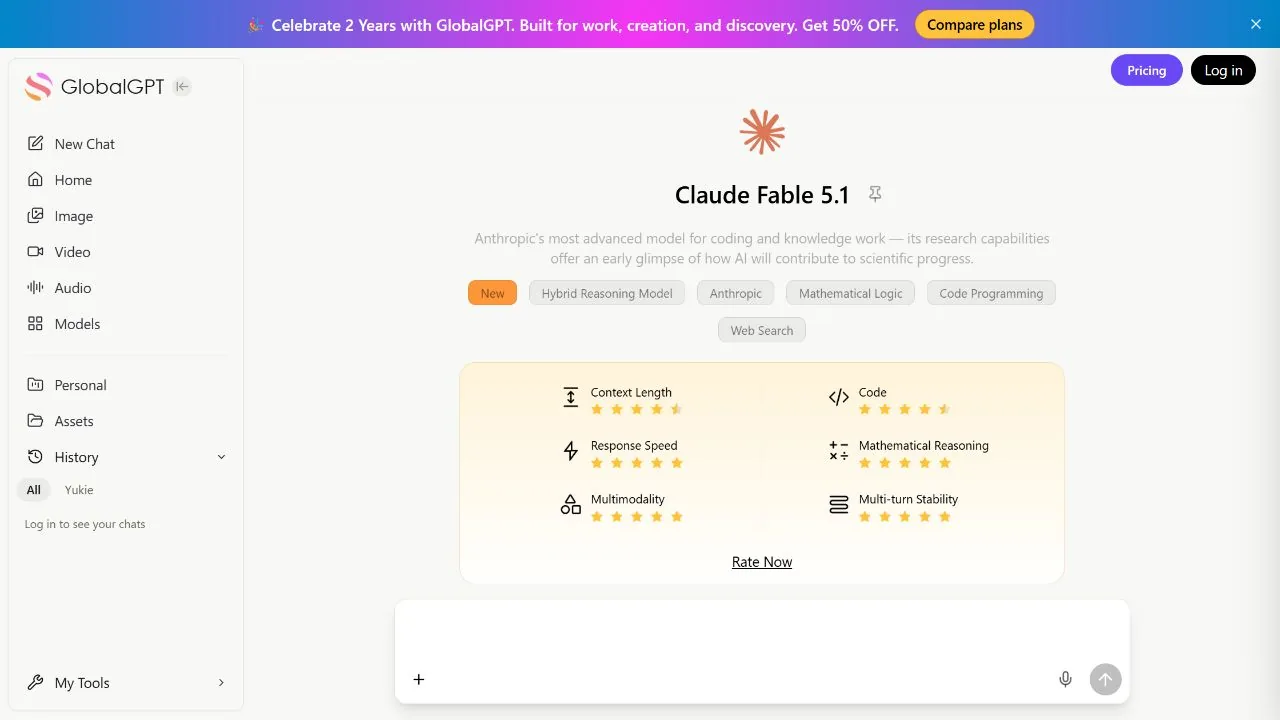
GlobalGPT biedt afzonderlijke verwerkingsroutes voor beide modellen. Gebruik dezelfde prompt, uitvoerbeperking en bronmateriaal, en beoordeel eerst de zichtbare juistheid en pas daarna de stijl. Registreer de latentie en het tokengebruik wanneer de interface of API deze gegevens teruggeeft. Meet bij lange documenten elke route afzonderlijk, omdat identieke tekst op verschillende manieren in tokens kan worden opgedeeld.
Veelgestelde vragen
Is de GPT-6 Astra goedkoper dan de Claude Fable 5.1?
Hun standaard catalogusprijzen voor invoer en uitvoer zijn gelijk. De tarieven voor cache-hits en de regels voor lange context verschillen, terwijl bij GlobalGPT-facturering mogelijk gebruik wordt gemaakt van afzonderlijke credits.
Welk model heeft het grotere contextvenster?
GPT-6 Astra heeft 1,05 miljoen tokens en Claude Fable 5.1 heeft 1 miljoen. Beide hebben een maximale uitvoer van 128.000.
Wat was beter om mee te programmeren?
GPT-6 Astra leverde het duidelijkere zichtbare antwoord op in onze enige TypeScript-test. Fable leverde via deze compatibiliteitsroute geen zichtbare inhoud op, dus dit is geen oordeel dat specifiek betrekking heeft op de provider zelf.
Wat werkte beter voor het ophalen van informatie uit een lange context?
Ze stonden gelijk op 10/10, waarbij ze hetzelfde vooraf geplaatste amendement hadden gevonden en geciteerd. Fable rapporteerde bijna drie keer zoveel input-tokens voor hetzelfde dossier.
Waarom scoorde Fable lager?
Bij verschillende Fable-aanroepen werden voltooiingstokens verbruikt, maar werd er onvolledige of lege zichtbare inhoud geretourneerd. Dit kan te maken hebben met een probleem in de compatibiliteitslaag of met de serialisatie van de uitvoer.
Kan ik beide modellen in GlobalGPT gebruiken?
Ja. Beide speciale GlobalGPT-routes waren actief toen dit op 8 september 2026 werd gecontroleerd.
Eindoordeel
GPT-6 Astra is de veiligere standaardkeuze uit deze testreeks: het leverde completere, bruikbare resultaten op en scoorde 43/50 tegenover 19/50. Claude Fable 5.1 deed het nog steeds even goed als Astra bij de taak voor nauwkeurigheid bij lange contexten en produceerde degelijke marketingteksten. Voordat u Fable afwijst, moet u de tests herhalen via uw productie-eindpunt; twee lege uitvoerresultaten zijn evenzeer een waarschuwing over het integratiegedrag als over het gedrag van het model.