Qwen 3.8 Maxは、Alibaba Qwenが提供する、コーディング、専門業務、長時間稼働するエージェント、およびマルチモーダルタスク向けの新しいフラッグシップモデルです。正式名称は Qwen3.8-Max, 2026年8月3日に発表されたこのモデルは、パラメータ総数2.4兆、アクティブパラメータ数950億、コンテキストウィンドウが100万トークンである。.
今回のリリースは、単なるベンチマークの更新以上の意義を持っています。Qwenは、このモデルを、単に一度に1つのプロンプトに答えるだけのチャットボットとしてではなく、計画を立て、ツールを使用し、視覚的なフィードバックを確認し、長いタスクチェーンにわたって作業を継続できるエージェントとして位置づけています。これにより、このモデルは 実務に最適なAIモデル, …ですが、APIの価格、利用量に応じた料金プラン、および導入要件については、乗り換える前に詳しく確認しておく必要があります。.
Qwen3.8-Maxとは何ですか?
Qwen3.8-Maxは、アリババのQwenチームによって構築された大規模な「専門家混合モデル」です。パラメータ総数は2.4兆ですが、各トークンに対して950億のパラメータを活性化させます。 このモデルは、テキスト、コード、視覚理解、ツールの活用、長期的な計画立案を1つのシステムに統合しており、複雑な作業を最初から最後まで完遂するように設計されています。.
について Qwenの公式リリース ここでは、4つの中心的な目標が挙げられている。すなわち、より強力な自律的なコーディング、実運用レベルの品質を備えたプロフェッショナルな成果物、より長期にわたる閉ループタスク、そしてネイティブなマルチモーダルエージェントである。 具体的には、Qwenでは、モデルが「この質問に答える」という段階から、「この目標を受け取り、計画を立て、利用可能なツールを活用し、結果を確認し、作業が完了するまで継続する」という段階へと移行することを目指しています。“
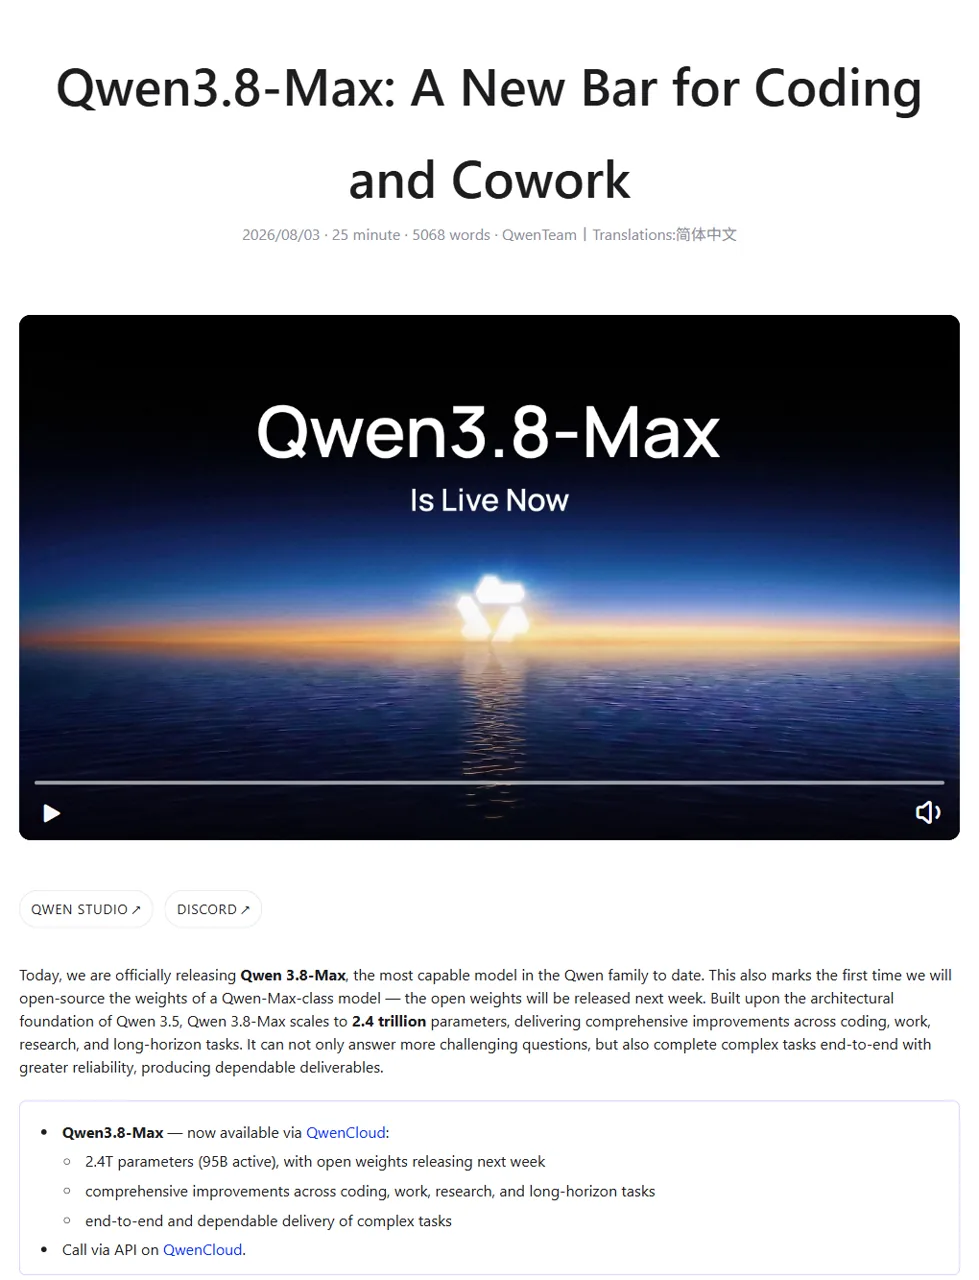
Qwen 3.8 最大仕様
パラメータ数は文脈を考慮する必要があります。2.4兆パラメータのモデルは膨大ですが、「Qwen3.8-Max」はすべてのトークンに対してすべてのパラメータを使用しているわけではありません。このモデルは「エキスパートの混合(Mixture of Experts)」という設計を採用しており、各トークンはネットワークのより小規模なアクティブな部分を経由して処理されます。 したがって、推論の挙動を理解する上では、総パラメータ数だけを見るよりも、950億というアクティブパラメータ数のほうが有用です。もっとも、どちらの数値も、それだけでは実際のレイテンシやハードウェア要件を示すものではありません。.
100万トークンのコンテキストウィンドウは、より即座に活用できます。1回のリクエストで、大規模なリポジトリ、長大なドキュメントセット、膨大なエージェントの履歴、あるいは数ヶ月分の運用記録を格納することが可能です。これにより、すべてのトークンにわたって完全なリコールが保証されるわけではありませんが、開発者は、過度なトリミングを行うことなく、指示、ツールの出力、コード、および中間的な決定を保存するための余裕を大幅に確保できます。.
Qwen3.8-Maxにはどのような機能がありますか?
自律的なコーディング
Qwenのリリース資料では、単なるコード生成のリクエストをはるかに超えたプロジェクトが強調されています。 同社は、エラーや新たな要件に対応しつつ、空のフォルダから本番環境向けのプロジェクトへと発展させる、10日以上にわたる自律的な開発プロセスを説明しています。これはリポジトリ規模のエージェントにとって正しい方向性ですが、購入者は自社の言語、テストスイート、セキュリティルール、およびデプロイ環境において、このモデルを独自に検証する必要があります。.
日常的なエンジニアリングにおいては、実用的な疑問はもっと単純です。そのモデルは複数のファイルを一度に処理できるか?リファクタリングの際にインターフェースを維持できるか?テストを作成し、失敗を検証し、自身のパッチを修正してくれるか?ツールを選ぶ際には、こうした基準が、ランキングのスコアひとつよりも重要になります。 コーディングに最適なAIモデル.
業務上の「共同作業」タスク
「cowork」という言葉は、気軽な雑談ではなく、仕事の成果物を指します。Qwenでは、数百に及ぶ職種にわたる報告書、調査報告、プレゼンテーション、分析、文書、その他の成果物を特集しています。 優れた「cowork」モデルとは、要件定義に従い、根拠を整理し、適切な形式を用い、単なる説得力のある文章ではなく、編集や提出が可能な成果物を提供できるものでなければなりません。.
長期的な視野を持つエージェント
Qwenは、数百ターンに及ぶシステムレベルのタスクについても報告しています。 その例としては、500ターン以上にわたるチップ設計の最適化や、1年間にわたるeコマース戦略のシミュレーションなどが挙げられる。これらはベンダーによるデモンストレーションであり、すべてのエージェントが数日間無人稼働するという保証ではない。しかし、これらは本製品が目指す方向性を示している。すなわち、単発的な解答ではなく、継続的な計画立案、閉ループ評価、そして繰り返しの改善である。.
マルチモーダル計画と視覚的フィードバック
Qwen3.8-Maxは、画像や画面をエージェントループの一部として扱います。視覚エージェントは、ページを調査し、アクションを選択し、何が変化したかを観察し、計画を修正することができます。これにより、コンピュータ操作タスク、文書理解、インターフェーステスト、ビジュアルコーディング、グラフ分析、空間的推論などが可能になります。 難しいのは、単に画像を認識することではなく、多くのステップにわたって視覚的な観察結果をエージェントの目標と結びつけ続けることです。.
実機テスト:有用な出力、応答の遅さ、そして1回の空実行
私は、そのに対して3つの独立したリクエストを実行しました。 qwen3.8-max 2026年8月4日、Anywhere OpenAI互換APIを通じてモデルIDを取得しました。これらは小規模な実用的な検証であり、独立したベンチマークや、すべてのQwen導入環境に関する主張ではありません。目に見える回答の質と、テスト対象のゲートウェイパスの挙動の両方を示す点で、有用なものです。.
Retry-helper のデバッグ
最初のタスクでは、決済ウェブフックのシナリオにおける不具合のあるリトライ機能を使用しました。プロンプトでは、試行回数を3回に制限し、バックオフ遅延を2回正確に設定し、成功した場合は直ちに処理を終了し、完全に失敗した場合は3回目の例外を再発生させるようモデルに指定しました。.
その回答では、3つの別々の不具合が特定されました。それは、試行のたびに無条件にスリープ状態になること、割り当てられていない 結果 例外の処理の後、成功を遅延させたり誤って処理したりした「トゥルーイネス」チェックが行われました。その予想される行は "sleep_fn の引数 [0.1, 0.2] を使用して「paid」.
そこで、その説明を鵜呑みにするのではなく、ローカルでコードを実行してみました。その結果、3つのケースで正常に処理されました。具体的には、2回の失敗の後に成功したケースと、最初の呼び出しで「falsey」な成功値が返されたケースです。 0, 、そして最終結果が RuntimeError("failure-3") 再送信する必要がありました。これは技術的に優れた解決策でした。その代償として、レイテンシが発生しました。テスト対象のゲートウェイを経由した場合、応答が確認されるまでに51.577秒かかりました。.
矛盾する証拠の統合
2つ目の課題では、モデルが最新の公式情報と、過去のメモ、ベンダーの主張、コミュニティからのコメント、および未確認のプラットフォーム経路とを区別できるかどうかを検証しました。.
このモデルは、仕組まれた対立を正しく処理しました。 256Kのコンテキストや「$1.20」という入力価格を現在の値として繰り返すことはなく、4つのGPUに関するコメントをハードウェア要件として解釈することもなく、また「GlobalGPT」にはすでに専用の「Qwen3.8-Max」ルートが存在すると主張することもなかった。 また、公式のベンチマーク表には「ベンダー報告」というラベルを付けました。応答には94.973秒を要したため、これは高速な抽出結果というよりは、品質を最優先した結果と言えます。.
計画テストでは何が失敗したのでしょうか?
3件目のリクエストでは、明確な「実施/中止」および「ロールバック」のゲートを設けた、2時間のCMS移行計画(担当エンジニア2名)が求められました。1件目のリクエストは、アップストリーム接続が切断されたため、133.682秒後に終了しました。より短い再試行セット 最大完了トークン数 1,200まででしたが、APIの報告によると finish_reason: "長さ", 推論予算をすべて使い果たし、32.899秒経過しても目に見える答えを返さなかった。.
これは実用的な運用上の警告ではありますが、Qwen3.8-Maxが移行計画を立てられないという証拠にはなりません。評価対象となる計画が存在しなかったためです。このゲートウェイでは、複雑な計画立案には、より大きな完了許容値、ストリーミング、あるいは段階的なプロンプトが必要であり、そうすることで、表示されるテキストが出力される前に内部推論が応答予算をすべて消費してしまうことを防ぐことができます。.
Qwen 3.8 最大ベンチマーク
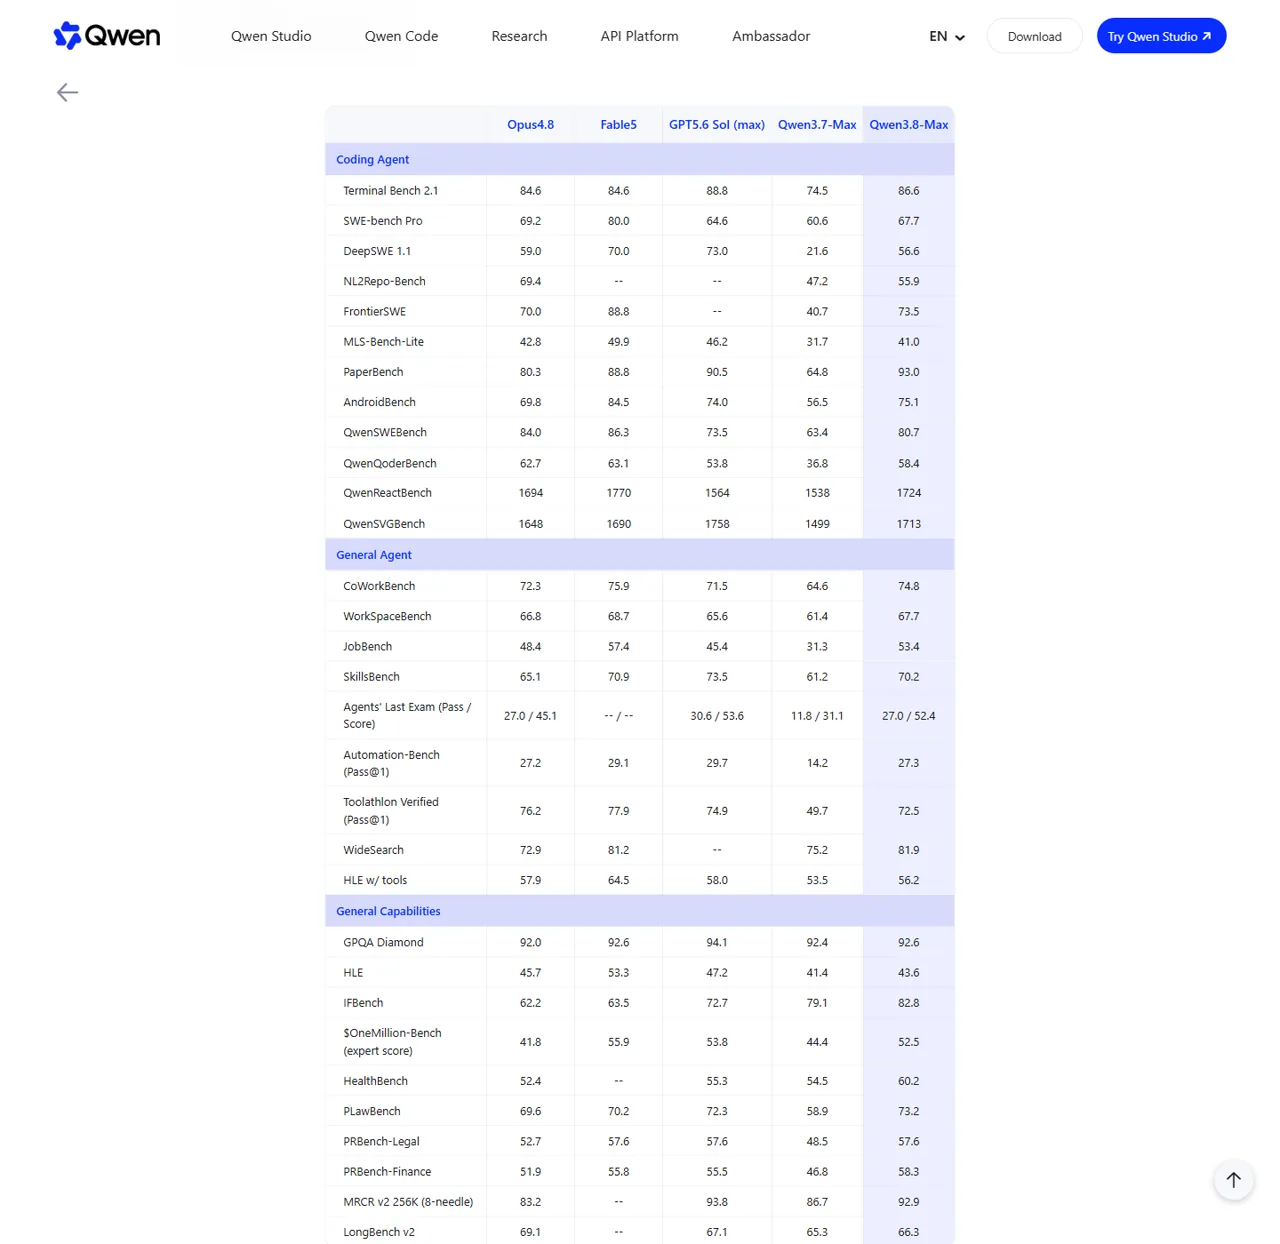
Qwenの公式ベンチマークパッケージでは、Qwen3.8-Maxが強力なコーディングおよびマルチモーダルエージェントとして紹介されていますが、結果は圧勝というよりは賛否両論です。 一部のテストではリストされたモデルの中でトップに立ち、他のテストではトップモデルに迫る成績を収めている一方、いくつかのカテゴリーではGPT-5.6 SolやFable 5に後れを取っています。これは、数十ものテストを単一の「最優秀モデル」というラベルに集約するよりも、より健全な評価と言えるでしょう。.
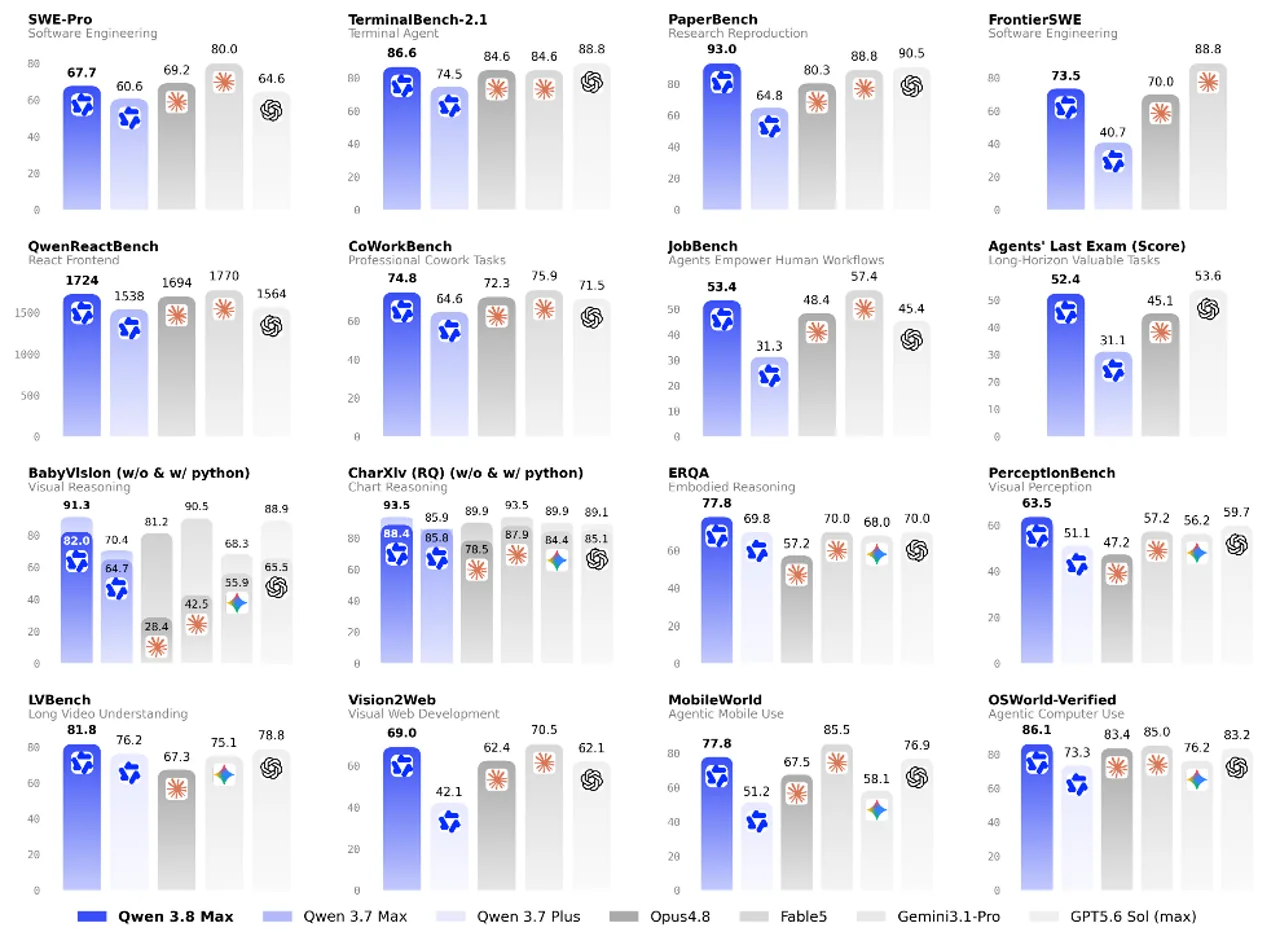
Qwenの公式順位表から抜粋した結果
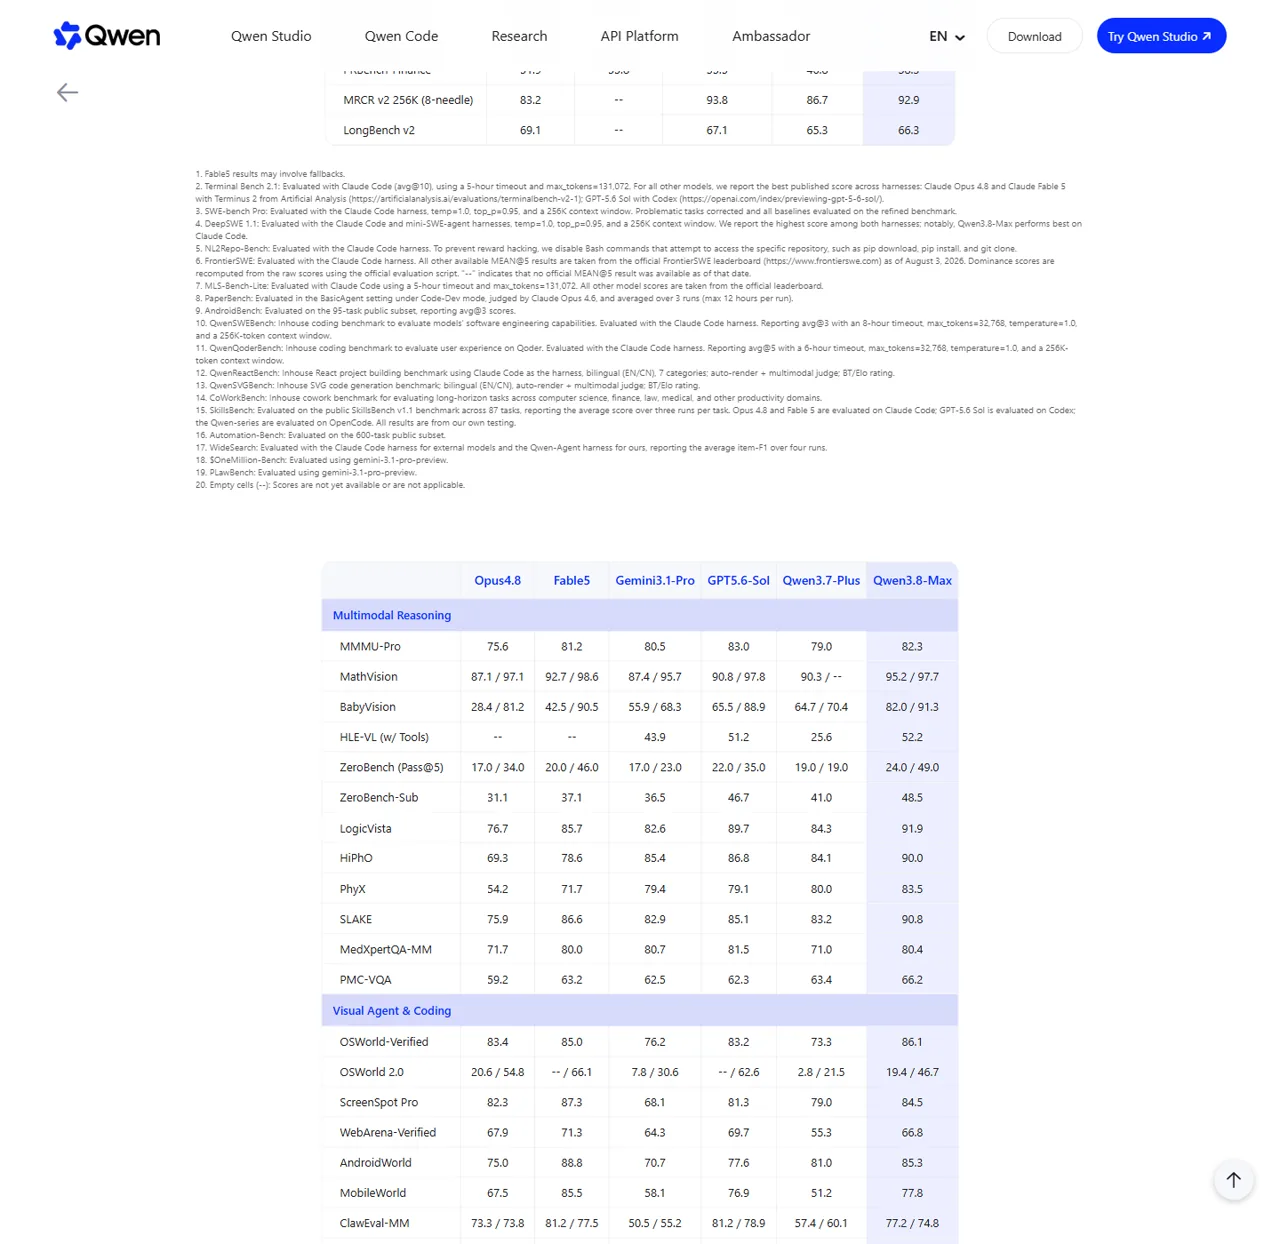
これらの数値は、Qwenが独自に公開した資料に基づいています。 脚注によると、この表には公式のモデルレポート、システムカード、公開リーダーボード、およびQwenの社内評価が組み合わされています。また、一部のモデルではハーネスや設定が異なります。この表を参考にして有望な強みを特定し、高額な投資を決定する前に、ご自身で候補リストを検証してください。.
コーディング結果の意味
最も明らかな利点は、そのバランスです。Qwen3.8-Maxは、ターミナル作業、ソフトウェアエンジニアリング、論文の実装、共同作業、ウェブ検索、指示の遂行といった幅広い分野において、トップクラスに位置しています。 有用であるためにすべての項目でトップになる必要はありません。計画、コーディング、ツール操作、視覚的チェックといった項目全体で一貫して高い性能を維持できるエージェントは、特定の狭いテストに最適化されたモデルよりも信頼性が高い可能性があります。.
この公式の表からは、並行テストがなぜ重要なのかも明らかになっています。GPT-5.6 Solは、推論や端末関連の項目で上位を占めていますが、Fable 5は共同作業、インターフェース、視覚タスクにおいて特に高い競争力を維持しています。別の GPT-5.6 と Fable 5 の比較 Qwen3.8-Maxを候補リストに加える前に、これらのモデルファミリーを日常的な使用シーンに当てはめて考えるのに役立ちます。.
マルチモーダルな結果が意味すること
Qwen3.8-Maxは、マルチモーダル推論、視覚的グラウンディング、コンピュータ操作、文書処理、空間理解の各分野で優れた公式結果を示しています。OSWorld-Verifiedにおける86.1というスコアは、単に画像を記述するだけでなく、デスクトップ環境内でのタスク遂行能力を測定するものであるため、画面操作を行うエージェントにとって特に重要な指標となります。.
Qwen3.8-Maxの比較
「Qwen3.8-Maxは、GPT、Claude、あるいはGeminiよりも優れているか」という問いに対して、一概に答えられるような簡潔な回答はありません。Qwen自身のデータを見ても、カテゴリのトップは行ごとに変わっていることがわかります。 また、製品の適合性は、ツールの信頼性、出力品質、レイテンシ、地域ごとの利用可能性、プライバシー制御、およびモデルを取り巻くインターフェースにも左右されます。.
Qwen3.8-Maxは、コーディング、文書作成、調査、長時間のタスク、ビジュアルエージェントといった幅広い用途を1つのモデルでカバーしたい場合に、最も魅力的な選択肢となります。一方、GPT-5.6 Solは、その強力な推論能力や最終的な成果がユーザーの環境に転用できるワークロードにおいては、依然としてより適した候補と言えるでしょう。 Fable 5は、共同作業やUIを多用するタスクについては、より詳しく検討する価値があります。 Fable 5 と Opus 4.8 の比較 その決定のその部分について、より詳しい背景情報を提供しています。.
このモデルの計画されているオープンな重みデータは、最大の構造的利点となる可能性があります。現在ではAPIのみによる性能が重視されていますが、ダウンロード可能な重みデータがあれば、微調整、プライベートインフラ、研究、地域ごとの展開といった選択肢が広がります。最終的な価値は、公開されるライセンス、重みのフォーマット、量子化への対応、そして実用的な速度でモデルを実行するために必要なハードウェアによって決まるでしょう。.
Qwen3.8-Max API の価格
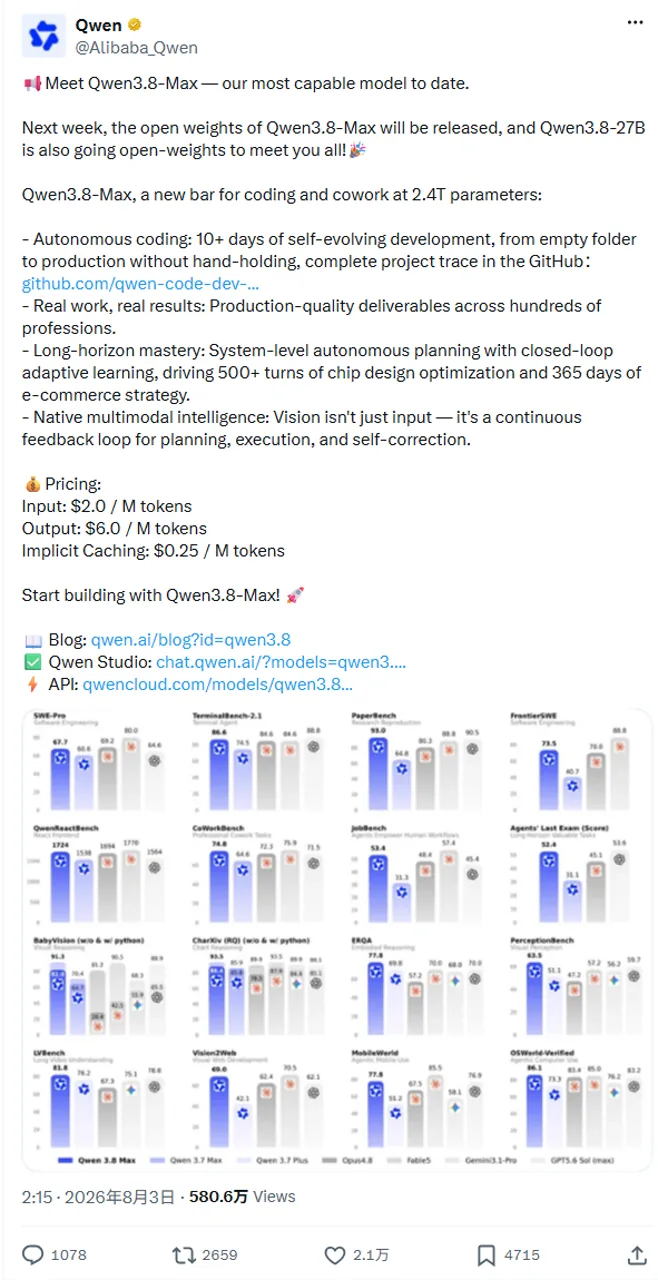
Qwenは、その資料の中で以下の発売価格を記載した。 公式発表:
簡単な見積もりは次のとおりです:
推定コスト = キャッシュされていない入力 × $2/M + キャッシュされた入力 × $0.25/M + 出力 × $6/M
例えば、キャッシュされていない入力トークン1,000万個と出力トークン200万個を使用する実行の場合、他のプラットフォームからの課金が発生する前のローンチ時のレートでは、約$32のコストがかかります。内訳は、入力に$20、出力に$12です。 毎ターン、大規模なリポジトリを再読み込みするエージェントは、はるかに多くのコストを消費することになるため、キャッシュやコンテキスト管理は、表面上の入力価格と同じくらい重要になります。.
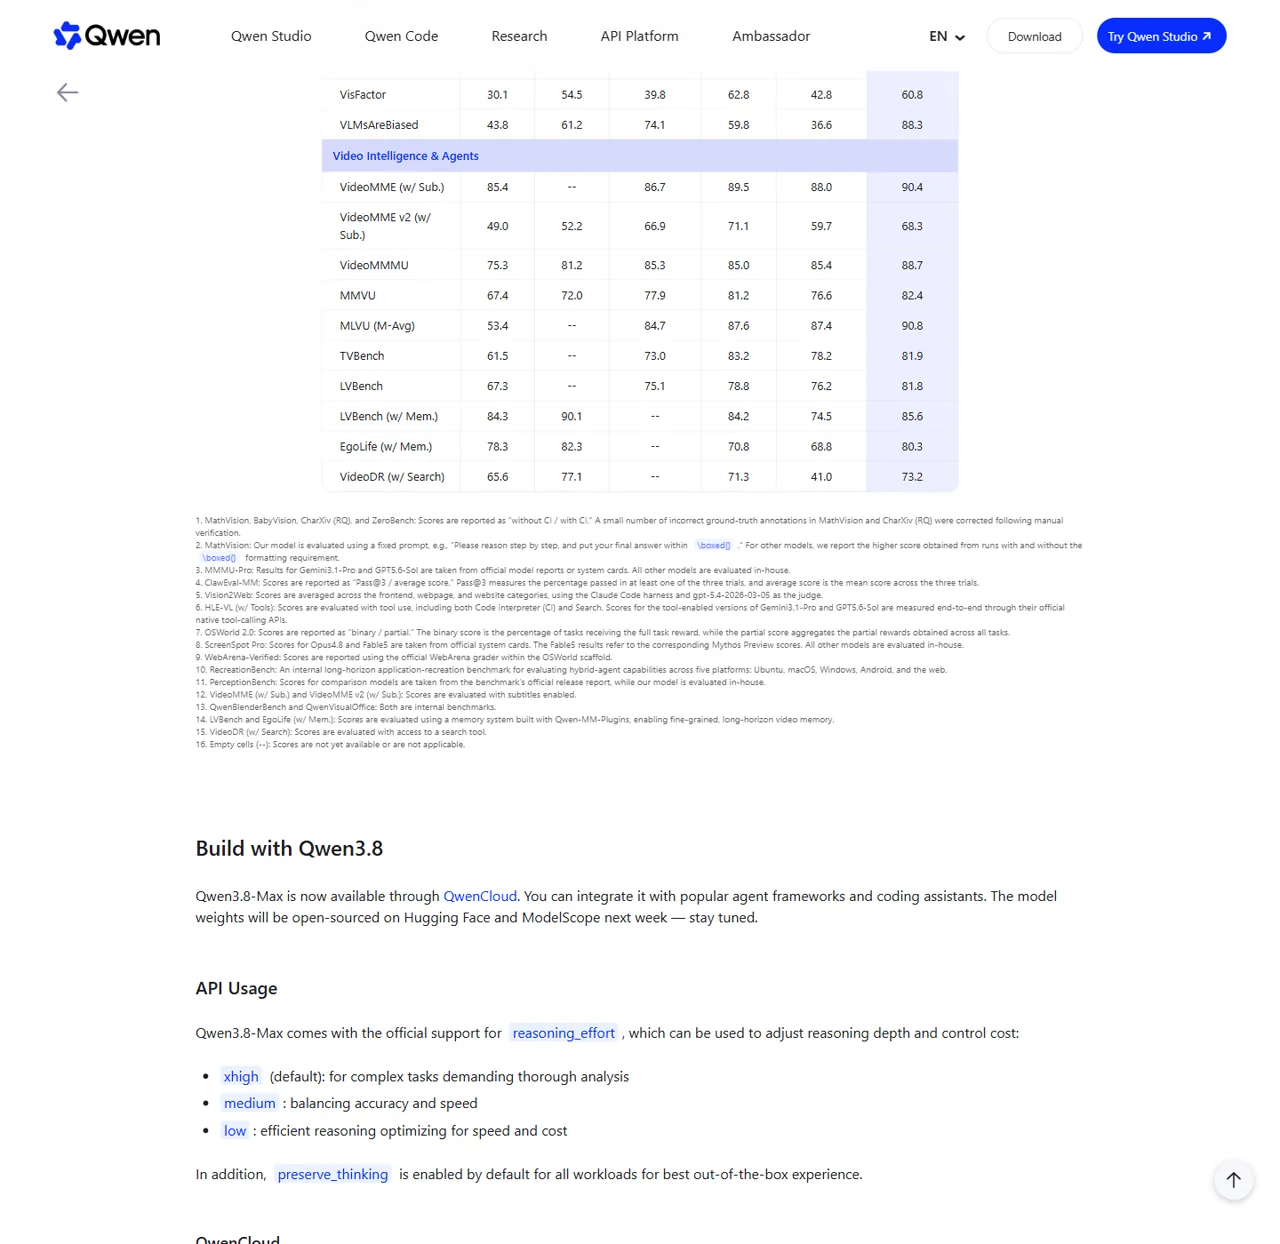
Qwen3.8-Max は、以下の機能もサポートしています 推論の努力 コントロール。公式のAPIセクションには、以下のものが記載されています。 xhigh 複素解析のデフォルトとして、, 中 精度と速度のバランスをとるため、そして ロー より迅速かつ効率的な作業を実現するため。. preserve_thinking デフォルトで有効になっています。これらの制御機能はコスト削減につながりますが、単に互換性のあるモードとして扱うのではなく、タスクの品質との関連で検証する必要があります。.
プロバイダーをまたぐ価格設定についても、同様の注意が必要です。トークン単価が安いモデルであっても、より長いプロンプトや、より多くの再試行、あるいは追加のツール呼び出しが必要になる場合、結果としてコストが高くなる可能性があります。その Gemini 3.1 Pro API 価格ガイド これは、基本発生率に加え、文脈の長さや使用頻度レベルがなぜ重要なのかを示す有用な例です。.
Qwen3.8-Maxへのアクセス方法
1. Qwen Studio を使用して直接評価を行う
ファーストルックを行うための最も早いルートは Qwen スタジオ. 単なる雑学的な課題ではなく、実際のタスクから始めましょう。例えば、整理されていない要件定義書、複数のファイルにわたるコーディング問題、一連のドキュメント、あるいは画像を基にしたワークフローなどを用意します。その結果が正確で、編集可能であり、時間を節約できるほど十分に網羅されているかどうかを確認してください。.
2. アプリケーションで QwenCloud API を使用する
Qwen3.8-Maxは、以下のルートから入手可能です。 QwenCloud. リリースページによると、このAPIは、OpenAIの仕様に準拠した業界標準のチャット補完および応答プロトコルに加え、Anthropicと互換性のあるインターフェースをサポートしています。これにより移行が容易になりますが、モデル名、パラメータ、ストリーミングの挙動、ツールスキーマ、およびエラー処理については、公式ドキュメントで改めて確認しておく必要があります。.
3. コーディングツールやエージェントツールと連携する
Qwenのリリースページには、Qwen Code、Claude Code、Codex、およびOpenClawとの連携機能が記載されています。したがって、このモデルは、新たなインターフェースを無理に導入することなく、既存の端末やエージェントのワークフローに組み込むことが可能です。 連携機能のサポートがあっても、関連ツールのコストが削減されるわけではないため、本モデルの請求額と、別途発生する費用を比較してください。 Codexの価格体系 チームのワークフローを標準化する前に。.
Claudeコードをご利用のお客様は、コーディング製品のコストと外部モデルAPIのコストを分けて管理する必要があります。利用可能なプランおよび課金方法については、以下の Claude コード価格ガイド.
OpenClawのユーザーには、もう1つ疑問があります。それは、特定のエージェントにとって、ツールの使い勝手、速度、価格のバランスが最も優れているのはどのモデルか、ということです。その OpenClawモデルの比較 最大のモデルを無条件に採用するのではなく、その選択を行うための実用的な枠組みを提供する。.
4. マルチモデル・ワークフローの整合性を保つ
リリース時点において、QwenCloudはQwen3.8-Maxの検証済み量産ルートです。GPT、Claude、Gemini、あるいはFableの代替案と比較した場合、 GlobalGPT マルチモデルワークスペース これにより、対応しているモデル間のタブ切り替えを減らすことができます。GlobalGPT専用のモデルページが確認されるまでは、Qwen3.8-Maxについては公式のQwenルートを使用してください。モデルが発表されたからといって、新しいモデルURLが存在すると決めつけないでください。.
Qwen3.8-最大開放重量
Qwenは、8月3日の発売から翌週に「Qwen3.8-Max」の重量データが公開されると発表した。同様に Xの公式投稿 また、Qwen3.8-27Bがオープンウェイトになるとも述べた。これは現地での導入や研究にとっては朗報だが、この発表だけでは、本番用クラスタの計画を立てるには不十分である。.
ハードウェアをダウンロードしたり、予算を組んだりする前に、最終モデルカードに記載されている以下の5つの項目を確認してください:
- 具体的なライセンスおよび商用利用に関する条件。.
- Hugging Face または ModelScope の公式リポジトリの URL。.
- 利用可能な精度および量子化形式。.
- CPU、GPU、RAM、およびストレージの最低要件と推奨要件。.
- リリースされたモデルが、ホストされているAPIの挙動およびコンテキストの長さと一致しているかどうか。.
“「オープンウェイト」と「オープンソース」は、必ずしも同じ意味ではありません。 「オープンウェイト」とは、モデルパラメータがダウンロード可能であることを示すものであり、何を修正・再配布・商用利用できるかはライセンスによって決まります。リポジトリとライセンスが公開されるまでは、Qwen3.8-MaxのダウンロードやGGUFビルド、あるいは正確なローカルハードウェア要件を約束するページは、根拠に先んじた主張に過ぎません。.
27Bの発表についても同様に扱うべきです。地元のユーザーにとっては、こちらの方が現実的な選択肢となる可能性がありますが、そのアーキテクチャ、コンテキスト長、メモリ要件、ベンチマークスコアについては、Maxモデルから転用するのではなく、独自の公式モデルカードに基づいて提示されるべきです。.
Qwen3.8-最大制限値と最適適合
考慮すべき制約事項
- 打ち上げに関する証拠のほとんどは、Qwenから得られている。. 独立した評価では、異なる指示、ツール、または採点基準が用いられる場合があります。.
- 長い文脈は、完璧な記憶とは限りません。. モデルは100万個のトークンを受け入れても、細部を見落としたり、不十分な指示に従ったりすることがある。.
- 出力負荷の高いエージェントは、コストがかさむ可能性があります。. ワークフローで長いコードやレポート、あるいは繰り返される推論トレースが生成される場合、$6/百万という出力レートが重要になります。.
- 重みとモデルカードが届くまでは、ローカルでの展開に関する詳細は不完全なままです。. 2.4Tのトータルパラメータシステムは、小型のデスクトップ型モデルのような動作はしません。.
- 道具の使用は、さらなる失敗の要因となります。. ブラウザの状態、権限、ネットワークエラー、および定義が不十分なツールスキーマは、本来は十分に機能するモデルであっても、その動作を妨げる可能性があります。.
- 打ち上げに関する情報は刻一刻と変化します。. 公開や調達を行う前に、価格、リポジトリ、連携機能、および提供状況について再度確認する必要があります。.
今、どんな人に試してみるべきでしょうか?
要するに、Qwen3.8-Maxは本格的なテストを行う価値はあるものの、安易な移行は避けるべきだということです。成功条件が明確な負荷の高いタスクを1つ用意し、トークンの総数と再試行回数を記録した上で、最初の回答だけでなく、最終的な成果物を比較してください。.
よくある質問
「Qwen 3.8 Max」はいつリリースされましたか?
Qwen3.8-Maxは、2026年8月3日に正式に発表されました。 このホスト型モデルは、リリース当初からQwen StudioおよびQwenCloudを通じて利用可能となりました。Qwen社によると、オープンウェイトは翌週に公開される予定であるため、APIの提供開始とダウンロード可能なウェイトの提供は、別々のマイルストーンとして扱うべきです。.
Qwen3.8-Maxはオープンソースですか?
QwenはQwen3.8-Maxのオープンウェイトを発表しましたが、ユーザーが実行、変更、再配布、または商用利用できる範囲は、最終的なリポジトリおよびライセンスによって決定されます。これらのファイルが公開され、検証されるまでは、あらゆるオープンソースの許可やローカル形式がすでに利用可能であると想定するよりも、「オープンウェイトリリースの発表」という表現の方が正確です。.
Qwen3.8-Maxにはいくつのパラメータがありますか?
Qwen3.8-Maxのパラメータ総数は2.4兆個で、トークン1つあたり950億個のパラメータがアクティブになります。このモデルは「ミクスチャー・オブ・エキスパート(MOE)」アーキテクチャを採用しているため、パラメータ総数とアクティブパラメータ数はシステムの異なる側面を表しています。いずれの数値も、それだけでは実環境での処理速度やハードウェア要件を予測することはできません。.
Qwen3.8-Maxのコンテキストウィンドウとは何ですか?
公式リリースでは、100万トークンのコンテキストウィンドウが記載されています。これは、大規模なコード、ドキュメント、ツールの出力結果、エージェントの履歴などを扱うには十分な大きさですが、コンテキストの上限値があっても、完璧な検索結果が保証されるわけではありません。実際のワークフローで使用される情報の位置、形式、密度に合わせて、モデルをテストしてください。.
Qwen3.8-Max APIの価格はいくらですか?
ローンチ時点において、Qwenは、入力トークン100万個あたり$2、出力トークン100万個あたり$6、暗黙的にキャッシュされたトークン100万個あたり$0.25と設定されていました。これらをローンチ価格として扱い、予算策定前に確認してください。 エージェントのコストは、コンテキストの再利用、推論の負荷、再試行、および生成される出力の長さにも依存します。.
Qwen3.8-Maxは、GPT-5.6 SolやFable 5よりも優れていますか?
すべてのテストでそうとは限りません。Qwenの公式表によると、Qwen3.8-Maxはコーディング、検索、指示の遂行、コンピュータ操作などのベンチマークでトップの成績を収めている一方、他のベンチマークではGPT-5.6 SolやFable 5がトップとなっています。 どちらのモデルが優れているかは、タスク、ツール環境、レイテンシ、価格、および最終成果物の品質によって異なります。.
Qwen3.8-Maxをローカルで実行することはできますか?
Qwenは、発売後の週にダウンロード可能なウェイトを公開すると発表しましたが、現地での導入の可否は、最終的なファイル、精度、量子化への対応、ライセンス、およびハードウェアに関するガイダンスによって左右されます。RAM、VRAM、ストレージの正確な見積もりを信頼するには、公式のモデルカードが公開されるまで待つ必要があります。より小型のQwen3.8バリエーションについては、公式に文書化されれば、より実用的な選択肢となる可能性があります。.
Qwen3.8-27Bとは何ですか?
Qwenのリリース告知によると、Qwen3.8-27Bもオープンウェイト版としてリリースされる予定です。Maxのリリース記事には、Maxモデルの仕様を27Bバージョンに流用するための十分な詳細が記載されていません。 アーキテクチャ、コンテキストウィンドウ、ベンチマーク、ライセンス、およびダウンロード方法については、専用のモデルカードをご確認ください。.
GlobalGPTでQwen3.8-Maxを使用することはできますか?
Qwen3.8-Max 専用の GlobalGPT ルートは、本稿の公開時点では検証されていません。 直接アクセスするには、Qwen Studio または QwenCloud をご利用ください。GlobalGPT は、プラットフォームを切り替えることなく、利用可能な他の GPT、Claude、Gemini、および Fable モデルと比較する際に引き続き有用です。.
最終評決
Qwen3.8-Maxを直接評価するには、Qwen StudioまたはQwenCloudを使用してください。専用のQwen3.8-Maxルートがすでに存在することを前提とせずに、他の検証済みモデルと比較するには、GlobalGPTを使用してください。.
利用可能なモデルを比較するQwen 3.8 Maxは、2026年において最も野心的なモデルリリースの一つです。総パラメータ数2.4兆、アクティブパラメータ数950億、100万トークンのコンテキストウィンドウを備え、コーディングやマルチモーダルエージェントの分野で強力な公式結果を示しており、オープンウェイトへの移行も発表されています。 そのローンチ時のAPI価格は、特にキャッシュによってコンテキストの繰り返しコストが削減されることを考慮すれば、テストを行うのに十分な競争力があります。.
注目すべき最大の理由は、単一のベンチマークでの勝利ではありません。それは、コーディング、プロフェッショナルな成果物、長期的な計画、視覚的なフィードバック、そしてツールの活用を、ひとつのモデルに統合しようとする試みにあるのです。 まずはQwen Studio、あるいは管理された環境でのQwenCloudの評価から始め、完了したタスクの品質と総コストを測定し、公式の重み付けとライセンスが確定するのを待ってから、オンプレミス展開の約束をしてください。.
2026年8月4日に確認した一次資料: Qwen3.8-Max 公式リリース そして @Alibaba_Qwen の公式ローンチ投稿.