業務の委任、成果要件、およびユーザーの制御に関する探索的GlobalGPT研究。.
データの出典および利用許諾: 本研究では、8月にGlobalGPTに対して自発的にデータを共有し、本研究での利用を許可したユーザーの記録を使用しています。プライバシー保護のため、事例は一般化されています。正確な活動総数、アカウント数、サンプル数、および観測日は公表されていません。.
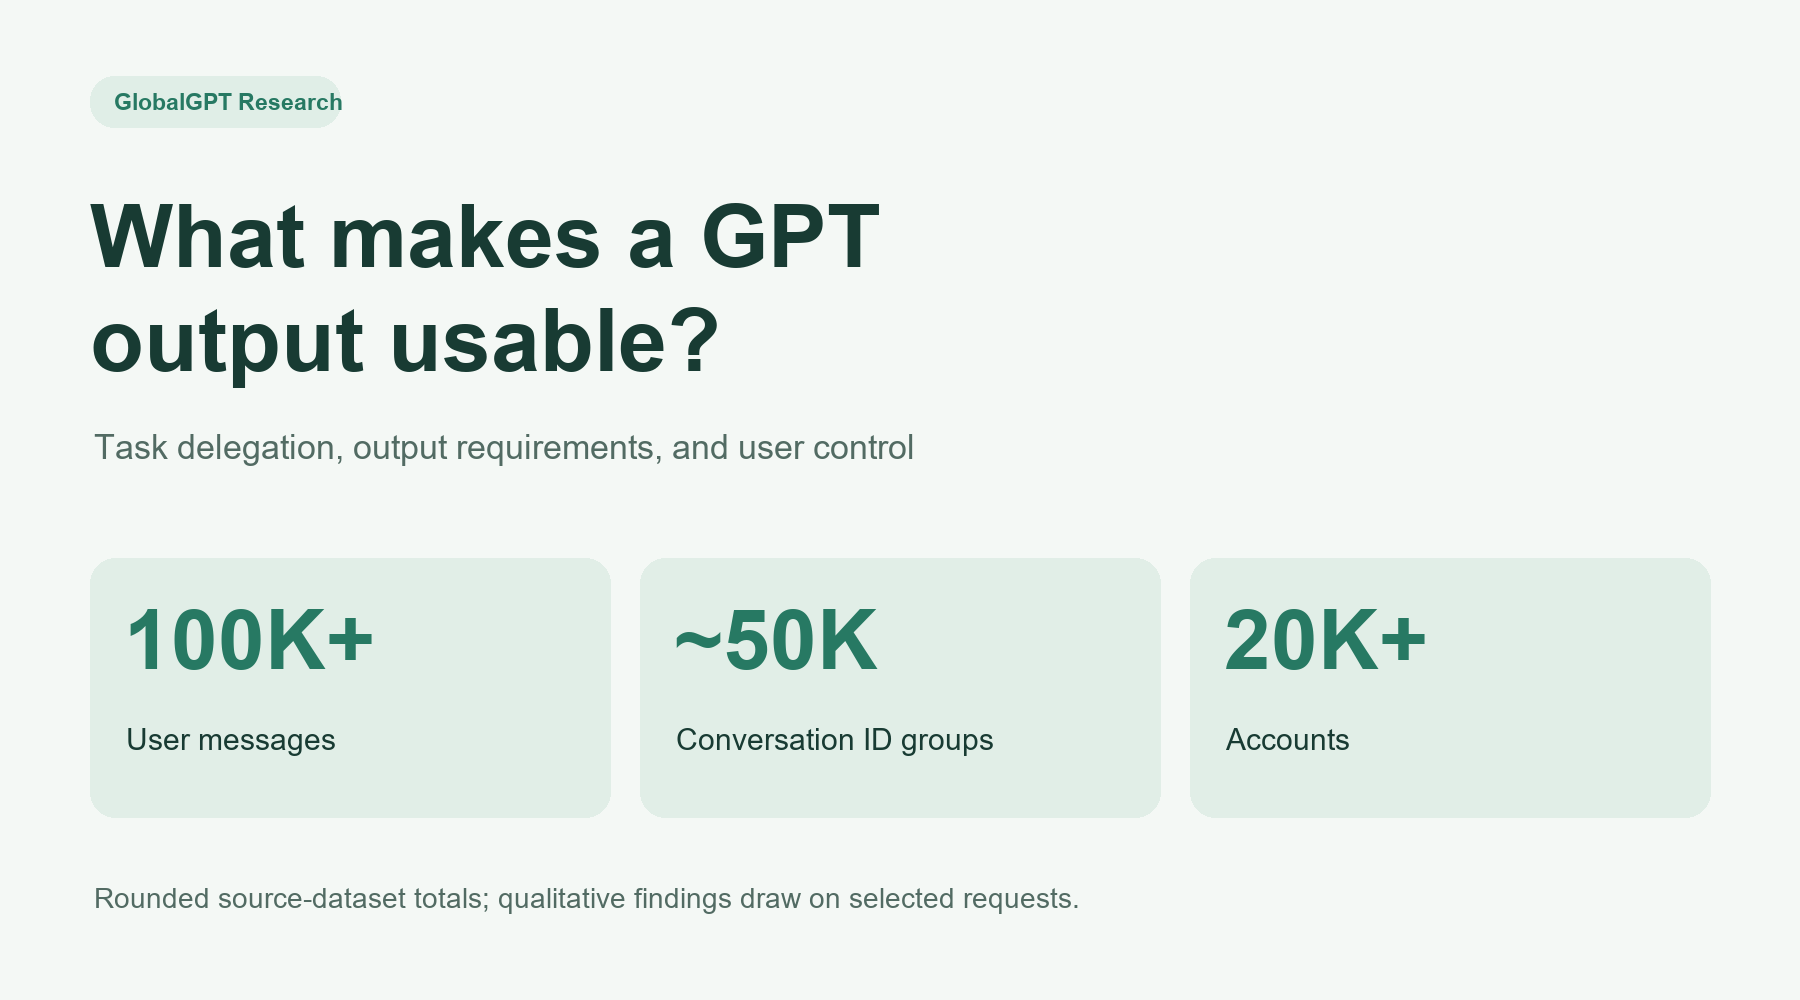
調査データの一覧: 10万件以上のユーザーメッセージ、約5万の会話識別子グループ、および2万以上のアカウント。これらの四捨五入された合計値は、ソースデータセットの規模を示すものであり、定性分析で調査されたリクエストの件数ではありません。.
要旨
背景 会話型AIに関する研究では、人々が話し合うトピックと、情報を得たり業務を委任したりする意図とを区別しています。しかし、業務の委任には、関連するコンテンツの作成以外にも、利用しやすい形式、提供された資料への忠実性、根拠の提示、あるいは実行前の確認の機会といった要件が伴う場合があります。.
研究課題: リクエストレコードでは、出力が利用可能となる条件をどのように指定しているのでしょうか?フォローアップリクエストでは、納品や管理に関する要件をどのように表現しているのでしょうか?「トピックのみ」のタスクラベルによって、どのような区別が曖昧になっているのでしょうか?
方法: 本研究では、承認済み資料から抽出されたリクエストの抜粋に対し、AIを活用した定性分析を行った。主要タスク、診断、およびフォローアップの各レビュー表を用いることで、出力要件、情報源の忠実度、根拠、管理の維持、およびプラットフォームへのアクセスに関する比較が可能となった。これらの表は個別に分析され、テーマ別の分析結果は、対象集団における有病率ではなく、調査対象資料の内容について記述している。.
調査結果: 調査対象のリクエストには、コンテンツの作成と、実用可能な成果物の提供とを区別するものがあります。編集可能またはダウンロード可能な形式を指定するものもあれば、ソース資料への変更を制限したり、証拠の提示を求めたり、実装前にレビューを行うことを条件としたりするものもあります。 プラットフォームの操作に関する質問や、他のツールを想定した指示は、トピックのみの記述をさらに複雑にします。対照的な事例としては、直接的な事実確認の質問、実行を伴わない助言の要請、および文脈が不十分な入力などが挙げられます。.
解釈: タスクの委任とユーザーによる制御は、同一のリクエスト内で共存し得る。この証拠は、要求された操作とその結果に付随する条件との間に分析的な区別があることを裏付けている。しかし、これらのパターンの普及状況、成果の達成、労力の削減、あるいはモデル利用による因果関係については立証していない。.
1.はじめに
本報告書では、自発的に共有され、承認されたGlobalGPTデータの中から選定されたリクエストを分析し、利用量だけでは答えられない以下の疑問について調査を行う: AIが生成した結果が実際に使えるようになるまでに、ユーザーには何が必要なのでしょうか?
スプレッドシートの説明を求める依頼と、編集可能なスプレッドシートを返すよう求める依頼は、同じ対象に関するものであっても、求められる作業内容が異なる場合があります。同様に、文書の修正とは、事実を変更せずに表現を修正することを意味する場合もあれば、自由に新しいバージョンを作成することを意味する場合もあります。どちらも「執筆」に分類されるかもしれませんが、モデルに許容される役割とユーザーの受け入れ基準は異なります。.
本研究では、ユーザーがGPTに実行させたい作業や、その結果に付随する条件をどのように表現しているかを検証する。人間とコンピュータの相互作用に関する研究の枠組みに立ち、成果物の提供、忠実度、根拠、および制御に関する要求の表明を通じて、タスクの委任について調査する。.
大規模な利用実態調査により、会話のトピックとユーザーの意図との間に有用な区別が確立されています。Chatterjiらは、消費者向けChatGPTに関する研究において、「質問(Asking)」「実行(Doing)」「表現(Expressing)」の3つを区別しています[1]。 これにより、さらなる疑問が生じる。何かを行うよう要求する場合、ユーザーが具体的に指定、確認、または承認すべき事項は、一体何なのだろうか。出力は、要求された形式を満たしていなかったり、指示通りに元の資料を保持していなかったりしても、そのトピックに関連している可能性がある。.
マルチモデルAIサブスクリプションプラットフォーム「GlobalGPT」では、リクエストの対象を外部タスクそのものと、その実行方法の両方に設定できる仕組みを提供しています。 選択されたレコードには、コンテンツ、ファイル、モデルの機能、および過去の作業へのアクセスに関する質問が含まれています。これらはGlobalGPT上のGPTラベル付きレコードであり、公式のChatGPTアプリケーションのユーザーサンプルではありません。.
ここでは3つの質問を投げかけます:
- RQ1 — 利用可能性の条件: 検査対象のリクエストは、期待される出力に対してどのような固有の要件を課しているのでしょうか?
- RQ2 — 権限委譲と管理: 初期依頼およびフォローアップ依頼では、成果物の提供、改訂、根拠、ならびに助言と実行の境界について、どのように規定されているのでしょうか?
- RQ3 — 測定: リクエストが主要なトピックラベルのみで記述される場合、これらの区別のうちどれが失われるでしょうか?
本稿は、ユーザーが「使いやすい」AIの出力をどのように定義するかを理解するための枠組みを提示するものである。要求された操作と、提供要件および保持される制御権とを区別することで、本分析は、AIを活用した業務の設計および評価において重要な差異を明らかにしている。.
2. 関連研究と分析的アプローチ
2.1 トピック、意図、および経済活動
ChatGPTの活用方法 本研究では、複数の分類手法を用いて、観測された消費者ChatGPTの活動を分析している[1]。主要な分類データセットは、会話および各サンプリングされた会話内のメッセージを抽出しており、サンプリング重みは、基となるソーステーブルにおける変化率を考慮して調整されている。分類にあたっては、各短文メッセージを独立した単位として扱うのではなく、先行する会話の文脈を活用している。.
本論文では、トピックと意図を区別している。「尋ねる(Asking)」は情報やアドバイスを求める行為、「行う(Doing)」はモデルによって生成される出力を指し、「表現する(Expressing)」は情報の要求でもタスクの委任でもない発言を扱う。技術的な質問では説明や動作するコードを求めることができる一方、文章作成の依頼では、そのまま再利用可能な草案を求めることができる。したがって、この区別は単に主題の問題に還元できるものではない。.
また、この研究では、大規模な分類と検証を区別している。付録Bでは、公開されているWildChatの資料について、モデルのラベルと人間の判断を比較し、一致度指標を報告するとともに、別の開発用データセットを使用している。人口統計学的分析における回帰分析では、測定された特性に関連する差異が検討されている。これらの手順は特定の質問やデータ構造に対応するものであり、大規模なサンプルも回帰分析の設計も、本研究には適用できない。.
私たちの疑問は、委任された成果物に課される要件に関するものです。 私たちは、NBERの分類法を適用したり、同等の妥当性を主張したりすることなく、解釈の出発点として「情報」と「行動」の区別を用いています。調査対象となったリクエストからは、「実行(Doing)」について、何を保持しなければならないか、成果物をどのように提供しなければならないか、そしてユーザーがいつそれを確認したいか、という観点からさらに詳しく説明できることが示唆されています。.
2.2 分類から比較へ
定性分析は、類似した要求に何が必要かを比較し、解釈に異議を唱える事例を検討することで、単なるカテゴリーのリスト以上の貢献をもたらすことができる。Galeらは、事例とカテゴリーの比較、明確な分析フレームワーク、および矛盾する事例への注目が持つ価値について述べている[2]。また、彼らは、マトリックスを作成したからといって、意図的に選択された資料が統計的に代表性を持つようになるわけではないと注意を促している。.
本分析では、その比較論的アプローチを採用している。ただし、フレームワーク・メソッドを完全に実施したわけではない。すなわち、学際的なコーディングチームは編成されず、すべての原文に対する網羅的な行単位のコーディングも行われず、独立した質的調査研究者による評価も実施されなかった。資料は異質であり、比較は「AIシステムに対して明示的に提示された要件」という共通の特徴に限定されている。 我々は、この手順を「探索的定性的内容分析」と呼び、テーマ別エビデンスマトリックスを用いて支援する。.
2.3 基本概念
業務の委任 システムに対して、ある操作を実行したり、結果を生成したりするよう明示的に要求することを指す。. ユーザビリティの条件 その結果に対して求められる要件、例えば編集のしやすさ、出典への忠実性、根拠、対象読者への適合性、あるいは提供方法などが挙げられます。. 支配権の維持 これは、システムが現在行うべきことに対する明確な制限を指し、作業を進める前に計画や草案を提示するよう求めることも含まれます。.
これらの概念は、リクエストの文面を説明するものです。詳細な指示が、必ずしも不信感、専門知識、苛立ち、あるいは作業負荷の増加を示す証拠とは限りません。出典の提示を求めることは、それ以前の回答が間違っていたという証拠にはなりません。この分析では、そうした可能性のある説明を、直接表現された内容とは区別して扱います。.
3. 方法
3.1 設計とデータ源
本研究は、8月にGlobalGPTに対して自発的にデータを共有し、本研究での利用を承認したユーザーに関する既存の記録を対象とした、遡及的探索的分析である。8月とは、ユーザーが資料を共有した時期を指すものであり、観察期間全体を示すものではない。本レビューのために、新たな参加者の募集、介入の割り当て、および追加のデータベース抽出は行われなかった。.
提供された抽出データには、空ではなく、削除されていないユーザー・メッセージ行のうち、会話識別子が空ではなく、かつ提供されたGPTフィルターに一致するモデルラベルを持つものが含まれています。ルーティング、適格性、および会話の完全な境界については、個別に検証されていません。商業的に機密性の高い情報を保護するため、正確な抽出日、アクティビティの合計数、およびアカウント数は非公開としています。.
定性的な知見は、選定されたレビュー資料に基づいています。本レビューは、抽出された全データの記録ごとの分析を行うものではなく、また、承認された寄稿者は、プラットフォームの全ユーザーを代表するサンプルとして扱われていません。.
3.2 利用可能な復習資料と単元
| 素材 | 本分析における使用 |
|---|---|
| 主要タスクのレビュー表 | 意図の検証と探索的な残差カテゴリーの再コード化 |
| 診断レビュー表 | 出力条件、明示的制御、および対照事例の比較 |
| フォローアップ評価表 | 初期およびその後の要請文の抜粋に関する検討 |
| 集計結果表 | 内部での抽出チェック;正確な数値は公表されていない |
この診断表には、不確実なラベルや実質的なタスクカテゴリが含まれています。その構成は、ソースからの抽出量に比例するものではありません。選択は不確実な分類に重点が置かれ、包含確率は設定されていませんでした。.
いくつかの初期のテキストが、複数のレビュー表に繰り返し出現している。同一のテキストが存在しても、それが同一のユーザーや会話であることを立証するものではないが、これらの表を、明らかに独立した相互裏付けとなるサンプルとして扱うことはできない。それらの分母は統合されておらず、再コード化された割合は抽出データに外挿されていない。.
定性単位とは、検査対象のフィールドまたはフォローアップの抜粋内において特定可能な要求を指します。保存された行には、貼り付けられた文書や埋め込まれた履歴が含まれる場合がありますが、必ずしも自然な会話のやり取りそのものであるとは限りません。レビューテーブルの正確なサイズは公表されていないため、分析範囲に関する外部からの評価には限界があります。.
3.3 読取および解釈の手順
初期の検討では、主要タスク表に含まれる意図を示す開口部と、長文または曖昧なフィールドの特定の末尾部分を調査した。以前は「その他」と分類されていた記録には、探索的なカテゴリーが割り当てられた。フォローアップ表からの初期およびその後の抜粋について、その頻度を推定することなく、表現された行動が検討された。.
その後の確認作業では、診断テーブルの冒頭部分、およびより長いフィールドについては末尾部分も点検しました。出力の切り捨てによって隠れていた部分は、再度読み直しました。これは、タスクに関連する抜粋の点検であり、埋め込まれた契約書、研究論文、伝記、コード履歴のすべてを網羅的に読み通したわけではありません。参照されていた添付ファイルや外部リンクは開いていません。.
この比較フレームワークでは、入力データ、要求される操作、出力形式、受け入れ条件、制御の保持、およびプラットフォームへのアクセスを区別した。これは、データを精査し、文献を参考に開発されたものであり、事前登録は行われていない。元の分類ラベルは表示されたままとなっていた。.
この分析では、対照的な形式を比較した。すなわち、「直接的な生成」対「説明」、「原形の保持」対「自由な改変」、「即時の実行」対「事前の計画」、そして「外部の課題要件」対「プラットフォームの操作」である。曖昧な原文箇所、挨拶、定型応答の指示、および文中に組み込まれた役割に関する記述については、それらを強制的に実質的なカテゴリーに分類するのではなく、解釈上の制約として保持した。.
レビューと解釈は、1人のAIアシスタントによって行われました。独立した人間のコーダー、ブラインドラベル、裁定、および実証されたテーマの飽和度は存在しませんでした。概念的次元は、すべての行に対して網羅的に二値ラベルとして割り当てられたわけではありません。結果マトリックスは、有病率や共起率ではなく、パターンや反例を記述したものです。.
3.4 記述統計および統計分析
集計演算および探索的なカテゴリ別件数については、内部で検証が行われました。正確な件数、割合、平均値、および観測期間の長さについては、商業的に機密性の高い規模が明らかになる恐れがあるため、公表していません。公開レポートには、ソースデータセットの合計値(四捨五入済み)および定性的な対比が記載されています。カテゴリ別の出現頻度の拡大推計値や四捨五入された推定値は記載されていません。.
プライマリ・タスクの再コード化では、レビュー対象となった各残差レコードに探索的なカテゴリが割り当てられた。これは、抽出された部分集合に対する帳簿付けであり、標本加重による母集団推定値ではない。また、保存行の構造や抽出の境界により、グループ内の集計値を「会話完了後のフォローアップ確率」や「自然なターン長」として扱うこともできない。.
仮説検定、回帰分析、母集団の信頼区間、遷移確率の計算は行われなかった。未知の包含確率、テキストの重複、不完全な会話の関連付け、および検証されていないラベルが、統計的推論を制限している。選択された行を再サンプリングしても、その選択プロセスは是正されない。独立した評価が存在しなかったため、評価者間の一致度統計量は報告されていない。.
3.5 プライバシーと反射性
本報告書では、個別の引用文、特定の経歴、アカウント識別子、連絡先情報などではなく、一般的な記述を用いています。個人の状況に関する言及は、身元の確認や属性として扱われません。メッセージの表現や内容から、人口統計学的プロファイルが推測されることはありません。.
GlobalGPTは当該プラットフォームを運営しており、その利用に関して商業的な利害関係を有しています。本報告書はコンテンツ調査の枠組みの中で作成されたものであり、生産性や需要に関する魅力的な事例が優先的に取り上げられるリスクがあります。そのような解釈を避けるため、本分析では対照的な事例も盛り込んでおり、依頼があったからといってその実行が成功したとは見なしていません。 データ共有に対するユーザーの承認は、独立した倫理審査や分析に対する人間による検証を構成するものではなく、本報告書においてもそのような主張は行っていません。.
4. 調査結果
4.1 RQ1:実用的な結果を得るには、関連性の高いコンテンツ以上の要素が必要となる場合がある
リクエストの中には、単なる回答だけでなく、特定の成果物を指定するものもあります。例えば、編集可能なワークシート、プレゼンテーション資料、ダウンロード可能な画像、あるいはその後の制作工程に適した文書などが求められます。このような場合、内容と提供形式は別々の要件となります。ファイルの作成方法についての説明だけでは、そのファイルを受け取りたいという明示的なリクエストには応えることはできません。.
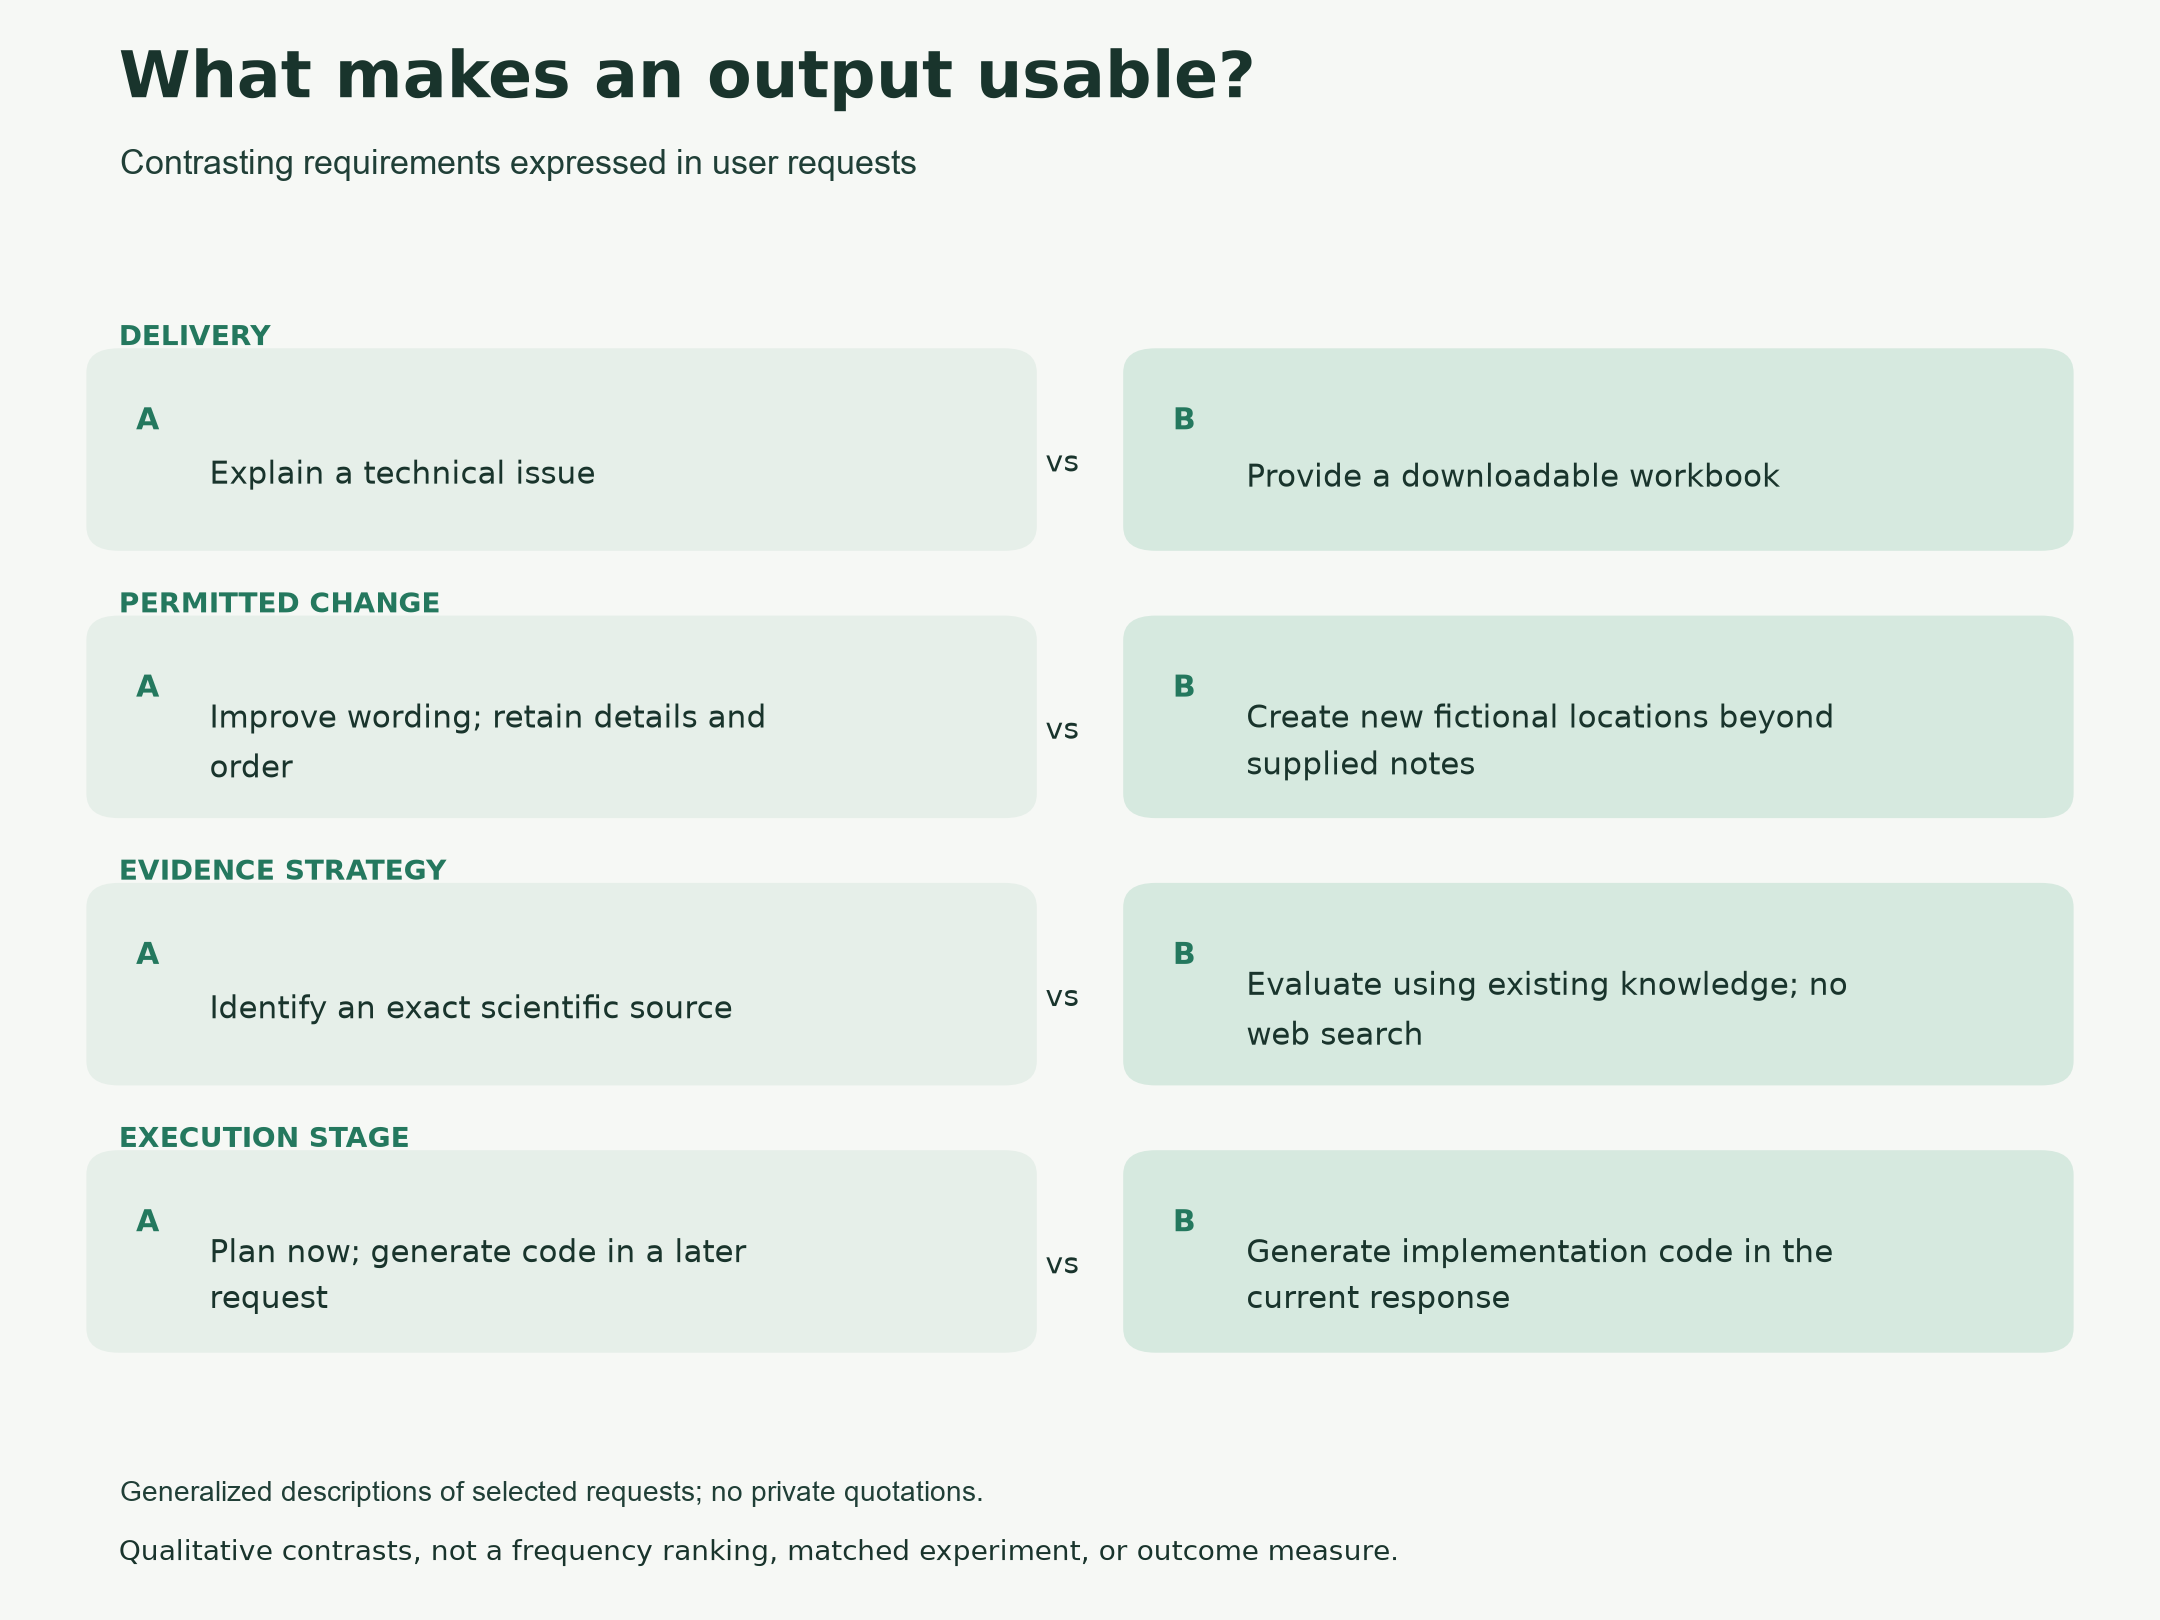
以下の比較は、記載された要件の違いを説明するために、選択されたリクエストを要約したものであり、逐語的な引用や発生頻度の推定値ではありません。AおよびBの各項目は、1つのソースレコードを表しています。これらの組み合わせは、異なるリクエスト間のタスク条件を比較するものであり、一致する実験や同一ユーザー内での変化を比較するものではありません。.
比較 1 — 技術的な問題の説明とファイルの納品。.
リクエストA — 一般的なもの: あるユーザーが、数値形式の変換によってアンダーフローが発生する可能性があるかどうかを尋ねています。目的は技術的な説明であり、ファイルの提出は求められていません。. リクエスト B — 一般化: 別のユーザーがワークブック作成用のコードを提供し、それに基づいて作成されたダウンロード可能なスプレッドシートを求めています。求められているのはそのファイルそのものであり、提供されたコードの説明ではありません。.
この違いは提供方法に関するものです。Aはテキスト形式の回答の中で対処可能ですが、Bはユーザーが取得できる成果物を明示的に必要とします。 主題は異なるものの、この2つの事例は、RQ1が示す「内容に関する質問への回答」と「出力形式の要件を満たすこと」との区別を裏付けています。ただし、スプレッドシートが生成またはダウンロードされたこと、あるいはいずれの回答もユーザーのニーズを満たしていたことを立証するものではありません。.
その他の要求では、変換に条件が課される。事実や詳細、あるいは説明の順序はそのままに、表現を改善するよう求められるのだ。したがって、原資料は単なる背景情報ではなく、許容される変更の範囲を定義するものとなり得る。「ライティング」といったトピックラベルだけでは、その範囲は明らかにならない。.
比較 2 — 文書の保存と架空の設定の拡張。.
リクエストA — 一般的なもの: あるユーザーが、提供されたレポートの詳細や説明の順序はそのままに、文法や表現の修正を求めています。. リクエスト B — 一般化: あるユーザーが架空の世界設定に関するメモを提供し、簡単な説明付きの追加の場所をリクエストしています。このリクエストでは、提供された設定の範囲内にとどまりつつ、それ以上のアイデアを明確に求めています。.
どちらの要求も既存の素材からテキストを作成することを含むが、その出典が果たす役割は異なる。Aでは、残された内容が改変の制約となるのに対し、Bでは、与えられた設定を新たな創作の出発点として扱う。これはRQ1およびRQ3を裏付けるものである。すなわち、執筆上のラベルだけでは、許容される変更の程度を説明することはできない。 この比較は、報告書の事実に関する主張を検証するものではなく、またどちらの出力も指示を遵守していたことを示すものでもない。Bにおける創造的な許容範囲は、依然として架空の追加要素に限定されている。.
「証拠」もまた、要求される属性の一つです。一部のレコードでは、正確な参照先を求めたり、事実に関する主張の確認を求めたり、あるいは不確実な情報を確立された情報と区別することを要求したりします。これは、その結果として得られた回答が信頼できるかどうかを示すものではありません。これは、ユーザーが要求した結果の一部として、明示的に「証拠」を含めたことを示しているのです。.
比較 3 — 情報源の特定と外部検索の制限。.
リクエストA — 一般的なもの: あるユーザーが、添付された図に関連する正確な科学的参考文献を、学術的な引用形式で求めています。. リクエスト B — 一般化: 別のユーザーが、モデルの既存の知識を用いて材料の簡潔な技術的比較を行うよう依頼し、クレジットを節約するためにウェブ検索を明示的に除外しています。.
その違いは、証拠の要件と、回答に許容される手段にある。Aは特定可能な情報源を要求する一方、Bは外部からの情報収集に明確な制限を設けている。 Aでは必須の検索手順は規定されておらず、Bの制限によって正確性が求められるという要件が排除されるわけではない。これらを総合すると、RQ1が証拠戦略を「課題固有のもの」として扱っていることが裏付けられる。図および完成した回答はここでは評価対象外であったため、情報源の特定が成功したか、あるいは信頼性の高い技術的助言が提供されたかは定かではない。.
こうした対照的な事例は重要である。直接的な事実に関する質問では、必ずしもファイルを特定する必要はない。判断や説明を求める要求もあれば、閲覧対象として指定された種類によっては外部検索が明示的に制限される場合もある。したがって、これらの調査結果は、成果物の作成や最大限の調査を普遍的に好むという傾向ではなく、多様な形態の有用性を裏付けている。.
4.2 RQ2:委譲によって、実行上の明示的な境界を維持することができる
その資料には、規定に則った計画案の提出を求めるもの、プレゼンテーション用の要約が完成する前の初期案の提出を求めるもの、プロセスのどの程度を自動化するべきかについての助言を求めるものなどが含まれています。こうした依頼は、作業の一部を委任しつつ、最終的な決定は後回しにするものです。一方、他の記録には、直接的な実施や、直ちに完成した成果物の提出を求めるものもあります。.
比較 4 — 今すぐ計画を立て、今すぐコードを作成する。.
リクエストA — 一般的なもの: あるユーザーがソフトウェアプロジェクトについて説明していますが、今回の回答では研究と実装計画に焦点を当てるようシステムに明示的に依頼し、コード生成は後のプロンプトに留めるよう求めています。. リクエスト B — 一般化: 別のユーザーが、設定や動作ルールをカスタマイズ可能な、指定された自動化ルーチンを実装したソースコードを求めています。.
どちらもソフトウェア構築に関するものですが、現在の実行範囲は異なります。Aは将来の実装目標を定義しつつ、現在のタスクを計画段階に限定しています。一方、Bは現在の対応において実装を求めています。これはRQ2を裏付けるものです。すなわち、プロジェクトを委任したからといって、その後のすべてのステップが自動的に一度に承認されるわけではないということです。 この2つの事例は、Aの後のコーディング段階が行われたこと、Bのプログラムが動作したこと、あるいは計画段階を先に進めることで結果が改善されたことを立証するものではない。これらは個別の要求であり、観察された「前後」の順序ではない。.
この対比は、「要求」と「実行」という単純な区別を限定するものです。ある要求は最終的な生成に関するものである一方で、システムに対して中間段階で直ちに停止するよう求める場合もあります。これを制限のない実行として扱うと、明示的に定められた制御境界を見逃してしまうことになります。.
その後のやり取りの抜粋からは、別の視点が浮かび上がります。ユーザーは、表現の修正を求めたり、欠落している文脈を補足したり、別の形式を要求したり、出典リンクを求めたり、結果へのアクセス方法を尋ねたりします。これらはそれぞれ異なるインタラクションの要件です。これらをすべて「エラー回復」としてコーディングすることはできません。新たな要件は、エラーへの対応というよりも、タスクの詳細化である場合もあるからです。.
また、これらの抜粋からは、質問から草案、そして最終ファイルに至る普遍的な順序を立証することもできない。この資料一式からは、完全かつ独立して検証された回答の経緯は得られない。我々が確認できるのは、依頼書や一部の現地でのフォローアップであり、一般的なプロセスモデルや遷移確率ではない。.
4.3 RQ2:ツール間のアクセスやデータ転送に関する研究もある
「以前の成果物はどこにあるのか」「資料をアップロードするにはどうすればよいか」「提案されたタスクにはどのモデルが適しているか」「統合機能の使い方はどうか」といった質問が寄せられることがあります。こうした問い合わせは、作業を行うための環境に関するものです。これらは、外部コンテンツのタスクを進めるために必要な場合でも、そのタスク自体とは異なります。.
その他の記録では、個別の画像、プレゼンテーション、または研究ツールに関するプロンプトが求められています。ここでは、そのプロンプト自体が意図された中間成果物となっています。これはより広範なワークフローの一部である可能性がありますが、その記録からは、下流のツールが使用されたことや、モデル切り替えが実際に発生したことが確認できません。.
この分析から導かれるのは、ユーザー向けのAIリクエストは、少なくとも3つの異なる対象、すなわちタスク、その結果、およびその結果を生成・取得するための手段へのアクセスに対処できるということである。プラットフォームに関する質問は、ユーザーが示すナビゲーション上のニーズを明らかにするものであり、それ自体では、インターフェースの不具合や機能の欠如を検証するものではない。.
4.4 RQ3:トピックラベルは、タスクを横断する差異を圧縮している
前述の「その他」カテゴリの再分類により、当初「その他」と分類されていた記録の中から、視覚的制作、情報検索、執筆、実践的なアドバイス、ソフトウェアのヘルプ、構造化された文書、コーディング、学習、およびプラットフォームのナビゲーションが特定された。 補足表には、既存のトピックラベルではその操作内容が十分に説明されていない明示的な要求も含まれている。一部の長いソースフィールドは、「翻訳する」「要約する」「文書を作成する」といった具体的な指示で終わっている。.
これに伴い、2つの測定上の問題が生じます。第一に、分類器は、モデルに要求された操作ではなく、貼り付けられた内容そのものに反応してしまう可能性があります。第二に、トピックの割り当てが正しく行われたとしても、ある要求と別の要求を区別する形式、正確性、根拠、または承認条件が省略されてしまう可能性があります。.
| 寸法 | 調査対象資料に含まれる証拠 | 「トピック限定」ラベルでは捉えきれないもの | 極限の場合 |
|---|---|---|---|
| 配送 | 結果の編集やダウンロードに関するリクエスト | テキストのみでもその要望を満たせるかどうか | ファイルの提出を必要としない直接的な説明 |
| フィデリティ | 事実、順序、または出典の詳細を保持するための指示 | どの程度の変更が許可されるか | 自由形式の生成 |
| 証拠 | 参考資料や事実確認の依頼 | 請求を認める根拠として挙げられているもの | 外部研究に対する明確な制限 |
| 制御 | 実施前の計画または検討 | その段階でシステムが実行を許可されていること | 即時生産の依頼 |
| 移籍 | 別のツール向けに作成されたプロンプト | 要求された出力の仲介的役割 | 会話の中で使用することを目的とした出力 |
| アクセス | モデル、アップロード、履歴、および連携に関する質問 | サービス環境を対象とした取り組み | プラットフォームの運用について言及していない外部タスク |
これらの次元は重複する場合があります。これらは解釈の枠組みであり、新たに検証された網羅的な分類法ではありません。この表は、調査対象資料における対比をまとめたものであり、出現頻度の順位付けは行っていません。.
4.5 実質的な解釈に耐えうる記録
一次レビューテーブルには、繰り返し出現する、あるいは固定された短文応答パターンが含まれています。その出所は不明ですが、通常の使用、評価、接続性チェック、例文のコピー、あるいはその他のプロセスを反映している可能性があります。これらは黙って削除されたわけでも、確認済みのテストトラフィックとして特定されたわけでもありません。.
その他のフィールドには、埋め込まれた役割宣言、ツールマーカー、または貼り付けられた会話履歴が含まれている。このような形式になっているため、文を現在のユーザーのリクエストに紐付けることが複雑になる。一部のレコードには、ソース資料のみが含まれているか、文脈が欠けていると目的が判別できない断片が含まれている。.
こうした事例は、主張の範囲を限定するという点で分析的に有用である。データセットは、独立した、完全に観察された権限委譲の事例をありのままに記録したものではない。タスクの分類を改善しただけでは、保存された記録が何を表しているかについての不確実性を解消することはできない。.
5. 考察
5.1 生産を委任することは、管理権を放棄することとは異なる
中心的な解釈としては、リクエストは、結果やプロセスに関する条件を維持したまま、操作を委任することができるというものである。ユーザーは、事実関係を保持したまま草案を作成するようシステムに依頼したり、コードを生成する前に実装計画を立てさせたり、意思決定の前に根拠を提示させたりすることができる。これらは、タスクの委任に対する例外というよりは、むしろそれとの整合性があるものである。.
これは、明示された要件のレベルにおいて、情報探索と情報生成の区別を拡張するものである。これは、人間とAIの協働に関する新たな普遍的な理論を確立するものではない。この資料は、単一の意図ラベルに付随する次元が必要となる理由を示すには十分であるが、各組み合わせがどの程度の頻度で発生するかを推定するには不十分である。.
5.2 出力の生成と実用的な提供は、別々の評価対象である
回答がトピックを扱っているかどうかのみに焦点を当てた評価では、明示的な提供条件が見落とされる可能性があります。検査対象の成果物リクエストについては、要求されたフォームが提供されたか、必要な際に編集可能な状態が維持されていたか、指定されたソースコンテンツが保持されていたか、段階的な承認の境界が遵守されていたかといった点についても確認することが、有益な評価となります。.
これらは、要望に基づいて策定された評価基準の案であり、測定された実績結果ではありません。現時点の記録では、実際の遵守状況を点数化することはできません。とはいえ、この区別によって、メッセージの数やフォローアップの有無といった指標よりも、将来的な成果をより正確に測定する基準を策定することが可能になります。.
5.3 調査結果が協調性について立証していない点
要件の定義、証拠の確認、ファイルの検索といった作業は、委任された業務をめぐる調整活動と捉えることができる。こうした活動の存在は、より根本的な疑問を投げかける。すなわち、AIは総労力を削減するのか、それとも要件定義や確認といった作業へと労力を再配分しているのか、ということである。
本研究では、その疑問に対する答えは得られていない。比較対象となる条件、時間測定、完全な成果物、そして独立した課題達成度の評価が欠けているからだ。フォローアップ研究は、有益な共同研究、回避可能な摩擦、目標の変更、あるいは単なる次なる段階のいずれかを表している可能性がある。それを単に数えるだけでは、こうした説明を区別することはできない。.
今後の仮説としては、明示的な配信条件が後のフォーマット修正を予測するかどうか、あるいは段階的な承認依頼が望ましくない行動の減少と関連しているかどうかを検証することが考えられる。これらの仮説を検証するには、関連付けられたエピソード、検証済みのラベル、およびユーザー内での反復観測の適切な処理が必要となる。これらはあくまで研究課題であり、本報告書における知見ではない。.
6. 制限事項
選択と依存。. これらのレビュー表は、診断を目的として提供されたものであり、対象に含まれる確率は不明である。一部の初期の文献は、同一の表内および異なる表間で重複して掲載されている。これらの記録からは、母集団における有病率や独立した再現性の主張を裏付けることはできない。.
解釈。. あるAIアシスタントが、元のラベルが表示された状態で分析を行いました。独立した人間による検証や、評価者間の一致率の推定は行われていません。分析フレームワークはデータを精査した上で構築されたものであり、分析担当者の予想が反映されている可能性があります。.
読み込みが不十分で、文脈が欠けている。. 点検は、冒頭部分、抜粋された結末部分、およびその後の抜粋部分に重点を置いて行われました。長い原文の箇所、参照された添付資料、およびアシスタントによる回答全文については、網羅的に確認されていません。一部の指示や反例が見落とされている可能性があります。.
抽出範囲。. GPTラベルが付けられたウィンドウ化された行には、それ以前、それ以降、またはその間のアクティビティが省略されている場合があります。モデルのルーティングは独立して検証されていません。保存された行には埋め込まれた履歴が含まれている場合があり、行数は必ずしも自然なターン数を表すものではありません。.
結果。. リクエストは、配信、正確性、満足度、生産性、コンバージョン、あるいはモデルの優位性を保証するものではありません。本調査では、リクエストの内容から機微な個人属性について推論を行うことはありません。.
転用可能性と商業的環境。. 本調査結果は、あるマルチモデル・プラットフォームから抽出された特定の記録に基づくものです。これらは、ChatGPTの公式な使用状況や一般大衆の状況を代表するものではありません。本調査結果を解釈する際には、当該プラットフォームの商業的利益および独立した研究レビューが行われていない点を考慮する必要があります。.
7. まとめ
審査対象のリクエストでは、GPTに委任された処理と、利用可能な結果に付随する条件とが区別されています。これらの条件には、提供形式、原資料への忠実度、証拠、およびさらなる措置を講じる前の確認の機会などが含まれます。プラットフォームへのアクセスや他のツールへのプロンプトは、トピックラベルだけでは捉えきれない要件を追加するものです。.
この証拠は、ある明確な主張を裏付けている。すなわち、要求において「権限の委譲」と「管理権の保持」は共存し得るということである。その関係を説明するには、ユーザーがどのような成果物を求めているか、何が変更されてはならないか、そしてシステムに次に何を求めているかに注意を払う必要がある。本分析では、これらの区別を明らかにしているが、それらが実社会でどの程度の頻度で見られるかを推定したり、それらが成果の向上につながることを実証したりするものではない。.
参考文献
- Chatterji, A., Cunningham, T., Deming, D. J., Hitzig, Z., Ong, C., Shan, C. Y., & Wadman, K. (2025). ChatGPTの活用方法. NBERワーキングペーパー第34255号。https://doi.org/10.3386/w34255。公式記録:https://www.nber.org/papers/w34255。 ワーキングペーパーは、査読付き学術誌の論文とは区別して扱われます。.
- Gale, N. K., Heath, G., Cameron, E., Rashid, S., & Redwood, S. (2013). 多分野にわたる健康研究における質的データの分析へのフレームワーク法の適用。. BMC Medical Research Methodology, 13, 117. https://doi.org/10.1186/1471-2288-13-117. 全文:https://pmc.ncbi.nlm.nih.gov/articles/PMC3848812/.
付録A. 定性的な分類項目のリスト
探索的リコーディングの結果、視覚的制作、固定応答の指示、情報検索、執筆、実践的なアドバイス、プラットフォームのナビゲーション、曖昧な入力、ソフトウェアのトラブルシューティング、構造化された成果物、コーディング、学習、音楽、アイデア創出、長文の再構成、および役割・履歴のパッケージ化が特定された。.
この一覧は、選定された資料に見られるカテゴリーをまとめたものです。各カテゴリーの件数や合計数は非公開となっており、この一覧は出現頻度の順位付けでも、プラットフォームでの需要の推定値でもありません。.
研究に関する開示事項
AIアシスタント: AIアシスタントが記載された抜粋を検証し、探索的な解釈を導き出し、記述的検証を行い、原稿を起草しました。人間による独立したラベル付けとの一致については、一切主張していません。.
データの入手可能性: 本報告書の基礎となるデータには、権限のある寄稿者が自発的に共有した非公開の記録が含まれており、これらは掲載されていません。正確な数値の要約や観測日についても非公開としています。本報告書は、個々のメッセージやテンプレートの再配布を許可するものではありません。調査結果に記載されているすべての事例は、一般的な説明であり、個別の引用ではありません。.