たった1つのモデルで、サウンドシーン全体を構築することができます。.
Seed Audio 1.0 は、ボイス、フォーリー、アンビエンス、タイミング、インストゥルメンタル音楽を組み合わせることができます。当社のテストでは、並外れて高い創造性の限界が確認された一方で、無視してはならない再現性の問題も明らかになりました。.
Seed Audio 1.0は、私がこれまでテストしてきたオーディオモデルの中でも、単一の出力形式ではなく、シーン全体を念頭に置いて設計されていると感じられる最初のモデルの一つです。このモデルは、1つのプロンプトから、音声の生成、演技、環境音の追加、フォーリー音の作成、タイムライン上へのセリフの配置、そしてインストゥルメンタル音楽の生成を行うことができます。.
一言で言えば: Seed Audio 1.0は、統合的なオーディオ制作、特にタイミングを合わせたセリフや映画的なサウンドシーンにおいて、並外れて高い可能性を秘めています。その弱点は再現性です。. 優れた再生結果は驚くほど完成度が高いものになる一方で、同じプロンプトによる別の再生では、音声が乱れたり、あるイベントが抜けたり、指定された声のトーンが変わったりすることがあります。.
Anywhere/BrolyAIのテスト環境を通じて、23件の採点済みサンプルを生成しました。これらには、ナレーション、2人での会話、タイムスタンプ付き音声、効果音のみのシーケンス、音声と音楽が組み合わさったシーン、単独の音楽、多言語パフォーマンス、2分間の独白、および参照音声の続きなどが含まれています。.
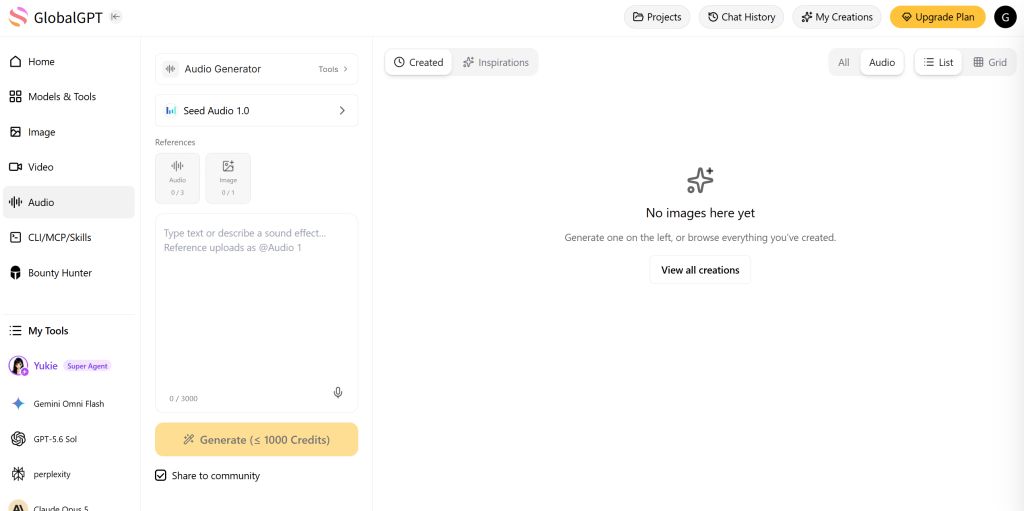
Seed Audio 1.0 レビュー:総評
| カテゴリー | 当社のテスト結果 |
|---|---|
| 表現力豊かな声 | ベストランでは高品質だが、繰り返しプレイでは品質にばらつきがある |
| 複数人の会話 | 正確な台本と、明瞭な話し手の区別 |
| セリフのタイミング | テストセットの中で最も信頼性の高い特徴量 |
| 音響効果 | 空間と事象の順序については現実的だが、事象の正確な個数については不十分 |
| 音声+効果音+音楽 | 要求されたすべてのイベントが確実に発生したときに、シーン全体が説得力を持つ |
| 単独の楽曲 | 予想以上に高性能で、30秒単位の体系的なキューを生成した |
| 多言語音声 | 理想的なケースではあるが、2回の実行のうち1回で、本来ないセリフが幻聴のように聞こえた |
| 2分間の音声 | 両回の実行において、明確な声の個性と物語の一貫性が保たれている |
| 参考音源 | 当社のテスト会場では信頼性が低かった。音声の類似度は低かった。 |
最高だ: ラジオドラマ、ゲームのシーン、ポッドキャストの企画、映像プロトタイプ、オーディオファーストのストーリーボードなどを制作するクリエイターたち。.
以下にはあまり適していません: 確定的な表現、正確なイベント発生回数の繰り返し、あるいは1回の無人生成による信頼性の高い音声クローン生成が求められる業務。.
Seed Audio 1.0 とは何ですか?
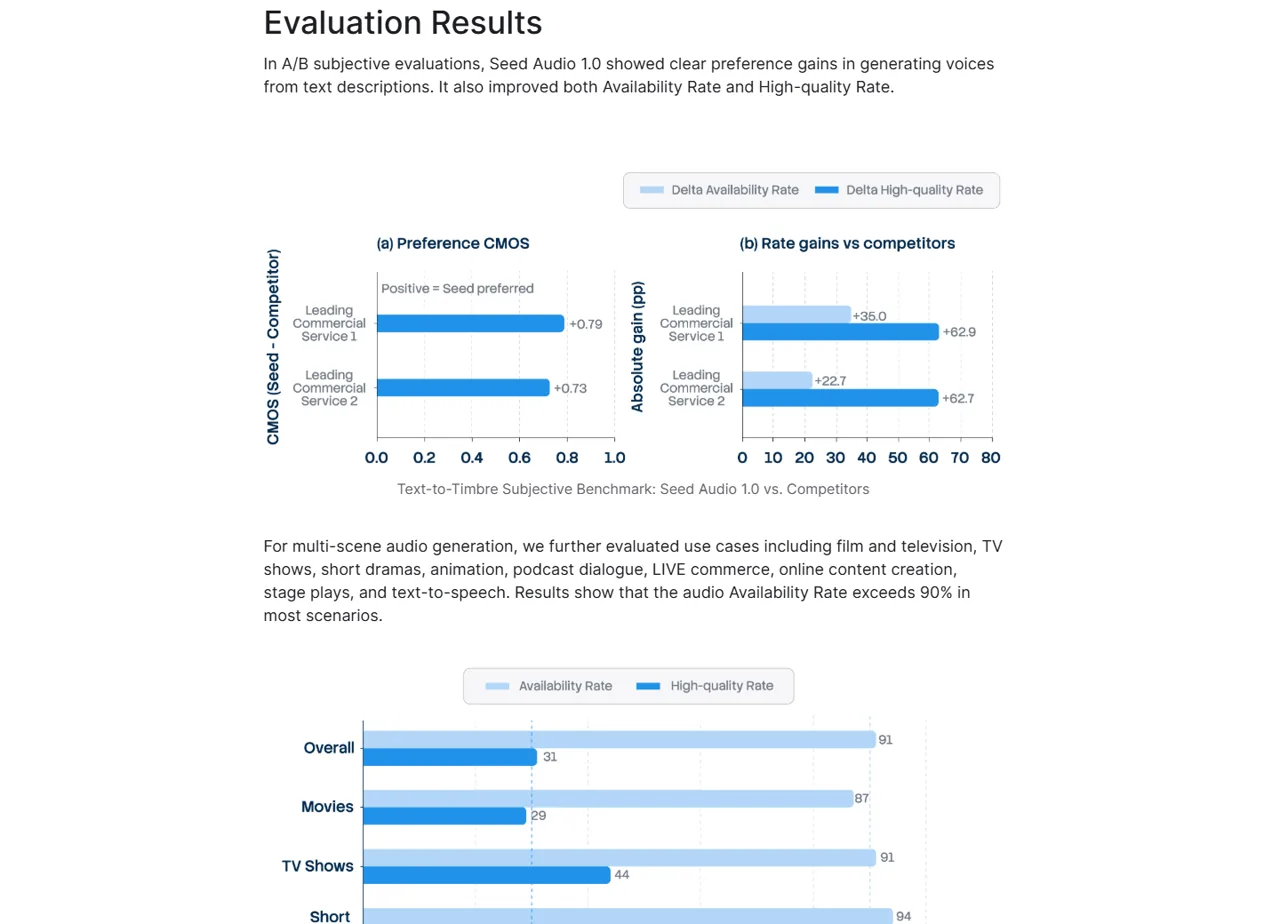
Seed Audio 1.0は、ByteDance Seedが開発した統合型テキストから音声への生成モデルです。音声、環境音、エフェクト、音楽を個別のタスクとして扱うのではなく、これらをまとめて1つのサウンドシーンとして生成することができます。 公式製品ページによると、100ミリ秒間隔でのセリフのタイミング調整に対応しており、1回の処理で最大2分間の音声を生成できるとのことです。.
その統一感のあるデザインこそが、この作品の真の魅力です。プロンプトには、誰が話すか、その声のトーンはどうか、部屋の中で何が起きているか、後でどのようなエフェクトが入るか、そしてシーンの背景にどのような音楽が流れるかなどを記述できます。うまくいけば、出来上がった音声は、寄せ集めではなく、まるで作曲されたかのような仕上がりになります。.
ここには重要な境界線があります。ByteDance自身のロードマップによると、現在、きめ細かなタイミング調整は主にキャラクターのセリフに重点が置かれています。効果音、環境音、音楽に対するより精密な制御については、依然としてさらなる開発が必要な分野となっています。私たちのテスト結果もこの区別を裏付けており、セリフのタイミングは極めて正確でしたが、フォーリー音の正確なカウントについては信頼性がやや低かったのです。.
2026年8月6日に確認した公式情報源:
Seed Audio 1.0のテスト方法
我々は9つのタスクを設計し、23回の採点対象となる生成実行を行った。ほとんどの性能試験では2回または3回の繰り返しを行った。というのも、1つの完成度の高いサンプルだけでは、生産時の信頼性についてほとんど判断できないからである。.
| テスト | タスク | ラン |
|---|---|---|
| T01 | 表現力豊かな英語のナレーション | 3 |
| T02 | 2人の登場人物によるラジオの会話 | 3 |
| T03 | 0秒、4秒、9秒の場面での会話 | 3 |
| T04 | SFXのみの廊下シーン | 2 |
| T05 | 音声、環境音、効果音、音楽 | 3 |
| T06 | インストゥルメンタル曲(単独作品) | 3 |
| T07 | 英語、日本語、ドイツ語に共通する1つの文字 | 2 |
| T08 | 120秒のポッドキャスト・モノローグ | 2 |
| T09 | 参照音声の続き | 2 |
計画された23件の出力には、約12.5分間の生成音声が含まれており、テスト環境を通じた上流の生成コストとして$1.7504が報告されました。Seed Audioでは、テキストトークンの使用量は返されませんでした。課金は生成された秒数に基づいて行われたため、生成トークンは「該当なし」として記録されています。.
スコア化された出力はすべて、40 kHz、16ビット、ステレオのPCM WAVファイルでした。直接の自動再生が利用できない場合、Gemini 3.6 FlashはWAVファイルを音声入力として受け取り、構造化されたトランスクリプト、イベントチェック、タイミングの推定値、およびアーティファクトに関する注記を返しました。 これらの判定は、人間によるMOSスコアではなく、自動化された聴取評価によるものです。.
音声生成:印象的な高音域、再現性にばらつきがある
T01 · 表現力豊かな語り
変動が大きい1つは幻覚のような余計な台詞があり、1つは不自然に聞こえ、もう1つは自然で完成度が高かった。.
使用したプロンプト
穏やかな女性のナレーターが、心配そうな口調から自信に満ちた口調へと移り変わりながら、まったく同じ文を2回読み上げます。音楽や効果音はありません。.ナレーションの指示では、落ち着いた口調の女性ナレーター1名に対し、BGMなしで、控えめな懸念から次第に高まる自信へと感情を移し替えながら、2つの全く同じ文章を読み上げるよう求められました。.
これら3つの実行では、挙動が大きく異なっていました:
- 第1走: 要求されたセリフを言い終えると、その後数秒間、支離滅裂で台本にない発言を続けた。.
- 2回目の走行: 正確な台詞を話したが、話し方はゆっくりで、断続的だった。.
- 第3走: 台本全体を自然な語り口で、絶妙なテンポと一貫した声のトーンで演じきった。.
これが本レビューの核心となるポイントです。Seed Audio 1.0は力強い音声パフォーマンスを生み出すことができますが、言葉遣いが重要な作業においては、一度の実行だけでは不十分です。代替案を生成し、公開前に音声全体を最後まで聴き通すようにしてください。.
このモデルは、3回のナレーション実行すべてにおいて、音楽・効果音・不要な背景音を排除するという指示を忠実に遵守しました。.
複数キャラクターによる対話と話し手の識別
T02 · 2人芝居のラジオドラマ
3/3 完全なスクリプト3つの台本はいずれも正確でした。部屋の雑音や導入部の長さは、テイクごとに異なっていました。.
使用したプロンプト
マヤがささやき、イーライが冷静に答えると、3つの決まった台詞のやり取りの下で、冷蔵庫のうなり音が響いている。.コンビニのシーンでは、大人2人のキャラクターと3つの決まり台詞が使われました。マヤは緊張した様子でささやき、一方のイーライは平静を装おうとしていました。背景音として求められたのは、冷蔵庫の微かなうなり音だけでした。.
3つの再生結果すべてにおいて、台詞は正しい順序で、2つの異なる声によって再生されました。最も優れた再生結果では、正確なセリフ、明瞭な話し手の区別、説得力のある感情表現、そして途切れることのない冷蔵庫のうなり音が組み合わさっていました。.
その他の再生では、シーンレベルでの軽微な問題が見られました。ある再生では、30秒の再生時間のほぼ前半をBGMに費やしてから、ようやく台詞が始まりました。また別の再生では、指定されていた冷蔵庫のうなり音が省略されていました。どちらのミスも台詞のあるシーンそのものを台無しにするものではありませんでしたが、どちらも編集の効率を低下させる要因となっています。.
オーディオドラマに関しては、実際の成果は期待が持てるものです。Seed Audioは、登場人物の感情の変化や声のコントラストを的確に捉えています。ただし、長い導入部分をカットしたり、適切なルームトーンを得るために再生成を行ったりする必要があるかもしれません。.
対話タイミングが最も優れた結果となった
T03 · プロンプトレベルのタイミング
最も信頼できる3回の実行すべてにおいて、線は要求された点の近く、かつ評価者の時間的不確実性の範囲内に位置づけられた。.
使用したプロンプト
0.0秒、4.0秒、9.0秒の位置に、男性・女性・男性のスピーカーによる3つのラジオラインを配置してください。.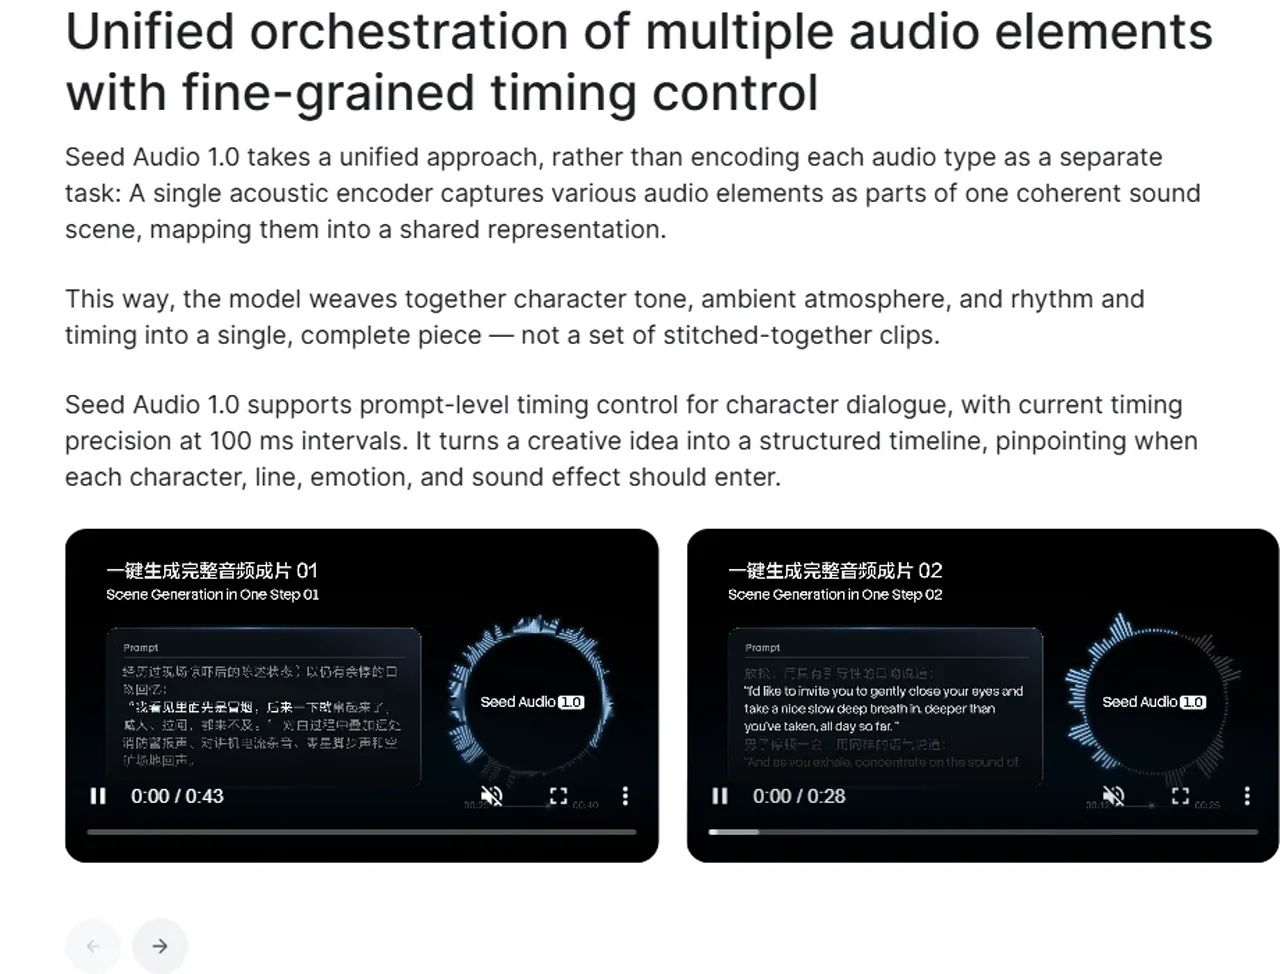
タイミングテストでは、3つの無線回線が要求されました:
- “「第7部隊、報告せよ。」0.0秒。.
- “4.0秒時点で「北側の入口は確保済み」。.
- “9.0秒の時点で「位置を維持せよ」。.
3回の再生すべてにおいて、セリフの順序や「男性・女性・男性」という話し手の順番は正しく再現されていました。Geminiによる音声推定では、繰り返し再生されたセリフの開始時刻は、それぞれ約0.1秒、4.0秒、9.0秒と算出されました。 第1回の実行については、それぞれ約0.1秒、3.9秒、8.9秒と推定された。.
これらの測定結果は、100ミリ秒の精度を裏付ける実験室レベルの証拠として提示すべきではありません。評価者自身も、不確かさがおよそ0.1秒であると述べています。その注意点はあるものの、今回テストした中で最も再現性の高い機能でした。計画されたタイムラインの位置付近に台詞を挿入する必要がある場合、Seed Audio 1.0は極めて有望なツールです。.
SFXの生成:リアルなシーン、不完全なカウント
T04 · 効果音のみの廊下
カウントに失敗しましたその空間と秩序は説得力があったが、2回の走行で4つの足跡と2つの足跡が残された。.
使用したプロンプト
鍵の音、重々しい扉、ちょうど三歩分の足音、雷鳴、そして最後にバタンと閉まる音。声も音楽もない。.SFXのみのプロンプトには、タイル張りの小さな廊下が描写されていた。マイクのそばに鍵があり、重厚な木製のドアが開き、3つの足音がゆっくりと遠ざかり、遠くで雷が鳴り、最後にドアがバタンと閉まる。セリフや音楽は禁止されていた。.
どちらの出力も、説得力のある音響空間を再現し、イベントの順序を忠実に再現するとともに、声や音楽の漏れを防いでいました。その効果は、距離感や空間の一貫性が良好で、リアルであると評価されました。.
どちらの実行も、正確なカウント通りにはなりませんでした。一方は4つの足音を、もう一方は2つの足音を生み出しました。そのため、Seed Audioは説得力のあるフォーリー・コンセプトを生み出すには有用ですが、編集者が正確に3つの衝撃音、ノック音、足音、あるいは銃声を必要とする場合には、あまり頼りになりません。.
最適なワークフローは、雰囲気作りやラピッドプロトタイピングにはワンパスSFX生成を用い、その後、DAWでカウントが重要なイベントを差し替えたり編集したりすることです。.
1つのシーンに音声、環境音、効果音、音楽がすべて含まれている
T05 · 完全版シネマティック・ミックス
2/3完了3回のランのうち2回は、すべてのキューを完遂した。1回は最後の金属音を伴うスラムを逃した。.
使用したプロンプト
雨の路地、車の往来、サイレン、囁くような探偵の声、弦楽器の脈動、早足、そして金属音が響く。.
この「シーン全体」のテストは、意図的に要素を詰め込んだものだった。雨の降る夜の路地、水滴の音、交通音、遠ざかっていくパトカーのサイレン、探偵のささやき声、控えめな弦楽器の音、急ぐ足音、そして金属音が響くドアの閉まる音などが求められていた。.
3回の再生のうち2回は、イベントの全シーケンスが網羅されていました。背景音や音楽の中でも台詞は明瞭に聞き取れ、シーンは、無関係なクリップを単に重ね合わせたような印象ではなく、空間的に一貫性のあるものとして感じられました。1回の再生では、それ以外の点では適切な雰囲気と正確な台詞が再現されていたにもかかわらず、最後の金属音が鳴り響く音が欠けていました。.
この点において、統合モデルはその真価を最も発揮します。ストーリーボードの作成やクリエイティブなアイデアの創出においては、1つのプロンプトから混合シーン全体を生成する方が、各要素を個別に調達するよりも迅速で表現力豊かです。最終的な制作段階では、重要な終了キューについては依然として検証が必要です。.
Seed Audio 1.0 は音楽を生成できますか?
T06 · 単独楽曲
音楽作品3人とも構成的な音楽を作曲した。そのうち1人は、ミュートをかけたピアノの音が見分けにくくなるような曲を作った。.
使用したプロンプト
チェロのオスティナート、ミュートをかけたピアノ、アナログ・ドローン、盛り上がり、そして未解決のエンディングを特徴とする、BPM 72のサスペンス・キュー。.
はい。私たちのテストでは、Seed Audio 1.0は、漠然としたアンビエントな質感にとどまらず、明確に識別できる独立したインストゥルメンタル音楽を生成しました。.
プロンプトでは、72 BPMの30秒間のサスペンス・キューが求められ、低音のチェロのオスティナート、ミュートをかけたピアノのパルス、柔らかなアナログ・ドローン、明確な盛り上がり、そして未解決の最終和音が含まれることが指定されていました。3つのテイクすべてが、指定されたテンポの雰囲気とエンディングを備えた、一貫性のある音楽キューを形成していました。 2つのテイクは要求された要素をすべて含んでいましたが、1つのテイクではミュートされたピアノの音が見分けにくいものでした。.
だからといって、Seed Audioが専用の楽曲生成ツールの代わりになるとは限りません。今回の課題は、歌詞付きのバース・コーラス形式の楽曲ではなく、短いインストゥルメンタルのシネマティック・キューでした。とはいえ、その音楽制作機能は、ゲームシーン、トレーラー、ポッドキャスト、プリビジュアライゼーションなどを支えるのに十分なほど充実しています。特に、音楽が音声やサウンドデザインと連動して生成される必要がある場合には、その真価が発揮されます。.
多言語対応のパフォーマンス:最良の場合は優秀、最悪の場合は不十分
T07 · ひとつの声、3つの言語
1/2 きれい一方の実行は完璧だったが、もう一方は言語切り替えの際、発話が繰り返されたり、支離滅裂になったりした。.
使用したプロンプト
ある女性キャラクターは、英語、日本語、ドイツ語を、同じ人物としての在り方と落ち着いた感情で話します。.
この多言語タスクでは、ある女性キャラクターに対し、録音スタジオでの同じ役柄を英語、日本語、ドイツ語で演じるよう求めました。2回の収録で、正反対の印象が生まれました。.
性能の高い実行では、3つの文すべてを正確に発話し、同じ声のトーンを維持し、落ち着いた感情表現を保ち、適切な間を取りながら話しました。一方、性能の低い実行では、英語の部分は正しく開始したものの、日本語の部分では発話を繰り返したり、誤った発話を生成したりし、ドイツ語の冒頭部分も不自然になってしまいました。その結果、言語をまたいだ声の統一感は著しく低下しました。.
つまり、Seed Audio 1.0 では説得力のある多言語キャラクターの演技を実現できますが、この機能を活用するには複数の候補と、言語を意識したレビューが必要となります。最初の言語のみを確認して、多言語出力を承認しないでください。.
2分間の生成と長文音声の安定性
T08 · 120秒の独白
2/2 安定版どちらのファイルも、安定した発声で120秒間続きました。一方のファイルでは、発音で一瞬つまずく箇所がありました。.
使用したプロンプト
ある男性ポッドキャストのホストが、背景説明を一切省き、3つの発見を盛り込んだ、体系的な気象観測所の話を語っている。.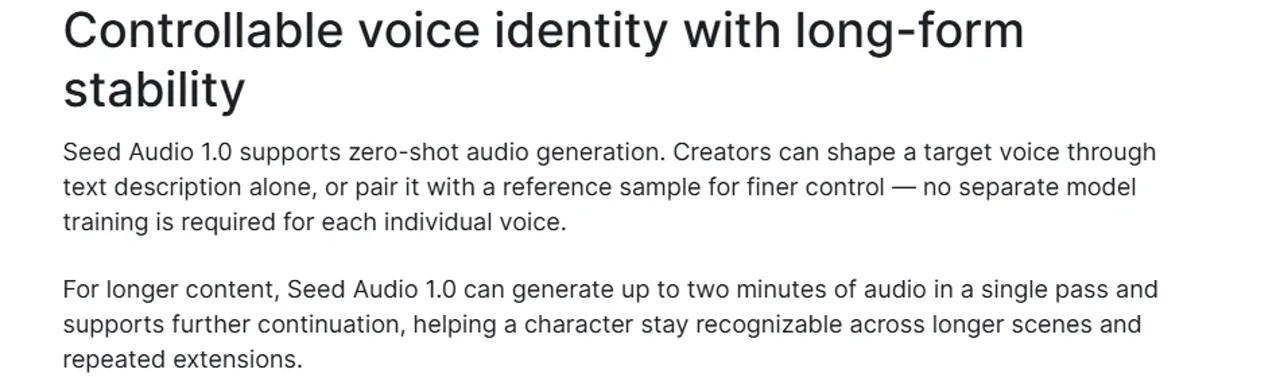
2つの長編課題はいずれも、正確に120秒のWAVファイルが生成されました。いずれも、音楽や効果音のない、スタジオで録音された淡々とした口調の男性ポッドキャスト司会者の音声が使用されていました。.
最初の再生では、最初から最後まで一貫した語り口と首尾一貫した調査構成が維持されていました。明確な導入部、時系列に沿った3つの発見、好奇心から不安への移行、そして最後に残された未解決の疑問。明らかな語り口のずれや支離滅裂な部分は見られませんでした。.
2回目の実行も同様に一貫性と安定性を保っており、1分31秒あたりで発音が一瞬つまずいた箇所が1か所あったのみだった。2分間のワンパス・モノローグとしては、これは素晴らしい結果だ。このことは、Seed Audioが掲げる「ロングフォーム」という主張が単なる再生時間の制限にとどまらないことを示唆しており、このモデルはウィンドウ全体を通じてキャラクターの個性や物語の構造を維持できることを示している。.
基準音源の連続性については注意が必要です
T09 · 参照の続き
ルートが不明テキストは正確でしたが、声の類似度は低かったです。1つの出力では、声が男性の声に変わり、フォリー音も追加されていました。.
使用したプロンプト
声の個性や親密な録音スタイルを保ちつつ、承認済みの女性の音声を基に続きを録音する。.この参照テストでは、最も説得力のあるナレーションサンプルを公式の入力として使用し、同じ女性キャラクターのアイデンティティと親密な録音スタイルを維持したまま、その続きを作成するよう求めました。.
どちらの出力も要求された続きを正確に発話したが、どちらも参照音声とはよく一致しなかった。1つ目は息の混じったささやき声に変化し、音声類似度スコアは控えめな2/5と評価された。2つ目は男性の声を使用していると判断され、類似度スコアは1/5と評価されたほか、発話前に約17秒間の不要なフォリー音が入っていた。.
ここには重要な環境上の制約があります。「Anywhere」タスクのエンドポイントは参照フィールドを受け付けましたが、上流のモデルがその参照をどのように利用したかを示す確認情報を返してきませんでした。これらの結果は、私たちのテスト経路において参照の継続性が信頼できなかったことを証明するものであり、BytePlusのネイティブAPIが常に同じように動作することを証明するものではありません。.
Seed Audio 1.0 の価格と利用制限
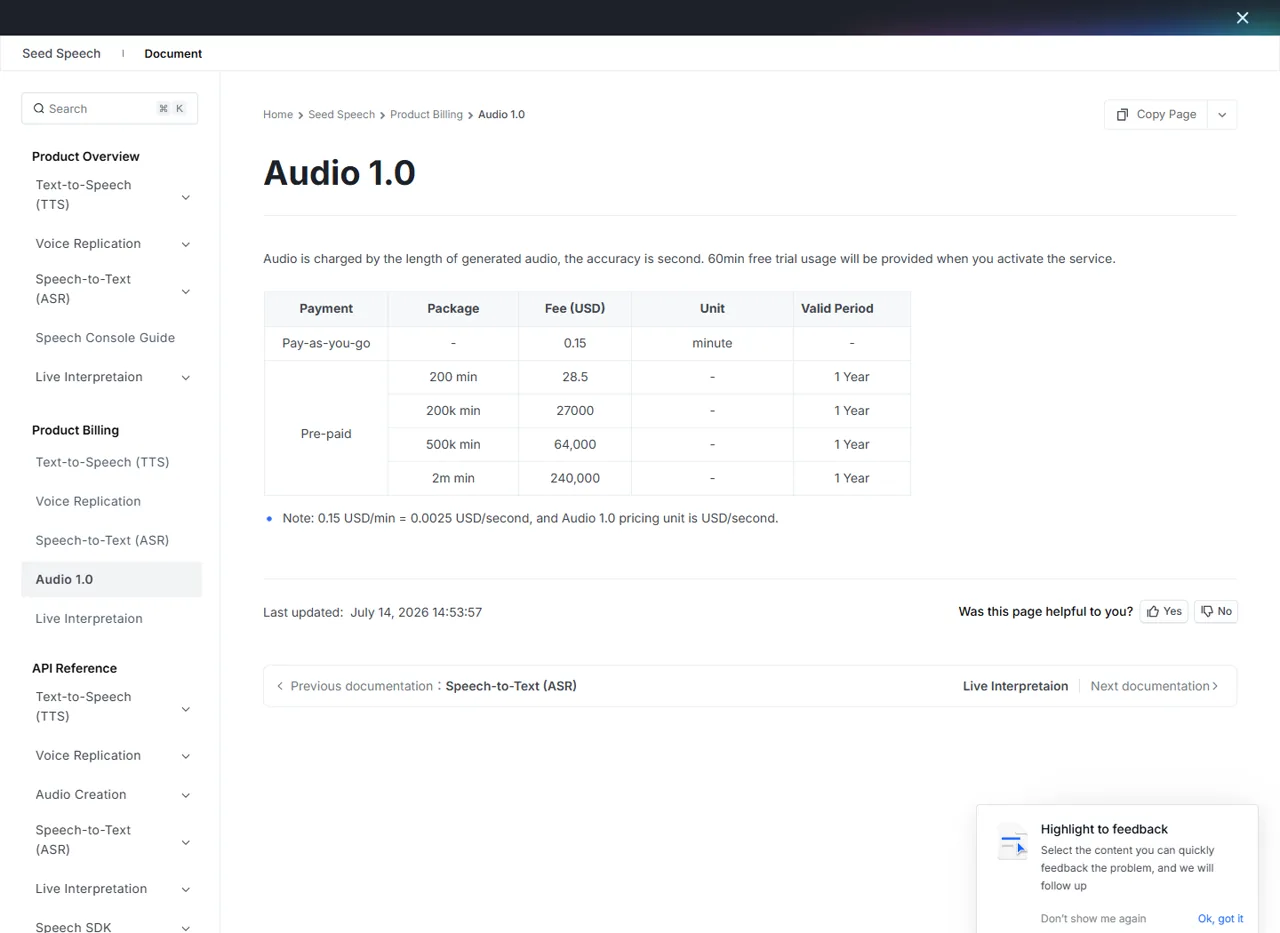
1秒単位で課金され、サービス開始時に60分の無料体験時間が付与されます。.
最大出力
プロンプトの文字
音声資料
参考画像
BytePlusでは、公式の従量課金制の料金を以下のように掲載しています。 生成された1分あたり$0.15, 、1秒単位で課金され、 60分の無料体験 サービスが有効化されたとき。APIドキュメントでは、 最大出力120秒, は最大 3,000文字, 最大 3つの参考音声クリップ, 、および参照画像を1枚受け付けます。.
各参照用音声クリップは、最長30秒、最大10 MBまでです。参照用画像の制限は10 MBです。これらはBytePlus独自の制限であり、サードパーティのプラットフォームでは、入力フォームの容量が小さかったり、異なる料金体系が適用されたりする場合があります。.
当社のAnywhere/BrolyAIテストルートでは、アップストリームコストが別途報告されており、生成された1分あたり平均で約$0.14でした。このテスト環境の数値は、BytePlusの小売価格や他のプラットフォームの最終価格と混同しないようご注意ください。.
Seed Audio 1.0の長所と短所
その強み
- 統一された音声、効果音、環境音、および音楽
- 絶妙なセリフのタイミング
- 確固たる長期的なアイデンティティ
- 映画にぴったりの音楽
どこで壊れるのか
- テイク間のばらつきが大きい
- 時折、言葉が不明瞭になる
- 弱い厳密なSFX計数
- 当ルートの参照連続性に不確実性がある
長所
- 1回の処理で、音声、環境音、フォリー、音楽を生成します。.
- 繰り返し行ったテストにおいて、会話のタイミングが極めて良好でした。.
- 2つのスピーカー間の分離が鮮明で、台本の再現も正確です。.
- 実用的なスタンドアロンの映画音楽を生み出します。.
- 2分間にわたり、声の個性と物語の一貫性を維持する。.
- 当社のテスト経路を通じて、40 kHzのクリアなステレオWAVを出力します。.
短所
- 反復実行の結果は、自然さや信頼性の点で大きく異なる場合があります。.
- 時折、幻聴や支離滅裂な話し方が見られる。.
- SFXの正確なカウント数は信頼できません。.
- 一部の完全なシーンでは、要求された最後のイベントが欠落しています。.
- 多言語対応については、慎重な検討が必要です。.
- 当社のテスト環境では、リファレンス音声の連続性が不十分でした。.
- 高並列での送信により、上流側の並行処理エラーが発生しましたが、失敗したタスクについては課金されませんでした。.
Seed Audio 1.0はどのような方に適していますか?
Seed Audio 1.0は、個々の素材ではなく「シーン」単位で考えるオーディオクリエイターに最適です。特に、ラジオドラマ、ゲームのセリフ、映像プロトタイプ、オーディオストーリーボード、ポッドキャストのコンセプト、そしてサスペンスを盛り込んだ短いBGMなどに役立ちます。.
ワンクリックで最終成果物を生成するシステムとしては、あまり説得力に欠けます。正確な表現、声の個性、イベントの数が法的またはクリエイティブな観点から重要である場合は、繰り返し生成を行い、人間による確認を行うよう計画してください。このモデルは、決定論的なレンダラーとしてではなく、複数のテイクを持つ「迅速な音声ディレクター」として扱う場合に、最も効果を発揮します。.
よくある質問
Seed Audio 1.0 はテキスト読み上げモデルですか?
Seed Audio 1.0 では、音声なしで効果音を生成することはできますか?
Seed Audio 1.0 は音楽を生成できますか?
Seed Audio 1.0 はどのくらいの時間、音源を生成し続けることができますか?
Seed Audio 1.0 はリファレンスオーディオに対応していますか?
Seed Audio 1.0の価格はいくらですか?
最終評決
Seed Audio 1.0 は、実に興味深い統合型オーディオモデルです。1つのプロンプトから、説得力のある音声、フォーリー、環境音、音楽を生成できるという機能は、単なる発売時の宣伝文句ではありません。当社の混合シーンおよび音楽のテストでは、これらの要素が互いに調和して機能することが実証されました。.
このモデルの最大の特徴は、セリフのタイミングの精度でした。最大の弱点は、一貫性の欠如でした。23のサンプル全体を通じて、このモデルは優れたベストケースを示す一方で、明らかに劣る別のテイクを繰り返し生成していました。.
クリエイティブなプロトタイピングの場合、そのトレードオフは受け入れやすいものです。いくつかのバージョンを生成し、最も優れたものを選び、すべてのエンディングを精査します。一方、確定的な制作、正確な音声マッチング、あるいはイベント数の正確さが求められる作業の場合は、ワークフローに人間によるレビューと編集の段階を設けておく必要があります。.
総合的な評価: Seed Audio 1.0は、私たちがテストした中で最も高性能なシーンレベルのオーディオジェネレーターの一つですが、ワンショットの最終レンダラーというよりは、複数のテイクを組み合わせるクリエイティブなツールとして活用するのが最適です。.