Muse Spark 1.2 は、異例に低いトークン単価と 100 万トークンのコンテキストウィンドウを組み合わせたもので、当社の初回 API スイートにおける 3 つのベースモデルコーディングタスクすべてに合格しました。. Metaはこのモデルを 2026年8月5日, 、100万トークンのコンテキストウィンドウ、2つのAPI料金プラン、そして「Muse Code」と呼ばれる独立したターミナルエージェントを備えています。Metaのベンチマーク結果は有望ですが、独立した公開コーディングリーダーボードでは、同様のモデルとエージェントの組み合わせについてはまだ検証されていません。.
本レビューでは、モデルとエージェント、公式スコアと独立した証拠、標準価格設定と「Contributor」ティアのデータ使用量のトレードオフを区別しています。 当社のテストでは、モデルはPythonの冪等性修正、互換性を維持したTypeScriptのリファクタリング、およびリポジトリ全体のJSONL機能の処理を、再試行なしで完了しました。Muse Codeエージェントの実行およびツール呼び出しの信頼性についてはテストを行っていません。より広範な分野をまず比較したい場合は、当社のガイドを コーディングに最適なAIモデル より広範な競争環境を明らかにする。.
Muse Spark 1.2 レビュー:まとめ
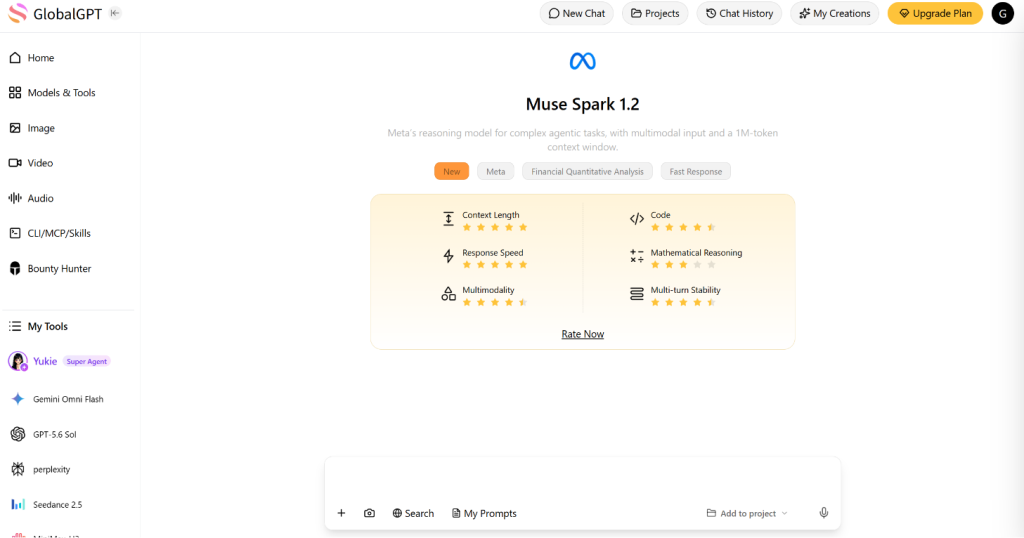
要約すると: Muse Spark 1.2は、コーディングに特化したMetaモデルであり、100万トークンのウィンドウ、OpenAI SDK互換のAPIアクセス、そして注目を集める「Contributor」ティアを備えています。 その最大の売りはコストパフォーマンスです。Contributorモデルでは、100万トークンあたり$0.10の入力コストと$0.20の出力コストを実現しています。このティアはMeta製品の改良に活用できる一方、より高価な標準モデルはその目的には使用されません。.
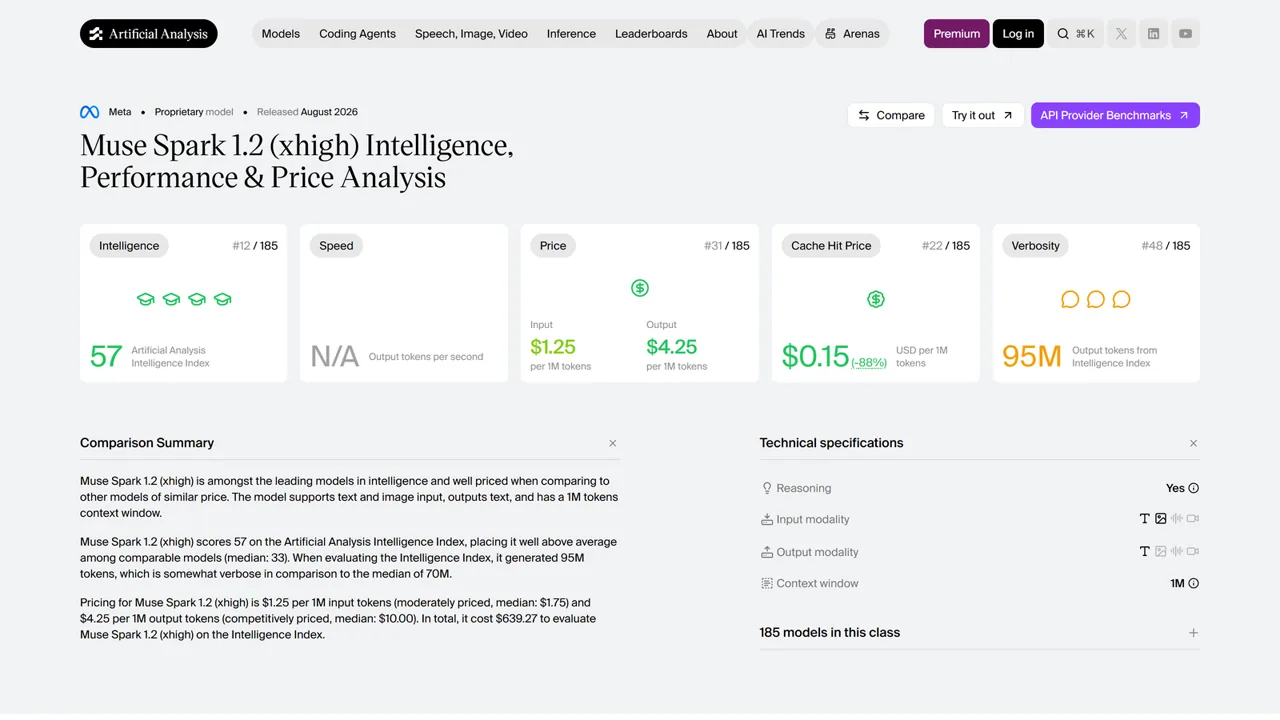
パフォーマンスに関する記述は、もう少し控えめにする必要がある。Metaによると、Muse Codeを搭載したMuse Spark 1.2のTerminal-Bench 2.1におけるスコアは82.9%、DeepSWEでは59.3%となっている。これらはMetaが実施したテスト結果である。 2026年8月26日時点で確認したところ、公開されているTerminal-BenchおよびDeepSWEのボードには、依然としてMuse Spark 1.2が掲載されていませんでした。. 人工分析 独立した裏付けとなる指標として、同モデルの「インテリジェンス・インデックス」は57を維持しており、同クラスのモデルの中央値である35を上回っている。.
- 今すぐ試してみるべき最大の理由は: 低価格のコントリビューター向けプラン、大規模なコンテキスト、そしてお馴染みの「OpenAI」クライアントパターンに準拠したAPI。.
- 慎重であるべき最大の理由: 3つの制御された基本モデルタスクだけでは、大規模な本番リポジトリ全体におけるMuse Codeエージェントの信頼性、ツール呼び出しの品質、あるいはパフォーマンスを立証することはできない。.
- 重要なプライバシーに関する選択: Metaの製品の改善に利用されたくないコードやプロンプトについては、標準モデルを使用してください。.
Muse Spark 1.2 の概要
確認済みの仕様
Metaは、Muse Spark 1.2について、Muse Spark 1.1に比べて初回試行でのコーディング精度が高く、ツールの呼び出しの信頼性も向上したモデルであると説明しています。これらは、 「Muse Spark」の公式モデルページ, 、私たち自身のコーディングセッションから導き出された結論ではありません。.
Muse Spark 1.2 対 Muse Code
Muse Spark 1.2 がそのモデルです。Muse Code は、そのモデルを基盤とする別のベータ版ターミナルエージェントです。. この区別が重要なのは、エージェントが、基盤となるモデルに対して、計画立案、ツールのオーケストレーション、リポジトリのナビゲーション、ワークツリーの分離、ロギング、および再試行動作を追加できるためです。.
レイヤーを分けておく
Muse Spark 1.2
コンテキスト、推論、APIの動作、トークン課金、出力、およびツール呼び出しの決定。.
モデルID1M コンテキストAPI価格
ミューズ・コード
ターミナルUX、サブエージェント、Gitワークツリー、イベントログ、フローの再開、バンドルされたスキル、およびオーケストレーション。.
エージェントのワークフローメタ実行システムの結果
について 「Muse Code」の公式ページ この製品を「ベータコーディング剤」と呼んでいる。そのため、観察されたワークフローの違いのすべてが単純なモデル呼び出しに起因するふりをするよりも、Claude CodeやCodexといった製品との比較を行うほうが有益である。我々の Codex と Claude のコード比較 これにより、モデルと同様に、周囲のエージェントも開発者の体験を大きく変える可能性がある理由が説明されています。.
Muse Spark 1.2 のベンチマーク:スコアが実際に示すもの
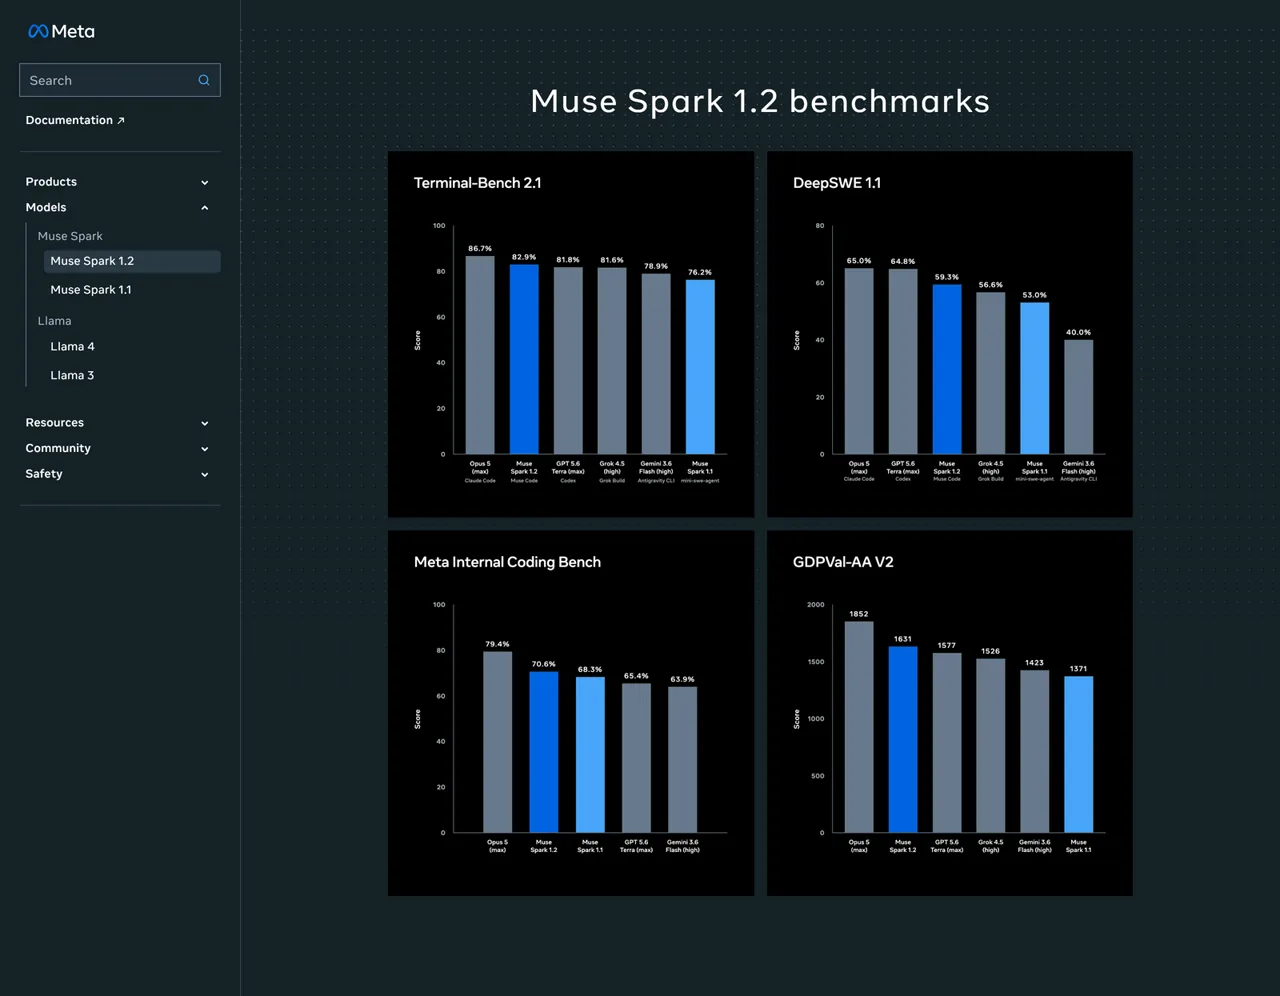
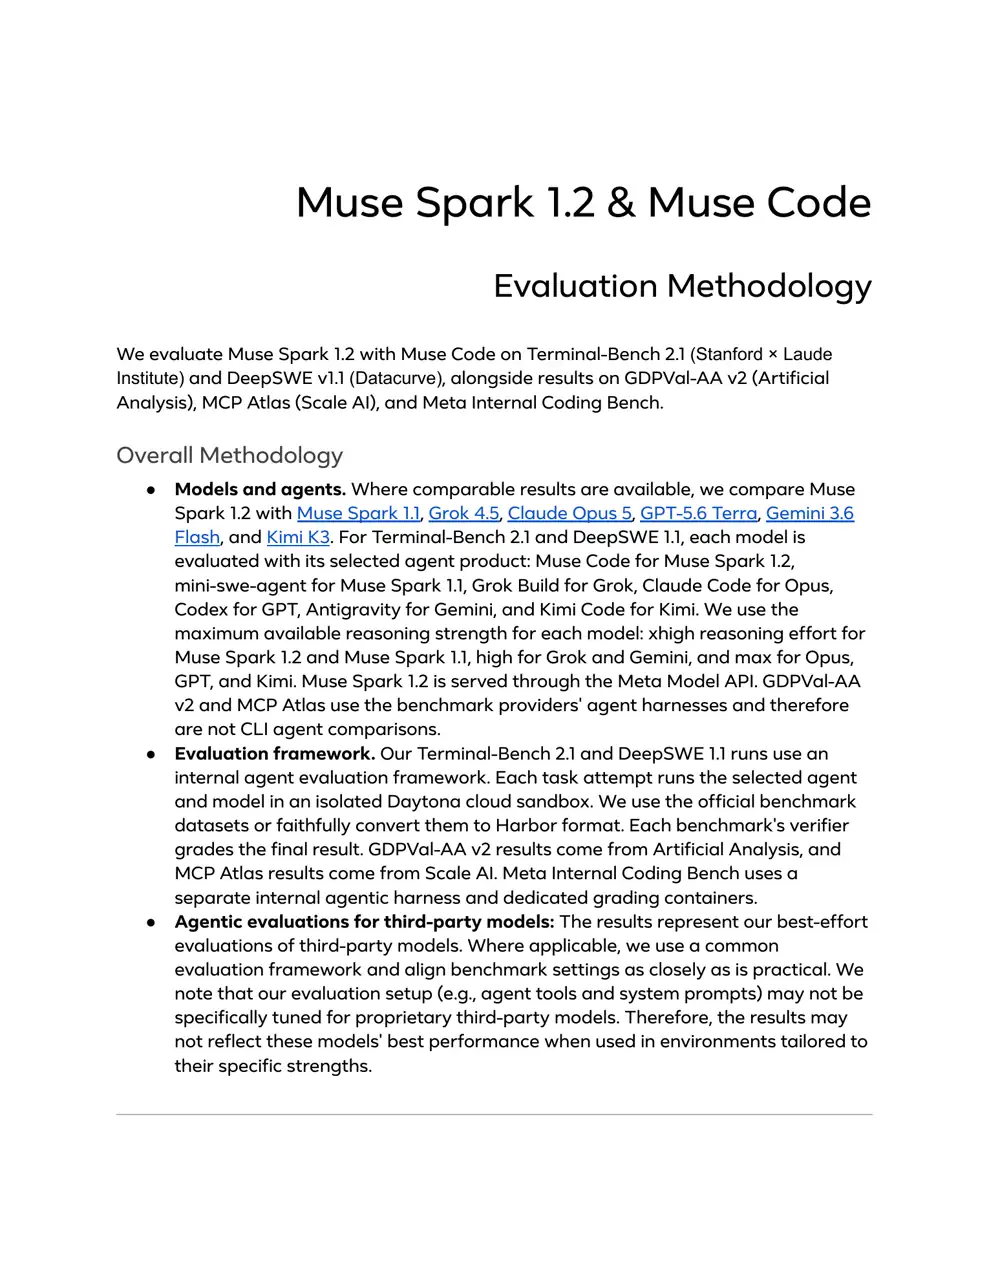
Metaのベンチマークチャートによると、Muse Spark 1.2はいくつかのコーディング評価において上位に位置しています。これらの数値は検討する価値がありますが、モデルの純粋な品質を示す単一の明確なランキングというわけではありません。モデル、エージェント、ハーネス、推論能力、タスクプロトコルは、すべて連動して変化する可能性があるからです。.
メタレポート版 Terminal-Bench 2.1
メタベンチマークパネル
ターミナル・ベンチ 2.1
全89のタスク・5回の試行でpass@1を達成・選定されたモデルとエージェントの組み合わせ
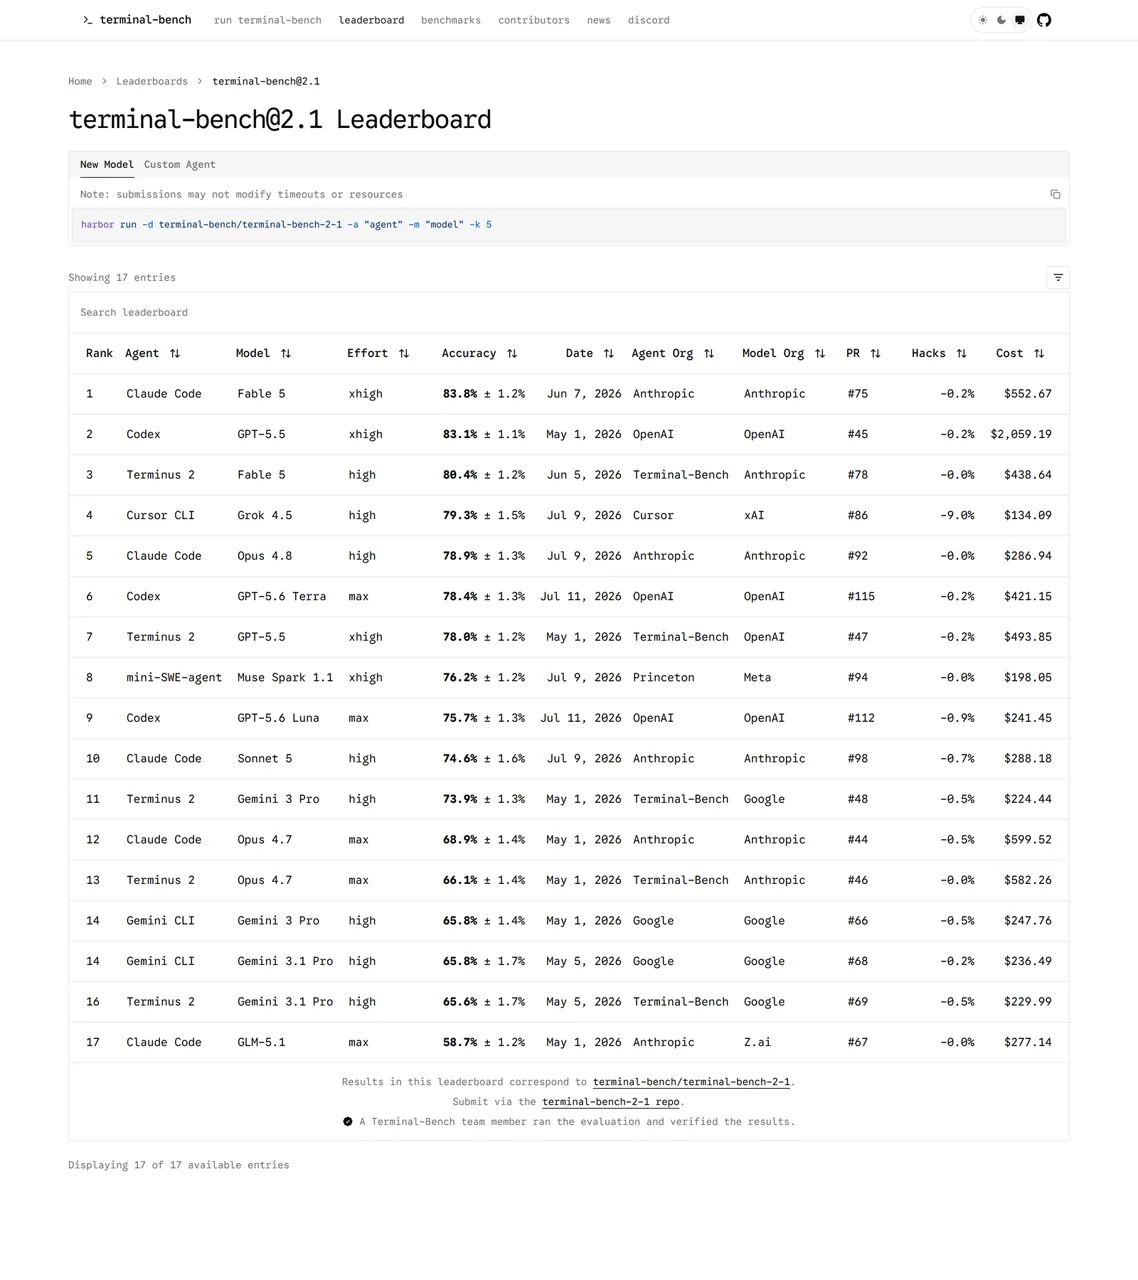
82.9%という数値は、 Meta-run Muse Code の結果. . public Terminal-Bench 2.1 ランキング 2026年8月26日には「Muse Spark 1.2」がリストに載っていなかったため、それは 認証されていない公開ランキングのエントリー. 公開ボードには、mini-SWE-agentを搭載したMuse Spark 1.1の性能が76.2% ±1.2%と記載されていた。.
DeepSWE 1.1 のメタレポート
メタベンチマークパネル
DeepSWE 1.1
113件のタスク・91のリポジトリ・5つの言語・5回の挑戦の末にpass@1を達成
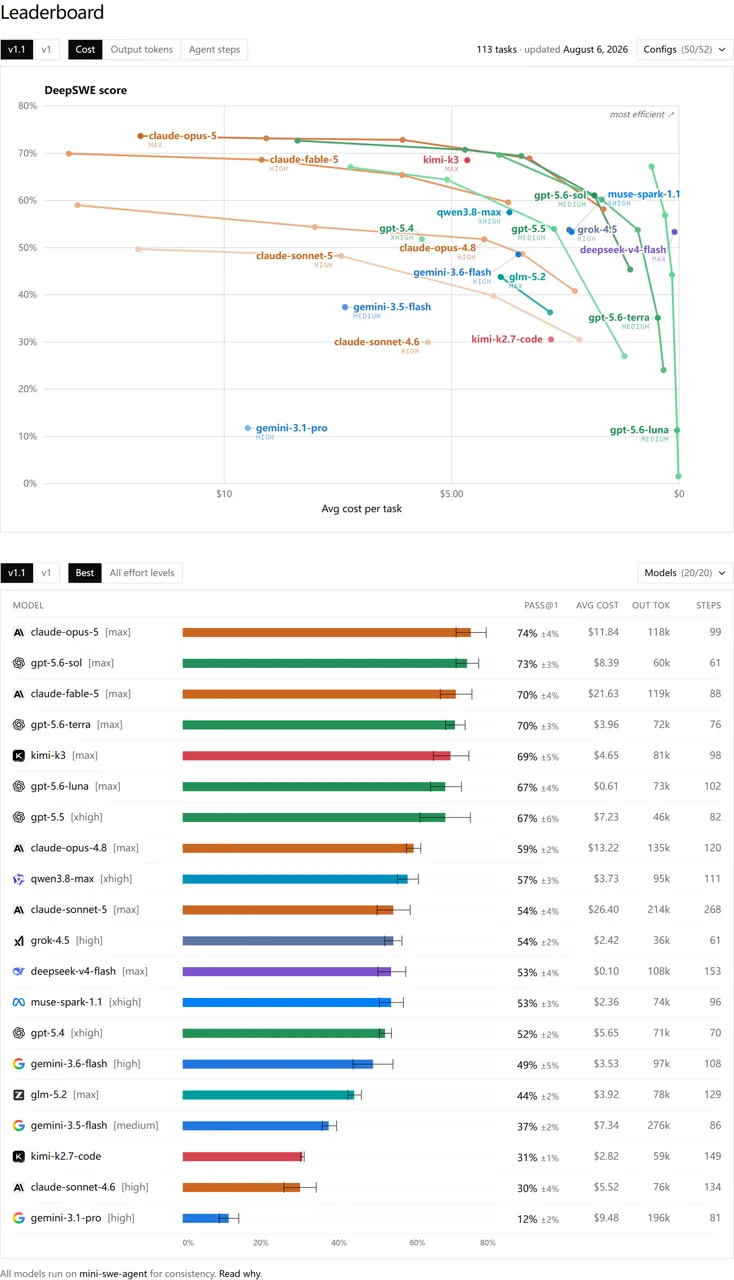
について 公開版 DeepSWE v1.1 リーダーボード 一貫性を保つため、掲載されている全モデルでmini-swe-agentを使用しています。確認時点では、Muse Spark 1.2は追加されていませんでした。Muse Spark 1.1のスコアは53%と記載されていました。Metaの59.3%という結果はMuse Codeを使用しているため、これら2つの数値はハーネスが同一ではありません。.
Metaの内部評価および汎用エージェントの評価
2つの異なる評価尺度
Meta社内コーディングベンチ
440件の内部タスク・各タスクにつき2回の挑戦
| モデル | スコア |
|---|---|
| 作品第5番 | 79.4% |
| Muse Spark 1.2 | 70.6% |
| GPT-5.6 Terra | 65.4% |
| Gemini 3.6 フラッシュ | 63.9% |
| Grok 4.5 | 表示されていません |
GDPVal-AA v2
一般的なエージェントタスクの評価 · Elo方式の値
| モデル | スコア |
|---|---|
| 作品第5番 | 1852 |
| Muse Spark 1.2 | 1631 |
| GPT-5.6 Terra | 1577 |
| Grok 4.5 | 1526 |
| Gemini 3.6 フラッシュ | 1423 |
Metaの 評価手法 Terminal-Benchは89のタスクすべてを処理し、5回の試行でpass@1を達成したと述べている。DeepSWEは91のリポジトリと5つの言語にまたがる113のタスクを網羅しており、こちらも5回の試行でpass@1を達成している。 また、Metaは、自社のセットアップがサードパーティ製モデルに対して最適に調整されていない可能性があることも指摘している。実際の製品決定に基づいて行われた最新の競合他社比較については、以下を参照のこと。 Claude Opus 5 対 GPT-5.6.
方法論が意味を変える
モデル+選定されたエージェント
89のタスク、5回の試行、推論設定の最大値が異なり、Metaのハーネスはサードパーティ製システムに対して均等に調整されていない可能性がある。.
確認済みの登録情報
確認したところ、Muse Spark 1.2 は含まれていませんでした。ボードの設定および検証状況については、Metaの表とは別に確認する必要があります。.
一般的なミニスウェエージェント
91のリポジトリにまたがる5つの言語で、計113件のタスク。Muse Spark 1.2は含まれておらず、Muse Spark 1.1は53%として記載されていた。.
人工分析:有用な独立した文脈
について 人工知能分析モデルのページ Muse Spark 1.2 の知能指数を 57, 、2026年8月26日時点での同クラスモデルの中央値である35を上回っています。 そのハーネスは、Terminal-Bench v2.1で80%、GDPVal-AA v2で正規化後57%、SciCodeで56%、AA-LCRのロングコンテキスト評価で83%を記録している。.
人工知能による分析におけるバージョンのドリフト
ここから得られる実用的な教訓は単純です。Muse Spark 1.2は競争力があるように見えますが、単一のスコアだけでこのモデルを評価することはできません。MetaのチャートはMuse Codeシステムの証拠として、公開リーダーボードは別の裏付けとして、そしてArtificial Analysisは独立した、ただし設定の異なる評価として捉えるべきです。.
Muse Spark 1.2:価格とプライバシーのトレードオフ
Metaは、価格が大幅に異なる2つのAPIモデルIDを提供しています。安価なオプションは単なる割引ではなく、送信されたデータの利用方法そのものが異なります。.
100万トークンあたりの米ドル · 1Mの文脈
製品の改善には使用されません
Metaの製品の改善には使用されません
より安価だが、データ通信量とのトレードオフがある
データ Metaの製品の改善に活用される可能性があります
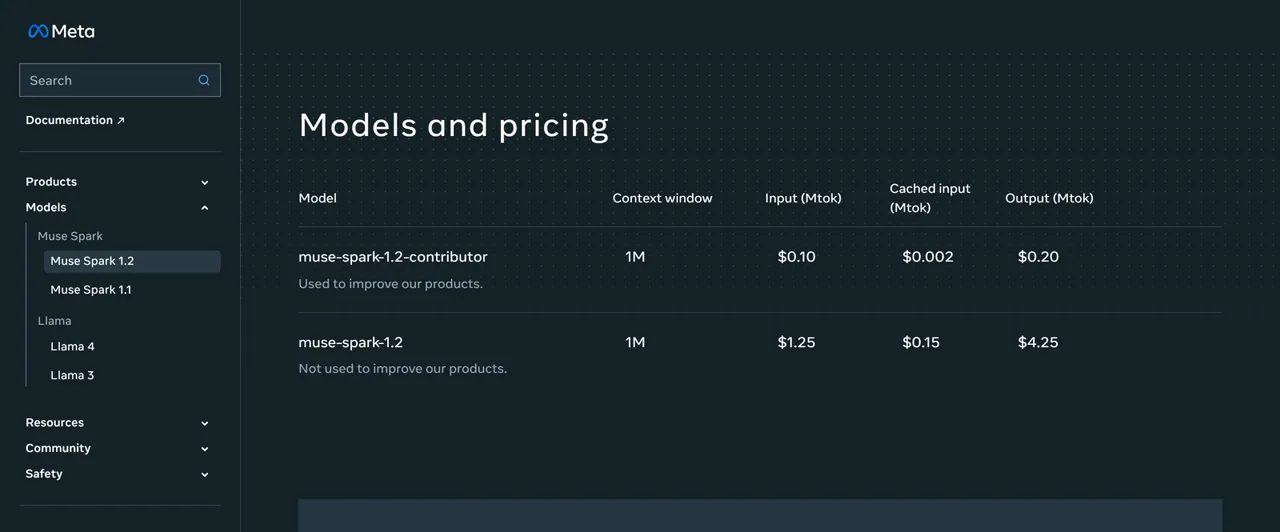
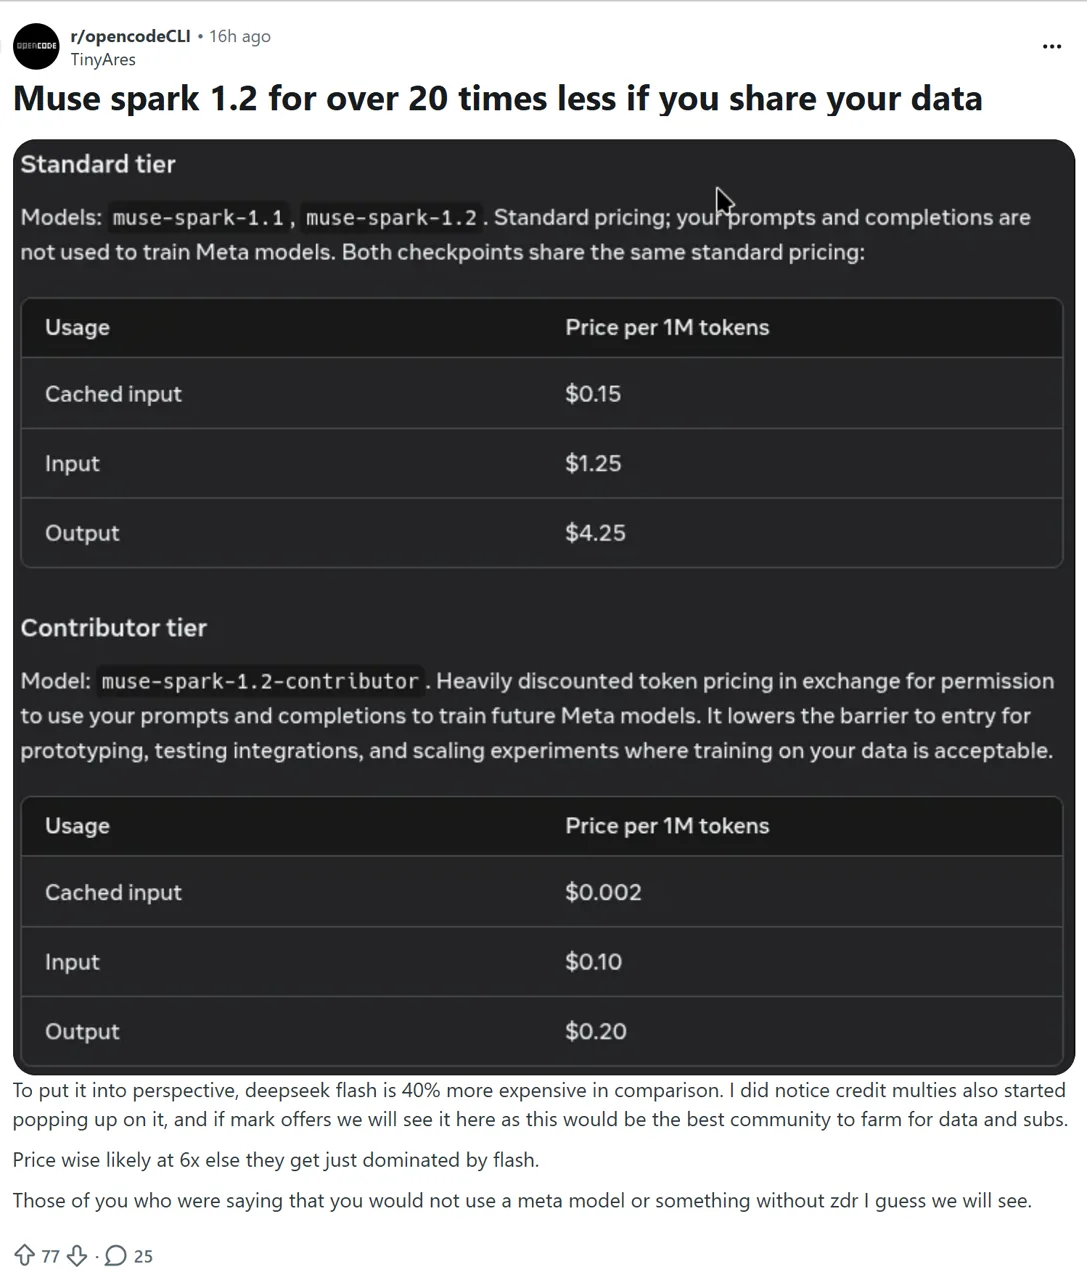
コントリビューター価格では、入力は標準プランに比べて12.5倍、キャッシュされた入力は75倍、出力は21.25倍安くなっています。すべてのトークンタイプを網羅する、単一の割引率というものは存在しません。.
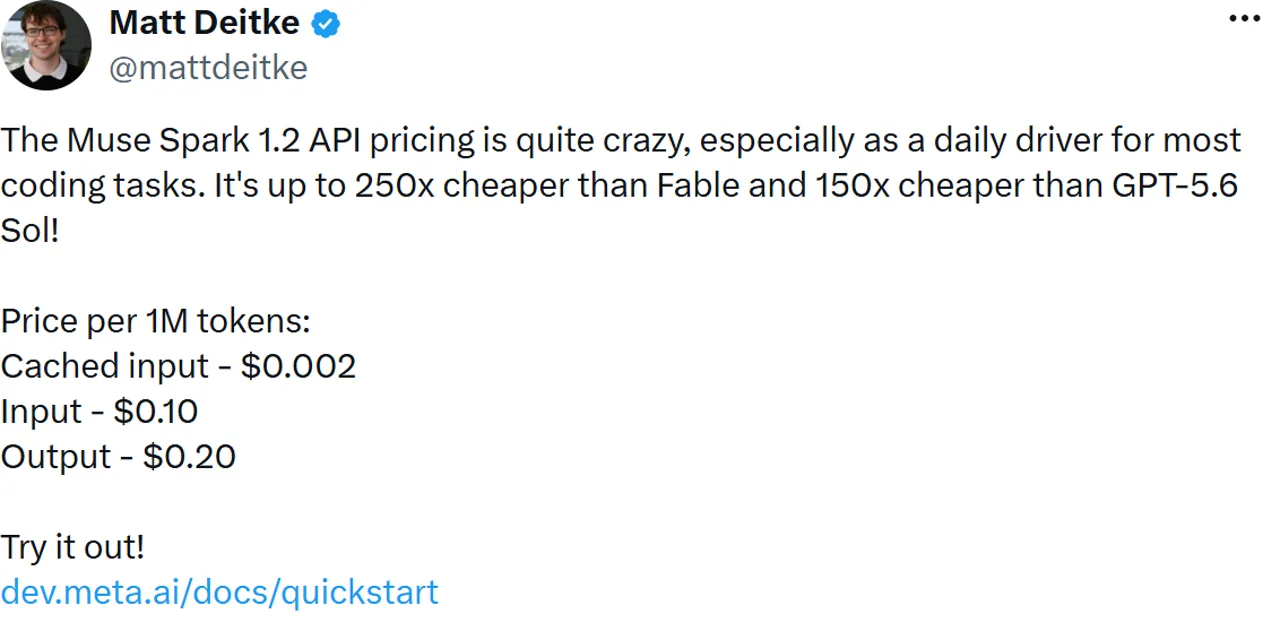
Metaの研究者は、Contributorティアについて、Fableよりも「最大250倍安い」、GPT-5.6 Solよりも「150倍安い」と宣伝した。その 社会的比較 標準モデルではなく「コントリビューター価格」を採用しており、常にデータ使用量の条件が付帯します。競合他社の現在のコストを比較したい読者は、当サイトの別の GPT-5.6 価格ガイド そして Claude コードの価格内訳.
パブリックリポジトリ、合成タスク、または使い捨ての評価用フィクスチャの場合は、「Contributor」ティアが適しているかもしれません。プライベートコード、顧客データ、認証情報、または独自のアーキテクチャについては、「Standard」ティアの方が安全なデフォルト設定となります。 また、Metaは、デフォルトのセルフサービス設定とは別のアクセス経路として、営業部門を通じて「データ保持期間ゼロ」の要請を受け付け始めたとも述べています。.
Muse Spark 1.2 の API アクセスとサンプル
3つの公式アクセスルート
公式レシピ本のベースURL: https://api.meta.ai/v1 ・1.2 本レビューにおける要請:未実施
について メタモデル API OpenAI SDK 互換のワークフローに対応しています。Meta の公式クックブックでは、ベース URL を使用しています https://api.meta.ai/v1 そして、以下の場所からキーを読み込みます。 MODEL_API_KEY. 。製品ページでは検索のグラウンディングについても解説されており、クックブックではチャットの自動補完、ストリーミング、ツール呼び出し、構造化出力、プロンプトのキャッシュ、推論制御、ビジョン、ロングコンテキスト、再試行、および検索レシピについて取り上げられています。.
公式レシピ本の例 — キャプチャ版: について 公式 GitHub クックブック 現在も使用している muse-spark-1.1. これはクライアントの構造とベースURLを確認するものであり、この例がバージョン1.2向けに更新されたことを示すものではありません。.
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.chat.completions.create(
    model="muse-spark-1.1",
    messages=[{"role": "user", "content": "Hello, world!"}],
)

print(response.choices[0].message.content)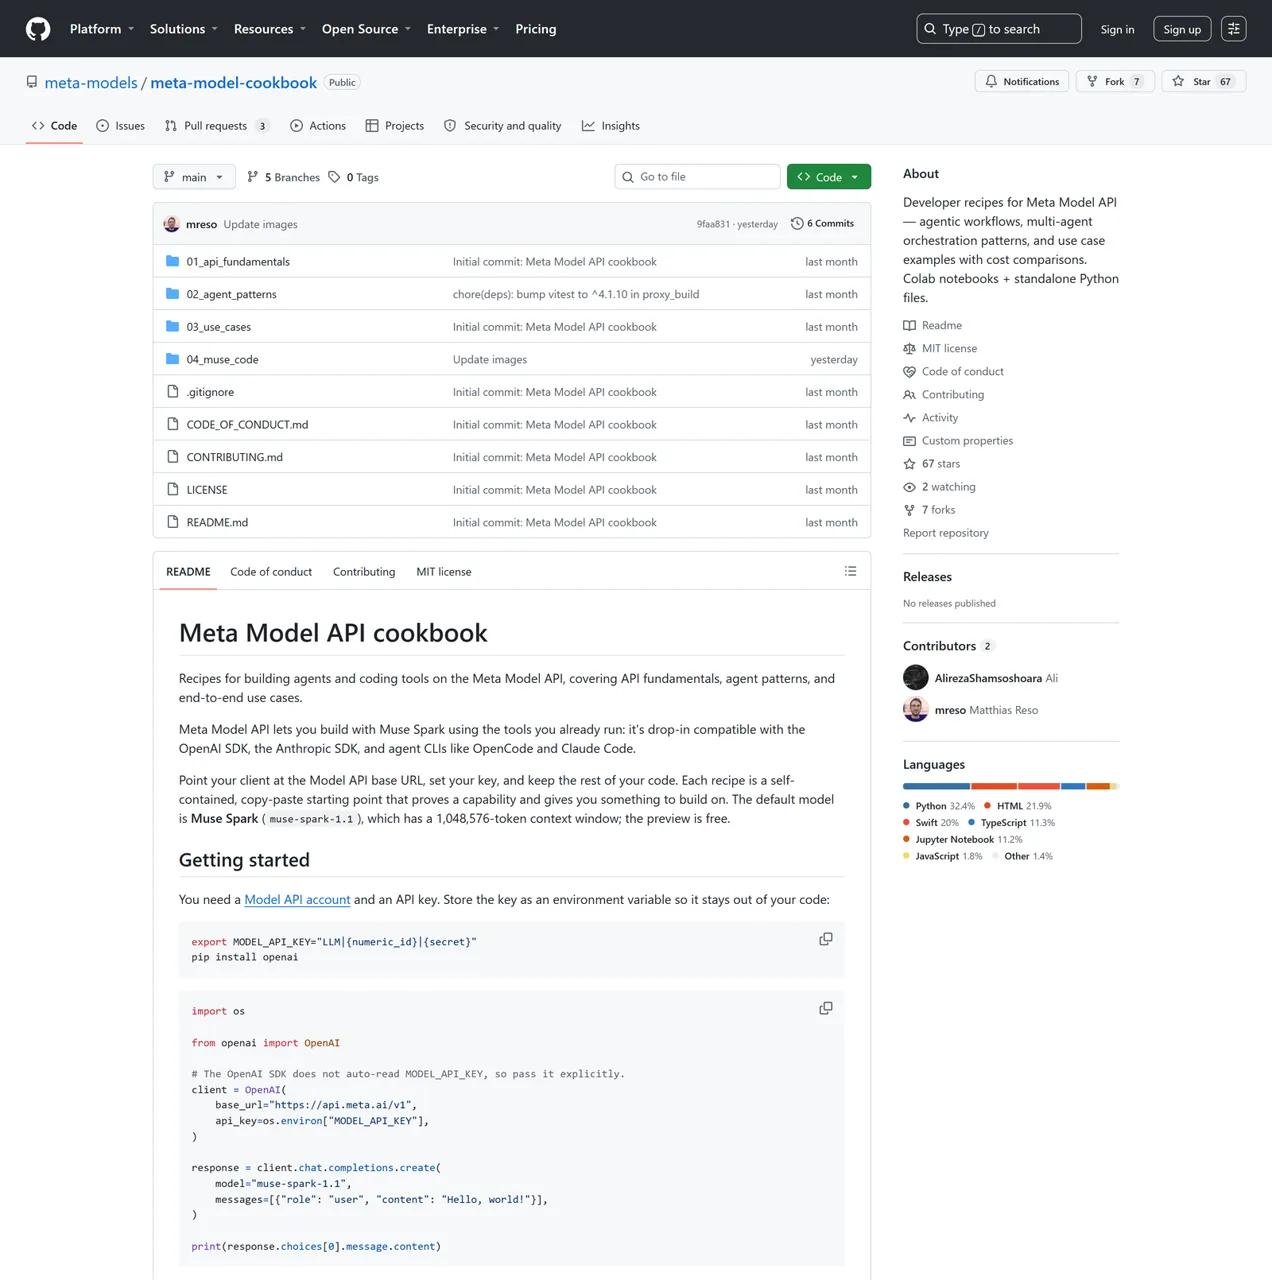
文書化された適応 — 実行されていない: Metaは別途、以下のように記載しています muse-spark-1.2 標準の1.2モデルIDとして。以下の最小限の置換は2つの公式な事実を組み合わせたものですが、今回のレビュー期間中には有料のリクエストは送信されませんでした。.
response = client.chat.completions.create(
    model="muse-spark-1.2",
    messages=[{"role": "user", "content": "Hello, world!"}],
)
Muse Sparkは推論モデルであり、 推論トークンは出力として課金されます. そのため、$4.25という標準出力レートは、一見したよりも重要な意味を持ちます。一見簡潔に見える回答であっても、その裏には重要な推論の仕組みが隠されている可能性があるからです。実際のレイテンシ、最初のトークンが返されるまでの時間、リトライ率、およびタスクごとのコストについては、ここではまだ測定されていません。.
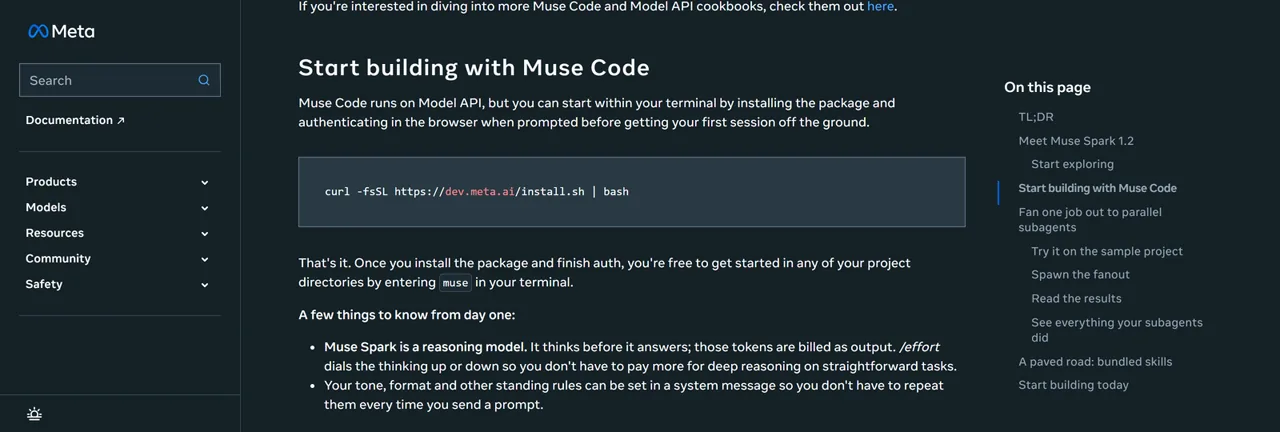
/努力 このコマンドは推論の深さを変更します。. 出典:Meta開発者ガイド.Muse Codeがもたらすもの
Muse Codeはターミナルからインストールされ、Muse Spark 1.2をエージェントワークフローに組み込みます。Metaの 開発者向け詳細解説 API呼び出しそのものには含まれないいくつかの挙動について説明しています:
- 並列エージェント: タスクは、分離されたGitワークツリー内で実行できます。.
- 追記専用イベントログ: セッションとアクションは、監査および再生のためにローカルのJSONLに書き込まれます。.
- フローの再開:
ミューズの履歴書中断したセッションを再開できます。. - 推論制御: the
/努力このコマンドは推論の強さを調整します。. - 具体的なスキル: メタ名
/味,/バーベキュー,/ドキュメント付きグリル, そして/plan.
エージェント製品の機能
サブエージェント
独立したタスクは、枝分かれすることがあります。.
ワークツリー
並行作業中は、ブランチは分離されたままになります。.
JSONL ログ
追加専用ローカルイベントはリプレイに対応しています。.
履歴書
ミューズの履歴書 中断されたセッションを続行します。.
スキル
/味, /バーベキュー, /ドキュメント付きグリル, /plan.
こうした機能セットにより、Muse Codeは、モデルの知能に加え、計画立案、隔離、リプレイ、ツールの規律が重要視される、より広範なコーディングエージェント市場においても重要な存在となっています。その OpenClaw 対 Claude:コード版とオープンコード版の比較ガイド こうした製品レベルの相違点を理解する上で、有用な背景情報となります。.
ローンチ時の主張と初期のコミュニティからの反応
反応は肯定ではない
トレーニング+長期的な視点
コーディング処理能力の向上、環境の多様化、共同トレーニング、そして1,000以上のツール呼び出しによるストレステスト。.
価格とOpenCode
あるRedditユーザーが、初期のプログラミング体験とその価値を称賛した。.
プライバシーと信頼性
他のユーザーからは、データ使用量、標準価格、入手可能性、および初期段階での信頼性について懸念が寄せられた。.
MetaのAI部門によると、Muse Spark 1.2では、コーディングトレーニング用の計算リソースが増強され、より多様な環境が導入されたほか、リポジトリ全体の生成とデバッグがより重視され、Muse Codeとの共同トレーニングが行われたという。別の スレッドを開始する NVIDIA Hopper GPU上で、1,000回以上のツール呼び出しを行う、最大24時間にわたるストレステストについて説明しています。.
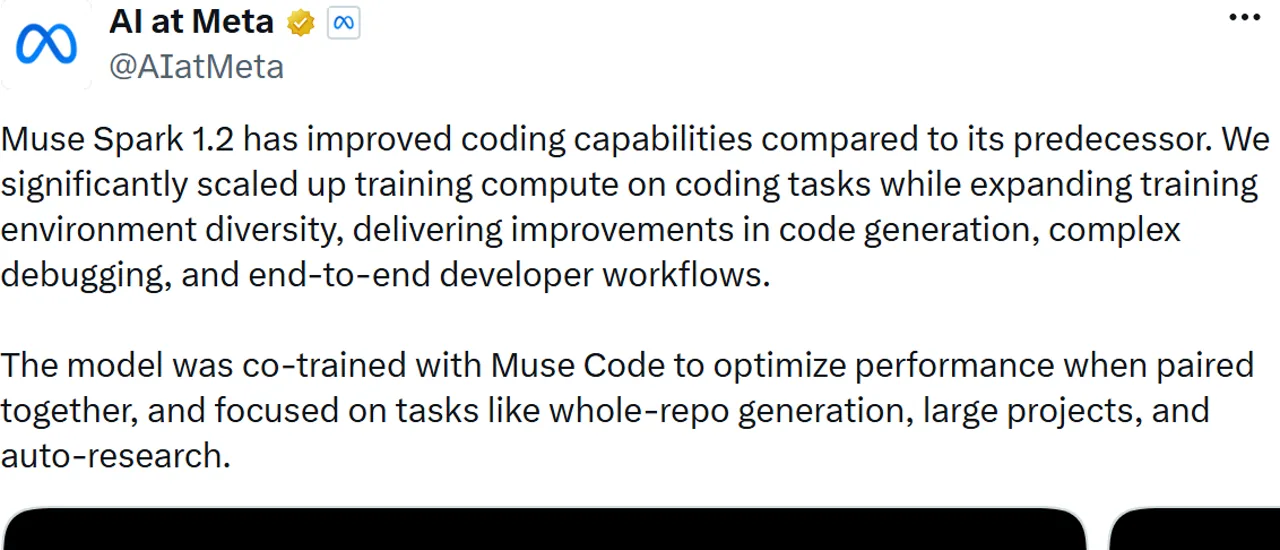
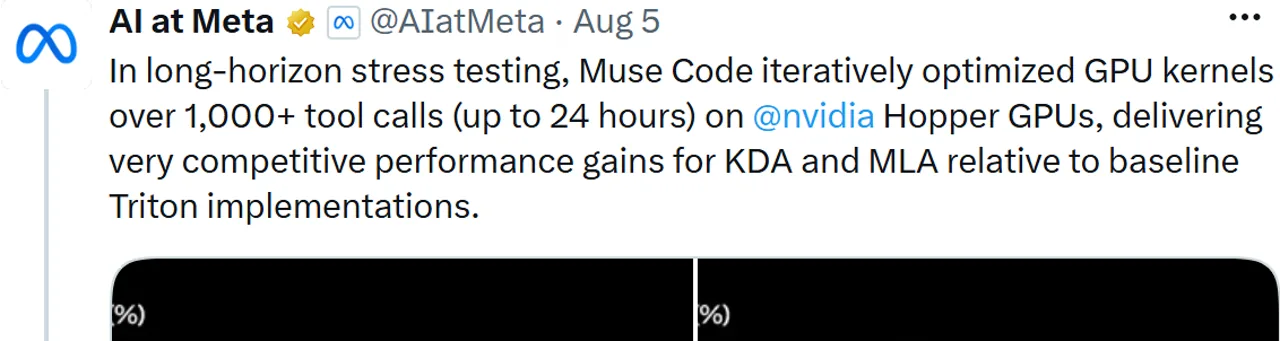
これは印象的なデモンストレーションですが、測定された一般的な成功率というわけではありません。エージェントが適切なツールを選択した頻度、エラーから回復した頻度、重複した呼び出しを回避した頻度、あるいは誘導なしに通常のリポジトリタスクを完了した頻度については、このデータからは分かりません。.
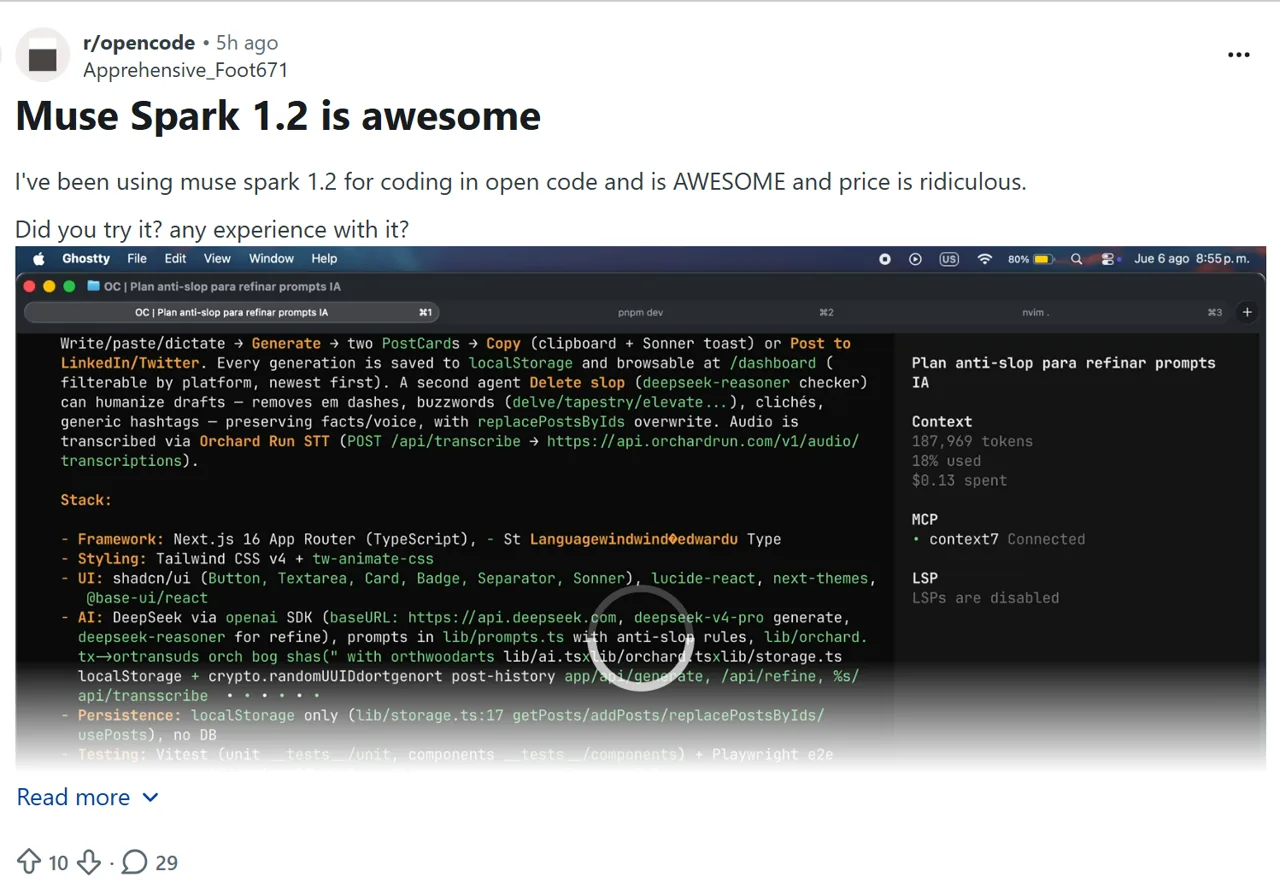
Redditの初期の投稿も同様に賛否が分かれている。ある投稿では r/opencodeのユーザーが、OpenCodeでの良い体験を報告しました そして、その価格を称賛した。別の 寄稿者への報酬に関する議論 データ使用量、スタンダードプランの料金、可用性、信頼性に関する疑問が提起された。これらは個々の反応であり、コミュニティ全体の合意ではない。.
Muse Spark 1.2 コーディングテスト:3つの課題すべてに合格
当社のテストでは、ベースモデルの「Muse Spark 1.2」が、OpenAI対応のチャット補完APIを通じて、3つの制御されたコーディングタスクを完了しました。. 各タスクには1回の試行が割り当てられ、再試行は0回、手動による介入も一切行われませんでした。一時的なリポジトリに返されたファイルについて、公開チェックおよび非公開チェックに基づいて評価を行いました。Muse Codeエージェントの実行およびツール呼び出しの信頼性についてはテストを行っていないため、これらの結果をエージェントのベンチマークとして解釈すべきではありません。.
1回の試行結果
回答には6,618個の推論トークンが使用された。3つの結論理由はいずれも以下の通りであった。 停止, 、また「プロバイダー」フィールドには「Meta」と報告された。.
テスト 1: Python の冪等性に関するバグの修正 — 合格
パブリックAPIを変更せずに、重複した転送を防止する
このモデルは、欠落していたリクエストIDガードを特定し、最小限の安全な修正を加え、アトミックな残高更新を維持したまま回帰テストを提供しました。.
元の隠し評価関数は、return 文を2回呼び出すよう誤って要求していました 偽, 、そのタスクでは送信者に二重に課金しないことだけが求められていたにもかかわらず。この架空の戻り値要件を修正したところ、変更を加えていない最初の応答が6つのテストすべてに合格しました。再試行やモデル出力の編集は行っていません。.
テスト 2: TypeScript の複数ファイルリファクタリング — 合格
検証、永続化、監査ログの分離
返されたファイルでは、パブリック・ルート・コントラクト、厳格なTypeScript、および注文と監査の書き込みの両方をカバーする単一のトランザクションが維持されました。また、ランタイムへの依存関係のない、的を絞った検証テストも追加されました。.
最初の評価者は、対象物を生のものと比較した JSON.stringify, そのため、キーの挿入順序が異なる同等のオブジェクトが異なるものとして扱われていました。そのWindows npx 起動も型チェックの前に失敗しました。順序に依存しない比較演算子とWindows対応のコマンド実行を使用した場合、元の応答はすべてのチェックに合格しました。ここでも、モデルによる再試行は行われませんでした。.
テスト 3: JSONL リポジトリ機能 — 合格
リポジトリ全体にわたる指示の順守
CSVの互換性を損なわずにJSONLを追加する
このモデルでは、拡張機能の検出、1を起点とする不正な行のエラー、アトミック出力、ドライラン時の安全性、重点的なテスト、ヘルプテキスト、およびREADMEのサンプルが実装されました。.
検査の結果は以下の通りです: Muse Spark 1.2 は、1回の実行で、実用的なマルチファイルパッチを生成し、互換性の制約を遵守し、テストを追加し、リポジトリ全体にわたる小規模な機能の処理を行うことができます。報告された平均コストはタスクあたり約 $0.0151 でしたが、これらのフィクスチャは小規模なものであり、大規模なコードベースのコストを予測するために用いるべきではありません。.
Muse Spark 1.2 はどのような方に適していますか?
意思決定ガイド
管理下での評価
公開コードまたは合成コード、測定可能なタスク、大規模なコンテキストへの対応、そして有望な3/3のベースモデル結果。.
エージェントの証明が必要
Muse Codeの動作、安定したレート制限、ツールの繰り返し呼び出し、あるいは広範なリポジトリのベンチマークなどが、判断基準となります。.
センシティブなコードまたは高出力
プライバシーや推論トークンのコストが主な要因となる場合は、標準ティアを使用するか、代替案を検討してください。.
組織が「コントリビューター規約」を別途承認していない限り、機密性の高いコードには標準モデルを使用してください。標準の出力価格が値の算出に影響を与える場合は、それを現在の値と比較してください。 コーデックスの価格設定, 、Claudeコード、およびその他のコーディング担当者の費用について、ワークフローを確定する前に確認してください。.
Muse Spark 1.2 レビューの総評
Muse Spark 1.2は、評価の最終候補リストに名を連ねたものの、自動的に本番環境での導入が推奨されるわけではありません。. 100万トークンの規模、馴染みのあるAPIの構成、コントリビューター向けの低価格設定、3回の初回コーディング試行、そしてMetaが実施したMuse Codeでの高スコアなど、これらを無視するのは難しい。また、Metaは方法論の詳細を公開する点においても、他の多くのローンチよりも優れた対応を見せている。.
注意点も同様に具体的です。コントリビューター価格には、データ使用量に関するトレードオフが伴います。標準的な出力トークンや推論トークンは、実際のコストを押し上げる可能性があります。 Metaが発表した最高記録は、公開されているTerminal-BenchやDeepSWEのボード上で同等の結果として再現されておらず、また、今回の実証サンプルはMuse Codeエージェントの実行ではなく、3つのベースモデルタスクを対象としています。.
賢明な方法は、影響の少ないコードを用いて、生の使用状況データとローカルでの検証結果を保存しながら、制御された環境下で試験運用を行うことです。測定されたコストとレイテンシを小規模タスクのサンプルとして扱い、本番環境での導入を決定する前に、自社のリポジトリサイズ、障害復旧、およびエージェントのワークフローについてテストを行ってください。.
Muse Spark 1.2 よくある質問
Muse Spark 1.2 とは何ですか?
Muse Spark 1.2は、Metaが2026年8月5日にリリースしたコーディングに特化したモデルであり、100万トークンのコンテキストウィンドウを備え、Muse Code、Meta Model API、およびOpenRouterを通じて利用可能です。.
Muse Spark 1.2 は Muse Code と同じものですか?
いいえ。Muse Spark 1.2 がモデルであり、Muse Code はその基盤技術を利用した別のベータ版ターミナルエージェントです。Muse Code には、サブエージェント、隔離された Git ワークツリー、イベントロギング、再開機能、バンドルされたスキルなどの製品機能が追加されています。.
Muse Spark 1.2 API の利用料金はいくらですか?
標準モデルのコストは、100万トークンあたり、入力$1.25、キャッシュされた入力$0.15、出力$4.25です。 Contributorモデルのコストは、入力あたり$0.10、キャッシュされた入力あたり$0.002、出力あたり$0.20です。.
Metaは、トレーニングにMuse Spark APIのデータを使用していますか?
Metaによると、スタンダード・ティアのデータはMeta製品の改良には使用されないとのことです。コントリビューター・ティアのデータはMeta製品の改良に使用される可能性があるため、組織が別途承認しない限り、プライベートまたはプロプライエタリなコードではスタンダード・ルートを使用する必要があります。.
Muse Spark 1.2は、Terminal-BenchやDeepSWEの公開リーダーボードに掲載されていますか?
2026年8月7日に確認したところ、どちらの公開掲示板にも掲載されていませんでした。Metaによると、Terminal-Bench 2.1(Muse Code使用)では82.9%、DeepSWEでは59.3%と報告されていますが、これらはMetaが実行した結果です。.
このレビューでは、Muse Spark 1.2の実機テストは行われましたか?
はい。3回の単回実行による基本モデルテストにおいて、Muse Spark 1.2は、Pythonのバグ修正、TypeScriptのリファクタリング、およびJSONLリポジトリ機能のテストに合格しました。平均レイテンシは12.98秒、報告された総コストは$0.045362でした。 Muse Codeエージェントおよびツール呼び出しの信頼性についてはテストされていません。.
開発者はどのようにしてMuse Spark 1.2を利用できますか?
Metaは、Muse Codeベータ版ターミナルエージェント、Meta Model API、OpenRouterの3つの方法を挙げています。公式のクックブックでは、ベースURLがhttps://api.meta.ai/v1であるOpenAI SDK互換のクライアントを使用しています。.