
簡単な答え: GPT-6 Lunaは、OpenAIが提供する、集中処理型の大規模タスク向けモデルです。 公式APIによると、スタンダード料金では入力トークン100万トークンあたりOpenAI0.10、出力トークン100万トークンあたり$0.50が課金され、コンテキストウィンドウは105万トークン、最大出力は12万8千トークンとなっています。 最も重要な検討点は、その回答が許容可能な総コストの範囲内で、タスクの要件を満たすかどうかです。.
OpenAIは、GPT-6 Lunaを「集中的な大量処理タスクにおいて最も効率的なモデル」と説明しています。この表現はプロバイダーによる位置付けであり、測定された品質スコアではありません。本レビューでは、公開されている仕様を購買およびアーキテクチャの意思決定に落とし込み、出典を明記した上で世間の反応を記録しています。 また、モデルID、実行経路、プロンプトセット、生出力、および使用状況を保持した状態で、3つの小規模なタスクを実行しました。タスクの結果は、公式のベンチマークではなく、1回の観測結果として以下に示します。.
ひとくちレビュー
公式価格表において、Lunaはコストを最優先した実用的な選択肢となっています。Solと同じ主要な仕様と出力上限を維持しつつ、トークン料金はSolの数分の1に抑えられています。そのため、特定の用途に絞った繰り返し利用には魅力的ですが、厳密なテストを行わない限り、低価格が必ずしも低遅延や高品質を保証するものではありません。.
最も有用な区別は、単に「賢い」か「速い」かという点ではありません。それはワークロードの特性です。GPT-6 Lunaは、同シリーズの他のモデルと同じ主要なコンテキストと出力の上限を備えていますが、その位置づけと価格を考慮すると、異なる運用ポイントが妥当となります。より広範な AIモデル選定ガイド そして コーディングに最適なAIモデル タスクが複数のプロバイダーにまたがる場合のガイド。.
GPT-6 Lunaの概要
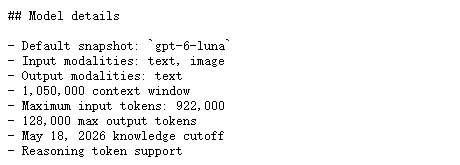
以下の表は、現在の GPT-6 Lunaの公式モデルページ. コンテキスト容量は、推奨されるプロンプトサイズとは異なります。また、最大入力サイズは、見出しコンテキストウィンドウとは別物です。.
gpt-6-luna両方の姉妹モデルは、ドキュメントに記載されている機能セットにおいて、構造化出力、関数呼び出し、ストリーミング、プロンプトのキャッシュ、画像入力、ファイル検索、およびウェブ検索に対応しています。ツールの具体的な動作は、エンドポイント、アカウント、およびリクエストの設定によって異なります。機能のチェックボックスが表示されているからといって、ツールが正常に実行されるとは限りませんのでご注意ください。.
家族レベルの文脈においては、 GPT-6 Astra レビュー 関連するGPT-6の記事では、プロバイダーのドキュメント、プラットフォームのルート、および属性付き反応がどのように区別されているかが示されています。.
GPT-6 Lunaの価格設定と「272Kルール」
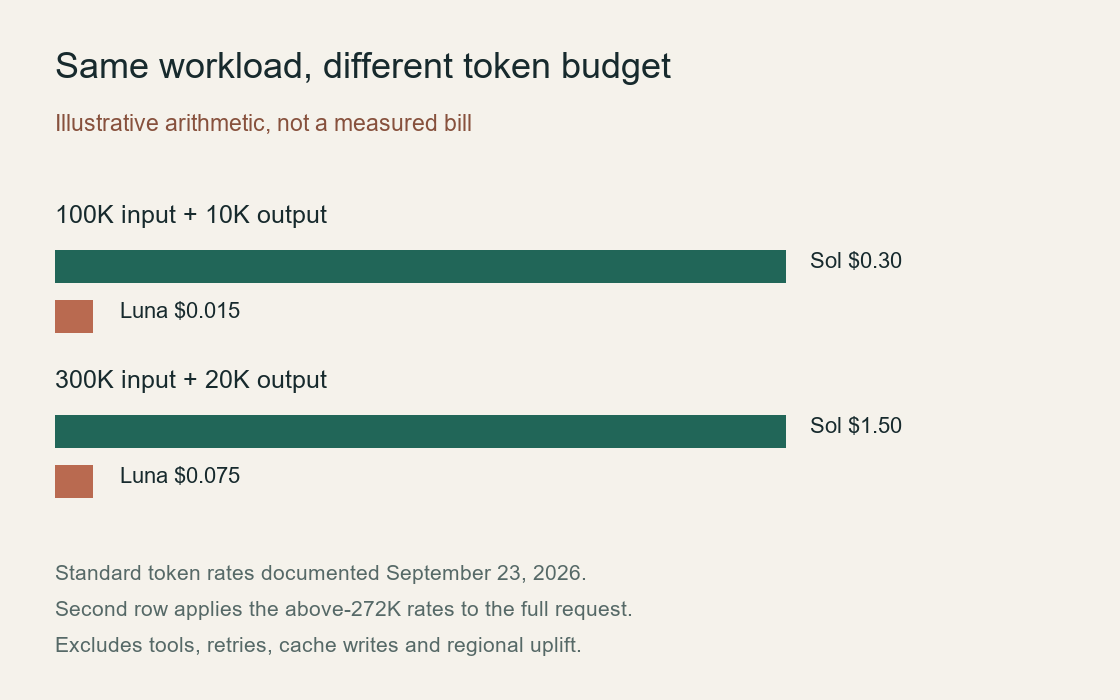
標準料金では、 OpenAIの価格ページ 100万トークンあたり、入力$0.10、キャッシュされた入力$0.01、キャッシュ書き込み$0.125、出力$0.50となっています。キャッシュ書き込みは、キャッシュされていない入力の1.25倍です。 BatchおよびFlexの価格はStandardで50%、Fastモードは適用レートの2倍、地域別処理が利用可能な場合は10%が追加されます。.
「ロングコンテキスト」の列は、OpenAIのルールに基づいて算出されています。具体的には、入力量が272Kを超えると、入力レートとキャッシュレートが2倍になり、リクエスト全体の出力レートは1.5倍になります。これは混合レートによる課金ではありません。 実用的な予算の基準として、入力100Kに追加で出力10Kの場合、コストは約 $0.015 ツールや地域的な地殻上昇の影響を受ける前の段階。入力30万、出力2万の例の場合、コストは約 $0.075 ロングコンテキストのレートで。.
大きなコンテキストウィンドウは、内容を埋めるのに手間がかからなくても役立つことがあります。検索、チャンクの選択、キャッシュの再利用、出力の上限といった要素は、表向きの「1.05M」という数字よりも重要です。詳しくは GPT-6 Astra の価格内訳 コンテキストしきい値やキャッシュの仕組みに関する説明については、こちらをご覧ください。.
GPT-6 Luna API の適合性、ツール、および制限事項
OpenAIでは、組み込みツールや関数呼び出しにはResponses APIの使用を推奨しています。Chat Completionsは、以下の場合にのみ関数呼び出しをサポートしています。 推論の努力 は次のように設定されます なし. これは、移行前に確認しておくべき実装上の詳細です。リクエストは構文的には正しいにもかかわらず、現在の統合環境が想定しているツールの動作と一致しない場合があります。.
現在のレート制限表には、以下のスタンダード階層が記載されています。RPMは1分あたりのリクエスト数、TPMは1分あたりのトークン数を指し、キューの値はバッチトークンの上限を表します。.
本番環境への展開前に、ご自身のアカウントで、正確なティア、エンドポイント、ストリーミングモード、およびツール契約を確認してください。 コーデックスの利用制限ガイド これは、モデルの公表されている上限額が、アカウントの実際の利用可能額と一致しない理由を理解する上で役立つ背景情報です。.
GPT-6 Lunaのスペックが示唆すること
これは適合マップであり、ベンチマークではありません。以下の オールインワンAIモデルのワークフローガイド 重要なのは、どの単一のモデルが最も説得力があるかということではなく、1つの反復可能なプロセスの中でどのようにモデルを切り替えるかということなのです。.
当社のテスト:3つの実用的なタスクにおけるGPT-6 Lunaの性能
2026年9月23日に、JavaScriptの軽微な修正、3項目の意思決定メモ、およびJSONの抽出についてテストを行いました。以下に示す保存された結果は、モデルIDに対する完全な応答です。 gpt-6-luna. 。これまでの試みでは一時的な過負荷エラーが発生していたため、これらの結果を「初回試行における信頼性測定」として解釈すべきではない。ここでは、回答の内容、読者が再利用できる部分、およびまだ検証されていない点について検討する。.
コードの修正:関数を書き換えずにゼロを保持する
このコーディング課題では、バグの診断、最小限のパッチ、および2つの回帰テストが求められました。ここに示されているのは、完了した再試行の結果であり、プロンプトの正確な文言は不明です。.
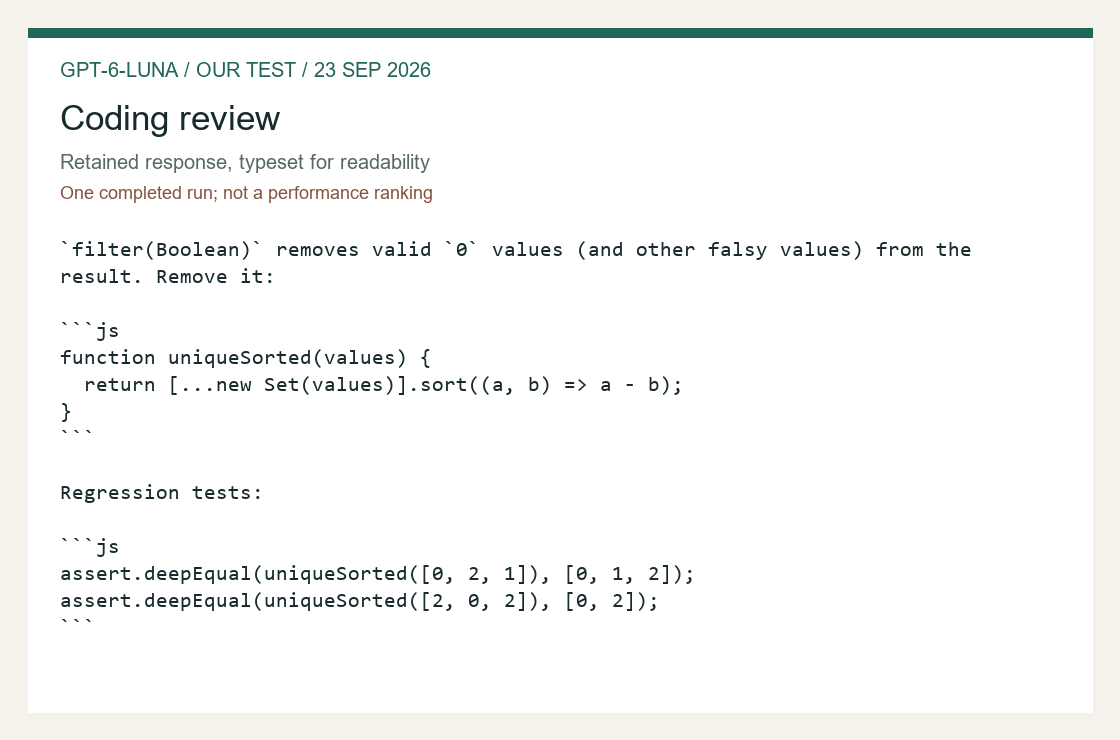
`filter(Boolean)` は、結果から有効な `0` の値(およびその他の falsy 値)を除去します。これを削除してください:

```js
function uniqueSorted(values) {
  return [...new Set(values)].sort((a, b) => a - b);
}
```

回帰テスト:

```js
assert.deepEqual(uniqueSorted([0, 2, 1]), [0, 1, 2]);
assert.deepEqual(uniqueSorted([2, 0, 2]), [0, 2]);
```
この完了した回答について報告された使用状況: 入力トークン 61 個、完成トークン 317 個、トークン合計 378 個. 補完結果には推論トークンが含まれる場合があり、単に表示されている回答の長さだけではありません。.
ルナの回答は、以下の点を正しく指摘していました。 filter(Boolean) 有効なゼロ値を削除し、その最終的な処理を取り除きました。この対応では、既存のセットベースの重複排除機能と数値比較演算子は維持されました。範囲が限定されたメンテナンスチケットにおいては、短い説明の後に具体的な関数が続くというこの出力形式は有用です。修正内容を曖昧にするような、不必要なAPIの再設計や新しいパッケージへの依存関係、あるいは無関係なフォーマット変更は一切行われませんでした。.
統合のギャップはテスト部分にあります。ルナは assert.deepEqual 2回実行しましたが、assertのインポートが含まれていませんでした。これらのステートメントを新しいNode.jsファイルに貼り付けると、どちらのアサーションも実行される前に失敗してしまいます。アサーション自体は、ゼロ、ソート、重複の関連する組み合わせを対象としていますが、この例は独立したテストケースではありません。 厳密なアサーションのインポートを追加するか、既存のテストランナーに合わせてステートメントを修正してください。これは些細な修正ですが、妥当なコードの解答と、実行可能な成果物とは異なる受け入れ基準であることを示しています。.
保存されたコーディング回答はリトライによるものです。以前の試行では出力上限の900トークンに達していましたが、完了したリトライではより短いプロンプトと1,200トークンの上限が使用されました。 再試行時の正確な文言は保存されていなかったため、この回答を生成したかのように元のコーディングプロンプトを提示することはしません。これにより、Solとの品質やレイテンシの直接的な比較が妨げられます。また、これは実用的な導入上の教訓にもなります。プロンプトのバージョンと完了理由を記録し、切り詰められた応答を成功したコードパッチとして決して扱わないようにしてください。.
3音の合成:決定を条件付きに保つ
以下の3つのメモを、決定事項、根拠、リスク、および次のステップを含む簡潔な意思決定メモにまとめなさい。注A:1.05Mトークンのコンテキストウィンドウは大規模なソースセットを収容できるが、すべてのリクエストのコストが低くなるわけではない。 注B:入力トークン数が272Kを超えると、文書化された入力/キャッシュ率が上昇し、リクエスト全体に対して出力が倍増する。注C:検索とキャッシュの再利用により、プロンプトの繰り返しコストを削減できるが、受け入れ基準については依然としてテストが必要である。.
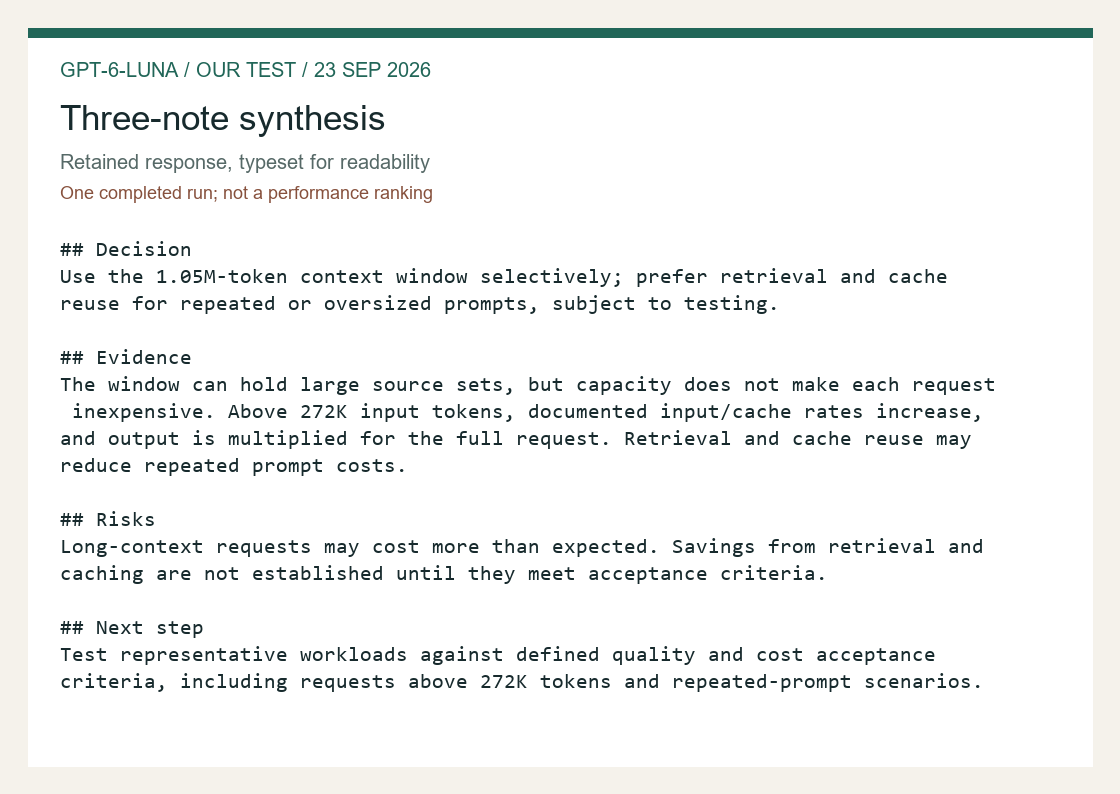
## 決定
1.05Mトークンのコンテキストウィンドウは選択的に使用すること。繰り返し使用されるプロンプトや容量の大きいプロンプトについては、テストの結果を踏まえ、検索およびキャッシュの再利用を優先する。

## 根拠
このウィンドウは大量のソースセットを保持できますが、容量があるからといって各リクエストのコストが安くなるわけではありません。入力トークン数が272Kを超えると、文書化された入力/キャッシュレートが上昇し、リクエスト全体の出力量が倍増します。リトリーブとキャッシュの再利用により、繰り返しのプロンプトにかかるコストを削減できる可能性があります。

## リスク
長文コンテキストのリクエストは、予想以上にコストがかかる可能性があります。検索およびキャッシュの再利用によるコスト削減効果は、許容基準を満たすまで確立されません。

## 次のステップ
272Kトークンを超えるリクエストやプロンプトの繰り返しシナリオを含め、定義された品質およびコストの許容基準に対して、代表的なワークロードをテストします。.
この完了した回答について報告された使用状況: 入力トークン 99 個、完了トークン 223 個、トークン合計 322 個. 補完結果には推論トークンが含まれる場合があり、単に表示されている回答の長さだけではありません。.
Lunaは、要求された4つのメモセクションをすべて維持し、その推奨事項をテストの結果次第とする条件を付けた。また、大規模なソースセットを保持することと、それを経済的に処理することとの区別を明確にした。さらに、検索とキャッシュによるコスト削減効果は、受け入れ基準を満たすまで確定しないとも述べた。 こうした慎重な姿勢は、定期的な内部要約において有用である。そうでなければ、魅力的な推奨事項も、数回の書き直しを経るうちに根拠のない約束になってしまう可能性があるからだ。.
このタスクには3つの短いメモが含まれており、報告されたプロンプトトークンはわずか99個でした。これを「長文コンテキストのベンチマーク」と呼ぶのは、実際の状況を過大評価することになります。 この実行結果から、Lunaはこの実行において、提供されたごくわずかな証拠パケットを整理できることが示されている。しかし、最大入力サイズに近い条件下での検索リコール率、文書網羅率、矛盾する指示への耐性、あるいは正しさについては、確立されていない。反復的な要約にこれを使用する前に、日付が矛盾しているケースや所有者が不明なケースを含め、最終的な表現において不確実性が残っていないかを確認する必要がある。.
JSONの抽出:未知の要素を明示的に扱う
この概要から以下のフィールドを抽出し、キーとして「customer」、「priority」、「deadline」、「unknowns」のみを含む有効なJSONを返してください。概要:顧客:Northwind Labs。優先度:高。期限:2026-10-04。担当者の氏名は記載されておらず、予算も確定していません。.
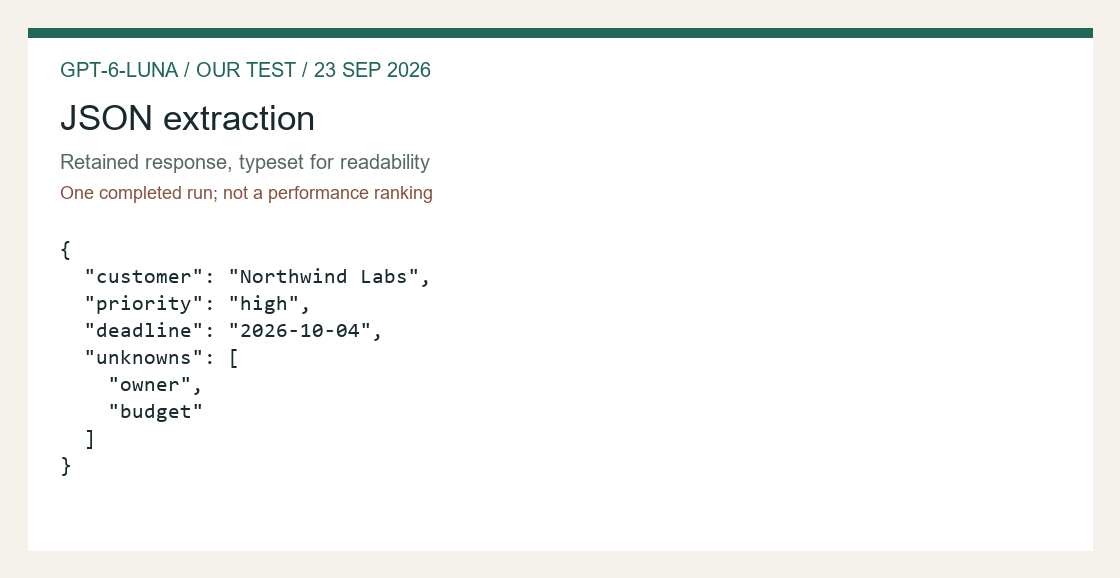
{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}この完了した回答について報告された使用状況: 入力トークン 64個、補完トークン 63個、トークン総数 127個. 補完結果には推論トークンが含まれる場合があり、単に表示されている回答の長さだけではありません。.
この少数のサンプルにおいて、反復性の高い限定的な作業にLunaを採用すべき最も説得力のある具体的な理由は、そのデータ抽出機能にある。Lunaは、要求されたキーを含む有効なJSONを返し、Northwind LabsおよびISO形式の期限を正しく転記し、所有者と予算については「不明」として保持した。 削除すべき会話形式のプレフィックスは存在しませんでした。Solも同一の抽出プロンプトに対して全く同じJSONを生成したため、現時点の証拠からは、この記録に関してより高価なモデルに優位性があるとは示されていません。.
構文上の妥当性は、あくまで最初の関門に過ぎません。JSONパーサーは、架空の所有者や間違った顧客、あるいは一見有効に見えるが実際には誤った日付であっても、問題なく受け入れてしまいます。 スキーマはフィールドや型を制限することはできますが、内容がソースに準拠していることを証明することはできません。このタスクにおいては、3つの既知の値を要件定義書と照合し、2つの欠落フィールドが依然として不明であることを確認することで、意味論的なチェックポイントを提供します。大規模な処理においては、ルート間の競合や不確実な日付については、推測して修正するのではなく、レビューに回すようにしてください。.
解析可能なJSONの範囲を超える妥当性チェック
以下は、編集上の検証例であり、追加のモデル応答ではありません。これはNode.js上でローカルに実行され、モデルへのリクエストは行いません。これは、前述の特定のフィクスチャを検証するものであり、モデルに対する一般的な評価ではありません。.
const assert = require('node:assert/strict');
const response = '{"customer":"Northwind Labs","priority":"high","deadline":"2026-10-04","unknowns":["owner","budget"]}';
const value = JSON.parse(response);
assert.deepStrictEqual(Object.keys(value).sort(), ['customer','deadline','priority','unknowns']);
assert.equal(value.customer, 'Northwind Labs');
assert.equal(value.priority, 'high');
assert.equal(value.deadline, '2026-10-04');
assert.deepStrictEqual(value.unknowns, ['owner', 'budget']);
console.log('このフィクスチャは要件に合致しています。新しい入力には、それぞれ独自の期待値が必要です。');
バリデータは、キーセットだけでなく、期待される事実も意図的にチェックします。有効なJSONでありながらも、「confident owner」フィールドが追加されたり、日付が変更されたりしたレスポンスは拒否されます。これらの正確な値はこのフィクスチャに固有のものであり、本番環境のバリデータは、すべての顧客に対してNorthwind Labsをハードコードするのではなく、入力契約から期待値を取得する必要があります。 カレンダーの検証とレコードの更新権限は、別々のチェック項目です。この例に合格したということは、返された回答がこの要件に合致していることを意味するものであり、将来のすべての抽出が正しいことを保証するものではありません。.
GPT-6 Lunaが実際のワークフローをどのように変えるか
主要な仕様が重要となるのは、それがチームの働き方に変化をもたらす場合のみです。GPT-6 Lunaは、集中的な大量処理タスク向けに設計されているため、まず検討すべきは、自社のワークロードがその特性から恩恵を受けられるかどうかです。 すべてのリクエストが短い入力、限定的な出力仕様、明確な受け入れテストを備えている場合、そのモデルは反復可能なパイプライン内に組み込むことができます。一方、タスクが曖昧であったり、ツールの使用が頻繁であったり、数回の修正が必要になる可能性が高い場合は、モデル名と同様に、それを取り巻くオーケストレーションも同様に重要になります。.
GPT-6 Luna の場合、有用な生成パターンとして「2段階処理」が挙げられます。まず、不確実性を明示した簡潔な回答を求め、次に、議論の余地がある部分や不完全な部分のみを2段階目の処理に送ります。 これにより、無駄な出力トークンを抑え、失敗を可視化できます。また、GPT-6 Solとの比較基準も明確になります。重要なのは、どちらの名前がより力強く聞こえるかではなく、再試行の回数が少ない方で受け入れ基準を満たせるルートがどれかということです。.
出荷前のシンプルなコストモデル
公式の価格表は、チームが実際に購入する単位、すなわち「1日あたりのリクエスト数」、「平均入力トークン数」、「キャッシュされたプレフィックスのシェア」、「出力トークン数」、および「入力数が272Kを超える呼び出しの割合」に合わせて換算する必要があります。見出しの入力価格のみを追跡するスプレッドシートでは、長期的なコンテキストによる乗数やリトライのコストが見落とされてしまいます。.
この計算は、GPT-6 LunaとGPT-6 Solを比較する際に特に重要になります。安価なリクエストでも、修復処理を繰り返し行う必要があればコストが高くなってしまう可能性があります。一方、処理能力の高いリクエストであっても、タスクが確定的な抽出である場合には無駄になる可能性があります。適切なベンチマークとなるのは、同じプロンプト、同じスキーマ、同じレビュールールを使用した、自社のトラフィックの小さなサンプルです。.
導入前に確認すべき故障モード
モデルページでは、どのエンドポイントやモダリティがドキュメント化されているかを確認できますが、移行後も既存のアプリケーションが同じように動作することを保証するものではありません。ストリーミングイベントが正しく解析されているか、ツールの呼び出しでリトライ後も状態が保持されているか、構造化された出力が形式不備のフィールドを拒否しているか、そしてロギングパイプラインがすべてのリクエストについてモデルIDと推論設定を記録しているかを確認してください。.
こうした基準があるからこそ、本レビューにおける実地検証の結果は、単なるランキングにはならず、有益なものとなっています。3つのタスクを通じて、このルートが、小さなコードの欠陥、意思決定メモ、および厳密なJSON抽出にどのように対処したかを示しています。ただし、これらのタスクは、レイテンシや大規模環境での信頼性、あるいは普遍的な品質ランキングを確立するものではありません。.
実際のチームのための意思決定フレームワーク
モデルレビューは、制約条件下で意思決定を行う際に役立つものです。GPT-6 Lunaの場合、最も関連性の高い制約条件は、リクエストの形式、レビューコスト、コンテキストのサイズ、出力形式、そして誤った回答がもたらす結果です。 プロバイダーの説明は、焦点を絞った大量処理タスクを想定しているようですが、チームとしては、その説明を監視可能な実行手順に落とし込む必要があります。まず、その業務を一文でまとめ、モデルが受け取る入力、別のシステムが期待する出力、そして気付かれないミスを防ぐための人的チェックポイントを書き出しましょう。.
最初の過ちは、デモのプロンプトからモデルを選んでしまうことです。デモでは流暢さが重視され、再試行、トークン管理、ツールの権限、スキーマエラーといった運用上の詳細が隠されています。 より適切な比較を行うには、3つの代表的なジョブを使用します。1つは通常のリクエスト、1つは困難なリクエスト、そしてもう1つは拒否またはエスカレーションすべきリクエストです。その結果は単一のスコアではありません。それは、モデルがどこで時間を節約できるか、どこで監督が必要か、そしてどこで別のモデル(多くの場合GPT-6 Sol)の方がコスト効率が良く、あるいは安全に適しているかを示す小さなマップなのです。.
まずは受け入れテストから始めましょう
プロンプトを作成する前に、受け入れテストを作成してください。コードの場合、テストとは、パスするユニットテストや、パブリックAPIを変更しないパッチなどが該当します。データ抽出の場合、必要なキーがすべて含まれ、未知の値が明示的に保持された有効なJSONなどが該当します。意思決定メモの場合、根拠、リスク、担当者、次のステップが記載された固定の構造などが該当します。 モデルは、明確な目標に対してのみ評価することができます。その目標がなければ、洗練された文章であっても、下流のプロセスで必要とされる1つのフィールドが知らぬ間に省略されているにもかかわらず、一見成功しているように見えてしまう可能性があります。.
優れた受け入れテストとは、自動実行できるほど範囲が絞り込まれており、かつユーザーを保護するのに十分な意味を持つものである。また、不一致の原因が明確に把握できるものでなければならない。2つの出力が異なる場合、チームは、欠落している事実、根拠のない仮定、形式不備のフィールド、あるいは誤った計算などを具体的に指摘できるべきである。これは、ある答えが「より賢明に感じられた」と言うよりも、はるかに具体的な対応策につながる。 また、これは、調達に役立つレビューと、単にリリース時の文言を繰り返すだけのレビューとの違いでもあります。.
モデル名に基づいて、初期仮説を選択します。受け入れテストを用いて、その仮説が本番環境での運用に耐えられるかどうかを判断します。.
モデルのプロファイルに合ったプロンプト設計
同じプロンプトを、モデルごとにそのままコピーして使用すべきではありません。タスクの契約内容は一定に保つことができますが、コンテキストの量、推論の指示、および出力の制約は、そのルートに合わせて調整する必要があります。 GPT-6 Luna の場合、システム指示は、ソース資料と競合しない程度に短く保つようにしてください。役割、決定ルール、必要な出力の形式、および明示的な未知数やエスカレーションを必要とする条件を明記してください。.
長い文書の場合は、情報抽出と推論を分けて行う。まず、質問に答える箇所を特定し、次に、それらの箇所と提示された基準のみを用いて結論を導き出す。これにより、文脈から離れた無関係な詳細に基づいて、確信に満ちた文章が構築されてしまう可能性を低減できる。また、これにより、1.05Mトークンのコンテキストウィンドウがデフォルトではなく、あくまでツールとして機能するようになる。 広範囲のコンテキストは、離れた位置にある証拠間の関係が重要となる場合に価値があります。一方、適切に選択された少量の証拠群で課題を解決できる場合には、広範囲のコンテキストは無駄になります。.
ツールを使用するワークフローについては、モデルとツールの境界を明確に定義してください。モデルは、ツールが必要かどうかを判断し、厳格なスキーマに従って引数を指定し、返された値をどのように処理するかを説明する必要があります。 アプリケーションは、権限の適用、引数の検証、呼び出しの記録を行い、ツール呼び出しが失敗した場合に再試行可能かどうかを判断する必要があります。モデルをアプリケーション全体として扱うと、デバッグが困難になり、誤った仮定による影響範囲が拡大してしまいます。.
4つの要素からなる再利用可能なプロンプト
コンテキスト その課題に必要な事実や資料のみを提示してください。. ゴールだ: その決定や変化を1文で述べなさい。. 制約条件: フォーマット、除外項目、不確実性の取り扱い、およびツールの制限を指定します。. 確認: モデルに、回答を確定する前に、不足している入力や矛盾点を列挙するよう依頼します。この構造は、繰り返し呼び出しを行うのに十分なほど簡潔であり、モデル間で比較を行うのに十分なほど明確です。.
大きなコンテキストウィンドウが役立つ場合
「1.05Mトークン」という見出しは、口に出して言いやすく、誤解されやすいものです。コンテキストウィンドウは、1回のリクエストにどれだけのデータが収まるかを示すものであり、どれだけのデータを送信すべきか、モデルが各パッセージをどの程度有効に活用するか、あるいはそのリクエストにどれだけのコストがかかるかについては示していません。 リクエストが長いと、チームが確認すべき証拠が増え、指示の微妙な矛盾が生じる余地も広がるため、レビューの速度が低下する可能性があります。.
タスクが本当に遠隔の参照に依存している場合は、フルウィンドウを使用してください。例えば、定義と例外が分離された契約、インターフェースと実装が遠く離れているリポジトリ、あるいは答えを見つけるために一連の流れをたどる必要がある長い研究アーカイブなどが該当します。質問が局所的な場合、ソースセットが頻繁に変化する場合、あるいはコンパクトな引用履歴を残したい場合は、検索機能を使用してください。 多くのリクエストで安定したプレフィックスが再利用され、プラットフォームがキャッシュが機能していることを証明するのに十分な使用詳細を提供している場合は、キャッシュを使用してください。.
272Kという閾値は、価格設定に関する段落の脚注ではなく、アーキテクチャ図に明記されるべきです。この閾値以下であれば安全なリクエストでも、閾値を超えるとコストが大幅に高くなる可能性があります。 各チームは、入力トークン、キャッシュされたトークン、出力トークン、モデルID、推論設定、およびリクエストが閾値を超えたかどうかをログに記録すべきです。このログは、実際のコストモデルを裏付けるものであり、予期せぬコンテキストの肥大化が毎月の予想外の請求となる前に、それを発見することを可能にします。.
ステージング環境での実行が推奨されるAPI移行に関する質問
既存の統合をGPT-6 Lunaに移行する前に、匿名化された少量のサンプルを再生するステージング・ハーネスを構築してください。生成されたテキスト、構造化フィールド、ツール呼び出し、停止理由、およびトークンの使用状況を比較してください。 レスポンスの最初の画面のみを比較してはいけません。モデルは、フィールド名を変更したり、エラー条件を省略したり、アプリケーションが安全に実行できないツール引数を返したりしながらも、表示される結論は維持している可能性があります。.
統合計画において、「応答」と「チャット完了」は互換性のないラベルです。エンドポイントのサポート、推論設定、ツールの動作、ストリーミングイベント、エラーオブジェクトはすべて、アダプターに影響を与えます。モデル ID は設定で固定しますが、ログやテストレポートでは表示されたままにしておきます。 リクエストが失敗した場合、そのレコードにはエンドポイント、モデル、推論の負荷、プロンプトのバージョン、リクエストサイズ、および再試行の決定が表示される必要があります。この証拠があれば、エンジニアは「単にモデルの調子が悪かっただけなのか」という議論に終始することなく、障害を再現することができます。.
バッチ処理は、コスト面や業務のリズムに変化をもたらします。夜間に行う分類作業、文書の作成、あるいは緊急性の低い変換処理のキューなどには適している場合があります。一方、ユーザーへの応答を必要とする対話型の操作には不向きです。 「高速モード」や「地域モード」も価格計算に影響を与えます。これらを明確な設定オプションとして扱い、デフォルト設定に埋もれさせるのではなく、予算ワークシートに反映させてください。.
本番環境のデフォルト設定を変更する前に、代表的な入力の再生、構造化された出力の検証、ツールの引数の取得、停止理由の比較、トークンの使用状況の測定、および1つの失敗経路のテストを行ってください。.
品質、安全性、および審査費用
トークン単価が低いからといって、必ずしも総コストが低くなるわけではなく、また、高価なモデルが必ずしも優れたビジネス成果をもたらすわけでもありません。総コストには、再試行、人的レビュー、インシデント対応、および下流のデータを修復するために必要な作業が含まれます。有用な指標は、タスクの分類ごとに区分した「受け入れられた結果1件あたりのコスト」です。 リクエストあたりのコストがわずかに高いルートであっても、影響の大きいタスクにおける修復作業を削減できるのであれば、依然として有利となる可能性があります。また、強力な検証を伴う決定論的な抽出においては、非常に安価なルートが圧倒的に有利となる場合があります。.
リスクは、モデルのブランド名ではなく、アクションごとに分類すべきです。 公開文書を読み、要約を作成することは、顧客レコードの変更、支払いの承認、データの削除、あるいは法的声明の公表とは異なります。取り返しのつかない操作については、人間によるチェックポイントや、独立した第二の検証ステップを設けるようにしてください。モデルには不確実性の特定を求めますが、自信に満ちた表現の文を許可システムとして扱うことは決して避けてください。.
プライバシーおよび保存期間に関する事項は、導入審査の対象となります。どのようなデータが送信されるか、ログがどのくらいの期間保存されるか、誰がプロンプトを閲覧できるか、またリクエストに機密情報や個人情報が含まれているかどうかを確認してください。 可能な場合は情報を伏せ、文脈を最小限に抑え、どのフィールドが削除されたかを明確に記録してください。これらの対策は、モデルが公式APIを通じて使用される場合でも、その他の互換性のある経路を通じて使用される場合でも適用されます。.
GPT-6 LunaとGPT-6 Solを比較する方法
公正な比較を行うには、タスクと受け入れルールを一定に保ちつつ、各モデルが文書化された強みを活かせるようにします。同じ入力パケットを実行しますが、その際、モデルごとに異なる推論設定やエンドポイントが必要かどうかを記録します。 その違いを率直に報告します。あるモデルはより完全なパッチを生成するかもしれませんし、別のモデルは繰り返し抽出を行う際にコストが低いかもしれません。また、3つ目のモデルは、そのツール契約が現在使用しているアダプターと一致しているため、統合が容易である可能性があります。.
1つのタスクが成功したからといって、それを一般的な順位付けに結びつけてはいけません。3つの小規模なタスクは、ワークフローに関する問題点を発見するには有用ですが、普遍的な勝者を証明するためのものではありません。 現実的な入力をいくつか用意してタスクを繰り返し実行し、少なくとも1つの敵対的ケースまたは不完全なケースを含め、何が「合格」とみなされるかを事前に決めておきましょう。サンプル数が少なすぎて結論を裏付けることができない場合は、その旨を明記してください。その境界線を明確にすることは、レビューの信頼性を弱めるどころか、むしろ高めることにつながります。.
決定を撤回可能な状態に保つ段階的な導入
まずはシャドウトラフィックや重要度の低いキューから始めましょう。既存のルートを「信頼できる基準」として維持しつつ、新しいルートで結果を出させてみてください。 一定期間、受け入れ率、トークンコスト、レビュー時間、および失敗カテゴリを比較します。その後、ロールバック用の切り替えスイッチと明確なバージョンタグを用意した上で、タスクファミリーを1つずつ移行していきます。段階的な展開を行うことで、モデルの選択を「1日で完了する置き換え」ではなく、観測可能なエンジニアリング変更へと変えることができます。.
ロールアウトの際には、単純な合格率だけでは表れない変化に注意を払ってください。例えば、出力の増加、ツール呼び出しの増加、エスカレーションの増加、あるいはロングコンテキストの閾値を超えるリクエストの増加などです。モデルは正確に見える一方で、予算を消費しすぎたり、オペレーターの作業負荷を増大させたりしている可能性があります。こうした観点についてアラートを設定し、実際に例外処理を担当している担当者と確認を行ってください。.
成功とはどのようなものか
成功とは、コストが明確で、失敗のパターンが把握でき、誰もが従うことができるレビュープロセスを備えた、安定した道筋のことです。 そのモデルが完璧であるかのように装う必要はない。どの業務をうまく処理できるか、どの業務には別のルートが必要か、そして入力が不完全な場合にそれを停止または修正する方法を把握しておく必要がある。それこそが、本レビューで収集された観察結果や文書化資料の背後にある実践的な基準である。.
世間の反応から何がわかるか、何がわからないか
以下の情報源は、公式文書や管理されたベンチマーク結果ではなく、出典が明記された一般の反応として掲載されています。それぞれのタイトルは、各作成者が検証または説明の対象として選んだ内容を示しているに過ぎず、市場全体の結果を示すものではありません。.
- Chase AI: GPT 6「Sol」と「Luna」が登場(しかも50%より安い!). その枠組みや表現は、そのクリエイター自身の体験として捉え、普遍的な基準として捉えないようにしてください。.
- 「AIの専門家、ロブ」: ChatGPT、GPT-6 SolおよびGPT-6 Lunaをリリース(ChatGPTの新しいモデルとエージェント). その枠組みや表現は、そのクリエイター自身の体験として捉え、普遍的な基準として捉えないようにしてください。.
- 「Surya」を活用したAI: GPT-6 Soul vs Luna vs Claude Opus 5.5:どれを使うべきか?. その枠組みや表現は、そのクリエイター自身の体験として捉え、普遍的な基準として捉えないようにしてください。.
ここで、別の名称に関する問題があります。いくつかの公開動画では、タイトル内で「GPT-6」と「GPT-5.6」が混用されています。主張を引用する際は、正確なモデルIDを明記してください。その GPT-6 Astra と GPT-5.6 Sol の比較 これは、プロバイダーID、プラットフォームラベル、およびルートを個別に記録すべき理由を示す有用な例です。.
GPT-6 Lunaへのアクセス方法
を開く。 GPT-6 Luna ワークスペース まずは、評価可能なタスクから始めましょう。たとえば、小さなコード例、短いソースパケット、あるいは構造化された抽出要項などです。リビジョンを比較する際は、求められている出力と受け入れ基準を常に確認できるようにしておきましょう。上記の公式トークン価格は、APIの直接利用に関するものであり、ワークスペースのクレジットやサブスクリプションの割り当てに関する約束ではありません。.
現在のプラットフォームの命名規則および個別のクレジットに関する詳細については、以下の GPT-5.6 価格ガイド そして GPT-5.6モデルの比較. これらのページはプラットフォームや編集上の背景に関するものであり、OpenAIのAPI価格表に優先するものではありません。.
代表的なタスクを用意し、その結果を自身の受け入れ基準と照らし合わせてみてください。.
GPT-6 Luna ワークスペースを開くGPT-6 Lunaはどのような人に適しているのでしょうか?
候補リストに低価格の代替案が含まれている場合は、それらを比較して より幅広いモデルカタログ 最新モデルが自動的に最もコストパフォーマンスに優れていると決めつけるのではなく。データ処理量の多い作業を検討している場合は、 データ分析モデルガイド 別のワークフローレンズを提供します。.
よくある質問
GPT-6 Lunaとは何ですか?
GPT-6 Lunaは、OpenAIが開発した、集中処理型の大規模タスク向けモデルです。その公式APIモデルIDはgpt-6-lunaです。.
GPT-6 Lunaの価格はいくらですか?
OpenAIによると、GPT-6 Lunaのコストは、入力トークン100万個あたり$0.10、キャッシュされた入力トークン100万個あたり$0.01、 キャッシュ書き込み100万回あたり$0.125、出力トークン100万トークンあたり$0.50となっています(スタンダード料金)。.
入力トークン数が272Kを超えるとどうなりますか?
リクエストの入力トークン数が272Kを超えると、OpenAIはリクエスト全体に対して、入力レートとキャッシュレートを2倍、出力レートを1.5倍に適用します。.
コンテキストと出力の制限はどのようなものですか?
GPT-6 Luna の仕様によると、コンテキストウィンドウは 1,050,000 トークン、最大入力は 922,000 トークン、最大出力は 128,000 トークンとなっています。.
知識の基準値とは何ですか?
現在のOpenAIモデルページには、GPT-6 Lunaの知識の更新期限として2026年5月18日が記載されています。.
どのような推論設定が利用可能ですか?
このAPIでは、推論の負荷として「none」、「low」、「medium」、「high」、「xhigh」、「max」が定義されており、デフォルトは「medium」です。.
どのAPIエンドポイントがサポートされていますか?
GPT-6 Luna は、チャット補完、応答、バッチ処理に対応しています。モデルページには、リアルタイム処理、アシスタント、音声、動画、画像生成、埋め込み、微調整、モデレーション、および従来の補完機能は、対応機能として記載されていません。.
GPT-6 Lunaは画像を受け付けることができますか?
はい。そのモデルのページには、テキストと画像の入力、およびテキストの出力が記載されています。しかし、それだけでは、それが画像生成モデルであるとは言えません。.
GPT-6 LunaはGlobalGPTで利用できますか?
上記のリンク先にある、GPT-6 Luna専用のモデルページをご利用ください。ワークスペースのクレジットおよびプランの割り当て量は、本レビューで説明されているAPIトークンの直接料金とは別扱いとなります。.
この記事にはベンチマークは掲載されていますか?
これには3つの小規模なタスクの観察結果が含まれており、制御されたベンチマークではありません。Lunaは再試行の際に、コーディングの指示文の修正が必要でした。これらの結果から、普遍的な勝者や大規模な環境での性能を断定することはできません。.
最終評決
公式価格表において、Lunaは実用的な「コスト優先」の選択肢です。Solと同じ主要なコンテキストと出力上限を維持しつつ、トークン料金はごく一部に抑えられています。そのため、特定のタスクに焦点を当てた反復的な呼び出しには魅力的ですが、厳密なテストを行わない限り、低価格だからといってレイテンシが低い、あるいは品質が低いとは限りません。 受け入れ可能な出力と総運用コストに基づいて選択し、ワークロードが変化した際にはその選択を見直してください。.
2026年9月23日確認。公式情報:OpenAI Developers。プラットフォームのルート名称:GlobalGPT。世間の反応:関連するクリエイターや出版物をリンクしたのみで、出典の明記のみ。.









