
Grok 4.7は、コーディングやナレッジワークにおいて大幅な性能向上をもたらすものですが、その実証はまだ初期段階にあります。公式発表や独立系ベンチマークの結果からは、改善が見られるものの、あらゆる場面で優れているとは言い切れないようです。.
簡単な回答
Grok 4.7は、xAIが2026年9月21日にリリースした、コーディングや難易度の高い知識労働タスクを対象としたアップグレードです。 xAIによると、Grok 4.6と同等の価格と処理速度を維持しつつ、難解な問題にはより多くの時間をかけ、作業結果をより慎重に検証し、新たなセーフガードスタックを追加しているとのことです。また、ローンチページでは、同等のモデルと比較して処理速度が2倍、価格が半額であると紹介されていますが、このベンダー比較は、その背景にあるタスクや処理経路と併せて検討する必要があります。 Independent Artificial Analysisのデータによると、Grok 4.6に比べて全体的な性能がわずかに向上しており、50万文字のコンテキストウィンドウが記録されています。 3つのタスクからなるAPIテストでは、Grok 4.7はデバッグとソース境界の遵守において最も優れた性能を示しました。そのプロジェクト計画は不確実性を適切に維持していましたが、要求されたほど実行可能なものではありませんでした。これは有用な実証データではありますが、すべての競合モデルに勝っているという証拠ではありません。.
Grok 4.7とは何ですか?
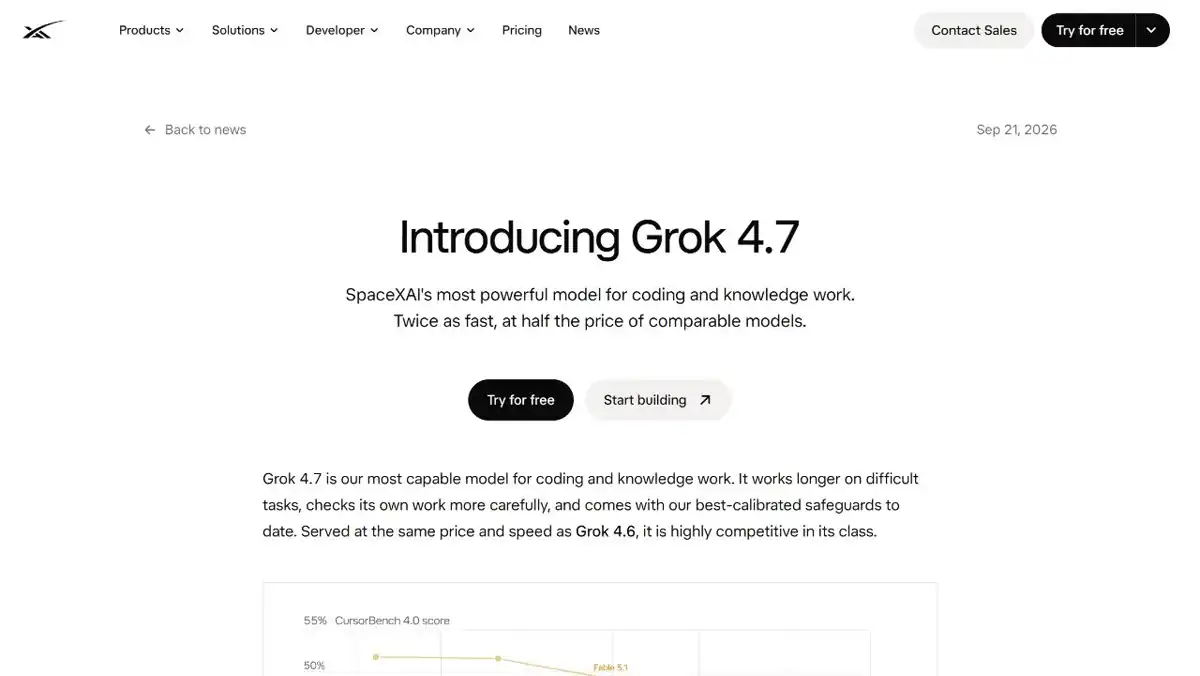
Grok 4.7は、2026年9月21日に発表されたxAIのGrokシリーズの最新モデルです。この xAIの公式発表 これにより、同社にとってコーディングや知識労働において最も高性能なモデルとして位置づけられている。重要な変化は、消費者向けの新たな機能リストにあるのではない。むしろ、このモデルがどのようにリソースを配分すべきかという点における変化にある。すなわち、難易度の高いタスクにより多くの時間を割き、自己チェックを強化し、その追加機能をより制御しやすくするための安全対策が講じられている。.
この位置づけが重要なのは、それがチャットボットの個性ではなく、ワークフローモデルを説明しているからです。Grok 4.7は、デバッグ、計画立案、技術文書作成、研究結果の統合、およびモデルが複数の制約条件を常に考慮する必要がある長いプロンプトなど、継続的な分析が有効なタスク向けのモデルとして販売されています。.
その境界線も同様に重要です。xAIの発表は、意図された動作に関するベンダー側の声明に過ぎません。これは、Grok 4.7がすべての競合モデル、すべてのプロンプト、あるいはすべてのコーディングリポジトリに勝るという独立した証明ではありません。 xAIの主張については、その発表ページを情報源として捉え、独立した測定結果と独自のタスクを用いて、それらの主張が重要かどうかを判断してください。.
Grok 4.7 対 Grok 4.6:実際には何が変更されたのか?
最も妥当なまとめとしては、これは「機能の向上と信頼性の向上」であり、まったく別の製品ではないということだ。.
| エリア | Grok 4.7 | 証拠が裏付けていること |
|---|---|---|
| リリース | 2026年9月21日 | xAIの公式ローンチページに記載されている日付 |
| 主な位置付け | コーディングと知識労働 | xAIの公式な位置づけ |
| 難しい課題 | より長い時間をかけて取り組むことと、より入念な自己チェック | xAIの公式説明:当社の3つのタスクを対象としたAPI実行は、簡単な実地検証を目的としたものであり、厳密な比較ではありません。 |
| 安全 | 新しいセーフガード・スタック | xAIの公式説明 |
| 価格と速度 | xAIによると、Grok 4.6と同じです。 | 発売時の主張であり、第三者による価格監査ではない |
| 文脈 | 「人工分析」プロファイル内の50万トークン | 独立系モデルのプロフィール:利用するルートを確認してください |
| 推論制御 | Artificial Analysisのリストにおける「Low」から「xhigh」まで | 独立したルート/モデルメタデータ |
これは購入者にとって有用な区別です。もし Grok 4.6 がすでにワークフローに適合しているなら、4.7 は導入のハードルが低いアップグレードとして検討する価値があります。一方、エコシステム、レイテンシ、信頼性、あるいはアクセス上の制約などの理由で 4.6 が適合しなかった場合、ベンチマーク数値が高くなっただけでは、それらの問題は解決されません。.
モデル購入に関するより広範な枠組みについては、 GPT-5.6 価格ガイド そして GPT-5.6の比較 これらは、モデルの品質と、計画の経済性およびワークフローへの適合性を区別するための有益な指針となります。.
機能:Grok 4.7が役立つ場面
コーディングとデバッグ
xAIのローンチにおける最大の強みは、コーディングにあります。その魅力は、単にGrok 4.7がより多くのコードを記述できるということではなく、困難な技術的課題に長く取り組み続け、自身の回答を検証し、より熟考されたパッチや説明を提示できる点にあります。 これこそが、実際のリポジトリにおいて求められる振る舞いである。すなわち、既存の設計を維持し、根本原因を特定し、有用なテストを追加し、そしてまだ把握できていない点を明確に示すことができるか、ということだ。
「ToDoアプリを作成する」といった、全くの白紙の状態からのプロンプトでモデルを評価しないでください。テストが失敗する限定的なバグ、少数のファイル、そして明確な制約条件をモデルに与えてください。パッチを提示する前に、診断を求めましょう。そうすることで、長めの推論結果がレビュー作業の負担を軽減しているのか、それとも単に文章が長くなっているだけなのかを、より明確に判断できるようになります。.
異なるコーディング手法を比較するチームについても、同様のルールが適用されます。A DeepSeek V4 Pro レビュー そして GLMコーディング計画のレビュー これらは比較の参考にはなりますが、実際に使用しているリポジトリやツールチェーンをテストする代わりとして扱うべきではありません。.
長期的な文脈を要する知識労働
Artificial Analysisによると、Grok 4.7では50万トークンのコンテキストウィンドウが設定されています。これは、ソース資料が膨大な作業への取り組み方を変えるのに十分な大きさです。つまり、長い技術仕様書、一連の会議議事録、コードベースの一部、あるいは研究資料一式といったものも、繰り返し要約されることなく、1つの会話の中で扱えるようになります。.
コンテキストの容量は、コンテキストの質とは異なります。 モデルは大量の入力を受け入れても、中盤付近の制約を見落としたり、最後の段落を過大評価したり、出典の確認が必要な自信満々の要約を生成したりすることがある。実用的なテストは、プレッシャー下での検索能力だ。長い文書のさまざまな箇所に決定的な事実をいくつか配置し、制約付きの判断を求め、その回答が正しい箇所を引用しているかどうかを確認する。.
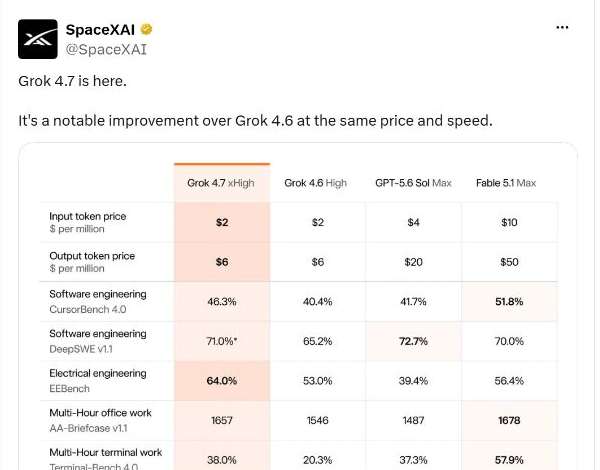
SpaceXAIの公式Xアカウントは9月22日、この打ち上げに関する見解を繰り返し、Grok 4.7について、同じ価格と速度でGrok 4.6に比べて著しい改善が見られると述べ、モデル比較図を共有しました。 この投稿は、同社の公的な位置づけを示す有用な証拠ではあるが、独立した検証やコミュニティのコンセンサスを示すものではない。.
このモデルを研究に活用する場合は、エビデンス・ループを明確に示してください。当団体の Gemini と Perplexity の比較 そして Perplexityの代替品ガイド これらは同じ実用的な点を指摘しています。つまり、洗練された回答はソースコードの監査ではないということです。.
自己点検と安全
xAIによると、Grok 4.7では、モデルの動作をより慎重に検証し、新たなセーフガード・スタックが導入されているとのことです。これらは、特にモデルが長い一連の意思決定を行うよう求められた場合、非常に重要な目標です。ただし、これらは出力が正しいことや、自動実行において安全であることを保証するものではありません。.
本番環境では、モデルを取り巻く通常の管理措置(テスト、権限設定、人間によるレビュー、引用チェック、明確な停止条件など)を維持してください。モデルの自己チェック機能は、検証すべきもう一つの指標であり、モデルを取り巻く管理措置の代わりになるものではありません。.
Grok 4.7のベンチマーク:数字が示すもの
コーディングの結果は好調で、公式ランキングではGrok 4.7がGrok 4.6を4.7ポイント上回った。.
大型モデルの比較では、このナレッジワーク・ベンチマークにおいて顕著な性能向上が確認された。.
道具を使用するワークフローにとって有用な指標ではあるが、あくまで一つの評価に過ぎず、普遍的なスコアというわけではない。.
この独立した指標も、同じ方向性、すなわち「改善」を示しており、普遍的な勝利の証拠ではない。.
これらのカードは、あくまで参考情報としてお読みください。データセットの構成、利用可能なツール、サンプリング、およびモデルの設定によって、順位は変動する可能性があります。.
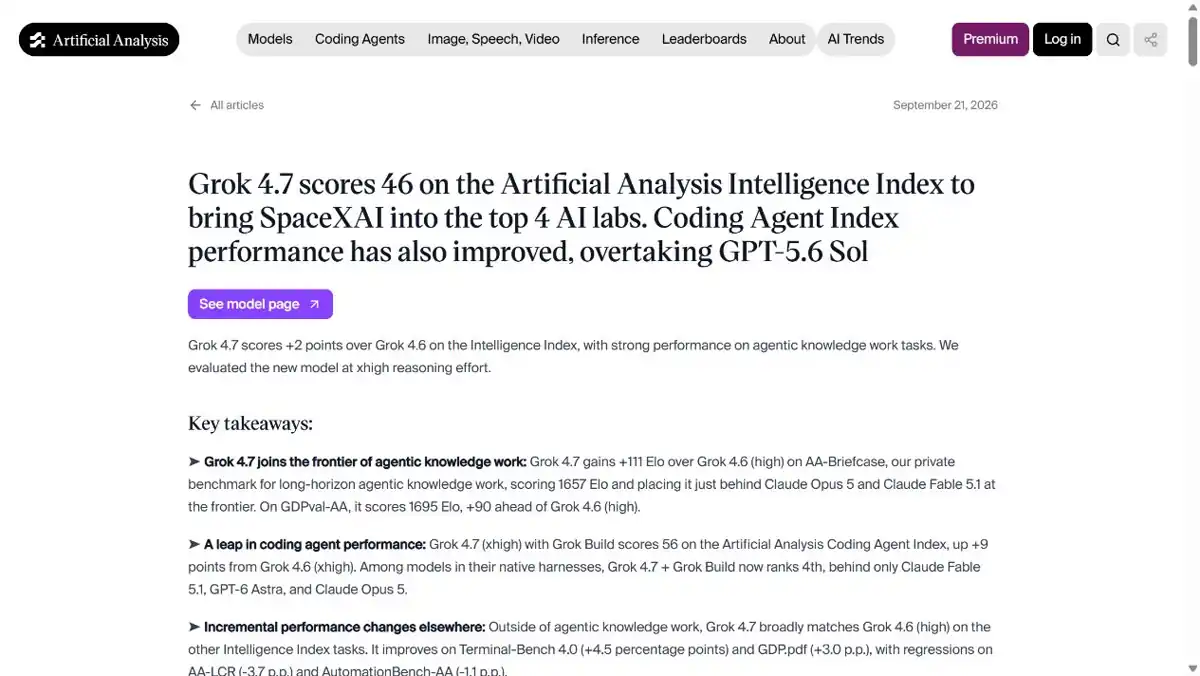
現在、最も有用な独立したスナップショットは、 Artificial Analysis誌の「Grok 4.7」に関するベンチマーク記事, 、2026年9月21日付。.
| 測定 | 報告された結果 | 読み方 |
|---|---|---|
| 人工知能分析指数 | 46 | 同じ指数内のGrok 4.6より2ポイント高い |
| AA-ブリーフケース | 1,657 エロー | その評価では、Grokより111 Elo上、4.6でした |
| コンテキストウィンドウ | 50万トークン | モデルプロファイルフィールドであり、完全な長文コンテキスト検索の証明ではない |
| 推論努力 | 低~x高 | Artificial Analysisが掲載したルートレベルの制御 |
その傾向は期待が持てるものだ。独立した指標は前回のバージョンに比べて改善が見られ、AA-BriefcaseにおけるEloスコアの差が拡大していることは、この特定の評価においてより顕著な向上があったことを示唆している。しかし、この表はあくまで2つのデータセットに関するものであり、普遍的なランキングではない。ベンチマークの構成、ツールの利用状況、サンプリング、およびモデルの設定によって、結果は変わる可能性がある。.
xAIの公式ローンチページには、Grok 4.7が CursorBench 4.0 における 46.3% その比較表には、40.4%のGrok 4.6、41.7%のGPT-5.6 Sol、および51.8%のFable 5.1が並んでいます。 また、このページには、DeepSWE v1.1での高負荷時のスコア71.0%、EEBenchでの64.0%、AA-Briefcase v1.1での1,657も掲載されている。 これらはベンダーが提示した比較数値であるため、独立した再現実験の代わりとするのではなく、公式に報告された結果として扱うべきです。より安全な結論としては、xAIは本格的なコーディングや専門的な知識労働をターゲットとしている一方で、独立した測定結果では、一部のタスクで有意な改善が見られる一方、他のタスクではそれほど顕著ではない結果となっていると言えます。.
Grok 4.7 実技試験:3つの実践課題
私たちは、3つの固定プロンプトを grok-4.7 2026年9月23日、OpenAI互換のテストAPIを通じてモデルIDを取得しました。これは単一ルートの評価であり、direct xAI APIによるものではなく、競合他社のモデルとの比較テストでもありません。各実行から得られた可視化された回答を以下に示します。非公開の推論トレースは除外されています。.
| タスク | 観測時刻 | 結果 |
|---|---|---|
| TypeScriptの並行処理に関するバグ | 333.7秒、ストリーミング配信 | 「Strong pass」:SharedPromiseの診断が正確で、パッチも最小限に抑えられ、2つの有用なテストが含まれており、スニペットで証明できる範囲が慎重に限定されている |
| 矛盾する研究記録 | 68.7秒 | 「合格(Strong pass)」:出典情報を保持し、両方の許容シナリオを算定した上で、出典の矛盾が確認されるまで承認を保留した |
| だらしのない1週間の計画 | 50.6秒 | 部分的な合格:締め切り、矛盾点、所有者の不明点、および5つのリスクは反映されていたが、作業内容を明確な日別スケジュールには落とし込めていなかった |
レイテンシの数値は、このルートおよびこれらのプロンプトについてのみ示しています。コーディングタスクは、最初に非ストリーミングのゲートウェイタイムアウトが発生しましたが、その後、ストリーミングを有効にして完了しました。これは、トランスポートおよびタイムアウト処理に関する実運用上の警告であり、Grokの4.7という一般的な速度スコアを示すものではありません。.
テスト 1: TypeScript の並行処理のデバッグ
タスク 1 — TypeScript API ハンドラの並行処理に関するデバッグ

2 つのリクエストが立て続けに届いた場合、ある小さな TypeScript ハンドラが、ボディが空の HTTP 200 を断続的に返すことがあります。

提供されたファイル:

src/cache.ts
```ts
let current: Promise | null = null;

export async function getPayload(load: () => Promise): Promise {
  if (!current) {
    current = load();
  }
  const value = await current;
  current = null;
  return value;
}
```

src/handler.ts
```ts
import { getPayload } from './cache';

export async function handler(load: () => Promise) {
  const payload = await getPayload(load);
  return { status: 200, body: payload };
}
```

本番環境での症状は、2つのリクエストが重なった場合にのみ断続的に発生します。ローダー自体は並行して呼び出しても安全であり、リクエストごとに異なるペイロードを返します。他に利用可能なファイルはありません。

以下のセクションを正確に記載してください:
1. 根本原因
2. 最小限の安全なパッチ(統一差分表示)
3. 2つの回帰テスト(TypeScriptまたはJestスタイルのコード)
4. 前提条件と制限事項
コードを実行したとは主張しないでください。.1. 根本原因
`current` は、すべての呼び出しで共有されるモジュールレベルの状態です。JavaScript の 1 ターンにおいて、null チェックと代入はアトミックであるため、2 つの呼び出しが重なった場合でも、両方が `load()` を実行することはありません。最初の呼び出しはそのプロミスを格納し、そのプロミスが解決する前に到着した 2 番目の呼び出しは、自身の `load()` をスキップして、同じプロミスを待機します。 その後、`handler` は HTTP 200 を返しますが、その `body` は 2 番目のリクエストのペイロードではなく、最初の呼び出しの文字列になります。この「隙間」は呼び出しが進行中の間のみ存在するため、この不具合はリクエストが重なり合った場合にのみ発生します。
`current = null` は、`await` がすでにプロミスをキャプチャした後の各継続で実行されます。これにより、他の待機者が変数を再読み込みするわけではありません。したがって、これらのファイルだけでは、その待機者を `null` や `""` に解決することはありません。重複が発生した際に生じるのは、解決値の共有と、リクエストごとの `load()` のスキップです。 また、この処理により、スロットは単一フライトキャッシュとしても不適切になります。再開する最初の継続は `current` を破棄し、後続の呼び出し元は、別の呼び出し元がまだアンワインド中の段階で、異なる `load()` を開始できてしまうからです。
2. 最小限の安全なパッチ(統合差分表示)
各リクエストは、自身で `load()` を呼び出す必要があります。並行した `load()` の呼び出しは許可されており、それぞれが異なるペイロードを返すため、1つの共有プロミスでの重複排除は安全ではありません。`handler.ts` の変更は必要ありません。
```diff
--- a/src/cache.ts
+++ b/src/cache.ts
@@ -1,10 +1,3 @@
-let current: Promise | null = null;
-
export async function getPayload(load: () => Promise): Promise {
- if (!current) {
- current = load();
- }
- const value = await current;
- current = null;
- return value;
+ return await load();
}
```
3. 2つの回帰テスト(TypeScriptまたはJestスタイルのコード)
```ts
import { handler } from '../src/handler';
function deferred() {
let resolve!: (value: T) => void;
let reject!: (reason: unknown) => void;
const promise = new Promise((res, rej) => {
resolve = res;
reject = rej;
});
return { promise, resolve, reject };
}
test('各リクエストは互いに重なりつつ実行され、それぞれ独自のボディを保持する', async () => {
const first = deferred();
const second = deferred();
const started: string[] = [];
const p1 = handler(() => {
started.push('a');
return first.promise;
});
const p2 = handler(() => {
started.push('b');
return second.promise;
});
expect(started).toEqual(['a', 'b']);
second.resolve('payload-b');
first.resolve('payload-a');
await expect(p1).resolves.toEqual({ status: 200, body: 'payload-a' });
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
test('拒否された重複するリクエストは、他のレスポンスに影響を与えない', async () => {
const failed = deferred();
const ok = deferred();
let started = 0;
const p1 = handler(() => {
started += 1;
return failed.promise;
});
const p2 = handler(() => {
started += 1;
return ok.promise;
});
expect(started).toBe(2);
failed.reject(new Error('upstream failed'));
ok.resolve('payload-b');
await expect(p1).rejects.toThrow('upstream failed');
await expect(p2).resolves.toEqual({ status: 200, body: 'payload-b' });
});
```
4. 前提条件と制限事項
私はこのコードやテストを実行していません。 テストでは、Jest スタイルのランナーと、`src/` と同じ階層にあるファイル(例:`test/cache.test.ts`)を前提としています。
「リクエストごとに異なるペイロード」については、重複する `getPayload` の呼び出しが 1 つの `load()` の結果を共有してはならないという要件として扱いました。 正しいシングルフライトリライト(`load().finally(() => { current = null; }); return current`)では、これらのリクエストは依然として結合されてしまうため、使用しませんでした。キャッシュキーは存在せず、重複排除の要件も明示されていません。
`load` が空ではない文字列を返す場合、示されたステートメントではリテラルな空の HTTP ボディは書き込まれません。その現象がこれらのファイル外のアダプタに起因するものである場合、ここでは確認できません。このパッチは、これらのファイルが実際に実装している重複による結合を解消するだけです。ロック、リトライ、キー付きキャッシュなどは追加していません。.Grok 4.7 は、モジュールレベルでの 現在 promise を使用すると、各リクエストにはそれぞれ独自のペイロードが必要であるにもかかわらず、重複するリクエストが 1 つのローダー結果を共有することになります。そこで、最小限の安全な変更として、共有されている promise を削除し、 load() 要望に応じて。2つの回帰テストでは、異なる同時ペイロードと、1つのローダーがリクエストを拒否した場合の分離について検証しました。この回答の最も優れた点は、その控えめな姿勢にありました。回答では、提示されたコードがリクエスト間の結合性を証明していることは明示しつつも、ローダーが常に空でない文字列を返す場合、それだけでは文字通り空のボディが生じることを説明できないと述べていました。.
評決: 根本原因の正確性、パッチの適用範囲、回帰テストのカバレッジ、および不確実性の取り扱いにおいて、高い評価を得た。.
テスト2:情報源が矛盾する研究メモ
課題 2 — 矛盾する調査メモを整理し、意思決定メモにまとめる。

以下の 6 つのメモのみを使用し、事実に関する記述の横には必ず情報源名を記載すること:

- ベンダー A、価格ページ、2026年9月20日: 「Team」プランは1シートあたり月額$40で、100,000回のアクションが含まれています。
- ベンダーB、比較記事、2026年9月21日:ベンダーAの「Team」プランには、1シートあたり月額120,000回のアクションが含まれています。
- 顧客インタビュー、2026年9月18日:当社のチームは8シートあり、先月は710,000アクションを利用しました。
- 財務スプレッドシート、2026年9月19日:現在の予算上限は月あたり$360です。
- ベンダーA、利用制限ページ、2026年9月20日:含まれる割り当て量を超えた分については、1アクションあたり$0.004が請求されます。
- 調達メモ、2026年9月22日:月間合計が予算内であり、割り当て量が確認された場合にのみ、切り替えが認められます。

以下のセクションを正確に返却してください:
1. 確認済みの事実
2. 帰属する主張
3. 矛盾表
4. 独立した計算(8 × 100,000 および 8 × 120,000 の両方のシナリオ、ならびに超過分について計算すること)
5. 推奨事項
6. 矛盾により推奨事項が変わる場合に限り、1つの明確化のための質問
100,000対120,000の矛盾については、黙って解決しないでください。.
1. 確認済みの事実
- 「Team」プランの料金は、1シートあたり月額$40である(ベンダーA、価格ページ、2026年9月20日)。
- 当該チームは8席を保有しており、先月は710,000アクションを使用した(顧客インタビュー、2026年9月18日)。
- 現在の予算上限は、月あたり$360である(財務スプレッドシート、2026年9月19日)。
- 許容範囲を超えた分については、1アクションあたり$0.004が請求される(ベンダーA、利用制限ページ、2026年9月20日)。
- 月間合計が予算内であり、かつ割り当て量が確認された場合に限り、ベンダーの切り替えが認められる(調達メモ、2026年9月22日)。

2. 帰属請求
- チームには100,000件の含まれるアクションが含まれる(ベンダーA、価格ページ、2026年9月20日)。その注記には「1シートあたり」とは明示されていない。
- ベンダーAのチームには、1シートあたり月間120,000件のアクションが含まれている(ベンダーB、比較記事、2026年9月21日)。

3. 矛盾一覧表
| 項目 | 主張 | 出典 | ステータス |
| --- | --- | --- | --- |
| 含まれるアクション数 | 100,000件のアクションが含まれる;「1シートあたり」との記載なし | ベンダーA、価格ページ、2026年9月20日 | 未解決 |
| 含まれるアクション数 | 1シートあたり月間120,000アクション | ベンダーB、比較記事、2026年9月21日 | 未解決 |

100,000と120,000の相違点は未解決である。これらの注記からは、どちらの数値が正しいかは明らかではない。

4. 独自計算
基本ライセンス単価(両シナリオで同一):8ライセンス(顧客インタビュー、2026年9月18日)× $40/ライセンス/月 (ベンダーA、価格ページ、2026年9月20日)=月額$320。

以下の2つの乗数は、要請に基づき算出されたものである。これらは、ベンダーAが1席あたりの手当額を明示したことを示すものではない。

- 100,000という数値(ベンダーA、価格ページ、2026年9月20日)を用いると、8 × 100,000 = 800,000のアクションが含まれます。
- 利用数 710,000(顧客へのヒアリング、2026年9月18日)は 800,000 を 90,000 下回っているため、超過アクション数 = 0。
- 超過料金 = 0 × $0.004 = $0(ベンダーA、利用制限ページ、2026年9月20日)。
- 月間合計 = $320 + $0 = $320 であり、これは $360 の上限内である(財務スプレッドシート、2026年9月19日)。

- 120,000という数値を用いると、8 × 120,000 = 960,000件のアクションが含まれる(ベンダーB、比較投稿、2026年9月21日)。
- 利用実績 710,000(顧客インタビュー、2026年9月18日)は 960,000 を 250,000 下回っているため、超過アクション数 = 0。
- 超過料金 = 0 × $0.004 = $0(ベンダーA、制限ページ、2026年9月20日)。
- 月間合計 = $320 + $0 = $320 であり、これは $360 の上限内である(財務スプレッドシート、2026年9月19日)。

5. 提言
現時点では切り替えを承認しないこと。いずれの算定基準においても、先月の710,000件のアクション (顧客インタビュー、2026年9月18日)でも超過は発生せず、月間合計は$320となり、これは上限の$360の範囲内である(財務スプレッドシート、2026年9月19日)。 このコスト結果は、100,000 を選ぶか 120,000 を選ぶかには依存しません。切り替えは依然として 2 番目の条件を満たしていません。すなわち、許容量の確認が必要です(調達メモ、2026年9月22日)。また、これらのメモに記載されている数値は 100,000 (ベンダーA、価格ページ、2026年9月20日)と120,000(ベンダーB、比較投稿、2026年9月21日)との間に矛盾が残っている。

6. 矛盾によって推奨事項が変わる場合に限り、1つの確認質問を行う
確認質問はありません。100,000と120,000の矛盾は、推奨事項を変更するものではありません。.
この調査資料では、1席あたりの許容量が10万アクションか12万アクションかについて、意図的に矛盾する記述がなされていた。 Grok 4.7では、2つの情報源を区別し、最初の情報源には「1シートあたり」という記述が明示されていないことに着目し、8シートの場合の2つのシナリオをそれぞれ計算した結果、提供された使用量において超過はなく、いずれも$320の範囲内にとどまることが示された。 それでも、調達部門が許容量の検証を求めていたため、承認を保留するよう推奨した。これは、数値的に安定した推奨事項と、未解決の契約上の事実とを正しく区別したものである。.
評決: 帰属、算術、対立処理、および意思決定の規律において高い評価を得た。.
テスト 3:乱雑なメモから実行プランへ
タスク3 — これらの散らかったプロジェクトのメモを、700語以内の1週間の実行計画にまとめなさい。

備考:
- ランディングページは金曜17:00に公開。プロダクトオーナーは後のメモで木曜の午前中と述べている。
- ミナ:見出しと価格表を作成。また、ミナは水曜日の午後までにはコピーを確認できないとしている。
- アルジュン:アナリティクスイベント。重複したメモには、アナリティクス担当者が未定と記載されている。
- デザインチームには、「モバイルヒーローのトリミング」と「モバイルヒーローのトリミング(最終版)」という2つの重複したタスクがある。
- 公開前の法的レビューが必須。
- アナリティクスイベントが利用可能になってから、QAに丸1日必要。
- オマールは火曜日の午後、不在となる。
- ローンチ告知メールは金曜16:00に送信予定。
- 不明:最終的な実施・中止の決定権限者が誰か。

要件:重複する作業をまとめ、担当者が不明な項目は「未定(TBD)」と明記し、両方の厳守期限を維持し、矛盾点は黙って解決するのではなく指摘し、最後に5項目のリスクリストを記載すること。

以下のセクションを正確に再現すること:
1. 1週間の計画
2. 矛盾点と不明点
3. 5つのリスク
担当者や日付を勝手に設定してはならない。.
1. 1週間の計画

メモにはカレンダーの日付が記載されていないため、追加は行わない。明示されたアンカーと依存関係のみを使用する。重複するデザイン作業は1つのタスクとする。担当者が不明なタスクは「未定(TBD)」のままとする。競合するリリース時期は両方とも維持する。

- コピー:ミナが見出しと価格表を作成する。彼女のコピーレビューは水曜日の午後のみ。
- デザイン:1つのタスク(モバイル用ヒーロー画像のトリミング)。これには「最終」チェックも含まれる。担当者は特に指定されていない。
- アナリティクスイベント:QAの前に設定済みである必要がある。担当者は未定(あるメモではアルジュン、別のメモでは「未定」)。
- QA:1日分。アナリティクスイベントが利用可能になってからのみ実施。担当者は未定。ここではQAの日程は割り当てられていない。
- 法務レビュー:公開前のリリースに必須。担当者は未定。メモにはスケジュールが記載されていない。
- 実施/中止の判断:担当者は未定。決定済みとはみなされていない。
- 公開開始の基準日:木曜日の午前(プロダクトオーナー)と金曜日の17:00(ランディングページ)の2つは維持。
- リリースメール:金曜日の16:00。担当者は未定。
- オマルは火曜日の午後に不在。これらのメモにはオマルに割り当てられたタスクがないため、移動されるタスクはない。

新しい日程を含まない優先順位:ミナによる草案は水曜午後のレビューに間に合うように準備する必要がある;デザインチームはシングルヒーローのトリミングを完了させる;アナリティクスイベントは未確定の担当者によって提供される;その後、QAに丸1日かかる;法的レビューは一般公開前に完了させる;実施可否(未定)は依然として担当者が決まっていない。 木曜日の午前、金曜日の17:00、および金曜日の16:00のタスクは削除しないでください。

2. 矛盾点と未確定事項

矛盾点(未解決):
- ランディングページの公開は金曜日の17:00とされているが、後のプロダクトオーナーのメモには木曜日の午前と記載されている。
- アナリティクスの担当者は、あるメモではArjunと記載されているが、別のメモでは「未定」となっている。

不明点(TBDとマークされているもの):
- 最終的なゴー/ノーゴーの担当者。
- 確定したアナリティクスの担当者。
- 法務審査の担当者。
- QAの担当者。
- 公開告知メールの担当者。
- 「デザイン」以外の具体的な名称が示されたデザイン担当者の担当者。
- オマールの役割。火曜日の午後の不在のみが記載されている。
- どのリリース時間が正式なものか、また金曜16:00のメールがどちらの時間に合致するか。それらの平日時間以外の日付は記載されていない。

3. 5つのリスク

1. 木曜の朝と金曜17:00の両方をランディングページのリリース日とすることはできない。決定なしにどちらか一方を使用すると、早期にリリースされてしまったり、もう一方の期限に間に合わなくなったりする可能性がある。
2. 公開通知メールは金曜16:00に固定されており、金曜17:00より前ではあるが、メモ上では木曜午前とは整合が取れていないため、意図した状態になっていない、あるいはすでにその状態ではなくなったページに対して送信される可能性がある。
3. アナリティクスの担当者が未定であるため、イベントの記録が漏れる可能性がある; QAにはイベント終了後、丸1日が必要であり、どちらの公開タイミングの前にも収まらない可能性があります。
4. 公開前には法務レビューが必須ですが、担当者とスケジュールが未定であるため、公開がブロックされるか、レビューなしで行われる可能性があります。
5. 実施/中止の決定権者が指定されていないため、どちらの厳格な締め切りについても、公開を承認または中止する担当者が明示されていません。.
Grok 4.7 では、重複していた mobile-hero タスクを統合し、木曜日の午前と金曜日の 17:00 におけるリリース日程の競合を維持し、金曜日の 16:00 というメールの締め切りを維持し、未確定の担当者には「TBD」とマークし、リスクを正確に 5 件にまとめました。カレンダー上の日付や担当者を独自に設定することはありませんでした。 弱点は実行可能性でした。月曜日から金曜日にかけての作業割り当てを行う代わりに、順序付けられた依存関係リストを返し、QA日を割り当てることはできないと回答しました。この慎重な姿勢は正当化できますが、プロンプトでは「1週間の実行計画」が求められていたため、回答は要求された形式を部分的にしか満たしていませんでした。.
評決: 部分的な合格:制約の保持は優れているが、スケジューリング上の有用性は低い。.
Grok 4.7が実際のワークフローにどのような変化をもたらすか
この発表を最も有用に読み解くには、ワークフローの観点から考察するのがよいでしょう。つまり、持続的な推論によってレビュー作業が軽減されるのはどの部分か、また単に回答が長くなるだけなのはどの部分か、ということです。 3つのAPIタスクからは、実用的なパターンが示唆される。Grok 4.7は、特にプロンプトで「事実と仮定を区別する」よう求められた場合、複数の制約条件を同時に可視化しておくことに長けている。一方、ソースのメモでは十分に明記されていない具体的なスケジュールや実行順序が必要なタスクでは、その性能はそれほど説得力を持たない。.
コーディングとデバッグ
リポジトリ作業においては、このモデルは、自由度の高い「アプリを構築する」という依頼よりも、範囲が限定された診断に適しています。 最小限の有用なファイルセットを提供し、不具合の症状を説明した上で、パッチを適用する前に根本原因の特定を求めましょう。変更前は失敗し、変更後は成功するテストを提示するように依頼してください。私たちのハンドラテストでは、回答は提供されたコードに忠実であり、空のボディという症状に対して外部要因をでっち上げるようなことはしませんでした。.
その行動が重要となるのは、コーディングの質が単なるコード生成だけではないからです。有用なコーディング対応とは、局所的な設計を維持し、差分(diff)を最小限に抑え、前提条件を明確にし、検証のコストを抑えるものでなければなりません。Grok 4.7 は、これらを1つの小さなタスクで実現しましたが、単一のタスクだけではリポジトリ全体にわたる信頼性を確立することはできません。 チームは、本番環境での作業に移行する前に、実際のバグ、リファクタリング、複数ファイルにわたる変更、およびセキュリティ上重要なパスについて、同じ評価基準を繰り返し適用すべきです。.
研究および文献の統合
この調査作業を通じて、もう一つの強み、すなわち「情報源と境界の厳格な管理」が明らかになった。Grok 4.7は、ベンダーが主張する「10万件のアクション」という数値と、比較対象の投稿にある「12万件」という数値を、黙って合算することはなかった。 また、両方のシナリオにおいて安定している計算と、依然として検証が必要な調達条件とを区別した。.
これは、調査を多用する作業に適した手法です。モデルに対し、検証済みの事実、出典が明記された主張、未解決の矛盾、計算結果、および提言を個別にラベル付けするよう依頼してください。 たとえ洗練されたメモであっても、二次的な主張を出典不明の事実としてすり替えてしまえば、誤りになり得ます。Grok 4.7の回答が有用だったのは、算術的な結果が変わらなかったにもかかわらず、矛盾が明確に示されていたからです。.
計画と運用
計画の段階で、その限界がより明確になりました。このモデルは、すべての期限や不明な所有者を反映していましたが、月曜日から金曜日までのスケジュールを自動的に作成する機能までは備えていませんでした。これは日付を勝手に設定するよりも安全ですが、その一方で、ユーザーは依然として依存関係をカレンダー上の割り当てに変換しなければなりません。.
運用に関する指示については、計画期間、利用可能な稼働日数、所有者の空き状況、および意思決定者を記載してください。これらの項目が記載されていない場合は、まず依存関係マップを求め、次にカレンダーを求めます。この2段階のワークフローにより、モデルの警告を「決断力の欠如」と見なすのではなく、有益な情報として活用できるようになります。.
長文コンテキストの検索
50万のコンテキストウィンドウは、1回のリクエストに収まる範囲を変えるが、検証なしに信頼できる範囲を変えるわけではない。長コンテキストの処理では、検索プローブを使用すべきである。すなわち、決定的な事実をパケットの先頭、中間、末尾に配置し、意図的に1つの矛盾を加え、ソースの位置情報を明記した上で判断を求める。リコール率と境界の厳密性の両方を測定する。.
コンテキストが長いルートを、大規模なリクエストを受け入れるかどうかだけで判断してはならない。モデルが事実を認識できていない箇所、最終セクションに過度に重きを置いているかどうか、入力サイズに応じてレイテンシがどの程度増加するか、プロバイダーがリクエストを截断または変換しているかどうかを記録しておくこと。公表されている大きなウィンドウサイズは、処理能力の主張に過ぎず、限界状態での安定した推論を保証するものではない。.
Grok 4.7を自分で評価する方法
本番環境のデフォルト設定を変更する前に、小規模で再現性のあるテストセットを使用してください。その目的は、リーダーボードを再現することではなく、モデルを、すでに費用を支払っている評価プロセスやレビュープロセスと比較することです。.
- 入力を凍結してください。. プロンプト、ファイル、ソースパケット、モデルID、温度、推論設定、およびツールの権限を正確に保存してください。プロンプトを変更しながら、ダイレクトルートとプロバイダールートを比較しないでください。.
- 文章そのものではなく、作品そのものを評価してください。. コーディングについては、根本原因の正確性、パッチの適用範囲、テスト、および前提条件を評価する。研究については、引用範囲、算術的正確性、矛盾、および推奨事項の質を評価する。計画については、期限の遵守、責任の所在、依存関係、および実行可能性を評価する。.
- 輸送については別途記録してください。. ルートログには、最初のトークン取得までの時間、合計時間、ストリームモード/非ストリームモード、HTTPステータス、および再試行の挙動を記録しておく。ゲートウェイのタイムアウトは、必ずしもモデル品質上の障害とは限らないが、それでも生産コストにはなる。.
- 障害時の挙動を確認してください。. 曖昧な入力を1つ、矛盾する情報源を1つ、意図的に不完全なファイルセットを1つ含めます。ここで重要なのは、モデルが不確実性を明示するのか、それとも確信を持った推測でその空白を埋めるのかという点です。.
- コストと工数を合わせて検討してください。. 入力トークン、出力トークン、キャッシュされた入力、公開された際の推論トークン、および人間によるレビューの所要時間を追跡します。検証に2倍の時間がかかる安価な応答は、実際には安価ではない可能性があります。.
- 切り替える前に、もう一度繰り返してください。. チームのデフォルト設定を変更する前に、各タスクを少なくとも2回実行するか、あるいは代表的な例をいくつか用いて実行してください。他のレビュー担当者がその判断を再現できるよう、未加工の回答と採点メモは残しておいてください。.
本レビューで紹介する3つの実行結果は、あくまで初期のサンプルであり、チームの評価セットに代わるものではありません。これらは、Grok 4.7が1つのコーディング課題、1つのソース競合メモ、および1つの計画パケットにおいてどのように動作するかを示すものであり、普遍的な順位を決定づけるものではありません。.
Grok 4.7 の価格および API アクセス
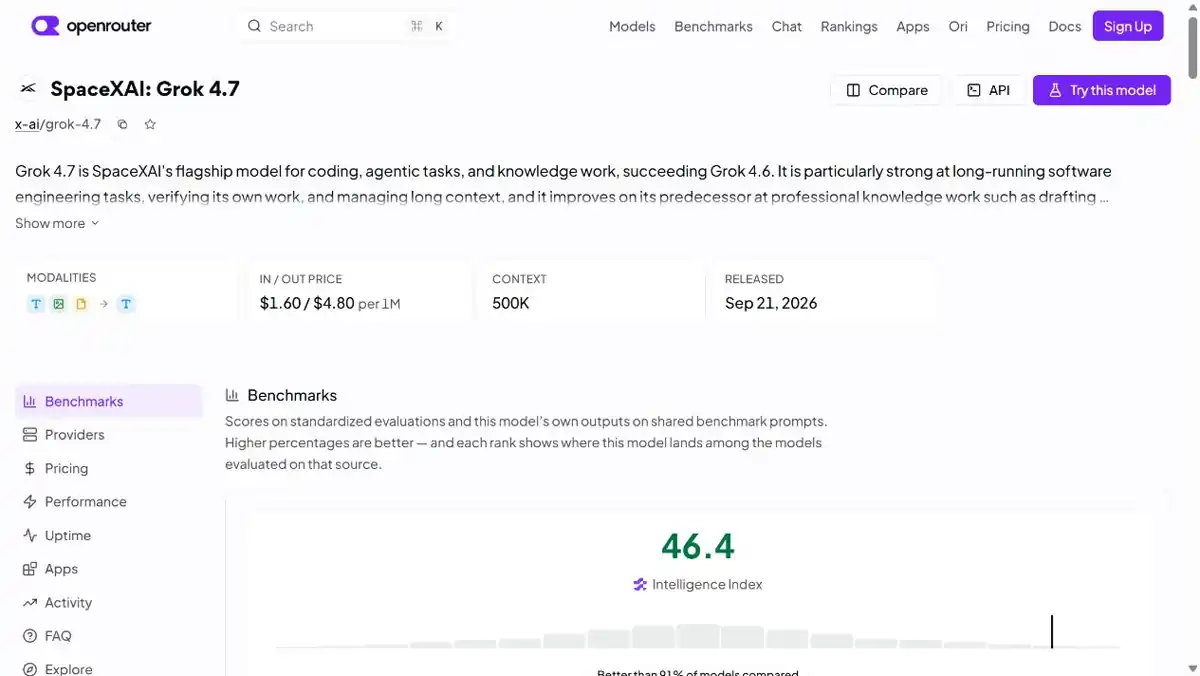
価格設定に関しては、モデルレビューが誤解を招きやすい傾向があります。読者が目にする数字には、少なくとも3つの異なるものがあります。xAIのAPI直接価格、アグリゲーター経由の価格、そして消費者向けサブスクリプション価格です。これらは互いに置き換え可能なものではありません。.
xAIの発表によると、Grok 4.7はGrok 4.6と同じ価格と速度で提供される。ローンチページによると、スタンダードモデルの価格は 入力トークン100万枚につき$2 そして 発行されるトークン100万枚につき$6; 『Artificial Analysis』では、同じ直行ルートに関する数値が個別に記載されており、 キャッシュされた入力トークン100万個につき $0.50. xAIによると、高速版は価格が2倍になる代わりに、出力速度が2倍になるという。以下の 公式の開発者向けドキュメント 本番環境へのトラフィックを送信する前に、現在のAPI契約およびアカウントごとの利用状況を確認してください。.
OpenRouterのGrok 4.7ページ 表示 入力トークン100万枚あたり $1.60 そして 発行されるトークン100万枚あたり$4.80 そのルートについて。これはOpenRouter/プロバイダーの価格であり、xAIの直接定価に対する修正価格ではありません。ルーティング、マージン、キャッシュ、制限、および利用可能性はプロバイダーによって異なる場合があります。.
「Grok 4.7はいくらですか?」という質問に対して、輸送ルートを明記せずに一概に正しい答えを出すことはできません。APIの購入者の方は、以下の点を比較してください:
- 入力および出力のトークンレート;;
- キャッシュされた入力の処理;;
- コンテキストおよび出力の制限;;
- レート制限および地域ごとの利用可能状況;;
- プロバイダーが推論制御機能を公開しているかどうか;;
- 記録、保存、およびデータ処理に関する条件。.
コンシューマー向けアクセスについては、APIの価格がXやGrokのサブスクリプションの価格を示しているとは限りません。コンシューマープラン、APIルート、およびサードパーティのアグリゲーターによって、アクセスルールが異なる場合があります。.
どのAPIルートを選べばよいでしょうか?
| ルート | 最適 | 使用前に確認すべき事項 | 主なトレードオフ |
|---|---|---|---|
| DirectX AI API | プロバイダー独自の契約が必要な本番システム | 公式モデルID、レート制限、データ利用規約、対応地域、ストリーミング、および現在の価格 | 出所が最も明確ですが、請求や空き状況の管理はご自身で行っていただきます |
| オープンルーター | プロバイダーの迅速な比較とルートの試行 | 実際の上流プロバイダ、ルート価格、キャッシュ、プライバシー、コンテキスト、およびフォールバック動作 | 乗り換えは簡単ですが、ルートはxAIサービスの直行便とは異なります |
| OpenAI対応のテストAPI | 内部評価、あるいはすでにOpenAIスキーマに対応しているレガシークライアント | モデルのマッピング、タイムアウト制限、ストリーミングのサポート、使用状況フィールド、保存期間、およびエラーのセマンティクス | 統合は便利ですが、互換性があるからといってプロバイダの動作が完全に同一になるとは限りません |
実習セクションで使用された互換ルートは、次のように返されました grok-4.7 また、ストリーミングにも対応していました。ストリーミング以外のエンコード要求は、ストリーミングによる再試行が完了する前に、ゲートウェイの待機ウィンドウを超過してしまいました。この観察結果はクライアントを設計する際に有用ですが、それをそのままxAIのレイテンシに関する主張に転用すべきではありません。.
Grok 4.7へのアクセス方法
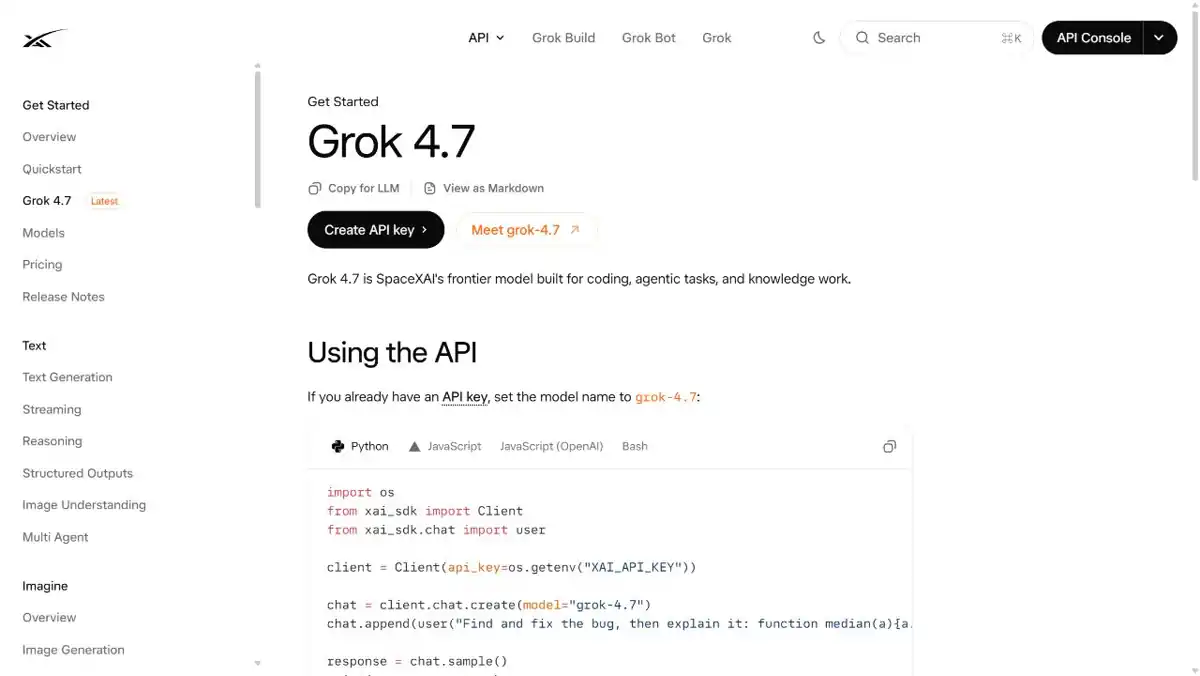
最もすっきりとした方法は、まず xAIの発表 そして xAI 開発者向けページ, その後、Grok Build、Cursor、ダイレクトAPI、またはアグリゲーターのどれが必要かを確認してください。 xAIによると、Grok 4.7は、CursorおよびGrok Build、Grok API、ならびにサードパーティ製のコーディングハネス、モデルルーター、クラウドプラットフォームを通じて利用可能です。この区別によって、課金、モデルの制御、プライバシー規約、および利用可能なツールが決まります。.
アグリゲーターを使用する場合は、そのモデルページを開き、プロバイダーのルート、トークン価格、コンテキスト制限、およびモデル識別子を確認してから、それに基づいて構築を行ってください。OpenRouterは文書化されているルートの一つですが、その価格設定をxAIの課金表にコピーしてはいけません。.
1つのワークスペースで複数のモデルファミリーを比較したい読者の皆様へ、, GlobalGPTのマルチモデルワークスペース プロンプトの並列評価に役立つ可能性があります。この記事では、 ない 「Grok 4.7 ルートはすでに利用可能である」と主張しています。カタログに掲載されているルートの利用可否については別途確認が必要であり、購入前に製品のUIで確認する必要があります。.
Grok 4.7 対 ChatGPT、Claude、および Gemini
このレビューには、Grok 4.7のタスク結果が3件含まれていますが、ChatGPT、Claude、Geminiとの比較結果は含まれていません。したがって、「Grok 4.7が勝っている」という一概な結論は、依然としてマーケティングに過ぎず、分析とは言えません。 より適切な判断は、そのモデルをめぐる研究内容次第である:
| もし優先順位が高ければ... | まずは評価することから始めましょう… | なぜ |
|---|---|---|
| 長文の技術的なパケット | Grok 4.7 およびその他の大規模コンテキストルート | 宣伝されている期間だけでなく、検索の精度も確認してください |
| リポジトリのデバッグ | Grok 4.7、コーディングに特化したモデル、そして通常のテストループ | 根本原因の品質とレビュー時間を比較する |
| ソースファーストの研究 | 研究志向のワークフローと汎用推論モデルの組み合わせ | 結論を受け入れる前に、引用文献を確認する |
| 既存の生産性向上向け連携機能 | お使いのツールにすでに組み込まれているモデル | 切り替えコストは、ベンチマークの収益を上回る可能性がある |
| API利用料が最も安い | ダイレクトルートとアグリゲータルートを並べて表示 | 価格はプロバイダーやキャッシュの動作によって異なります |
について “「どのAIにお金を払う価値があるのか?」ガイド 適切な購入判断の基準を用いるべきだ。つまり、「どの定常的なタスクが、サブスクリプションやAPIの利用料金に見合うだけの価値を生み出すようになるか」という問いである。これは、ランキングの最新順位を追いかけるよりも、より持続可能な意思決定の指針となる。.
限界と未解決の問題
Grok 4.7は登場して間もないため、独立した専門家による広範な合意が形成されるには至っていない。現時点で入手可能な証拠からは、いくつかの疑問が残されている:
- コーディング、調査、執筆、およびマルチモーダルな課題において、その向上ぶりはどの程度一貫しているのでしょうか?
- 500Kのコンテキストは限界付近でも信頼性を維持できるのでしょうか、それともそれより前に検索精度が低下してしまうのでしょうか?
- 最も高度な推論処理を行うと、どの程度の追加のレイテンシが生じるのでしょうか?
- このモデルは、どのコンシューマープラン、地域、ツール、およびレート制限を通じて公開されていますか?
- 正当ではあるが機密性の高い技術的な作業に対して、新しいセーフガードはどのように機能するのでしょうか?
- direct xAI、OpenRouter、およびその他のプロバイダーは、出力や制限値に実質的な違いがありますか?
こうした疑問は、そのモデルを却下する理由にはなりません。それこそが、ワークフローを移行したり、コスト削減を約束したりする前に、小規模ながらも代表的な評価を実施すべき理由なのです。.
Grok 4.7はどのような方に適していますか?
次のような場合は、まず Grok 4.7 を試してみる価値があります:
- 長時間、コードのデバッグや技術資料の分析を行うこと;;
- 通常のチャットウィンドウの表示範囲を超えるソースパケットを扱う;;
- 難しいプロンプトに対して、より多くの労力を惜しまないモデルを高く評価する;;
- 出力を本番環境に直接送信するのではなく、確認することができます;;
- APIを直接利用する場合とアグリゲーターを利用する場合の経済性を比較している。.
成熟した統合機能や、明確に文書化されたコンシューマープラン、あるいは既存のスタックに組み込まれているモデルに対して、同一タスクにおいて実証済みの優位性が必要な場合には、このソリューションの適合度は低くなります。そのようなケースでは、2ポイントのインデックス向上よりも、アクセス層やワークフロー層の方が重要になる可能性があります。.
よくあるご質問
Grok 4.7とは何ですか?
Grok 4.7は、xAIが2026年9月21日にリリースした、コーディングおよびナレッジワーク向けのモデルです。xAIによると、このモデルは困難なタスクに対してより長時間処理を行い、作業結果をより入念にチェックするほか、新たな安全対策スタックを追加しつつ、Grok 4.6と同等の価格と処理速度を維持しているとのことです。.
Grok 4.7はいつリリースされましたか?
xAIは2026年9月21日、Grok 4.7を発表しました。リリース状況、モデルの提供状況、APIの変更点については、公式のローンチページおよび開発者向けドキュメントが最も信頼できる情報源です。.
Grok 4.7は、Grok 4.6よりも優れていますか?
Artificial Analysisによると、インテリジェンス指数は46で、Grok 4.6を2ポイント上回っており、AA-Briefcase Eloは1,657で、4.6を111ポイント上回っています。これらは有用な指標ではありますが、すべてのワークフローに当てはまる普遍的な結果というわけではありません。.
Grok 4.7のコンテキストウィンドウとは何ですか?
「Artificial Analysis」によると、Grok 4.7では50万トークンのコンテキストウィンドウが指定されています。ウィンドウを大きくしたからといって完璧な検索結果が得られるとは限らないため、資料量の多い作業にこのモデルを活用する前に、長い文書内のさまざまな位置に配置された事実を用いてモデルをテストしてください。.
Grok 4.7 APIの価格はいくらですか?
Artificial Analysisによると、直接API経由の場合、入力トークン100万トークンあたり$2、出力トークン100万トークンあたり$6となり、キャッシュされた入力の場合は100万トークンあたり$0.50となっています。本番環境での使用前には、xAIの最新ドキュメントをご確認ください。.
OpenRouterのGrok 4.7の価格は、xAIのものと同じですか?
いいえ。OpenRouterでは、ルートについて、入力トークン100万トークンあたり$1.60、出力トークン100万トークンあたり$4.80と記載されています。 これはプロバイダー固有の価格であり、xAIの直接API価格とは別個に比較する必要があります。また、OpenRouterにはプロバイダー固有のキャッシュ、レイテンシ、スループット、プライバシーに関する項目も表示されており、これらはルートの実際のコストに影響を与える可能性があります。.
Grok 4.7にはどのようにアクセスすればよいですか?
まずはxAIの公式発表と開発者向けドキュメントを確認し、その後、コンシューマー向け製品「Grok」、xAIの直接API、またはOpenRouterなどのアグリゲーターのいずれかを選択してください。実際に利用するルートについて、モデルID、リージョン、レート制限、コンテキスト、および課金条件を確認してください。.
Grok 4.7はGlobalGPTで利用可能ですか?
このレビューは、GlobalGPTにおけるGrok 4.7ルートの検証済みであることを主張するものではありません。GlobalGPTは、利用可能なモデルファミリーを比較するために使用できますが、購入前には、製品のUIで最新のカタログおよび正確なモデルの在庫状況を確認してください。.
Grok 4.7は、コーディング剤に適していますか?
エージェントが仮定を説明し、テストを作成しなければならない、バウンドデバッグ、コードレビュー、および複数ファイルにわたる推論については、テストを行う価値がある。実践的なコーディング課題は充実していたが、ツールの実行、リポジトリの編集、権限、あるいはエージェントのループ全体についてはテストされていなかった。.
なぜコーディングテストにストリーミングが必要だったのでしょうか?
最初の非ストリーミング要求が、テストルートのゲートウェイ待機ウィンドウを超過しました。ストリーミングを有効にした場合、同じプロンプトは正常に完了しました。これは、本番環境のクライアントがストリーミングと明示的なタイムアウトをサポートすべき理由を示していますが、すべての Grok 4.7 ルートが同じレイテンシの挙動を示すことを証明するものではありません。.
500Kのコンテキストウィンドウはどのようにテストすればよいでしょうか?
冒頭、中間、末尾に決定的な事実を配置した固定パケットを使用し、さらに意図的に1つの矛盾を含めます。公表されている最大値だけに頼るのではなく、情報源の位置を尋ね、複数の入力サイズにおいて、記憶の再現性、矛盾への対処、および応答遅延を評価してください。.
Grok 4.6からGrok 4.7へアップグレードする価値はあるでしょうか?
現時点での検証結果は、有意義ではあるものの段階的なアップグレードを支持するものです。独立した測定結果が改善されており、実機での実行においても、デバッグやソース合成の面で優れた結果が得られました。アップグレードは、自身のタスクにおいてレビュー工数の削減や精度の向上が確認され、かつルート固有のコストが正当化できる場合にのみ実施してください。.
最終評決
Grok 4.7は、持続的な努力が報われるコーディングやナレッジワークという明確な目標を掲げた、本格的な段階的なモデルアップグレードのように見えます。 公式リリースではこの変更について説得力のある説明がなされており、Artificial Analysisの初期データもGrok 4.6に比べて後退ではなく改善を示しており、当社のAPI実行結果も、より小規模ながらも実用的な兆候を示しています。このモデルは、同時実行のバグやソースの競合するメモを特にうまく処理しましたが、計画に関する回答は慎重ではあったものの、求められていたほど実用的なものではありませんでした。.
率直な評価としては、現時点ではまだ暫定的なものです。これらは1つのテストルートでの3回の単発実行結果であり、最も時間がかかったタスクでは、ストリーミング非対応のゲートウェイのタイムアウト後にストリーミングが必要となりました。また、これと一致する競合他社の実行結果や、広範な独立したコンセンサスも存在しません。 まずは実際のワークフローから1つの難しいタスクを選び、その出力とレビュー時間を、現在使用しているモデルと比較し、そのルート固有のコストに見合うだけの価値があるかどうかを判断してください。.









