GPT-6 AstraとClaude Fable 5.1は、APIの公式価格では同額から始まりますが、当社が実施した互換性APIテストでは、その挙動に違いが見られました。. Astraは、推論、文章作成、コーディング、長文コンテキストの検索、戦略立案の各分野において、より実用的な可視出力を生成しました。Fableは長文コンテキストの正確性テストで同点となり、説得力のあるローンチコピーを作成しましたが、この特定のルートでは、いくつかの実行結果が途中で切り詰められたり、空白になったりしました。.

ひとくちレビュー
GPT-6 アストラ · 43/50
長文コンテキストの検索 · 各10/10
互換性ルーティングが、Fableの出力が空白になる原因である可能性があります。.
分析業務と技術業務が混在する作業において、信頼性の高い初期回答が必要な場合は、GPT-6 Astraを選択してください。 ご自身のエンドポイントが可視出力の処理について検証済みであり、長文コンテキストの解釈や抑制された表現を重視する場合は、「Claude Fable 5.1」を選択してください。これは普遍的なモデルランキングではありません。2026年9月8日にBroly Anywhereを通じて実施された、1回の制御された実行結果です。.
GPT-6 Astra 対 Claude Fable 5.1 の比較概要
| フィールド | GPT-6 アストラ | Claude Fable 5.1 |
|---|---|---|
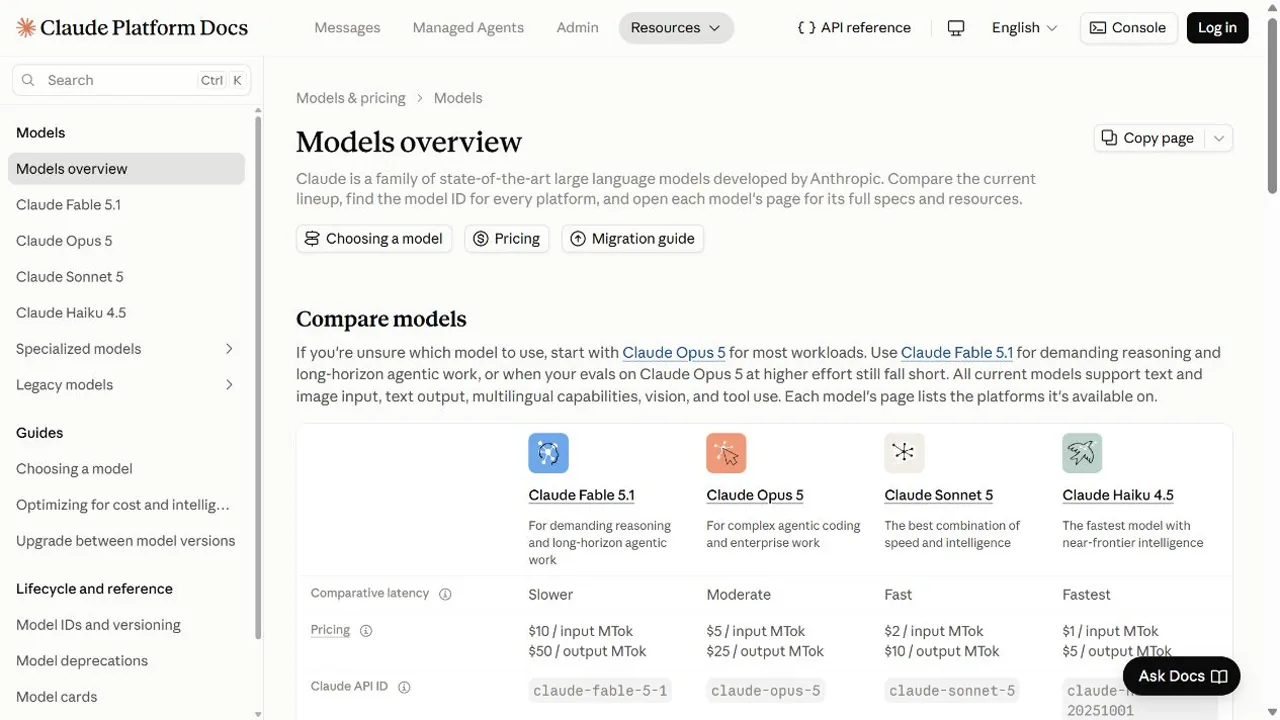
| API ID | gpt-6-astra | claude-fable-5-1 |
| 文脈 | 105万トークン | 100万トークン |
| 最大出力 | 128Kトークン | 128Kトークン |
| 基本入力 | $10 / 1M | $10 / 1M |
| キャッシュされた入力/ヒット | $1 / 1M | $0.25 / 1M |
| 出力 | $50 / 1M | $50 / 1M |
| バッチ | 標準仕様の50% | 1Mあたり$5入力/$25出力 |
| 推論 | 設定可能な推論の労力 | 適応的な思考を常に維持し、デフォルトで高いレベルを保つ |
| 測定されたテストの得点 | 43/50 | 19/50 |
モデルに関するより詳しい背景については、当社の GPT-6 Astra レビュー, Claude Fable 5.1 ガイド, そして Claudeモデルの比較.
価格設定、キャッシュ、コンテキスト、および制限
どちらのモデルも、入力トークン100万個あたり$10、出力トークン100万個あたり$50と記載されています。動作上の違いはキャッシュ処理にあります。GPT-6 Astraは、キャッシュされた入力トークン100万個あたり$1、キャッシュ書き込みレートが$12.50と記載されています。 Fable 5.1は、100万トークンあたり$0.25のキャッシュヒット、$12.50の5分ごとの書き込み、および$20の1時間ごとの書き込みを規定しています。 Anthropicによると、100万トークンのコンテキスト全体については標準価格のままですが、Astraでは入力が272Kトークンを超えるとより高い価格が適用されます。.
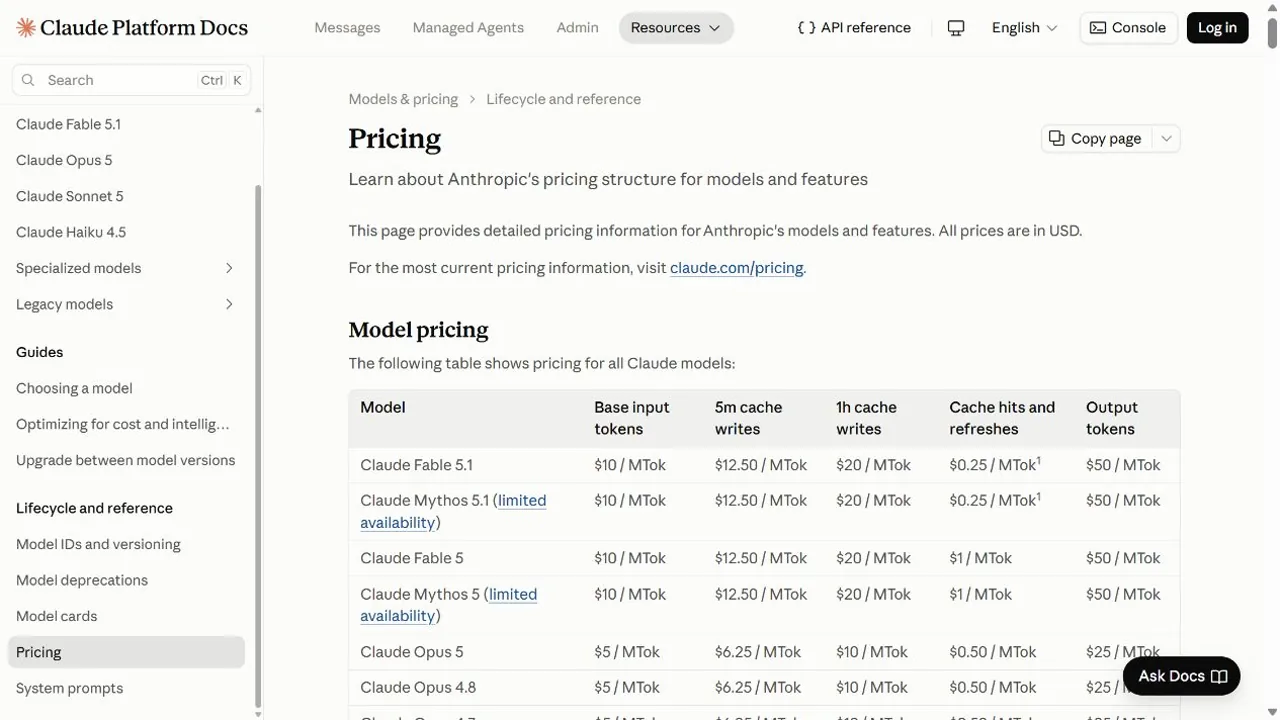
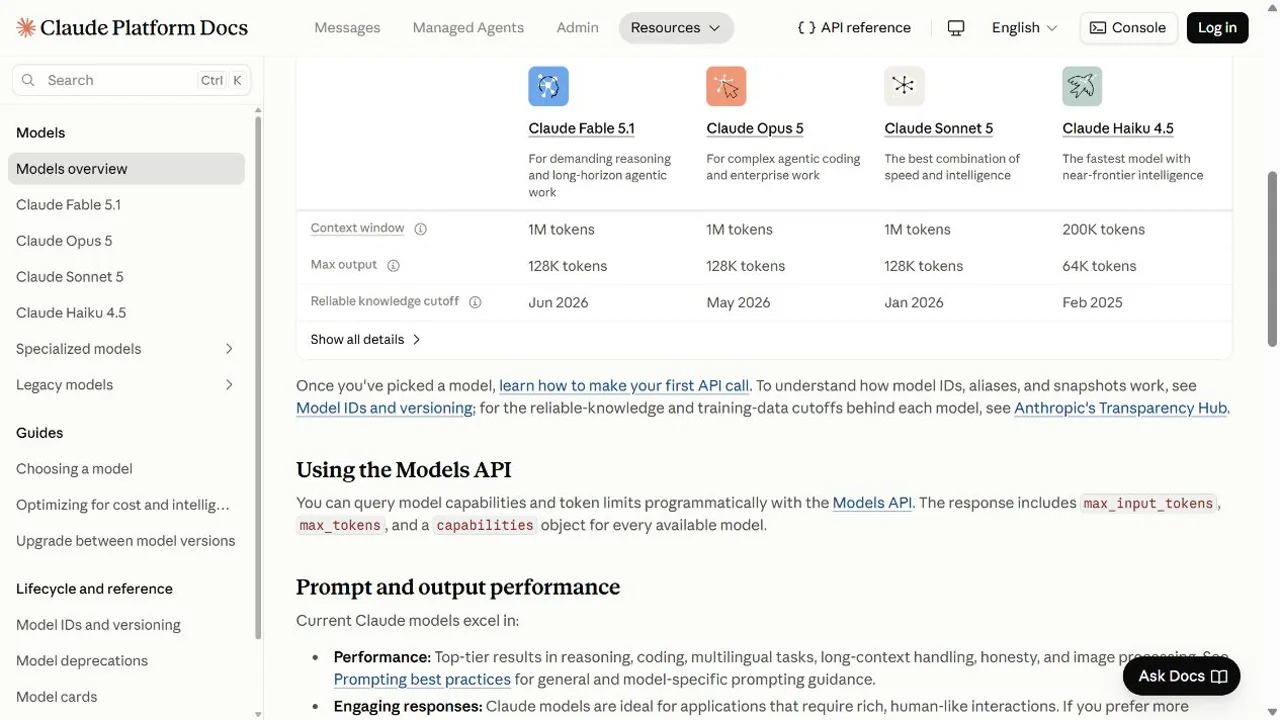
全文を読む GPT-6 Astra の価格内訳 あるいは、当社の製品と Claude Fable 価格ガイド. プロバイダーの定価は、必ずしもGlobalGPTクレジットや互換性レイヤーの課金額と一致するわけではありません。.
一致したAPIテストが5件
同じOpenAI対応エンドポイントを通じて、各モデルIDに同じタスクを送信しました。テスト1~4では、最大2,000個の出力トークンが許可されていました。テスト5では、ゲートウェイが約30秒で長時間の非ストリーミングリクエストを切断したため、両方のテストで1,200個を使用しました。 すべてのスコアは、テスト前に定義された5つのルールに基づいて算出されています。結果が空白の場合、目に見えない作業に対しては評価点が付与されません。.
理由:SaaSのコストに関する意思決定
Astraは財務モデルを完成させたが、Fableは前提条件の策定の段階で中断した。.
タスクの詳細を表示
HTTP 200 · 28.98秒 · 入力 242件 · 完了 1,427件 · スコア 10/10
HTTP 200 · 26.01秒 · 入力357件 · 完了2,000件 · スコア 1/10
執筆:製品発売に関する編集
どちらも実用的な原稿が完成しましたが、『Fable』にはメモにはなかった詳細が盛り込まれていました。.
タスクの詳細を表示
HTTP 200 · 15.47秒 · 入力165件 · 完了500件 · スコア 10/10
HTTP 200 · 26.01秒 · 入力 263件 · 完了 1,881件 · スコア 8/10
コーディング:TypeScriptの並行処理
アストラは確かな診断結果と一部の検査結果を返したが、フェイブルはこのルートでは目に見える回答を返さなかった。.
タスクの詳細を表示
HTTP 200 · 41.54秒 · 入力181件 · 完了2,000件 · スコア 9/10
HTTP 200 · 29.44秒 · 入力 277件 · 完了 2,000件 · スコア 0/10
詳細な背景:植栽に関する修正案
両者とも、決定的な根拠となる第417条の改正条文を引用し、その内容を指摘した。.
タスクの詳細を表示
HTTP 200 · 14.96秒 · 入力 99,495件 · 完了 244件 · スコア 10/10
HTTP 200 · 22.24秒 · 入力 295,912件 · 完了 1,053件 · スコア 10/10
戦略:90日間の市場投入(GTM)計画
アストラは着実な計画に着手したが、途中で打ち切られてしまった。フェイブルからは目に見えるような回答は得られなかった。.
タスクの詳細を表示
HTTP 200 · 34.27秒 · 入力210件 · 完了1,200件 · スコア 4/10
HTTP 200 · 21.09秒 · 入力 338件 · 完了 1,200件 · スコア 0/10
どのモデルを選べばいいでしょうか?
- 推論と運用上の決定: 今回の走行では、アストラの方がはるかに完成度が高かった。.
- 執筆: どちらも実用的なものでした。Astraは原曲の音符により忠実でしたが、Fableは洗練されたサウンドだったものの、インターフェースの細部については独自に脚色されていました。.
- コーディング: Astraの方が、より明確な診断結果を示しました。当方のデータにおけるより広範囲なパターンを比較すると、 Claude 対 ChatGPT コーディングガイド.
- 長い文書: 両者ともその矛盾を正確に見つけ出しました。トークンの会計処理は大きく異なっていたため、ご自身の資料を使ってコストを検証してください。.
- 主体性に基づく戦略: どちらも最終期限内に制約のあるタスクを完了できなかったが、Astraはそれでも実用可能な部分的な成果を返した。.
別のベンチマークフレームについては、以下を参照してください。 GPT-6 Astra 対 GPT-5.6 Sol または クロード・フェイブル5 対 GPT-5.5.
GlobalGPTで両者を比較する方法
GlobalGPTは、両方のモデルに対して個別のランディングルートを公開しています。同じプロンプト、出力制約、およびソース資料を使用し、スタイルよりも先に可視的な正しさを評価してください。インターフェースやAPIがレイテンシやトークン使用量を返す場合は、それらを記録してください。長い文書の場合、同一のテキストでもトークン化の仕方が異なる可能性があるため、各ルートを個別に測定してください。.
よくある質問
GPT-6 AstraはClaude Fable 5.1よりも安いですか?
基本の入出力定価は同じです。キャッシュヒット時の価格設定やロングコンテキストに関するルールは異なりますが、GlobalGPTの課金では別のクレジットが適用される場合があります。.
どちらのモデルの方がコンテキストウィンドウが大きいですか?
GPT-6 Astraは105万トークン、Claude Fable 5.1は100万トークンをリストアップしています。いずれも最大出力は12万トークンと記載されています。.
コーディングにはどちらが適していたのでしょうか?
単一のTypeScriptテストにおいて、GPT-6 Astraの方がより明確な回答を生成しました。Fableはこの互換性ルートを通じて目に見えるコンテンツを返さなかったため、これはプロバイダー固有の結論ではありません。.
長い文脈の検索には、どちらが適していたでしょうか?
両者は10対10で同点となり、同じ仕込まれた修正案を見つけ出して引用した。Fableは、同一の書類に対して、入力トークンの数がほぼ3倍多いと報告した。.
なぜ『Fable』のスコアは低かったのでしょうか?
いくつかのFable呼び出しで、完了トークンが消費されたにもかかわらず、表示されるコンテンツが切り詰められたり空白になったりしました。これは、互換性レイヤーまたは出力シリアライゼーションに関する問題である可能性があります。.
GlobalGPTでは、両方のモデルを使用できますか?
はい。2026年9月8日に確認したところ、GlobalGPTの専用ルートは両方とも稼働中でした。.
最終評決
このテストセットでは、GPT-6 Astraの方がより安全なデフォルト選択肢と言えます。より完全で実用的な結果を返し、50問中43問正解したのに対し、もう一方のモデルは19問正解にとどまりました。Claude Fable 5.1も、長文コンテキストの正確性タスクではAstraと同等の精度を示し、堅実なマーケティングコピーを生成しました。 Fableを却下する前に、本番環境のエンドポイントを通じてテストを繰り返してください。2回連続で空白の出力が得られた場合は、モデルの挙動だけでなく、統合環境の挙動についても警告と見なすべきです。.