
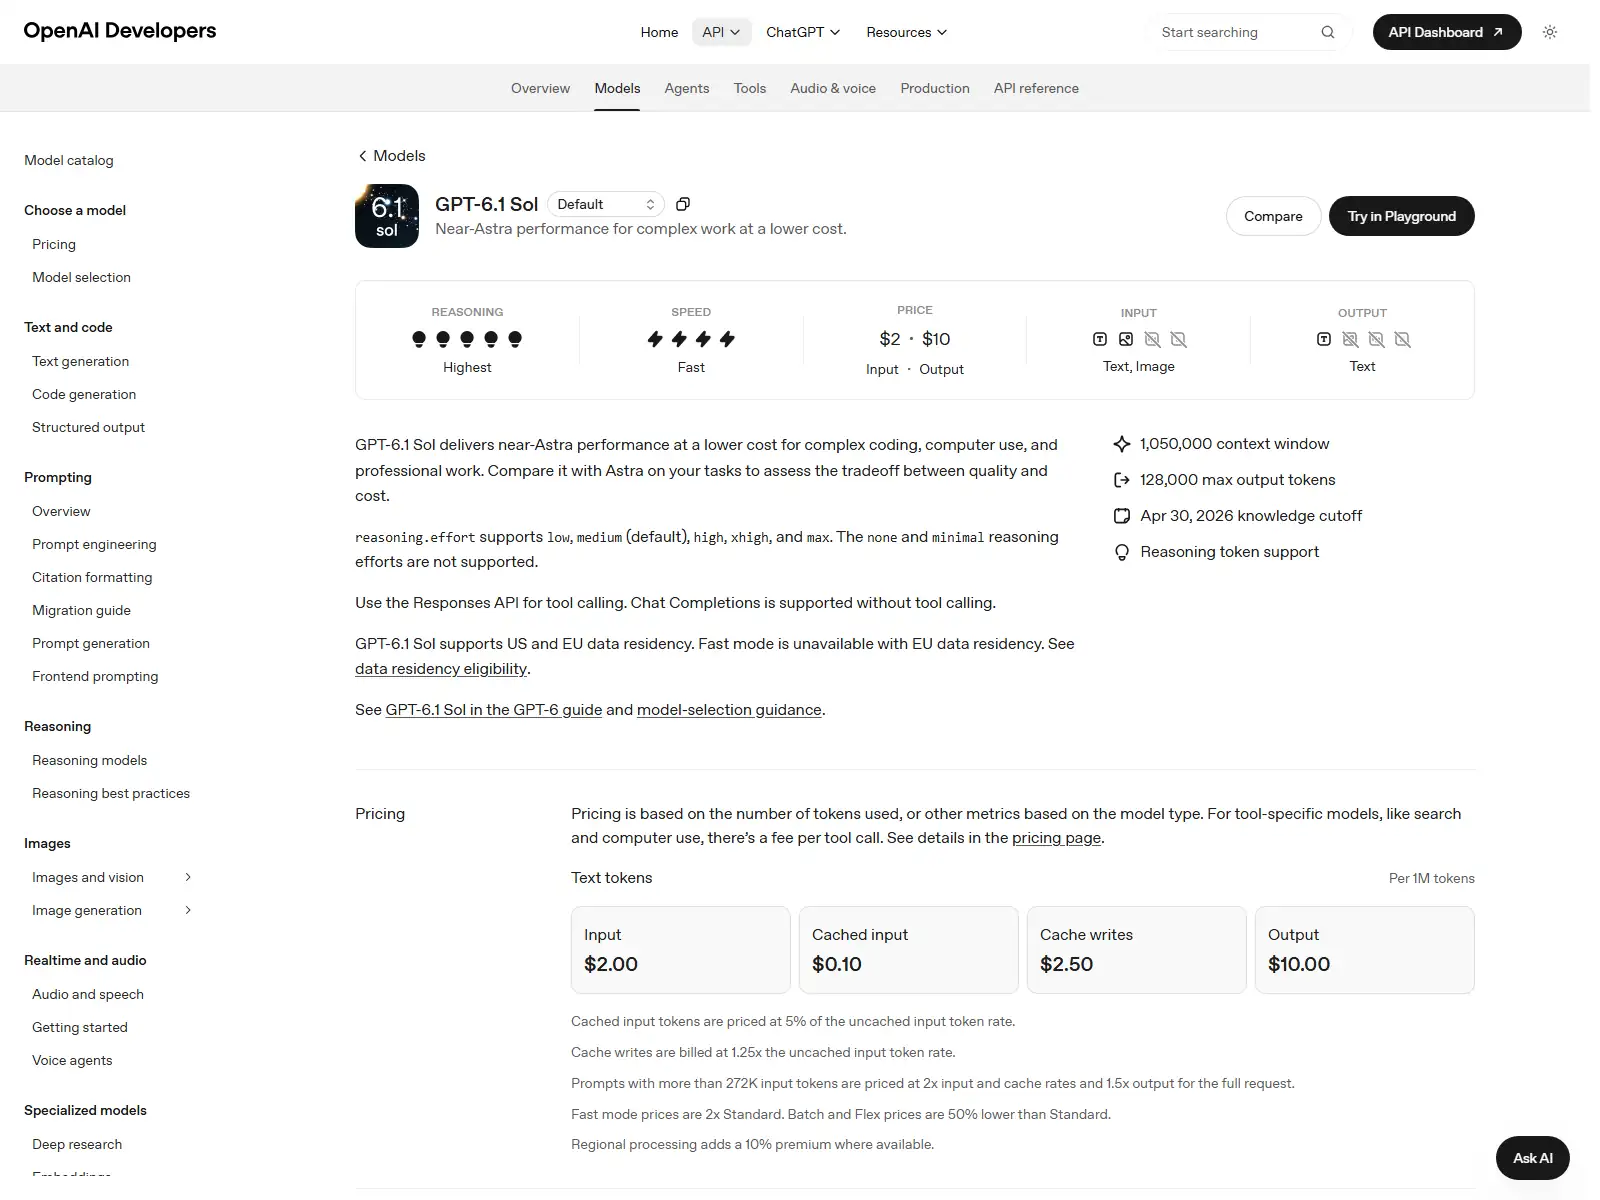
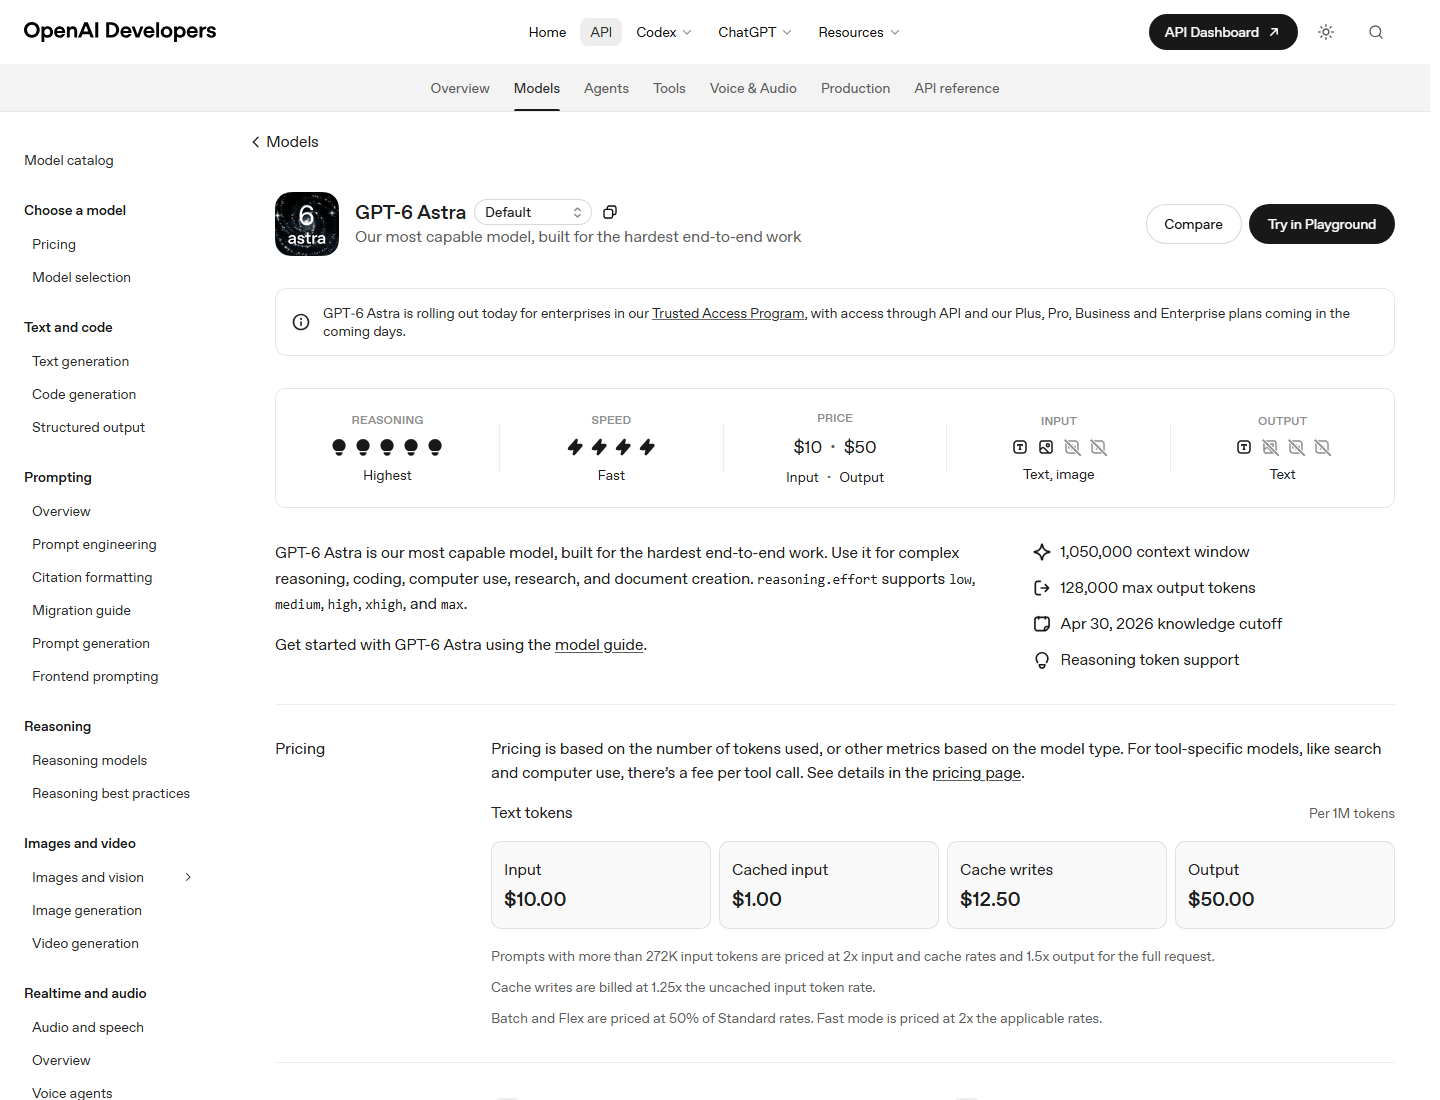
GPT-6.1 Sol は価値のデフォルトであり、GPT-6 Astra は品質の上限です。. どちらも、1,050,000トークンのコンテキストウィンドウ、128,000トークンの出力制限、マルチモーダル入力、そして幅広いツールセットを備えています。 決定的な違いは、ポジショニングと価格にあります。Solは入力トークン100万トークンあたり$2、出力トークン100万トークンあたり$10のコストがかかるのに対し、Astraはそれぞれ$10と$50のコストがかかります。 つまり、Astraは、5倍高いStandardトークンのコストを正当化できるだけの十分な付加価値を生み出さなければならない。.
だからといって、Solが「より安価な同等のモデル」というわけではない。OpenAIは、Astraを「最も過酷なエンドツーエンドの作業に対応できる最高性能のモデル」と位置づけ、Solについては「複雑な作業においてAstraに匹敵する性能を、より低コストで実現する」と説明している。したがって、正しい選択は評価の問題であり、単なるブランド順位の比較ではない。この比較では、現在の GPT-6.1 Sol ドキュメント, その GPT-6 Astra モデルページ, 、および2026年10月9日に確認された同一のコストシナリオ。.
GPT-6.1 Sol 対 GPT-6 Astra:簡単な比較
この表を見れば、最初の判断は簡単です。タスクに特化したエビデンスがまだない場合は、主要なインターフェースや処理能力の特性を維持しつつ、トークンコストを大幅に削減できるため、Solを最初に試す価値があります。一方、作業が異常に困難な場合、誤答によるデメリットが大きい場合、あるいはその優れた結果によって人間やモデルによる修正を数回回避できる場合には、Astraが合理的な選択となります。.
これは、Solを小型で高速なモデルと比較する場合とは異なります。OpenAIの現在のファミリーガイダンスによれば、Solは最下位ではなく、トップクラスに位置づけられています。ラインナップ全体から選択を検討している読者の皆様は、当社の 優れたAIモデルのガイド そして GPT-6 Luna レビュー どのような場合に軽量モデルで十分なのかを確認するため。.
GPT-6.1 SolとGPT-6 Astraの共通点
2つの公式モデルページには、コンテキストウィンドウ、最大入力、最大出力、および知識のカットオフ値が同じように記載されています。どちらもテキストと画像を受け入れ、テキストを出力します。 いずれのページにも、モデルのネイティブ入力または出力として音声や動画が記載されていません。また、推論負荷も「低」「中」「高」「x高」「最大」の5段階が共通しており、デフォルトは「中」に設定されています。この対称性により、A/Bテストが簡素化されます。アプリケーションは、モデルIDのみを切り替えつつ、ほとんどのリクエストパラメータを一定に保つことができるからです。.
どちらのモデルも、構造化出力、関数呼び出し、Web検索、ファイル検索、画像生成、コードインタプリタ、ホスト型シェル、パッチの適用、コンピュータの利用、MCP、スキル、ツール検索に対応しています。OpenAIでは、Responses APIを介したツール呼び出しが記載されています。ツールが関与しない場合は、「Chat Completions」が利用可能です。 どちらのモデルページでも、ファインチューニングはサポートされていません。これらは機能の宣言であり、2つのモデルが同一の精度でツールを選択することを保証するものではありません。.
100万トークンのコンテキストウィンドウは「容量」であり、検索設計を無視してよいという許可ではありません。非常に長いリクエストは処理コストが高く、デバッグも困難であり、入力トークン数が272Kを超えると価格帯が上昇します。チャンキング、検索、要約、プロンプトのキャッシュは依然として重要です。 この警告は、128Kという出力上限についても同様です。通常、1つの巨大な応答よりも、検証可能な小さな成果物の方が安全です。.
価格設定:5倍の格差
標準料金では、GPT-6.1 Solの料金は、キャッシュされていない入力トークン100万個あたり$2、キャッシュされた入力の場合は$0.10、キャッシュへの書き込みの場合は$2.50、出力の場合は$10となります。 GPT-6 Astraの料金は、それぞれ$10、$1、$12.50、$50です。 Solは、キャッシュ未保存の入力、キャッシュ書き込み、および出力において5倍安く、キャッシュ保存された入力では10倍安くなります。現在の数値は、OpenAIのモデルページから直接引用したものであり、 APIの価格に関するドキュメント.
ヘッドライン比率は請求額のすべてではありません。リクエストの入力トークン数が272Kを超えると、OpenAIでは、リクエスト全体に対して通常の入力レートおよびキャッシュレートの2倍、出力レートの1.5倍が適用されます。 BatchおよびFlexの料金はStandardの50%に設定されていますが、Fastは適用レートの2倍となります。AstraにはUltrafastというティアも用意されています。同等の条件で比較してください。SolのBatchリクエストとAstraのFastリクエストを比較しても、その背後にあるモデルと価格の比率は明らかになりません。.
フラッグシップクラスのより詳細な内訳については、当社の GPT-6 Astra 価格ガイド. 以前の GPT-6 Solの価格分析 これは、以前のSol世代からの移行を計画する際に役立ちますが、生産量の予測には、正確な現在のモデルIDと現在のレートを使用する必要があります。.
ロングコンテキスト設計:同じ容量、異なる経済性
1,050,000トークンという同一のコンテキストウィンドウにより、文書量の多い作業においてはSolとAstraは互換性があるように見えるかもしれませんが、処理能力はあくまで最初の制約に過ぎません。 制限値に近いリクエストであっても、適切な証拠を特定し、指示と引用部分を区別し、多数のファイルにわたる関係を維持し、人間やプログラムが検証可能な結果を返さなければなりません。より大きな名前を持つモデルであっても、情報アーキテクチャの必要性がなくなるわけではありません。情報源を整理し、境界にラベルを付け、安定した文書識別子への引用を明記する必要があります。.
Solの低コスト化により、長期コンテキストを用いた実験が経済的に実現可能になりました。チームは、Astraを1回実行するコストで、複数のチャンキング戦略、検索閾値、要約形式をテストできます。この広範な探索により、たとえAstraが単一のプロンプトで勝ったとしても、システムを改善できる可能性があります。 ワークフローが安定し、未解決のエラーが真にモデルの限界によるものである段階に至ると、アストラの有用性はさらに高まります。開発の初期段階では、予算のすべてを少数の主要な呼び出しに費やすよりも、多くの代表的なケースにわたって体系的なSol評価を実行した方が、より多くの知見が得られる可能性があります。.
272Kという閾値については、特に注意深く監視する必要があります。入力トークン数が271Kのリクエストと273Kのリクエストはサイズが近いですが、後者の場合、リクエスト全体がより高い料金帯に分類されてしまいます。 プリフライト段階でトークン数を推定し、各ジョブがどのバンドに属したかを記録してください。入力が閾値をわずかに超えている場合は、重複する定型文、古い会話履歴、または価値の低い検索結果のパッセージを削除することで、品質を損なうことなくコストを大幅に削減できる可能性があります。この最適化は両方のモデルに適用されますが、Astraは基本レートが高いため、誤りのコストがより高くなります。.
プロンプトのキャッシュは、大規模なプレフィックスが呼び出し間で安定している場合に最も有用です。例としては、ポリシーマニュアル、コーディング標準、製品カタログ、あるいは多くのタスクで共有されるツールスキーマなどが挙げられます。APIのキャッシュ動作がそのレイアウトに対応している場合は、安定したコンテンツを先に配置し、変動する指示は後回しにしてください。そして、キャッシュヒットを単に想定するのではなく、実際に測定してください。 Solのキャッシュ済み入力の利点は特に大きいですが、絶えず変化するプレフィックスによってその利点が失われる可能性があります。キャッシュの設計は、精度やレイテンシと同様に、ベンチマークレポートに記載すべき項目です。.
調査や文書分析を行う際は、段階的なワークフローを採用してください。まず、有力な証拠を抽出し、モデルに構造化された証拠マップの作成を依頼し、引用情報を検証した上で、初めて統合を依頼します。 エビデンスのパイプラインが適切であるにもかかわらず統合結果が不十分である場合、あるいは出典セットに異常に微妙な矛盾が含まれている場合は、Astraを使用してください。これにより、検索の失敗と推論の失敗を区別することができます。この区別がないと、チームは回避可能な文脈構築の問題を補うために、より高性能なモデルにコストを費やすことになりがちです。.
コーディングと道具の使用
コーディングに関して言えば、重要な問いは「どのモデルがコードを書けるか」ではありません。どちらも書けるからです。重要なのは、Astraの追加機能がどこで結果に違いをもたらすかということです。 Solは、スコープを限定した機能の実装、再現可能なバグの診断、プルリクエストのレビュー、テストの作成、データの変換、反復的なツールループの実行といった、一般的なリポジトリ作業において魅力的です。その低い実行コストにより、同じ予算内でより多くの試行、より多くの検証、そしてより大規模な評価セットが可能になります。.
Astraは、不確実性や調整が主となるタスクに活用するのが適しています。例えば、不慣れなモノレポへの移行、セキュリティ上重要なアーキテクチャのレビュー、長期的なコンピュータ利用、困難な異言語間移植、あるいは証拠が不完全な本番環境でのインシデントなどが挙げられます。1つの正しい計画によって数時間のやり直しを回避できるのであれば、最も高性能なモデルに割高な費用を払う価値は十分にあります。当社の コーディング比較に最適なAIモデル リポジトリのテストが、単なるコーディングの印象よりも重要な理由を説明しています。.
- 明確な受け入れテストを備えたスコープ化された機能
- 日常的なデバッグとコードレビュー
- 高ボリュームのエージェントループ
- 移行およびリファクタリングの草案
- テストの生成とドキュメント作成
- Solの実行後のハードフェイル
- リスクの高いセキュリティまたはデータ変更
- 曖昧なクロスシステムアーキテクチャ
- 長時間にわたる自律的なコンピュータ利用作業
- ミスが大きな代償を伴う場合の最終確認
一見妥当に見えるコードだけで、どちらのモデルも評価してはいけません。 両モデルに、同じリポジトリのスナップショット、指示、ツール、所要時間、およびテスト条件を提示してください。合格率、人間による修正、ツール呼び出しの失敗、トークン数、レイテンシ、およびコストを記録してください。コストは5倍かかるものの、失敗回数を半減させるモデルであれば正当化されるかもしれませんが、受容性を向上させずにスタイルのみを改善するモデルは正当化されません。.
実績に基づく証拠:結論として導き出せること、導き出せないこと
OpenAIのポジショニングは、最も説得力のある要約を提供しています。すなわち、Astraは最も困難なエンドツーエンドの作業において最高の能力を持つモデルである一方、GPT-6.1 Solは、複雑な作業においてAstraに迫る性能を、より低いコストで実現することを目指しています。これらの記述は、普遍的な性能差の割合を示すものではなく、選択の根拠となる仮説を裏付けるものです。 公開されているベンチマークだけでは、貴社の独自の文書、ツール、ポリシー、あるいはコードベースにおけるパフォーマンスを予測することはできません。.
ローンチ動画は、企業が製品をどのように位置づけているかを理解する上で有用ですが、それ自体は独立した評価ではありません。同様に、クリエイターによるレビューでは実際のインターフェースや実用的な例が紹介されていますが、それぞれのレビューは特定の課題設定、ツールの設定、および公開期限を反映したものです。 好意的なサムネイルや第一印象の評価は、AstraやSolがすべてのカテゴリーで勝っているという証拠ではなく、ご自身のテスト計画のヒントとして捉えてください。.
上記のOpenAI公式動画は、Astraのローンチ時の反響を記録したものです。以下の独立系サイト「Matt Wolfe」のページを見ると、サードパーティの注目がすぐにこのリリースの規模に集中したことがわかります。いずれのスクリーンショットも、ここでは数値的なベンチマークとして使用されていません。本記事では、熱狂度や閲覧数、あるいはクリエイターの肩書きを、根拠のないパフォーマンススコアに変換することを意図的に避けています。.
適切な比較を行うには、本番環境に近い独自の評価セットを使用します。簡単なタスク、典型的なタスク、および失敗した場合のコストが高いケースを含めます。人間の好みが重要となる場合は、出力を隠します。エージェントについては、最初の応答ではなく、タスクの完了と回復能力をテストします。OpenAIの モデル選択の指針 同様に、同一のタスクでモデルを比較し、品質基準を満たす中で最も軽量なモデルと推論負荷を採用することを推奨している。.
SolとAstraを公平に評価する方法
まず、評価によってどのような判断が下されるのかを定義することから始めます。「どのモデルがより賢いのか?」という問いは曖昧すぎます。有用な問いとしては、「このリポジトリのプルリクエストのレビューを、中程度の推論レベルで処理すべきモデルはどれか?」や、「最終的な契約合成をSolからAstraにエスカレーションすべきか?」といったものが挙げられます。 出力を生成する前に、タスクの分類、サービスレベル、推論の労力、ツール、時間制限、および受け入れ基準を明確に定めておきましょう。そうしないと、好ましい結果がモデルそのものではなく、設定によるものと解釈されてしまう可能性があります。.
一般的なケースと、意味のあるエッジケースを網羅できる十分な規模のデータセットを構築してください。慎重に選んだ20件の事例でも明らかな不具合は明らかになるかもしれませんが、本番環境のルーティングポリシーには通常、それ以上の事例が必要です。 機密情報を削除した上で、最近の実務事例からサンプルを抽出し、各ケースに難易度とリスクのタグを付けます。プロンプトのチューニングによって、誰もがすでに目にした例に対して徐々に過学習が生じないように、ロックされたホールドアウトセットを確保しておきましょう。アプリケーションコードにバージョン管理を行うのと同様に、データセットと評価ツールにもバージョン管理を行ってください。.
タスクの都合が許す限り、決定論的なチェックを優先してください。コードのコンパイル、テストの実行、スキーマに基づくJSONの検証、抽出されたフィールドとラベルの照合、引用箇所の確認などを行ってください。 人間の採点者は、明瞭さや判断力、推奨内容がビジネス上の文脈を尊重しているかどうかなど、自動化では十分に捉えきれない要素に焦点を当てるべきです。モデルの識別情報を隠蔽し、出力の順序をランダム化してください。採点者がどの回答がAstraによるものかを知っていると、価格や評判が、意図しない偏りをもたらすことなくスコアに影響を与える可能性があります。.
平均値だけでなく、重大度も追跡しましょう。10件の軽微なスタイル上の利点が、1件の重大なデータ損失に関する推奨事項を上回るべきではありません。 捏造された引用、安全でないコマンド、必須フィールドの欠落、法的制約の不遵守など、絶対的な拒否事由を定義する。難易度およびリスクカテゴリ別の分布を報告する。Solは通常の作業ではAstraと同等であり、最も難易度の高い5%のケースでのみ遅れをとる可能性がある。この結果は、すべてか無かの移行ではなく、ルーターの採用を強く支持するものである。.
最後に、不確実性を算出し、不安定なケースを再実行します。モデルの出力は変動する可能性があるため、1回限りの比較では運の要素が過大評価されてしまいます。サブセットを繰り返し実行し、評価者間の不一致を調査し、監査のために生出力を保存しておきます。最終的な推奨事項には、テスト実施日、モデルID、設定、データセットのバージョン、使用した価格、および既知の不備を明記する必要があります。 モデルの更新、プロンプトの変更、またはワークロードに有意な変化があった後は、再検討を行う。モデルの選択は、維持管理が必要な運用上の決定であり、永久に変わらない「トロフィー」ではない。.
評価者が「隠れた決定モデル」になってしまわないようにしてください。自動判定システムが特定の出力を強く好む場合は、その判定結果を抽出して専門家によるレビューを行い、実際の合格結果と比較してください。提示の質とタスクの正しさを区別してください。洗練された説明は要件を満たしていないことを隠してしまう一方で、簡潔な回答はすべてのテストに合格してしまう可能性があります。 また、勝者を強引に決定するのではなく、棄権や同点の結果も報告する。こうした詳細情報は結果の劇的な印象を薄めるが、予算策定やルーティングの決定においてははるかに有用である。目標は、他のチームメンバーが検証し再現できる、再現性のある運用ルールを確立することだ。却下された出力も記録しておくこと。失敗例は、平均スコアの表よりも、ルーティングの境界線をより明確に説明してくれることが多い。.
実際のコスト例
キャッシュされていない入力トークン200,000個と出力トークン20,000個で実行されるコーディングエージェントを考えてみましょう。Solのコストは約$0.60です。内訳は、入力に$0.40、出力に$0.20です。 Astraのコストは約$3.00です。内訳は、$2.00に$1.00が加算されたものです。 10,000回の実行全体で、ツール手数料、キャッシュ、地域ごとの割増、またはサービス階層の調整を考慮する前の差額は、およそ$24,000となります。.
ここで、入力トークン数30万、出力トークン数3万という長文のリクエストについて考えてみましょう。入力が272Kを超えているため、リクエスト全体に高いレートが適用されます。 Solの実効入力レートは100万あたり$4となり、出力は$15となるため、合計で約$1.65となります。 Astraの場合は、入力が$20、出力が$75となり、合計で約$8.25となります。5倍の関係は維持されますが、絶対的な差は拡大します。.
キャッシュにより、計算負荷はSol側にさらにシフトする可能性があります。これは、Solのキャッシュ入力レートがAstraの10分の1であるためです。これは、安定したシステム命令、大規模な反復参照、およびエージェントのスケフォールディングにおいて重要です。ただし、キャッシュへの書き込みには依然としてコストがかかり、プレフィックスを変更すると再利用率が低下する可能性があります。 すべてのトークンがキャッシュレートで処理されると仮定するのではなく、実際の使用ログに基づいて推定を行う。.
API内のモデルを比較する方法
ツールを利用するアプリケーションではResponses APIを使用し、比較の設定を同一に保ってください。最もシンプルで実用的なテスト環境は、両方のモデルIDに同じ入力を送信し、応答のメタデータを記録し、同じ評価器を実行するものです。ソースコード内にAPIキーを公開しないでください。環境変数と普段使用しているシークレットマネージャーを使用してください。.
サンプル数は意図的に少なくしています。本番環境のテスト環境では、リクエストID、評価ツールのバージョン、リポジトリのコミット、ツールのトレース、再試行回数、および受け入れ結果を保存する必要があります。また、実際に使用されたサービス階層とロングコンテキストバンドに基づいて価格を算出する必要があります。ルーティングシーケンスを明示的にテストしている場合を除き、一方のモデルが受け取ったフィードバックをもう一方のモデルが見られないようにしてください。.
SolからAstraへの実用的なルーティング戦略
2段階ルーターは、すべてのプロンプトが同等であるかのように装うことなく、Solにとって最も説得力のある経済的根拠を捉えます。 通常のトラフィックは、中程度の推論レベルでSolに送信する。決定論的テストが失敗した場合、モデルが低い信頼度を報告した場合、タスクが高リスクカテゴリに該当する場合、または人間が明示的にフラッグシップレビューを要求した場合は、エスカレーションを行う。コストが知らぬ間に増加しないよう、エスカレーションルールを可視化しておく。.
同じプロンプト、ツール、および受け入れテストを使用してください。.
テスト、信頼性、リスククラス、および人的レビュー。.
送信に失敗した場合やリスクの高い作業は、Astraに依頼してください。.
受入状況、手直し、遅延、および総コストを追跡します。.
ルーティングにより、チームはデフォルト設定を管理された方法で更新できるようになります。あるタスク群においてSolの受け入れ率が向上した場合は、その割合を拡大します。Astraがコストのかかる欠陥を繰り返し未然に防いでいる場合は、そのカテゴリを直接ルーティングします。これにより、比較検討は、単発的なモデルに関する議論ではなく、データに裏打ちされた運用方針となります。以前の世代の参考例については、以下を参照してください。 GPT-6 Astra 対 GPT-5.6 Sol.
レイテンシと信頼性は、同じルーティングポリシーに組み込むべきです。モデルがより強力な回答を生成できたとしても、その応答時間が対話型ワークフローを妨げたり、推論に時間がかかりすぎてジョブがタイムアウトしたりする場合は、デフォルトとして不適切となります。現実的な並行処理環境下で、ファーストトークンまでのレイテンシ、総所要時間、ツール呼び出しの回復時間、および正常完了率を測定してください。 次に、タスククラスごとにサービス目標を定義します。Solが時間的制約のある本番トラフィックを担当し、Astraが非同期のレビューを処理するようにすることも可能です。あるいは、難易度の高いタスクがエスカレーションされる前に日常的に失敗する場合は、その逆の役割分担も正当化されます。モデルの決定は、単なる編集上の判断ではなく、運用上の決定です。.
「Sol」を選ぶべきなのは誰で、「Astra」を選ぶべきなのは誰か?
コスト効率を重視した生産には、GPT-6.1 Solをお選びください
Solは、膨大な量の困難な作業をこなしつつも、測定可能な受け入れ基準を定めているプロダクトチーム、代理店、研究者、開発者に適しています。 特に、反復がプロセスの一部となっている場合——コード・テスト・修正のループ、文書の改訂、検証を伴うデータ抽出、研究結果の統合、多段階の内部エージェントなど——において、その真価が発揮されます。低価格であるため、より広範囲な評価と、より多くの再試行の機会を確保できます。.
品質が極めて重要で難易度の高い作業には、GPT-6 Astraをお選びください
Astraは、最も困難なタスクにおいてエラーのコストが高い、あるいは自動チェックが不十分なチームに適しています。難しいアーキテクチャの決定、最終的なセキュリティレビュー、斬新な科学的推論タスク、あるいは長時間にわたるコンピュータ操作などでは、フラッグシップモデルの導入に費用をかける価値があります。また、チームが小型モデルでは見逃してしまう点をまだ把握しておらず、コストが当面の制約となっていない初期の発見段階においては、Astraはより適切なデフォルトの選択肢となります。.
課題の難易度が異なる場合は、両方を使用してください
成熟したシステムの多くは、すべてのリクエストに単一のモデルを強制的に適用すべきではありません。幅広い中間領域にはSolを、エスカレーション層としてはAstraを使用します。予測可能な分類や変換には、Lunaやその他の小規模なモデルを追加します。この階層型設計は、実際のワークロードの多様性を反映しており、単一の「恒久的な最適解」を模索するよりも、通常は経済的です。当社の モデル検証手法 これは、再現可能な証拠と単なる印象とを区別するための有用な枠組みを提供する。.
GlobalGPTでGPT-6.1 SolおよびGPT-6 Astraを使用する方法
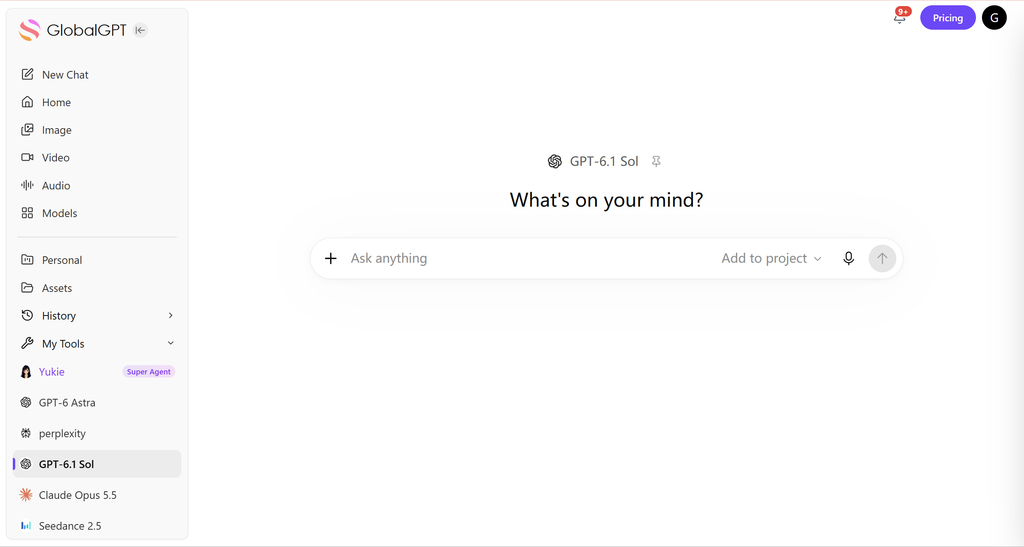
GlobalGPTでは、1つのマルチモデルワークスペース内で、両方のモデルのライブ製品ルートを提供します。 ワークスペースを開き、新しい会話を開始して、現在のモデルピッカーで「GPT-6.1 Sol」または「GPT-6 Astra」を選択してください。両方のモデルを1つのインターフェースにまとめておくことは、並行して探索的な作業を行う際に役立ちますが、自動スコアリング、正確な使用状況の把握、およびデプロイメント制御に関しては、APIによる評価の方が依然として適しています。.
最初のパスではSolから始め、その後、最も難しいプロンプトをAstraで再実行し、具体的にどのような点が変化したかを比較してください。.
GlobalGPTを開くモデルごとのより詳しい背景情報については、当社の GPT-6.1 Solの解説ガイド そして GPT-6 Astra レビュー. 。それらのページでは各モデルを個別に解説していますが、このページでは、各モデル間の購入や利用ルートの選択に焦点を当てています。.
よくある質問
GPT-6.1 SolはGPT-6 Astraよりも優れているのでしょうか?
絶対的な意味ではそうではありません。OpenAIでは、GPT-6 Astraを最も高性能なモデルとして位置づけ、GPT-6.1 Solを、複雑な作業においてAstraに匹敵する性能を持ちながら低コストなモデルとして位置づけています。品質基準を満たすのであれば、Solの方がコストパフォーマンスに優れています。一方、最も困難なタスクにおいては、品質を最優先する安全な選択肢としてAstraが適しています。.
GPT-6.1 Solは、GPT-6 Astraに比べてどれくらい安いのでしょうか?
標準レートでは、Solのコストは入力トークン100万枚あたり$2、出力トークン100万枚あたり$10であるのに対し、Astraはそれぞれ$10と$50となっている。 したがって、キャッシュされていない入力および出力の場合、SolはAstraよりも5倍安くなります。また、キャッシュされた入力の料金は$0.10であり、Astraの$1という料金の10分の1となっています。.
GPT-6.1 SolとGPT-6 Astraは、同じコンテキストウィンドウを持っていますか?
はい。OpenAIでは、両モデルともコンテキストウィンドウが1,050,000トークン、最大入力数が922,000トークン、最大出力数が128,000トークンと記載されています。入力トークン数が272Kを超えるリクエストの場合、リクエスト全体がより高いロングコンテキストレートに移行します。.
プログラミングにはどちらのモデルが適していますか?
Astraは、特に困難で曖昧、あるいはリスクの高いリポジトリ作業において、品質を最優先する選択肢です。一方、Solは、日常的な機能開発、デバッグ、レビュー、エージェントループにおいて実用的なデフォルトの選択肢です。その理由は、コストが低く抑えられているため、より多くの反復作業が可能になるからです。標準化する前に、同じリポジトリのテストに対して両方を試してみてください。.
どちらのモデルも、ツールと画像入力をサポートしていますか?
はい。公式のモデルページには、テキストおよび画像の入力、テキスト出力、構造化出力、関数呼び出し、Web検索、ファイル検索、コードインタプリタ、ホスト型シェル、パッチの適用、コンピュータ利用、MCP、スキル、ツール検索が記載されています。ツールの呼び出しには、Responses APIを使用する必要があります。.
GPT-6 Astraの料金はいつ支払うべきですか?
エラーのコストが高い場合、タスクが真に最先端レベルである場合、あるいは比較評価の結果、その付加価値によって手戻りが十分に削減され、トークン価格の5倍のコストを正当化できることが示された場合には、Astraを使用してください。例としては、重要な移行作業、難易度の高い自律型コンピュータの運用、および重大な成果物の最終レビューなどが挙げられます。.
どの推論手法を選べばよいでしょうか?
まず、両モデルで文書化されているデフォルト設定である「中」から始めます。単純な変換の場合は設定を低くし、タスクの難易度やエラーコストが要求する場合にのみ設定を高くします。効率的な設定とは、受け入れテストを安定して通過できる最小限の設定です。.
GlobalGPTでGPT-6.1 SolとGPT-6 Astraは使用できますか?
GlobalGPTのマルチモデルワークスペースには、GPT-6.1 SolとGPT-6 Astraの両方について、稼働中のルートが用意されています。利用可能状況はアカウントやインターフェースによって異なる場合がありますので、本番ワークフローを開始する前に、ワークスペースを開いて現在のモデルピッカーを確認してください。.
すべてのプロンプトを1つのモデルにルーティングすべきでしょうか?
通常はそうではありません。シンプルなルーターであれば、通常の処理はSolに任せ、信頼性が低いケース、テストに失敗したケース、あるいはリスクの高いケースをAstraにエスカレーションすることができます。これにより、Solのコスト面での優位性を最大限に活かしつつ、限界的な能力に測定可能な価値があるプロンプトについてはAstraを活用することができます。.
最終評決
コストを重視するチームが最初に評価すべきモデルはGPT-6.1 Solであり、最も困難な作業については、引き続きGPT-6 Astraをエスカレーション先とすべきである。. 両者に共通するコンテキスト、出力制限、モダリティ、推論制御、ツールカタログにより、比較が極めて明確に行えます。Solは経済的な優位性をもたらし、Astraは公式な機能面での優位性を備えています。.
決定的な指標は、トークン価格やモデルの評判だけではありません。実際の運用上の制約や予算の下で、受け入れられた結果1件あたりのコストを測定してください。もしSolが同程度の合格率を達成するのであれば、そのキャッシュされていない入出力レートが5分の1であるという事実は、無視しがたいものです。 もしAstraが失敗を防ぎ、専門家によるレビューを削減し、あるいはSolでは解決できない課題を解決できるのであれば、そのプレミアムは合理的であると言える。まず同一のタスクから始め、可能な限り評価をブラインドで行い、その地位にふさわしいモデルと推論の取り組みのみを評価すべきである。.









