
Claude Sonnet 5.5 対 Opus 5.5:価格、ベンチマーク、実機テスト
Sonnet 5.5とOpus 5.5は、ともにClaude 5.5世代に属していますが、価格設定や市場での位置づけは異なります。この比較では、両製品に同じ5つのプロンプトを入力し、実際に返された結果を報告します。.
その差は、主にコストとスピードにある。. この5つのプロンプトからなるパックでは、Sonnet 5.5の方が処理時間が短く、出力トークンの使用量も少なく、算術リクエストコストの推定値も低くなりました。一方、Opus 5.5はトークンと処理時間をより多く消費し、その回答はしばしば冗長なものでした。タスクカードには、その余分なテキストが有用な結果にどのような変化をもたらしたか、また両モデルが単に合格した箇所が示されています。.
プロンプト、リクエストの上限、労力設定、エンドポイント、および「モデルごとに1回の実行」という設計は、前回と同様に維持された。 Claude Opus 5.5 レビュー.
簡単な回答
- このマッチランでのスピード: Sonnet 5.5は、ローカル環境で5つの連続したリクエストを31.930秒で処理し終えた。一方、Opus 5.5は47.725秒を要した。.
- ルートから報告された出力トークン: Sonnet 5.5では2,686が使用され、Opus 5.5では3,952が使用された。シンキング・フィールドは、それぞれ987と2,214であった。.
- 算術的な定価見積もり: 公式の標準トークン単価を使用し、キャッシュ、クレジット、税金、およびマージンを除いた場合、5件のSonnetリクエストの合計は約$0.02826、5件のOpusリクエストの合計は約$0.08184となりました。.
- タスクの結果: どちらのモデルも、抽出、JSON、数学の課題をクリアしました。Sonnetは、求められた2段落構成の中国語形式をより正確に維持していました。コーディングの出力はどちらも実用的なものでしたが、詳細度やエッジケースの説明において違いが見られました。.
- APIの移行: 思考を無効にすることはできません。ツールの選択を強制することは認められず、トークンの予算には思考も含まれます。以下を確認してください。 移行に関する注意事項 切り替える前に。.
- 決定境界: これは、サードパーティのルートを経由したタスクごとの1回の実行結果です。観測されたプロンプトへの応答、ローカルの実時間、およびルートから報告された使用状況を測定するものであり、普遍的な機能スコアではありません。.
公式価格およびモデル仕様
Anthropicの現在のモデルカードには、コンテキストウィンドウが1Mトークンで、最大出力が128Kの2つのモデルが記載されています。Sonnet 5.5には次のように記載されています。 速い デフォルトでの処理に多大な労力を要する;Opus 5.5には「」というラベルが付けられている 中程度 デフォルトの「中」の労力で。標準のトークンレートでは、Sonnet 5.5はOpus 5.5の入力価格および出力価格の半分となります。.
| モデル | API ID | 公式レイテンシーラベル | 入力/出力 | コンテキスト / 最大出力 | デフォルトの取り組み | キャッシュ読み取り |
|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | claude-sonnet-5-5 | アクティブ・高速 | $2 / $10(MTokあたり) | 1M / 128K | 高い | $0.20 / MTok |
| Claude Opus 5.5 | クロード・作品第5番第5曲 | アクティブ・中程度 | $4 / $20(MTokあたり) | 1M / 128K | ミディアム | $0.20 / MTok |
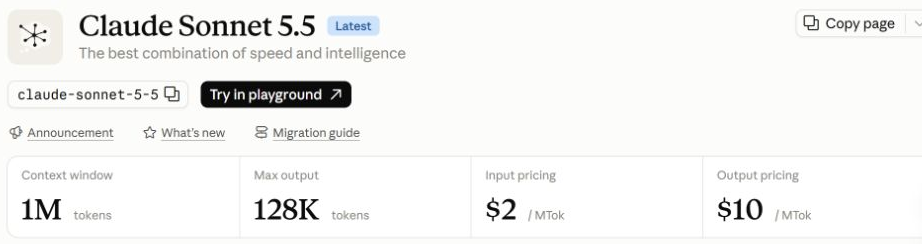
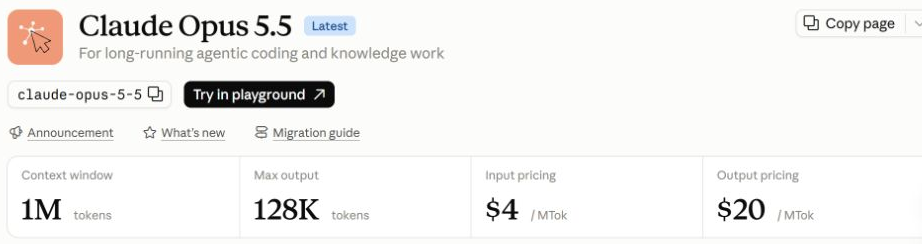
入力トークン100,000個と出力トークン20,000個という、キャッシュを使用しない単純な例の場合、記載されているトークンレートは、Sonnet 5.5では約$0.40、Opus 5.5では$0.80となります。 詳しくは Claude の価格および制限に関するガイド 計画の文脈において。.
公式ベンチマークの背景
Anthropicの Sonnet 5.5 に関するお知らせ 両方のモデルを、プロバイダーが報告した1つの表にまとめます。行の構成は、ベンチマークと労力設定によって異なります。.
| Anthropicが報告したベンチマーク | Sonnet 5.5 | 作品第5.5番 | 測定 |
|---|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4%¹ | エージェンティック終端符号化 |
| FrontierCode v1.1 (メイン) | 46.2% Max² / 52.1% Xhigh | 54.4% | コードの変更がマージされるかどうか |
| CursorBench 4.0 | 55.5% | 57.8% | 曖昧な複数ファイルのコーディング作業 |
| GDPval-AA v2.1 | 1844 | 1846 | 職種を横断した知識労働 |
| 人類の最終試験 | 64.5%(工具付き) | 67.7%(工具付き) | 学際的な推論 |
| OSWorld 2.1 | 80.1% 部分 | 81.8% 部分 | コンピュータを用いた作業 |
| 地図学 | 61.6% 工具不要 | 64.4% 工具不要 | 図表の認識 |
¹ Opus 5.5 Terminal-Bench は「xhigh」負荷を使用しています。² Sonnet 5.5 FrontierCode は、最大負荷時で 46.2%、Xhigh 負荷時で 52.1% です。 OSWorldの値は「部分的」とマークされています。これらはプロバイダー固有のコンテキストによるものであり、等負荷での独立した再実行結果ではありません。.
同じプロンプトのAPIメソッド
各モデルには、を通じて同じ5つのプロンプトが与えられました 投稿 https://anywhere.broly.ai/v1/messages. クライアントは1件のユーザーメッセージを送信し、, max_tokens: 8192, output_config.effort: high, 、しかもツールは一切使用しませんでした。すべてのリクエストに対してHTTP 200が返され、 ターン終了.
このテスト手法は、より広範な GlobalGPT モデル検証ワークフロー. 別の Claude APIガイド リクエストの設定とトークンの管理について解説します。.
所要時間、トークン、および推定費用
| ルート | 現地時間の5回 | 入力トークン | 出力トークン | 伝えられている考え | リクエストの推定費用* |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 31.930秒 | 700 | 2,686 | 987 | $0.02826 |
| Claude Opus 5.5 | 47.725秒 | 700 | 3,952 | 2,214 | $0.08184 |
* ルート報告トークン数および公式の標準レートに基づく推定値。このパックにおいて、Sonnet 5.5は、ローカル経過時間では33.1%低く、出力トークン数では32.0%低かった。.
5枚のペアになったタスクカード
各カードには、タスク、観察内容、現地時間、ルート報告トークン、ステータス、および境界情報がまとめて記載されています。.
これらのモデルは、混合型の重複排除機能を修復できるでしょうか?
タスクの設定: その正確なプロンプトは、以前の投稿からコピーしたものです。 Claude Opus 5.5 レビュー テストパック。.
| モデル | 所要時間/ルートの利用状況 | 結果の短いラベル |
|---|---|---|
| Claude Sonnet 5.5 | 8.679秒 入力145/出力830 0 思考 HTTP 200 · end_turn | 関数の解答と2つの演習問題;解説を簡潔にしました。. |
| Claude Opus 5.5 | 15.844秒 入力 145 / 出力 1478 700の考え方 HTTP 200 · end_turn | 関数の修正と2つのテストを追加。エッジケースに関する考察をさらに追加。. |
観察された比較: どちらも修正済みの関数と2つのテストを返しました。Sonnet 5.5では型タグ付きキーが使用され、, casefold(), 、そしてより短い応答ではリストによるフォールバックが採用された。Opus 5.5は、追加のエッジケースを説明するために、より多くの出力トークンを費やした。どちらの実行結果も、コーディングの勝者を一概に決定づけるものではない。.
境界: Pythonの小さな修正1つで、具体的なエッジケースは確認できますが、リポジトリ全体にわたる信頼性や、ツール主導のコーディングについては確認できません。.
モデルは、与えられた5つの事実を、主張を追加することなく保持できるでしょうか?
タスクの設定: その正確なプロンプトは、以前の投稿からコピーしたものです。 Claude Opus 5.5 レビュー テストパック。.
| モデル | 所要時間/ルートの利用状況 | 結果の短いラベル |
|---|---|---|
| Claude Sonnet 5.5 | 3.569秒 入力210/出力209 0 思考 HTTP 200 · end_turn | 番号付きの箇条書きが5つ。提示された事実はそのまま維持。. |
| Claude Opus 5.5 | 4.374秒 入力210/出力312 101の考え方 HTTP 200 · end_turn | 番号付きの箇条書きが5つ。提示された事実はそのまま維持。. |
観察された比較: どちらも番号付きの箇条書きを正確に5つ返し、与えられた事実の範囲内に収まりました。Sonnet 5.5は209個の出力トークンを使用したのに対し、Opus 5.5は312個でしたが、プロンプトは文脈の広い入力ではなく、短いメモでした。.
境界: これは、実環境での抽出およびフォーマットチェックの結果であり、100万トークン規模のコンテキストにおけるパフォーマンスを示す証拠ではありません。.
モデルは、要求された構造と完全に一致する結果を返すことができますか?
タスクの設定: その正確なプロンプトは、以前の投稿からコピーしたものです。 Claude Opus 5.5 レビュー テストパック。.
| モデル | 所要時間/ルートの利用状況 | 結果の短いラベル |
|---|---|---|
| Claude Sonnet 5.5 | 5.052秒 入力128 / 出力260 0 思考 HTTP 200 · end_turn | 解析可能なJSON。要求されたキーと項目数。. |
| Claude Opus 5.5 | 8.276秒 入力128 / 出力622 390の思考 HTTP 200 · end_turn | 解析可能なJSON。要求されたキーと項目数。. |
観察された比較: どちらも、リクエストされたキーと「長所2つ・短所2つ」を含む、解析可能なJSONを返しました。Sonnet 5.5は出力トークン数が260で、より簡潔でした。これらの文字列は架空のレビュー設定を記述したものであり、製品の事実ではありません。.
境界: このスキーマを一度実行しただけでは、ツールの呼び出し時や長時間の会話における構造化出力の信頼性を測定することはできません。.
これらのモデルは、丸め処理されたバッチシーケンスを最終的な答えまで反映させることができるでしょうか?
タスクの設定: その正確なプロンプトは、以前の投稿からコピーしたものです。 Claude Opus 5.5 レビュー テストパック。.
| モデル | 所要時間/ルートの利用状況 | 結果の短いラベル |
|---|---|---|
| Claude Sonnet 5.5 | 2.947秒 入力89/出力163 0 思考 HTTP 200 · end_turn | 正解:67;最終答えは別行に記入してください。. |
| Claude Opus 5.5 | 3.830秒 入力89/出力257 74の考え方 HTTP 200 · end_turn | 正解:67;最終答えは別行に記入してください。. |
観察された比較: どちらも67と計算し、最終的な答えを別行に表示した。Sonnet 5.5の出力トークン数は163であったのに対し、Opus 5.5は257であったが、このプロンプトに関しては正答性に違いは見られなかった。.
境界: ある等差数列だけでは、広範な推論の信頼性を評価することはできない。.
このルートでは、要望通りの2段落構成を維持することは可能でしょうか?
タスクの設定: その正確なプロンプトは、以前の投稿からコピーしたものです。 Claude Opus 5.5 レビュー テストパック。.
| モデル | 所要時間/ルートの利用状況 | 結果の短いラベル |
|---|---|---|
| Claude Sonnet 5.5 | 11.683秒 入力128 / 出力1224 987の思考 HTTP 200 · end_turn | 中国語の段落が2つ。余分な枠付けはありません。. |
| Claude Opus 5.5 | 15.401秒 入力128 / 出力1283 949の思考 HTTP 200 · end_turn | 要点を網羅しました。Markdownと英語の注釈を追加しました。. |
観察された比較: Sonnet 5.5は、余分な枠付けなしに、要求された2つの中国語の段落を返しました。Opus 5.5も要求された点を網羅していましたが、Markdownの枠付けと英語の注釈が追加されていました。これは、1回の処理における出力形式を記録したものであり、中国語の品質全般を示すものではありません。.
境界: このプロンプトは『Opus 5.5』に関する導入文を求めているため、本文自体は中立的な言語のベンチマークとはなりません。.
APIおよび移行に関する注意事項
Sonnet 5.5 はデフォルトで適応型思考を実行します。「thinking: disabled」と指定すると 400 エラーが返され、max_tokens は思考と応答テキストの両方を対象とします。tool_choice に「any/tool」を強制的に指定しても拒否されます。切り替えを行う前に、コンテンツブロックをタイプ別に解析し、トークン予算の基準値を再設定してください。.
証拠が裏付けていること
タスクレベルの判定
Sonnet 5.5: このルートではコストと所要時間が削減され、中国のタスクについては規定のフォーマットに正確に準拠している。.
作品5.5: ここでは価格も高く、コストもかかるが、いくつかのオープンエンドなタスクにおいて、公式のベンチマーク結果は依然として上位を維持している。.
タスクレベルの証拠を基に起点を選び、自分にとって重要な作業負荷を検証してください。.
関連する文脈については、以下の Claude ファミリーの比較, 『Opus 5』のレビュー, そして Fable 5.1 レビュー.
よくあるご質問
比較テストでは、どちらのモデルの方が速かったのでしょうか?
Sonnet 5.5は、5回連続のリクエストにおいて、Opus 5.5の47.725秒に対し、31.930秒というより低いローカル合計時間を記録しました。これには、ここで使用されたルートおよびネットワークパスが含まれているため、プロバイダ側の遅延ではありません。.
どちらのモデルの方が出力トークンの数が少なかったでしょうか?
Sonnet 5.5は5つのタスク全体で2,686個のルート報告出力トークンを使用したのに対し、Opus 5.5では3,952個であった。トークン数だけでは回答の質を証明することはできない。.
今回の実行では、どちらのモデルの方が安かったのでしょうか?
公式の標準APIレートと返された入出力カウントを用いて計算すると、5件のSonnet 5.5リクエストの推定値は$0.02826となり、一方、Opus 5.5の場合は$0.08184となります。 この計算には、キャッシュ料金、プラットフォームクレジット、税金、およびマージンは含まれていません。.
Sonnet 5.5は、すべてのベンチマークでOpus 5.5を上回るのでしょうか?
No. Anthropic独自の表は、ベンチマークと負荷設定によって結果がまちまちです: Sonnet 5.5はTerminal-Bench 4.0で高いスコアを記録している一方、Opus 5.5はFrontierCode、CursorBench、GDPval-AA、Humanity’s Last Exam、OSWorld、Chartographyで高いスコアを記録しています。これらはベンダーが報告した結果であり、独立した再実行によるものではありません。.
Sonnet 5.5は、APIのドロップイン置換となりますか?
いいえ。移行ガイドによると、thinkingはデフォルトで実行され、「thinking: disabled」と指定すると400エラーが返され、「any/tool」によるツールの強制選択は拒否されます。また、クライアントはコンテンツブロックをタイプごとに解析する必要があります。切り替えを行う前に、トークン予算とツールループのベースラインを再設定してください。.
これは長期的なベンチマークだったのでしょうか?
いいえ。抽出プロンプトには短い文章が含まれています。これは、事実に基づく根拠と正確な書式が正しいかどうかを検証するものであり、文書化された100万トークンのコンテキストウィンドウ周辺での挙動を測定するものではありません。.



